
このメモは、RDMA の内部構造、特に DGX Spark (右の画像) に統合された 200Gb connectX-7 などの PCIe サブシステムと相互接続する「RDMA 準拠 NIC」を作成するために必要なことを理解することを目的としています。
RDMAを「クライアントサーバー」プロトコルとして使用する
見出しへのリンク
このメモは、RDMAプロトコルの概要から始めましょう。
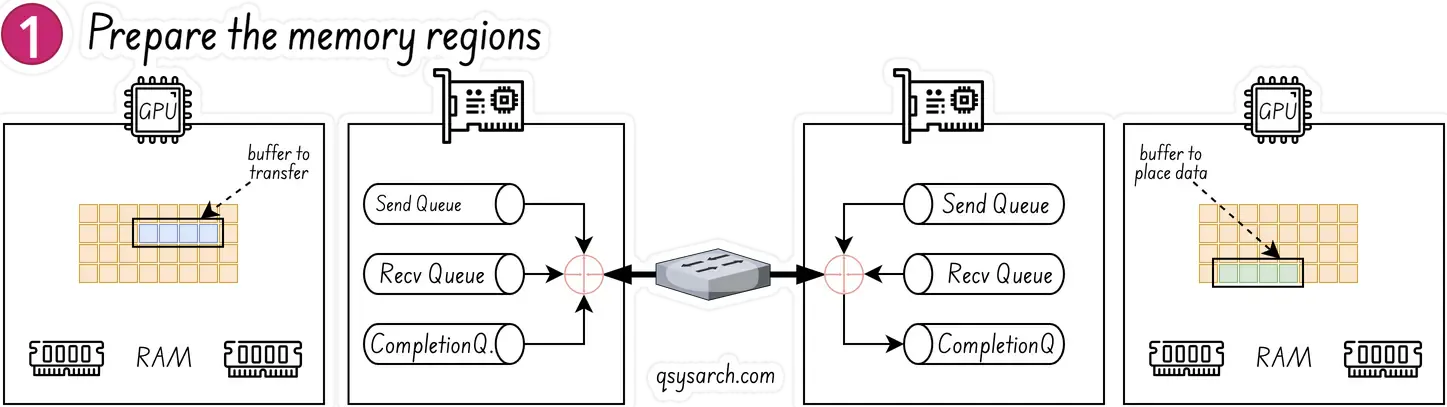
RDMAデータチャネルを設定する際、メモリバッファは使用する前にネットワークカードに登録する必要があります。登録プロセスは以下の手順で構成されます。
RDMA通信は3つのキューのセットに基づいています
SQ: 送信キュー
RQ: 受信キュー
CQ: 完了キュー
RDMAキューペア、または「QP」とは、送信キューと受信キューを指します。
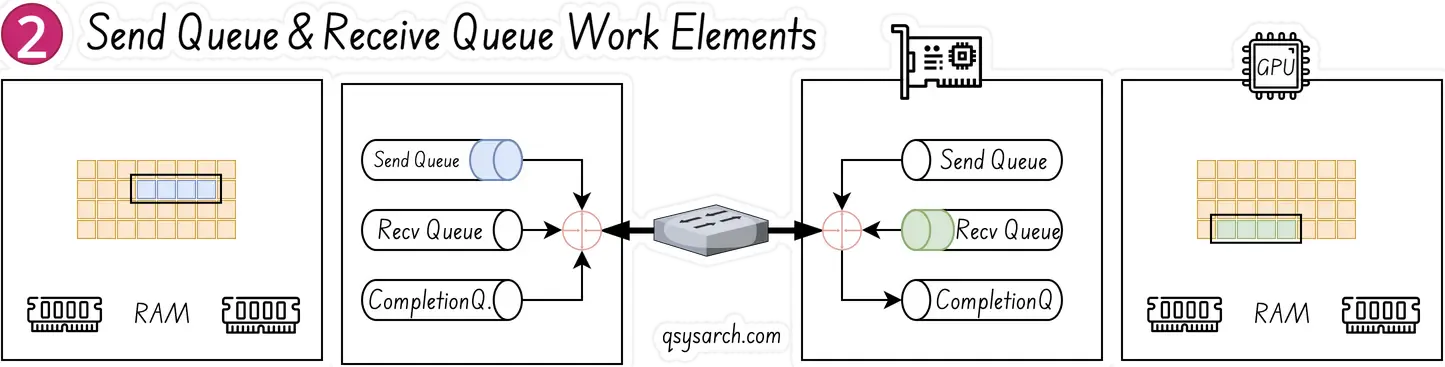
アプリケーションは、ワークリクエスト(ワークキュー要素(WQE)とも呼ばれる)を使用してジョブを発行します。ワークリクエストは、バッファへのポインタを持つ小さな構造体です。
作業依頼が完了すると、アダプタは完了キュー要素を作成し、それを完了キューに追加します。
送信側(左)と受信側(右)は、キューペアと完了キューを作成し、RDMAを実行するためのメモリ領域を登録しました。送信側は、受信側へ移動させたいバッファを指定します。受信側は、データを格納するための空のバッファを確保しています。
右側の受信側エンティティは、ワークキュー要素WQE_WOOKIE_を作成し、受信キューに配置します。このWQEには、データが配置されるメモリバッファへのポインタが含まれています。左側の送信側エンティティも、送信されるメモリ内のバッファを指すWQEを作成します。
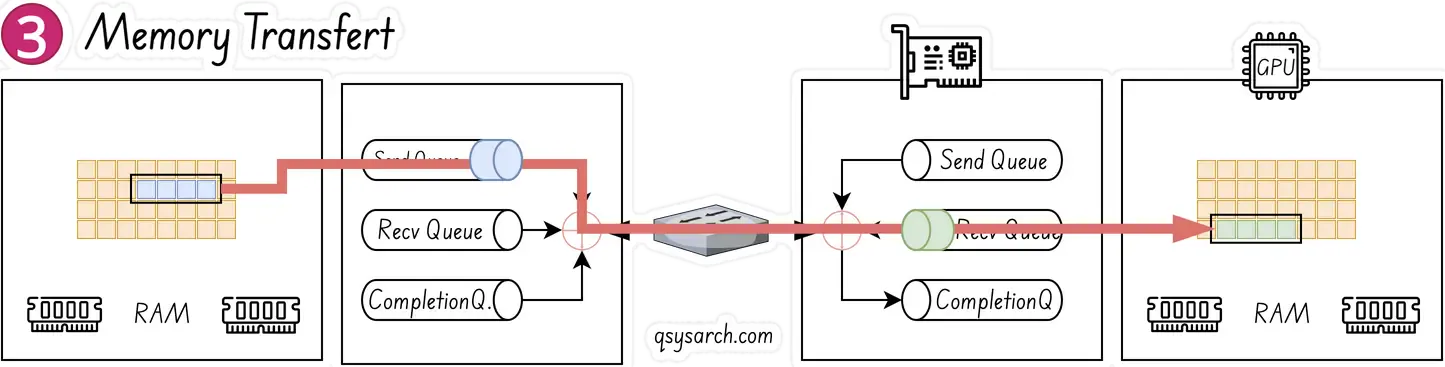
NIC(RDMA準拠のハードウェアNIC、別名RNIC)は、送信キュー上のWQEを常にポーリングして探しています。この処理はGPUやCPUを介さずに行われ、ポーリングはRNICのみに影響します。CPUからWQEがプッシュされると、RNICは送信側でそれを消費し、メモリ領域から受信側へのデータのストリーミングを開始します。受信側にデータが到着し始めると、RNICは受信キュー内のWQEを消費して、データの配置場所を決定します。
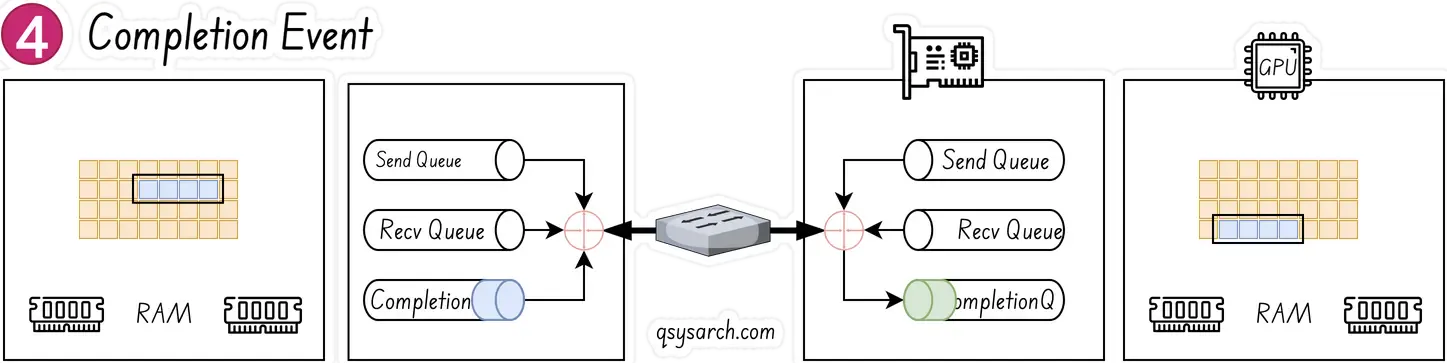
最終段階として、データ転送が完了すると、RNICは完了イベントCQE「COOKIE」を作成し、完了キューに配置します。このイベントは、トランザクションが完了したことを示します。WQEが消費されるごとに、CQEが生成されます。
画像クレジット
送信側のみがアクティブであり、受信側はパッシブであることに注意することが重要です。パッシブ側は操作を実行せず、CPUサイクルを使用せず、「読み取り」または「書き込み」が発生したことを示す情報も受け取りません。
RDMAの読み取りまたは書き込みを発行するには、ワークリクエストに以下を含める必要があります。
リモート側の仮想メモリアドレス
リモート側のメモリ登録キー
つまり、アクティブ側はパッシブ側のアドレスと鍵を事前に取得する必要があるということだ。
ネットワークパケットの観点から見たRDMA
見出しへのリンク
この部分は、Toni Pasanen氏のNetwork Timesによる優れた記事に基づいています。
クライアント計算ノード(別名CCN)上のアプリケーションは、サーバー計算ノード(SCN)上のアプリケーションに通信要求(REQ)メッセージを送信することにより、接続確立を開始します。
REQメッセージには、物理的なRNICとポートを識別する手段が含まれています。
- チャネルアダプタのローカル通信識別子(
LID)とグローバル一意識別子(ローカルCA GUID)。ローカルCA GUIDはRNICを識別し、ローカル通信IDはNIC上のポートを識別します。
REQメッセージには、キューペアに関するすべてのメタ情報も含まれています。
REPメッセージはQPメタデータの確認応答です。そして最後に、クライアントはRTU(Ready to Use)メッセージを返信し、QPが確立されたことをサーバーに確認します。セッションが確立されると、CCN上のアプリケーションはRDMA書き込み処理を開始できます。

用語:
CCN: クライアントコンピューティングノード
SCN: サーバーコンピューティングノード
PD: 保護ドメイン
L_Key、R_Key:ローカルキーとリモートキー
QP: キューペア (QP) = 送信キュー + 受信キュー。
CQ: 完了キュー
RC:信頼性の高い接続
UD: 信頼性の低いデータグラム
要求: CCN はローカル ID、QP 番号、P_Key、および PSN を送信します。
返信: SCN は ID、QP 情報、および PSN で応答します。
RTU: 使用準備完了: CCNが接続を確認します。
WR: 作業依頼
後日完成予定 - ここで言及する価値のあるWRメッセージには特に目立った点はありません - 詳細を知りたい場合は、Toni Pasanen氏のNetwork TimesとInfiniBand Transport Protocolを参照してください。
ネットワーク転送の観点から見たRDMA
見出しへのリンク
RDMA UC(Unreliable Connected)は再送信を行いません。UCはコネクションレス型の信頼性の低いデータグラムサービスであるため、信頼性の管理とパケット損失の処理はアプリケーションに委ねられます。ネットワークインターフェイスカード(NIC)は再送信を試みずにパケットを破棄し、アプリケーションは失われたデータの追跡と再要求を担当します。これは、ネットワークハードウェアが再送信を処理する信頼性の高い接続(RC)QPとは対照的です。では、RDMA UCアプリケーションはパケットが失われたことをどのように知るのでしょうか?
パケットシーケンス番号(PSN):アプリケーションは送信する各パケットに一意の連番を割り当てます。受信側はこのシーケンス番号を記録します。シーケンス番号に欠落がある場合は、1つ以上のパケットが失われたことを示します。
タイムアウト:アプリケーションレベルのプロトコルはタイムアウトメカニズムを実装できます。一定期間内に応答または確認応答が受信されない場合、アプリケーションはパケットが失われたと判断し、再送信を開始します。
- アプリケーションレベルのパケット損失回復

受信側がシーケンス内でパケットの損失を検出した場合、送信側にそのパケットを再送信するよう通知する必要があります。そして、送信側に通知するために使用されたパケット自体も損失した場合、非常に複雑な状況に陥る可能性があります。
- タイムアウト:送信側は、受信側が受信したパケットに対して確認応答を行うことを期待します。確認応答がない場合、送信側はまだ確認応答されていないパケットを積極的に再送信します。
RDMA QPの上に、常に別の信頼性モジュール(https://www.usenix.org/system/files/osdi23-li-qiang.pdf)を構築する必要があるのでしょうか?必ずしもそうではありません。状況によっては、パケットの損失を理由に、失われたパケットを再送信するのではなく、セッション全体を失敗とみなすことが許容される場合があります。このアプローチが有効なのは、基盤となるネットワークが通常、1兆パケットあたり1つのエラーなど、非常に高い信頼性を提供できるほど信頼性が高いためです。
優先フロー制御 (PFC) および明示的輻輳通知 (ECN)
見出しへのリンク
RDMA UCは信頼性の低いプロトコルであるため、パケットが失われたかどうかを本質的に認識することはできません。そのため、パケット損失はアプリケーションまたは上位レイヤーによって処理されます。RDMAにおける「ロスレス」保証は、優先フロー制御(PFC)や明示的輻輳通知(ECN)といった基盤となるネットワーク技術によって実現され、これらの技術はそもそもパケット損失を防ぎます。
このプロトコルは、RDMAデータセグメントをUDPデータセグメントにカプセル化し、UDPヘッダー、IPヘッダー、そして最後にイーサネットヘッダーを追加することで、3層構造のデータパケットを形成します。イーサネットVLANのPCPフィールド、またはIPヘッダーのDSCPフィールドを用いて分類することができます。
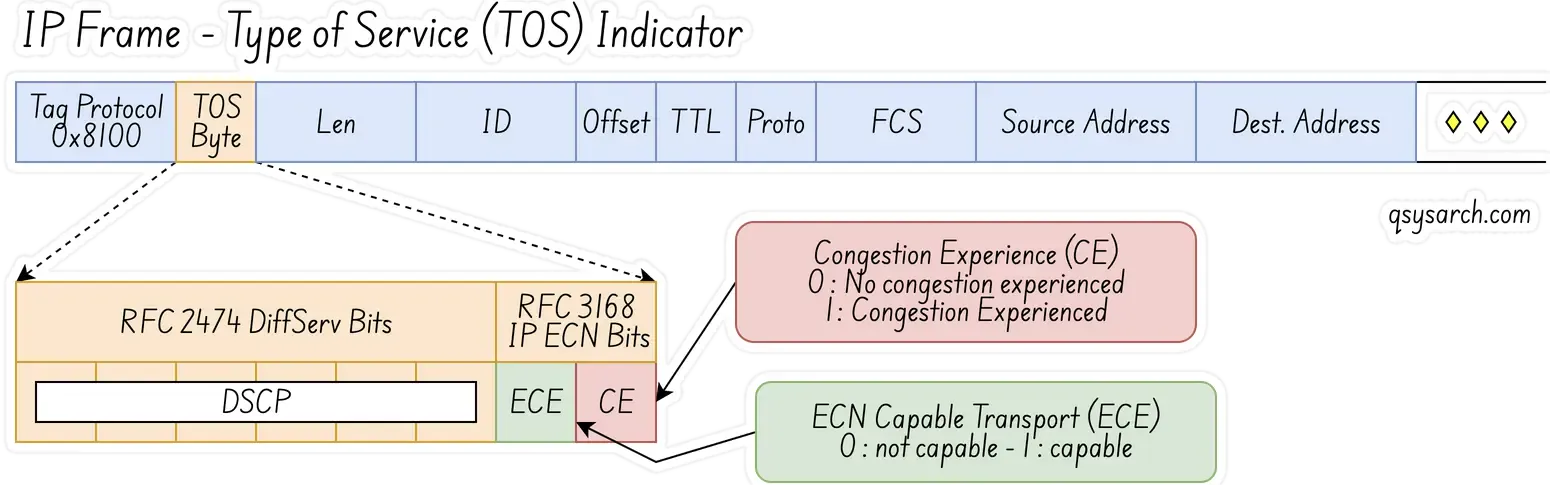
簡単に言うと、レイヤ2ネットワークの場合、PFCはVLAN内のPCPビットを使用してデータフローを区別します。レイヤ3ネットワークの場合、PFCはPCPとDSCPの両方を使用できるため、異なるデータフローが独立したフロー制御を受けることができます。現在、ほとんどのデータセンターはレイヤ3ネットワークを使用しているため、PCPよりもDSCPを使用する方が有利です。
画像クレジット
 PCIe の分析は、Dolphin の優れた論文 SmartIO: Zero-overhead Device Sharing through PCIe Networking に基づいています。
PCIeの最大の特徴は、右図に示すように、デバイスがCPUやシステムメモリと同じアドレス空間にマッピングされる点です。このマッピングのおかげで、CPUはシステムメモリにアクセスするのと同じ方法でデバイスメモリへの読み書きを行うことができます。これは一般的にメモリマップドI/O(MMIO)と呼ばれています。
初期化時にシステムが PCIe ツリーをチェックすると、各デバイスのメモリ領域用にメモリ アドレス範囲が (BIOS またはカーネルによって) 予約されます。この予約されたアドレスは、デバイスのベース アドレス レジスタ (BAR) に書き込まれます。デバイスは最大 6 つの BAR を持つことができます。
PCIeは、物理的な割り込み線ではなく、メッセージシグナル割り込み(MSI)を使用します。MSIをサポートするデバイスは、システムから指定された特定のアドレスとペイロードを使用して、メモリ書き込みをCPUに送信します。CPUはこのメモリ書き込みを読み取り、その情報を使用して割り込みを発生させます。
MSI-XはMSIの拡張機能であり、最大2048種類の割り込みベクタを利用できます。MSI-Xの利点の1つは、マルチコアシステムにおいて特定のCPUコアをターゲットにできることです。また、異なるMSI-Xベクタは、異なる種類のイベントを通知できます。
ConnectX-8 最適化設計
見出しへのリンク
[1] 2 つの CPU ソケットを介した GPU 間通信: 従来の設計では、この経路はホスト CPU とソケット間のボトルネックに遭遇し、CPU 間リンクの使用率に基づいて 25 GB/s 以下に制限される可能性があります。これに対し、最適化された CX8 ベースの設計では、NCCL がすべてのトラフィックをネットワーク経由で直接ルーティングするため、クラスタ内のすべての GPU 間通信で GPU あたり最大 50 GB/s の IO 帯域幅を実現できます。
[2] GPUとNIC間の通信:最適化されたアーキテクチャにより、GPUまたはホストシステムがPCIe Gen5またはGen6をサポートしているかどうかに関係なく、2:1のGPU-NIC構成で各GPUに50 GB/sの帯域幅が提供されます。
[3] 同じ PCIe スイッチを介した GPU 間転送: PCIe Gen6 を搭載したシステムは、Gen5 と比較して帯域幅が 2 倍になるため、同じ PCIe スイッチを介したピアツーピアの GPU 転送が大幅に高速化されます。
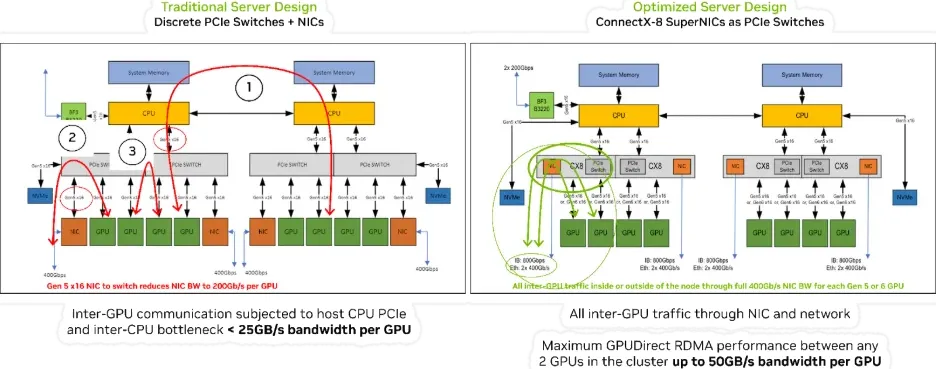
参考資料:NVIDIA ConnectX-8 SuperNICsプラットフォームアーキテクチャ
プログラムAPIの観点から見たRDMA
見出しへのリンク
このセクションは、Netdev 0x16 RDMA チュートリアル に基づいています。
## 設定
PDとCQを含む必要なオブジェクトを作成します。
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
.cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
データを保持するためのバッファを割り当て、それをlibibverbsに登録します。
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
ソケットのような、非同期イベント駆動型インターフェース。(必須ではないが、複数のトランスポートをカバーする抽象化を提供する)まず、「イベントチャネル」を作成します。
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
両側でサーバーアドレスを解決します。
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
パッシブ側(SCN)は、リスニング「ID」を作成してバインドし、以下の処理をリッスンします。
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
アクティブ側はサーバーのIDを作成し、アドレスを解決します。
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
接続イベントを処理するためのイベントループ:
struct rdma_cm_event *event;
while (true) {
err = rdma_get_cm_event(test.channel, &event);
switch (event->event) {
case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
}
rdma_ack_cm_event(event);
}
対処すべき注目すべきイベント:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
散布リストとキュー作業リクエストを入力して、受信キューに渡します。
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
収集リストとキュー作業リクエストを入力して、キューに送信します。
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
完了キューエントリの非ブロッキングチェック
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
end_flag = true;
/* consume cq->status, cq->wr_id, etc */
err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
GPUダイレクトの観点から見たRDMA
見出しへのリンク
ここからが非常にややこしくなります。「GPUDirect RDMA」とRDMAの関係は何でしょうか?以前の投稿で述べたように、Nvidiaの公式ドキュメントでは、両者に関係はないとされています。その理由を理解するには、それがまだMellanoxの技術だった頃、2016年頃まで遡る必要があります。当時の仕様には次のように書かれていました。
GPU間通信における最新の進歩は、GPUDirect RDMAです。この新しい技術は、GPUメモリとNVIDIA HCA/NICデバイスとの間で直接的なP2P(ピアツーピア)データパスを提供します。これにより、GPU間通信の遅延が大幅に削減され、CPUの負荷が完全に軽減され、ネットワーク上のすべてのGPU間通信からCPUが排除されます。
GPUNetIO 仕様 には、NIC-GPUメモリの相互作用を有効にするには、次の手順が必要であると記載されています。
NICがGPUメモリを使用してパケットを送受信できるようにするには、通常CUDAツールキットのインストールに含まれているNVIDIAカーネルモジュールnvidia-peermemをロードします。
GPUパケット処理ネットワークアプリケーションは、大きく2つのフェーズに分けられます。
CPU のセットアップフェーズでは、アプリケーションは次のことを行う必要があります。
このため、DOCA GPUNetIOは2つのライブラリで構成されています。
例: UDPネットワークトラフィック
見出しへのリンク
これは、受信および分析パケット ヘッダーの最も一般的な使用例です。100Gb/s の受信ネットワーク トラフィックに対応するように設計された UDP トラフィックを担当する CUDA カーネルは、512 個の CUDA スレッド (ファイル gpu_kernels/receive_udp.cu) からなる 1 つの CUDA ブロックを別の Ethernet UDP 受信キューに割り当てます。
データパスループは次のとおりです。
doca_gpu_dev_eth_rxq_receive_block という GPUNetIO 関数を使用してパケットを受信します。
各CUDAスレッドは、受信したパケットのサブセットを処理します。
パケットを含む DOCA バッファを取得します。
パケットのペイロードを分析し、DNSパケットを他の一般的なUDPパケットと区別します。
パケットのペイロードをクリアして、古いパケットが再度解析されないようにします。
各CUDAブロックは、DOCA GPUNetIOセマフォを使用してCPUスレッドに統計情報を送信します。
CPUスレッドはセマフォをチェックして統計情報を取得し、コンソールに出力します。
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
struct doca_gpu_eth_rxq *rxq0,
struct doca_gpu_eth_rxq *rxq1,
struct doca_gpu_eth_rxq *rxq2,
struct doca_gpu_eth_rxq *rxq3,
int sem_num,
struct doca_gpu_semaphore_gpu *sem0,
struct doca_gpu_semaphore_gpu *sem1,
struct doca_gpu_semaphore_gpu *sem2,
struct doca_gpu_semaphore_gpu *sem3)
{
__shared__ uint32_t rx_pkt_num;
__shared__ uint64_t rx_buf_idx;
__shared__ struct stats_udp stats_sh;

doca_error_t ret;
struct doca_gpu_eth_rxq *rxq = NULL;
struct doca_gpu_semaphore_gpu *sem = NULL;
struct doca_gpu_buf *buf_ptr;
struct stats_udp stats_thread;
struct stats_udp *stats_global;
struct eth_ip_udp_hdr *hdr;
uintptr_t buf_addr;
uint64_t buf_idx = 0;
uint32_t lane_id = threadIdx.x % WARP_SIZE;
uint8_t *payload;
uint32_t sem_idx = 0;

if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

if (threadIdx.x == 0) {
DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}
__syncthreads();

while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
stats_thread.dns = 0;

/* No need to impose packet limit here as we want the max number of packets every time */
ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
/* If any thread returns receive error, the whole execution stops */
if (ret != DOCA_SUCCESS) { ... }

if (rx_pkt_num == 0) continue;

buf_idx = threadIdx.x;
while (buf_idx < rx_pkt_num) {
doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
raw_to_udp(buf_addr, &hdr, &payload);

if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

/* Double-proof it's not reading old packets */
wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
buf_idx += blockDim.x;
}
__syncthreads();

for (int offset = 16; offset > 0; offset /= 2) {
stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
__syncwarp();
}

if (lane_id == 0) {
atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
}

__syncthreads();

if (threadIdx.x == 0 && rx_pkt_num > 0) {
ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
if (ret != DOCA_SUCCESS) { ... }

DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
__threadfence_system();

sem_idx = (sem_idx + 1) % sem_num;

DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}

__syncthreads();
}
}
上記の例では、実際にはRDMAは関与していません。GPUNetIOは、GPUがパケットデータを直接処理できるようにするだけです。RDMAに似ている唯一の点は、パケットがCPUメモリを経由せずに、直接DMA転送によってNICからGPUに転送されることです。
最後に、一つ不明な点があります。それはDOCA RDMAです。前のセクションではDOCA GPUNetIOについて見てきましたが、DOCA RDMAとは一体何なのでしょうか?また、以前確認した「ibv」APIとはどのように異なるのでしょうか?
答えは簡単です。DOCA RDMAは、CPUまたはGPUを使用してRDMA操作を実行するためのNVIDIAのソフトウェアフレームワークです。IBVは、InfiniBandおよびRoCEハードウェアのプログラミング用標準APIの一部である、従来の低レベルInfiniBand Verbsライブラリです。重要な違いは、DOCA RDMAがVerbsインターフェースの基本機能を基盤とした、より高レベルで包括的なSDKであり、GPUアクセラレーションを可能にし、RDMAタスクをCPUからGPUにオフロードできる点です。
例えば、RDMAパケットを送信するためのコードは次のとおりです。コード
doca_error_t rdma_send(struct rdma_config *cfg)
{
struct rdma_resources resources = {0};
union doca_data ctx_user_data = {0};
const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
doca_error_t result, tmp_result;

/* Allocating resources */
result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
doca_rdma_cap_task_send_is_supported,  &resources);

result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
rdma_send_error_callback, NUM_RDMA_TASKS);

result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

/* Include the program's resources in user data of context to be used in callbacks */
ctx_user_data.ptr = &(resources);
result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

/* Create DOCA buffer inventory */
result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

/* Start DOCA buffer inventory */
result = doca_buf_inventory_start(resources.buf_inventory);

/* Start RDMA context */
result = doca_ctx_start(resources.rdma_ctx);

/*
* Run the progress engine which will run the state machine defined in
* rdma_send_state_change_callback(). When the context moves to idle, the context change
* callback call will signal to stop running the progress engine. */
while (resources.run_pe_progress) {
if (doca_pe_progress(resources.pe) == 0)
nanosleep(&ts, &ts);
}

// ... cleanup
}
既成概念にとらわれない: RDMA でなければどうなるか?
見出しへのリンク
前節では、RDMAの様々な側面について検討しました。RDMAの究極の目的は、CPU、GPU、および量子制御スタック間でデータを数マイクロ秒の遅延で双方向に転送することです。転送される情報は多岐にわたり、I/Qソフト読み出しデータ、制御パルスサンプル(「波形」)、あるいはニューラルネットワークのコンテキストにおけるパルスのパラメトリック構成などが含まれます。また、論理量子ビットのシンドロームなどのより単純な情報を転送したり、計算ユニット内のQECデコーダをリモートで呼び出したりする必要もあります。後者の場合、猫を猫と呼んでも構いません。この動作を「リモートプロシージャコール」、略してRPCと呼ぶだけで十分です。
 幸いなことに、RDMA 上の RPC に関する文献は多数存在し、例えば 100 Gbps Mellanox Connect-X5 RoCE NIC をベースとした非常に興味深いレイテンシの数値を提示する mRPC などがあります。この論文には混乱があり、「RDMA 上では、mRPC は中央値レイテンシとテールレイテンシに関して eRPC をそれぞれ 1.3 倍と 1.4 倍高速化します」と述べている一方で、表では eRPC が mRPC より高速であると示されています。しかし、今のところ、レイテンシの数値は経験的にあり得ると想定できます。
 さらに興味深いのは、mRPC のフォローアップである 論文 です。この論文では、Compute Express Link (CXL) を使用して、さらに高速な RPC である「HydraRPC」を作成しています。右の表を見れば、その性能は一目瞭然です。ここで問われるべきは、これが 5 年後にはどうなっているかということです。私の意見では、NVLink も非常に魅力的な機会のように思えます…
# 結論
ほら、このメモを完成させるのに時間がかかりましたが、おかげで少し理解が深まったと思います。RDMAとGPUDirectの混同は、RDMAが当初Mellanoxによって純粋なネットワーク改善として開発されたことに起因していると考えられます。MellanoxがNvidiaに買収された後、GPUとの「連携」機能が拡張されましたが、この拡張は当初の構想ではなく、DOCAエコシステムへのアドオンとして実装されたのです。

References:
DrawIO diagrams used in this memo: