このメモでは、GPUの基本に立ち返ります。特に、深層学習の中核となる演算である行列乗算に焦点を当てます。まず、基本的な実装と学術的な実装について説明します。次に、GPUを効率的に使用するために必要な最適化について見ていきます。
まずは、教科書によく載っている基本的な例から始めましょう。
/**
* Kernel to perform matrix multiplication C = A × B
* A is of size N x M, B is M x N, and C is N x N
* Each thread computes one element of matrix C.
*/

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

// Calculate global row and column for this thread
int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

if (row < N && col < N) {
float sum = 0.0f;
for (int k = 0; k < M; k++) {
// C[row][col] = sum(A[row][i] * B[i][col])
sum += A[row * N + k] * B[k * N + col];
}
C[row * N + col] = sum;
}

}
一見すると、これは簡単そうに見えます。出力行列Cの各セルを計算するだけです。このカーネルコードは、目的を達成しているように見えます。以下に、カーネルをより視覚的に表現したものを示します。
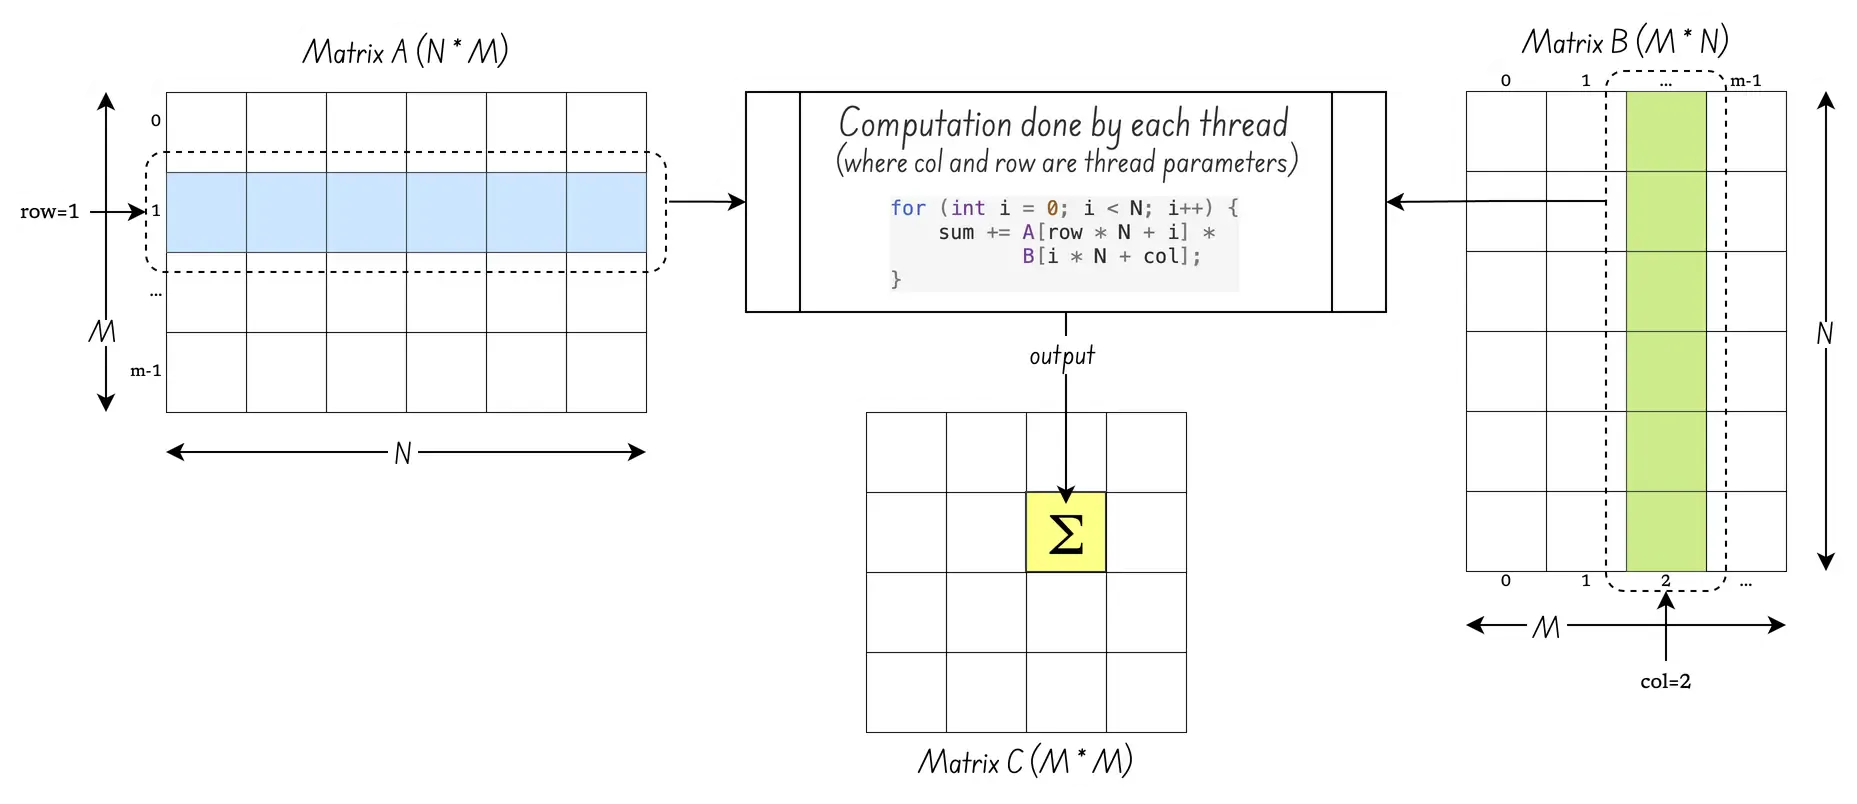
現実はもう少し複雑です。blockIdx、blockDim、threadIdxの意味をどう理解すればよいのでしょうか?それを理解するには、GPUがスレッド、ワープ、ストリーミングマルチプロセッサを中心にどのように構成されているかに戻ってみましょう。以下は、NvidiaのH100「Hopper」GPUマイクロアーキテクチャの、私なりの解釈を示した図です。
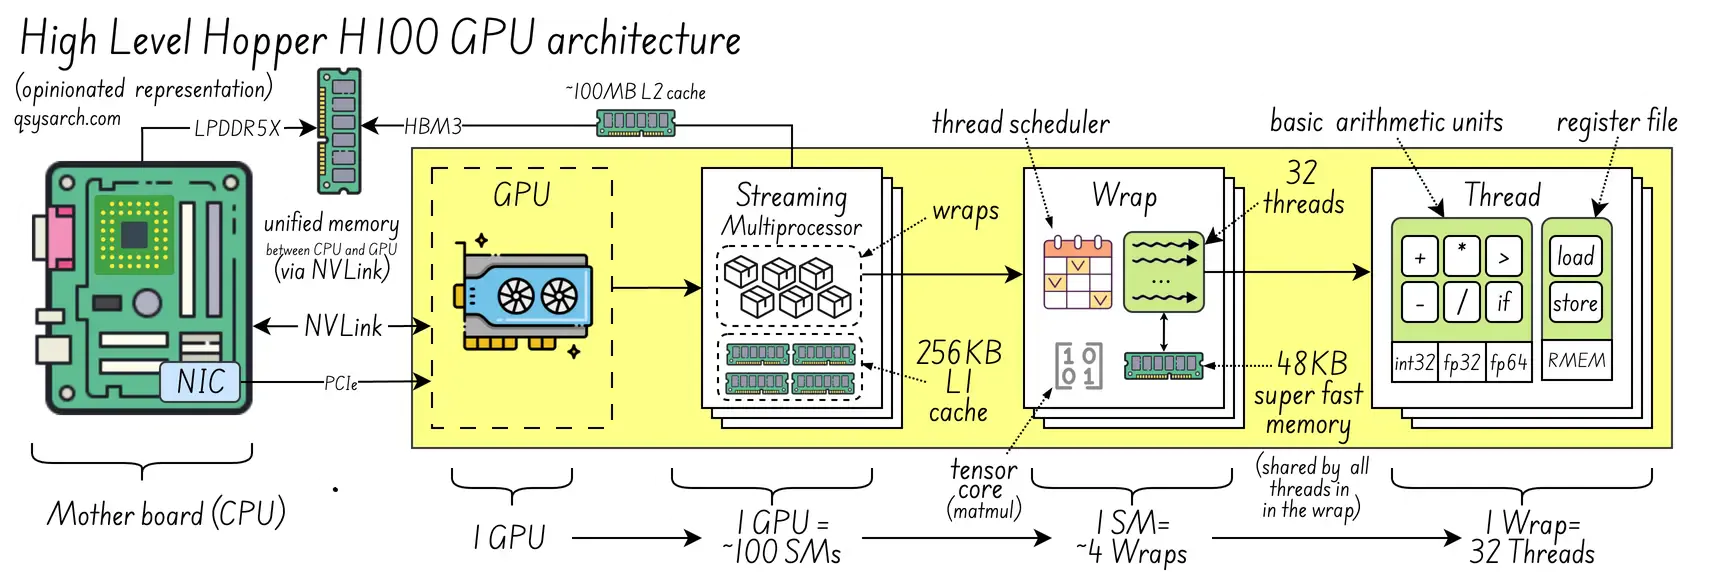
大まかに言うと:
1 GPU = 10~100ストリーミングマルチプロセッサ
1つのストリーミングマルチプロセッサ = 4~64ラップ
1ラップ=32~64本の糸
しかし、では、sumを計算するコード断片は、スレッド、ワープ、あるいはストリーミングマルチプロセッサとどのように関連付けられるのでしょうか?割り当てとマッピングの決定はどこで行われるのでしょうか?まず、カーネルがどのように構成されているかを理解する必要があります。
int launch_kernel(float *d_A, *d_B, *d_C) {

dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

// 2. Launch the kernel with the specified dimensions
naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
この階層構造は、以下のようにGPUハードウェアにマッピングされます。

この設定では、サイズ N の行列を 16*4 = 64 乗算することが可能です。では、N が 1000 の場合はどうでしょうか?その場合は、グリッドサイズを (1000+15)/16 に設定するだけで済みます。
実際のハードウェアへのマッピングはどうなっているのでしょうか?つまり、ブロックはワープに割り当てられるということでしょうか?ブロック内のスレッド数がハードウェアのスレッド数よりも多い場合はどうなるのでしょうか?
ここでGPUスケジューリングについて説明する必要があります。簡単に言うと、必要なスレッド数が物理ハードウェア上のスレッド数よりも多い場合、GPUは複数のワープを割り当てます。
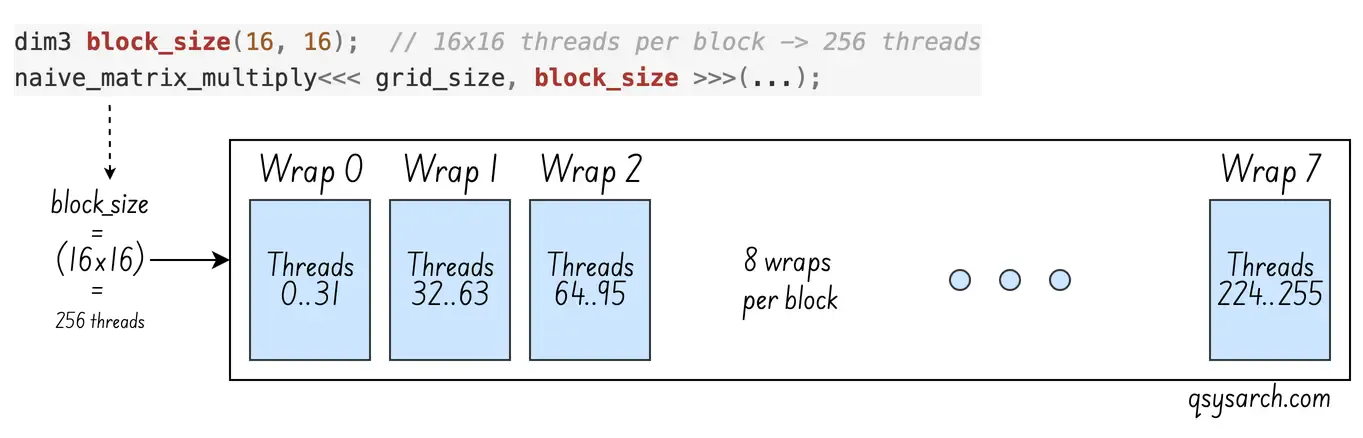
次の疑問は、ブロックごとに必要な8つのワープがストリーミングマルチプロセッサとどのように関連付けられるか、特にストリーミングマルチプロセッサのワープ数がブロックに必要な数よりも少ない場合、どのように関連付けられるかということです。答えは素晴らしいものです。ストリーミングマルチプロセッサは4つ以上のワープを持つことができ、それらを交互にスケジューリングします。メモリへのアクセスによってワープが停止すると、ストリーミングマルチプロセッサはすぐに別のワープに切り替わります。これはレイテンシー隠蔽と呼ばれ、GPUの基本的なパフォーマンス戦略です。これがなければ、効率はこれほど高くはならないでしょう。
次にgrid_sizeについて考えてみましょう。grid_sizeはハードウェアリソースに直接対応しているのでしょうか?いいえ、そうではありません。グリッドは単なる論理的な概念です。グリッドは、マトリックスをカバーするのに十分なブロックが利用可能であることを保証するものです。grid_sizeはハードウェアとは直接関係ありません。ブロックは実行時にキューから各SMに割り当てられます。
割り当てはブロックが必要とするリソースに基づいて行われます(各ラップには限られた数のレジスタがあり、各ブロックが静的に割り当てられた独自のレジスタセットを持っていることを確認する必要があります)。
ブロックの計算が完了すると、SMはスケジューラキューから新しいブロックを取り出し、完了したブロックと置き換えます。割り当てられたブロックは、そのSMに固定され、実行のためにレジスタが割り当てられます。
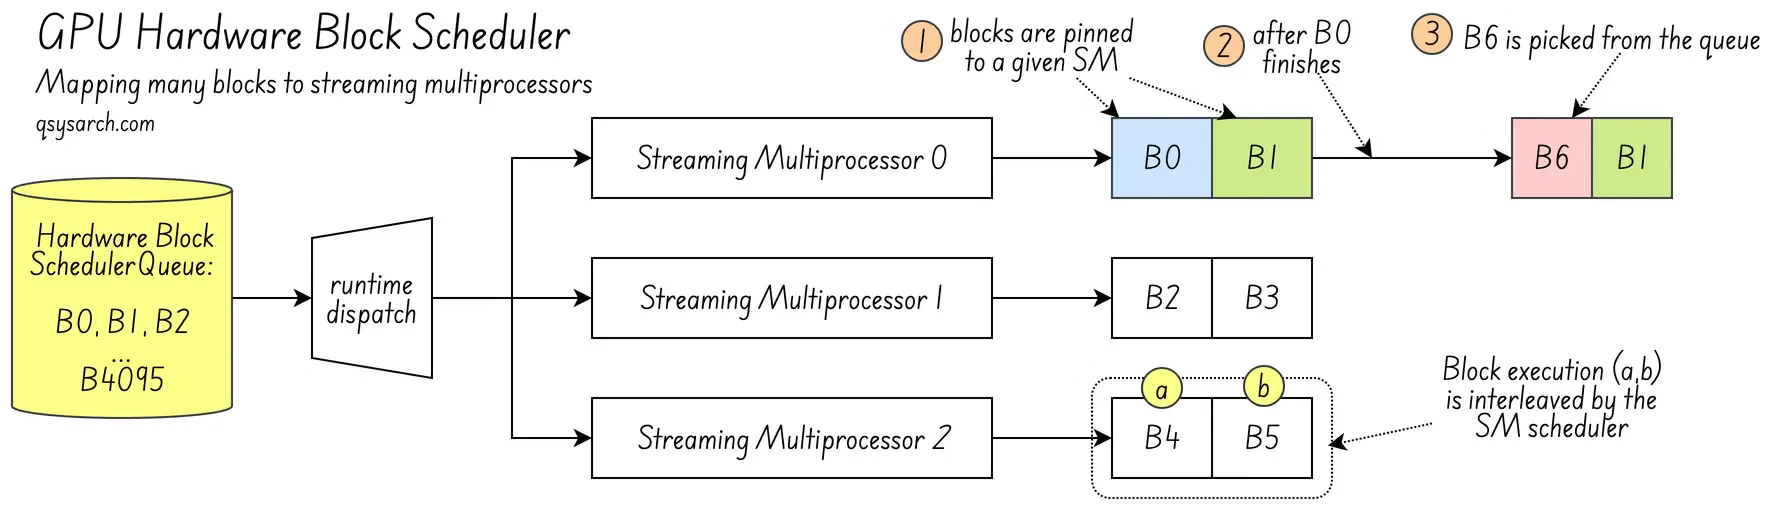
最後に質問です。ブロックはSMに固定されているのでしょうか、それともワープに固定されているのでしょうか?ワープに割り当てられたブロック内のスレッドが使用するメモリは、そのワープに割り当てられたメモリでしょうか?そうでない場合、SMはワープ間でメモリを移動する必要があります。はい、SM内では、ブロックのワープは固定されています。ブロック0がワープ0に割り当てられ、ブロック1がワープ1に割り当てられている場合、常にそのようになります。
並行スレッド実行について理解できたところで、単純な行列乗算カーネルを考えてみましょう。すべてのスレッドは、行列AとBへのメモリアクセスをめぐって競合します。各スレッドは、グローバルメモリからAの行全体とBの列をストリームします。再利用はありません。Bは列ごとにアクセスされるため(B[i * N + col])、バーストアクセスやメモリキャッシュを効果的に使用することはできません。
最も簡単な解決策は、共有メモリを使用することです。まず、行列の一部をサイズ T*T のタイルとしてワープメモリにロードします。次に、スレッドはこのローカルメモリからのみ読み取るようにします。こうすることで、スレッドはメモリへのアクセスを競合しません。ワープインターリーブを使用することで、SM は、一方のワープがキャッシュにメモリをロードしている間に、もう一方のワープが合計を計算することを保証します。以下に、拡張カーネルを示します。
__global__ void matmul_tiled(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x,  ty = threadIdx.y;
int row = blockIdx.y * T + ty;   // global row in C
int col = blockIdx.x * T + tx;   // global col in C

float accumulator = 0.0f;
for (int t = 0; t < M; t += T) {

// Read [T,T] subtile from matrix A and B.
// Assume that M and N are multiples of T (no bound check)
A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();   // wait all threads to finish loading

for (int k = 0; k < TILE; ++k)
accumulator += A_shared[ty][k] * B_shared[k][tx];

__syncthreads();   // all threads are ready to load again
}
C[row * N + col] = accumulator;
}
簡略化のため、MとNはTの倍数であると仮定します。そのため、グローバル行列をA_sharedとB_sharedにロードする際に境界チェックは行いません。
このコードにはちょっとした仕掛けがあります。ブロック内のすべてのスレッドは、同じメモリ読み取り A[row * M + t + tx] を実行します。t は連続しているため、スレッドは同じメモリ領域から読み取ります。これにより、メモリのバーストとキャッシュが可能になります。最初のスレッドがバースト読み取りを開始します。他のスレッドは、そのバーストによって生成されたキャッシュを使用します。B は転置されていないため、この仕掛けは B には適用されません。また、__syncthreads() はブロック内のスレッドを同期し、同じ SM 上で実行されるようにします。
従来の単純な乗数では、ブロックサイズは任意でした。タイル方式では、図に示すように、ブロックサイズはタイルサイズT*Tに適合する必要があります。
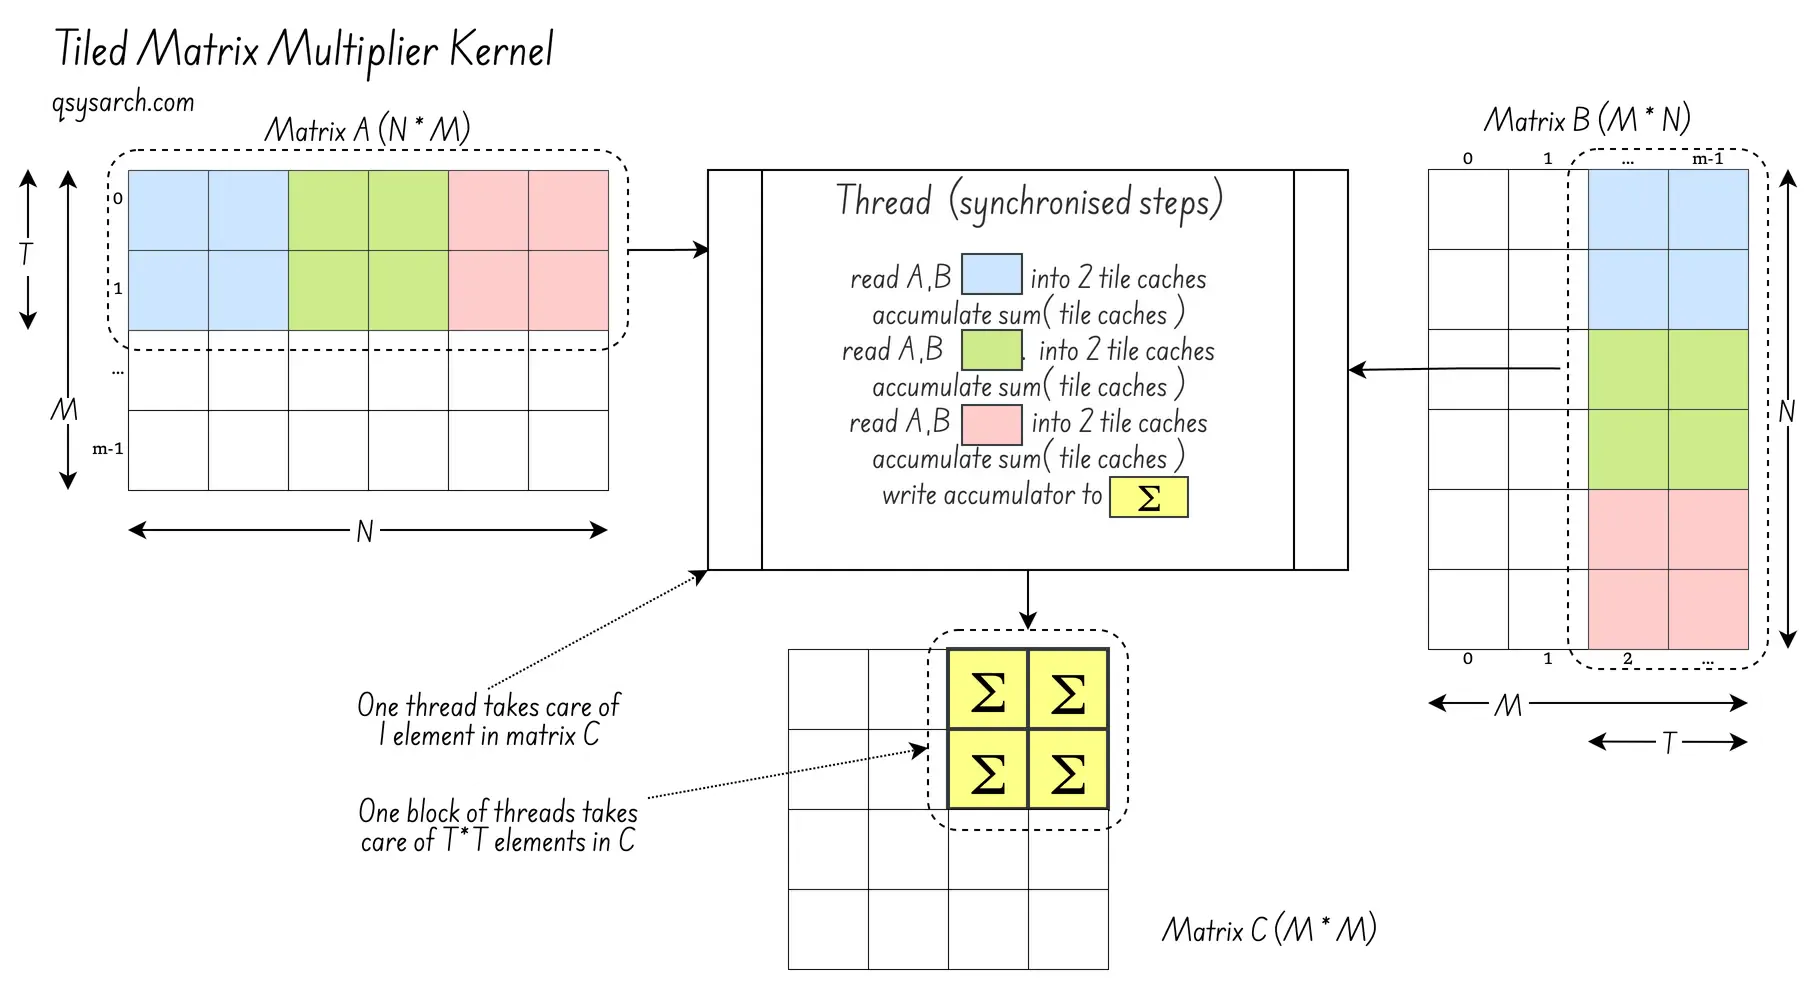
タイル方式では、ブロックがロードされている間に他のブロックが計算を行うことができます。この場合、計算は軽量で、メモリのロードよりも時間がかからない可能性があります。これを解決するには、計算中のスレッドごとの作業量を増やします。各スレッドは、1つの要素セットだけでなく、2x2の要素セットを計算できます。K=2、かつTがKの倍数であれば、これが可能です。
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x, ty = threadIdx.y;
int rowBase = blockIdx.y * T * K + ty;
int colBase = blockIdx.x * T * K + tx;

float accumulators[K][K]; // That's register memory

for (int t = 0; t < M; t += TILE) {

A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();

for (int k = 0; k < TILE; ++k)
for (int wr = 0; wr < K; ++wr)
for (int wc = 0; wc < K; ++wc)
acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

__syncthreads();
}

// Write out the T×T accumulated result
for (int wr = 0; wr < T; ++wr)
for (int wc = 0; wc < T; ++wc) {
int r = rowBase + wr * (T/K);
int c = colBase + wc * (T/K);
C[r * N + c] = acc[wr][wc];
}
}
# 結論
ほら、これがGEMM(一般行列乗算)ユニットの基本的な仕組みです!
次に、Tensor Core(NVIDIA)やMatrix Fused Multiply-Add(AMD)といった特殊なハードウェアについて説明しましょう。これらはストリーミングマルチプロセッサ内の専用ユニットで、TTK回の累積乗算を計算します。これについては後日改めてメモしておきます。
References:
DrawIO diagrams used in this memo: