NVIDIA GPU 向けにコンパイルする場合、CUDA はしばしばリファレンスコンパイルフレームワークとみなされます。しかし、コンパイラは実際にはどのように動作しているのでしょうか?GPU 用の「実行可能ファイル」を作成する際に、コンパイラはどのような命令セットアーキテクチャ (ISA) を生成する必要があるのでしょうか?また、コンパイラは実際にはどのように動作しているのでしょうか?CPU から起動して GPU 上で実行できるコードを生成するために、どのようなアーキテクチャが使用されているのでしょうか?
この日曜朝のメモは、NVIDIA GPUコンパイラアーキテクチャの概要を説明することを目的としています。GPU命令セット、CUDAフレームワークにおけるNVCCコンパイラ、そして最後に、GPU命令セットをターゲットとする代替アーキテクチャについて解説します。
GPUのようなデバイスをターゲットにする場合、それをプログラムするための命令セットが必要です。NVIDIAの場合、このデバイスはストリーミングマルチプロセッサ(SM)であり、右の図に示されています。この図で興味深いのは、IN32加算器、特殊機能ユニット、GEMM+++テンソルコアなど、多くの並列ユニットが存在し、コンパイラはそれらが最も効率的な方法(アイドル時間を最小限に抑えること)で使用される(パイプライン処理される)ようにする必要があることです。
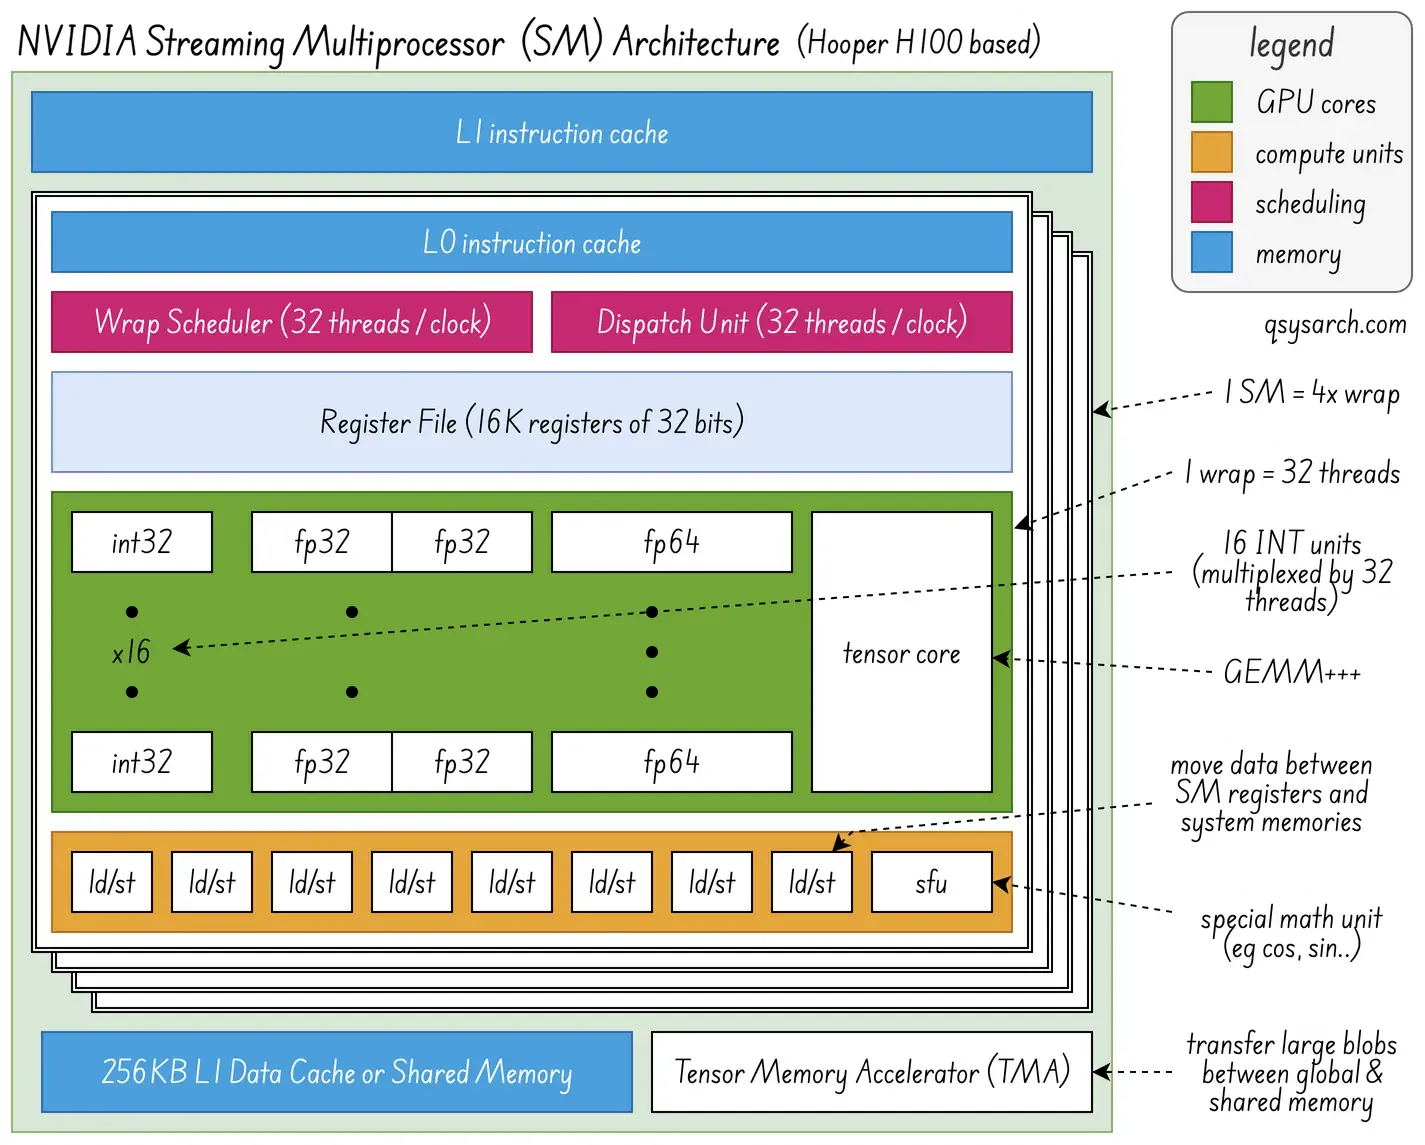
使用されている用語は以下のとおりです。
NVIDIA GPUには2種類のISA(命令セットアーキテクチャ)があります。
このカーネルをコンパイルしたいとしましょう。
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
int i = blockIdx.x * blockDim.x + threadIdx.x;

float vx = x[i], vy = y[i];
float len2 = vx*vx + vy*vy;
float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
z[i] = invLen; // Normalized length
}
ここでの魔法は、rsqrtf を SFU パイプラインにディスパッチすることです。これはどのように機能するのでしょうか? 行 float invLen = rsqrtf(len2); は、rsqrt.approx.ftz.f32 として PTX に変換され、次に MUFU.RSQ として SASS に変換されます。これは、[godbolt](https://godbolt.org/#g:!((g:!((g:!((h:codeEditor,i:(filename:'1',fontScale:14,fontUsePx:'0',j:1,lang:cuda,selection:(endColumn:2,endLineNumber:15,positionColumn:2,positionLineNumber:15,selectionStartColumn:2,selectionStartL ineNumber:15,startColumn:2,startLineNumber:15),source:’global+void+normalizeVector(float*+x,+float*+y,+float*+z,+int+n)%0A%7B%0A++++int+i+%3D+blockIdx.x++blockDim.x+%2B+threadIdx.x%3B%0A%0A++++float+vx+%3D+x%5Bi%5D%3B%0A++++float +vy+%3D+y%5Bi%5D%3B%0A++++float+len2+%3D+vxvx+%2B+vyvy%3B%0A%0A++++//+Use+SFU+fast+reciprocal+square+root%0A++++flo at+invLen+%3D+rsqrtf(len2)%3B+%0A%0A++++//+正規化+the+vector%0A++++x%5Bi%5D+%3D+vx++invLen%3B%0A++++y%5Bi%5D+%3D+ vy+*+invLen%3B%0A%7D’),l:‘5’,n:‘0’,o:‘CUDA+C%2B%2B+source+%231’,t:‘0’)),k:33.333333333333336,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:compiler,i:(compiler:nvcc130u2,filters:(b:‘0’,binary:‘1’,binaryObject:‘1’,commentOnly:‘0’,debugCalls:‘1’, demangle:‘0’,directives:‘0’,execute:‘1’,intel:‘0’,libraryCode:‘0’,trim:‘1’,verboseDemangling:‘0’),flagsViewOpen:‘1’,fontScale:14,fontUsePx:‘0’,j:1,lang:cuda,libs:!(),options:’-arch+sm_90+-use_fast_math+-O3’,overrides:!(),selection:(en dColumn:1,endLineNumber:1,positionColumn:1,positionLineNumber:1,selectionStartColumn:1,selectionStartLineNumber:1,startColumn:1,startLineNumber:1),source:1),l:‘5’,n:‘0’,o:’+NVCC+13.0.2+(Editor+%231)’,t:‘0’)),k:33.333333333333336,l:‘4’ ,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:device,i:(compilerName:‘NVCC+13.0.2’,device:‘SASS+(sm_90)’,editorid:1,fontScale:14,fontUsePx:‘0’,j:1,selection:(endColumn:6,endLineNumber:21,positionColumn:1,positionLineNumber:1,selectionStartColumn:6,s electionStartLineNumber:21,startColumn:1,startLineNumber:1),treeid:0),l:‘5’,n:‘0’,o:‘Device+Viewer+NVCC+13.0.2+(Editor+%231,+Compiler+%231)’,t:‘0’)),k:33.33333333333333,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’)),l:‘2’,n:‘0’,o:’’,t:‘0’)),version:4).
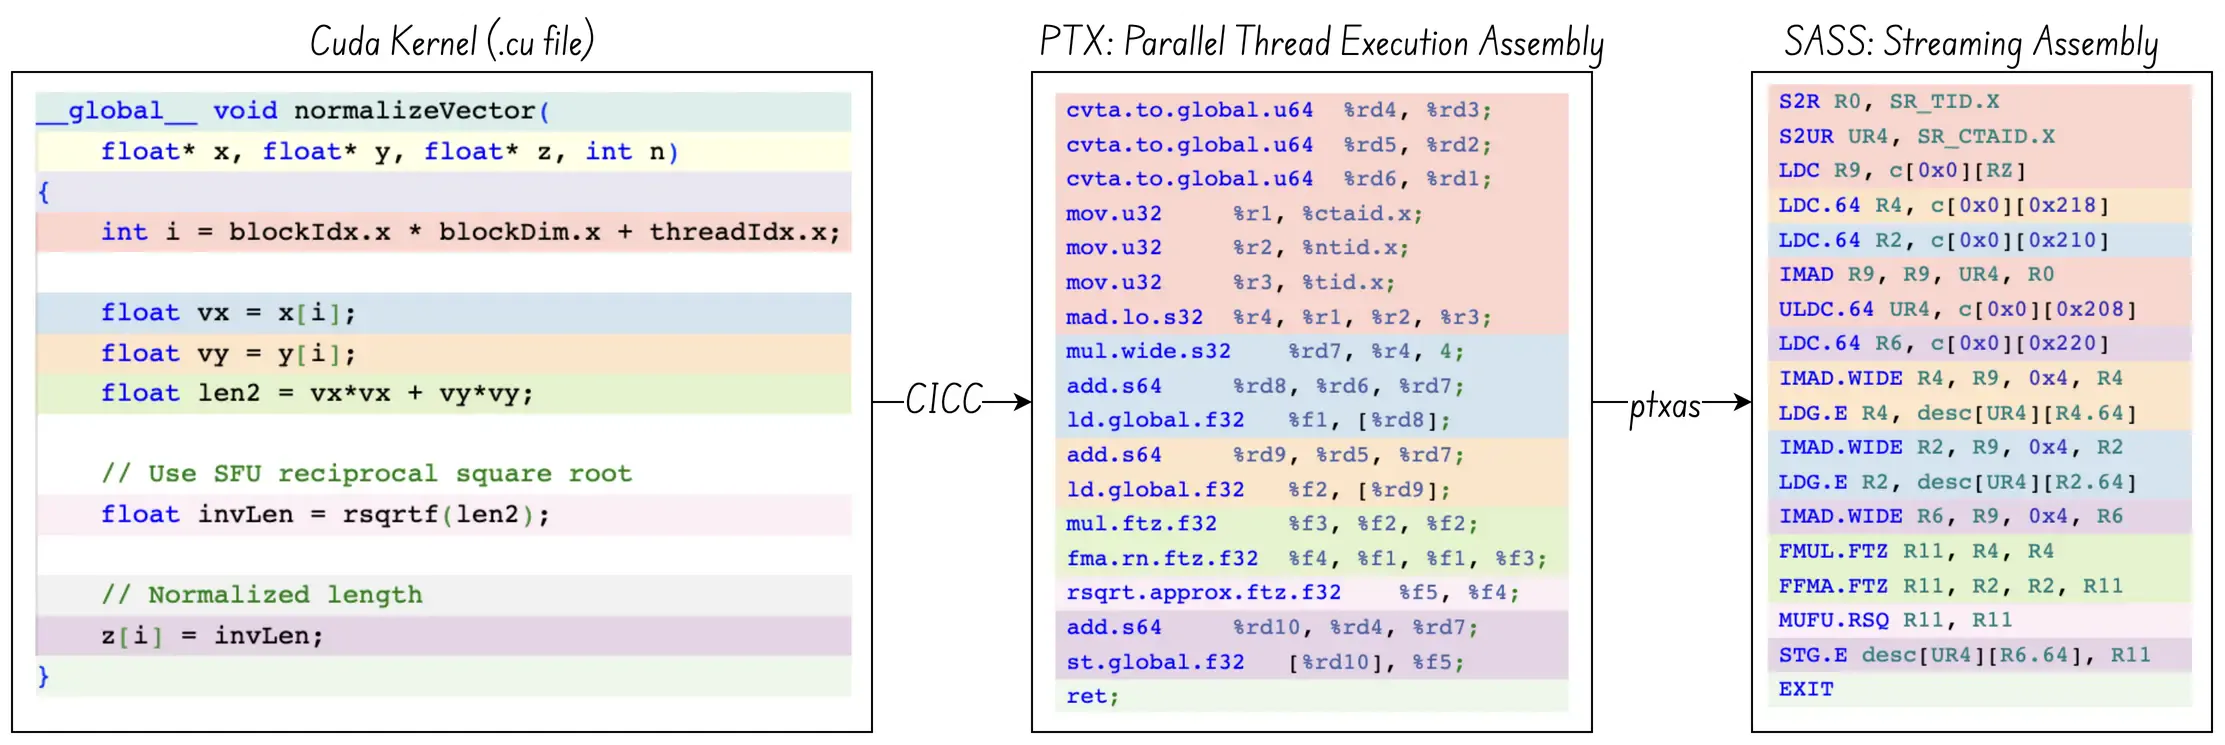
MUFU は多機能ユニットの略で、SFU とも呼ばれ、特殊機能ユニットです。MUFU.RSQ はレジスタを SFU ユニットのルート スクエア「パイプライン」に送ります。SASS アセンブリには、FMUL (積和演算) や FFMA (積和演算と累積演算) など、他にも多くの命令がありますが、これらはテンソル コア ユニットにディスパッチされます。ディスパッチ ユニットは、命令を適切なパイプライン ユニットに送信する役割を担います。
注目すべき点が3つあります。
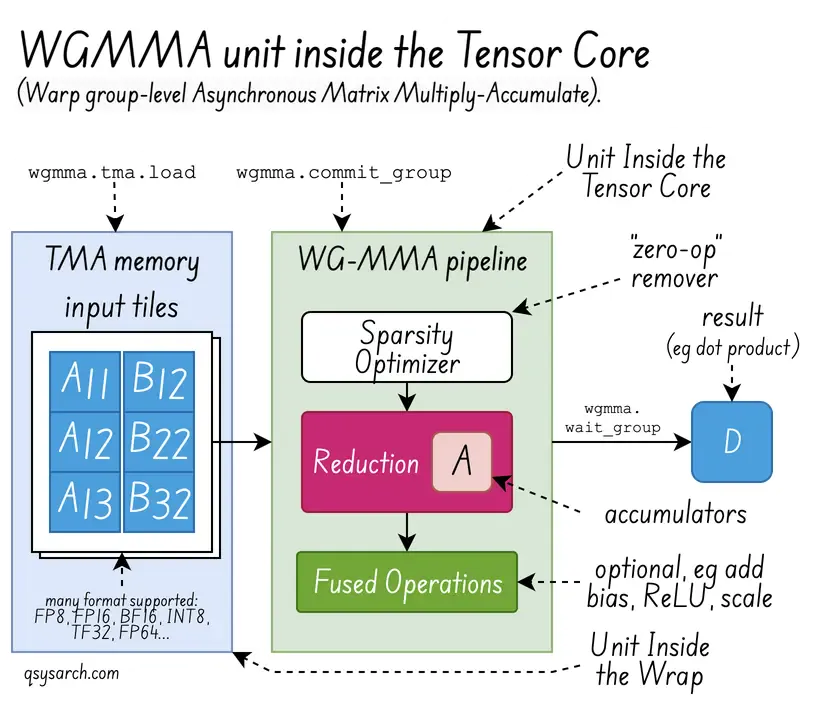
テンソルは、一般的な行列乗算器 (GEMM) よりもはるかにコアです。たとえば、テンソル コア内の MMA (行列乗算累積) ユニットを介して、削減操作 (合計、最小値/最大値、ドット積) を実行できます。
INT32 ユニットとレジスタの違い: ユニットは計算 (例えば、ADD、SHIFT、XOR など、より一般的には算術演算、または ALU) を担当し、レジスタは値を格納する役割を担います。
INT32 ユニットは 16 個しかありませんが、スレッドは 32 個あります。これは間違いではありません。理由は、ワープ スケジューラがサイクルごとに 2 つのスレッドセットを切り替えるためです。したがって、サイクル 0 では、ユニットはスレッド 0 ~ 15 に対して ALU 演算を実行し、サイクル 1 では、スレッド 16 ~ 31 に対して ALU 演算を実行します。
非同期ワープグループレベルマトリックス乗算累積命令 (WGMMA) は非常に強力です。詳細については、NVIDIA のドキュメント および Aleksa Gordić 氏の素晴らしい ブログ を参照してください。
NVIDIA CUDAコンパイラアーキテクチャ
見出しへのリンク
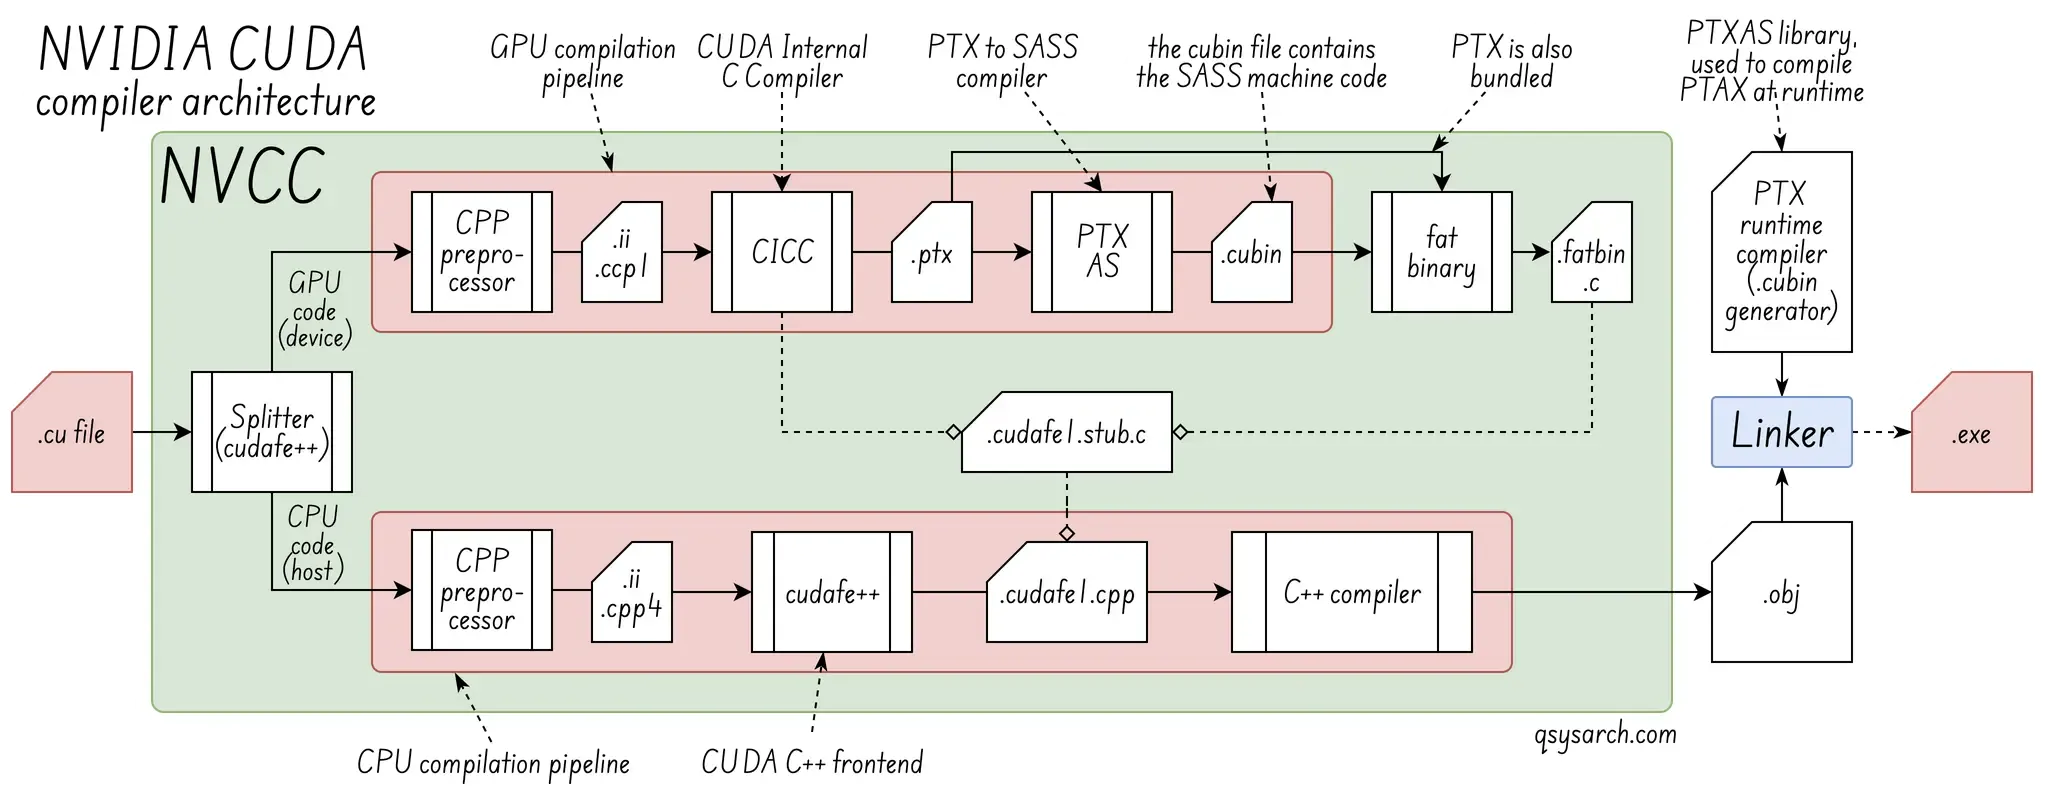
GPUストリーミングマルチプロセッサをプログラミングするためのGPUの低レベルISAについて少し理解が深まったところで、高レベルのC++カーネルがどのようにSASSにコンパイルされるかを理解してみましょう。CUDAカーネル(.cuファイル)をPTXに変換するために使用されるコンパイラはNVCCと呼ばれていることは既に知られています。
では、NVCCとLLVMの違いは何でしょうか?NVCCは、オープンソースのLLVMコンパイラインフラストラクチャをバックエンドとして使用する、特殊なコンパイラドライバです。一方、LLVMはNVCCのようなすぐに使えるコンパイラではなく、柔軟性の高いコンパイラフレームワークです。
ドライバプログラム:NVCCは、CUDA C/C++コードのコンパイルプロセスを管理するドライバです。ホスト(CPU)コードとデバイス(GPU)コードを分離します。
ツールチェーン: NVCCはツールチェーンであり、CPUコードにはホストC++コンパイラ(Linux上のGCC/Clangなど)を、GPUコード(PTXおよびSASS)にはNVIDIA固有の内部コンパイラ(CICCなど)を使用します。
ファットバイナリ: NVCCは通常、ホスト実行ファイルとコンパイル済みGPUコードの両方を含む「ファットバイナリ」を生成し、多くの場合、異なるGPUアーキテクチャ用に複数のバージョンが存在します。
フレームワーク: LLVMは、さまざまなコンパイラや言語ツールチェーンを構築するために設計された、無料、オープン、モジュール式、再利用可能なコンパイラ技術、ライブラリ、ツールの集合体です。
中間表現 (IR): LLVM IR は、フロントエンド (C++、Go など) と ISA バックエンド (x86、ARM など) の間の普遍的なリンクとして機能する、マシンに依存しない「中間層」です。
最適化: LLVM オプティマイザは、ソース言語やターゲットアーキテクチャに関係なく、IR に対してさまざまなパフォーマンス向上策 (ループ展開やデッドコード削除など) を適用します。
LLVM は CUDA をコンパイルできることに注目する価値があります。Clang フロントエンド (LLVM プロジェクトの一部) は、nvcc ドライバを必要とせずに、LLVM PTX バックエンド を使用して CUDA コードを処理できます。
Tritonコンパイラのアーキテクチャ
見出しへのリンク
Triton 言語は、GPU ターゲット向けに効率的な並列化コードにコンパイルできる高レベルのベクトル化アルゴリズムを作成するのに役立つように設計された、強力な Python ベースのドメイン固有言語 (DSL) です。
これは、メモリブロックからデータをロードして別のブロックに書き込む、最も単純なカーネルの例です。offsets の値は [pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1] です。このコードスニペットには示されていませんが、Triton はベクトル v に対して、math ops などを実行することで効率的に操作できます。
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
pid = tl.program_id(axis=0)
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
v = tl.load(x_ptr + offsets)
tl.store(output_ptr + offsets, v)
Tritonは1次元ベクトルに限定されず、テンソルを使用してより多くの次元を扱うことができます。例えば:
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
M , N , # Number of rows and columns
BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
# X and Y tile position
pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
# Ptr in memory based on the stride
base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
# Offsets for X and Y indices
offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
# 2D loading ...that's magic!
loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
return loaded_2d_tensor
CUDAと比較すると、Tritonはより高レベルの抽象化であり、ニューラルネットワークカーネルの構築(テンソルブロックアプローチのおかげで)に特化しており、効率的なベクトル化および並列GPUコードを生成できます。Tritonは複数のバックエンドGPUもサポートしています。
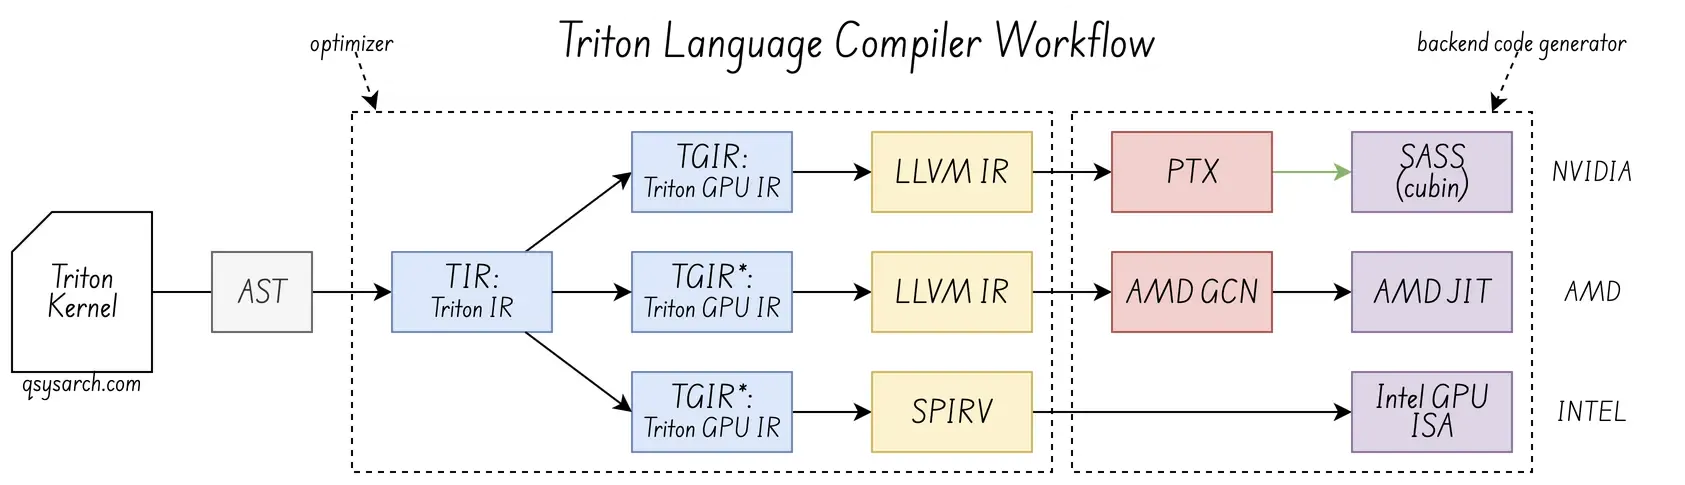
Triton は独自の言語パーサーを使用しません。代わりに、Python のランタイムと AST に依存し、その AST を独自の中間表現である TIR と TGIR に変換してから GPU コードを生成します。CUDA バックエンド コンパイラと Triton フロントエンド コンパイラ間のリンクは、汎用的な LLVMIR であり、Intel GPU の場合は SPIRV に基づいています (ただし、TGIR が中間の LLVMIR を経由するのではなく、直接 SPIRV に変換されるかどうかは不明です)。
私は「ベクトル化アルゴリズム」と書きましたが、コアコンセプトはタイル化されたブロックレベルのモデルに重点を置いています。
 タイリングが主要なメカニズムです。 Triton のメンタルモデルは、小さな静的に形状が決められた多次元サブ配列、つまり「タイル」に対するプログラミング操作を中心に展開され、コンパイラはこれを GPU コア間で自動的に並列化します。
ベクトル化とは、複数のデータ要素を単一の命令でロード/ストアする処理であり、最適化の一種です。コンパイラはこれを重要な内部最適化戦略として利用し、基盤となるハードウェア上でこれらのタイルを効率的に実装します。この概念は、ネストされたタイル化戦略(右図参照)と一致しており、タイルをマイクロタイル、そして最終的にはナノタイルへと分解することで、マシンの計算能力とメモリ階層にできるだけ適合させることを目指しています。
Triton言語の段階をストリーミングアセンブリまで下げる
見出しへのリンク
高レベルのTriton言語命令tt.loadがどのようにSASSに変換されるかを見ていきましょう。(読者の皆様へ:以下のコードは擬似コードであり、そのままでは動作しません。)
Python ASTを解析した後の最初の段階は、マシンに依存しないTriton IR(TIR、MLIRの方言)です。このレベルでは、タイルに対してtt.load操作が定義され、tt.load操作はタイル全体のメモリロードを表す高レベルで最適化されていない命令です。タイルは単一の配列でも、2次元配列でも、任意の次元の配列でも構いません。
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
テンソルポインタとデータブロック(タイル)に対する高レベルのtt.load操作。最初の入力パラメータ%ptrsは、tensorで表される_tensor_(_n_次元配列)です。 <MxN, ptr `。同じ次元のテンソルを返しますが、値へのポインタではなく値自体を返します。
実際には、tt.load はマスクとデフォルト値のパラメータも受け取ります。これは、メモリの境界から読み込むために必要です (ベクトルの次元がストライドに揃っていない場合)。
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
Triton-GPU IR (TTGIR / TGIT)
見出しへのリンク
次の段階では、Triton-GPU IRを使用して、汎用テンソルレイアウトをハードウェア固有のレイアウトに変換します。特に、メモリレイアウトとスレッドおよびワープ間の分散に関してです。言い換えれば、TGITはn次元のロードを、LLVMに容易に変換できるスレッドごとのベクトルロード演算に展開します。
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
Triton-GPU IRは、LLVM IRで表現されるスレッドごとの命令に変換されます。この低レベルIRは、最終的なマシン命令を忠実に再現し、ポインタ演算、メモリロード、同期プリミティブといった標準的なLLVM操作を使用します。テンソル抽象化はほぼなくなり、各スレッドごとに個別のメモリアクセス操作に置き換えられます。
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
表現: タイルのロードは、各スレッドの特定のデータ要素に対するポインタ演算を含む一連の個別のロード命令に分割され、共有メモリがステージング領域として使用された場合は、共有メモリ操作が含まれる可能性があります。
LLVMバックエンドがNVIDIA GPUをターゲットとする場合、次のステップはPTXへのダウングレードです。LLVMのロード命令は、対応するPTXのロード命令に直接マッピングされます。
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
最後に、NVIDIAドライバコンパイラ(ptxas)がPTXアセンブリをSASS(ストリーミングアセンブリ)に変換します。SASSはGPUコアによって実行される実際のネイティブマシンコードです。前述のとおり、このステップは通常、ジャストインタイム(JIT)方式で実行されます。
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
注目すべき点の1つは、CUDAがNVIDIA GPU用のマシンコードを生成する非常に便利な方法であるということです。TritonはPTXからSASSへのダウングレード時にCUDAを使用します。PTXへのダウングレードはLLVM IRから行われますが、CUDAツールキットに付属するライブラリ(例:libdevice.bc)が必要です。
 DeepSeek は別のアプローチを採用し、手動による PTX 最適化を選択しました。カスタム PTX カーネル ヘルパーは、PTX を GPU のアセンブリ言語として扱い、手作業で記述されています。DeepSeek は、この特定の、非常に非標準的なコードを生成するために汎用コンパイラに依存しませんでした。一方、Triton は汎用言語であるため、NVPTX ターゲットを備えた標準の LLVM コンパイラ バックエンドを使用して、中間表現 (Triton-IR/MLIR) を最適化された PTX アセンブリ コードに自動的に変換します。
 csrc/kernels/utils.cuh の DeepSeek ラッパーは、mbarrier.try_wait 命令を使用しています。
なぜこれが重要なのでしょうか? DeepSeek の技術 レポート から引用: 具体的には、DeepSeek はカスタマイズされた PTX (並列スレッド実行) 命令を採用し、通信チャンクサイズを自動調整することで、L2 キャッシュの使用と他の SM への干渉を大幅に削減しています。これは、LLVM NVPTX バックエンドが最適に効率的ではないことを意味するのでしょうか? 私にとっては、これは、LLVM レベルだけでなく、より優れたベアメタル ISA を公開することで、さらなる最適化の余地があることを意味します! これはウィンウィンです!
# 結論
ほら、このメモの作成にまたもや予想以上に時間がかかってしまいました。しかし、CUDA-Qのアーキテクチャを紹介する前に、これは非常に必要な事前調査作業です。準備が整い次第、この記事を更新します。
 (画像提供: LLVM MOS)
このメモで使用されているDrawIO図: