最近、容量効率エンジニアリングという概念に出会いました。これは、システムを最適な方法で設計・運用する分野です。システムアーキテクチャの重要な柱であり、量子コンピューティングシステムのように規模が重要な場合には特に重要です。
簡単に言うと、生産能力・効率工学とは、生産を最適化するための科学または学問分野です。これは、最大生産量(生産能力)と資源消費量(効率)のバランスを取ることによって実現されます。
キャパシティ・アンド・エフィシェンシー・エンジニアリング(CEE)の良い点は、その分野が明確に定義され、関連文献が豊富にあり、体系化されたエンジニアリング手法によって支えられていることです。本稿では、CEEで使用されるいくつかの重要な概念を抽出することを試みます。
能力と効率性に関するエンジニアリングの柱
見出しへのリンク
キャパシティ&効率エンジニアリングは、可観測性、モデリング、プランニングという3つの主要な柱に基づいて構築されています。
可観測性
モデリング
計画
最終的な目標は、モデルを用いて効果的にシミュレーションできる計画を作成することです。このモデルは、実測データに基づいて検証されるべきです。成長をモデル化し、ボトルネックを特定し、リソースを戦略的に配分することで、計画は過負荷やリソース不足を防ぎます。これにより、システムの最適な運用が保証されます。
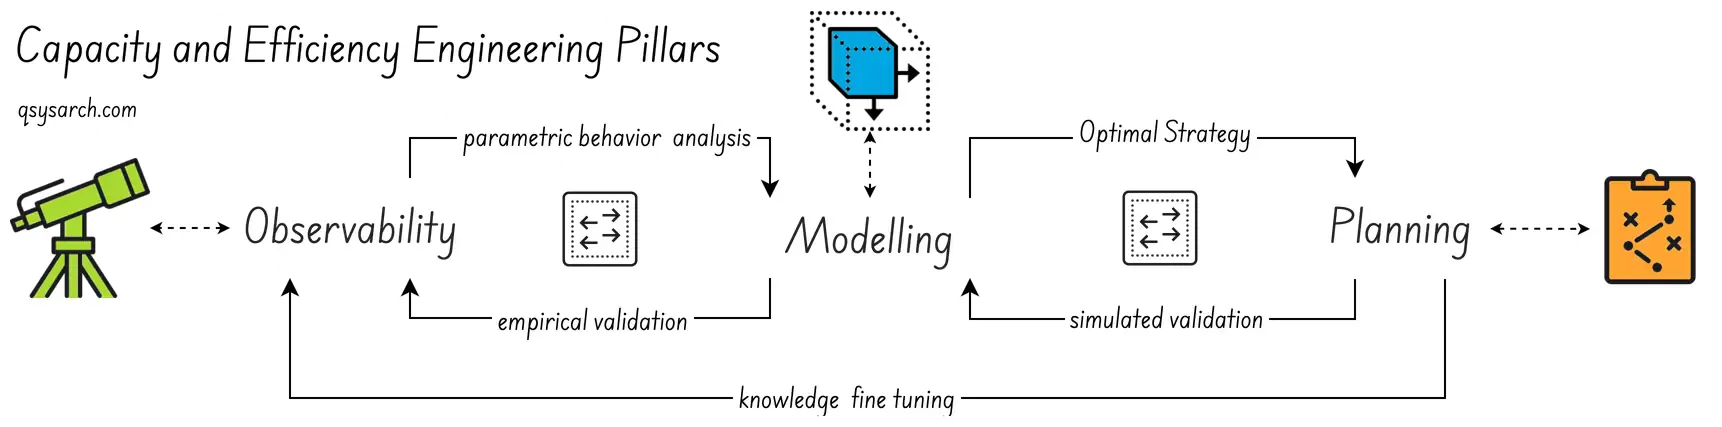
システムリソースはあらゆるものを指す可能性がある点に留意すべきである。CPUやメモリといったITリソースから、人員や機械設備まで、その範囲は多岐にわたる。実際、CEEは様々な分野で応用可能である。例えば、プロジェクト管理における人員配置の最適化や、インフラ管理におけるクラウドホスティングコストの削減などに役立つ。
可観測性とは、システムの_経験的分析_のことです。コンピューティングシステムでは、ログはしばしば可観測性と混同されますが、可観測性は全体像の一部にすぎません。例えば、OpenTelemetry標準は、ログ、メトリクス、トレース、バゲージなど、複数の可観測_シグナル_を包含しています。CEEにとって、効果的な可観測性とは、以下の点を満たすものです。
リソース使用状況:リソースの消費状況を監視および追跡します。監視では、リソースがいつ、誰によって、何に使用されたか、およびエラーが発生したかどうかを明記する必要があります。
パフォーマンス指標:レイテンシやスループットなどの主要業績指標(KPI)を追跡します。歩留まり、無駄、エラー率なども含まれます。
ボトルネックの特定:システムのスループットを低下させる制約を特定する。
重要なのは、システムの事後分析を、高負荷時、メンテナンス時、アイドル時など、あらゆる条件下で実施できることです。何が、いつ、なぜ起こったのかを詳細に理解することが重要です。こうした観測データがなければ、システム障害の根本原因を特定することは不可能です。
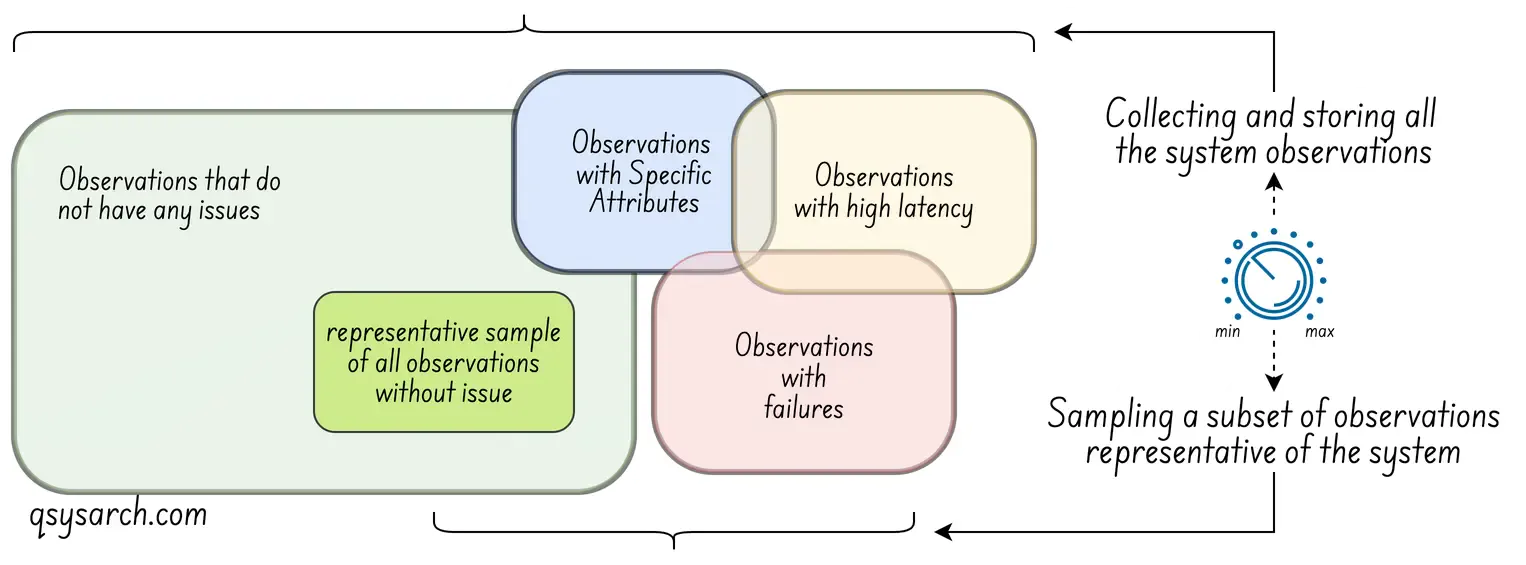
もちろん、システム全体の観測データを収集するには課題があります。観測は非常にコストがかかる場合があり、場合によっては破壊的になることもあります(量子コンピューティングの場合、システムを測定すると状態が変化する可能性があり、これは観測者効果として知られています)。つまり、システムを観測するだけの行為が、その動作を変え、パフォーマンスを低下させる可能性があるということです。この解決策はサンプリング(すべてのイベントではなく、一部のイベントからのみデータを収集すること)です。そのアイデアは、サンプリングレート(データ収集の頻度)を調整可能なシステムパラメータにすることです。下の図を参照してください(出典:OpenTelemetry)。
非コンピュータシステムの場合、効果的な可観測性によって、例えばプロジェクトが遅延している理由を説明できるようになります。可観測データとしては、各プロジェクトフェーズで行われた追跡可能な意思決定を説明する、ISO9001で規定されている技術文書および非技術文書が考えられます。
可観測性が確立されると、システムの解析的なパラメータ挙動を理解し始めることができます。この挙動は次の柱の基礎となります。つまり、それを記述し、パラメータモデルに変換することができます。次のステップは、一連のパラメータまたは条件が与えられた場合に、そのようなモデルが何を提供する必要があるかを明確にすることです。
パフォーマンス:システムが提供できる最大スループットと最大レイテンシはどのくらいですか。
運用コスト:割り当てられたリソース数で表した場合、システムを運用するのにどれくらいの費用がかかりますか?このコストは時間帯によって変動する場合があります。
再構成:システムパラメータを更新した場合の一時的な影響(一時的な効果)は何ですか?例えば、新しいサーバーやQPUを割り当てて適切に構成する場合などです。
重要なのは、システムの動作をシミュレーションし、さまざまな動作条件下での性能を観察することです。モデルにはリソースコストが含まれているため、これらの条件下でのコストのトレードオフを示すことができます。この情報は計画段階において重要です。
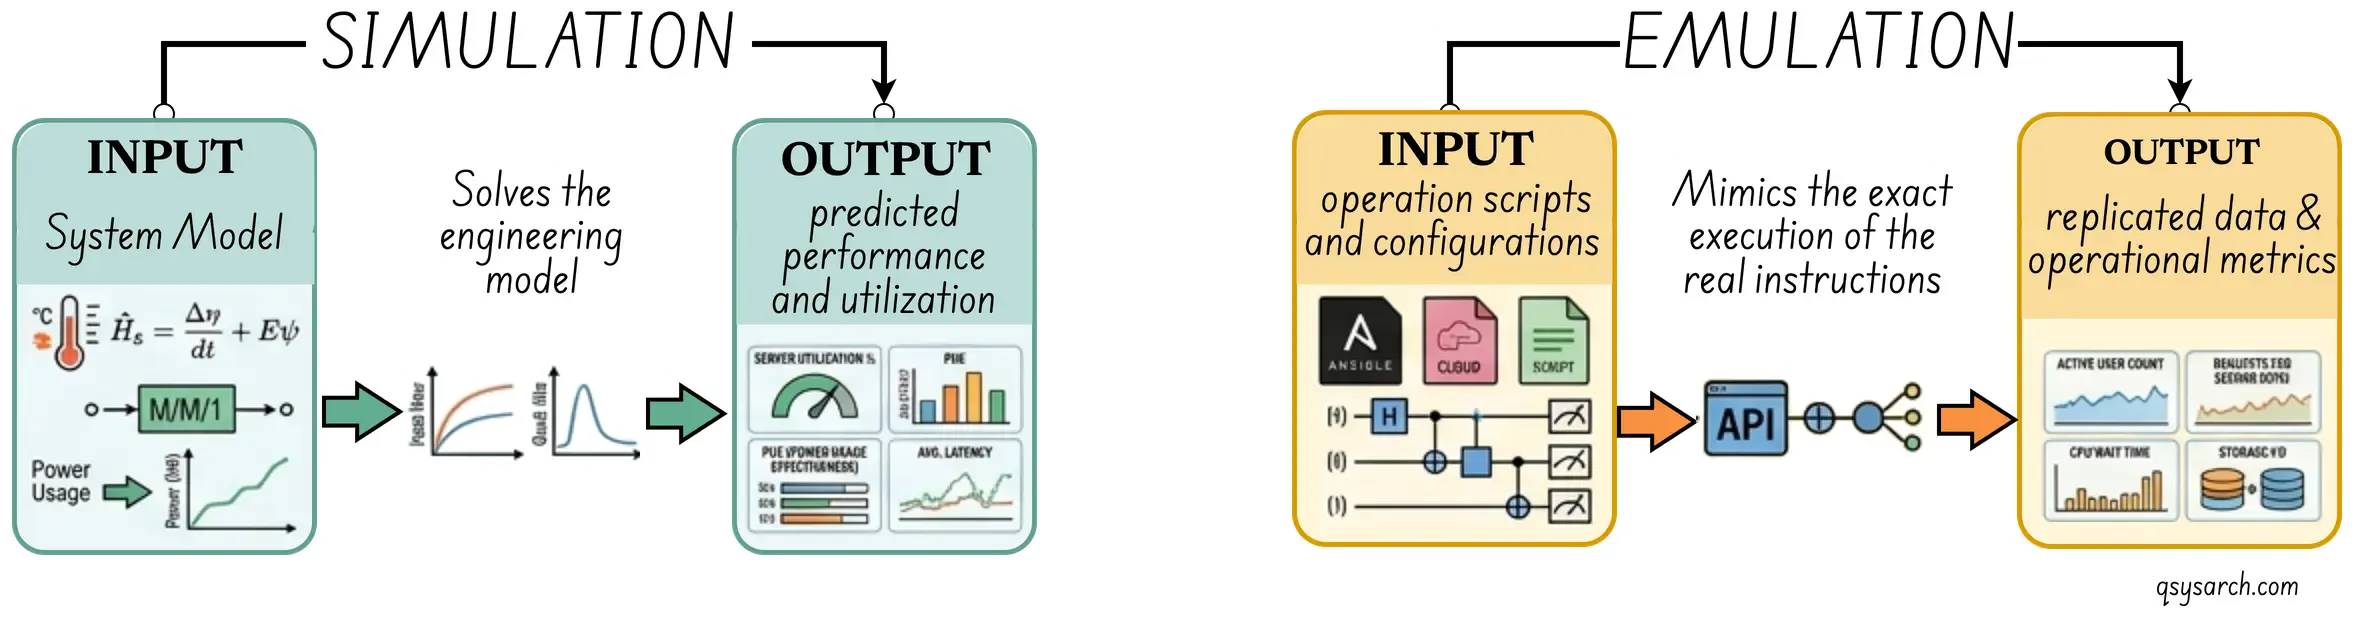
ここで、シミュレーションとエミュレーションの違いについて触れておく価値がある。大まかに言うと、エミュレーションはシステムの模擬版を作成するのに対し、シミュレーションはシステムの抽象モデル上で動作する。エミュレーションでは、入力が同じであるため、エミュレートされたパフォーマンスと実際のパフォーマンスを比較することが可能である。CEEの文脈では、モデルとは主にシミュレータを指すものと想定する。
非コンピューティングシステムに適したモデルであれば、プロジェクトにリソースを追加した場合の影響を予測できるはずです。実際、リソースを追加するとシステムのパフォーマンスが低下する場合もあります。この直感に反する結果は、ブルックスの法則として知られています。
モデルが完成したら、システム運用の計画を開始できます。モデルを使って様々な条件をシミュレーションし、最適な条件を見つけましょう。これらの結果を基に、需要に応じてリソースを戦略的に割り当てます。優れた計画には、需要予測、コスト管理、フェイルセーフ機能が備わっているべきです。需要予測は、将来の使用量、トラフィック、またはニーズを予測します。コスト管理は、ピーク時の容量を維持しながら、過剰なリソース供給を抑制します。フェイルセーフ機能は、予期せぬ需要に対応するためのバッファを提供します。
重要なのは、システムを効率的かつ確実に運用することです。ピーク負荷にも確実に対応し、コスト効率を保証します。予測された容量に基づいて、事前に再構成を行うことができます。予期せぬ事態に対応するための十分なバッファを確保します。
この計画は、需要が予想通りである場合の最良シナリオと、需要が予想よりも多い場合または少ない場合の最悪シナリオを組み合わせたものです。このアプローチにより、コスト効率に優れた生産能力の配分が実現します。
優れたモデルを設計することは、まさに卵が先か鶏が先かという問題です。システム内で何を観察すべきか、そしてそれをどのように観察すべきかを知らなければ、効率的かつ正確なモデルを構築することは困難です。正確なモデルがなければ、計画は良い結果を生み出す可能性は低いでしょう。
シミュレーション結果と実際の動作に差異が生じた場合、不足しているパラメータを特定しようとします。これは通常、事後的に観測対象システムのログを分析することによって行われます。目標は、新たに観測すべきパラメータを特定することです。
この学習ループは、上の図では「知識の微調整」として表されています。
エンジニアリングプラットフォーム
見出しへのリンク
CEE単体では、ワークフロー全体をサポートする自動化プラットフォームがなければ不十分です。このエンジニアリングプラットフォームは、以下の図に示されています。
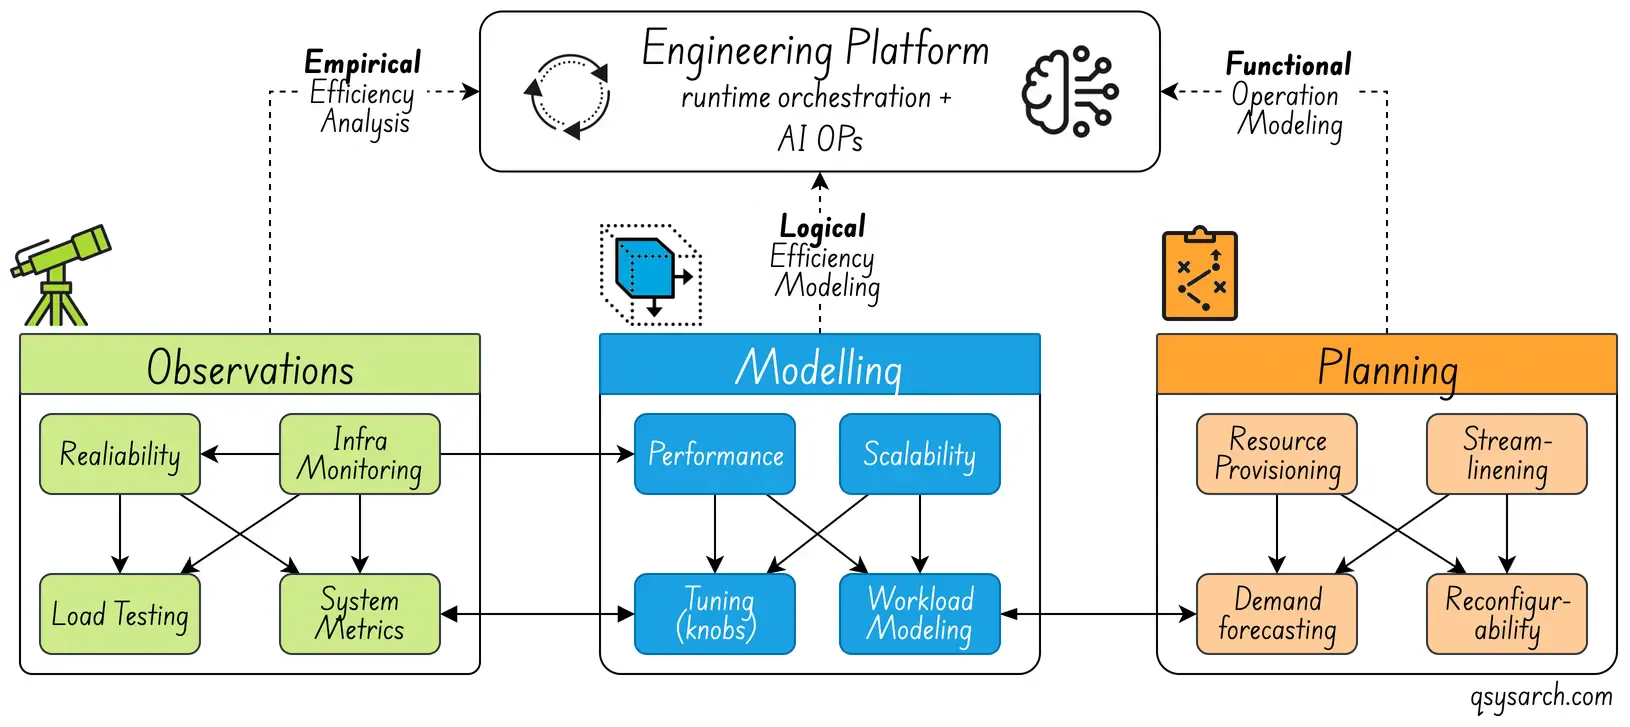
エンジニアリング プラットフォームの目的は、システムのスケールアップとスケールダウンのプロセスを自動化することだけではありません。このプロセスは Ai Ops エージェントに委任できます。また、シミュレーション モデルの妥当性を経験的観測と照らし合わせて継続的に検証し、その差異をモデルを微調整できる ML エージェントにフィードバックすることも目的としています。このエージェントは強化学習ベースのエージェントである可能性が高く、リアルタイムで使用する場合は ガバナンス を適用する必要があります。
十分な速さでスケールアップできなかった場合のコスト、つまり遅延のコスト。
見出しへのリンク
システムの安定性と堅牢性を確保するには、パフォーマンスを最大レベルではなく、安定したレベルに制限する必要があります。経験則として、安定したパフォーマンスは最大パフォーマンスの約3分の2です。この閾値を超えると、システムは劣化します。そうなると、ダウンタイムのコストは、過剰プロビジョニングのコストを急速に(多くの場合指数関数的に)上回ってしまう可能性があります。
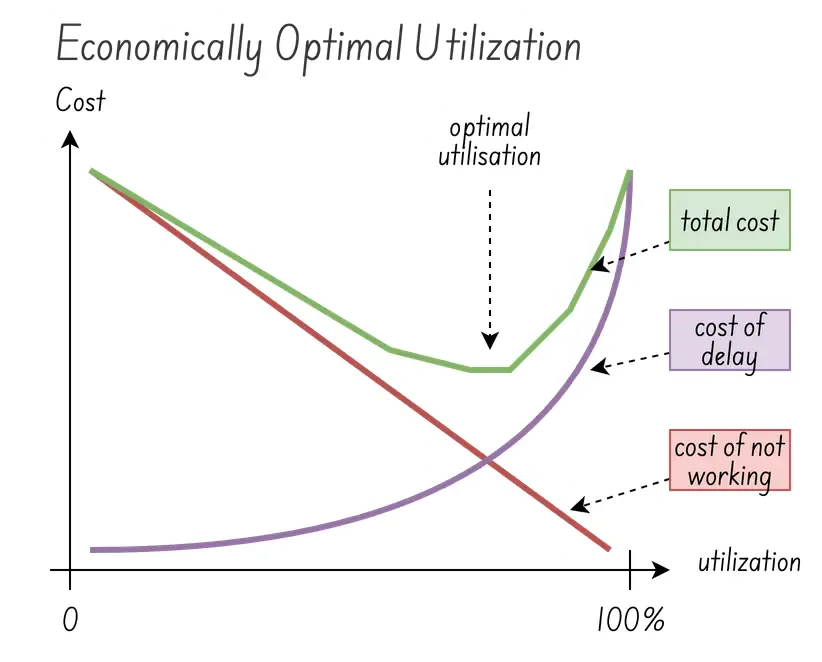
右側の図では、遅延コストは、システムを(リアルタイムで)拡張する際に需要に対応できないことによる経済的影響として捉えることができます。これは一時的なコストです。利用率が低い場合、遅延の影響を受ける需要はごくわずかです。しかし、利用率が高い場合、遅延の影響を受ける需要は多くなり、遅延コストは指数関数的に増加します。
スイートスポットとは、遅延コストと稼働していないコスト(過剰供給)の両方を最小限に抑える最適な利用率のことです。緑色の曲線は、これら2つの要素の合計として総コストを示しています。この曲線の局所的な最小値(通常は最大パフォーマンスの約2/3)が最適な利用率を示します。スイートスポットについては、実際にはもっと多くのことが言えます。スイートスポットは約80%だと主張する人もいるでしょう。重要なのは、システムを最適化することで遅延コストを削減すれば、最適な利用率を上げることができるという点を理解することです(画像クレジット:show me the data)。
システムの障害コストを下げることが、拡張にかかる時間を最小限に抑えることを意味するなら、ミリ秒単位、あるいはマイクロ秒単位で自己調整を行い、需要に応じて拡張できるシステムを想像してみてください。もちろん、そのようなシステムの開発には莫大な費用がかかる可能性があります(高頻度取引を考えてみてください)。しかし、そのようなシステムの開発コストが、システムをより高い稼働率で運用できるというメリットよりも低かったとしたらどうでしょうか?
この課題もまた、CEE(コスト効率性)の一部です。システムの改善コストをモデル化することで、改善コストとメリットのバランスが取れた計画を策定することが可能になります。これは運用上の課題というよりは、戦略的な投資と言えるでしょう。しかしながら、この課題も、システムとして捉えられる事業運営戦略に適用されるCEEの原則に基づいています。
バリューストリームマッピング(VSM)は、能力および効率エンジニアリングの文脈において、能力がどこで消費されているかを特定するための診断ツールとして一般的に使用され、無駄やボトルネックの根本原因を特定することを可能にする。
バリューストリームとは、システムがサービスを提供するために使用するワークフローにおけるすべてのステップ、つまりアクティビティのことで、マップはこのエンドツーエンドの流れを視覚的に表現したものです。VSMでは、アクティビティを3つのタイプに分類します。
付加価値 (VA): 顧客が求める出力に直接貢献するステップ (例: 実際の計算)。
付加価値はないが必須(NNVA):システムに必要な手順だが、顧客に直接的な価値はない(例:握手)。
無駄(ムダ、または無駄、日本語で「無駄」を意味する):何の価値も生み出さずに能力を消費する工程。
目標はムダ工程を排除することであり、VSMはそれらを特定することに優れています。VSMの強みは、仕掛品(WIP)を削減できる適切な最適化を特定できる点にあります。これは、平均リードタイム(またはサイクルタイム)が平均仕掛品(WIP)を平均スループットで割った値に等しいというリトルの法則(https://en.wikipedia.org/wiki/Little%27s_law)に基づいているため重要です。
リードタイム = 仕掛品 / スループットこれは、仕掛品(WIP)が倍増すれば、スループットが同じであってもリードタイムも倍増することを意味します。したがって、仕掛品の管理は、納品遅延(「遅延時間」)を改善し、ひいてはシステム効率を向上させるための最も直接的な手段の一つとなります。
# 結論
ほら、この日曜の朝に読んだ容量効率エンジニアリング(CEE)に関する短いメモのおかげで、このテーマをより深く理解することができました。今のところ覚えておきたいのは、システムの効率が非常に低い場合、それはシステムまたはそのワークフローがムダで溢れかえっている兆候である可能性が高いということです。この課題への解決策は、過剰なリソース投入ではなく、遅延コストの削減に投資することでしょうか?
References:
DrawIO diagrams used in this memo:
Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
Key
methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
Unique
angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
Metrics
emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |