xPU:これは、特定のワークロードに合わせてカスタマイズされたあらゆるコンピューティングアーキテクチャを表すことができる、特殊な処理ユニット(PU)の総称です。一般的なバリエーションとしては、GPU(グラフィックス)、TPU(テンソル/AI)、NPU(ニューラル)、DPU(データ)、PPU(パルス、主に量子制御スタックに使用)などがあります。
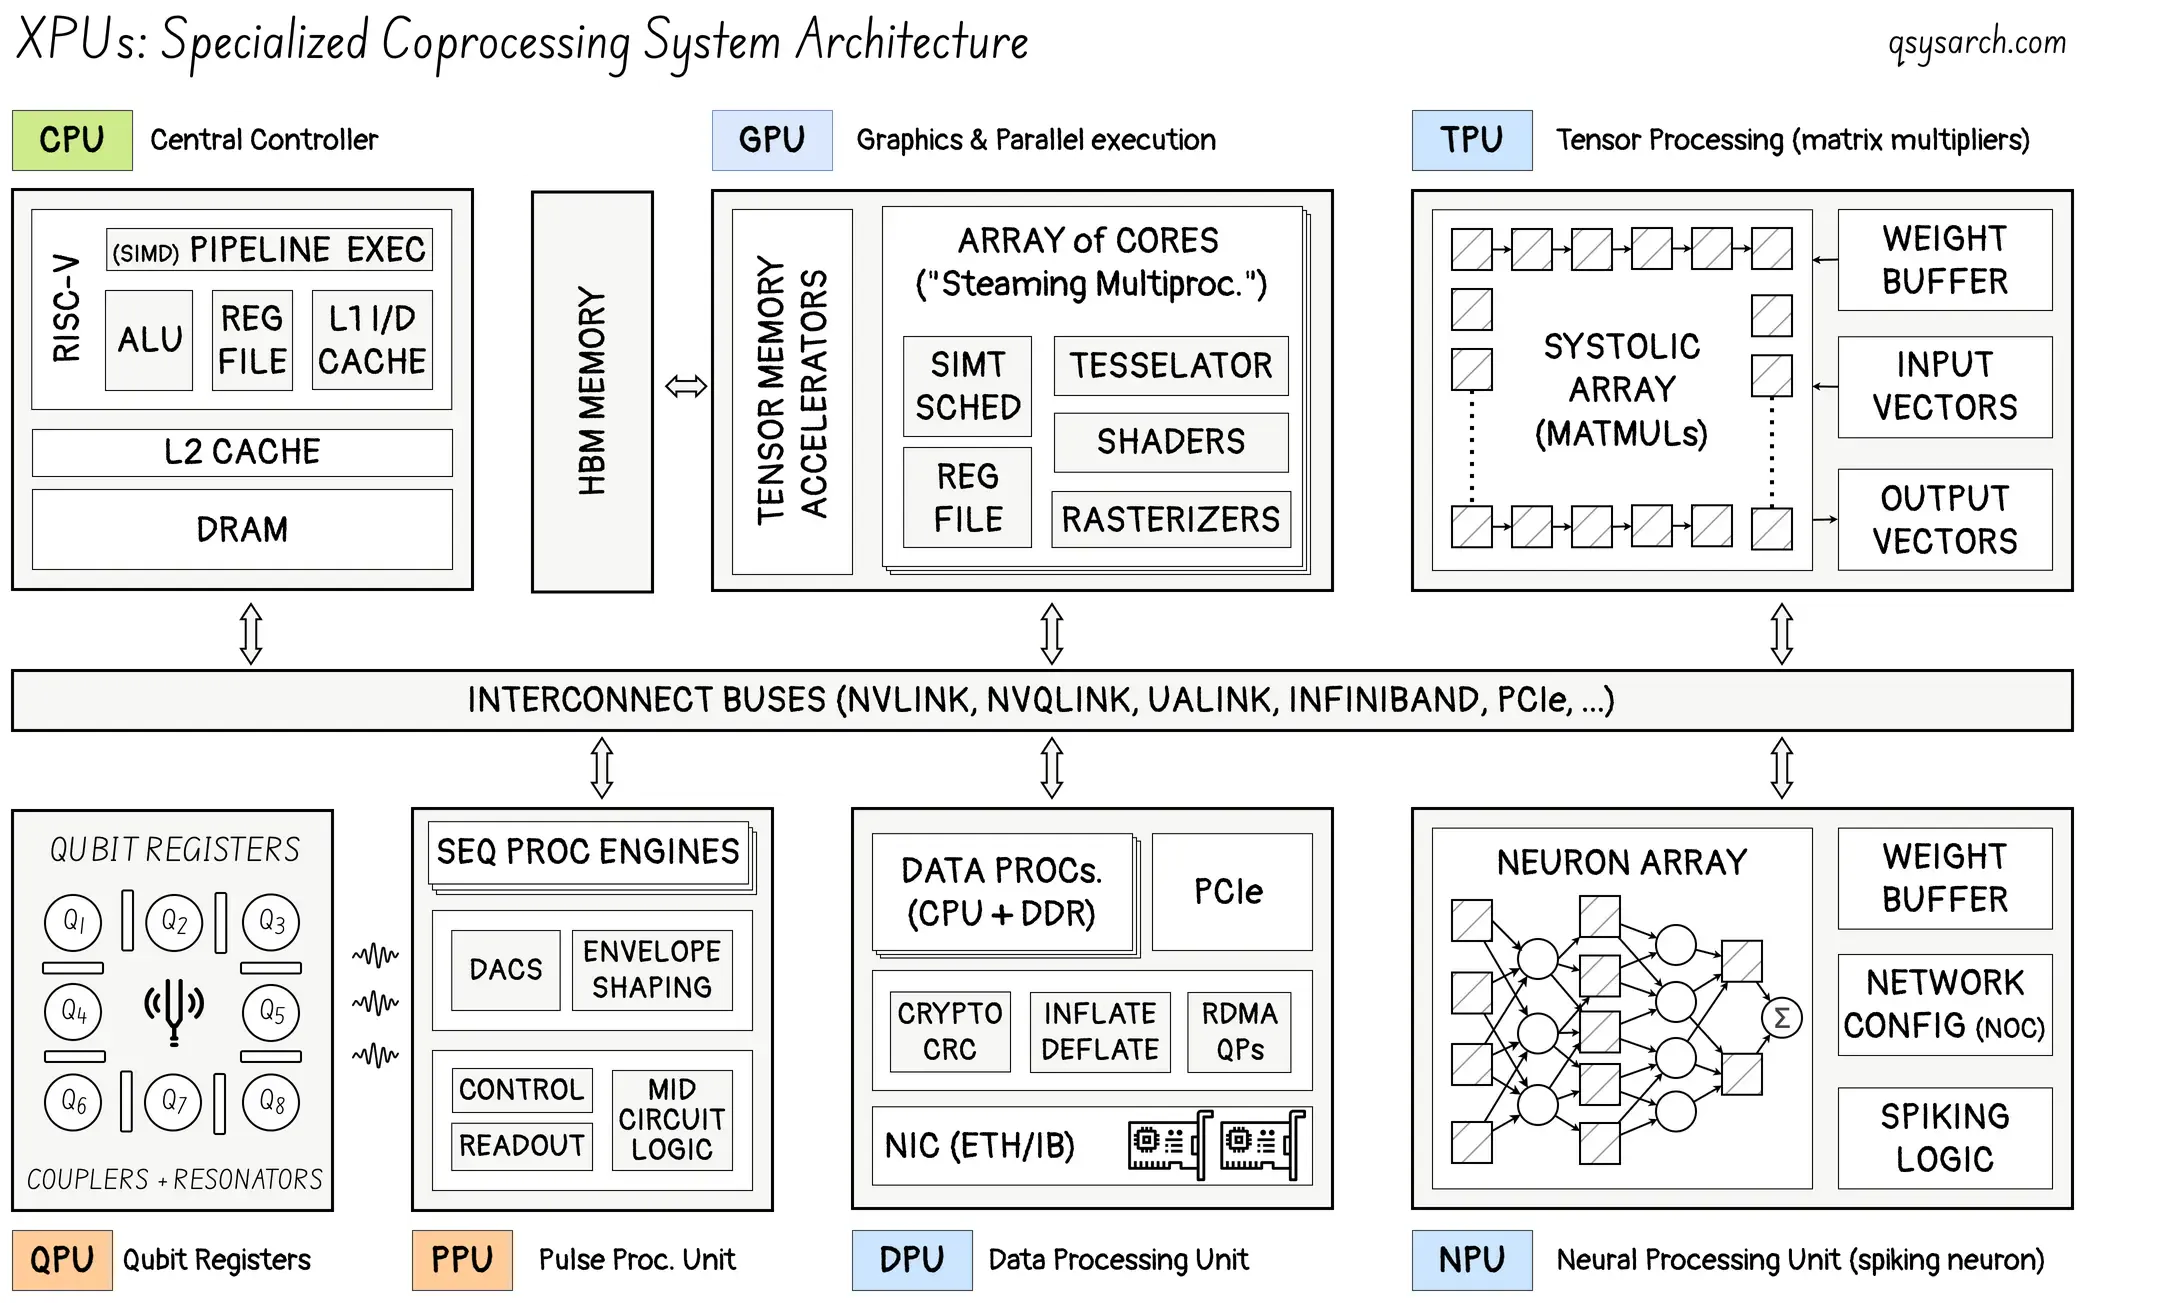
この非常に短いメモは、AI推論に適用されるxPU市場の状況に関する洞察を提供することを目的としています。
AI推論ASICの市場環境を分析する際、最も有用な指標は、単純な性能ではなく、ベンダーの差別化が3~5年の期間にわたって維持可能かどうかである。この観点から、以下の3つのクラスターが浮かび上がる。
ユニバーサルプラットフォーム: NVIDIA と 垂直統合型: AMD、Google
現在の挑戦者 Groq、Cerebras、FuriosaAI、Positron、SambaNova、Axelera AI。
将来の課題: エクストロピック、ノーマルコンピューティング、アンコンベンショナル、モトロニクス、アケトニクス
NVIDIA
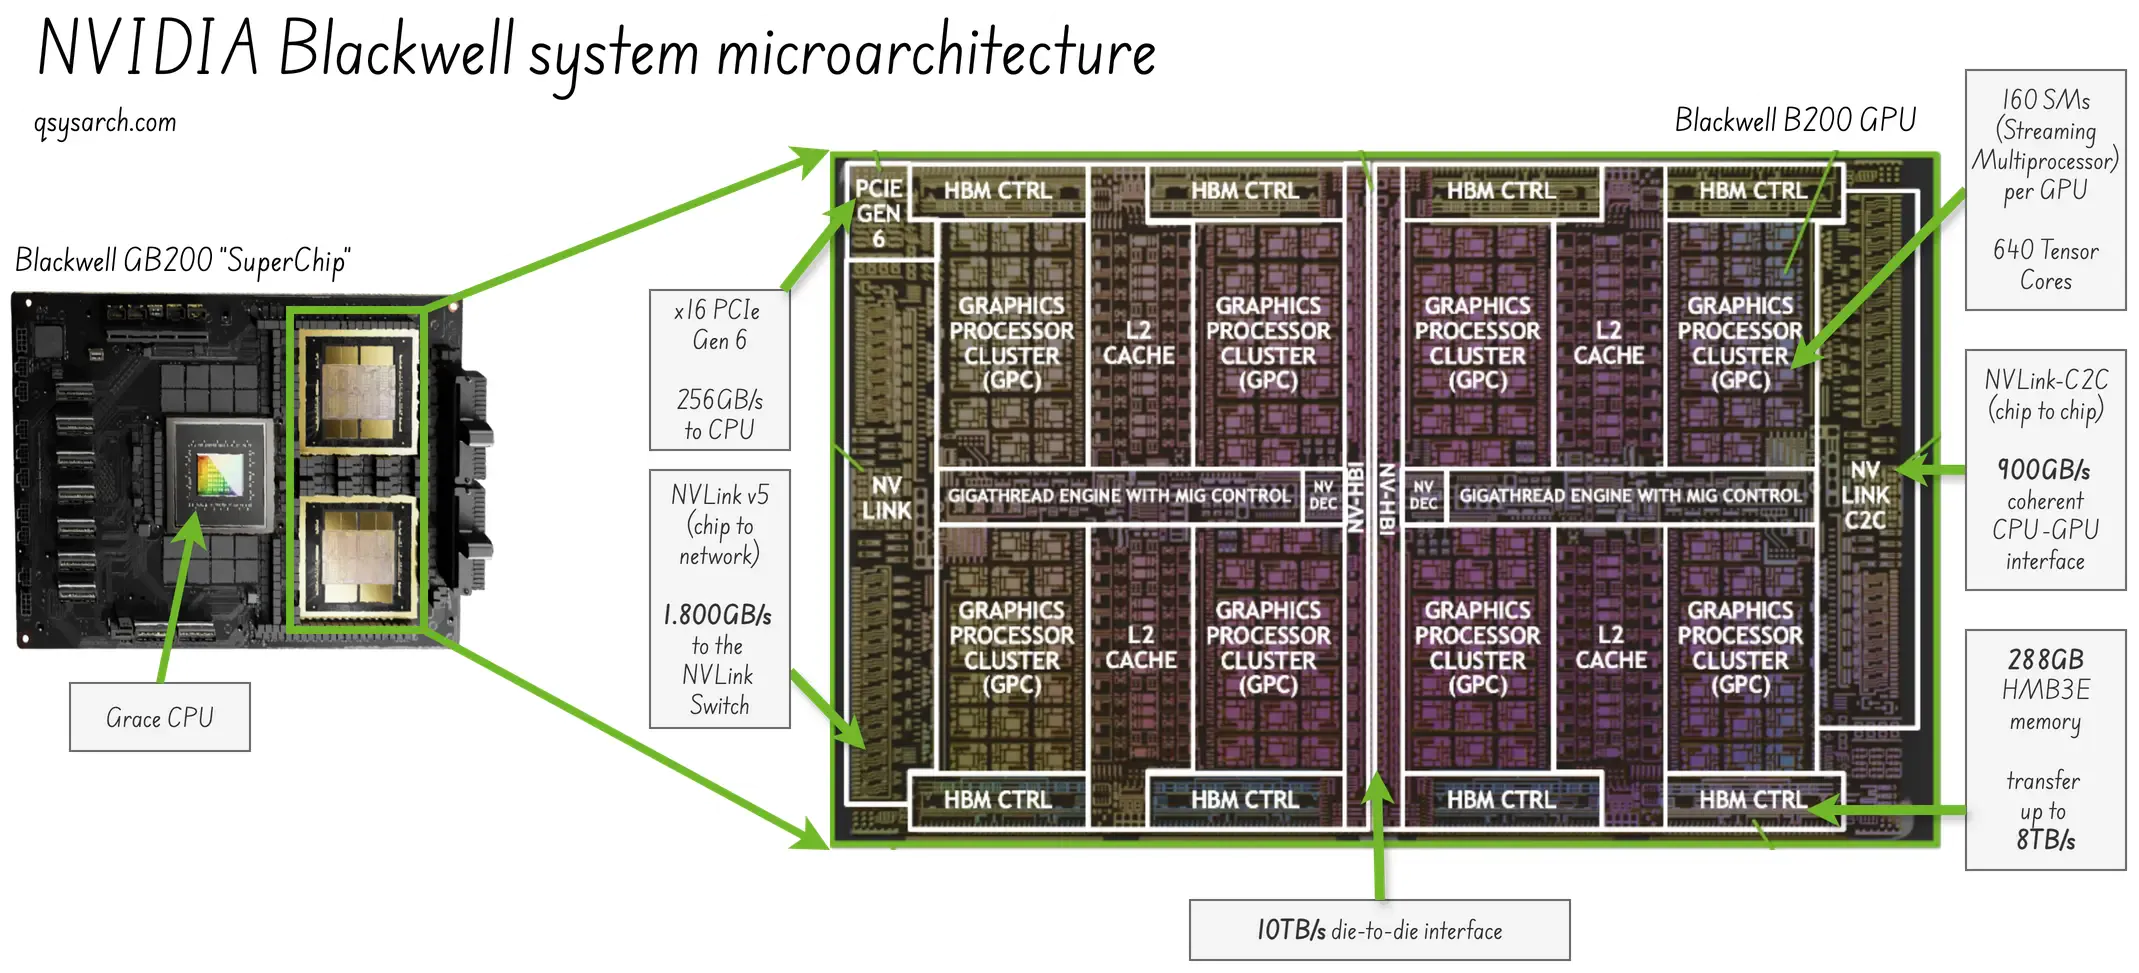
アーキテクチャ:GPU(2024年はBlackwellアーキテクチャ)
コアとなる強み:エコシステムへの囲い込み、ソフトウェアスタックの深さ、完全なシステム統合
対象ワークロード:汎用 — 大規模なLLMトレーニングと推論 - グラフィックシェーダー
脆弱性:高コスト、高消費電力。スパースコンピューティングには最適化されていない。
Google
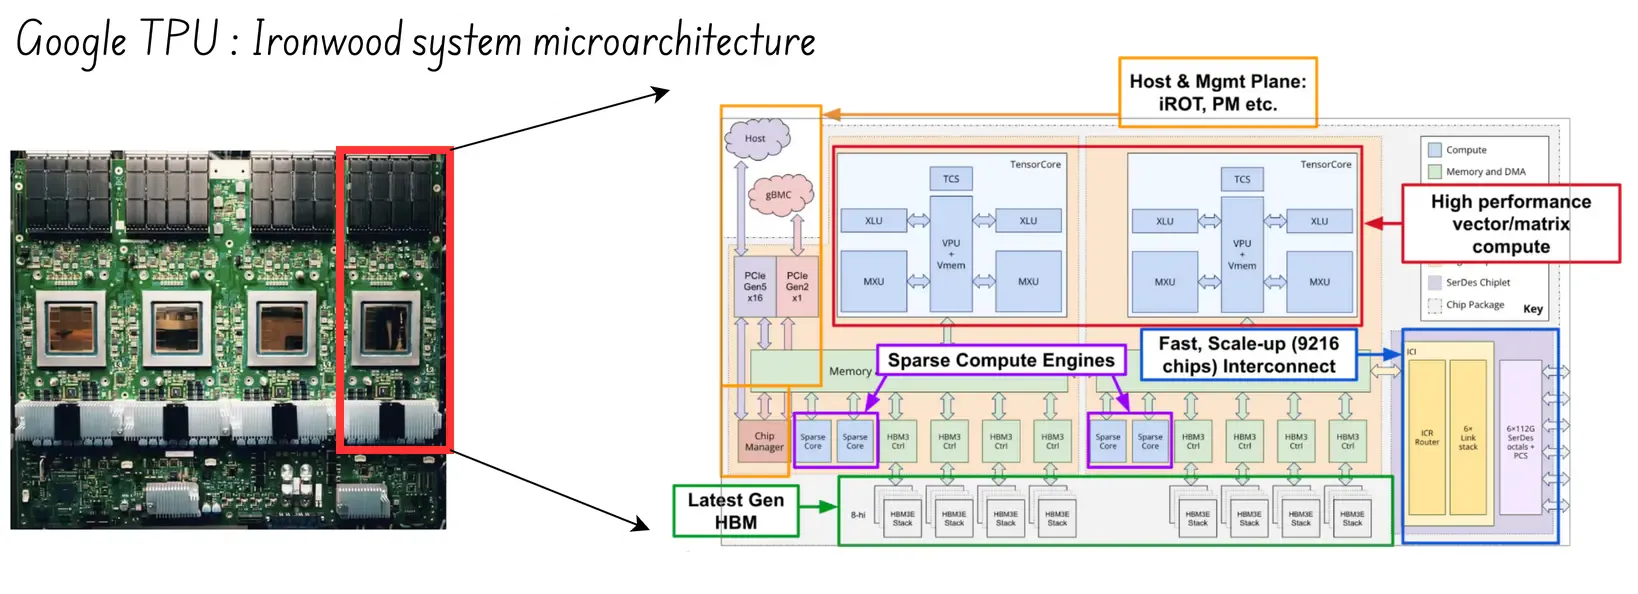
アーキテクチャ:TPU、カスタムASIC(シストリック)
コアとなる強み:垂直統合;Google規模での最低コスト
対象ワークロード: Google Cloudワークロード、Gemini推論
脆弱性:Google Cloudからのみ利用可能。GoogleからTPUコアを購入することはできません。
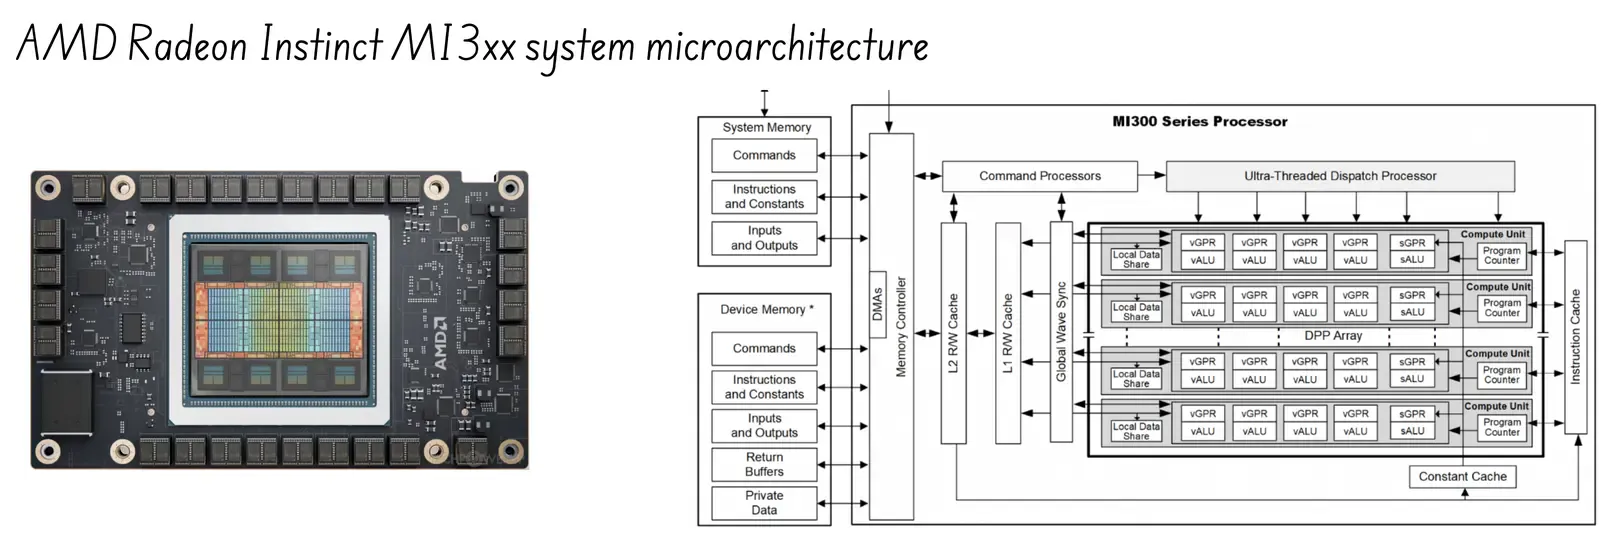
AMD
アーキテクチャ:MI300 Instinct + ROCm(AMD独自のCUDA)
コアの強み: CUDA の価格設定の代替手段。馴染みのある GPU モデル。
対象ワークロード:クラウドコスト重視のHPCおよび推論
脆弱性:CUDAに対するソフトウェアのギャップ。最先端のエコシステム(例:NVQLINK)への対応が遅れている。
Groq (NVIDIAに買収)
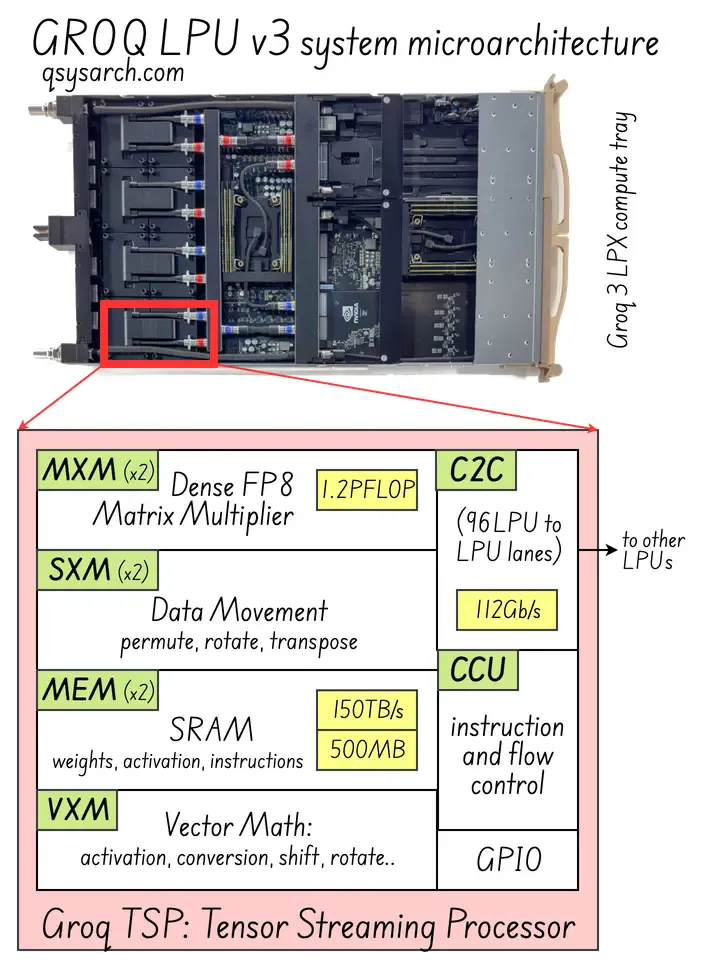
アーキテクチャ:LPU(言語処理ユニット)
動作原理:コアとなるテンソルストリーミングプロセッサ(TSP)アーキテクチャに基づいて構築されており、実行時間はクロックサイクル単位で完全に予測可能です。
コアとなる強み:決定論的な超低レイテンシ。メモリのボトルネックなし。すべてがコンパイラによって事前に「規律」されている。
対象ワークロード: リアルタイム推論
脆弱性:速度と容量のトレードオフ:大容量のHBM(高帯域幅メモリ)は搭載されておらず、小型の組み込み型超高速SRAMのみ(ただし、NVIDIAに買収された今となっては、NVIDIA Blackwellエコシステムを補完する優れた製品となっている!)
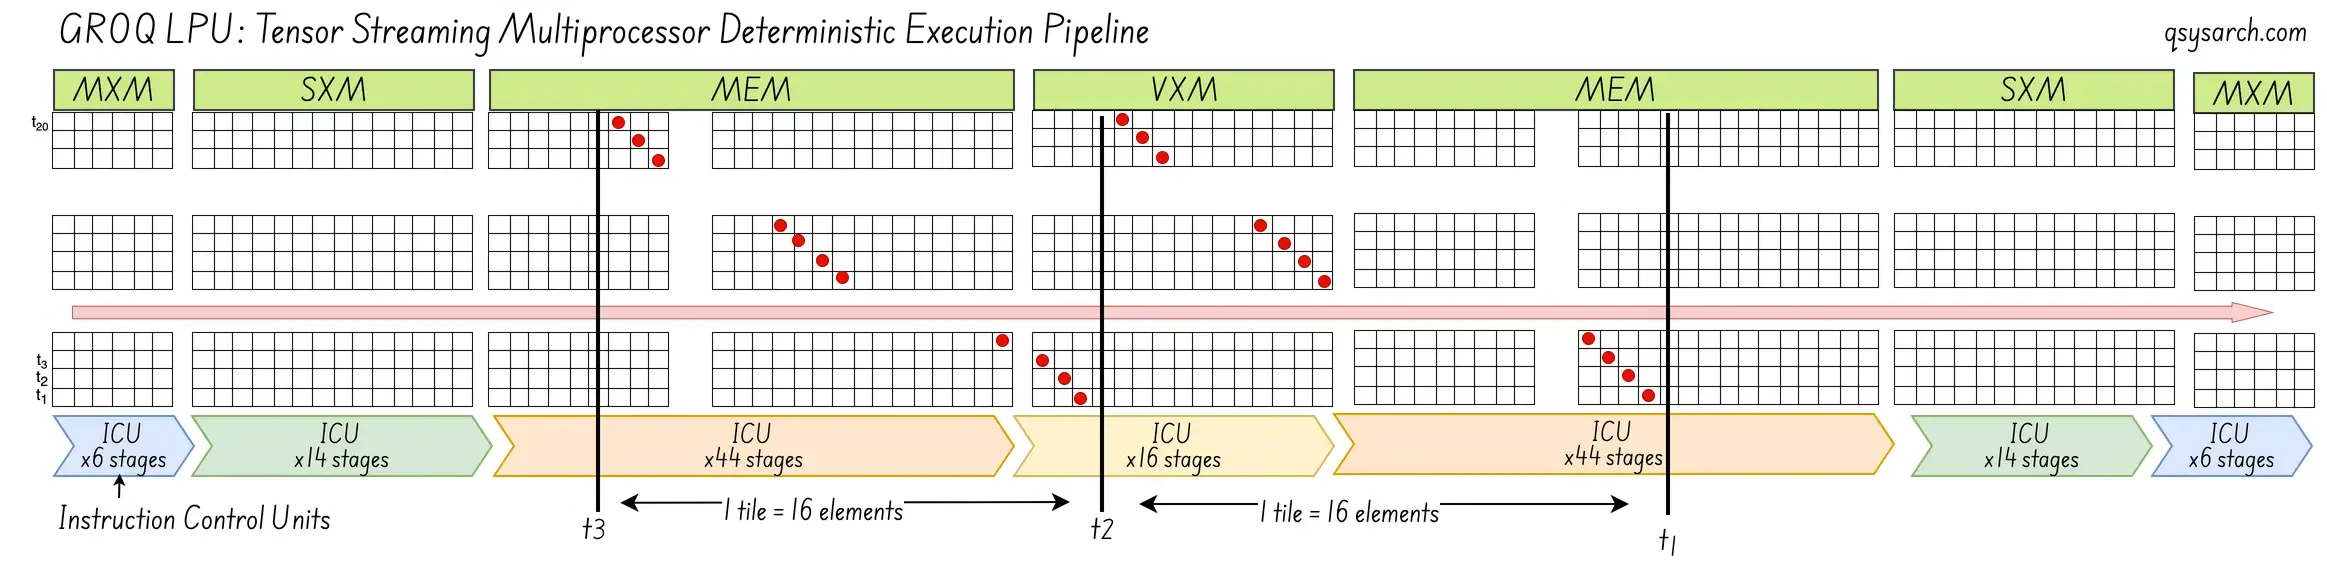
Groq LPUアーキテクチャは2020年に発表され、2024年に商用ローンチ、2026年に買収されたことに注目してください。これは、ユニコーン企業を目指す企業にとって良いタイムラインを示しています。開発に4年、市場での支持獲得に2年、そして大手企業が競争のプレッシャーを感じた場合に大当たりするチャンスです!
以下のソリューションを各ベンダーごとにきちんと検討するには数日かかる可能性があり、私はこのメモを書くための時間的余裕がありませんでした。そのため、以下の説明は不完全であったり、主観的な内容が含まれている可能性があるため、鵜呑みにしないでください。
SambaNova [インテルに買収されそう]
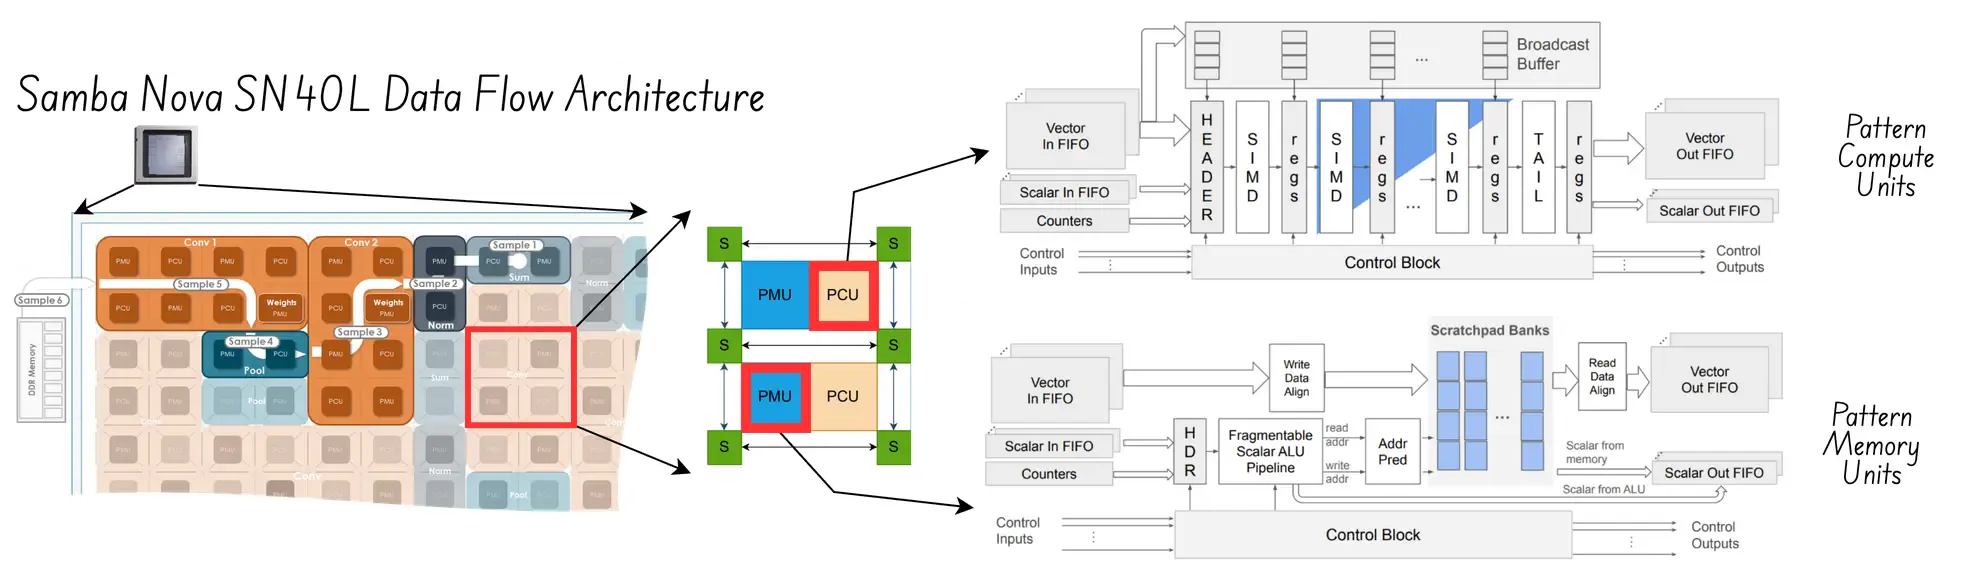
- アーキテクチャ: RDU (再構成可能なデータフローユニット)。計算グラフ全体に対してカスタム統合データ+処理パイプラインを可能にし、データ移動を最小限に抑え、高いハードウェア利用率を実現します。以下の図は、SN40Lで使用されているPCU (パターン計算ユニット)とPMU (パターンメモリユニット)の詳細なアーキテクチャを示しています。
コアとなる強み:同時推論パイプライン全体にシステムフローを慎重に分割することで、ハードウェアの利用率を最大限に高めることができます。高レベルのk8s統合、PyTorchおよびTensorFlowのコンパイラ、DataFlowアナライザーなど、完全なソフトウェアスタックが付属しています。
対象ワークロード:エンタープライズ、オンプレミス環境における規制対象業種。
脆弱性:ハードウェアの初期システムコストが高く、TCOが魅力的なものになるためには、長期間にわたって償却する必要がある。
Cerebras
アーキテクチャ:巨大なパイプライン型行列乗算器として機能するウェハースケールエンジン(WSE)。
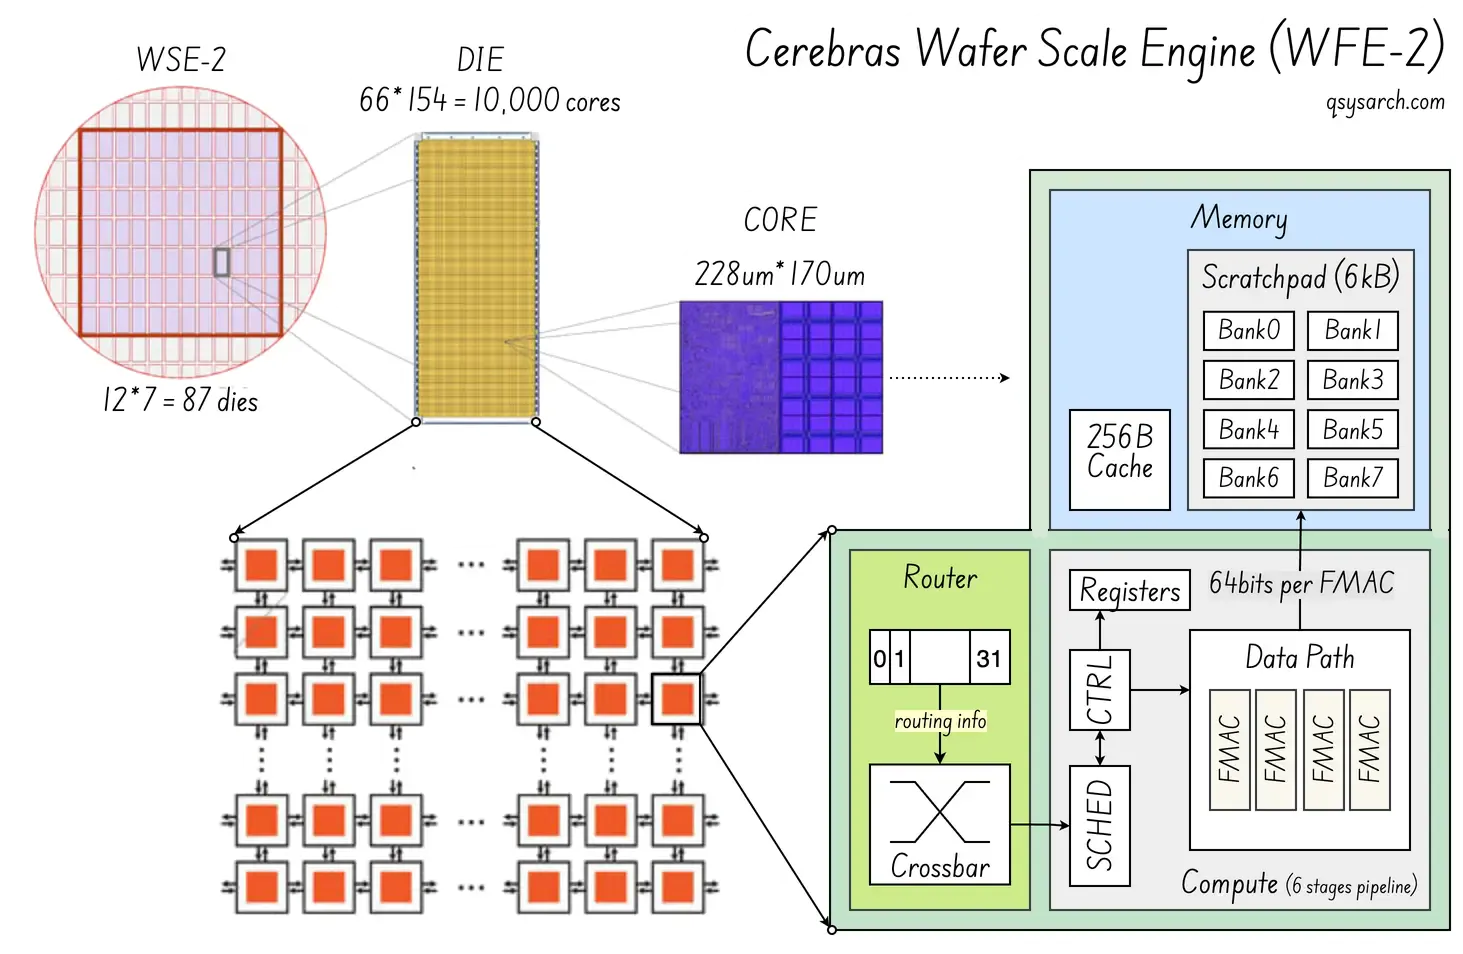
コアの強み:HBMのボトルネックを解消する大容量オンチップSRAM。メモリ内でテンソル演算が可能な高密度独立コア(WSE-2では最大85万個)。ウェハ上のノード間をシングルクロックレイテンシで接続するファブリックルータ。
対象となるワークロード:大規模なLLM推論、特にスパースモデル。
脆弱性: 大規模な処理能力を最大限に活用するには、最高レベルのソフトウェアスタックが必要です (すべての「PIM」またはメモリ内処理マイクロアーキテクチャと同様)。
【FuriosaAI】(https://furiosa.ai/)
- アーキテクチャ: Tensor Contraction Processor (TCP)、Renegade (RGND) Asic として販売されています。固定グリッドを持つ TPU シストリックアレイと比較して、Furiosa の TCP アーキテクチャは、動的に再配置可能な小型の構成可能なコンピューティングユニットを使用します (超スマートな NOC のように)。
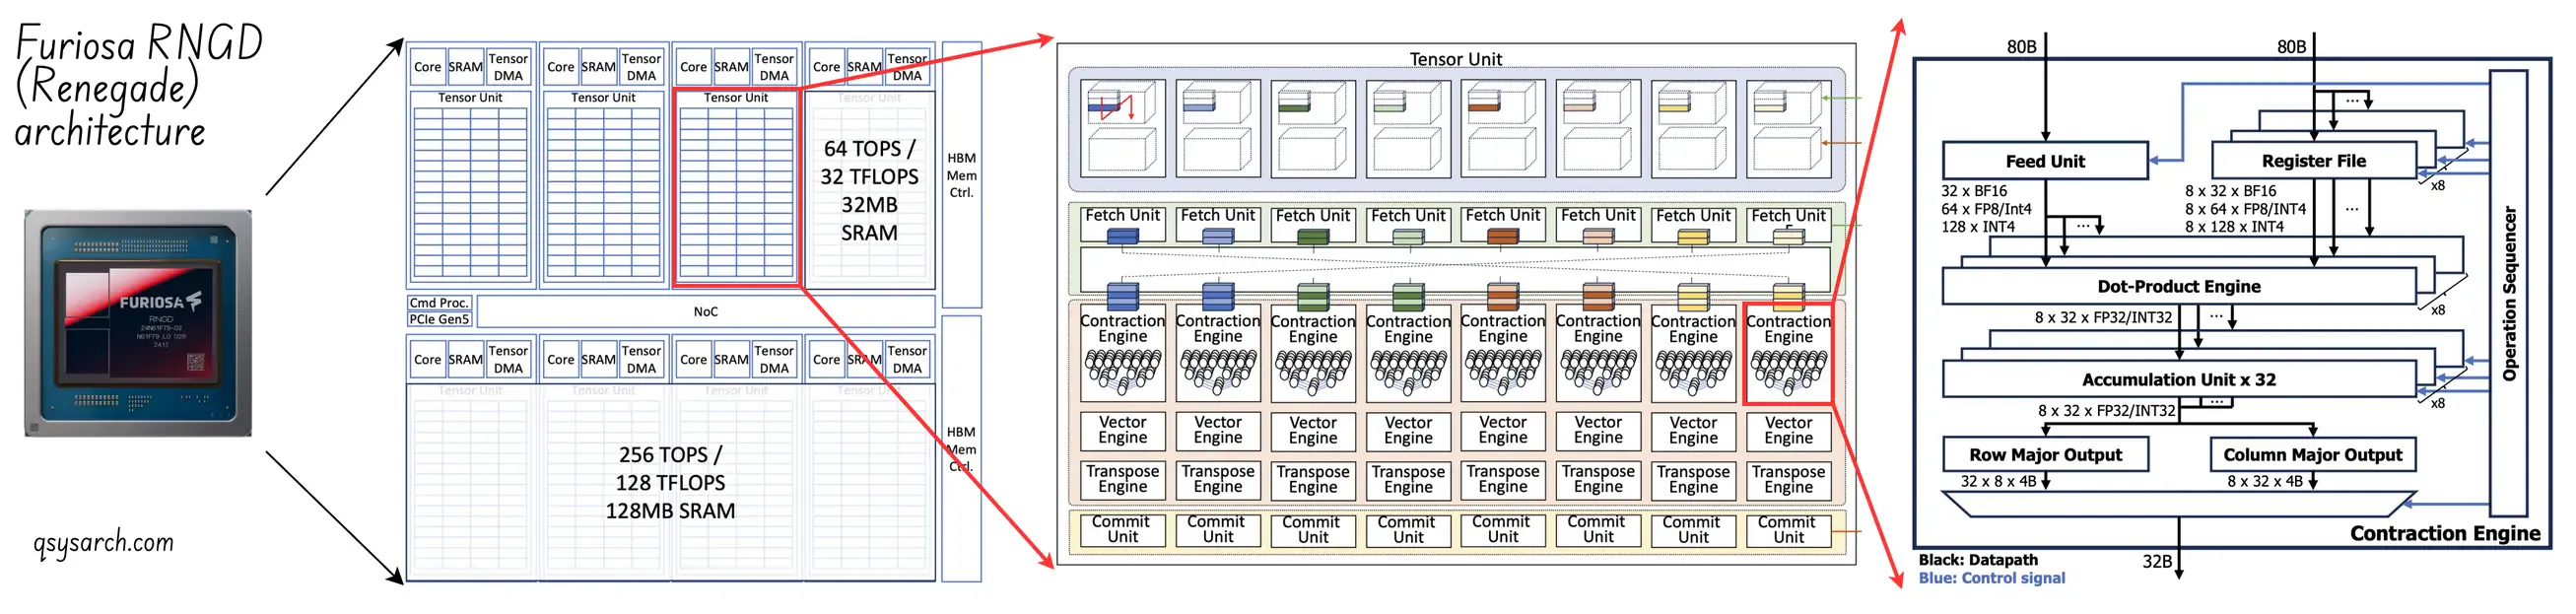
コアの強み: Furiosa は「フェッチ」 NOC を導入することで、TPU テンソル ネットワークの時空間プログラマビリティを実現し、計算ワークロードとテンソル縮約プロセッサを完璧に適合させることで、効率レベルを次の段階に引き上げます。
対象となるワークロード: LLM、VLMS、…
脆弱性:限られたエコシステム、地理的な集中リスク(ただし、アジア市場の一部を獲得できれば有利に働く可能性があり、例えば市場シェア拡大を目指すインテルにとっては良い投資対象となるだろう)。
Positron
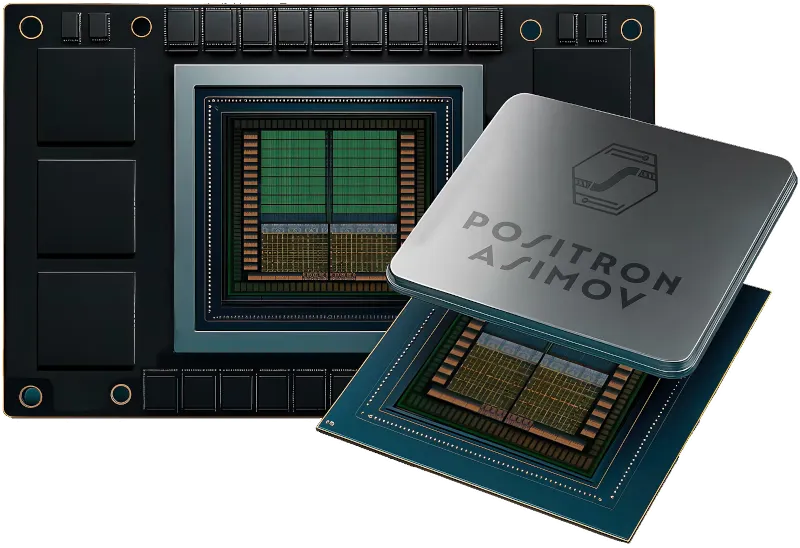
アーキテクチャ: Asimov ASIC - 入手できる情報は多くありませんが、Positron が伝えようとしている重要なメッセージは、メモリが王様であるということです。つまり、チップレットスタッキングを使用して、より多くの標準的な DDR5 メモリを ASIC に組み込むことができれば、メモリ容量の少ない NVIDIA Blackwell と比較して魅力的な製品を提供できる可能性があります。
コアとなる強み:標準的な高メモリ帯域幅(HBM)ではなく、高メモリ帯域幅利用率(MBU)に重点を置いている点。つまり、メモリバスのデューティサイクルまたは利用率を高めることができ、それによって同等(あるいはそれ以上)のメモリ電力(帯域幅×デューティサイクル、電力におけるV×I=ワットと同様)を実現できるため、高価なメモリに苦戦している競合他社を凌駕できる可能性がある。
ターゲットワークロード: 最初のASICが利用可能になったときに明らかになるが、標準的なLLMをターゲットにすると推測できる。
脆弱性:非常に初期段階であり、適切なファウンドリパートナーを見つける必要があります。一般提供および商用ソリューションまでにはおそらく2~4年かかるでしょう。その時点でメモリは依然としてボトルネックになっているでしょうか?
アクセラ AI:
- アーキテクチャ: Metis および Europe AIPU。これは、RISC-V ベースの制御データフローシステムを備えたインメモリコンピューティングアーキテクチャです。
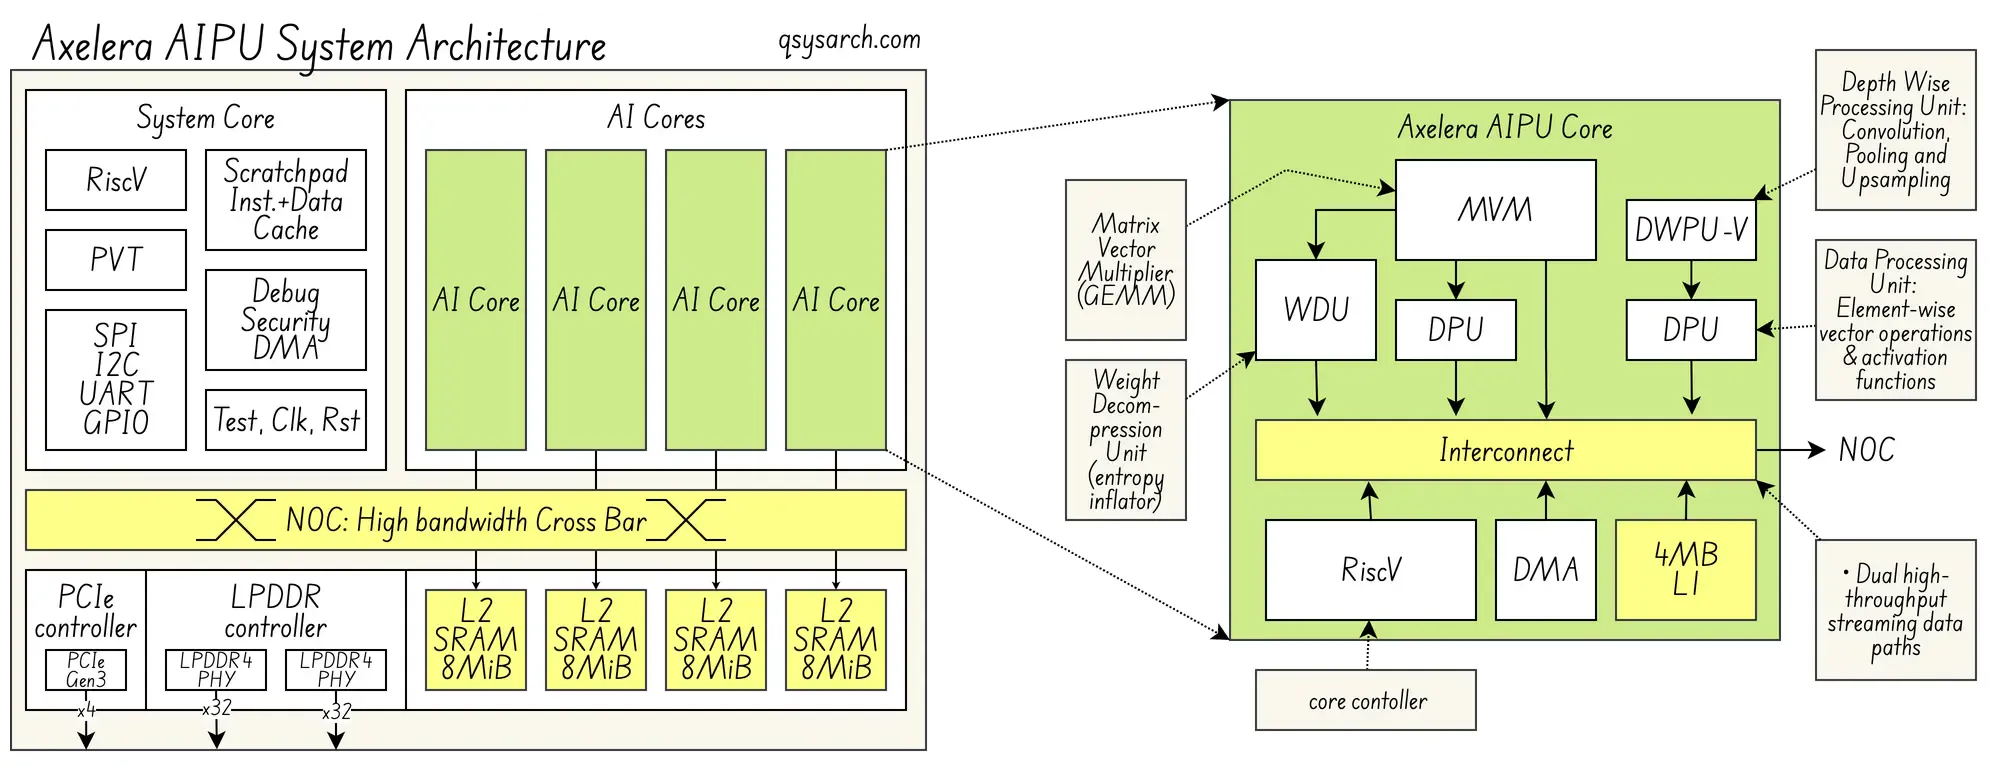
コアとなる強み:インメモリ演算を用いることで、複雑な行列乗算をデジタルメモリセル内で直接実行できるため、データ移動が不要になります。これにより、15 TOPS/ワット(NVIDIA Blackwellの約3 TOPS/ワットと比較)を実現できます。また、完全にヨーロッパで設計されたIPであるため、独自のソリューションとなっています。
対象ワークロード: 第1世代はコンピュータビジョン/マルチストリームビデオ分析に重点を置いていましたが、新世代(M2統合)はエッジLLMおよびvLMワークロードにも使用できます。
脆弱性:Axeleraの脆弱性は、エンジニアリングにあるのではなく、彼らの技術は世界最高水準である。彼らの真の脆弱性は市場の摩擦にある。彼らは、事業の焦点を分散させることなく、市場に参入できるだろうか?
上記企業に関する情報を探しているうちに、今後数年間で重要な役割を果たす可能性のある、製造業における挑戦者や破壊的イノベーターをいくつか見つけました。その中でも、Unconventional AIは、そのリーダーであるnaveengrao氏の過去の成功とビジョンのおかげで、決して軽視できない存在です。

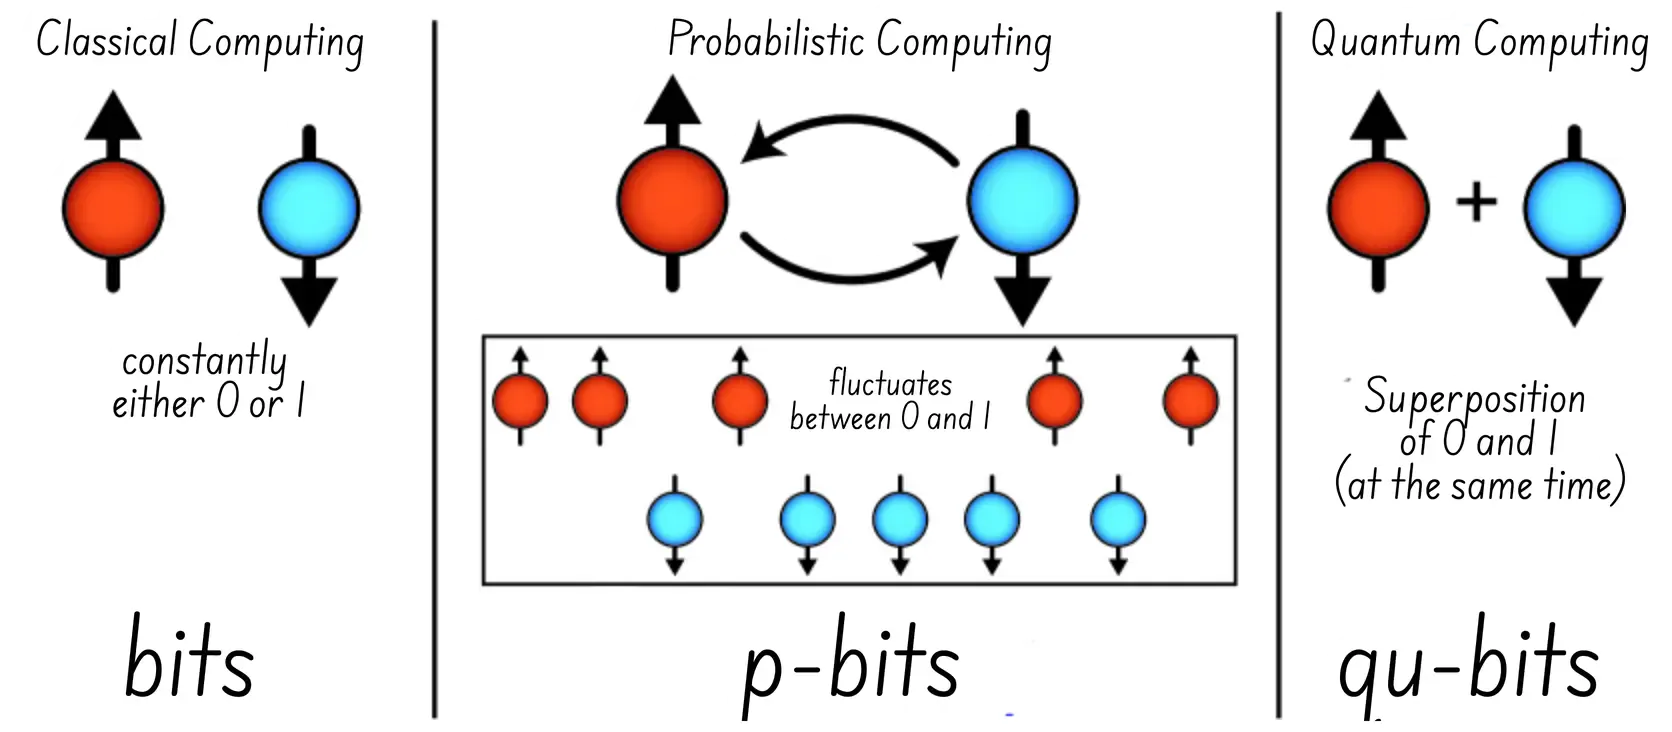
ExtropicとNormal Computing
- アーキテクチャ:TSU(熱力学的サンプリングユニット)/SPU(確率処理ユニット)を使用し、「pビット」(別名:確率ビット)を演算する。
Mottronix
アーキテクチャ:モットメモリ(モットRAM)を使用したSPU(スパイクニューラルネットワーク)。
なぜこれが重要なのか: 抵抗変化型メモリ (ReRAM) や、Mottronix の場合の Mott RAM など、代替メモリを検討する先見性のある人材が必要です。
脆弱性:研究段階から製品化されたICに移行できることを証明する必要がある。
Akhetonics
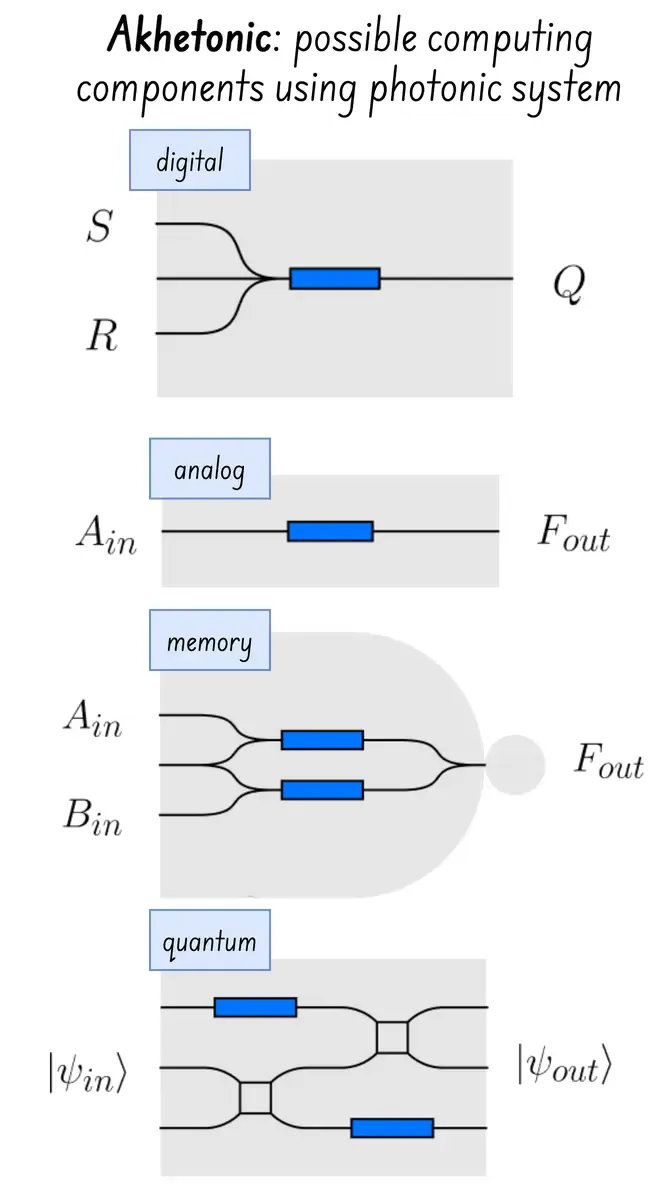
アーキテクチャ:全光デジタルプロセッサを使用したRPU(推論処理ユニット)
なぜこれが重要なのか:フォトニクスICは過去10年間で歩留まりが飛躍的に向上しました。例えばNVIDIAは現在、シリコンフォトニックネットワークスイッチを商用生産できるようになっています。これをコンピューティングワークロードに適用することは、自然な次のステップです!(これにより、光アドレス指定による量子コンピューティングも可能になります!)
脆弱性:OAQ量子計算とRPU推論計算の違いは不明確であり、どちらの場合も、商用ソリューションに拡張する前に慎重な調整とチューニングが必要です。
アラゴ
- アーキテクチャ: 光子AIアクセラレータとしての「JEF」、エネルギー消費を10倍~30倍削減可能 - Aragoに関する公開情報は非常に限られているが、フルスタックでPyTorch互換のソフトウェアSDKと組み合わせた、ハイブリッド決定論的/古典的+光子アクセラレータ統合ソリューションであるようだ。
 Unconventional AI
アーキテクチャ:蔵本発振器を用いた[UN]CPU([非]従来型処理ユニット)
なぜこれが重要なのか: 私はこのアイデアが大好きです。そして、これを実現するには実行が鍵となります。異なる考え方をする勇気を持つことは戦いの半分に過ぎません。真に世界を変える人々は、それを実行するための日々の努力を惜しみません。そして、そのためには、素晴らしい経験を持つリーダーが必要です。
脆弱性: 彼らはまだ0日目から1日目の段階なので、実行が鍵となります。
現在の市場環境を大きく変える可能性のある、真の戦線はどこにあるのだろうか?
NVIDIAの構造的な優位性はGPUそのものではなく、過去10年間で構築されてきたCUDAエコシステムにある。この戦いに勝つには、シリコンだけでなくソフトウェアでも勝利する必要がある。そして、多くの革新的なハードウェア中心の企業が失敗するのもまさにこの点だ。
- AMDはNVIDIAにとって最も過小評価されている短期的な脅威だ。CUDAを凌駕する必要はなく、独自のツールを持っている。コスト重視のクラウド顧客にとって「十分な性能」があれば良いのだ。ROCm 6.xは予想以上に速いペースでその差を縮めている。
ほとんどのイノベーターは、時間と空間の妥協のバリエーションを試みています。超高速のローカルメモリを増やすか、動的に構成可能なデータフロー(パイプライン)を許可するかのいずれかです。現状では、ボトルネックはRAMにあります。
おそらく、この両方の課題に同時に対処できるものが勝者となるでしょう。これは、メモリにゼロを転送するだけでなく、ゼロを計算することも避けたい疎行列計算(「ゼロ」が多い)において、さらに重要になります。Renegadeは違いを生み出すことができるでしょうか?
次世代チップメーカーは、コンピューティングの問題を別の角度から捉えている。つまり、数字を一つずつ命令的に掛け合わせるのではなく、動的なシステムをモデル化してデータを供給することが鍵となるのではないか?
- この境界は、量子コンピューティングと動的コンピューティングの間の重要な境界線となり得るだろうか? 量子ビットのデコヒーレンスを引き起こすことなく指数関数的な計算を可能にする中間システムを導入することで、量子クライオコンピューティングの課題と量子ビットのデコヒーレンス問題の両方を解決できるだろうか?
技術と市場の動向(2026年~2029年)
見出しへのリンク
以下は、ティア1からティア3までの展望に関する私の見解です。次のサイクルは3つの変化によって特徴づけられます。それらは影響の大きい順に記載されています。
メモリパワー™: 計算能力ではなくメモリこそが定量的なパワーを実現する鍵である
見出しへのリンク
LLM(論理レベルモデル)は、計算能力よりもメモリ帯域幅に制約される傾向が強まっています。モデルが大きくなり、コンテキストウィンドウが100万トークン以上に拡張されるにつれて、HBMとの間で重みを移動する際のコストとレイテンシが支配的になります。オンチップSRAMによるニアメモリ計算と、十分な帯域幅を備えた大容量メモリとの間でトレードオフが生じます。重要なKPIは、帯域幅×デューティサイクルとして定義されるメモリ電力になる可能性があります。
トークンごとに一部のパラメータのみをアクティブ化する(疎行列を使用する)エキスパート混合モデルもこのカテゴリに該当します。ほとんどのアクセラレータはまだ疎なアクティブ化パターンに最適化されていないため、NVIDIAはテンソルコアを導入しました。これは最終的な解決策ではないかもしれませんが、より一貫して堅牢なソリューションが登場するまでの「ハードウェアパッチ」と言えるでしょう。
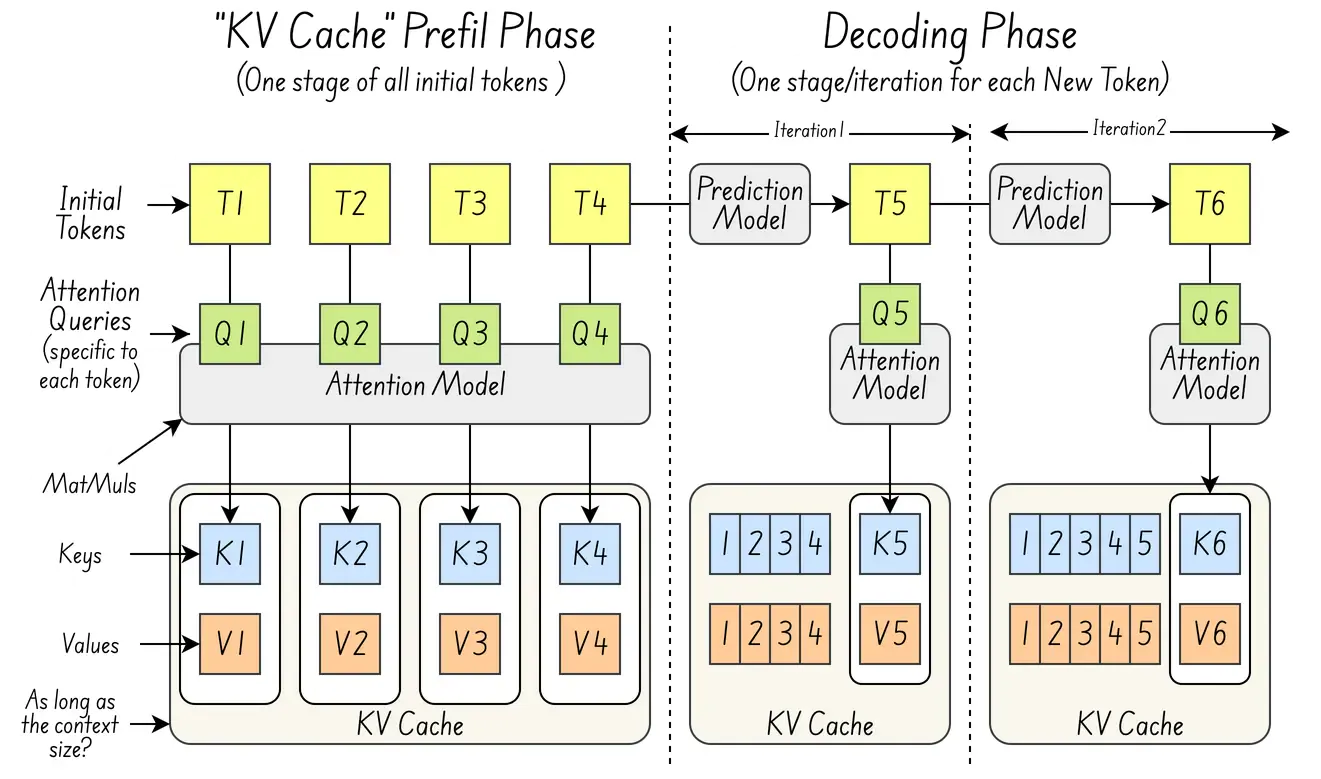 例えば、現在では、LLM の プリフィル (多数のトークンから構築される初期 KV キャッシュ) と デコード (一度に 1 つのトークンを生成する) 段階を分離するために、プリフィル/デコード (PD) 分離を使用することが一般的になっています。これにより、専用の推論コプロセッサの導入が可能になります。プリフィルにはより優れた計算能力が必要であり、デコードにはより優れたメモリ能力 (トークンごとに新しい KVQ をロードする必要があるため) が必要となるためです。
NVIDIAのスパース混合エキスパートモデル向けTensorコアも、このカテゴリーに該当します。
HWコモディティ化: インテリジェンス指数の圧力により、コモディティ化されたHWが促進されます。
見出しへのリンク
推論の価格は2年間で約10分の1に下がりました。エンタープライズAIの導入は、モデルの品質ではなく推論コストによって制限されています。つまり、標準的なLLMサービング向けに、ハイエンド(NVIDIA H100/B200)以下の汎用推論ハードウェアが登場しているということです。これは、挑戦者にとって最も明確なチャンスです。Positron Asimovプロセッサを使用して、汎用ハードウェアでGLM5.2を実行できることを想像してみてください。
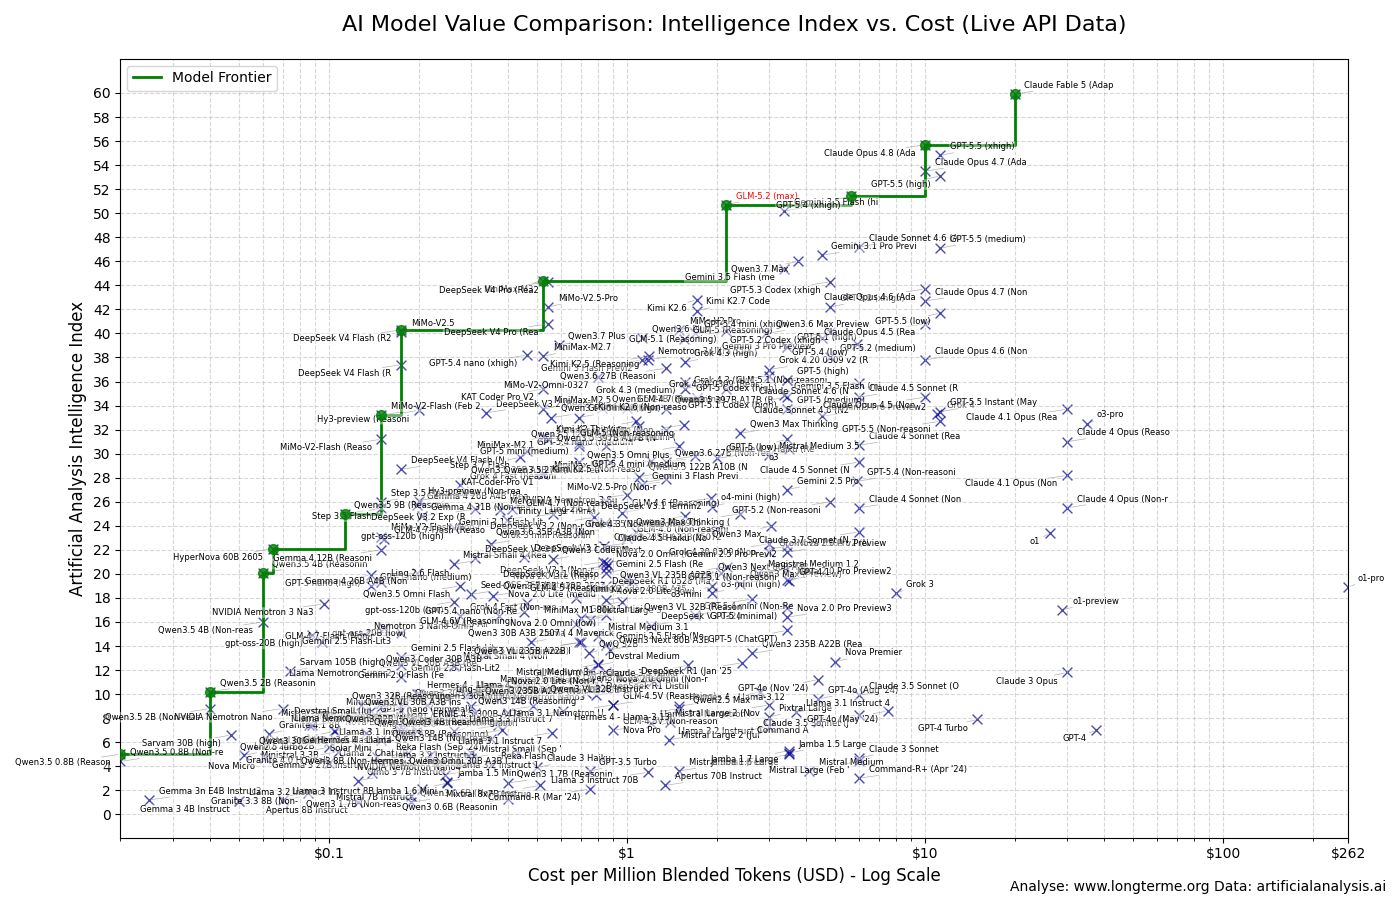 (画像出典: L’Observatoire du Long Terme - Z AI GLM5.2 はインテリジェンスとコストの点で明らかにアウトサイダーですが、200 GB 近いメモリが必要です)
導入の簡便性: 最後になりましたが、ハードウェアからソフトウェア、UI、ツールに至るまでの使いやすさが重要です。
見出しへのリンク
企業は運用上の複雑さを過小評価しがちだ。ゼロコンフィグレーションのランタイム(単なるチップではなく)を備えた「推論機能をパッケージ化したもの」を提供するベンダーは、企業市場において圧倒的なシェアを獲得するだろう。
EUおよびAPACにおける規制圧力により、オンプレミスでの推論の必要性が高まることで、この傾向はさらに強まるでしょう。なぜなら、多くの企業は自社の専有知識を外国のシステム上で推論することを望んでいないからです。
2024年から2026年にかけての推論市場は、2000年から2003年にかけてのネットワーク市場に似ている。NVIDIAは、かつてのCiscoのように、市場を支配し、多くの用途に対して過剰な設計を行い、高価格帯の製品を提供している。問題は、NVIDIAの得意とするワークロードでNVIDIAに挑戦するかどうかではなく、NVIDIAが市場を過剰にカバーしている分野、そして専用設計の代替製品が80%の性能を40%のコストで提供できる分野である。
同時に、NVIDIAはエコシステムにも多額の投資を行っており、NVIDIAがコミュニティに無償で提供しているCUDAQやNVQLinkといった優れた完全オープンソースの貢献は、NVIDIAの競合他社がこれらのコミュニティを獲得することをより困難にするだろう。
というわけで、これは短くて表面的な日曜の朝のメモでした。今後、将来の挑戦者たちのアーキテクチャの詳細についてもっと深く掘り下げていく必要がありますが、幸いなことに、少なくとも2つについてはこの夏中にメモを作成できる見込みです。さて、次のメモでは、長らく待たれていたテーマ(多くの読者から取り上げてほしいと要望されていたテーマ)である、量子誤り訂正の概要についてお話しします。
https://api-docs.deepseek.com/news/news260424
マルチコア異種ニューロモルフィックプラットフォームSpiNNaker2上でのSNN推論](https://arxiv.org/pdf/2406.17049)
このメモで使用されているDrawIO図: