L’utilizzo dell’intelligenza artificiale, o più precisamente delle reti neurali (NN), non è solo ovvio, ma anche un elemento quasi imprescindibile di qualsiasi sistema nel 2025. Non sorprende quindi che siano stati pubblicati numerosi articoli di ricerca su questo argomento. Tuttavia, la ricerca più recente ha portato i confini a un livello superiore, consentendo l’integrazione ad alte prestazioni delle reti neurali all’interno del sistema di controllo quantistico.
Questo articolo si basa sul lavoro del Singapore Centre for Quantum Technologies CQT/NUS, e più specificamente sulla ricerca di Arthur Strauss, con il quale ho avuto il grande onore di discutere e scambiare idee durante l’ultimo evento SQA.
L’apprendimento per rinforzo in soccorso Link to heading
La loro idea è affascinante: utilizzare un approccio di apprendimento per rinforzo per aiutare il sistema di controllo quantistico a sintonizzare il controllo dei qubit (ovvero i gate), basandosi su un sistema di ricompense che mira a massimizzare l’efficienza del controllo. Ci si potrebbe chiedere perché questo sia importante. Ebbene, come spiegato nell’articolo precedente (link), i qubit sono “entità” piuttosto sensibili che richiedono un’attenzione scrupolosa. Ed è qui che entra in gioco la rete neurale, aiutando a quantificare la qualità di questa attenzione, a volte definita anche fedeltà.
Come funziona? L’apprendimento per rinforzo si basa su un ciclo di Osservazioni/Azioni che vengono apprese tramite un sistema iterativo Ambiente -> Agente di ricompensa (“a” nello schema sottostante), solitamente eseguito con una GPU, e poi, una volta appreso, eseguito su un moltiplicatore di matrici strettamente accoppiato (o non!) sul sistema di controllo quantistico (“b” nello schema sottostante).
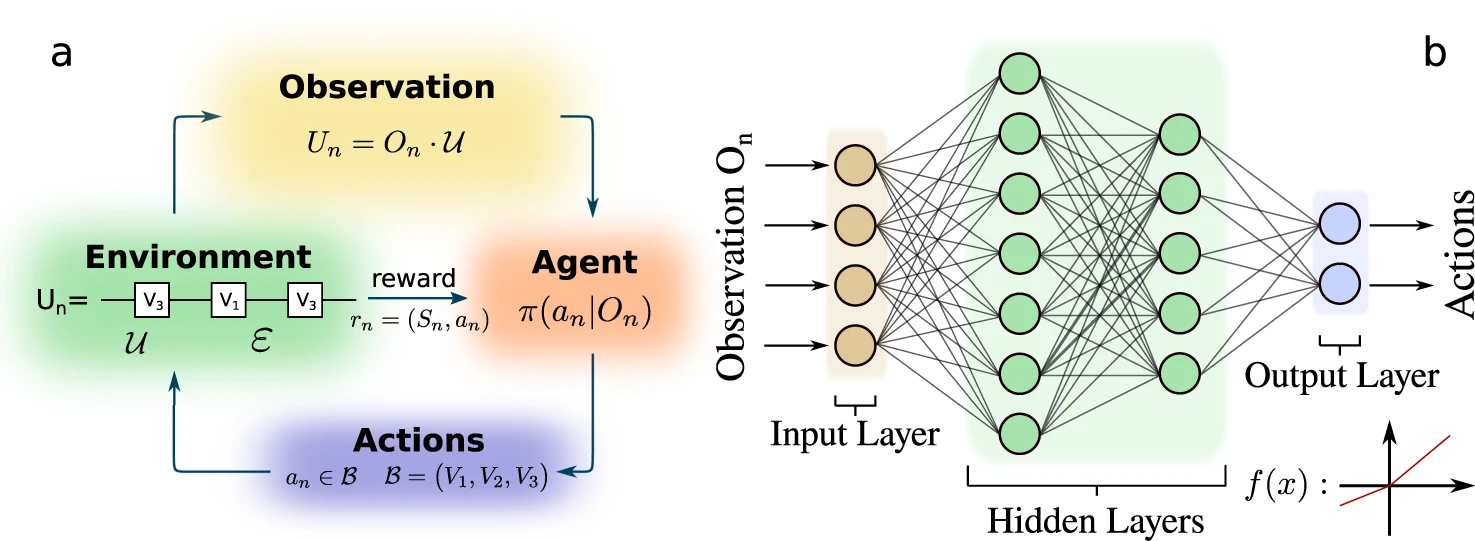 Crediti: Nature
Si noti che, poiché l’osservazione (chiamata anche lettura del qubit) distrugge lo stato quantistico, il ciclo di apprendimento prima ripristina lo stato del qubit, esegue una porta di controllo, legge lo stato del qubit e fornisce le informazioni all’agente.
Sistemi RL: Componenti chiave Link to heading
Analizziamo nel dettaglio le 4 componenti dell’apprendimento per rinforzo:
L’ambiente è costituito dal controller quantistico e dal qubit stesso.
Le azioni consistono nella regolazione delle diverse “manopole” o parametri di impulso del motore del generatore RF.
L’osservazione rappresenta le caratteristiche del qubit dopo essere state manipolate dall’ambiente.
L’agente è colui che apprende la politica che reagisce alle caratteristiche osservate del qubit e adatta di conseguenza i parametri dell’impulso.
Sistemi RL: Metodi di apprendimento Link to heading
I metodi di apprendimento per rinforzo (RL) possono essere generalmente classificati in due ampie categorie: basati sul valore e basati sul gradiente di policy.
I metodi basati sul valore si concentrano sulla stima di una funzione di valore e sulla derivazione di politiche da essa. I metodi basati sul gradiente di politica ottimizzano direttamente la politica massimizzando la ricompensa cumulativa attesa attraverso l’ascesa del gradiente.
Il vantaggio dell’iterazione delle politiche è che converge molto più velocemente rispetto ai metodi basati sui valori, sebbene siano computazionalmente più costosi. Ed è qui che entrano in gioco gli algoritmi di gradiente delle politiche, riducendo la complessità computazionale. Esempio di algoritmi di gradiente delle politiche, incluso l’algoritmo reinforce:
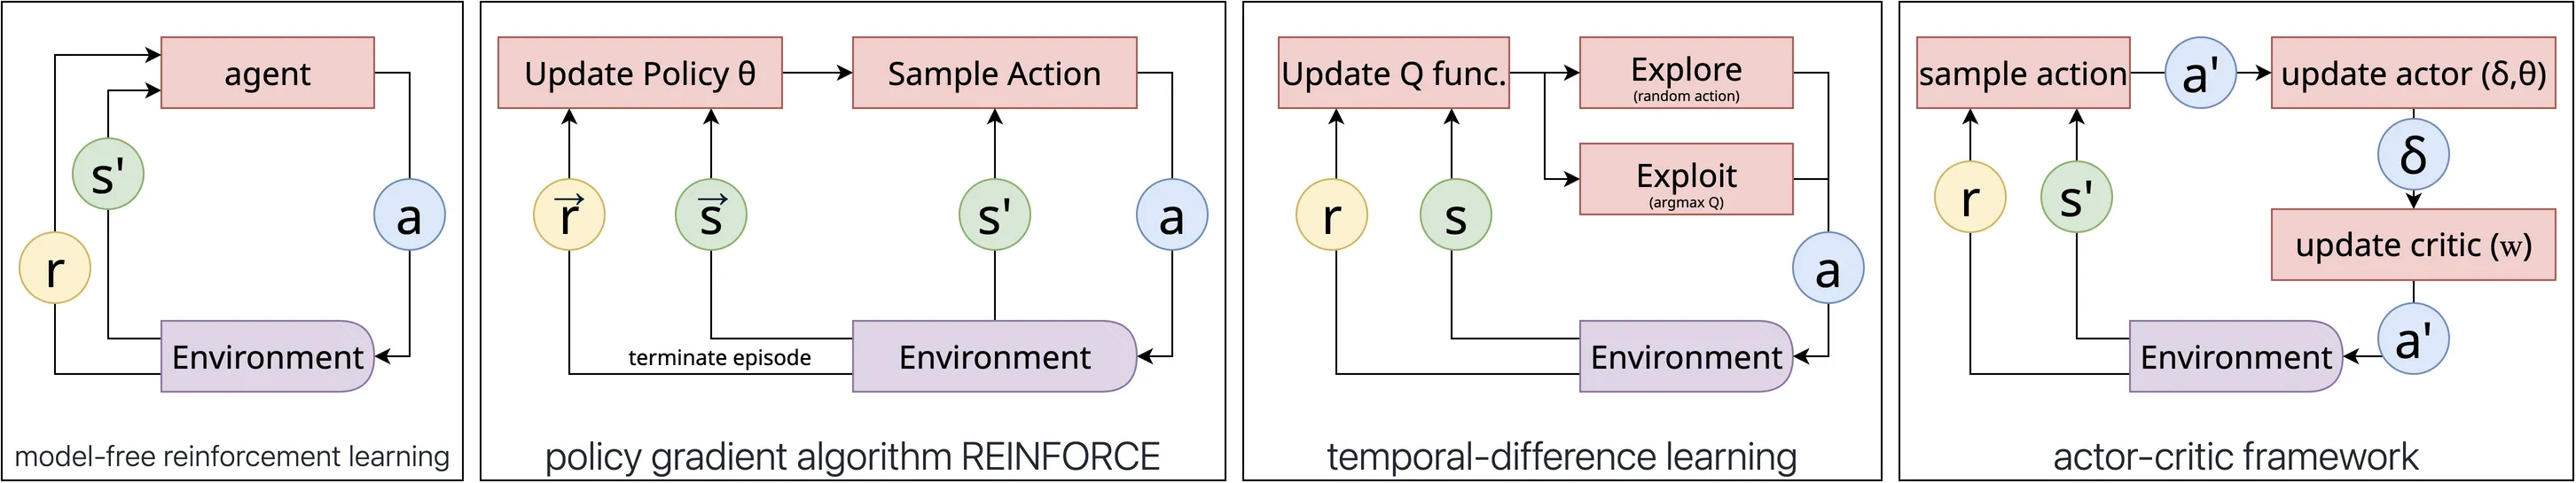
Nei diagrammi sopra riportati, s rappresenta lo stato, a l’azione e r la ricompensa.
Sistemi RL: Iterazione vs Episodi Link to heading
Nell’apprendimento per rinforzo, un episodio e un’iterazione sono concetti diversi:
Episodi:
Un episodio è una sequenza completa di interazioni tra l’agente e l’ambiente, che inizia da uno stato iniziale e termina in uno stato terminale (o dopo un orizzonte temporale massimo).
Esempio: In una partita a scacchi, un episodio è una partita completa, dalla scacchiera iniziale fino allo scacco matto, al pareggio o alla resa.
Iterazione:
In alcuni documenti/codici, un’iterazione può significare un singolo passo temporale dell’interazione agente-ambiente (stato → azione → ricompensa → stato successivo).
Nei contesti di ottimizzazione, un’iterazione può significare un passaggio di aggiornamento dell’algoritmo di apprendimento (ad esempio, un passaggio di discesa del gradiente, che potrebbe essere basato su più episodi o transizioni).
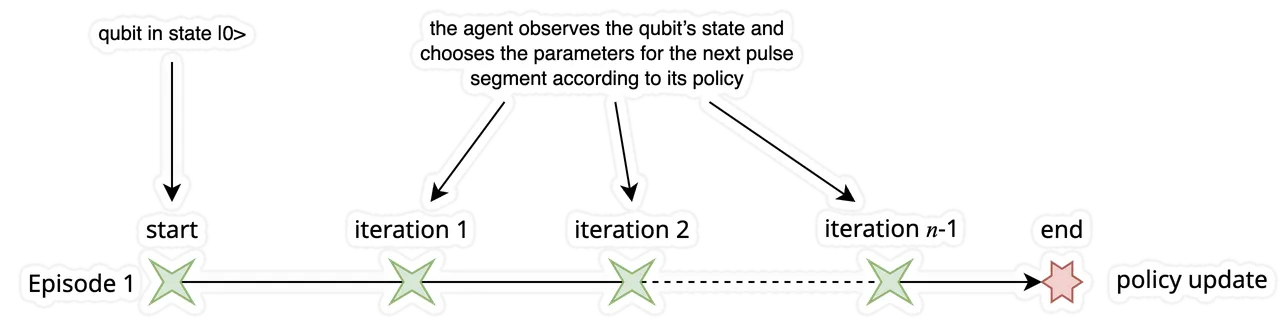
Mettiamo in pratica queste idee una per una, iniziando dal campionamento degli episodi.
Gli episodi iniziano con il qubit nello stato |O>.
Avvia il ciclo osserva-agisci
l’agente osserva lo stato del qubit
e sceglie i parametri per il segmento di impulso successivo in base alla sua politica.
Esplora provando l’azione:
Invece di scegliere in modo deterministico l’azione “migliore” (ad esempio quella con la probabilità più alta), il campionamento significa che l’agente estrarrà casualmente un’azione da quella distribuzione, in base alle probabilità.
Questo campionamento è essenziale nel metodo di rinforzo.
Calcola la funzione punteggio:
misurare quanto più (o meno) probabile diventi l’azione scelta se i parametri della rete vengono modificati in una particolare direzione.
In altre parole, valutare ∇(𝜃) per l’azione campionata.
Calcola la ricompensa al termine del programma a impulsi.
Il punteggio e la ricompensa, insieme, guidano l’aggiornamento dell’apprendimento nell’apprendimento per rinforzo basato sul gradiente di policy:
Ricompensa: feedback esterno dall’ambiente (prestazioni del compito).
Punteggio: sensibilità interna della politica ai suoi parametri (gradiente della probabilità logaritmica).
Approfondimento pratico: Flax e Jax Link to heading
da completare
Conclusion Link to heading
Scusate, questo doveva essere un post leggero, ma si è rivelato molto più complesso. Forse devo continuare a “semplificare l’equazione”. In ogni caso, cosa abbiamo imparato? Il processo di ottimizzazione per quantificare in modo ottimale la qualità dei qubit ha troppe dimensioni e, come prevedibile, le reti neurali sono molto brave a risolvere questa sfida. In questo post ci siamo concentrati sull’ottimizzazione della fedeltà di un singolo qubit. Ma pensate a due o più qubit: allora è necessario studiare l’impatto del crosstalk. Ci sono molte domande e sfide, soprattutto riguardo a come apprendere: globalmente a livello di molti qubit, o localmente e a livello di coppia di qubit. Magari anche gerarchicamente a livello di qubit logico. Molte domande, che esaminerò nel prossimo post sulla correzione degli errori quantistici.
Per approfondire e consultare i link: