In un mondo in cui l’intelligenza artificiale è avida di energia, la Tensor Processing Unit (TPU) rappresenta una vera e propria rivoluzione. Si tratta di un chip progettato su misura da Google specificamente per le attività di apprendimento automatico.
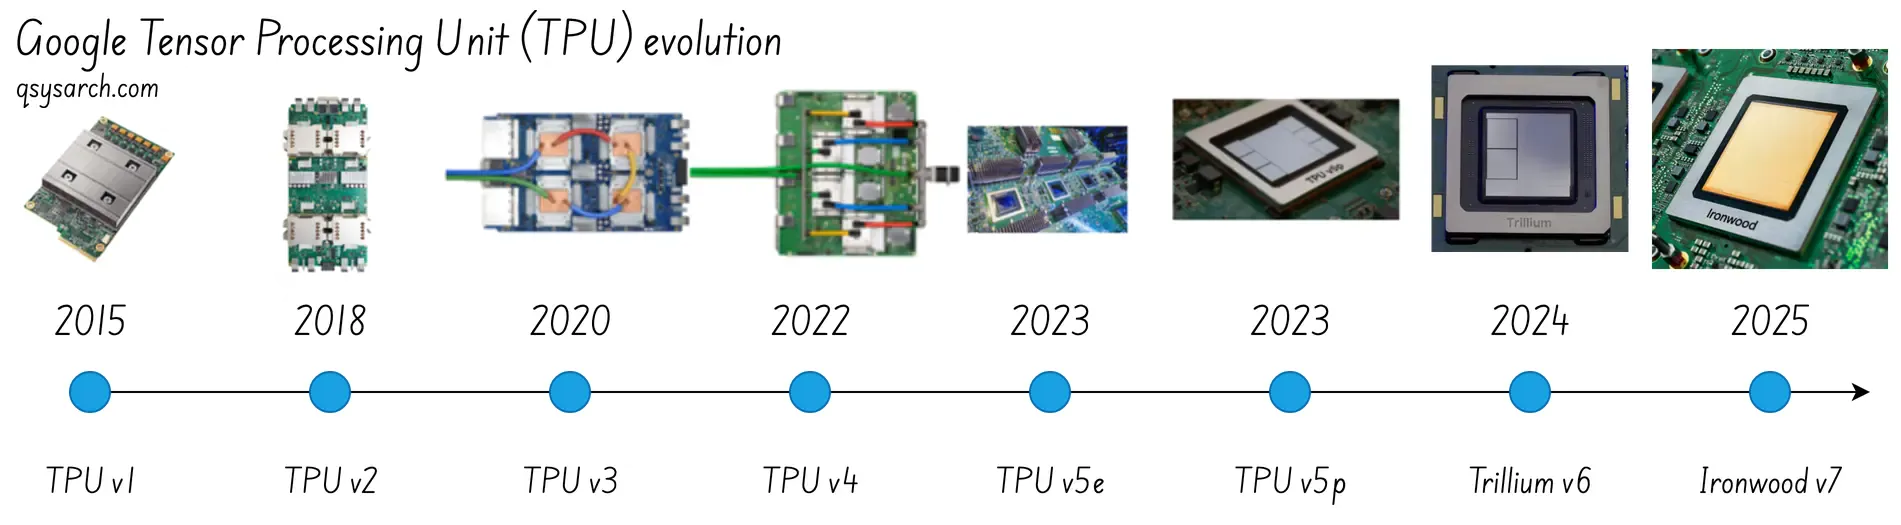
Questa breve nota informativa si propone di fornire una panoramica generale dell’architettura delle TPU e della loro evoluzione sin dalla loro nascita nel 2016.
Cercherò inoltre di rispondere a questa domanda fondamentale: perché abbiamo bisogno delle TPU se abbiamo già le GPU? Quali vantaggi offrono rispetto alle GPU? Come si confrontano con i circuiti integrati neuromorfici? Ed esiste un’architettura alternativa alle TPU e alle GPU?
 (Fonte: Google Cloud)
Perché esiste la TPU e quali problemi risolve Link to heading
La TPU condivide lo stesso obiettivo della GPU: superare la limitazione introdotta dal rallentamento della Legge di Moore, consentendo un parallelismo massiccio: a differenza delle CPU tradizionali che possono essere utilizzate per gestire calcoli generici e che, in una certa misura, hanno un livello di parallelismo tramite il concetto di multi-core (grazie alla legge di scala di Dennard), la TPU e la GPU sono hardware specializzati progettati per gestire compiti semplici e specifici, ma in un modo molto più efficiente di qualsiasi CPU.
A un livello generale, si può affermare che offrono prestazioni ed efficienza di gran lunga superiori rispetto alle CPU o GPU generiche, “scambiando la generalità con le prestazioni”.
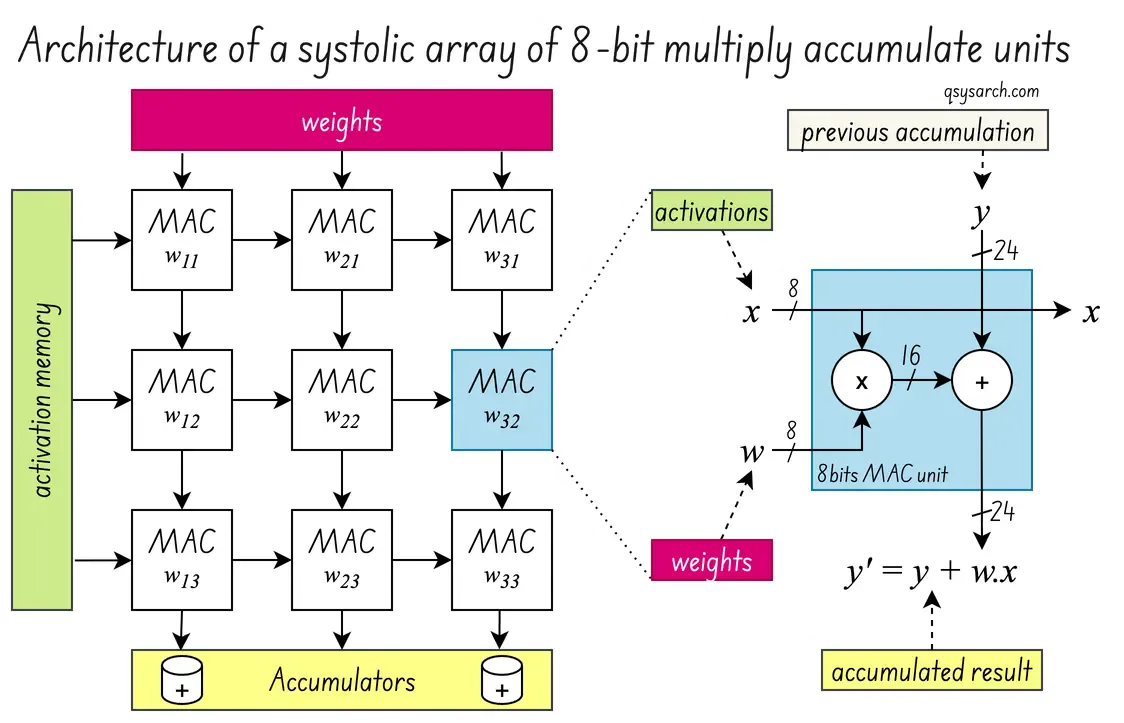
La TPU è progettata principalmente per operazioni di algebra lineare complesse, come moltiplicazioni di matrici e operazioni tensoriali, utilizzate dalle reti neurali.
Il cuore della TPU è l’array sistolico, una matrice di elementi di elaborazione (solitamente chiamata PE, indicata come MAC nello schema a destra) in grado di eseguire calcoli in parallelo.
Nel caso della TPU, questa unità di elaborazione, o MAC, è un semplice moltiplicatore a 8 bit che moltiplica e accumula i valori di attivazione (l’embedding) con i pesi della rete neurale. Solo eseguendo questa operazione in modo massivamente parallelo la TPU raggiunge una velocità di elaborazione molto superiore a quella di una CPU. E lo stesso vale per le GPU! Ma prima, diamo uno sguardo all’evoluzione della TPU nel tempo.
Evoluzione della TPU nel tempo Link to heading
TPUv1: la prima generazione di TPU Link to heading
La TPUv1 è stata sviluppata in soli 15 mesi, con l’obiettivo principale di migliorare l’inferenza delle reti neurali (non l’apprendimento, ma solo l’inferenza). Per questo, Google aveva bisogno di moltiplicatori di matrici e doveva tenere conto non solo dell’elevata velocità, ma anche della riduzione del consumo energetico. La chiave per ridurre il consumo energetico era migliorare la località della memoria, ovvero ridurre i trasferimenti di dati non necessari tra la memoria esterna e la memoria della TPU. Ciò avrebbe permesso di aumentare l’intensità aritmetica per unità di controllo, ovvero di ridurre i tempi di inattività della TPU in attesa dei dati.
Dal punto di vista hardware, il design della TPU v1 era semplice ma elegantemente efficace:
coprocessore a singolo thread su una scheda PCIe standard.
Nessuna cache multilivello, nessun multithreading, nessuna predizione di diramazione.
Calcoli matematici deterministici veloci su interi a 8 bit tramite l’unità MXU, o unità di moltiplicazione di matrici.
L’array sistolico è composto da 256 * 256 * MXU
La complessità è stata trasferita allo scheduler del software, con due responsabilità principali:
Mantenere la tubazione occupata, programmando le operazioni in modo che l’MXU non rimanga mai inattivo.
utilizzare un doppio buffer per la memoria, al fine di nascondere la latenza dell’accesso alla memoria.
TPUv2 e v3: Miglioramento della memoria e dell’interconnessione Link to heading
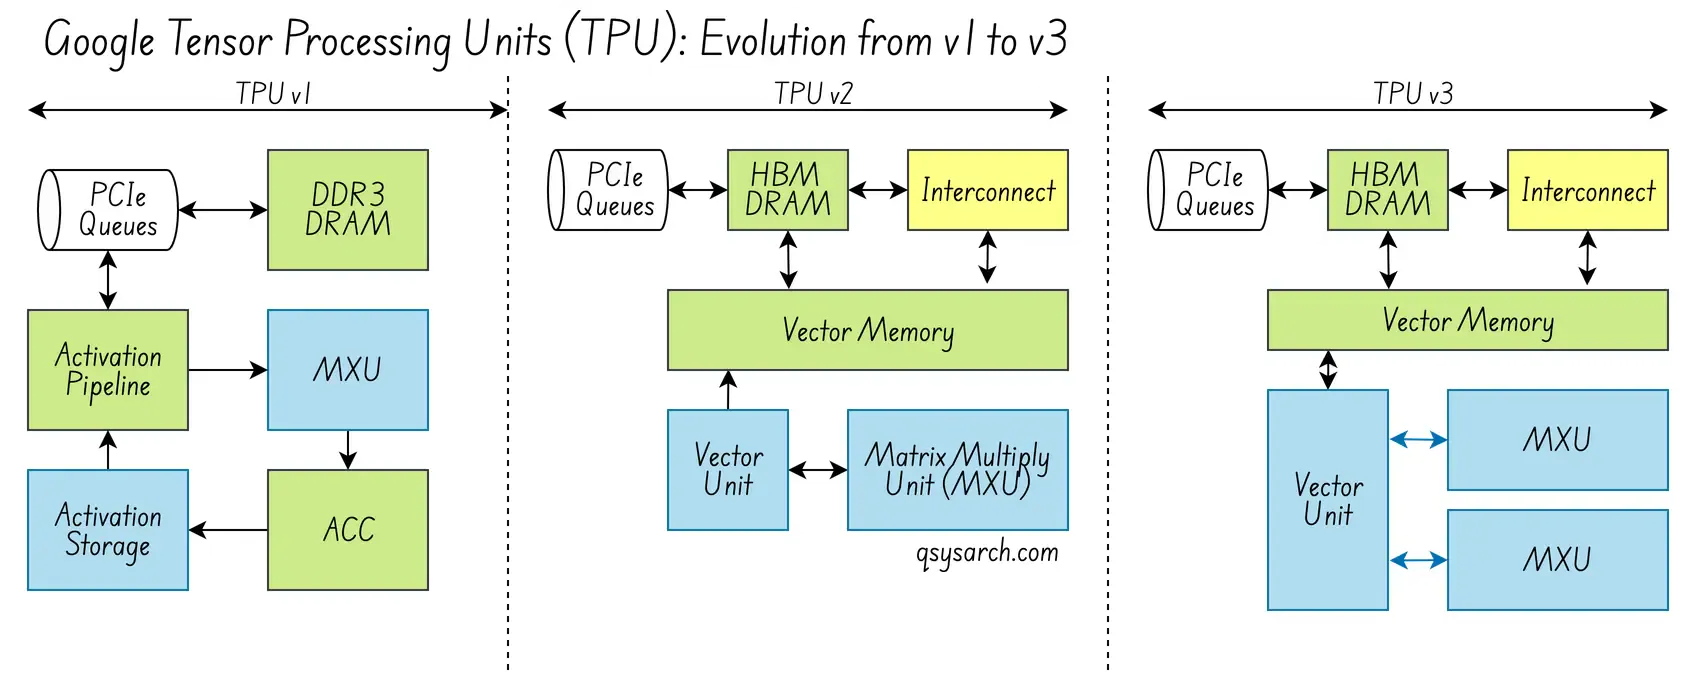
I concetti chiave delle versioni 2 e 3 riguardano l’addestramento della prossima generazione di modelli che richiedono la retropropagazione, una maggiore precisione e un numero molto maggiore di TPU distribuite e interconnesse.
Dal punto di vista dell’elaborazione del core hardware, hanno introdotto diversi concetti interessanti:
un chip dual core, ad esempio un TPUv2 è composto da due TPU
Ogni TPU aveva un array sistolico quattro volte più grande, costituito da 128*128 MXU,
Capacità di gestire valori in virgola mobile, utilizzando il formato Brain Floating Point Format (BF16), una versione migliorata del formato standard IEEE 754 FP16 in virgola mobile.
Una nuova memoria ad alta larghezza di banda (HBM) all’interno della TPU per ridurre la latenza di accesso alla memoria; (la TPUv1 ha solo una DRAM di base, con tempi di accesso lenti, mentre l’HBM è molto più veloce)
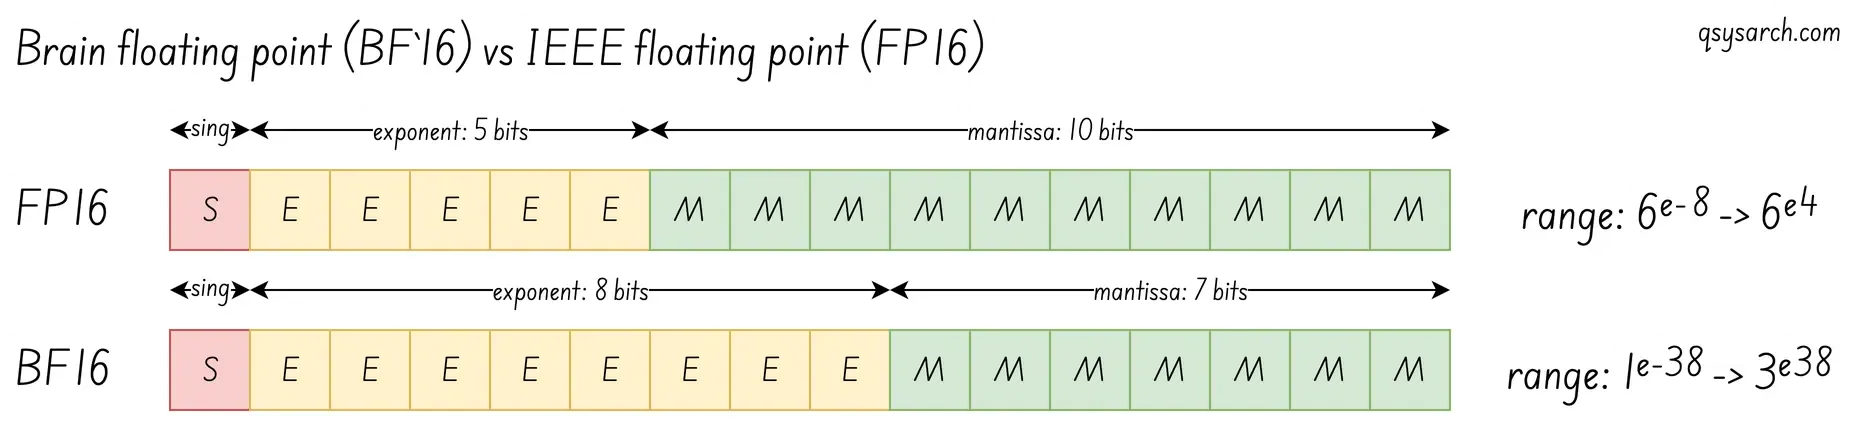
Dal punto di vista della connettività hardware,
- Un’interconnessione inter-core (ICI), la struttura ad alta larghezza di banda che consente la scalabilità, tramite una rete toroidale 2D 16x16 (rete ad anello) - Pod per supercomputer di 256 chip.
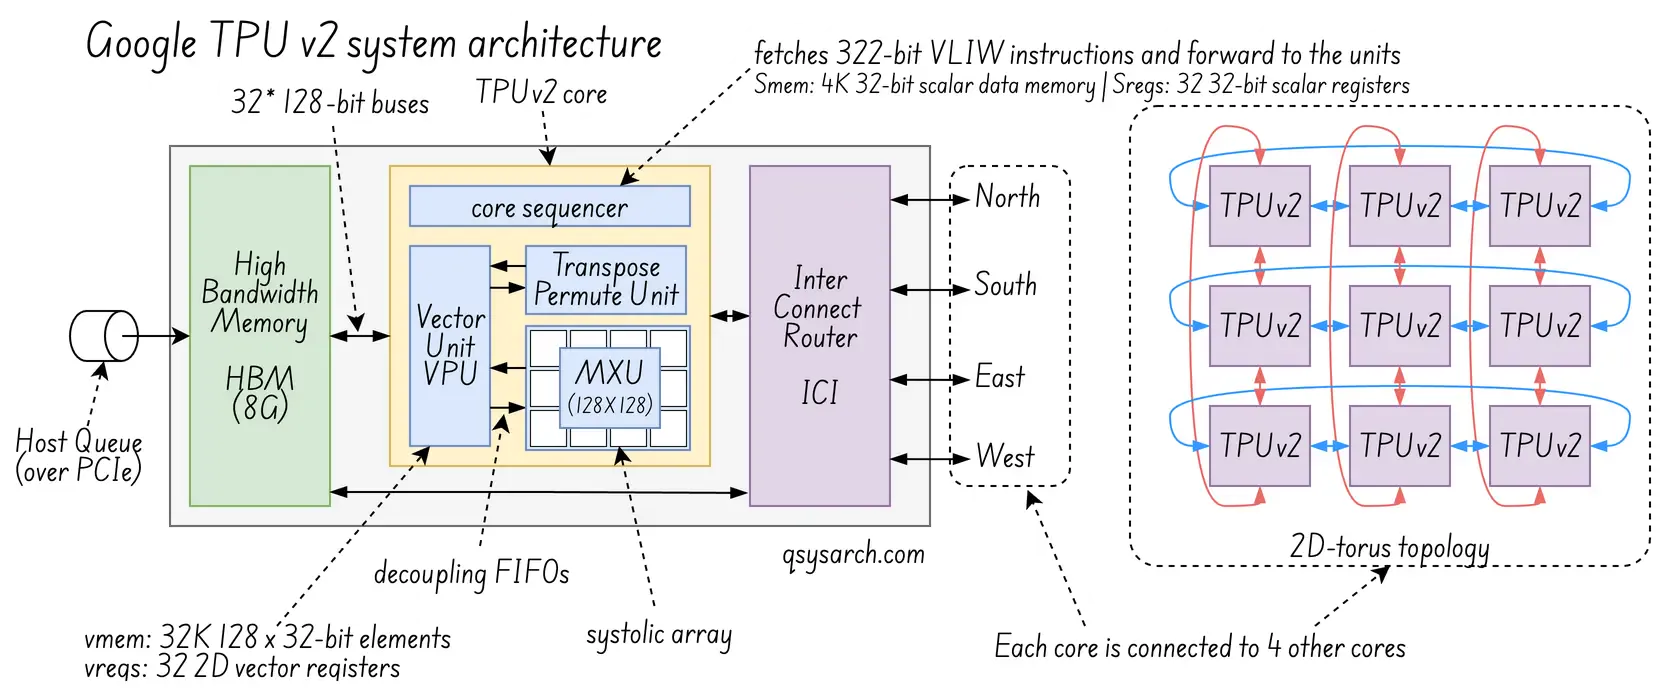
Dal punto di vista del software, un compilatore potente:
- Compilatore XLA: il cervello che genera le istruzioni VLIW utilizzate dal sequenziatore centrale (TCS).
TPUv4: Intelligenza artificiale su scala iper Link to heading
Il concetto chiave nella versione 4 era la capacità di eseguire modelli di intelligenza artificiale su scala iperscalabile. Ciò significava che la metrica determinante era il costo totale di proprietà (TCO).
Le generazioni più recenti sono progettate per l’addestramento su larga scala. I chip sono collegati in rack o moduli, con sistemi di memoria e interconnessioni avanzati. Supportano operazioni tensoriali su larga scala, addestramento distribuito, sincronizzazione e condivisione efficiente dei dati tra più chip.
Dal punto di vista dell’elaborazione del core hardware, hanno introdotto diversi concetti interessanti:
Core di riserva: impedisce che le operazioni “zero-ops” raggiungano l’MXU -> migliora l’utilizzo della memoria.
Cache di memoria: (20 volte più efficiente rispetto all’accesso alla RAM remota)
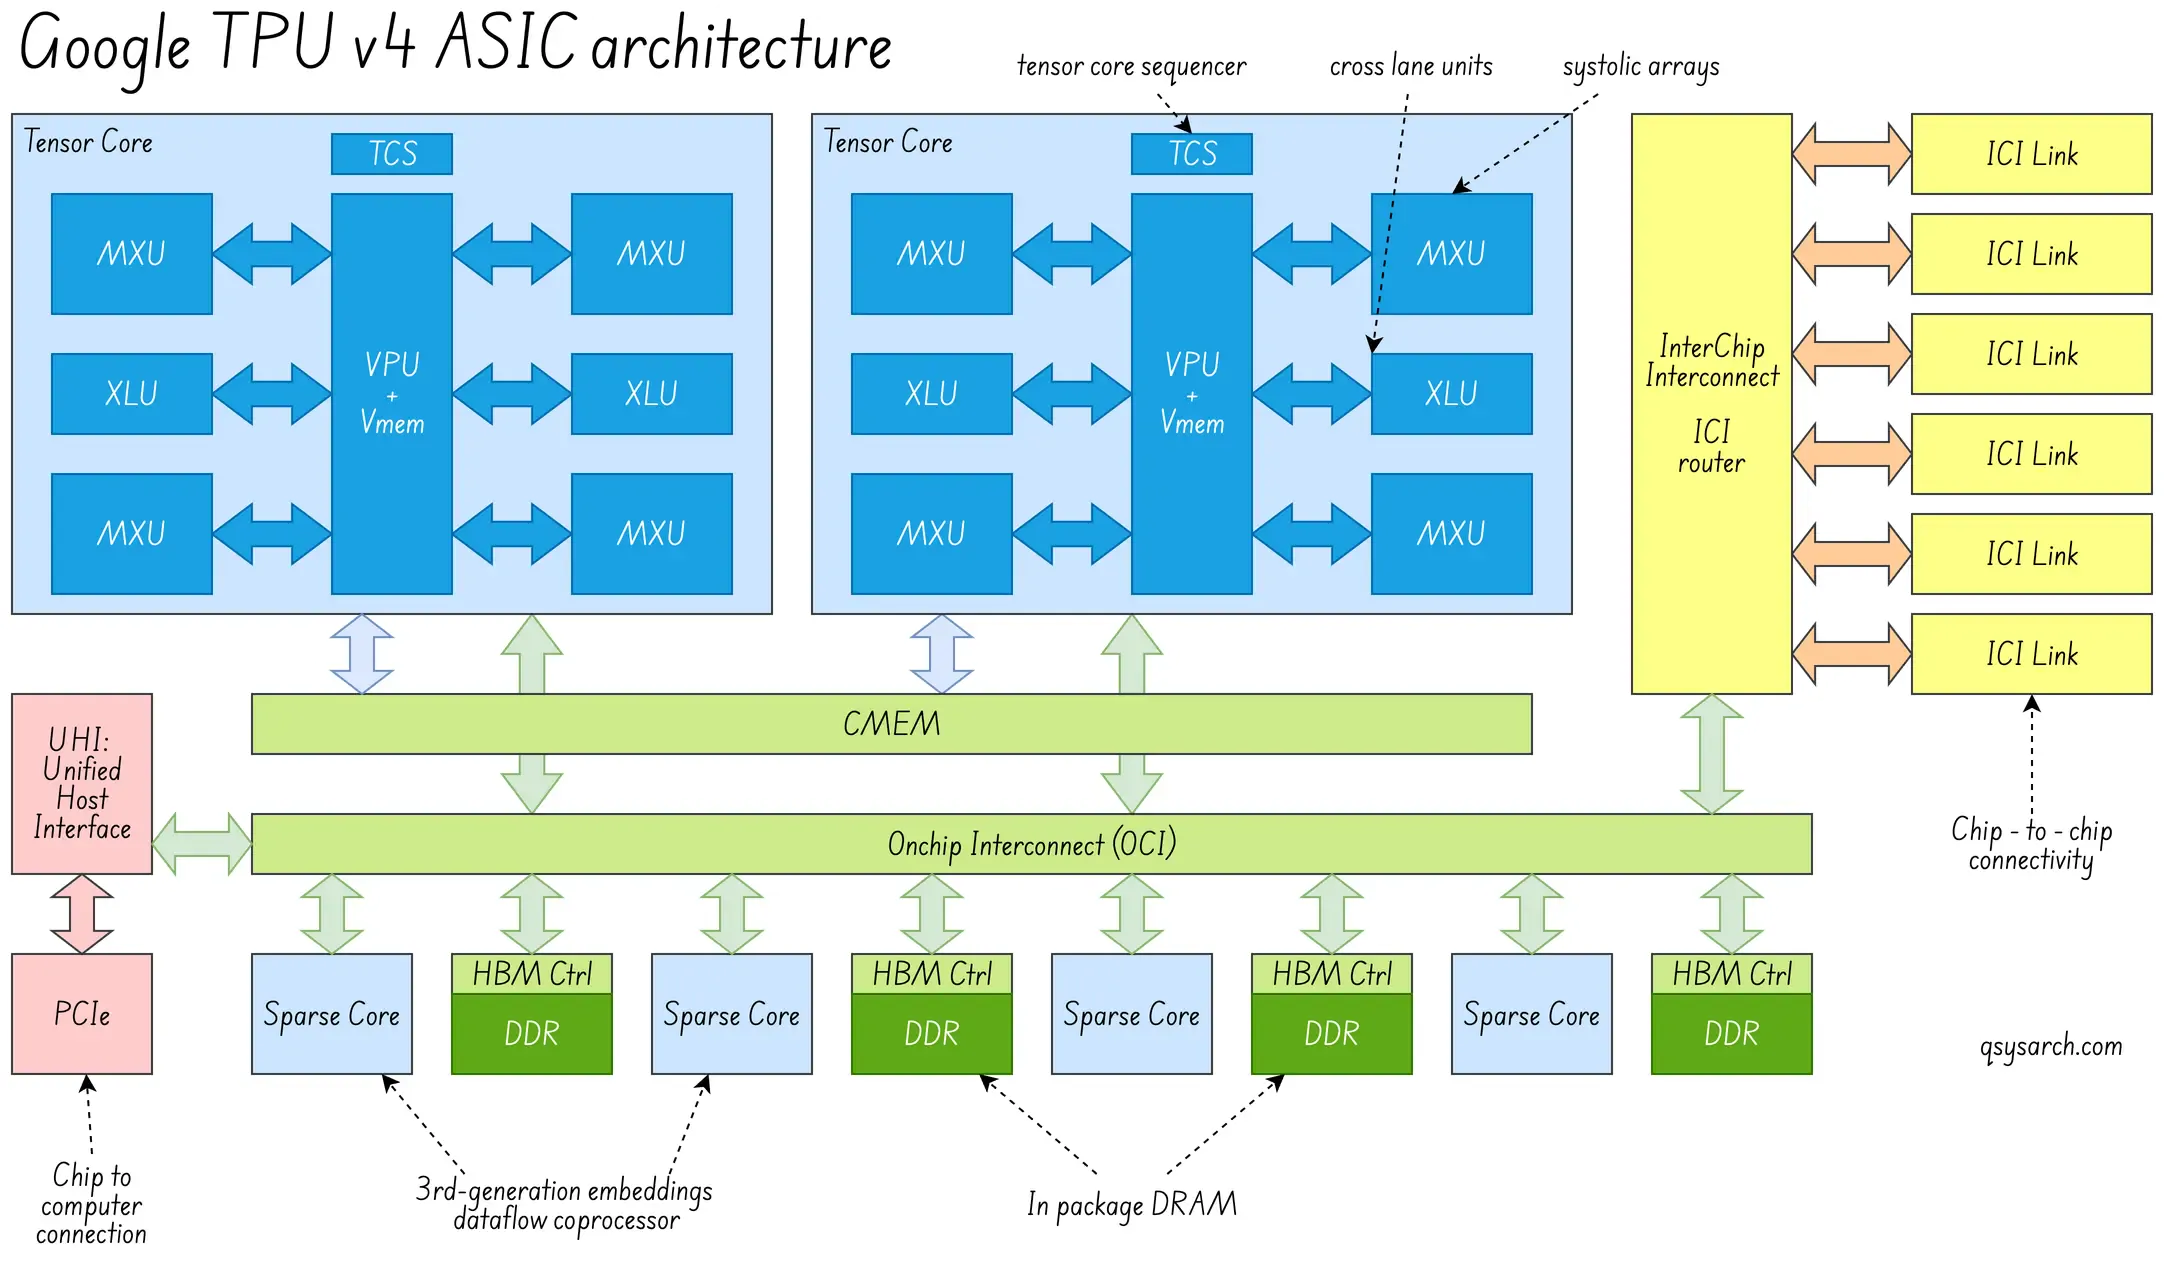
Dal punto di vista della connettività hardware,
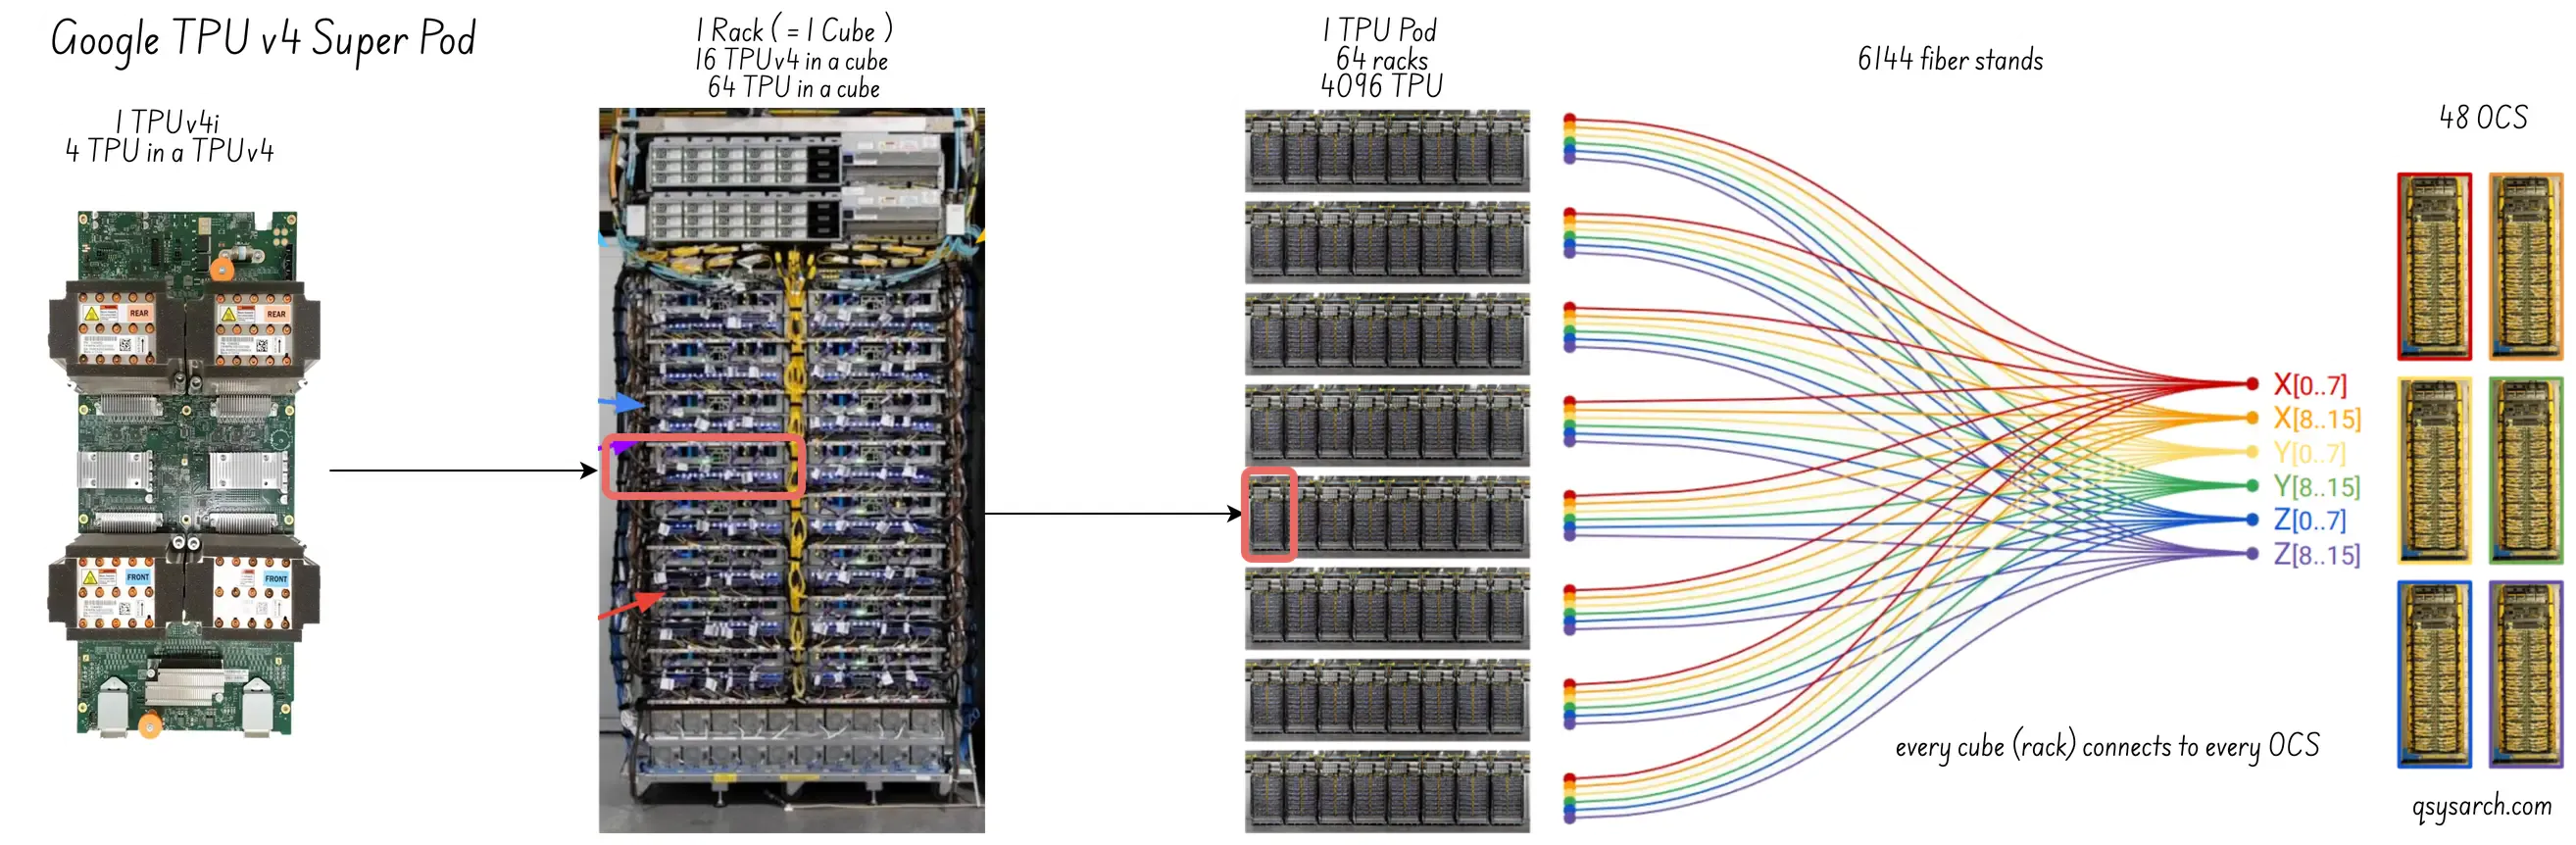
Le TPUv4, proprio come le TPUv2 e v3, utilizzano ancora un router di interconnessione (ICI), implementato come collegamento elettrico ad alta velocità tra le TPU all’interno dello stesso rack.
Tuttavia, la TPUv4 ottiene un collegamento ottico aggiuntivo tra i rack, chiamato Optical Circuit Switching, o OCS. Ciò consente di aumentare il numero di TPU in un pod a 4K (rispetto a 64 in un singolo rack), nonché di mitigare i guasti riconfigurando il routing OCS.
Infine, ma non per importanza, il routing diventa tridimensionale, grazie all’implementazione di un toro 3D, che offre il vantaggio non trascurabile di scalare l’efficienza della comunicazione in modo molto più efficace rispetto al toro 2D.
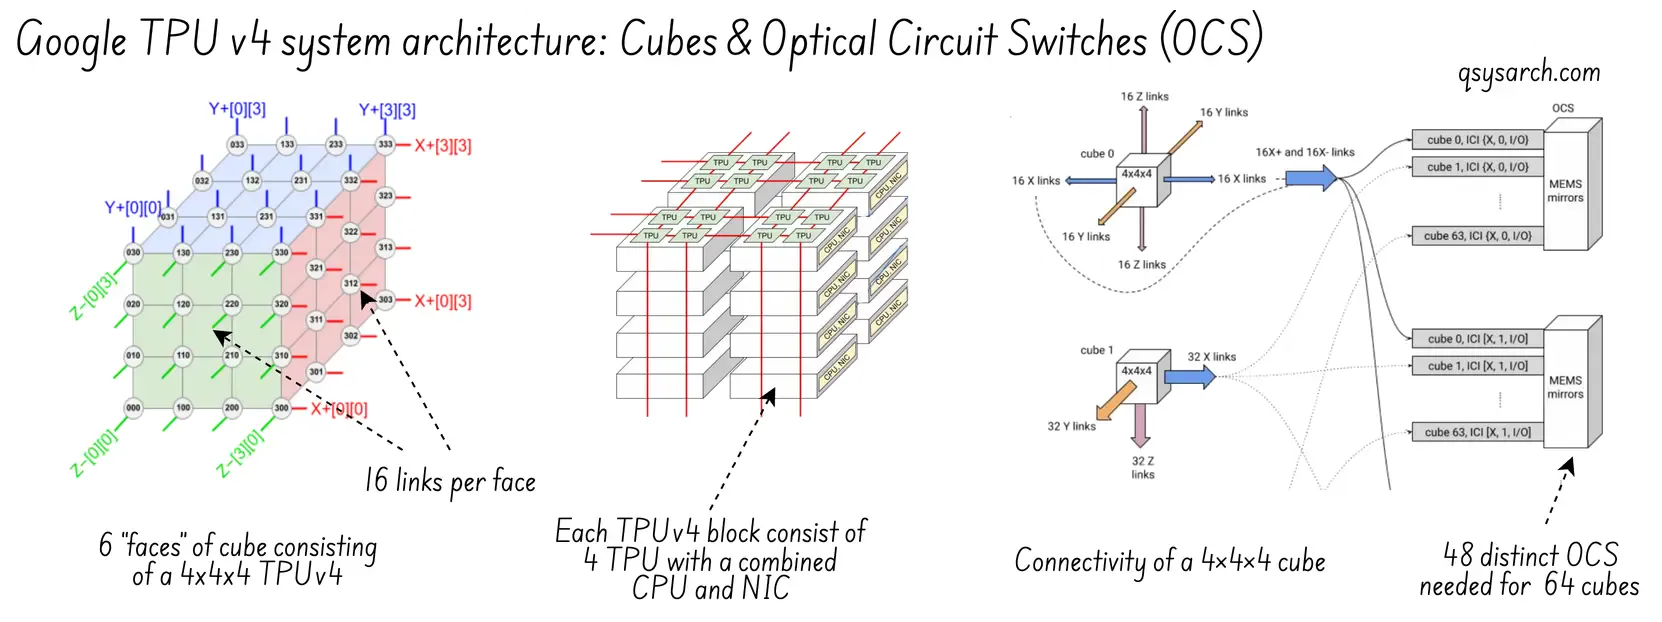
Dal punto di vista del software:
Introduzione di nuovi strumenti: Borg come gestore del cluster; gestore dei pod per configurare l’OCS; e Libpunet per impostare le tabelle di routing ICI e gestire la tolleranza ai guasti.
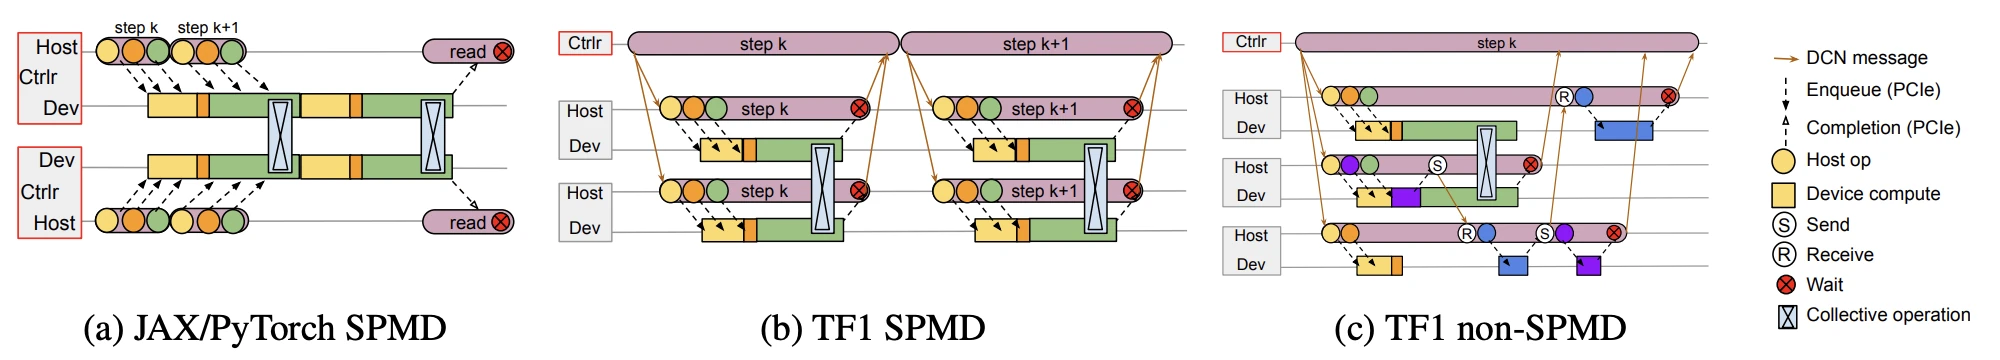
Compilatore avanzato single program multiple data (SPMD): Questo può essere visto come un compilatore che genera più thread, dove ogni thread è un programma in esecuzione su una TPU diversa all’interno dello stesso rack o meno. È in qualche modo simile al concetto SIMT della GPU, dove il compilatore genera codice per i thread all’interno di un warp della GPU.
Poiché molte TPU eseguono lo stesso programma, l’orchestratore Borg deve assicurarsi che tutte le TPU siano co-localizzate: questo è il ruolo del Gang Scheduler.
- Spiegare il concetto di “percorsi” necessari per gestire il flusso di dati asincrono per il Ministero dell’Istruzione.
Il nucleo sparso Link to heading
Il SparseCore (noto anche come SC) in TPUv4 è responsabile dell’accelerazione dei carichi di lavoro con matrici sparse, dove la maggior parte dei valori sono zeri o ridondanti (come nel caso degli embedding presenti negli LLM). Viene descritto come un ottimizzatore di “ricerca di embedding” e ogni TPUv4 include quattro processori SparseCore.
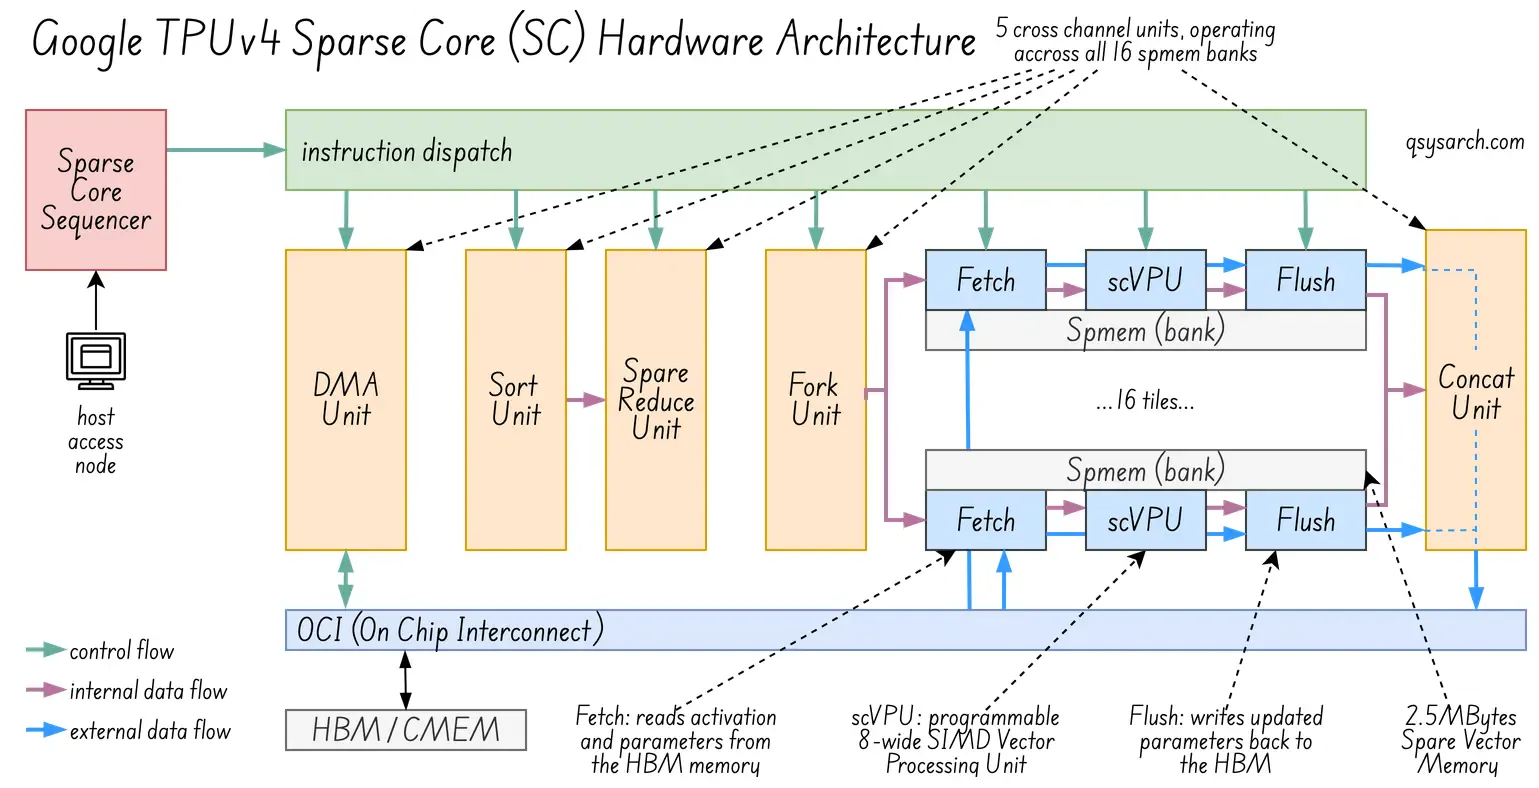 (immagine adattata dall’originale fonte immagine)
Il sequenziatore SparseCore (in rosso nell’angolo in alto a sinistra) è l’orchestratore responsabile dell’invio delle istruzioni alle 5 unità cross-channel (in arancione), nonché alle 3 unità SIMD “fetch/process/flush” (in blu). Ciascuna unità SIMD opera sulla propria memoria scratchpad strettamente accoppiata da 2,5 MB (in grigio).
Considerando che ogni unità SIMD di fetch/process/flush opera su 8 linee dati contemporaneamente (SIMD=8) e che in un processore Sparse Core sono presenti 16 di queste unità SIMD, ciò lo rende un’unità di elaborazione molto potente, quasi come una minuscola GPU all’interno della GPU! O per essere precisi, 4 minuscole GPU all’interno di una TPU!
Sarebbe davvero interessante poter dare un’occhiata all’ISA utilizzato per programmare questa potente unità di elaborazione SparseCore, ma non sono riuscito a trovare alcuna informazione online. Probabilmente perché si tratta più di un potente “computer DMA con ALU SIMD sincrona” con istruzioni così specifiche che ha senso solo fornire un’astrazione di livello superiore, come la libreria JAX.
In pratica, l’utente scrive il codice funzionale di alto livello e il compilatore XLA (Accelerated Linear Algebra) identifica i modelli che corrispondono alle capacità hardware di SparseCore.
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
    @nn.compact
    def __call__(self, indices):
        embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
        return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
Cosa succede dietro le quinte? Il metodo model.apply chiama il compilatore XLA, che riduce il codice a SparseCore. Per fare ciò, associa nn.Embed (un’operazione gather) e genera le seguenti “pseudo-istruzioni”:
Dedup: XLA rileva che 42 e 105 compaiono due volte nel tuo input. Genera istruzioni SparseCore per rimuovere i duplicati prima del recupero.
DMA: Genera le istruzioni scalari SC per calcolare gli offset di memoria per gli ID 105, 42 e 28.
Push: Sposta il tensore risultante 5*128 nella memoria comune (CMEM).
Il compilatore XLA deve anche occuparsi del posizionamento dei dati. In particolare, poiché lo Sparse Core dovrà accedere agli indici nn.Embed, questi devono essere posizionati in una memoria accessibile dallo Sparse Core. Potrebbe posizionarli nella CMEM, ma questa è piuttosto piccola (128 MB), quindi di solito posiziona l’embedding nella grande HBM (32 GB per TPUv4). L’output dell’elaborazione dello Sparse Core viene tuttavia riposizionato nella CMEM, poiché rappresenta solo una porzione dei dati.
Vale anche la pena notare che l’architettura SparseCore si è evoluta nelle successive generazioni v6+.
Il mix di esperti e i percorsi del Ministero dell’Istruzione Link to heading
Il Mix di Esperti (MoE), a differenza dei modelli convenzionali…
Il concetto di percorsi si riferisce ai percorsi fisici e logici che i token seguono quando vengono suddivisi tra esperti residenti su diversi chip TPU.
 (
Dal 2023 in poi: v5, v6 (Trillum) e v7 (Ironwood) Link to heading
Non ci sono molte informazioni disponibili sulle nuove generazioni, quindi questi sono i fari principali:
v5e: 16 GiB di HBM3e per chip;
v5p: 95 GiB HBM3e per chip;
v6: 32 GiB HBM3e per chip; prestazioni BF16 migliorate
v7: 192 GiB HBM3e; Nuova precisione FP8
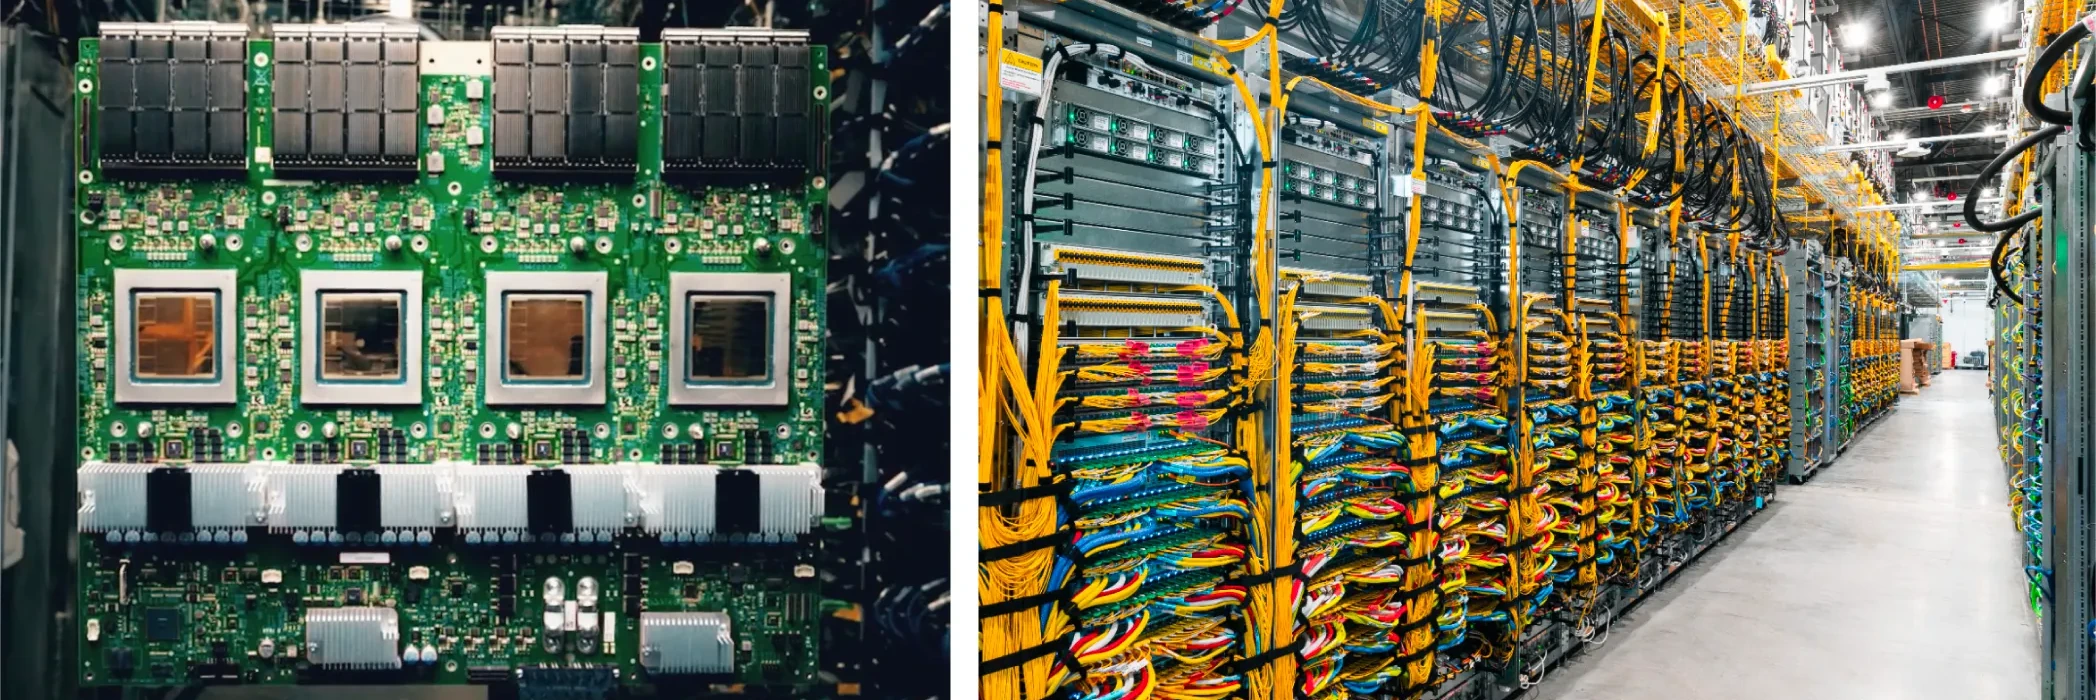
Con Ironwood v7, un super pod è composto da circa 9.000 TPU.
Quindi, perché abbiamo ancora bisogno delle GPU se abbiamo le TPU? Link to heading
Il design della TPU, che bilancia memoria, potenza di calcolo, consumo energetico e comunicazione dati, dimostra che la creazione di sistemi di intelligenza artificiale ad alte prestazioni su larga scala non si limita alla semplice disponibilità di chip veloci. Richiede anche il coordinamento tra hardware, software, sistemi e connessioni di rete.
Elaborazione dei pixel vs elaborazione delle matrici Link to heading
Sebbene i carichi di lavoro dell’IA siano oggi più vari, includendo inferenza, addestramento, modelli sparsi e sistemi di raccomandazione, le TPU non sono progettate per elaborare i pixel. Le GPU, tuttavia, non sono popolari oggi perché Nvidia ha reso disponibile un modello di programmazione e un’esperienza di sviluppo che hanno permesso alle GPU di comportarsi come una TPU.
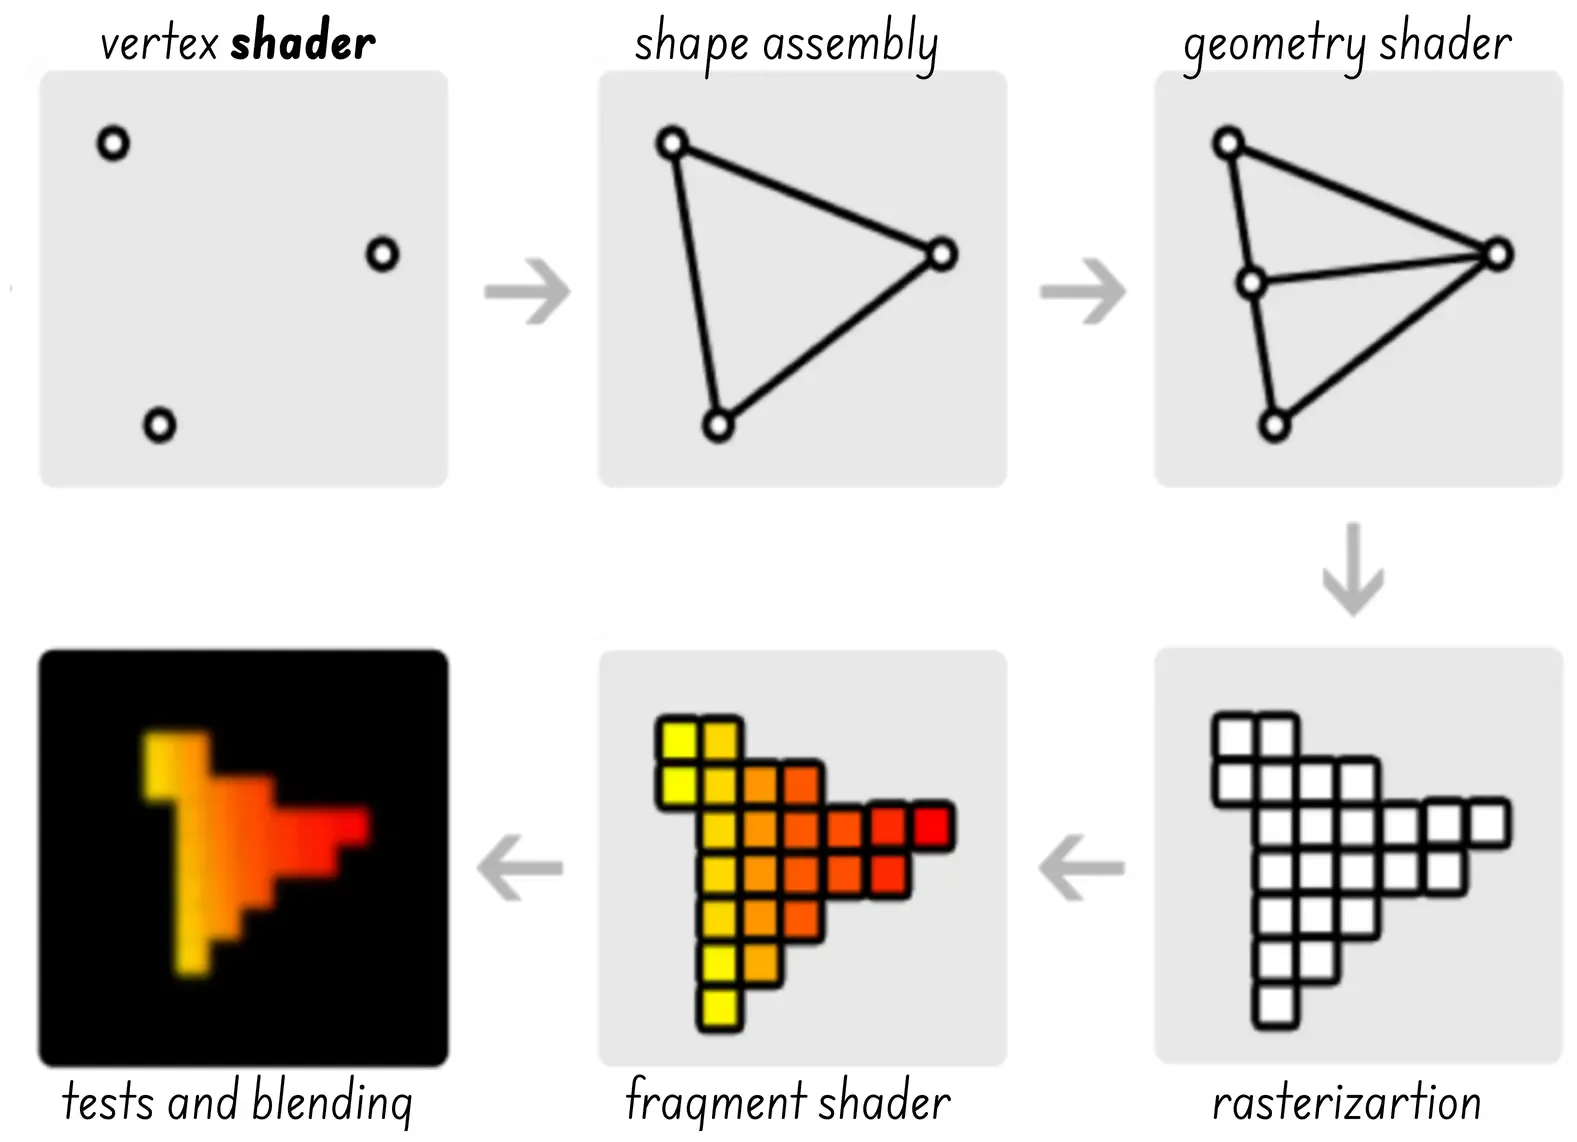
Questo significa che le GPU sono superiori? Non necessariamente: in presenza di carichi di lavoro molto specifici, le TPU possono essere più efficienti delle GPU, soprattutto in termini di consumo energetico e prestazioni per watt. E nel mondo in cui viviamo, dove i data center per l’IA consumano sempre più energia, le TPU potrebbero fare la differenza.
Che dire dei circuiti integrati neuromorfici analogici? Link to heading
E che dire dei circuiti integrati neuromorfici? Rispetto alle TPU, puntano a un consumo energetico ancora inferiore grazie all’utilizzo del calcolo analogico e dell’elaborazione event-driven a bassa frequenza. Cosa servirà perché i circuiti integrati neuromorfici diventino di uso comune e raggiungano la stessa diffusione dei super pod TPUv7?
Una delle sfide che devo ancora affrontare è comprendere meglio il consumo energetico relativo dell’array sistolico (MXU + Spares Core) rispetto al resto della TPU (inclusi ICI, OCI, TCS) e come questo rapporto si confronti con quello della rete neurale neuromorfica Spiking Neural Network (SNN) rispetto alla logica di controllo (RiscV e Spike copro).
Inoltre, se i circuiti integrati neuromorfici dovessero raggiungere le dimensioni delle TPUv7, probabilmente richiederebbero un livello di investimento simile in software, sistemi e connessioni di rete. In caso contrario, si potrebbe considerare di collegare una SNN a una TPU e utilizzare la “logica di controllo” della TPU per gestire la comunicazione tra la SNN e il resto della TPU/Rack/Pad. Ma c’è davvero bisogno di questo? Quale problema stiamo risolvendo? Forse è necessario ripensare il proprio approccio.
Ritorno al futuro: l’unità di elaborazione del linguaggio Link to heading
Questo promemoria non sarebbe completo senza menzionare la Language Processing Unit, un nuovo tipo di processore progettato per ottimizzare l’inferenza di modelli linguistici di grandi dimensioni.
Dovrò creare un promemoria dedicato a questo singolo argomento, quindi per ora questo è solo un confronto di alto livello, nel tentativo di capire se l’LPU sia qualcosa di più di una semplice reinvenzione della TPUv1, che era focalizzata solo sull’inferenza e non sull’addestramento.
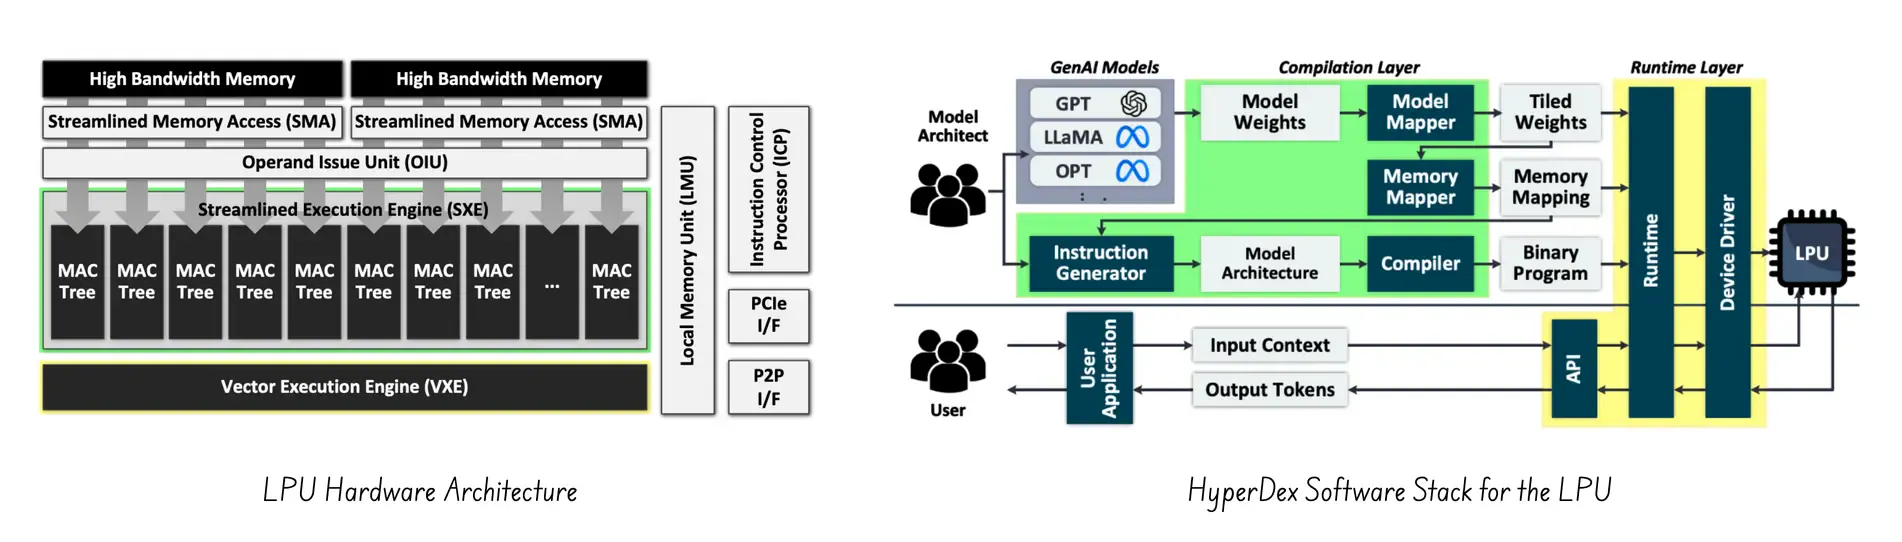
A un livello generale, sì, TPU e LPU condividono la necessità di svolgere alcune operazioni in modo molto efficiente e su larga scala, utilizzando un’architettura specifica per il dominio (DSA). Ma quando si tratta di implementazione e ottimizzazione specifiche, l’LPU è una bestia molto diversa, con un focus diverso.
La differenza principale è che TPUv1 è stato progettato prima ancora che esistesse LLM (ricordiamo che la prima versione di ChatGPT risale al 2022) ed era focalizzato sull’inferenza generale delle reti neurali profonde (DNN). Ciò significava garantire throughput e prestazioni per watt per operazioni massive e ad alto volume, implementate tramite un array sistolico MXU sottostante.
L’LPU, d’altro canto, è progettato per ottimizzare l’inferenza di modelli linguistici di grandi dimensioni (LLM). Il suo obiettivo è migliorare la latenza per token. Per questo, necessita di un’architettura ISA che supporti un’architettura multi-pipeline basata su VLIW, completamente deterministica e con pianificazione statica. Certo, si potrebbe obiettare che la TPUv4 introduce un’architettura ISA VLIW simile per il TCS. Ma la differenza principale è che l’architettura ISA dell’LPU è una macchina VLIW completamente deterministica, in cui ogni operazione di caricamento, calcolo e memorizzazione è pianificata ciclo per ciclo. Mentre per la TPU, l’MXU è un array sistolico “autogestito”.
Conclusion Link to heading
Ecco, questo è un breve promemoria che, ancora una volta, ha richiesto più tempo del previsto. Ciò che emerge chiaramente da questa analisi approfondita è che l’evoluzione dell’architettura TPU dimostra come la progettazione di acceleratori AI sia un compito complesso che richiede di bilanciare molti fattori.
Il design della TPU, che bilancia memoria, potenza di calcolo, consumo energetico e comunicazione dati, dimostra che la creazione di sistemi di intelligenza artificiale ad alte prestazioni su larga scala non si limita alla semplice disponibilità di chip veloci. Richiede anche il coordinamento tra hardware, software, sistemi e connessioni di rete.
Si ha un po’ la sensazione di un déjà vu. Che la Quantum Processing Unit (QPU) rappresenti il prossimo passo nell’evoluzione degli acceleratori di intelligenza artificiale?
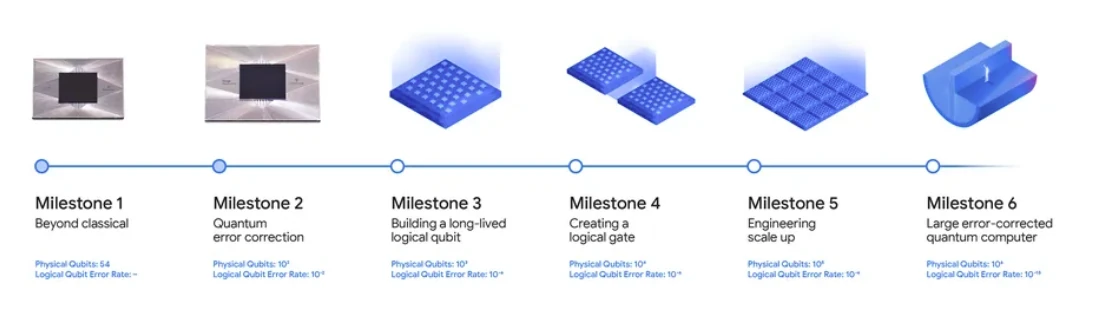 (fonte immagine: Google Willow)
References Link to heading
- An in-depth look at Google’s first Tensor Processing Unit (TPU)
- Touching the Elephant - TPUs: Understanding the Tensor Processing Unit
- TPU Architecture: Complete Guide to Google’s 7 Generations
- Tensor Processing Unit
- Why Google’s TPU Could Beat NVIDIA’s GPU in the Long Run
- LPU: A Latency-Optimized and Highly Scalable Processor for Large Language Model Inference
- TPUv2: A DomainSpecific Supercomputer for Training Deep Neural Networks
- TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings
- A Machine Learning Supercomputer With An Optically Reconfigurable Interconnect and Embeddings Support
- Resiliency at Scale: Managing Google’s TPUv4 Machine Learning Supercomputer
- TPU deep dive
- Ten Lessons From Three Generations Shaped Google’s TPUv4i
- How to Think About TPUs
- Google’s AI Processor’s (TPU) Heart Throbbing Inspiration
- Tensor Processor Unit (TPU)
- Raytracing & GLSL
DrawIO diagrams used in this memo:


