
Nel contesto delle GPU, sono numerosi i termini alla base della tecnologia RDMA: GPU-direct, NvLink, NVLink Fusion, InfiniBand, Quantum InfiniBand, GPUNetIO e DOCA. Questo può generare confusione, ma forse non dovrebbe essere così?
Questo articolo è scritto sotto forma di promemoria personale, nel tentativo di illustrare le diverse tecnologie e visualizzarle con l’ausilio di alcuni diagrammi.
GPU Direct e RDMA: Marketing contro Tecnologia. Link to heading
Iniziamo in medias-res, con la pagina GPUNetIO della documentazione ufficiale di Nvidia:
Si noti che l’acronimo RDMA descrive il protocollo che consente l’accesso diretto remoto alla memoria da un computer all’altro senza coinvolgere il sistema operativo di nessuno dei due. … Non deve essere confuso con GPUDirect RDMA, che non è correlato al protocollo RDMA.
Chiaro, quindi GPUDirect RDMA non è la stessa cosa del protocollo RDMA! Ma GPUDirect RDMA utilizza almeno il protocollo RDMA? Spero di sì; altrimenti, sarebbe davvero fonte di confusione.
GPUDirect RDMA è una delle tecnologie abilitate da NVIDIA nella famiglia di tecnologie GPUDirect. Consente alla scheda di rete di inviare o ricevere dati accedendo direttamente alla memoria della GPU, bypassando le copie di memoria della CPU e le routine del sistema operativo. GPUDirect RDMA può essere abilitato da qualsiasi framework di rete che utilizzi Ethernet, InfiniBand o RoCE.
Ok, almeno questo è chiaro: GPUDirect RDMA può essere implementato su qualsiasi livello di trasporto, che si tratti di Ethernet (ETH) o InfiniBand (IB). Ma cos’è GPUNetIO e qual è la sua relazione con RDMA? La risposta è semplice. GPUNetIO, come suggerisce il nome, è un’implementazione di rete di GPU Direct RDMA su una scheda di rete. Questo non significa che GPU Direct debba essere gestito da una scheda di rete, ma solo che GPUNetIO è una versione specializzata per quel tipo di scheda di rete.
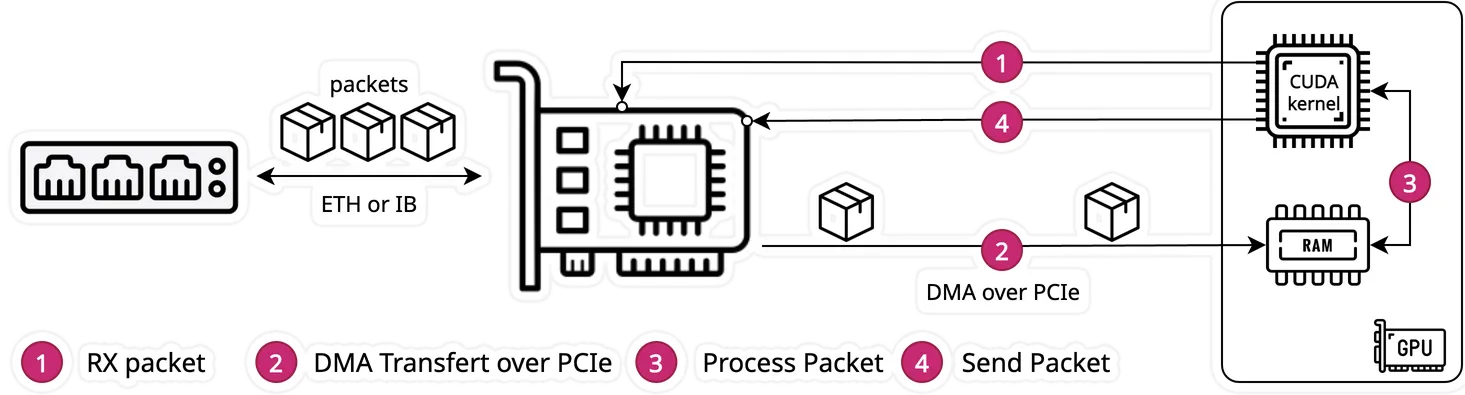
Nel diagramma sopra riportato nella documentazione, il riquadro “CUDA” è un po’ fuorviante. Presumo si tratti di un kernel in esecuzione sulla GPU, ma verifichiamo cosa dice la documentazione:
Gli approcci tradizionali spesso si basano su un modello incentrato sulla CPU, in cui la CPU si coordina con la scheda di rete per ricevere i pacchetti nella memoria della GPU utilizzando GPUDirect RDMA. Successivamente, la CPU notifica a un kernel CUDA sulla GPU di elaborare i pacchetti. … DOCA GPUNetIO affronta questa sfida offrendo una soluzione incentrata sulla GPU che elimina la CPU dal percorso critico.
Per me, questo non è ancora del tutto chiaro: si afferma che il percorso critico è “centrato sulla GPU”, ma qual è il percorso critico? Si tratta dei passaggi da (1) a (4) menzionati nel diagramma? E a cosa serve ancora la CPU? Per trovare la risposta, dobbiamo esaminare la modalità “Async Kernel-Initiated”, descritta come la possibilità per “un kernel CUDA GPU di controllare le comunicazioni di rete per inviare o ricevere dati”. GPUDirect IKA abilita:
La GPU può controllare le comunicazioni Ethernet (Ethernet/IP/UDP/TCP/ICMP)
La GPU può controllare le comunicazioni RDMA (sono supportati InfiniBand o RoCE)
L’intervento della CPU non è necessario nel percorso critico dell’applicazione
Quindi, questo è chiaro al 100%:
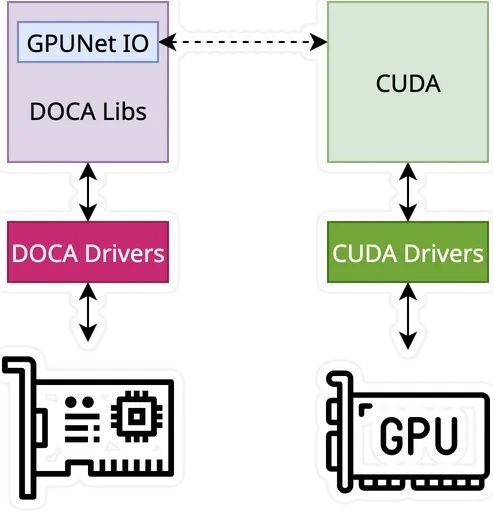
GPU Direct RDMA “consente trasferimenti diretti di dati da/verso la memoria GPU senza copie intermedie nella CPU.
GPU Direct AKI offre alla GPU la possibilità di “controllare” la scheda di rete.
GPUNetIO è un componente software che gestisce sia la tecnologia GPU Direct RDMA che la tecnologia AKI.
DOCA è l’SDK che Nvidia fornisce per programmare hardware compatibile con GPUNetIO (tra gli altri).
Suppongo che la confusione derivi dal fatto che “AKI” dovrebbe essere indicato come “GPU Direct RDMA + AKI”, poiché integra la funzionalità RDMA che consente di bypassare la CPU.
Interconnessione GPU RDMA Link to heading
Ora sappiamo che GPU Direct RDMA, commercializzato da Nvidia con il nome di GPUNetIO, è una soluzione basata su scheda di rete (NIC) che collega la GPU alla NIC tramite una connessione PCIe. Analizziamo nel dettaglio questa connessione PCIe, tralasciamo la parte relativa a GPUNetIO e concentriamoci nuovamente sulla parte RDMA:
Nella documentazione ufficiale di CUDA GPUDirect RDMA (https://docs.nvidia.com/cuda/gpudirect-rdma/index.html), si afferma che l’unico requisito è un root complex PCIe:
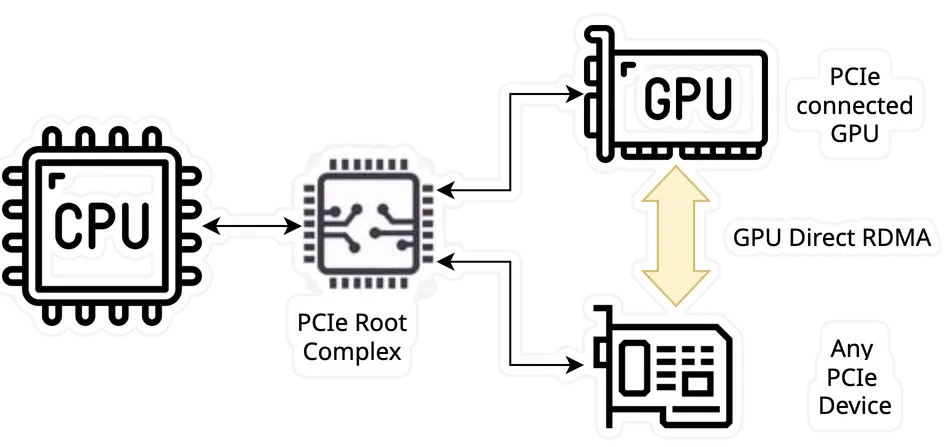
GPUDirect RDMA è una tecnologia introdotta nelle GPU di classe Kepler e CUDA 5.0 che consente un percorso diretto per lo scambio di dati tra la GPU e un dispositivo di terze parti utilizzando le funzionalità standard di PCI Express. …. Possono essere applicate alcune limitazioni, la più importante delle quali è che i due dispositivi devono condividere lo stesso root complex PCI Express upstream.
GPUDirect RDMA è una soluzione che consente a qualsiasi dispositivo PCIe di comunicare direttamente con la GPU, a condizione che si trovi nello stesso root complex. Quindi, sebbene sia principalmente “commercializzata e venduta” da Nvidia come soluzione in cui il dispositivo PCIe è una scheda di rete, potrebbe trattarsi di qualsiasi scheda PCIe, ad esempio una scheda PCIe per webcam ad alta velocità. È interessante, ma cerchiamo di capire come funziona.
Quando si configura la comunicazione GPUDirect RDMA tra due dispositivi peer, tutti gli indirizzi fisici sono identici dal punto di vista dei dispositivi PCI Express. All’interno di questo spazio di indirizzi fisici si trovano finestre lineari chiamate BAR PCI. Ogni dispositivo ha al massimo sei registri BAR, quindi può avere fino a sei regioni BAR attive a 32 bit. Le BAR a 64 bit occupano due registri BAR. Il dispositivo PCI Express esegue operazioni di lettura e scrittura sugli indirizzi BAR di un dispositivo peer nello stesso modo in cui vengono eseguite sulla memoria di sistema.
Tradizionalmente, risorse come le finestre BAR vengono mappate nello spazio degli indirizzi utente o del kernel utilizzando la MMU della CPU come indirizzi di I/O mappati in memoria (MMIO). Tuttavia, poiché i sistemi operativi attuali non dispongono di meccanismi sufficienti per lo scambio di regioni MMIO tra i driver, il driver del kernel NVIDIA esporta funzioni per eseguire le necessarie traduzioni e mappature degli indirizzi.
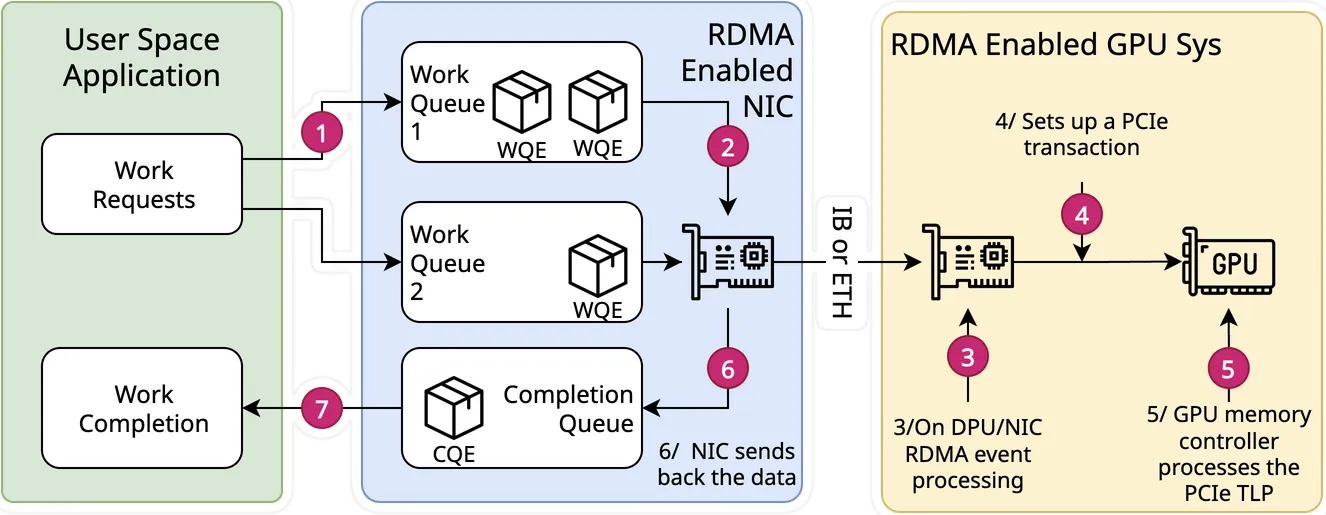
Ciò che può generare confusione è che il termine “DMA” potrebbe sembrare più appropriato rispetto a “RDMA” quando si considera un sistema intra-PCIe che collega dispositivi eterogenei. Ma è proprio questo il punto. DMA è la soluzione per trasferire i dati, mentre RDMA, sopra menzionato, è il protocollo utilizzato per dare semantica ai dati trasferiti, tramite verbi. Quindi, DMA in realtà corrisponde solo ai passaggi (4) e (5) nello schema sottostante, mentre il protocollo RDMA nell’hardware sul lato ricevente corrisponde solo al passaggio (3).
Un aspetto da notare, Nvidia chiarisce che non si tratta di una cosa semplice, quindi, per ottenere le migliori prestazioni, è probabilmente meglio utilizzare una piattaforma di test nota:
Sebbene l’unico requisito teorico per il funzionamento di GPUDirect RDMA tra un dispositivo di terze parti e una GPU NVIDIA sia la condivisione dello stesso root complex, esistono bug (principalmente nei chipset) che ne compromettono le prestazioni o ne impediscono completamente il funzionamento in determinate configurazioni.
Livello di trasporto Link to heading
Esiste ancora una certa confusione terminologica, in particolare tra Ethernet, InfiniBand e RoCE: il fatto che RoCE sia basato su Ethernet.

Il rivenditore InfiniBand descrive in termini semplici come un’evoluzione, rappresentata nel diagramma sopra. Si noti che ho volutamente usato il nome “100G + PFC” invece della menzione originale “DCB” (nota anche come Data Center Bridging). Se ho capito bene, DCB è un superset di PFC (noto anche come priority flow control), e l’idea è di dire che affinché DCB/PFC funzioni, è necessaria un’infrastruttura di rete, inclusi gli switch, per implementare queste tecnologie. Altrimenti, si torna alla categoria Ethernet.
E per quanto riguarda NVLink? Link to heading
Questo promemoria non sarebbe completo senza un riferimento a NVLink. La domanda immediata è se NVLink e InfiniBand siano la stessa cosa o in qualche modo correlati. In breve, sono complementari, non concorrenti.

NVLink: Comunicazione veloce tra nodi (all’interno di un server, tra GPU).
InfiniBand: Comunicazione veloce tra nodi (tra server in un cluster)
Nel diagramma a destra, è chiaro che le frecce verdi vengono utilizzate per interconnettere le GPU tra loro. La connessione tra le schede di rete, invece, è di tipo InfiniBand.
È interessante notare che NVLink è integrato nell’hardware Nvidia e non esposto all’esterno, a differenza dei connettori InfiniBand, come mostrato nel diagramma sottostante. Si noti che Quantum InfiniBand X800 è un dispositivo estremamente potente, con collegamenti a 800 Gb/s e fotonica al silicio integrata, ma non ha nulla a che vedere con il calcolo quantistico.
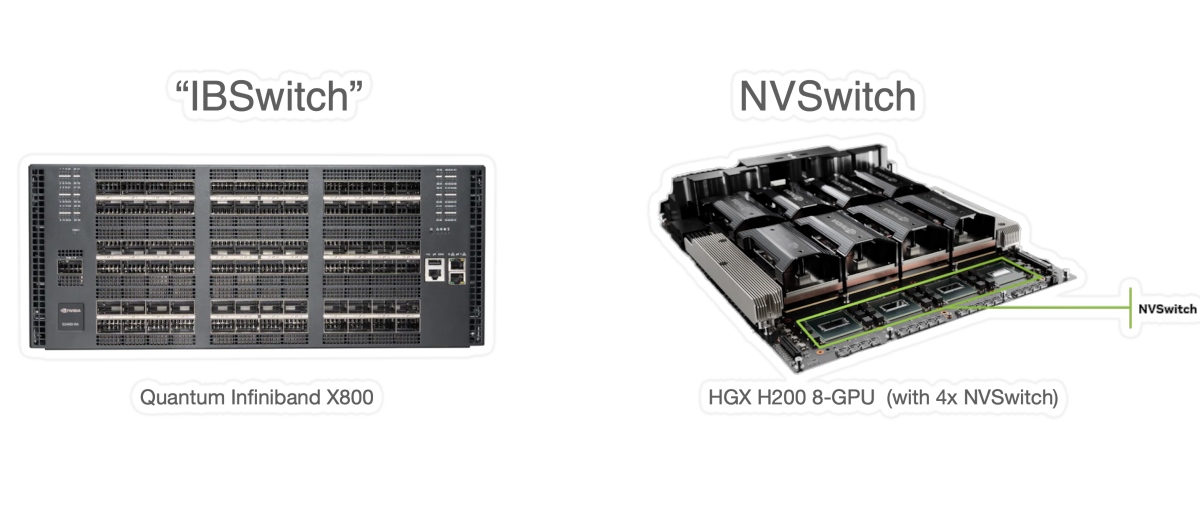
Un ultimo punto degno di nota: Nvidia ha introdotto NVlink Fusion come soluzione per rendere aperto lo standard NVLink. Quindi, probabilmente domani vedremo integrazioni personalizzate, che forse richiederanno ancora un PCB come “switch” (anziché un cavo), ma con un SoC, che potrebbe non essere un SoC Nvidia. Vale anche la pena ricordare che AMD ha risposto allo standard Nvidia introducendo UALink.
Riepilogo Link to heading
In sintesi, RDMA non è poi così complesso:
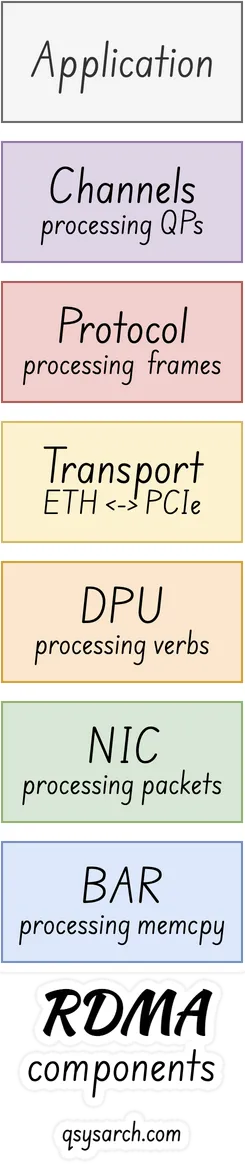
RDMA BAR: come mappatura BAR PCIe: A livello fisico, è presente un dispositivo PCIe che si connette alla GPU tramite lo stesso complesso radice PCIe e mappa la BAR di memoria di tutti i dispositivi.
Scheda di rete RDMA: come scheda di rete hardware (NIC): Questa scheda PCIe è solitamente una scheda di rete, ma non è obbligatorio. Tuttavia, sembra esserci solo una scheda di rete sul mercato con funzionalità RDMA.
RMDA DPU: come processore di verbi in-HW: Per rendere la scheda PCIe conforme a RDMA, l’hardware deve essere in grado di elaborare i verbi RDMA direttamente nell’hardware, solitamente utilizzando un processore chiamato DPU.
Trasporto RDMA: come livello di trasporto per il collegamento di rete: Il dispositivo PCIe è esposto, sul lato rete, come un trasporto che può essere Ethernet, Better Ethernet (RoCev2) e Infiniband.
Protocollo RDMA: come formato del frame: Il protocollo utilizzato per comunicare sul collegamento di rete è anche chiamato RDMA - non ho esaminato i dettagli del formato del frame, ma è presente in RFC5040
Canali RDMA: come metodo di comunicazione tramite QP: Il software/driver/SDK utilizzato sull’host per comunicare con il dispositivo RDMA è anch’esso chiamato RDMA, ma è definito come Queue Paris e Canali.
Ecco fatto. Credo di aver capito un po’ meglio RDMA adesso.
Conclusion Link to heading
Tornando alla sfida del calcolo quantistico, la domanda è: perché dovremmo interessarci all’RDMA? Beh, perché Nvidia ha chiamato il suo switch InfiniBand “Quantum InfiniBand”!
Eppure, nonostante il loro ultimo Quantum-X800 sia una bestia, non ha nulla a che fare con il calcolo quantistico. Ma forse potrebbe giocare un ruolo chiave nell’interconnettere il controllo quantistico alla GPU, per la sfida dell’apprendimento per rinforzo?