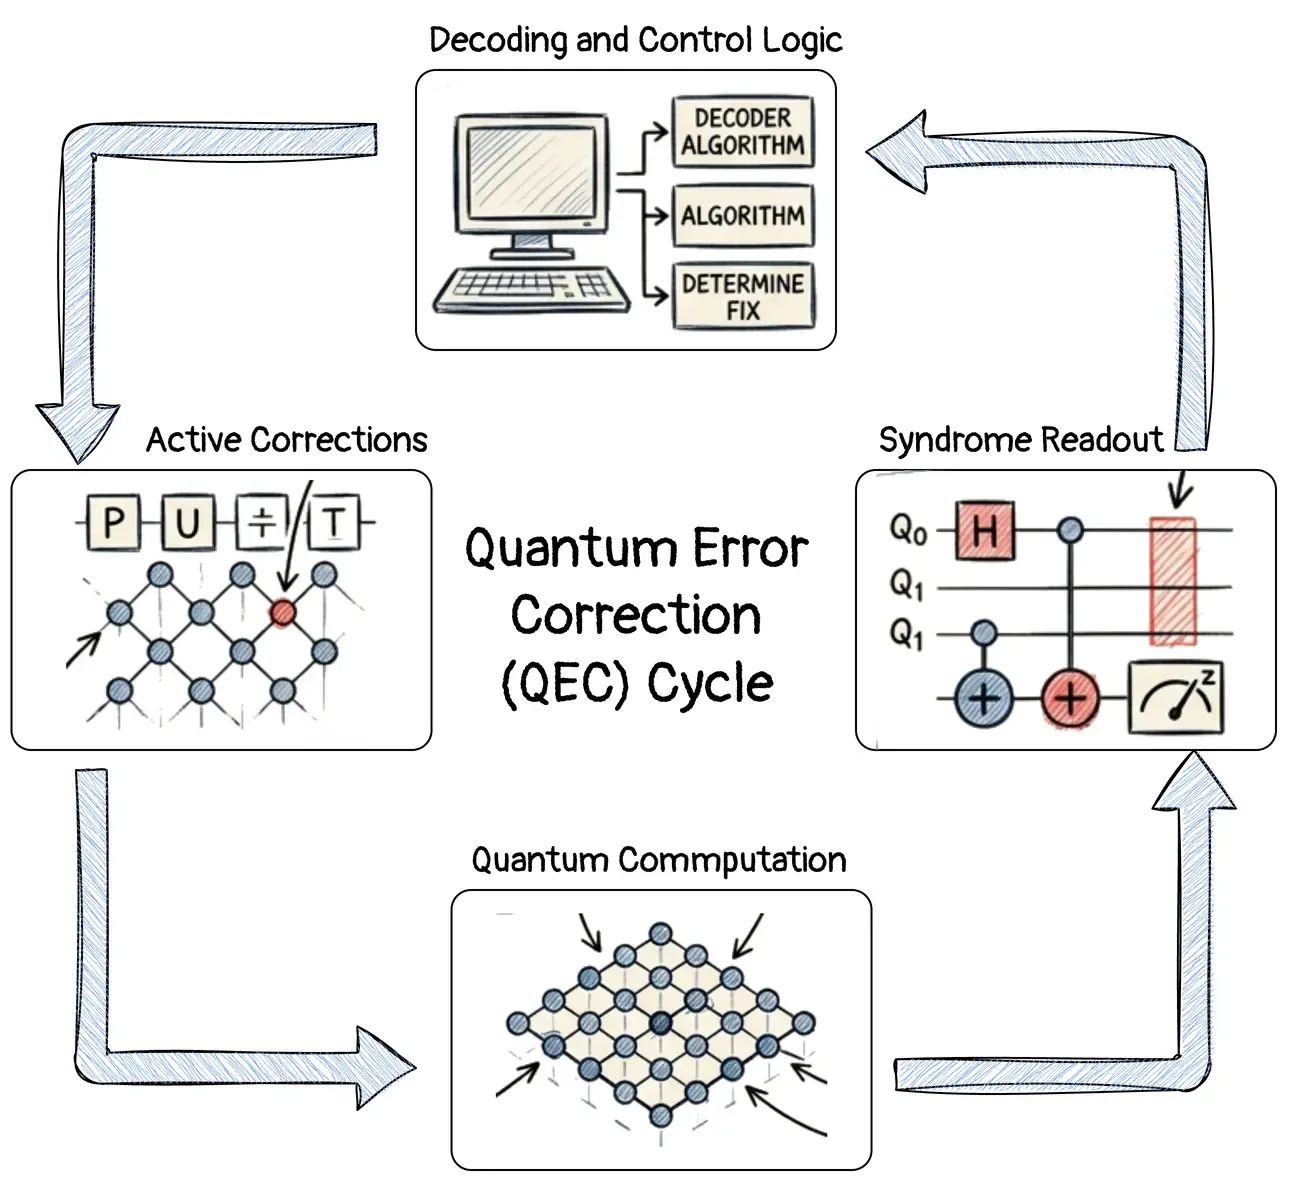
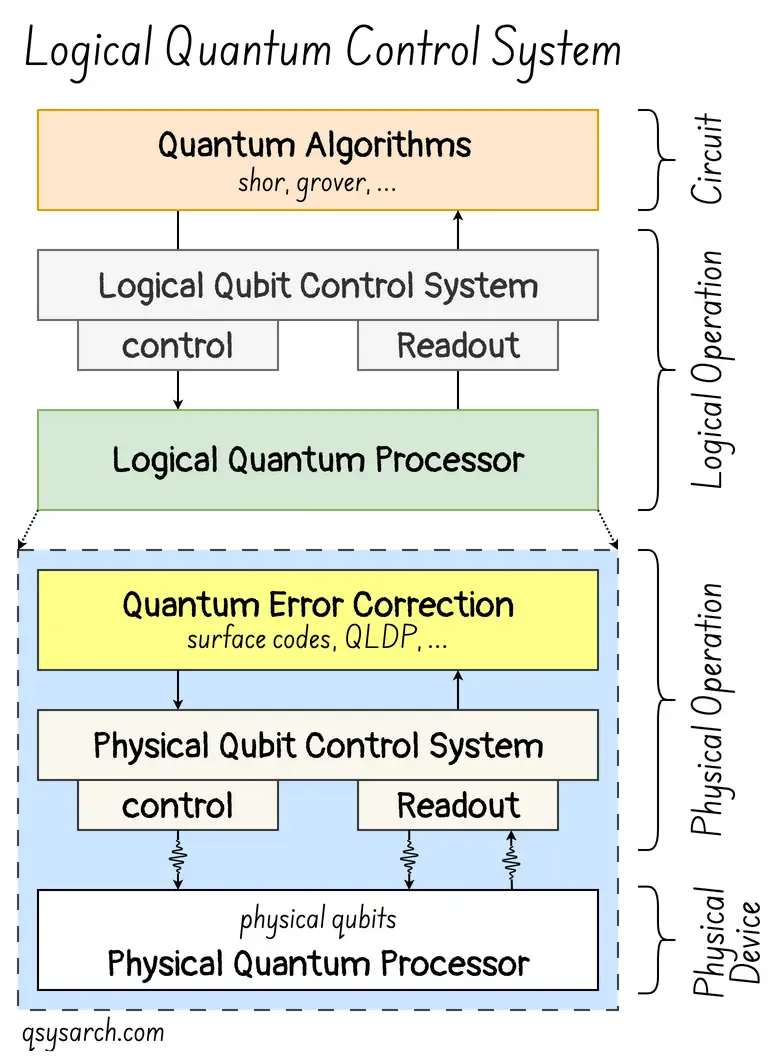
A prima vista, la correzione degli errori quantistici sembra semplice: raggruppare i qubit fisici in un qubit logico, applicare un metodo per mantenere la coerenza tra di essi e quindi far funzionare i circuiti quantistici utilizzando questi qubit logici.
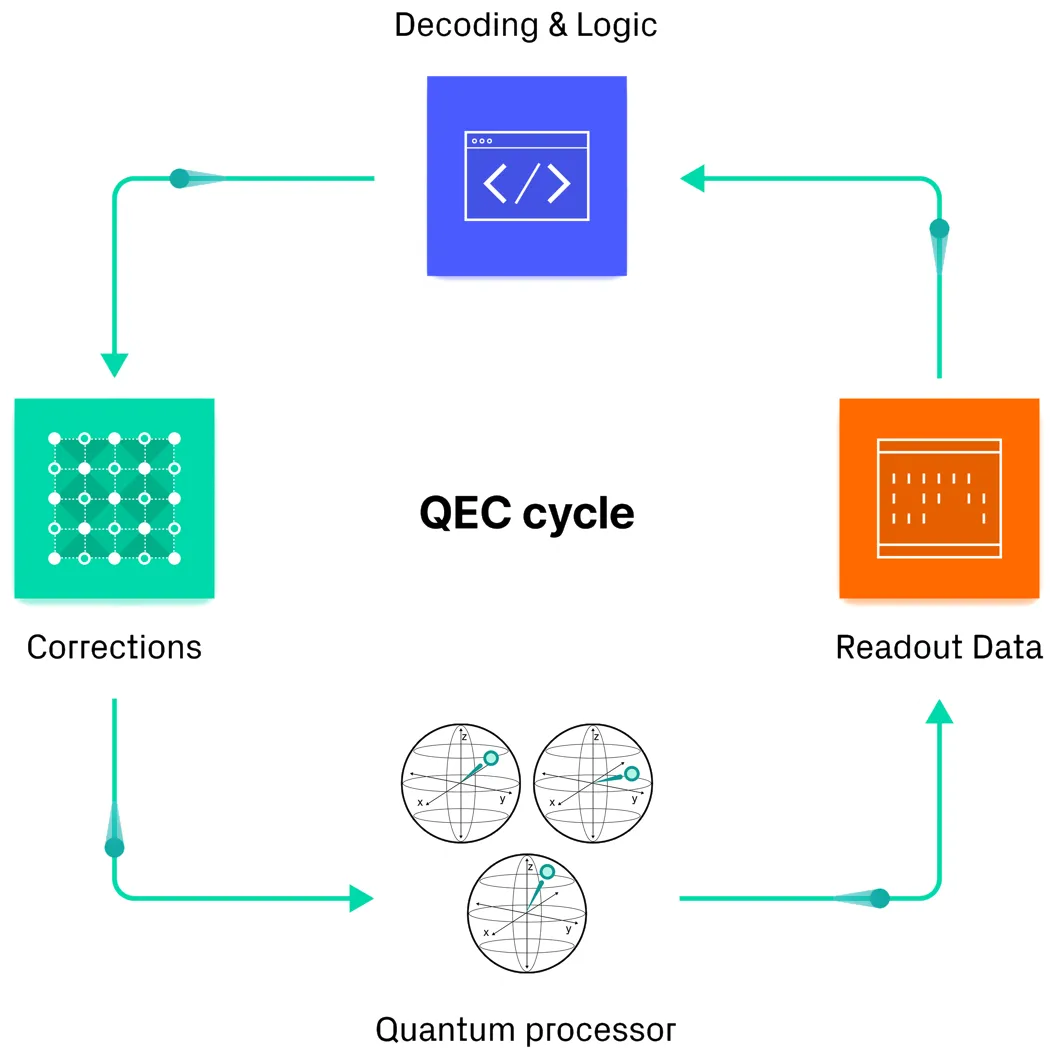 Fonte immagine: Riverlane
In pratica, però, questo primo passo è tutt’altro che ovvio. Come si creano e si mantengono questi qubit logici? Ad esempio, dal punto di vista di un Sistema di Controllo Quantistico (QCS) (come QM OPX1000, ZQCS di ZI ZQCS o Qblox Q1 Cluster), cosa serve per “gestire” o “orchestrare” il qubit logico? E una volta che questo qubit logico è “pronto” per essere utilizzato, cosa serve per impiegarlo nell’esecuzione di calcoli quantistici, tramite circuiti quantistici composti da porte a 1 e 2 qubit? Questa semplice domanda non riguarda solo il sistema di controllo hardware, ma anche lo stack software, in particolare i compilatori: abbiamo ora più compilatori, uno per i qubit fisici e uno per i qubit logici? E in termini di scalabilità, cosa serve ai compilatori per gestire la complessità di scalabilità quando si tratta di gestire 10.000 qubit fisici in un ambiente eterogeneo composto da GPU/QPU ibride e QCS? Sono domande semplici, con risposte tutt’altro che banali!
Questo promemoria è il primo di una serie sulla correzione degli errori quantistici dal punto di vista dei sistemi di controllo quantistici. Questo primo breve promemoria introduce i concetti di base necessari per “creare” un qubit logico coerente a livello fisico.
Formazione di qubit logici Link to heading
Cosa definisce un “qubit logico”? La creazione di qubit logici inizia con il raggruppamento di qubit fisici, a ciascuno dei quali viene assegnato un ruolo specifico. Alcuni fungono da qubit ausiliari o di supporto, mentre altri funzionano come qubit dati o principali.
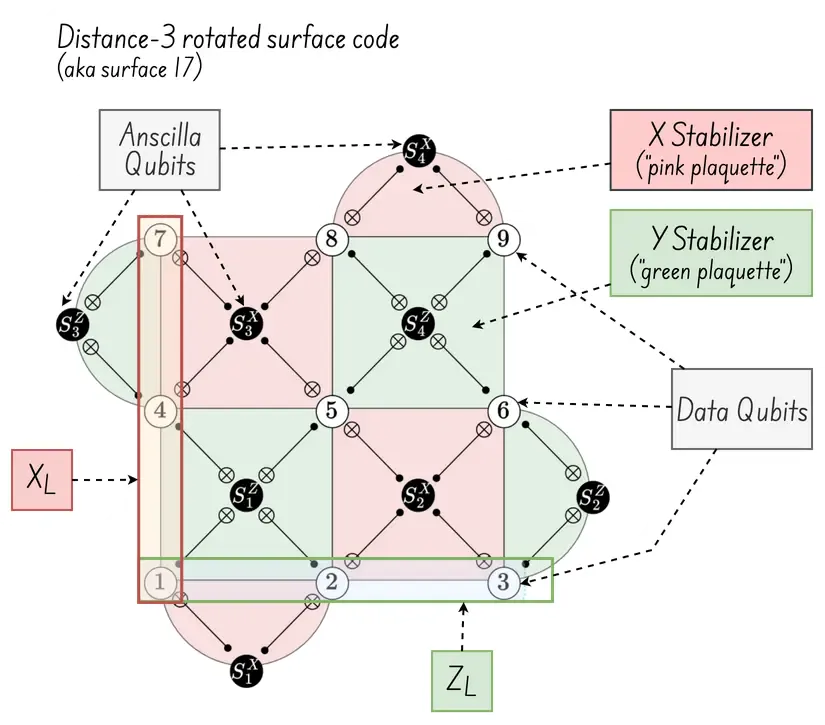
Questo raggruppamento è spesso rappresentato dal diagramma a destra, che mostra un “Codice di superficie 17 basato sulla distanza 3” (immagine di riferimento: Irréversible Inc).
Ecco la struttura di base, applicabile ai codici di superficie:
I qubit di dati (cerchi bianchi) contengono le informazioni quantistiche. La superficie 17 contiene 9 qubit di dati.
I qubit ausiliari (cerchi neri) eseguono controlli di parità non distruttivi. La superficie 17 contiene 8 qubit ausiliari.
QEC come protocollo Link to heading
L’interazione tra i dati e i qubit ausiliari è specifica per ogni “placca”:
Le targhette (facce verdi e rosa) definiscono la relazione tipologica di controllo degli errori tra il qubit ausiliario al centro e i suoi qubit dati vicini.
Lo stabilizzatore: Ogni qubit ausiliario viene utilizzato per misurare un operatore di Pauli, o stabilizzatore: i codici di superficie hanno due stabilizzatori: quelli di tipo Z rilevano gli errori di inversione di bit (X), mentre quelli di tipo X rilevano gli errori di inversione di fase (Z).
La misura dello stabilizzatore consiste nella misurazione di un singolo stabilizzatore, implementata accoppiando sequenzialmente un qubit ausiliario ai qubit dati adiacenti e quindi misurando l’ausiliario.
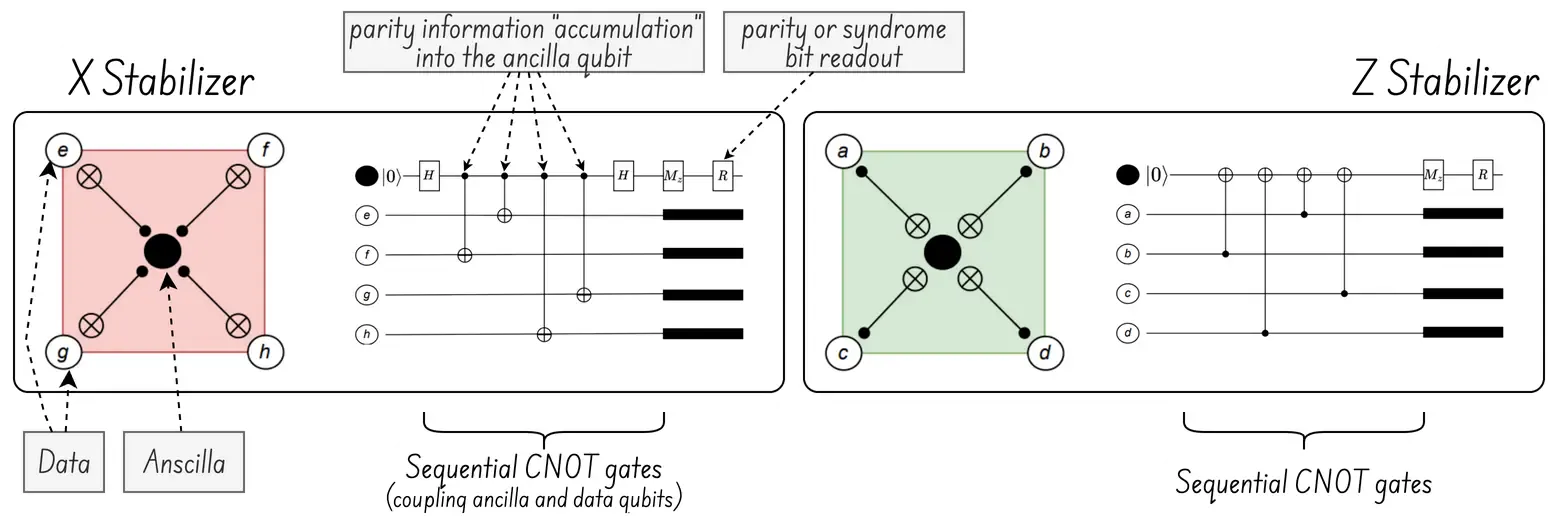
I bit di sindrome sono il risultato della misurazione dello stabilizzatore di controllo di parità operatore. I bit di sindrome vengono prodotti uno per ogni ciclo di misurazione.
L’estrazione della sindrome è il processo completo di esecuzione di tutte le misurazioni dello stabilizzatore in un ciclo di correzione degli errori per ottenere la sindrome di errore completa.
Un piccolo quiz: chi è il qubit colpevole? Link to heading
In questo contesto, si consideri il diagramma seguente (fonte: Laurent Prost da Alice & Bob). Z 1 Z 2 e Z 2 Z 3 rappresentano rispettivamente le misurazioni congiunte di controllo di parità (stabilizzatore) tra il Qubit 1 e il Qubit 2, e tra il Qubit 2 e il Qubit 3. A differenza delle precedenti plaquette bidimensionali, questo diagramma presuppone che ogni qubit fisico sia collegato a un solo altro qubit, indicando un codice di ripetizione unidimensionale.
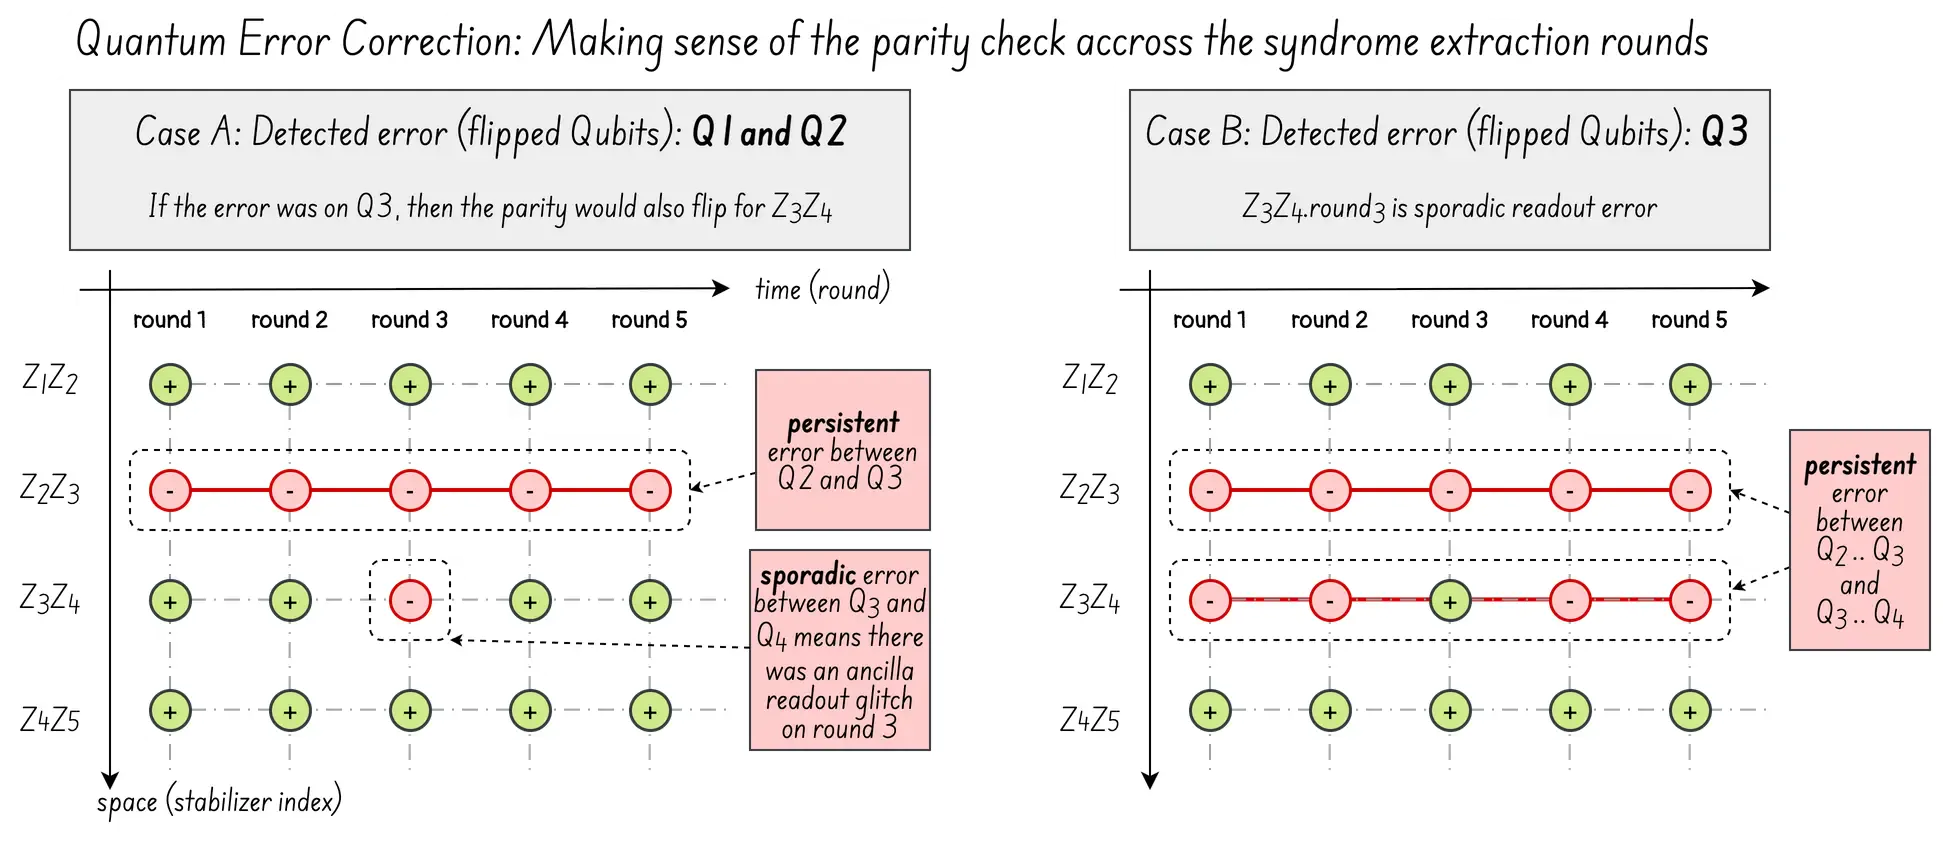
Nel diagramma a sinistra (caso A), sembra che l’errore sia sul qubit dati 3, ma in realtà indica errori sui qubit dati 1 e 2. La linea orizzontale rossa mostra che l’errore si verifica solo in Z 2 Z 3. Se l’errore fosse sul qubit 3, anche Z 3 Z 4 si invertirebbe. Pertanto, Z 1 Z 2 rappresenta un errore di tipo bizantino, il che significa che sia Q1 che Q2 si sono invertiti. Il diagramma a destra (caso B) mostra il risultato atteso se l’errore fosse sul qubit 3.
Dietro le quinte: la “magia” del QEC Link to heading
Questa seconda sezione è un po’ più complessa, ma è fondamentale per comprendere i successivi promemoria sull’orchestrazione dei qubit fisici all’interno di un gruppo logico. Cerco di renderla il più accessibile possibile, evitando di addentrarmi nei dettagli matematici più complessi, che i miei colleghi del QEC saprebbero spiegare molto meglio!
Muri di dominio ed errori degenerati Link to heading
L’errore bizantino Q1 + Q2 è in realtà una sfida comune chiamata errore degenerato. Nello specifico, si riferisce a una situazione in cui due o più errori fisicamente distinti producono esattamente lo stesso bit di sindrome, nel qual caso diventa impossibile distinguere gli errori.
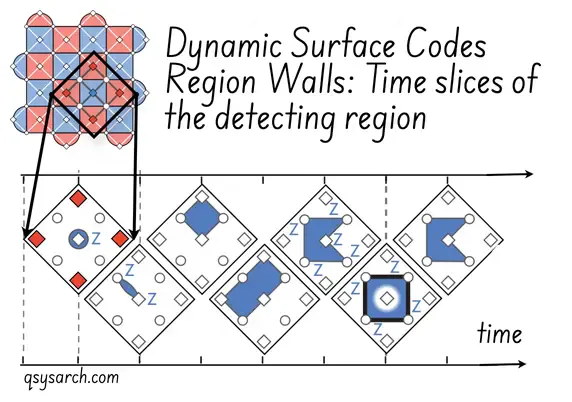 Ma questo non è un problema in QEC: gli stabilizzatori non vengono utilizzati per rilevare direttamente gli errori. Invece, gli stabilizzatori vengono utilizzati per identificare i confini fisici del qubit (noti anche come pareti di dominio) in cui reagisce una sindrome di errore. Quindi, aumentando la ridondanza per sovrapporre i confini, è possibile individuare i singoli errori (o in alternativa, utilizzare il codice di superficie dinamico nel tempo di GoogleAI come mostrato nel diagramma a destra)
Progettare questa ridondanza nei sistemi quantistici è fondamentalmente complesso e richiede una solida preparazione matematica. Per comprendere il concetto di alto livello, dobbiamo tornare alle basi: come funziona effettivamente il controllo di parità?
Come funziona effettivamente il controllo di parità? Link to heading
Inizialmente, potrebbe sembrare poco chiaro come funzioni il controllo di parità, poiché la determinazione della parità richiede la conoscenza del bit di sindrome atteso, che dipende dallo stato del qubit dati. Tuttavia, conoscere in anticipo lo stato del qubit dati vanificherebbe lo scopo del calcolo quantistico. In altre parole:
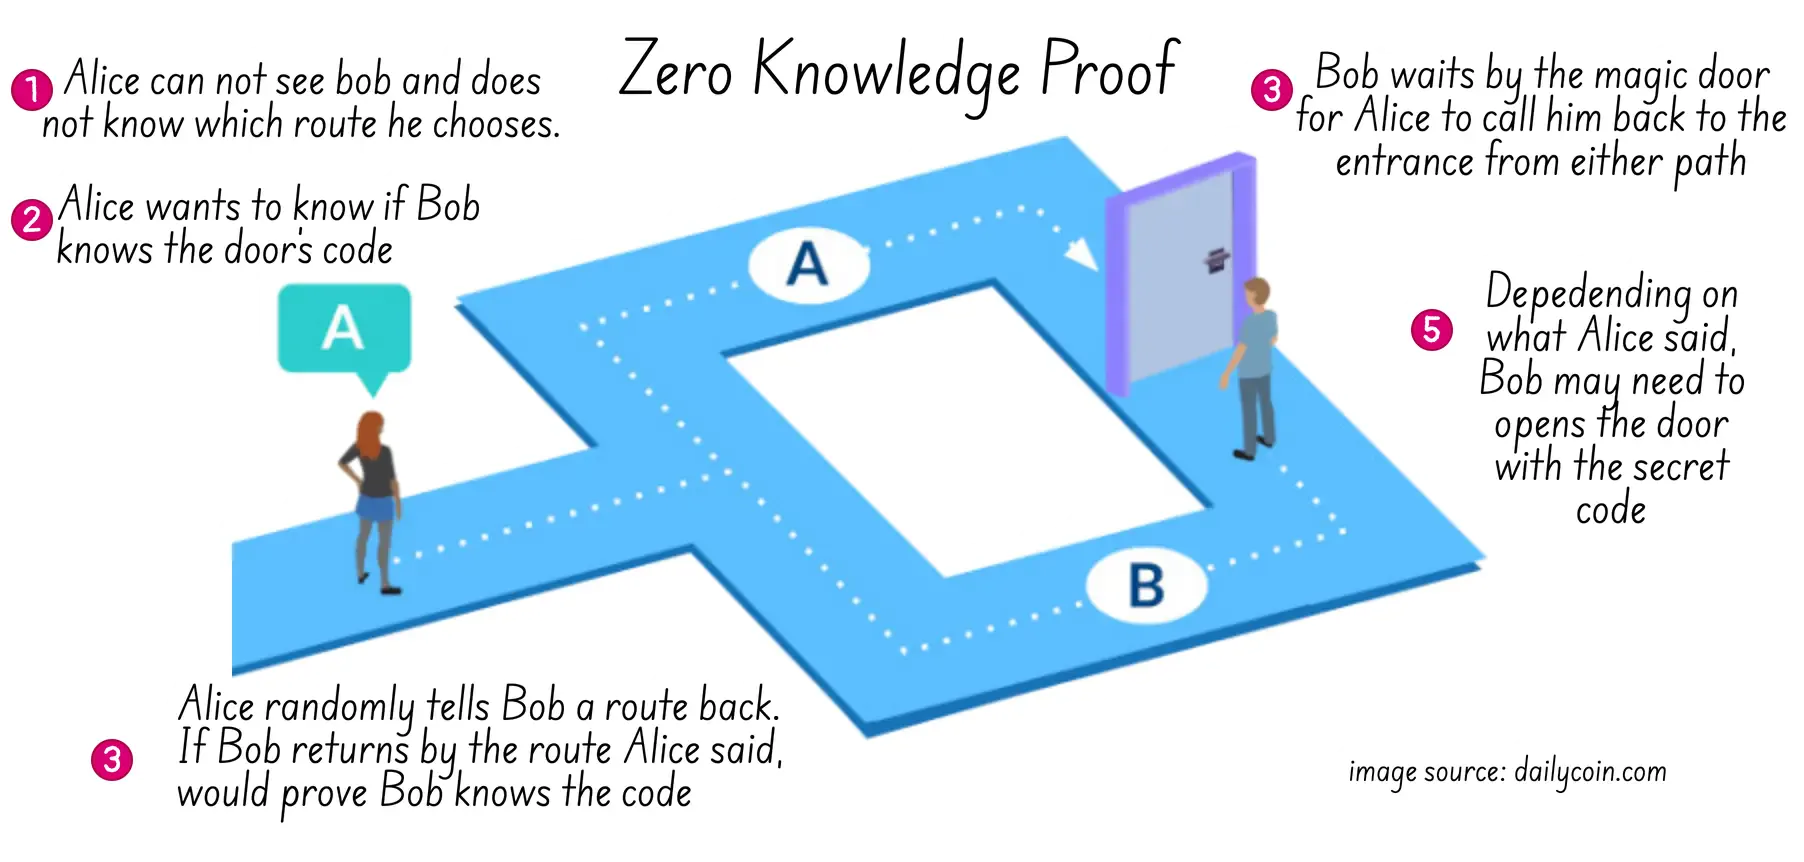 Per risolvere questa sfida, la chiave è fare riferimento allo stesso trucco utilizzato per la prova “a conoscenza zero” utilizzata nell’esperimento della grotta di Alibaba: è sufficiente porre domande specifiche le cui risposte sono note indipendentemente da quale sia l’informazione quantistica codificata (crediti immagine: dailycoin)
Queste domande specifiche corrispondono agli operatori dello stabilizzatore di Pauli. Il bit di sindrome, o risultato della misurazione, può essere visto come percorso A o B. Nel QEC, il percorso A rappresenta lo stato valido, mentre il percorso B indica un errore. Ciò che il “motore” del QEC deve fare è costruire il circuito quantistico che opera sul qubit logico in modo da preservare questo vincolo, detto anche “stato protetto”.
Codifica degli stati protetti Link to heading
È qui che l’ingegneria diventa fondamentale. Per garantire che la misurazione della sindrome restituisca sempre il percorso A in assenza di errori e il percorso B in caso contrario, le informazioni di parità multi-qubit devono essere codificate in modo tale che le relazioni tra i qubit siano fisse per ogni stato codificato valido.
Questa è la funzione del circuito di codifica. Il suo scopo è quello di mappare uno stato di input semplice e non corrotto (come un singolo qubit fisico \(|ψ> = α|0> + β|1>\) con ancilla vuote \(|00...0>\) in uno stato di qubit logico altamente entangled \(|ψ_L>\) protetto dalla correzione degli errori quantistici.
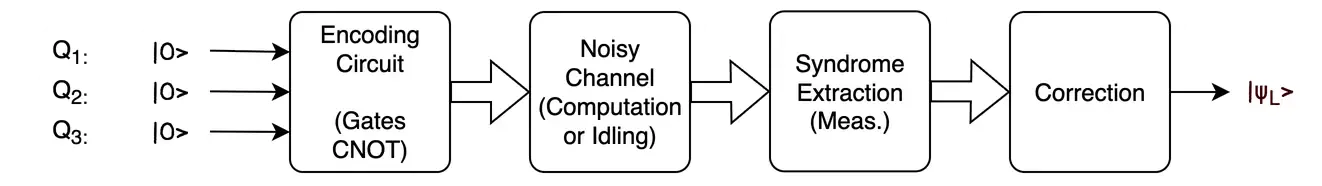
Tratterò il circuito di codifica in modo più dettagliato in una nota successiva. Per ora, si può considerare il circuito di codifica come un circuito quantistico progettato e specializzato, utilizzato per inizializzare, o avviare, il qubit logico nello stato protetto.
Codice di distanza Link to heading
Per correggere gli errori degeneri (ovvero le sindromi “bizantine” Q 1 + Q 2 ), è possibile aumentare la ridondanza incrementando quella che viene chiamata distanza del codice \( d \). A prima vista, si potrebbe dire che la distanza del codice \( d \) definisce quanto è robusta la protezione dagli errori.
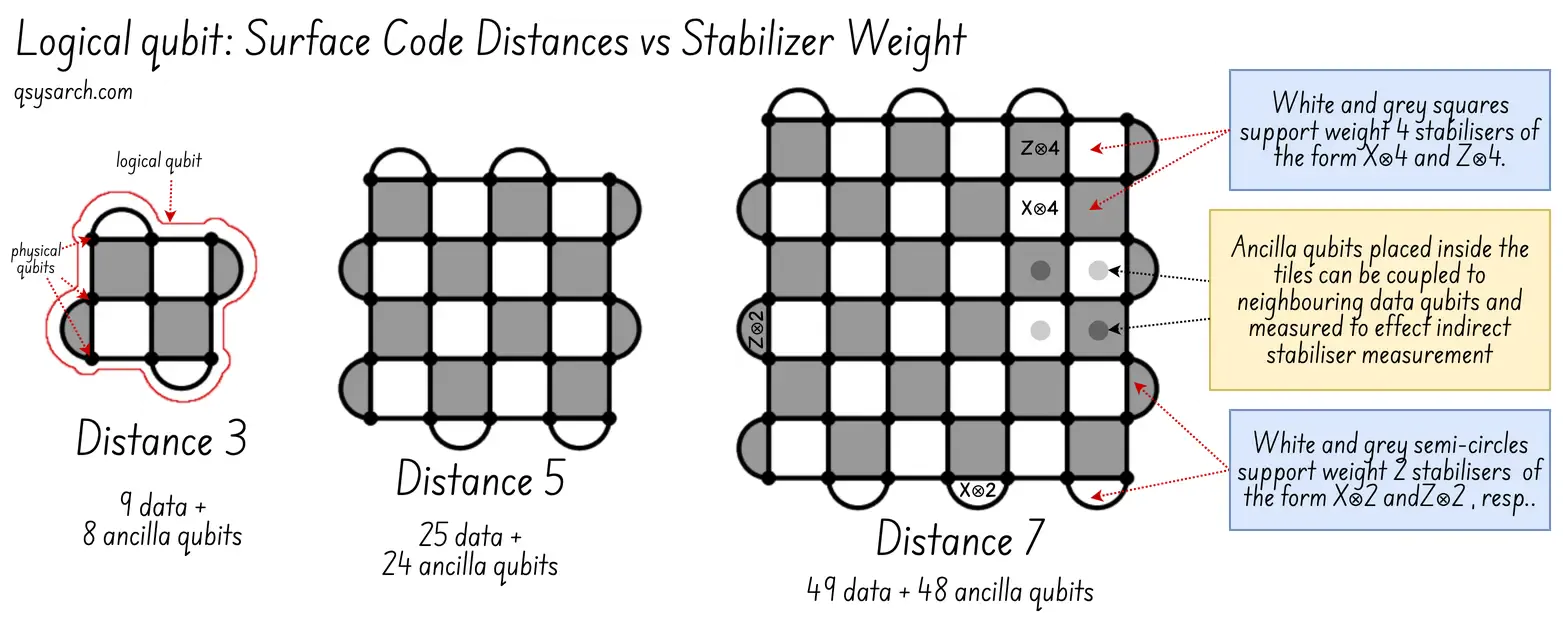
Se la distanza del codice è \( d=3 \), l’inversione di 2 qubit adiacenti distrugge l’informazione e il QEC non riesce a correggere il qubit logico, ovvero non riesce a mantenere il qubit logico nello stato protetto. Con una distanza del codice maggiore, ad esempio \( d=5 \), il decodificatore QEC può garantire che, anche se Q 1 e Q 2 si invertono e si mascherano a vicenda dal controllo Z 1 Z 2 , l’incremento della misurazione dello stabilizzatore fornirà al decodificatore un contesto sufficiente per identificare Q 1 e Q 2 come un doppio errore. Da una prospettiva matematica, questo può essere scritto come:
Il teorema della soglia Link to heading
Se la ridondanza risolve il problema, perché non usare semplicemente un codice di superficie con dimensioni maggiori? La difficoltà sta nel fatto che, per ogni qubit fisico aggiuntivo (per aumentare la ridondanza), è necessario misurare più stabilizzatori. E più misurazioni significano più rischi (che si verifichino errori fisici).
Ciò conduce al cosiddetto Teorema di soglia
In termini semplici, il teorema della soglia significa che, finché il tasso di errore dei qubit fisici \(p\) è inferiore a una soglia \(p_{th}\), è possibile aggiungere altri qubit fisici per migliorare la correzione degli errori, e che il numero di qubit aggiunti è in complessità \(N.log(N)\).
Perché è importante? Perché significa che, anche se i qubit “non si comportano” sempre come previsto, a patto che ciò non accada troppo spesso, è possibile ottenere un comportamento migliore, nel complesso, di un insieme più ampio di qubit rispetto alla somma dei singoli qubit, aprendo così la strada all’era post-NISQ, ovvero all’era FTQC, o Fault-Tolerant Quantum Computing (calcolo quantistico tollerante ai guasti).
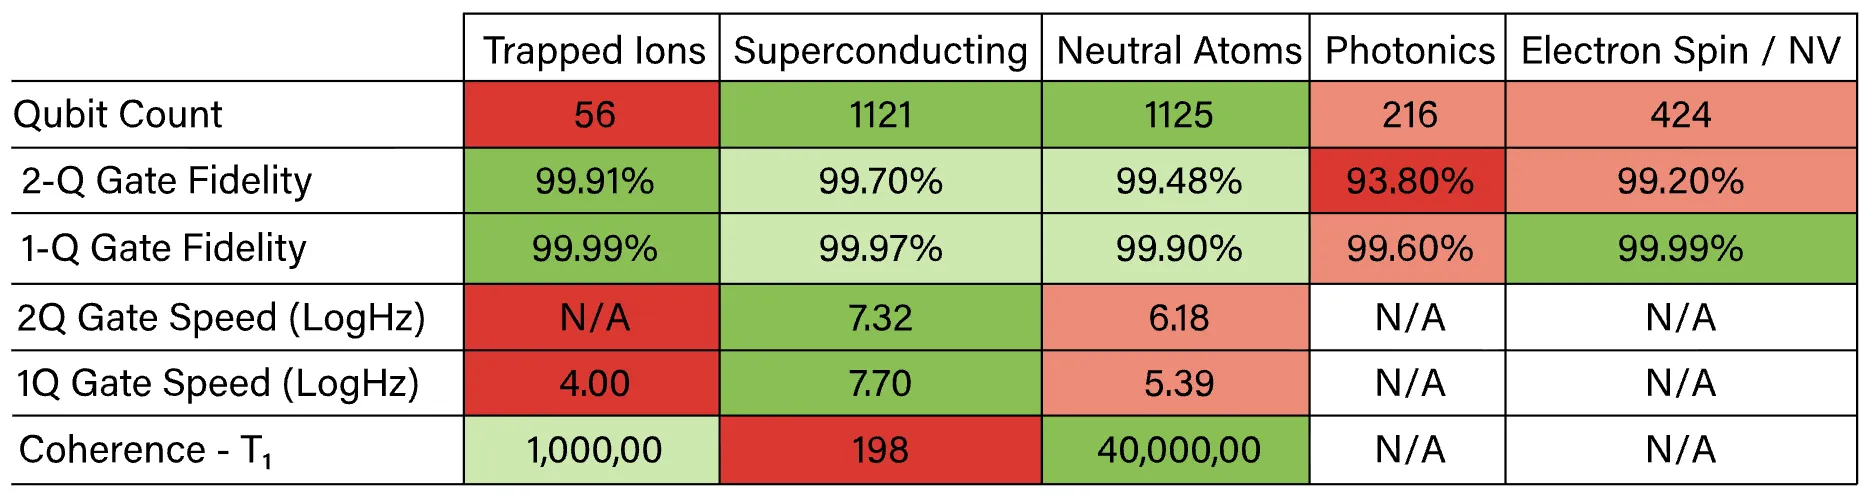
Naturalmente, la questione essenziale è quale sia questa soglia \ (p _ {th} ). Si aggira tra lo 0,1% e l'1%, e sebbene possa sembrare bassa, non rappresenta un problema poiché i qubit moderni possono già raggiungere fedeltà del 99,9% (per porte a un qubit).
Conclusion Link to heading
Ecco, questo breve promemoria getta le basi per i concetti utilizzati nella correzione degli errori quantistici.
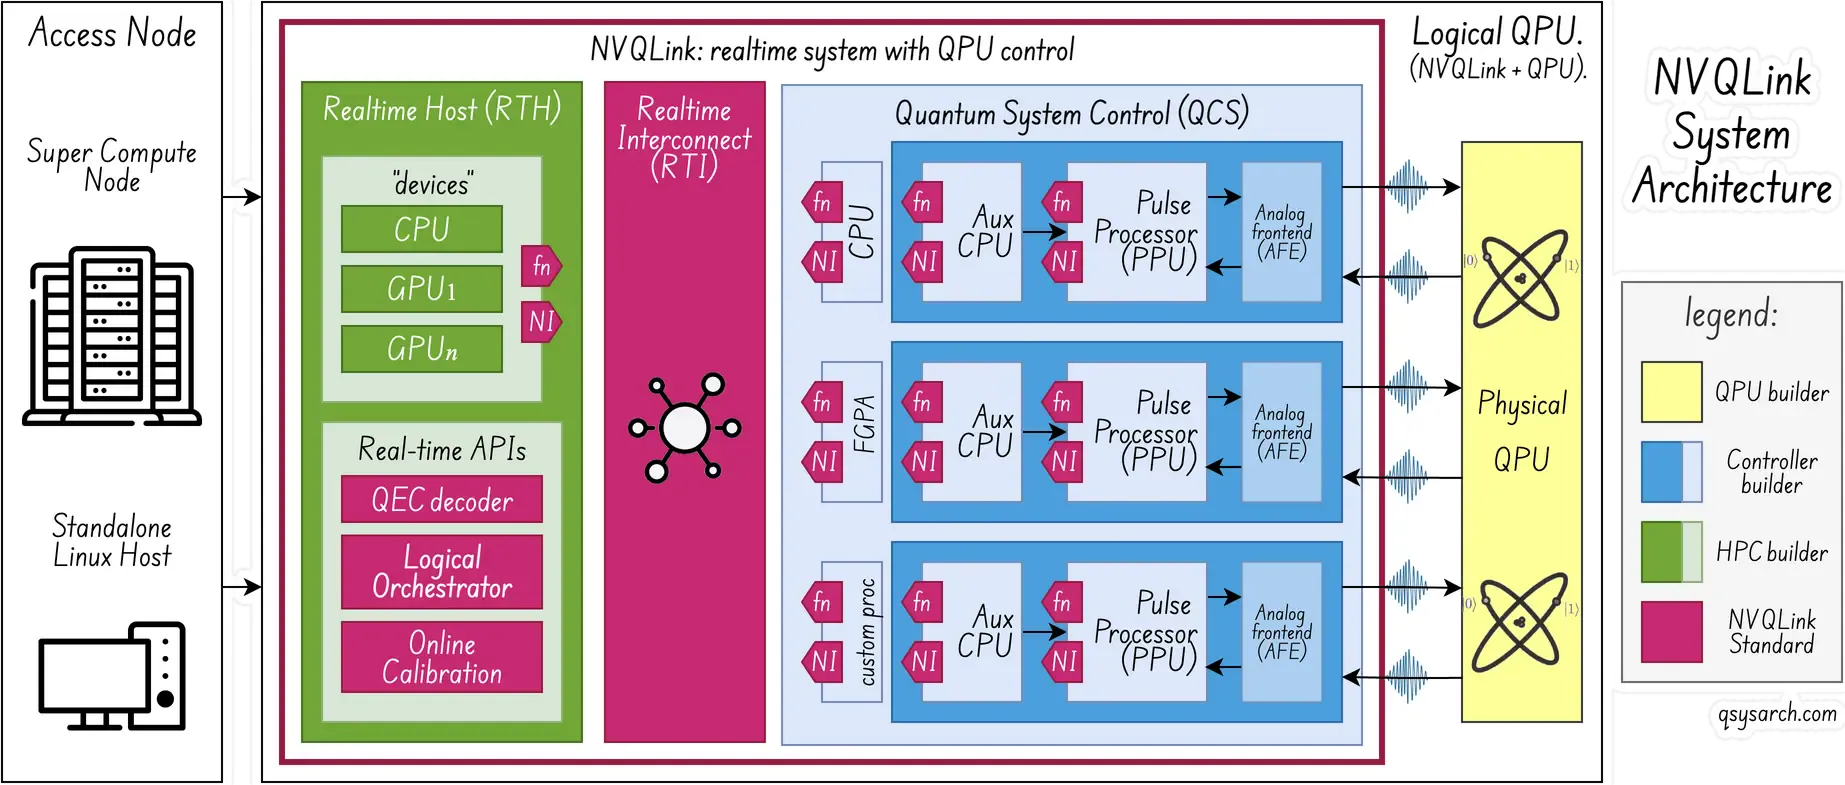
I prossimi due promemoria saranno più pratici. Il secondo analizzerà cosa significhi concretamente per il Sistema di Controllo Quantistico (e il decodificatore di errori) trasformare il qubit fisico in un qubit logico, in termini di controllo, lettura e sequenziamento. Il terzo promemoria si concentrerà sul sistema di decodifica, nonché sulla bassa latenza e sulla comunicazione in tempo reale tra il decodificatore e il sistema di controllo.
Questo promemoria è in realtà il primo di una serie. I prossimi promemoria del QEC si concentreranno sui seguenti argomenti:
Orchestrazione della sindrome dalla prospettiva del sistema di controllo quantistico
Decodifica degli errori in tempo reale: ASIC, GPU e reti neurali a bassissima latenza.
Qubit intelligenti co-progettati: il caso dei qubit protetti dagli errori di Alice e Bob
Compilatori di codice di superficie su larga scala: massimizza la tolleranza ai guasti per miliardi di operazioni fisiche
Architetture di decodifica gerarchica: principio di località ed elaborazione multistrato
Orchestrazione logica dei qubit: Chirurgia e intreccio del reticolo
Oltre i codici di superficie: il passaggio ai codici qLDPC
Distillazione allo stato magico e rotazioni analogiche
A quanto pare, questo mi terrà occupato per i prossimi 6 mesi!
References:
- Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder
- Real-Time Quantum Error Correction System Stack: Architecture, Algorithms, and Engineering Practice
- Reinforcement learning control of quantum error correction
- Riverlane Deltaflow: The Quantum Error Correction Stack
- Quantum Machine: QEC decoding
- How IQM is tackling quantum error correction
- Q-CTRL: Towards practical Quantum Error Correction
- Building logical qubits in a superconducting quantum computing system
- The Quantum Leap That Needs Error Correction
- Error budgeting for quantum error correction
- How Space and Time Could Be a Quantum Error-Correcting Code
- Quantum error correction in the presence of biased noise
- What Makes a “Logical Qubit” Actually Logical?
- Hybrid Multiplexing with Dynamic Qubit Grouping for Low-cost and Scalable Quantum Wiring
- Defining the Logical Qubit: Five Criteria to Benchmark Logical Qubit Claims
- Real-Time Decoding for Fault-Tolerant Quantum Computing: Progress, Challenges and Outlook
- Why do quantum computers need QEC?
- To reset, or not to reset—that is the question
- A memristive neural decoder for cryogenic fault-tolerant quantum error correction
- Decoupling AI for Quantum Control and Calibration
- A high performance compiler for very large surface code computations
- All about quantum error correction: distillation, mitigation, self-correction and beyond
- StreamingQEC: Streaming Quantum Error Correction in Tightly Integrated Quantum-Classical Systems via Certified Recurrence
- A real-time, scalable, fast and highly resource efficient decoder for a quantum computer
- Constraint-Optimal Driven Allocation for Scalable QEC Decoder Scheduling
- Comparison of spin-qubit architectures for quantum error-correcting codes
DrawIO diagrams used in this memo: