Sono estremamente felice di far parte del team di Qblox che ha lavorato e continua a lavorare attivamente con Nvidia per promuovere lo standard NVQLink, come metodo per interconnettere sistemi eterogenei che eseguono calcoli su GPU, CPU e QPU (processori quantistici, inclusi i controller quantistici di primo livello che Qblox sta sviluppando).
NVQLink in sintesi Link to heading
NVQLink non è l’ennesimo “cavo” per collegare le GPU ai processori Quantum, bensì un framework completo che permette di interconnettere dispositivi eterogenei, dalla rete allo stack software:
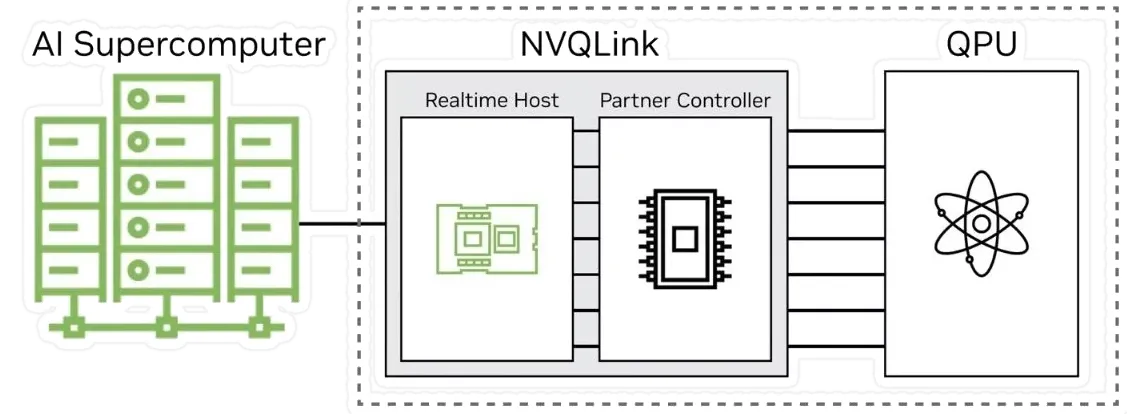 Crediti immagine: Nannod
Quali specifiche di prestazione Link to heading
Le principali specifiche “hardware” pongono l’accento sulle prestazioni delle risorse di rete e di elaborazione:
Velocità di trasmissione di rete: fino a 400 Gb/s dalla GPU alla QPU.
Latenza di rete: latenza di andata e ritorno (FPGA → GPU → FPGA) inferiore a 4,0 microsecondi.
GPU HW: Host in tempo reale basato su superchip NVIDIA GB200 Grace Blackwell, con un elevato numero di TFLOPS.
Perché è necessario NVQLink Link to heading
Potresti chiederti: “Perché è importante?”
Crea uno standard aperto per integrare strettamente l’hardware quantistico con il calcolo accelerato delle GPU.
Consente flussi di lavoro ibridi: calibrazione di reti neurali, correzione degli errori quantistici (QEC), ecc.
Fornisce una piattaforma aperta che integra software e hardware in un’unica soluzione, consentendo a chiunque di interagire con i computer quantistici, senza dover annegare in un oceano di conoscenza, grazie a Cuda-Q.
Specifiche NVQLink: Progettazione architettonica Link to heading
Il white paper di NVQLink è ora disponibile all’indirizzo https://arxiv.org/abs/2510.25213, quindi analizziamo nel dettaglio l’architettura proposta:
Architettura di sistema Link to heading
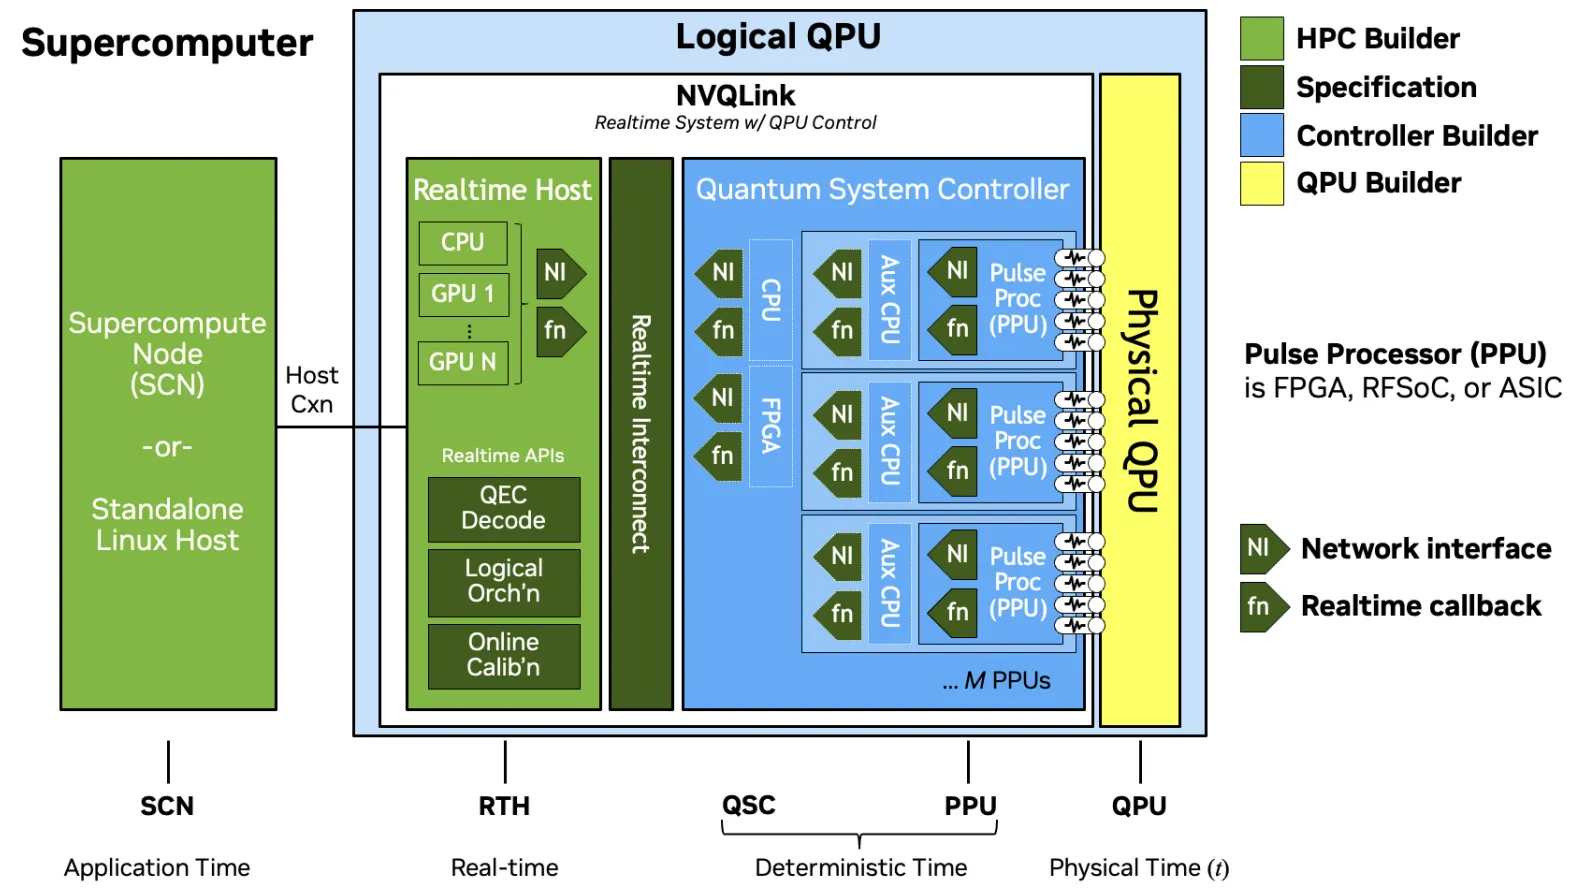
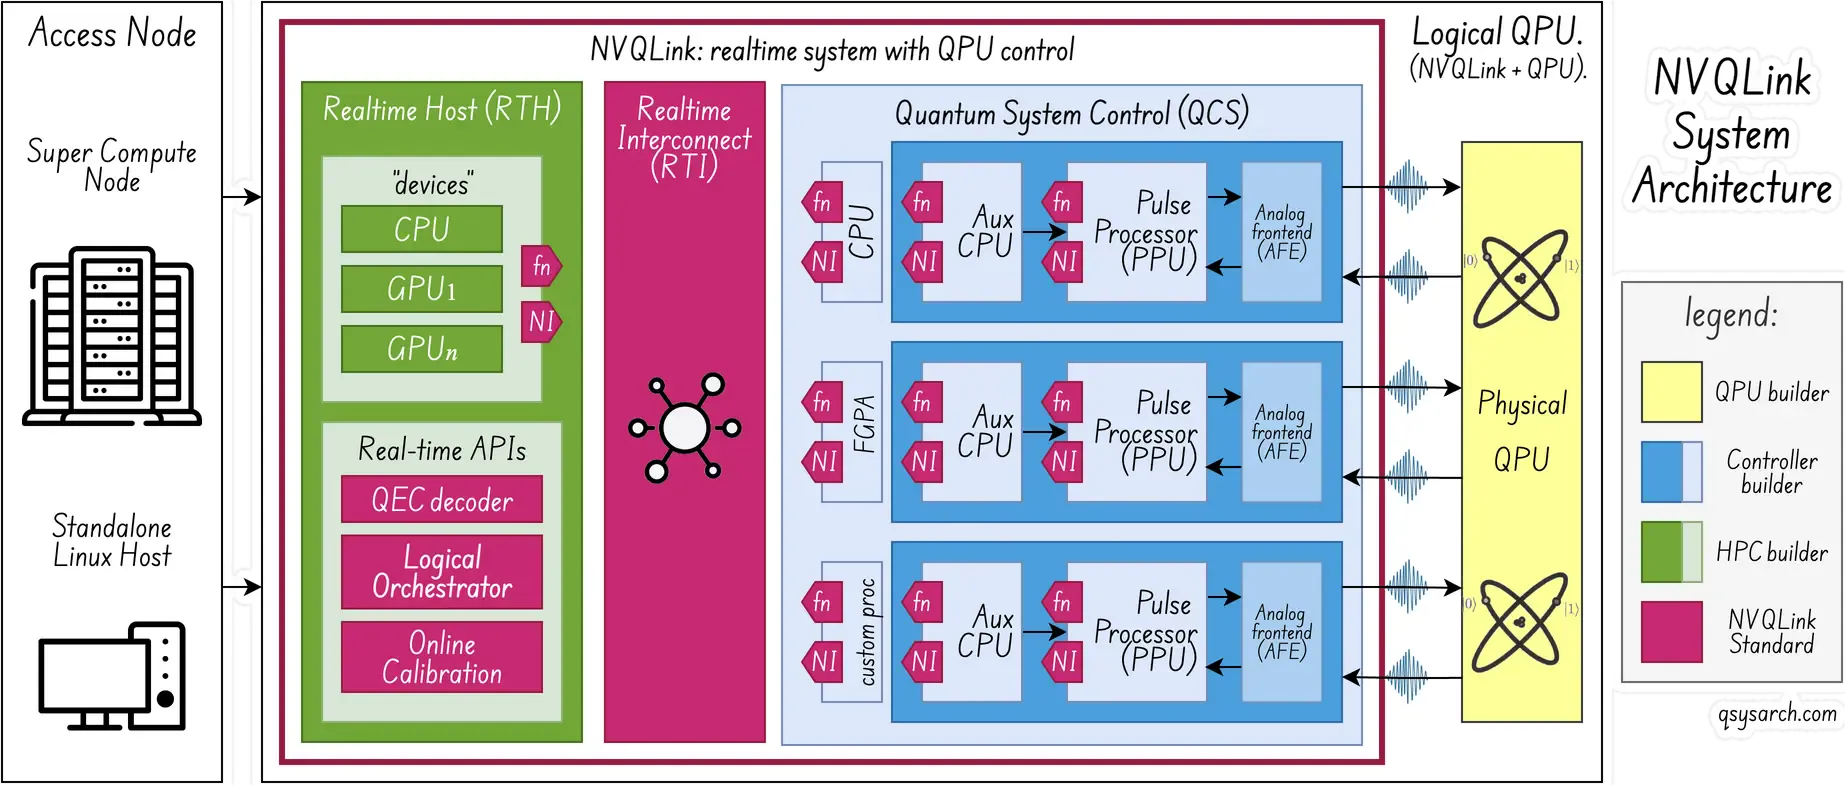 (diagramma di sistema adattato dall’immagine originale picture del white paper)
Come previsto, i dettagli corrispondono alla panoramica generale fornita da Nannod. Dal punto di vista dei componenti, l’architettura NVQLink comprende l’Host in tempo reale (RTH) e il Sistema di controllo QPU (QSC). Questi due componenti sono collegati da un’Interconnessione in tempo reale (RTI) scalabile e a bassa latenza. L’RTH dispone di risorse di calcolo HPC tradizionali come CPU e GPU. Per quanto riguarda il QSC, esso include tipicamente le Unità di elaborazione a impulsi (PPU) che controllano la QPU.
Questo diagramma introduce due parole chiave importanti: fn e NI. Nel modello mentale di NVQLink (“modello di programmazione”), ciascuna CPU, GPU, PPU (o altri circuiti integrati specializzati/FPGA) viene definita “dispositivo” e NVQLink consente di effettuare chiamate di procedura remote (“callback” o fn) a uno qualsiasi di questi dispositivi. Si tratta di una soluzione estremamente potente, in cui NVQLink funge da collante per il sistema eterogeneo. L’implementazione effettiva del runtime fn è altamente ottimizzata, al punto da gestire persino il marshalling. In questo modo, è possibile garantire latenze di pochi microsecondi. Per quanto riguarda NI, sta per Network Interface (Interfaccia di rete) ed è concettualizzata come una “piccola” scheda/interfaccia/cavo di rete opzionale che tutte le parti possono utilizzare per avere un sistema unificato e interconnesso.
Domini temporali Link to heading
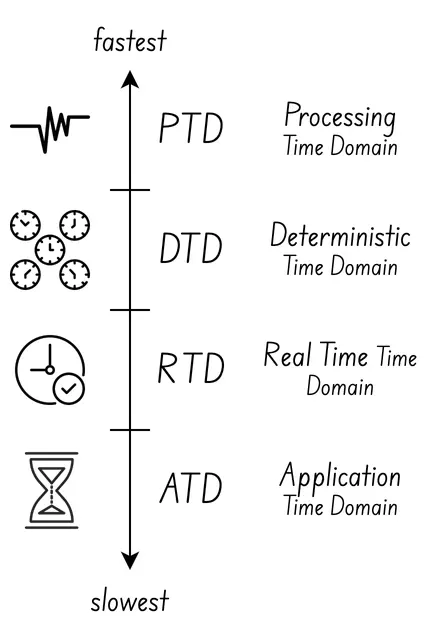
Il programma NVQLink introduce anche l’importantissimo concetto di domini temporali: questo è necessario perché non ci si aspetta che tutte le “unità di elaborazione” coinvolte nel sistema seguano lo “stesso orologio”.
Esistono 4 categorie di domini di tempo, o archi temporali, dal più veloce al più lento:

Dominio del tempo fisico (PTD): Solitamente l’orologio della QPU.
Dominio temporale deterministico (DTD): Solitamente l’orologio dei QSC/FPGA, in grado di operare con scale temporali coerenti a livello quantistico.
Dominio in tempo reale (RTD): Solitamente nella CPU o GPU classica. Può essere all’interno del tempo coerente quantistico, oppure tra due esperimenti coerenti quantistici.
Application Time Domain (ATD): Solitamente il laptop su cui è in esecuzione Jupyter Notebook!
Architettura di rete Link to heading
Come prevedibile, NVQLink utilizza RDMA e GPUDirect per bypassare qualsiasi elaborazione CPU non necessaria e garantire una latenza ottimale. Come specificato, “grazie a queste due tecnologie, solo la NIC e la GPU sono coinvolte durante l’elaborazione dei pacchetti in entrata e in uscita dal QSC, senza alcun coinvolgimento dell’host”.
La specifica raccomanda inoltre di utilizzare la modalità RDMA “Connessione non affidabile”, poiché il prezzo della latenza da pagare per le connessioni affidabili (RC) potrebbe essere eccessivo rispetto a una rete progettata correttamente.
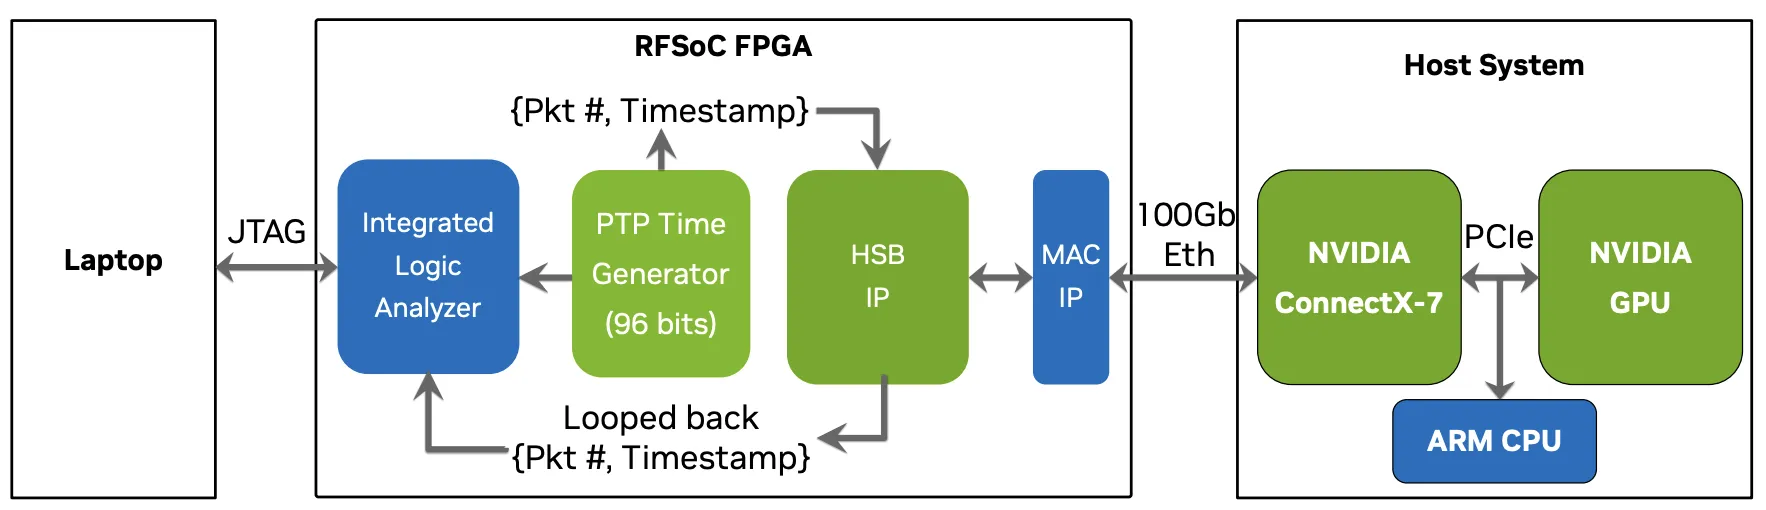
La specifica fornisce una “prova di concetto” per l’architettura di rete, come mezzo per verificare la latenza potenzialmente raggiungibile. Viene utilizzato il modulo Holoscan Sensor Bridge, che fornisce i mezzi per inviare dati tra un FPGA e una NIC utilizzando il protocollo RDMA over Converged Ethernet (RoCE), oltre a gestire le fasi di enumerazione e i segnali di controllo. Utilizzando questa architettura, la specifica mostra che è possibile ottenere una latenza di andata e ritorno inferiore a 4 microsecondi, per un payload RDMA di 32 byte, equivalente a un frame Ethernet di 92 byte.
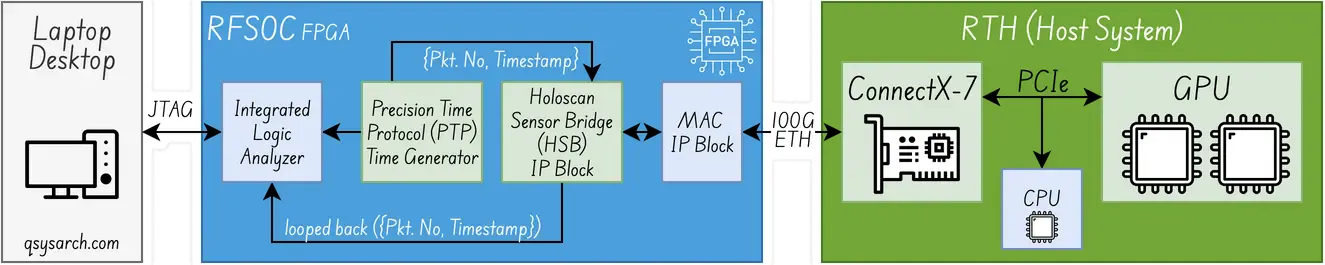 (diagramma adattato dall’immagine originale picture del white paper)
Architettura di compilazione (nota anche come modello di programmazione CudaQ+NVQLink) Link to heading
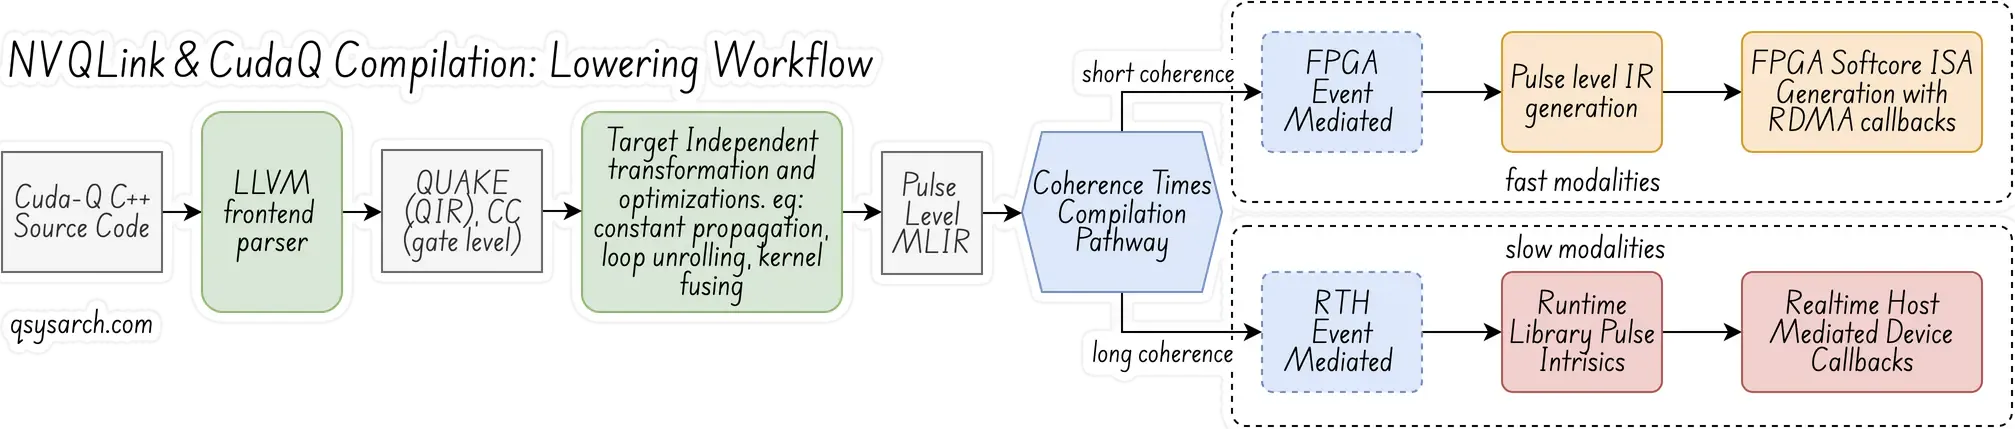
NVQLink distingue tra modalità lenta e veloce, e in questa sezione esaminerò nello specifico l’impatto dell’architettura della modalità veloce (la cosiddetta “sensibilità all’alta latenza”). La differenza principale con le modalità lente è che l’architettura consente la compilazione Just-in-Time (JIT) e la possibile mediazione RTH durante l’esecuzione.
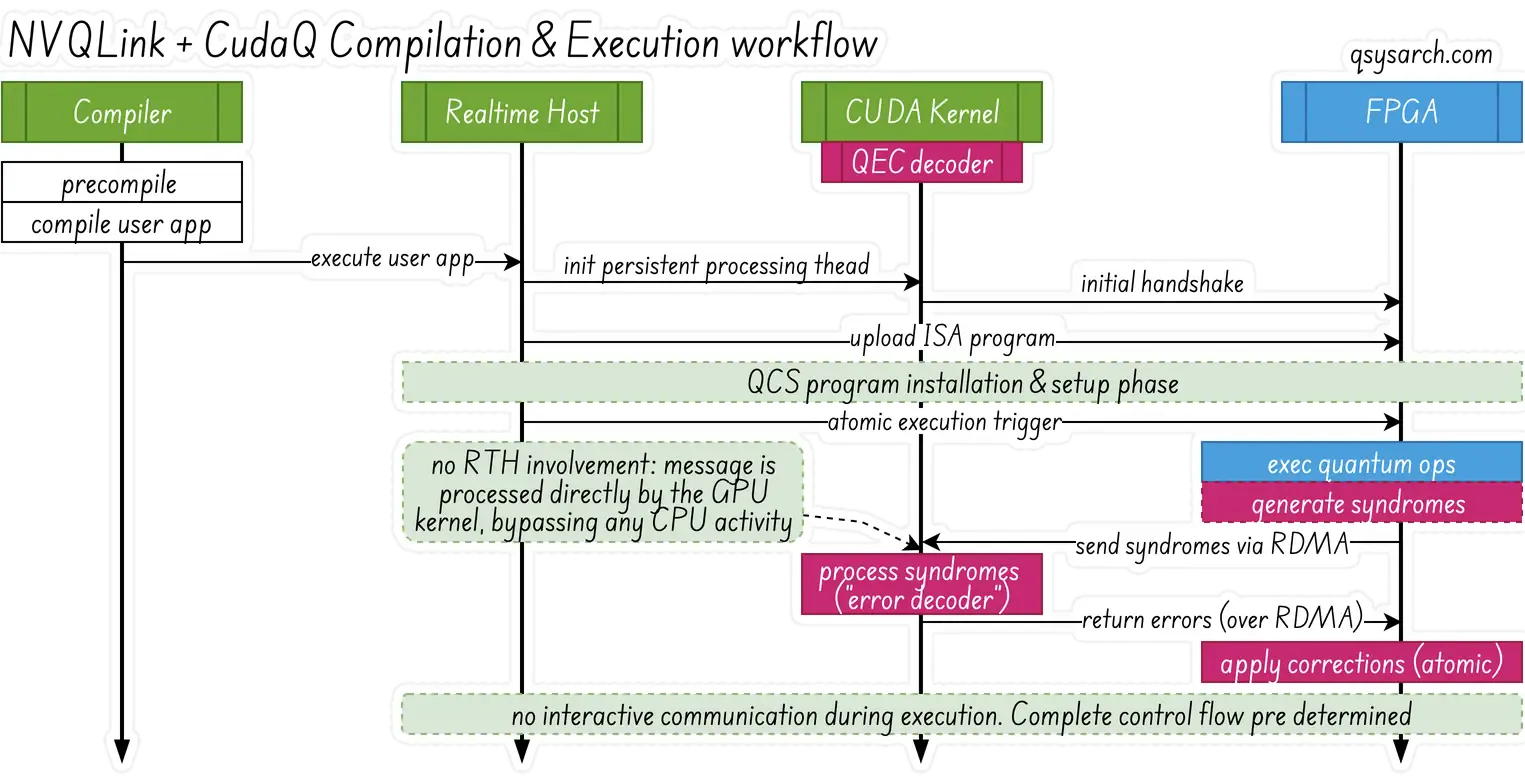
Affinché CudaQ + NVQLink funzionino con modalità veloci, la specifica stabilisce che i programmi ISA completi devono essere caricati in anticipo sugli FPGA ed eseguiti in modo atomico, con una comunicazione interattiva minima con l’host in tempo reale durante l’esecuzione. Il JIT è una tecnologia davvero interessante, quindi è un peccato che non possa essere utilizzata per le modalità veloci. Tuttavia, la specifica chiarisce che gli FPGA possono “ricevere” aggiornamenti dinamici dall’RTH (“tramite una coda di istruzioni”), a condizione che la coda di istruzioni rimanga non vuota fino alla terminazione del programma. Questo sembra essere un esempio di pianificazione “just in time”.
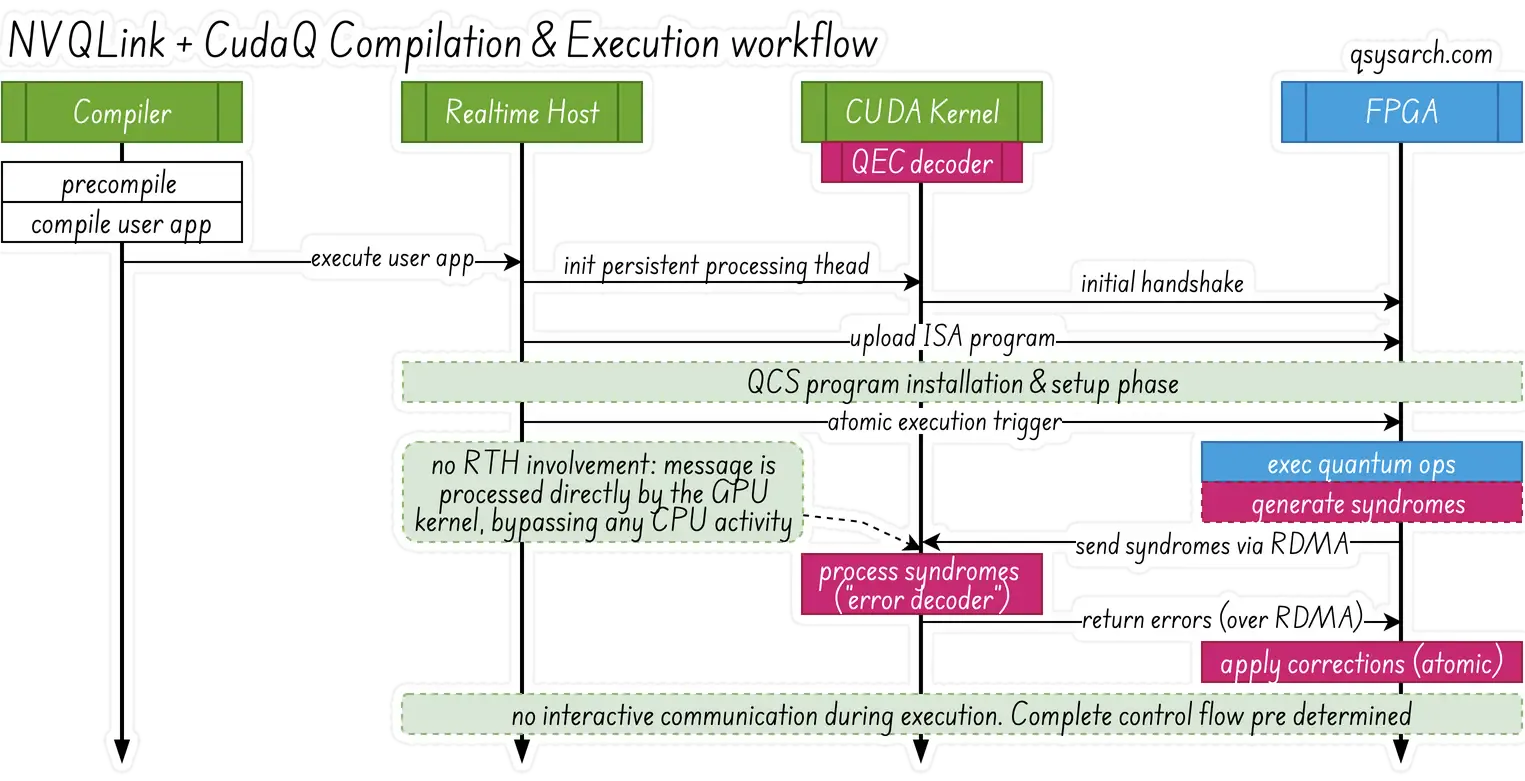
Senza alcuna sorpresa, la specifica chiarisce che la compilazione deve eseguire ottimizzazioni aggressive in anticipo, e questo è sicuramente qualcosa che tutti i fornitori di stack di controllo quantistico fanno di routine. Viene anche menzionato che se una qualsiasi callback deve essere eseguita nella GPU, il kernel CUDA nella GPU deve essere preinizializzato e in attesa attiva di eventi: niente di speciale qui, questo è il flusso di lavoro standard DOCA GPUNetIO
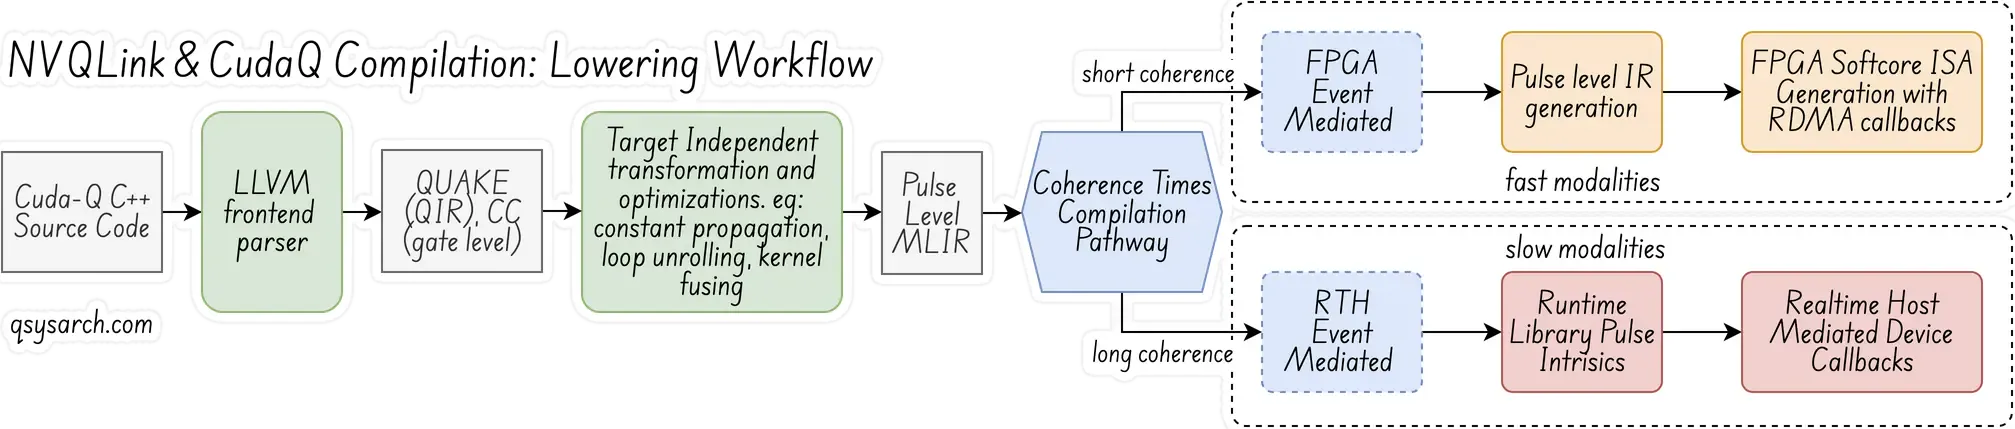
Il flusso di lavoro di compilazione e conversione CUDA=Q per l’architettura NVQLink si basa sull’architettura LLVM MLIR standard (vedi diagramma sopra). Il primo passo consiste nell’analizzare i kernel CUDA e generare l’IR Quantum (noto anche come QIR o QUAKE) e gli IR intermedi CC (classic compute), che vengono astratti a livello di gate. Una fase successiva introduce l’ottimizzazione e la fusione dei kernel necessarie, producendo un dialetto a livello di impulso. Quindi, a seconda del tipo di modalità, la fase di conversione successiva utilizza la mediazione RTH o FPGA.
Il “kernel quantistico” è identificato dal prefisso __qpu__.
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
    cudaq::qubit q;
    h(q); // Operate an H gate on qubit q
    auto readout = mz(q); // Read the Z axis of qubit q
    return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
Durante la fase di compilazione, viene prima convertito (“abbassato”) in una combinazione di rappresentazioni intermedie (IR) QUAKE (dialetto quantistico) e CC (dialetto di calcolo classico), o dialetti:
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
    %0 = quake.null_wire
    %1 = quake.h %0 : (!quake.wire) -> !quake.wire
    %measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
    %2 = quake.discriminate %measOut : (!quake.measure) -> i1
    %3 = cc.cast unsigned %2 : (i1) -> i32
    %4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
    return %4 : i32
}
Architettura di runtime: metaprogrammazione con tratti Link to heading
In linea con il concetto di zero-copy profondamente radicato in RDMA, il runtime NVQLINK promuove anche elevate prestazioni e un’astrazione a overhead zero, ottenuta grazie a due concetti chiave essenziali:
Composizione basata su tratti: è un metodo in fase di compilazione per esprimere qualsiasi comportamento del dispositivo e NVQLink propone un insieme di tratti standard.
Polimorfismo statico: è un meccanismo che, in fase di compilazione, permette al compilatore di istanziare il metodo corretto senza bisogno di indirezione tramite tabella virtuale.
Ci sono 4 caratteristiche essenziali:
explicit_data_marshalling_trait: mezzo per allocare e trasferire dati attraverso il sistema.
device_callback_trait: mezzo per richiamare le funzioni del dispositivo (“RPC”)
quantum_control_trait: significa caricare e avviare il programma sul QCS
rdma_trait: mezzo per inizializzare in modo efficiente la struttura da un buffer di memoria raw.
In pratica, le caratteristiche utilizzano il linguaggio C++ a un livello estremamente avanzato. Questo è un esempio della caratteristica di marshalling dei dati.
template <typename Derived> class explicit_data_marshaling_trait {
public:
  void *resolve_pointer(device_ptr &devPtr);
  device_ptr malloc(size_t size) const;

  template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
  auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

  void free(device_ptr &d);

  template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
    void free(Ptrs &&...d) { (free(d), ...);
  }
  void send(device_ptr &dest, const void *src);
  void recv(void *dest, const device_ptr &src);
};
C’è molto da analizzare in questa sintassi, che a mio parere è persino più potente della sintassi Rust (ad esempio, cow). Questa sintassi è anche nota come metaprogrammazione e, nel contesto di NVQLINQ, si riferisce al polimorfismo in fase di compilazione, o statico. Diamo un’occhiata alla riga template <typename… Sizes, enable_if_t<(conjunction_v<is_integral
is_integral<Sizes>come α:trueseSizesè un tipo intero cioè int, float, bool, ecc…conjunction_v<α...>come β:truese tutti i valori inα...sono verienable_if_t<(β),int>come δ: una condizione gruppo 2 che dovrebbe fallire seβera falso.modello<typename... Sizes, δ = 0>: Una costruzione SFINAE che impedisce aδdi fallire.
Con questa sintassi, diventa possibile avere una malloc specializzata di più blocchi contemporaneamente:
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
Potreste chiedervi perché questo sia importante. La risposta è semplice: offre la possibilità di ottenere una specializzazione ottimale in fase di compilazione. In questo caso, l’implementazione di malloc può raggruppare il buffer di memoria in modo contiguo, rendendolo adatto agli scambi RDMA e al marshalling atomico di più dati. Fantastico, vero?
Architettura di runtime: kernel Link to heading
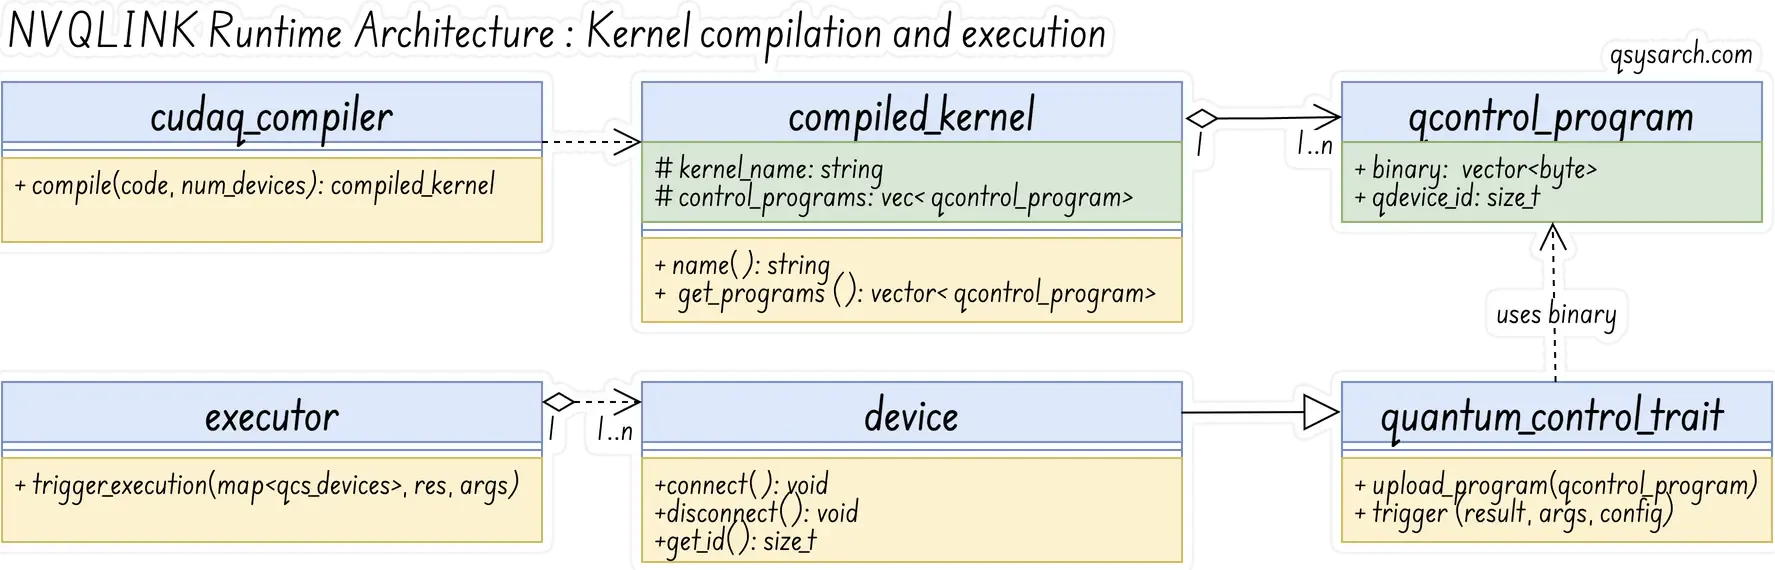
NVQLink fornisce una serie di interfacce standard per la compilazione, il caricamento e l’esecuzione (attivazione) di kernel quantistici. Poiché un’immagine vale più di mille parole, riassumerò questa sezione con questo disegno:
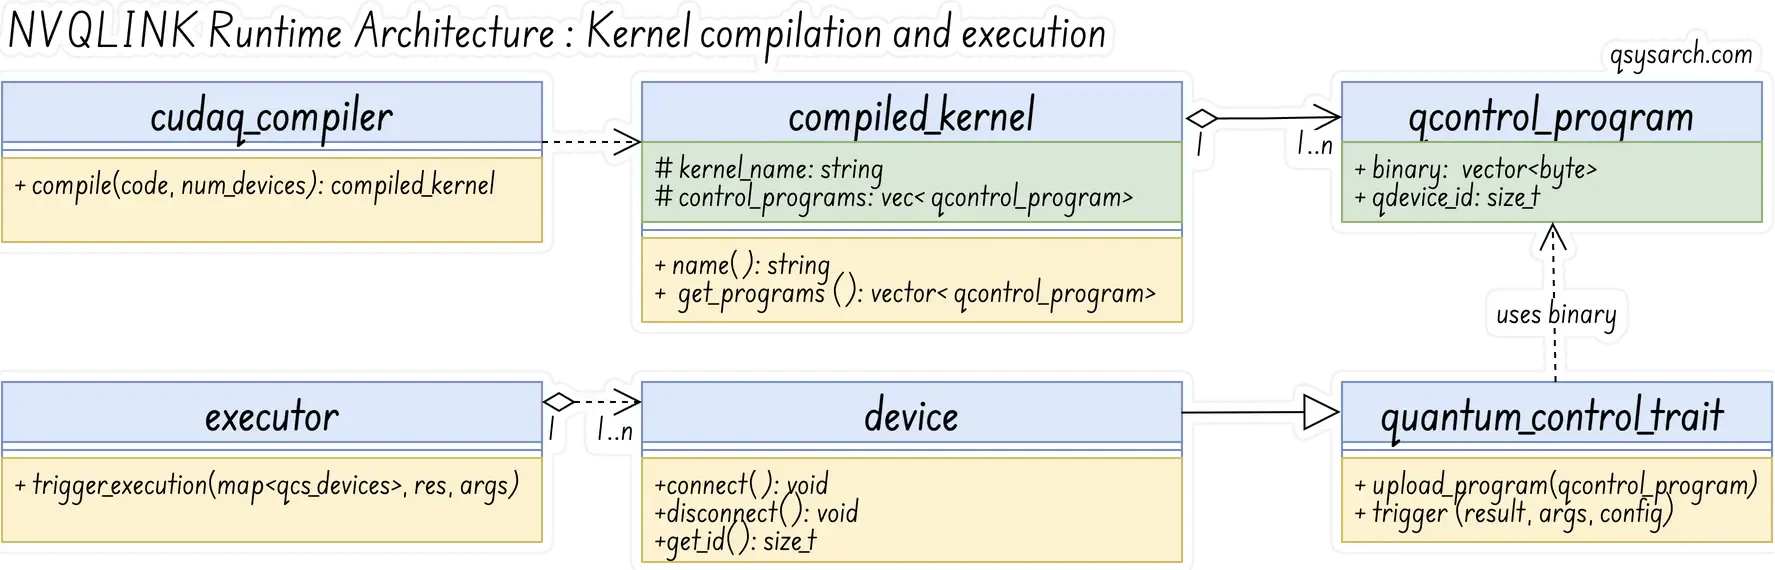
Un aspetto da notare è che un QCS (Quantum Control System) è composto da più PPU (Pulse Processor Unit). Pertanto, durante la compilazione di un kernel, potrebbe essere necessario eseguirlo in modo sincrono su più PPU. (Si noti che NVQLink è indipendente dalla sincronologia, ma ogni fornitore di QCS ha la propria soluzione, come SYNQ per Qblox).
Nel contesto delle interfacce NVQLINK, il concetto di PPU viene astratto e sostituito da QCS, acronimo di dispositivo quantistico generico. Pertanto, durante la compilazione di un kernel, NVQLINK genera più programmi per ciascun QCS.
Architettura di runtime: “libreria” di astrazione di livello superiore Link to heading
Poiché il codice spiegato nella sezione precedente può risultare piuttosto complesso da comprendere e su cui basarsi, NVQLINK fornisce un set di API di livello superiore, sotto forma di funzioni:
La libreria contiene funzioni per gestire le operazioni di inizializzazione e arresto di base, per gestire le API di modifica dei dati specifiche del dispositivo, come memcpy, per trasferire dati da e verso la QPU logica, e per gestire il caricamento e l’esecuzione. Di seguito è riportata una versione semplificata di tali funzioni:
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
Esempio di applicazione: Teletrasportiamoci Link to heading
da completare
Conclusion Link to heading
NVQLINK è una potente astrazione a livello di sistema che consente l’interconnessione di sistemi eterogenei con un runtime altamente efficiente e ottimizzato. Ciò che lo rende più interessante di qualsiasi altro framework è che il sistema NVQLink è composto da stack standard, tra cui RDMA per la rete, LLVM per il compilatore e trait e API standardizzate per il runtime.
Con NVQLINK, sviluppatori e integratori non devono più preoccuparsi dell’interconnessione. Possono invece concentrarsi sulla composizione del loro sistema eterogeneo e sulla compilazione dei kernel multi-dispositivo all’interno di un unico framework, lasciando che il runtime NVQLINK gestisca l’esecuzione dei diversi “dispositivi”, proprio come se si trattasse di un unico sistema. Il runtime NVQLink si occupa della rete, del marshalling e delle chiamate tra dispositivi, sollevandovi da questo compito.
Si tratta di un enorme passo avanti: insieme a CudaQ, consentirà agli ingegneri quantistici di creare applicazioni potenti, proprio come Nvidia CUDA ha reso possibili le potenti applicazioni di reti neurali. Immaginate un LLM con un tocco di quantistica…
Richiesta: disegna un’immagine di un “Modello a grandi qubit” che viene calcolato su una GPU adiacente collegata tramite il sistema NVQLINK >
> ChatGPT non ha capito che NVLINK non è NVQLINK.
Richiesta: Riesci a disegnare un’immagine in stile cartone animato di un sistema NVQLINK, che interconnetta un “Modello a qubit di grandi dimensioni” collegato a una GPU adiacente? ChatGPT non ha ancora capito che NVQLINK non è un “cavo”, ma un framework a livello di sistema che permette di comporre kernel eseguibili su più dispositivi eterogenei. E che il cavo, per ora, dovrebbe essere un RDMA (perché è uno standard), ma potrebbe benissimo essere NVLink tra 5 anni.
References
- Platform Architecture for Tight Coupling of High-Performance Computing with Quantum Processors
- An LLVM-based C++ Compiler Toolchain for Variational Hybrid Quantum-Classical Algorithms and Quantum Accelerators
DrawIO diagrams used in this memo:


In the press Link to heading
QPU Vendor Link to heading
- Pasqal: Integrated with their Qadence/Pulser stack.
- Quandela: Integrated with the Merlin framework
- IQM: Together with Zurich Instruments.
- Infleqtion: Integrated with the Superstaq.
- OQC|Oxford Quantum Circuits:
- Orca Computing: PT-Series systems
- Rigetti
- Silicon Quantum Computing:
- SEEQC:
- Alice & Bob
- Quantinuum
- IonQ