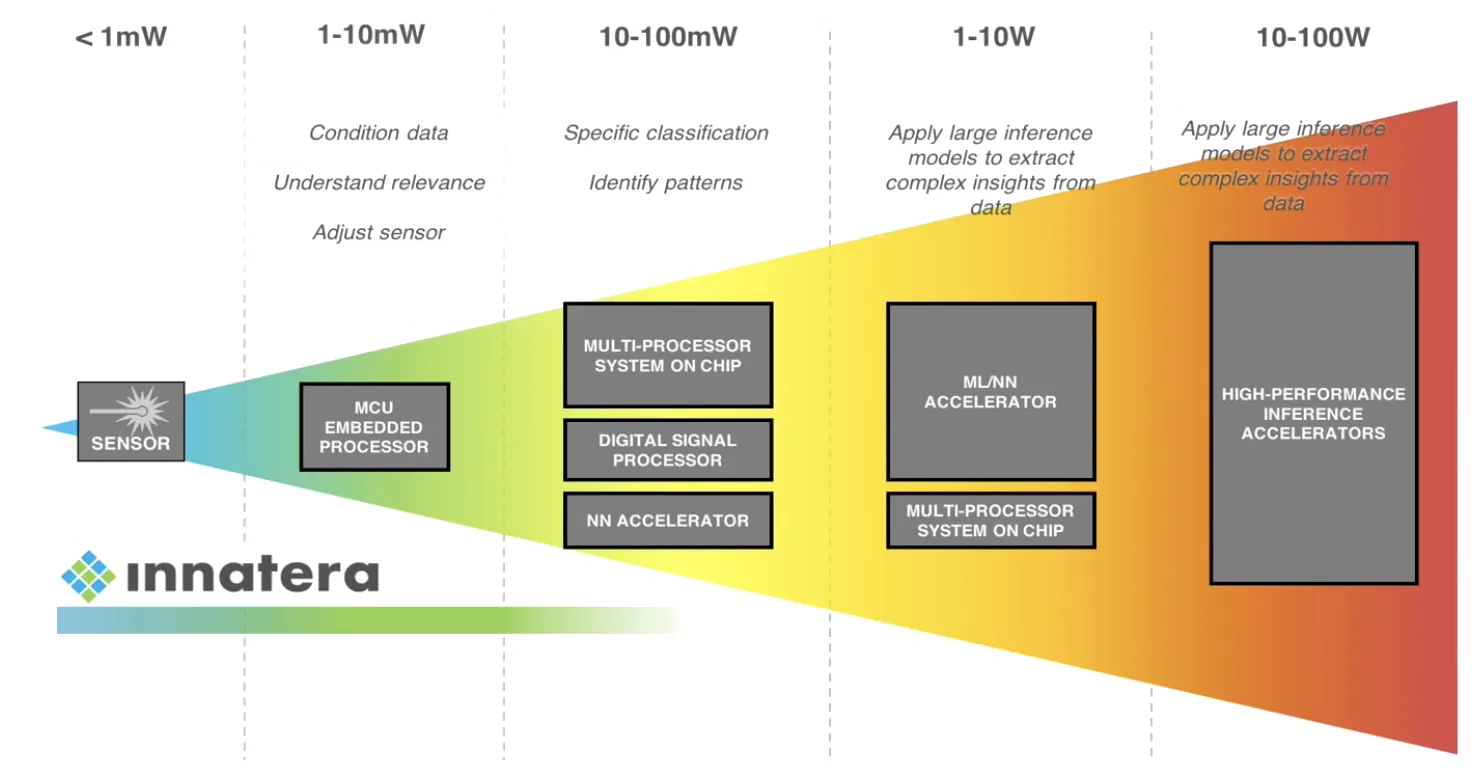
Recentemente ho sentito parlare di Unità di Elaborazione Neuromorfica, o NPU, durante una discussione su Neuralink.
 . Queste NPU non hanno nulla a che fare con il calcolo quantistico, ma ho pensato che sarebbe stato interessante dedicare un po’ di tempo a trarre ispirazione da una nuova architettura di elaborazione. E, a dire il vero, uno dei principali fornitori di circuiti integrati in questo settore è un’azienda olandese chiamata Innatera. L’ultimo circuito integrato di Innatera, Pulsar, si basa su reti neurali a impulsi a basso consumo (vedi l’immagine a destra).
In questo promemoria, cercherò di ricostruire, tramite ingegneria inversa, quante più informazioni possibili sull’architettura di questi circuiti integrati neuromorfici, sulla progettazione delle reti neurali a impulsi e sullo stack software utilizzato per programmare tali dispositivi.
Architettura hardware Link to heading
Questo è un tentativo di ridisegnare lo schema architetturale del circuito integrato Pulsar (immagine originale immagine, integrato con spunti tratti dal white paper):
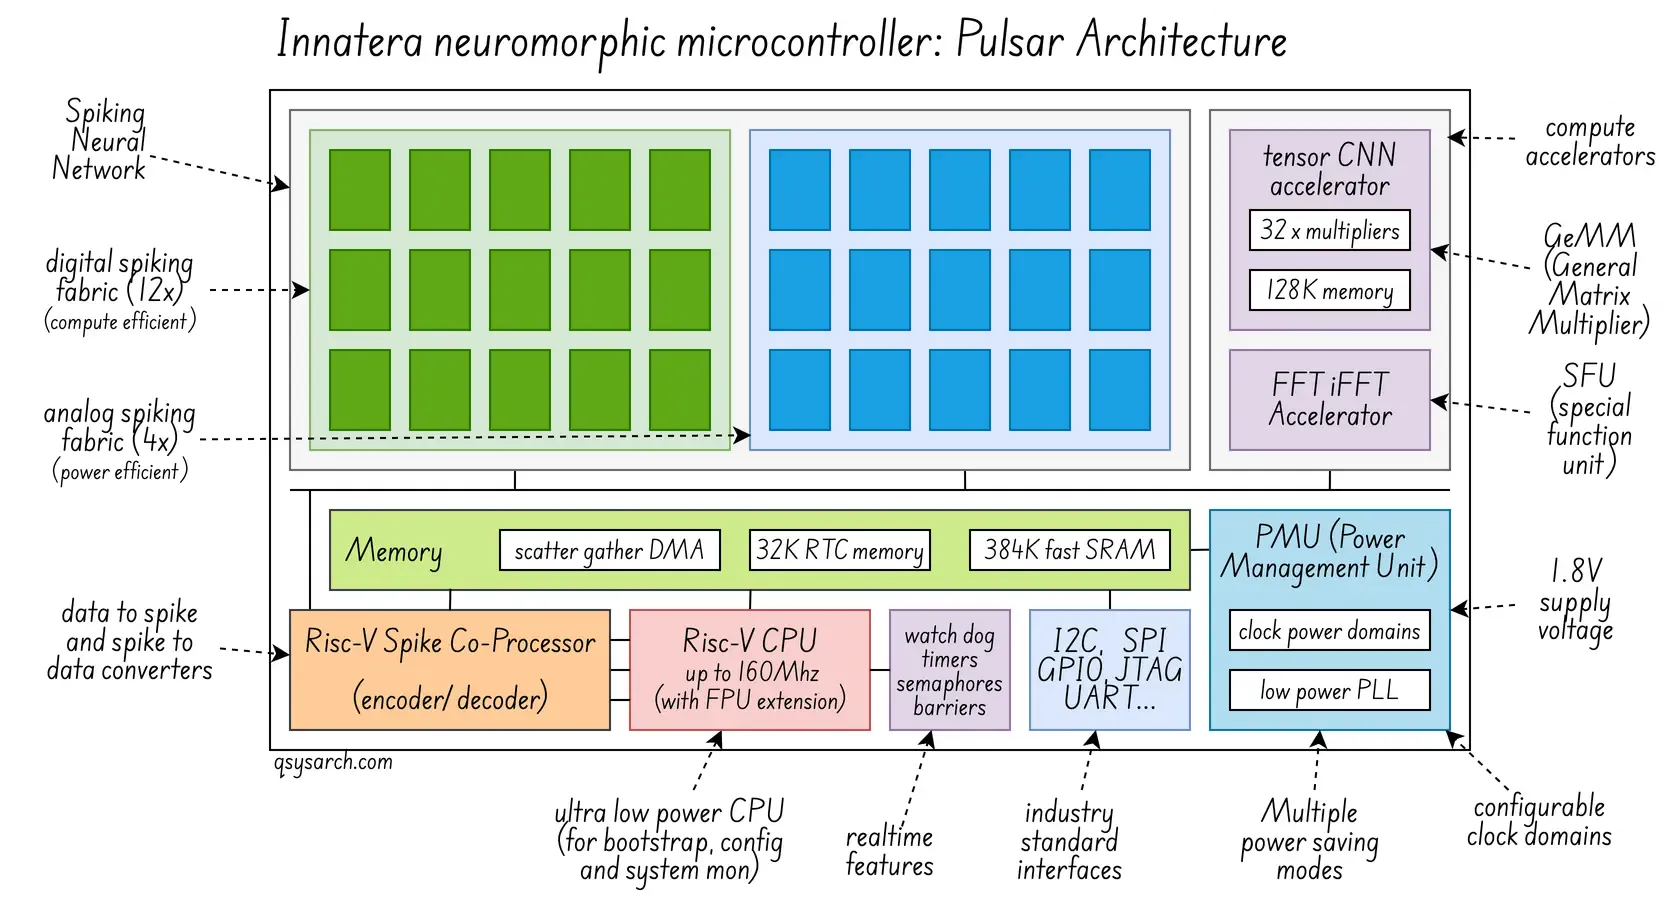
Mi piace l’idea di utilizzare una CPU RISC-V: è un chiaro segno che il team di Innatera sta prendendo la giusta decisione architetturale fin dal primo giorno. In uno dei diagrammi del precedente chip T1 di Innatera, la CPU RISC-V è fornita con un’estensione F (supporto per il calcolo in virgola mobile).
Il circuito integrato integra numerose interfacce standard (SPI, I2C, …) e un’unità di gestione dell’alimentazione (PMU) che attiva e disattiva parti del circuito integrato quando entra in modalità “sleep” o “risparmio energetico”. Purtroppo, non sono riuscito a trovare dati sul consumo energetico effettivo, a parte un valore di “meno di 1 mW” per un ballpack. Ipotizzando una tensione di alimentazione di 1,8 V, il consumo sarebbe inferiore a 500 µA (I=W/V). Mi chiedo anche se la metrica del consumo “per ciclo” sia rilevante: in questo caso, ipotizzando una frequenza di 100 Hz (periodo di aggiornamento sinaptico), ciò significherebbe un consumo medio di 5 µA per aggiornamento sinaptico.
L’ultimo diagramma di Pulsar mostra due acceleratori: uno per CNN e uno per FFT. Credo che questi possano essere descritti più ampiamente come un GEMM (moltiplicatore di matrici generale, fondamentale per il calcolo delle reti neurali) e un SFU (unità a funzioni speciali, utilizzata per accelerare il calcolo della FFT). Per maggiori informazioni, consultare il post sull’architettura GPU. È presente anche un codificatore-decodificatore di spike, che sembra essere stato sviluppato come coprocessore per RISC-V, ma non sono riuscito a trovare ulteriori dettagli.
Architettura di reti neurali a impulsi Link to heading
La domanda che rimane aperta riguarda la rete neurale a impulsi, o SNN: come funziona?
La metafora Link to heading
Ho chiesto a Gemini di fornirmi una metafora adatta a un bambino di 8 anni sulle reti neurali a impulsi. Ecco la storia che ho ricevuto:
Immaginate il cervello come un gigantesco ufficio postale, e i “neuroni” come i piccoli messaggeri che trasportano i messaggi.
- Messaggeri e note:
In un normale programma per computer, ogni messaggero parla e si scambia continuamente numeri. In una rete neurale a impulsi, invece, i messaggeri sono molto silenziosi ed efficienti dal punto di vista energetico: inviano un breve messaggio “Ehi!” solo quando accade qualcosa di importante, come un piccolo picco elettrico.
- Il misuratore di scintilla:
Ogni messaggero ha un indicatore che si riempie quando sente “Ehi!” dagli altri: quando l’indicatore è abbastanza pieno (raggiunge la soglia), anche quel messaggero si eccita e grida “Ehi!”. Subito dopo aver gridato, azzera l’indicatore, quindi non può gridare di nuovo immediatamente (periodo refrattario).
- Il tempismo è tutto:
Se un messaggero sente molti “Ehi!” in rapida successione, significa che il messaggio è estremamente importante (come “Fuoco!”). Se un messaggero grida “Ehi!” un po’ prima di tutti gli altri, potrebbe essere un segnale segreto che sta per succedere qualcosa di speciale (come “Tigre in arrivo!”). Quindi, i messaggeri devono essere attenti ai tempi.
- L’apprendimento è fondamentale:
I messaggeri imparano proprio come te: se il messaggero A grida “Ehi! Ehi!” subito prima che il messaggero B gridi “Ehi! Ehi!” (perché qualcosa li ha eccitati entrambi), la loro amicizia si rafforza e il messaggio del messaggero A aiuta il messaggero B a riempire più velocemente la sua barra la prossima volta.
Le reti neurali spiking (SNN) sono speciali perché sono progettate per essere incredibilmente veloci ed efficienti. Non sprecano energia comunicando continuamente; si attivano solo quando hanno un picco di informazioni da condividere! Aiutano i computer a comprendere i tempi, a riconoscere schemi e consumano pochissima energia.
Il vero design sotto il cofano Link to heading
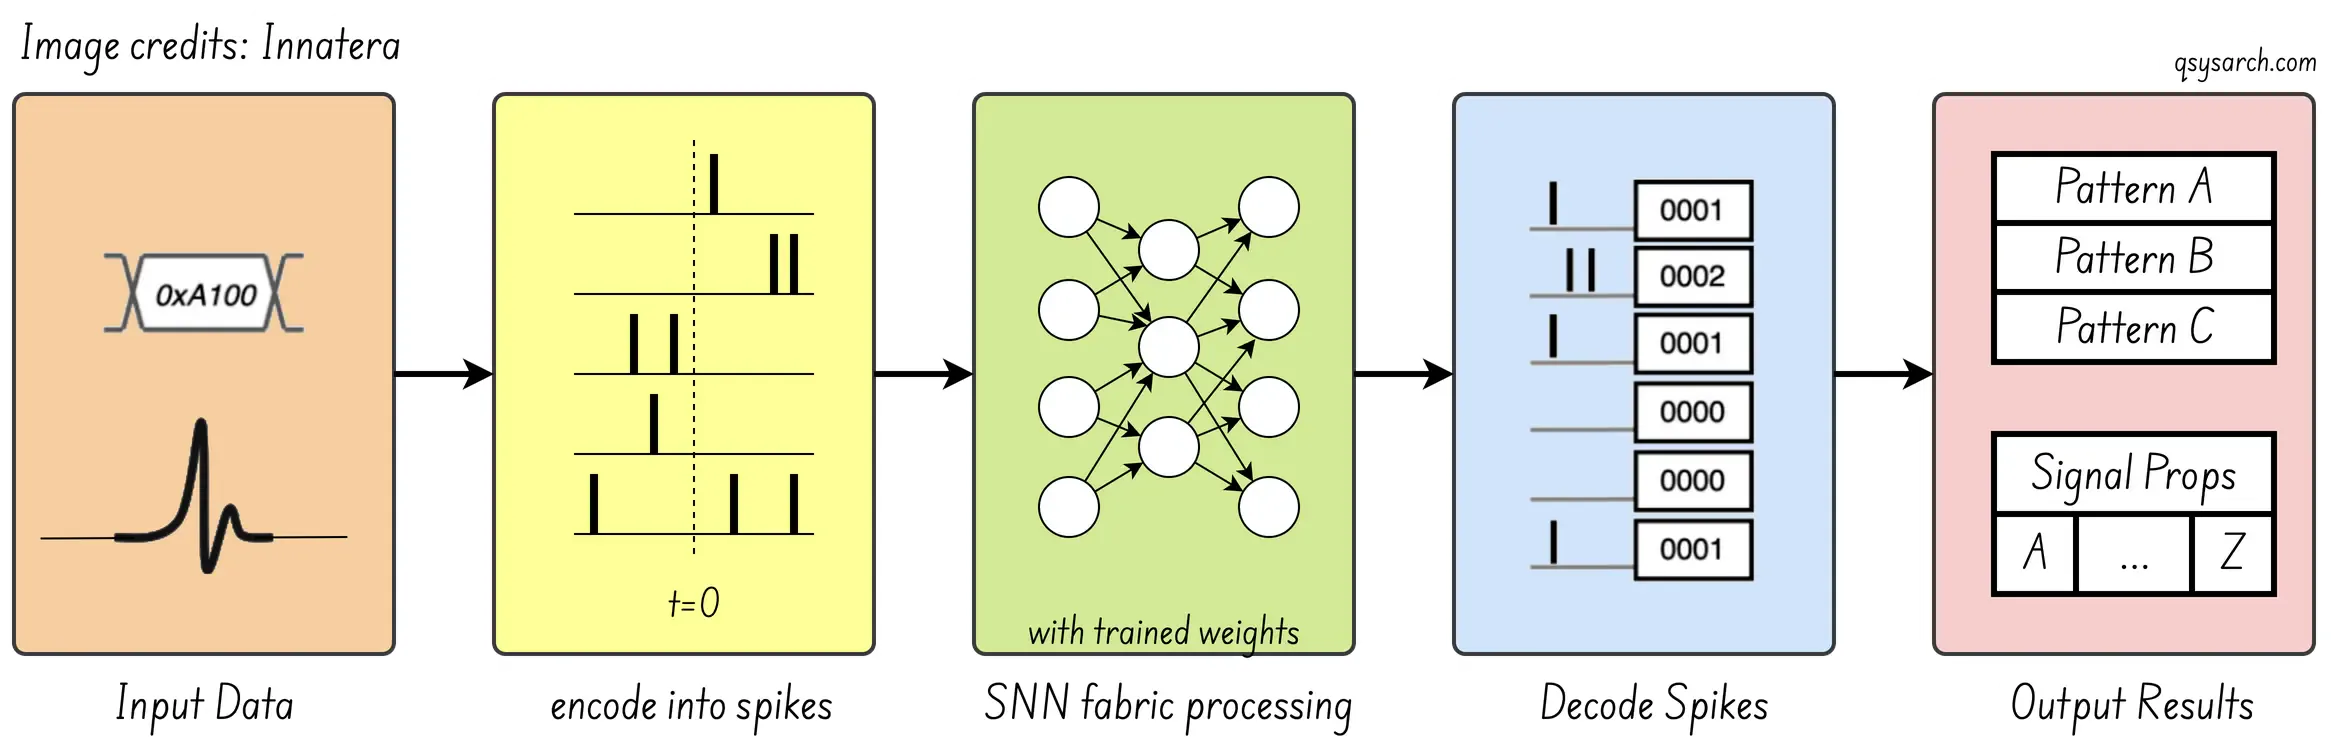
Il blog di Innatera Thinking in Pulses fornisce un’ottima panoramica su come questo verrebbe implementato a livello hardware. Codificare gli “hey” in valori binari, elaborarli tramite una rete neurale ed estrarre le caratteristiche. Fin qui, niente di speciale; si tratta di un processo standard per le reti neurali.
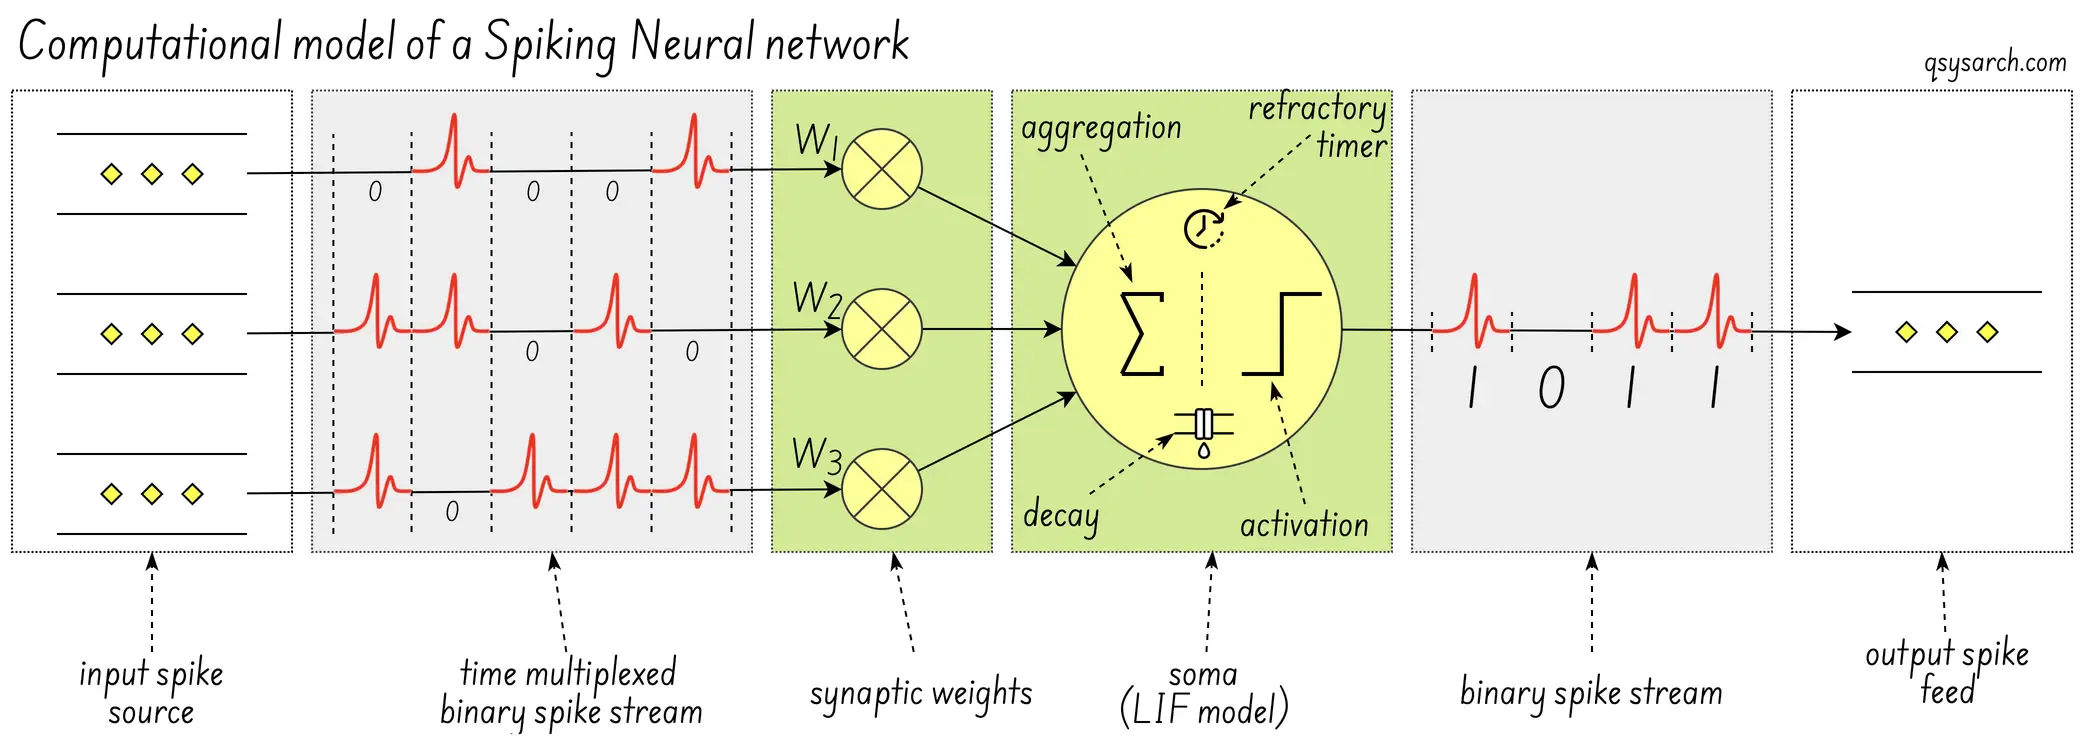
La questione più interessante è come viene implementata questa SNN. L’immagine sottostante sembra essere un “modello computazionale” convenzionale del neurone digitale (immagine fonte) - dove ho aggiunto la nozione esplicita di “leaky integrate-and-fire” (LIF) all’interno del SOMA.
Cosa rende l’implementazione hardware a basso consumo energetico Link to heading
da completare: spiegazioni necessarie per
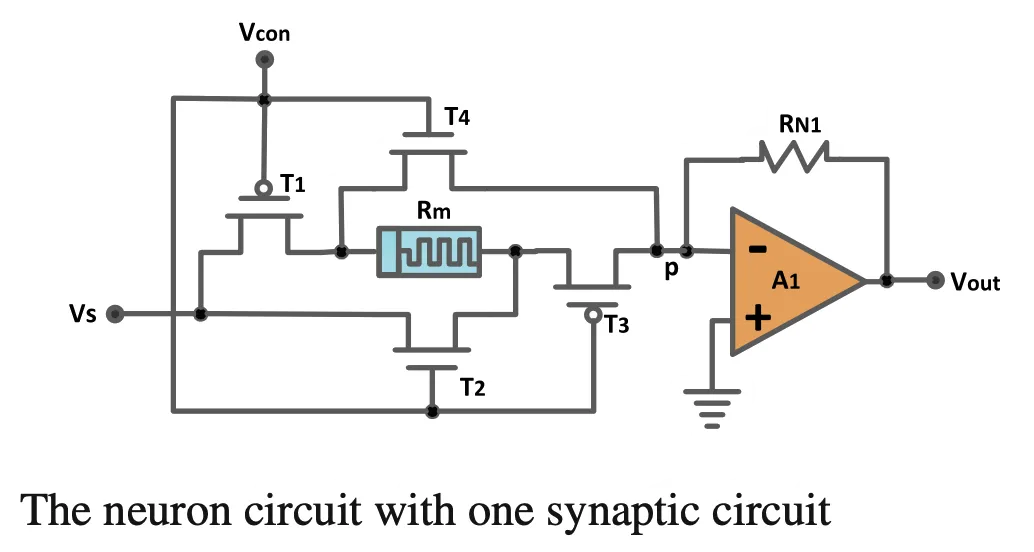
il guadagno in termini di prestazioni (10x, 1000x o più?)
le latenze di propagazione NN raggiungibili
i compromessi e i limiti
Prestazioni della progettazione analogica rispetto a quella digitale.
Consumo energetico relativo a GPU/TPU
Il design di base di Interiora Link to heading
Una domanda che sorge spontanea riguardo al progetto Pulsar è: perché ci sono due SNN? La risposta è che l’architettura SNN analogica (proprietaria a segnale misto analogico) di Innatera è ottimizzata per la massima efficienza energetica e per un’elaborazione degli eventi molto veloce e a bassissimo consumo. L’architettura SNN digitale, invece, è un design più programmabile e flessibile che supporta reti più configurabili a un consumo energetico leggermente superiore. (Fonte)
Sul sito web di Innatera non ci sono molte informazioni sull’architettura interna della loro rete neurale a impulsi, ma fortunatamente hanno alcuni brevetti che possiamo provare a decodificare!
| Data di deposito | Posta di pubblicazione | Titolo (abbreviato) |
| 2021-02-09 | US20220230051A1 | Rete neurale a impulsi |
| 2021-12-09 | EP4505212A1 | Metodo per una pre-elaborazione radar efficiente |
| 26/01/2022 | EP4323923B1 | Rete neurale a impulsi multisegmento riconfigurabile gerarchicamente |
| 14/02/2022 | EP4238006A2 | Struttura computazionale sinaptica multicomponente distribuita |
| 22-03-2022 | EP4226281B8 | Adattamento delle reti neurali ricorrenti tramite sincronia transitoria |
| 2022-04-08 | EP4548260A1 | Calibrazione delle reti neurali a impulsi |
| 2022-06-03 | EP4562540A | Sistema e metodo per encoder analogici a spike efficienti e incentrati sulle caratteristiche. |
| 24/06/2022 | EP4573485A1 | Macchina neurale sequenziale per inferenza ottimizzata per la memoria |
| 2022-09-08 | WO2024038102A1 | Sistema e metodo per il calcolo neurosinaptico modulare riconfigurabile… |
| 18/10/2022 | WO2024153705A1 | segnali misti sintetizzabili feedforward auto-temporizzati e tecnologicamente scalabili... |
| 18/05/2023 | WO2024175770A1 | Moduli e metodi di elaborazione audio neuromorfica sempre attivi |
| 24/05/2023 | WO2024175767A1 | Sistema e metodo per la mappatura di reti neurali a impulsi su superfici neuromorfiche… |
| 19/06/2023 | WO2025012331A1 | Metodo per l'addestramento di modelli di apprendimento automatico per substrati stocastici |
| 22/06/2023 | WO2025017094A1 | Metodo per costruire e implementare reti neurali a impulsi su dispositivi hardware |
| 23/10/2023 | WO2025021573A1 | Sistema e metodo per il rilevamento di presenza tramite un sensore basato su frame. |
| 2023-12-06 | WO2025062034A1 | Estrazione delle caratteristiche e codifica delle reti neurali a impulsi utilizzando la convoluzione |
| 2024-03-08 | WO2023242374A1 | Interconnessione Spike su chip multicast a pacchetto singolo |
Si tratta di un numero considerevole di brevetti per una startup! Per questioni di tempo, ho esaminato solo il primo e l’ultimo brevetto di questo elenco.
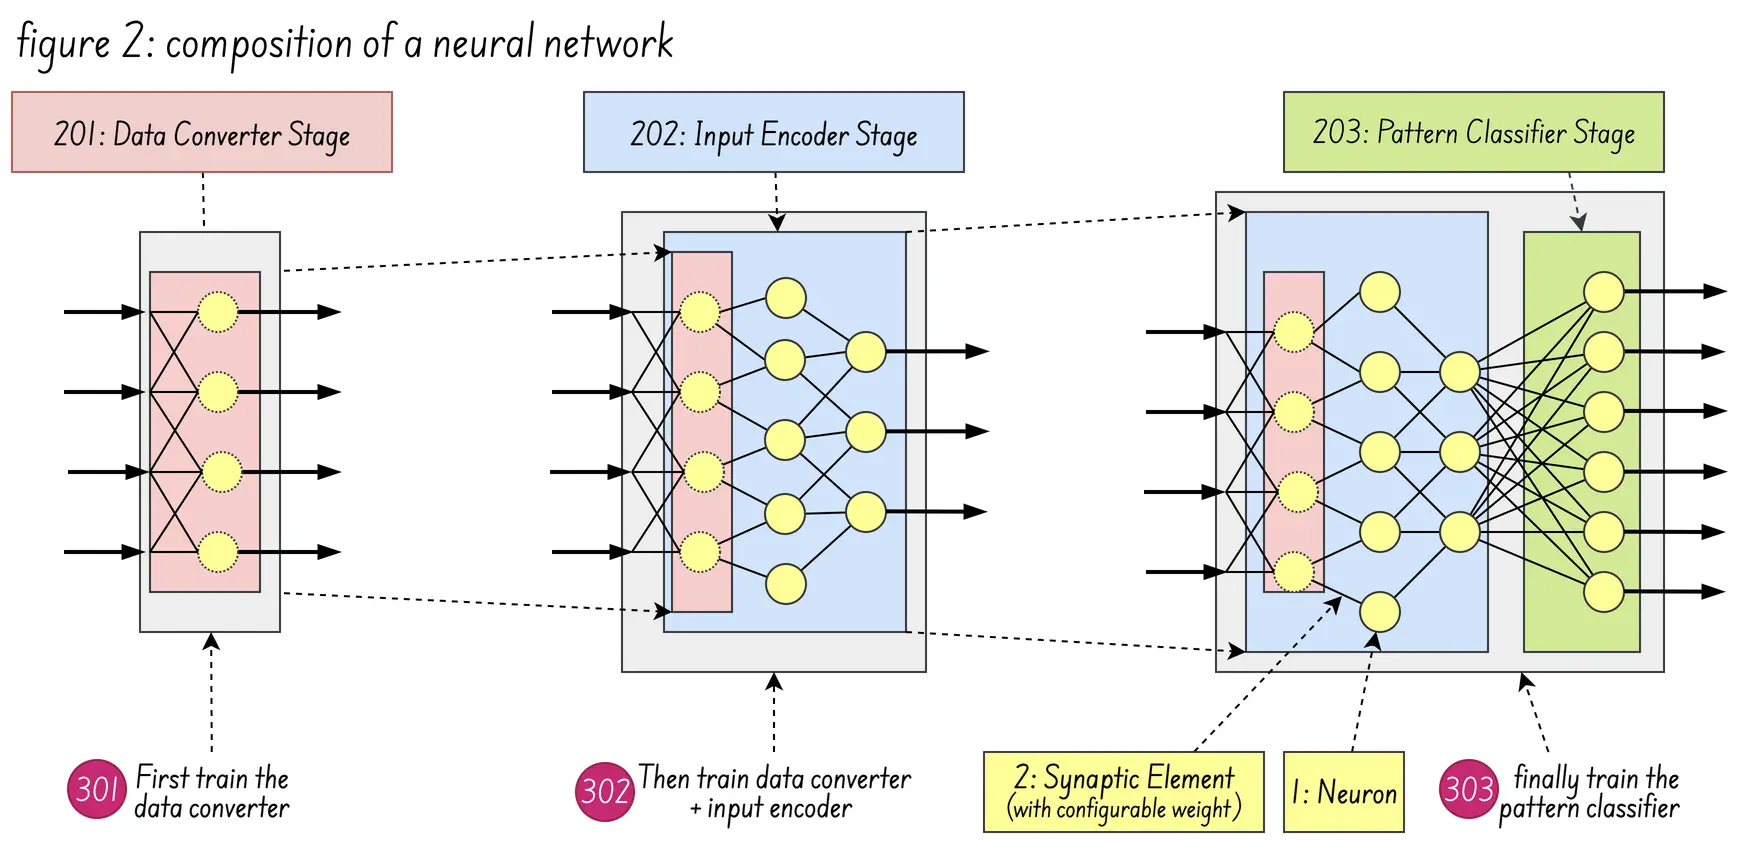
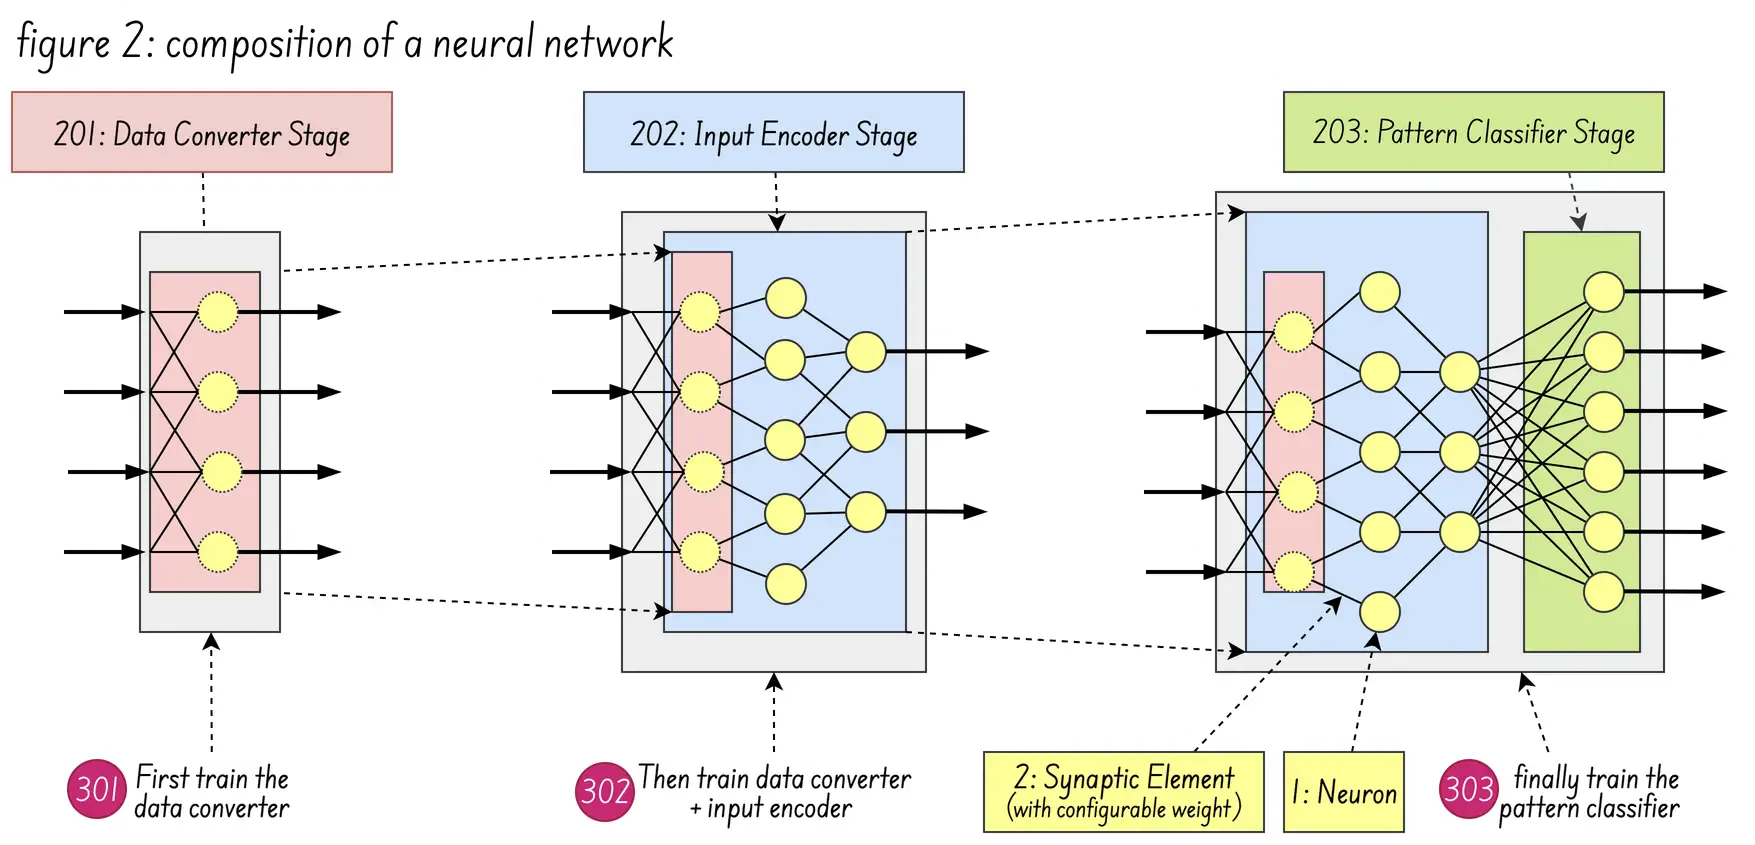
Cominciamo con il primo brevetto US20220230051A1, che sembra essere quello che più si avvicina a descrivere l’effettiva implementazione hardware della SNN: il brevetto è incentrato su una metodologia compositiva per la costruzione di SNN a partire da sottoreti specializzate e pre-addestrate (“celle”) utilizzando un principio di “risposta unica”.
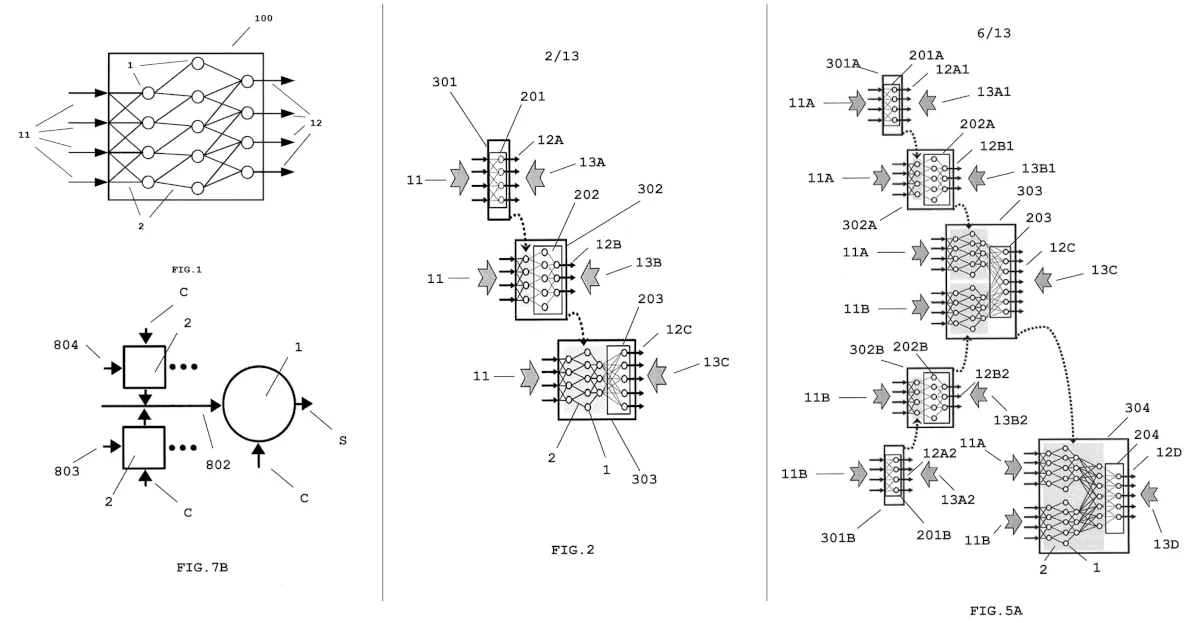
La figura 2 (sotto) mostra la composizione di una rete neurale formata dall’integrazione di uno stadio di conversione dati 201, uno stadio di codifica di input 202 e uno stadio di classificazione di pattern 203. Come per la figura 5B (sopra) mostra come più treni di impulsi temporali vengono fusi in un singolo treno di impulsi fuso.
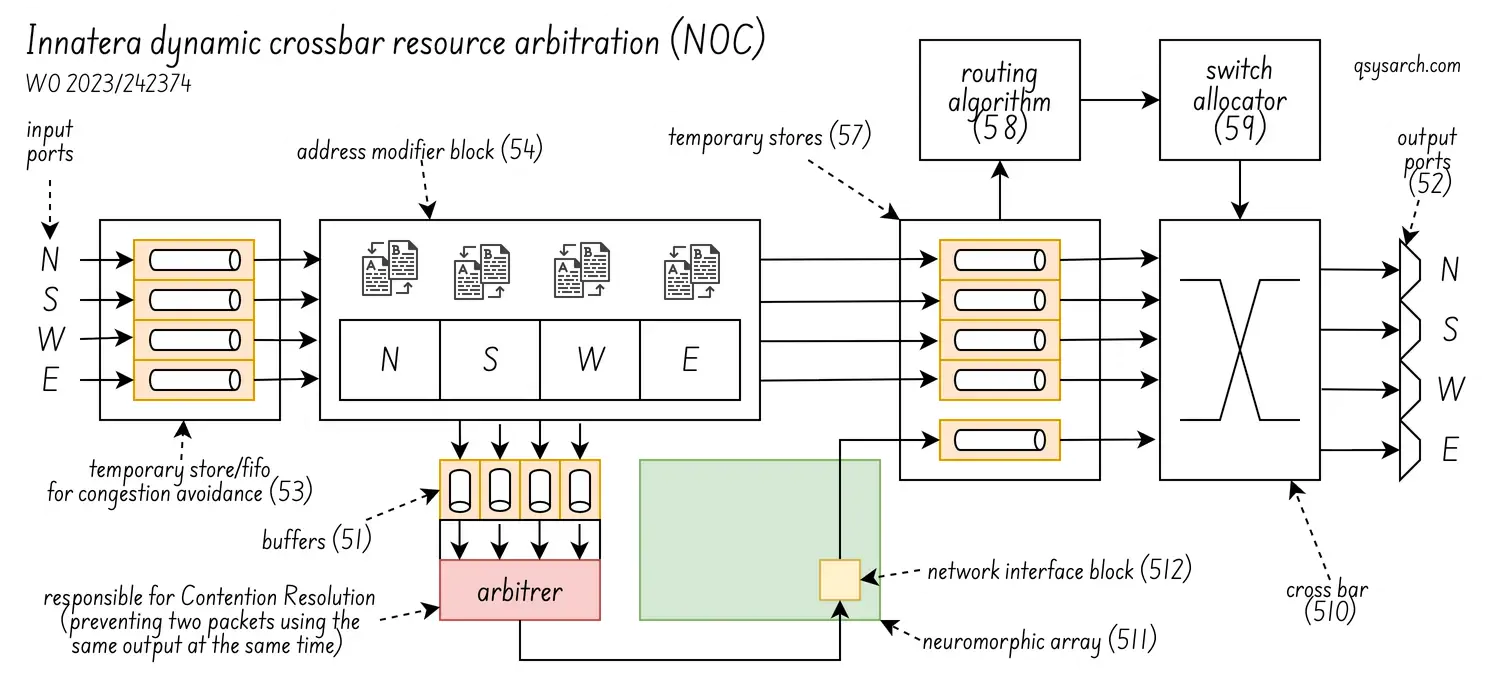
Per quanto riguarda l’ultimo brevetto WO2023242374A1, esso descrive l’architettura Spiking Neural Network di Innatera, utilizzata per implementare in modo efficiente il multicast a pacchetto singolo tramite reti network-on-chip. L’obiettivo è ridurre la duplicazione, la latenza e l’overhead nei sistemi multicore/many-core per la comunicazione multicast.
Il diagramma sottostante (figura 5 nel brevetto) mostra come funziona l’arbitraggio NOC. L’idea è quella di impedire che due (o più) impulsi vengano inviati contemporaneamente alla stessa porta di uscita. Questo è un modo efficiente per instradare gli impulsi a ogni ciclo. Tuttavia, mi chiedo quanto siano profonde le FIFO nell’hardware effettivo.
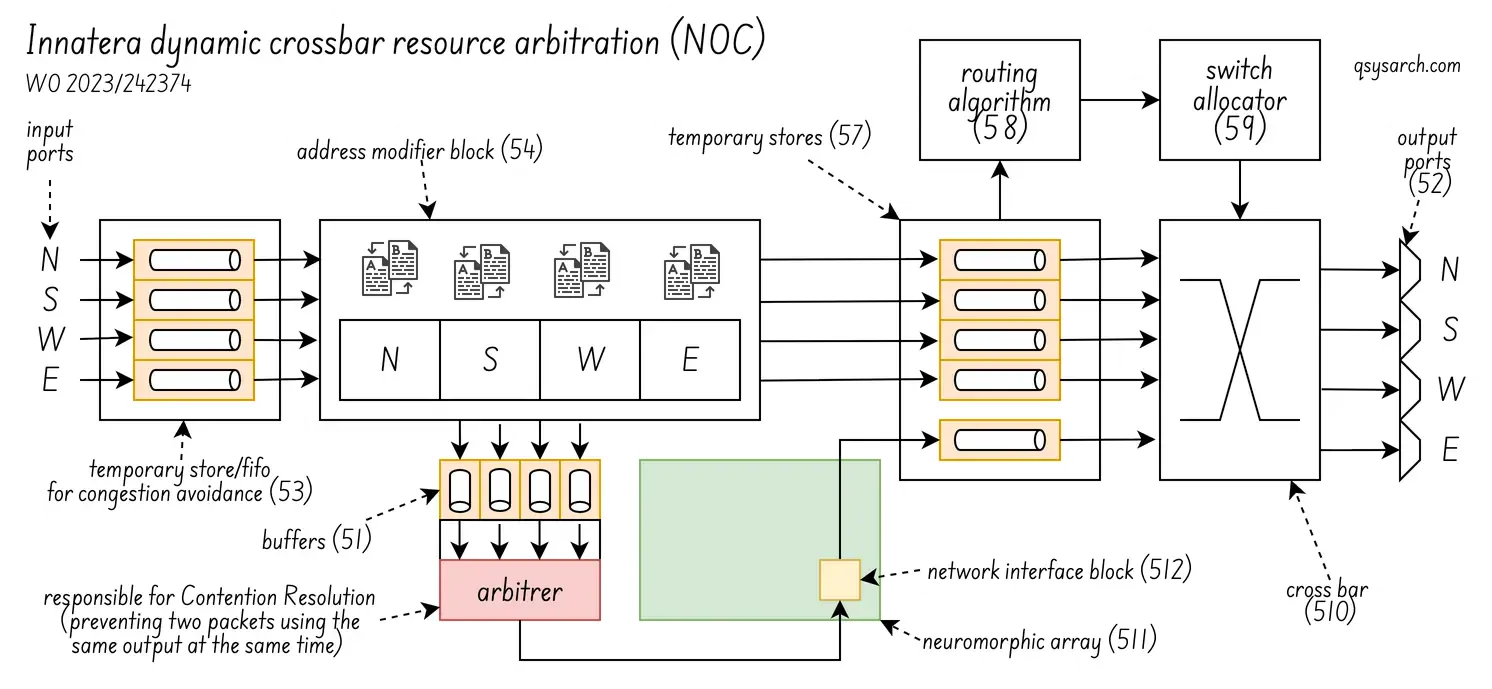
Ciò che non mi è chiaro è come il nucleo e la rete di spike si integrino tra loro: quanti neuroni ci sono nel nucleo? I neuroni del nucleo sono interconnessi o lavorano insieme? Oppure sono unità indipendenti in grado di elaborare classificazioni indipendenti in parallelo?
Altri progetti di reti neurali Link to heading
Non conosco l’esatta architettura di base di Innera, ma esistono numerosi articoli di ricerca che forniscono maggiori dettagli sulle possibili implementazioni. L’articolo “a system design perspective on neuromorphic computer processors [https://iopscience.iop.org/article/10.1088/2634-4386/ac24f5/pdf]” è particolarmente interessante perché confronta diverse architetture.
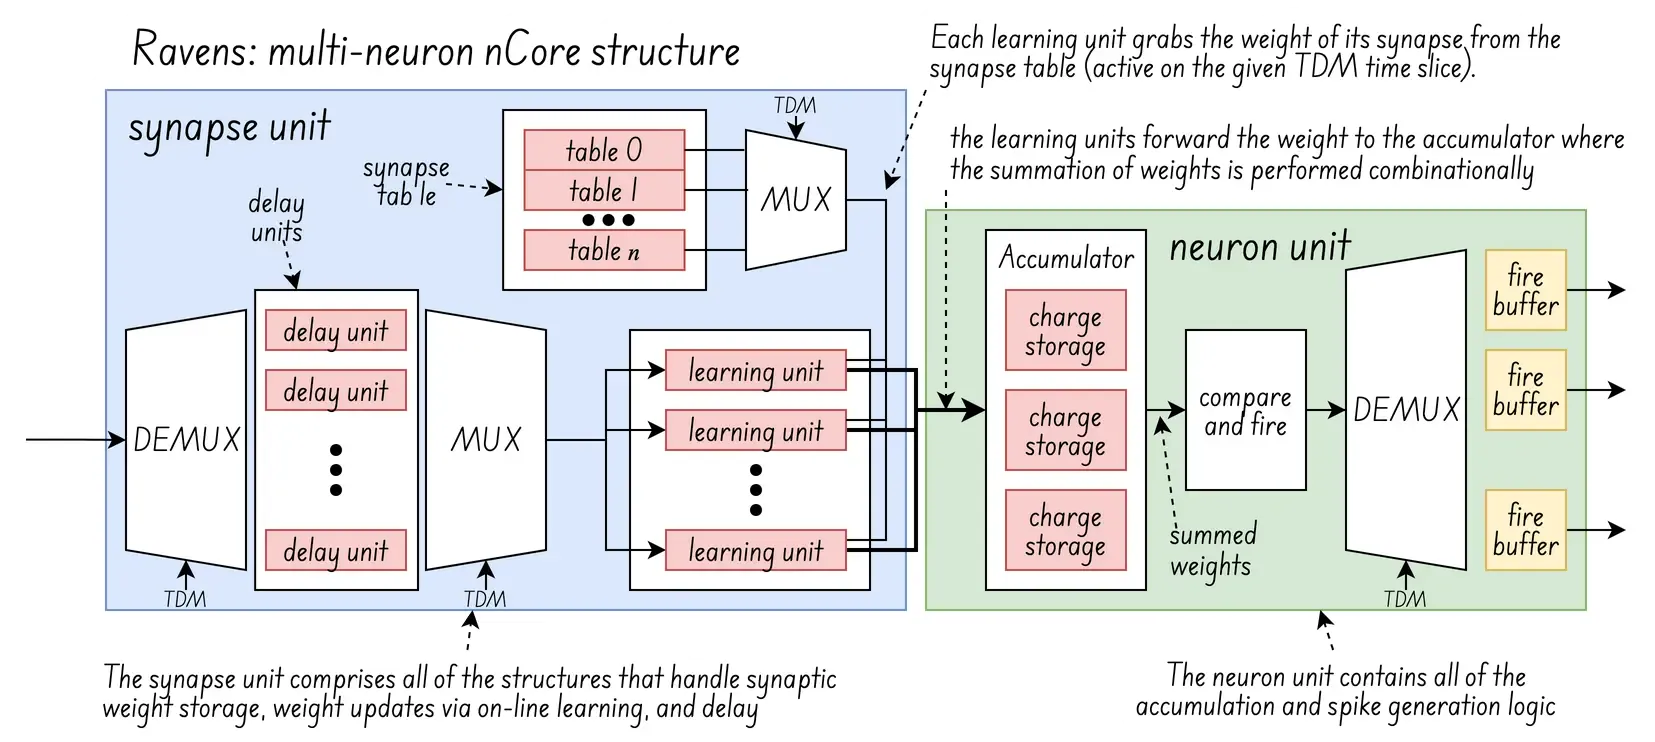
Una di queste architetture è il “sistema neuromorfico riconfigurabile ed estremamente efficiente”, o RAVENS, illustrato nel diagramma sottostante:
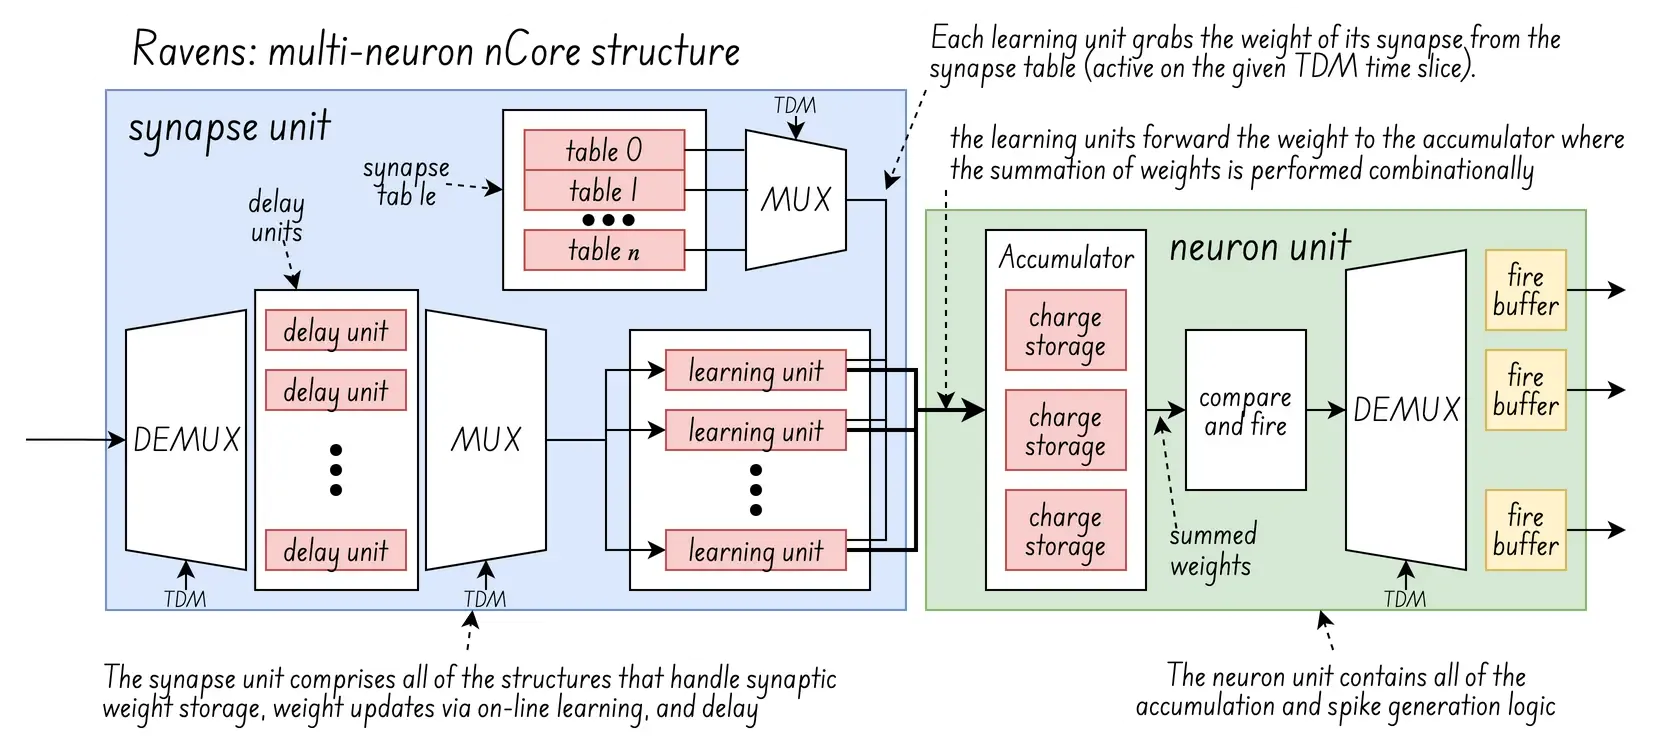 (diagramma aggiornato dall’immagine originale: )
L’idea alla base di RAVENS è quella di collegare in pipeline diversi “neuroni virtuali” utilizzando la multiplazione a divisione di tempo (TDM), in un processo a due fasi costituito da accumulo e aggiornamento.
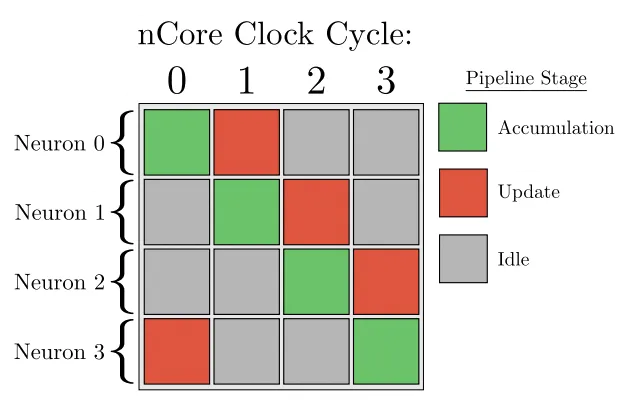
Fase di accumulo: un neurone accumula carica dalle sinapsi di input ad esso collegate e determina se un evento di attivazione debba verificarsi o meno in base alla sua soglia programmata e al suo stato refrattario.
fase di aggiornamento: include modifiche all’apprendimento online dei pesi sinaptici, carica di fuga, incrementi dei contatori refrattari, modifiche di carica accumulate dovute alla transizione fuori da un periodo refrattario
La parte interessante qui è l’apprendimento online: nei circuiti integrati neuromorfici, l’apprendimento online modifica i pesi sinaptici utilizzando algoritmi come l’apprendimento hebbiano o l’apprendimento per rinforzo per rinforzo per regolare la forza sinaptica in tempo reale in base all’input dei neuroni pre- e post-sinaptici.
Nel caso dei core analogici, questa regolazione viene implementata fisicamente tramite dispositivi come memristori o giunzioni tunnel magnetiche (MTJ), il cui stato di resistenza o conduttanza è modulato dall’attività neurale, rappresentando e memorizzando direttamente i pesi sinaptici. Nel caso dei core digitali, invece, ciò avviene tramite le tabelle sinaptiche, almeno nel caso di RAVENS.
Stack software: TALAMO Link to heading
Stack di alto livello Link to heading
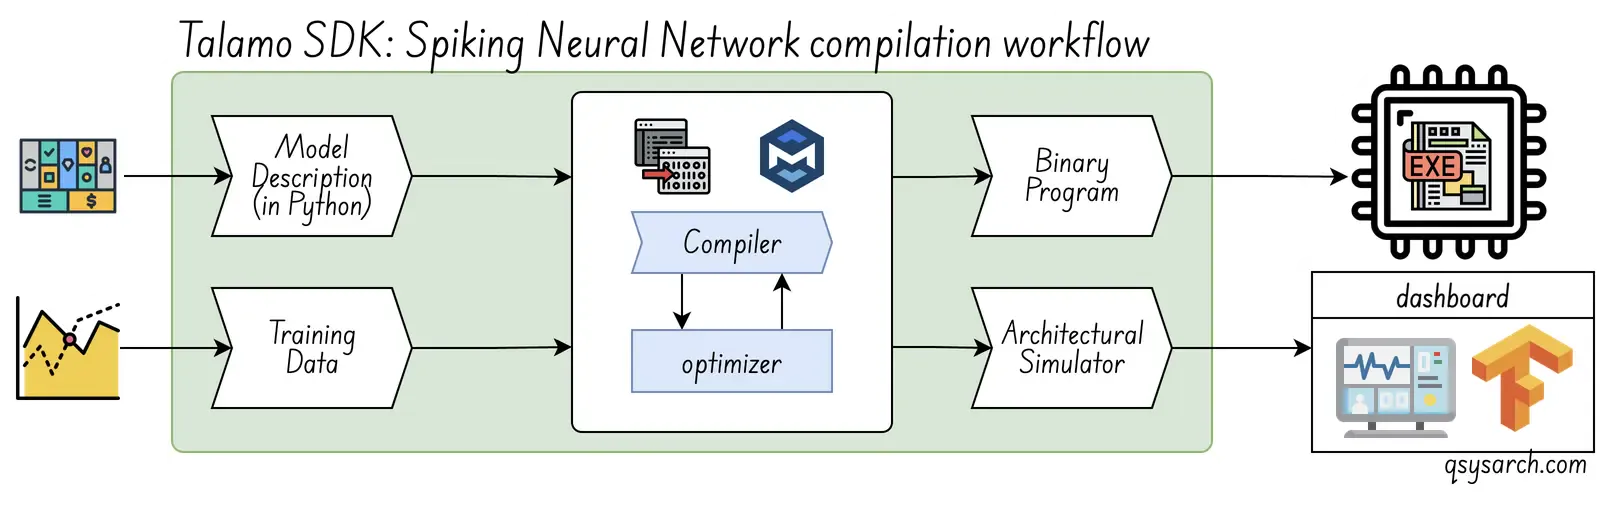
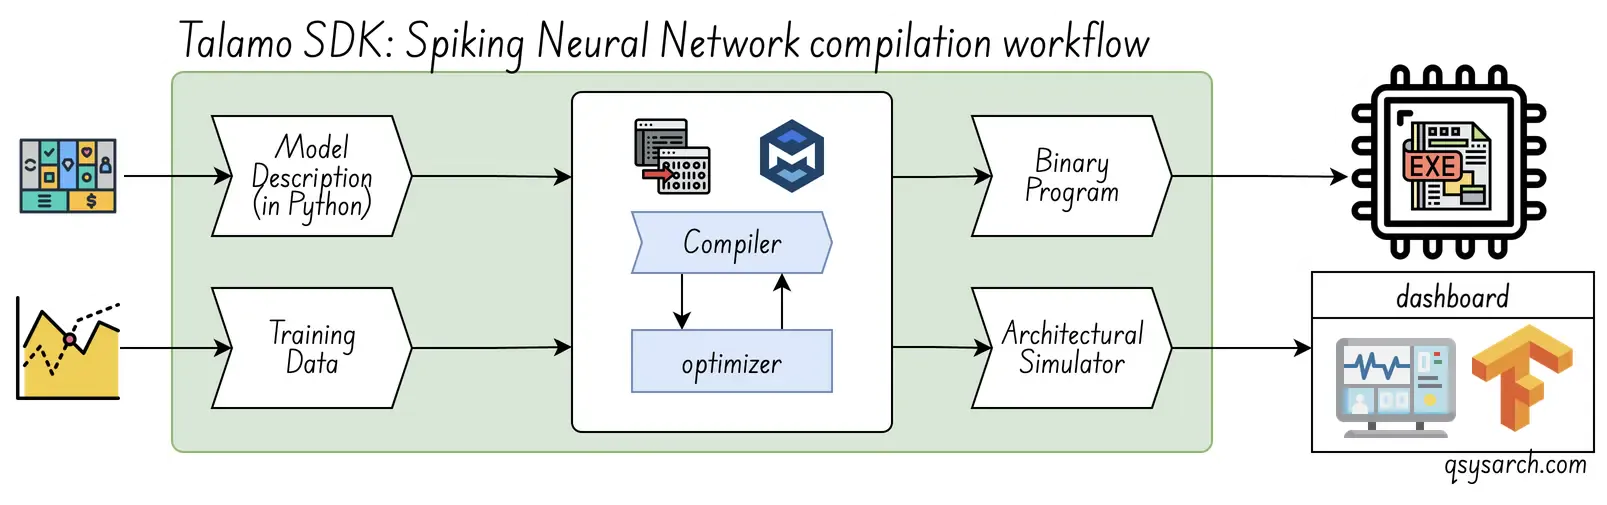
L’offerta di Innatera include un SDN Talamo integrato, che non richiede competenze specifiche sulle reti neurali spiking (SNN), supporta applicazioni end-to-end e utilizza un flusso di lavoro standard per il deep learning. Il kit Talamo aiuta gli sviluppatori a costruire modelli spiking da zero in un ambiente basato su PyTorch. È una batteria inclusa.
Il flusso di lavoro di compilazione è molto standard. Il diagramma seguente è una versione leggermente aggiornata del materiale originale di Innatera, presupponendo che la parte centrale del flusso di lavoro sia il compilatore. Mi chiedo anche se il simulatore prenda in input l’eseguibile binario, nel qual caso verrebbe chiamato emulatore. Sarebbe molto utile avere maggiori informazioni sul processo di ottimizzazione e se ci sono parametri che possono essere modificati dall’utente (come ridurre i pesi a 1,58 bit).
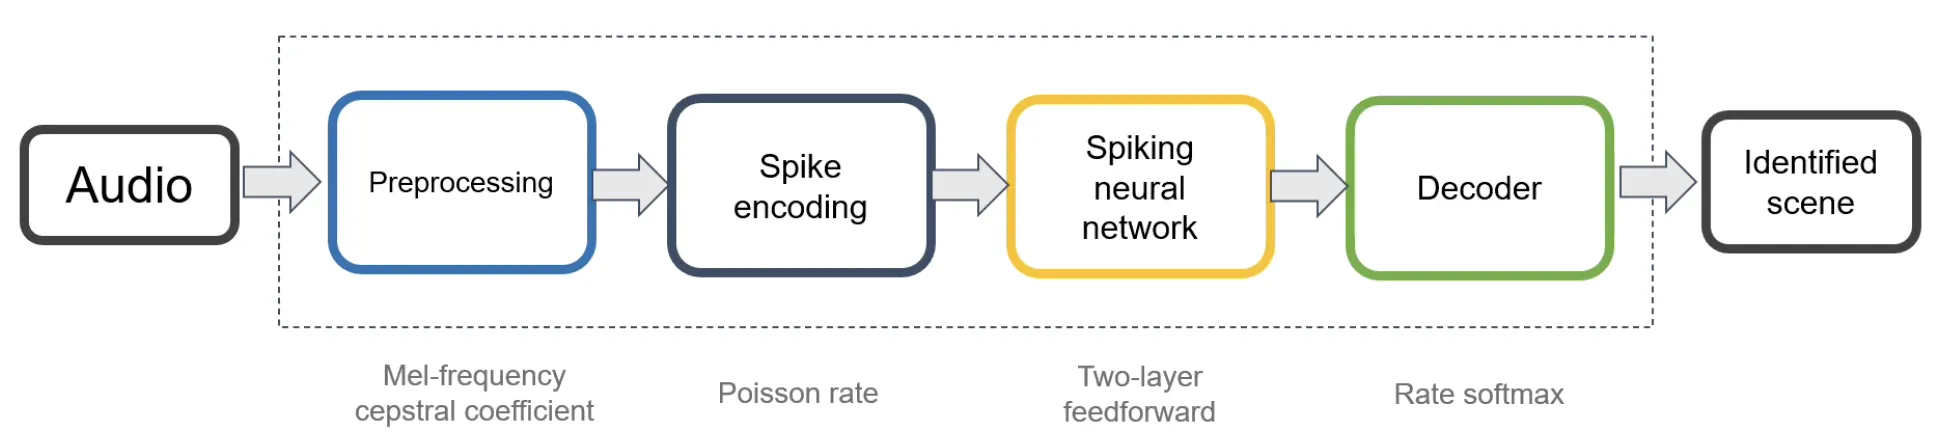
Una volta generato il programma binario, viene utilizzato questo flusso di esecuzione, che segue più o meno il processo definito nel brevetto WO2023242374A1.
Stack di basso livello Link to heading
L’hardware di Innatera include un potente RISC-V, un efficiente GEM e un acceleratore di calcolo SFU. Alcuni utenti esperti potrebbero trovare più interessante avere accesso diretto a questo hardware, piuttosto che limitarsi a caricare i pesi in una libreria C compatibile con l’architettura di Innatera.
Forse offrire una qualche forma di SDK firmware open-source potrebbe essere vantaggioso. In alternativa, si potrebbe pensare a CudaNN, che espone un’esperienza di unità di elaborazione neurale per scopi generali (GPNPU), proprio come Cuda-Q esiste per l’industria quantistica. Così come un NVNLink, simile a NVQLink, che consenta reti NPU su larga scala e architetture ibride?
Forse è questo che si intende con la strada verso il successo commerciale delle tecnologie neuromorfiche [https://www.nature.com/articles/s41467-025-57352-1]: “solo con l’avvento di semplici modelli e strumenti di programmazione, in concomitanza con un accesso API diretto all’hardware, i processori tensoriali hanno raggiunto un’adozione diffusa”. Basta sostituire processori tensoriali con unità di elaborazione neuromorfica (NPU)?
Per me, tutto si riduce all’esperienza utente (UX) e all’esperienza dello sviluppatore (DX). E sono fermamente convinto che la facilità d’uso e l’esperienza dello sviluppatore siano tra i fattori chiave, o pilastri strategici, per creare esperienze di prodotto davvero eccezionali.
 (Crediti immagine: archi monarch)
Conclusion Link to heading
Questo conclude il breve promemoria sull’architettura generale dei circuiti integrati neuromorfici. Senza dubbio, questa architettura hardware rappresenta una tecnologia alternativa e potente, con un potenziale significativo. Tuttavia, si potrebbe obiettare che i circuiti integrati neuromorfici non abbiano ancora trovato un’applicazione rivoluzionaria. Ma non è forse proprio questo l’aspetto più interessante? Significa forse che il mondo che li circonda deve essere creato da zero?
Credo fermamente che il team di Innetera sia tra coloro che “vedono il mondo in modo diverso”. E, in un contesto di crescenti preoccupazioni riguardo all’insaziabile fabbisogno energetico dei data center per l’IA, i circuiti integrati neuromorfici non rappresentano forse una possibile risposta alla domanda fondamentale: come ottenere più valore con meno energia? Se così fosse, cosa sarebbe necessario per scalare i circuiti integrati neuromorfici fino a raggiungere il livello di potenza di calcolo richiesto dai data center per l’IA?
Inoltre, mi chiedo se aggiungere un po’ di silicio fotonica alla SNN potrebbe essere d’aiuto? Potrebbe essere utile sia per il calcolo neurale, sia per creare una rete di interconnessione su larga scala tra i circuiti integrati della SNN.
References Link to heading
- A Multi-Context Neural Core Design for Reconfigurable Neuromorphic Arrays
- Low-latency hierarchical routing of reconfigurable neuromorphic systems
- Mosaic: in-memory computing and routing for small-world spike-based neuromorphic systems
- Neuromorphic Computing in the Netherlands
- Neuromorphic Computing: Energy-efficient smart chip design
- Development of a Neuromorphic Computing System
- TrueNorth: A Deep Dive Into IBM’s Neuromorphic Chip Design
- The road to commercial success for neuromorphic technologies
- A system design perspective on neuromorphic computer processors
- Rapidly develop and deploy next-generation neuromorphic AI
- Integrated platforms and techniques for photonic neural networks
- Photonic Spiking Neural Networks
- Matrix Core Programming on AMD architecture
- Neuromorphic Computing Group; Brain-Inspired Systems at UC Santa Cruz
DrawIO diagrams used in this memo: