Questo promemoria ha lo scopo di comprendere i meccanismi interni di RDMA, e in particolare cosa sia necessario per creare una “NIC conforme a RDMA” che si interconnetta con un sottosistema PCIe, come la connectX-7 da 200 Gb integrata con DGX Spark (immagine a destra).
RDMA come protocollo “client-server” Link to heading
Iniziamo questo promemoria con una panoramica del protocollo RDMA.
Configurazione RDMA Link to heading
Durante la configurazione dei canali dati RDMA, i buffer di memoria devono essere registrati con la scheda di rete prima di poter essere utilizzati. Il processo di registrazione consiste nei seguenti passaggi:
Blocca la memoria in modo che non possa essere scambiata dal sistema operativo.
Memorizza le informazioni di traduzione degli indirizzi nella scheda di rete.
Imposta le autorizzazioni per la regione di memoria.
Creare una coppia di chiavi remote e locali, utilizzate dalla scheda di rete durante l’esecuzione dei comandi RDMA.
Coppie di code RDMA Link to heading
La comunicazione RDMA si basa su un insieme di tre code
SQ: Coda di invioRQ: Coda di ricezioneCQ: Coda di completamento
La coppia di code RDMA, o QP, si riferisce alla coda di invio e alla coda di ricezione.
Elementi della coda di lavoro RDMA Link to heading
Le applicazioni inviano un job utilizzando una richiesta di lavoro, detta anche elemento della coda di lavoro (WQE). Una richiesta di lavoro è una piccola struttura con un puntatore a un buffer:
In una coda di invio, è un puntatore a un messaggio da inviare.
In una coda di ricezione: indica dove deve essere inserito un messaggio in arrivo.
Una volta completata una richiesta di lavoro, l’adattatore crea un elemento della coda di completamento e lo inserisce nella coda di completamento
Esempio semplice di scrittura RDMA Link to heading
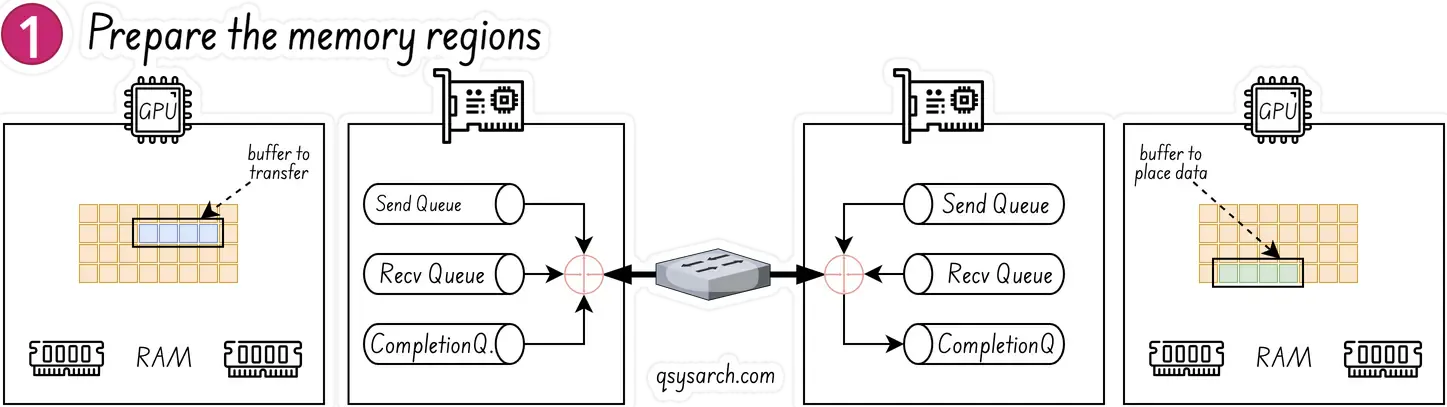
Le entità mittente (a sinistra) e ricevente (a destra) hanno creato le proprie coppie di code e code di completamento, oltre ad aver registrato delle regioni in memoria per l’esecuzione dell’RDMA. L’entità mittente identifica un buffer che desidera spostare verso l’entità ricevente. L’entità ricevente ha un buffer vuoto allocato per i dati da inserire.
L’entità ricevente a destra crea un elemento della coda di lavoro WQE WOOKIE e lo inserisce nella coda di ricezione. Questo WQE contiene un puntatore al buffer di memoria in cui verranno inseriti i dati. Anche l’entità mittente a sinistra crea un WQE che punta al buffer nella sua memoria che verrà trasmesso.
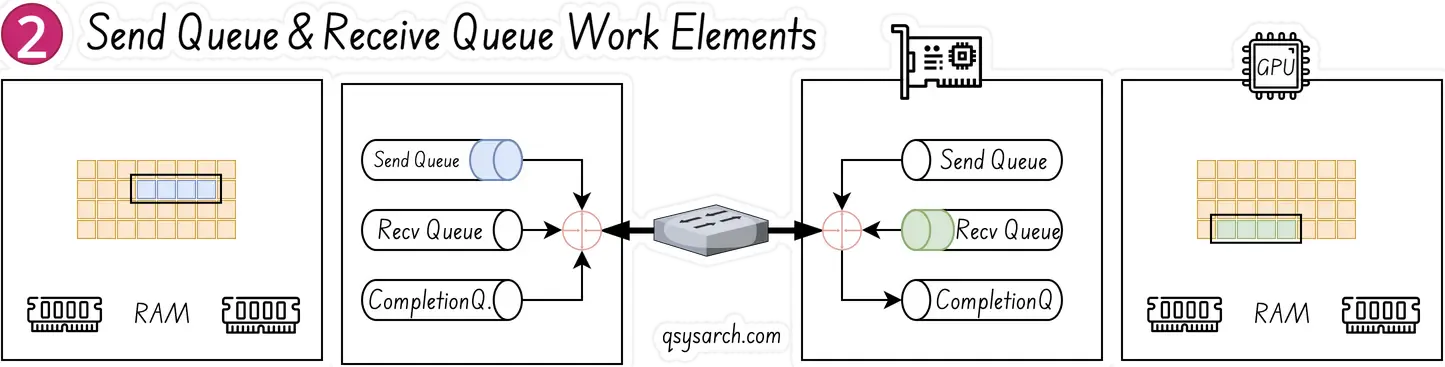
La NIC (intesa come NIC hardware compatibile con RDMA, detta anche RNIC) effettua costantemente il polling e la ricerca di WQE nella coda di invio; questo processo avviene senza il coinvolgimento della GPU e della CPU, in quanto il polling interessa solo la RNIC. Una volta che la CPU invia un WQE, la RNIC lo elabora sull’entità mittente e inizia a trasmettere i dati dalla regione di memoria all’entità ricevente. Quando i dati iniziano ad arrivare all’entità ricevente, la RNIC elabora il WQE nella coda di ricezione per determinare la posizione in cui collocare i dati.
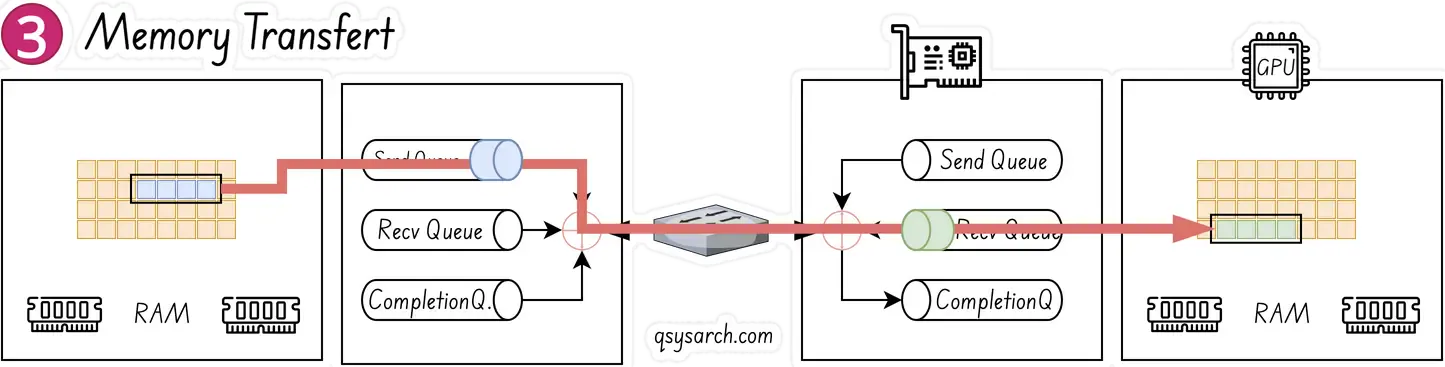
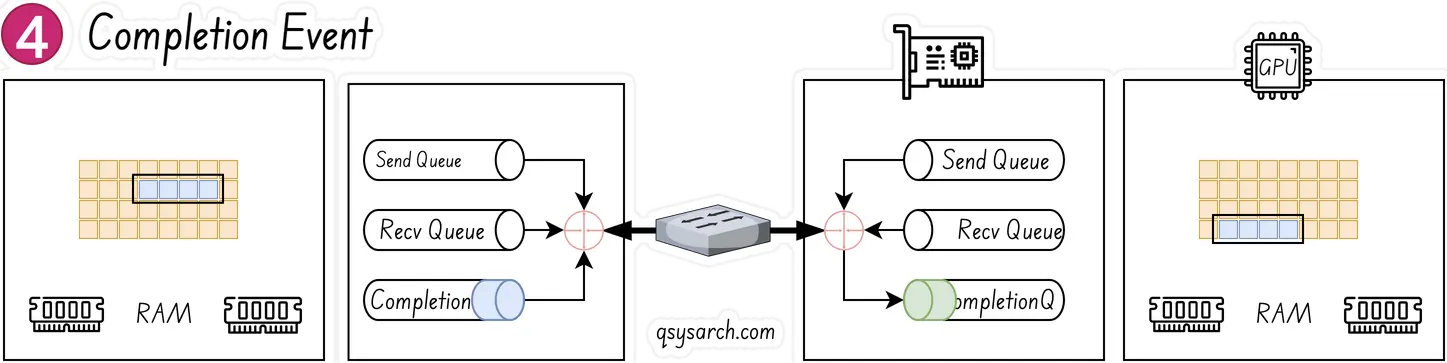
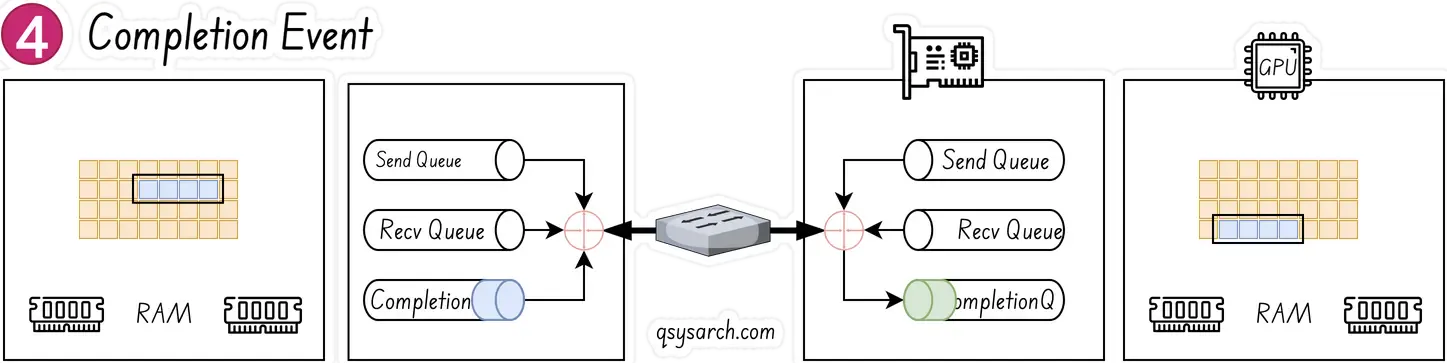
Come ultimo passaggio, al termine del trasferimento dei dati, l’RNIC crea un evento di completamento CQE “COOKIE”, che viene inserito nella coda di completamento. L’evento indica che la transazione è stata completata. Per ogni WQE consumato viene generato un CQE.
Lettura e scrittura RDMA Link to heading
È importante notare che solo il lato mittente è attivo; il lato ricevente è passivo; il lato passivo non esegue alcuna operazione, non utilizza cicli della CPU e non riceve alcuna indicazione che sia avvenuta un’operazione di “lettura” o di “scrittura”.
Per avviare un’operazione di lettura o scrittura RDMA, la richiesta di lavoro deve includere:
l’indirizzo di memoria virtuale del lato remoto
la chiave di registrazione della memoria del lato remoto
Ciò significa che il lato attivo deve ottenere in anticipo l’indirizzo e la chiave del lato passivo.
RDMA dal punto di vista del pacchetto di rete Link to heading
Questa parte si basa sull’eccellente lavoro di Toni Pasanen su Network Times
Creazione della sessione RDMA Link to heading
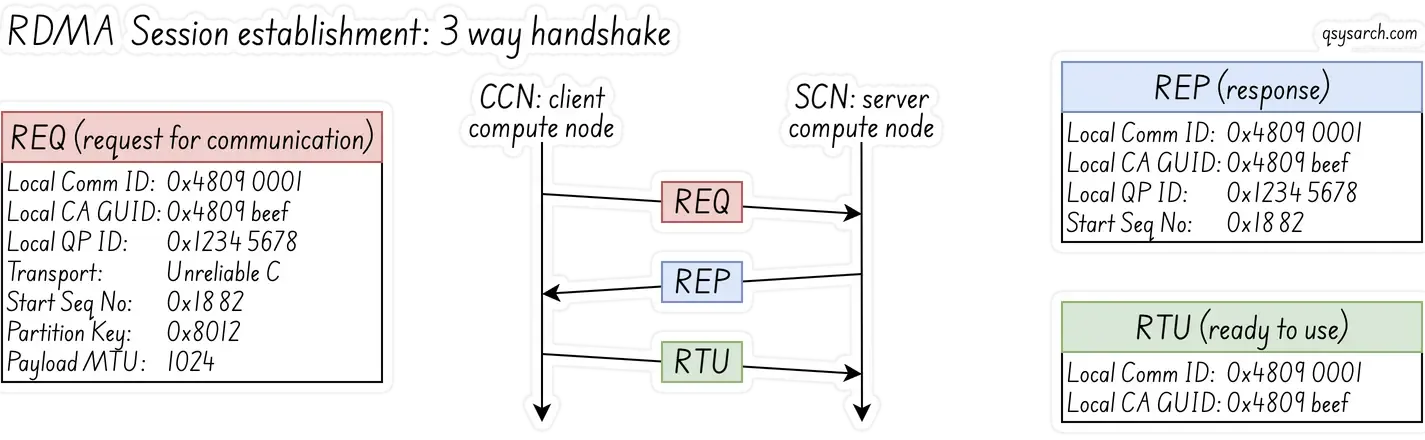
L’applicazione sul nodo di calcolo client (detto anche CCN) avvia la procedura di connessione inviando un messaggio di richiesta di comunicazione (REQ) all’applicazione sul nodo di calcolo server (SCN).
Il messaggio REQ include un mezzo per identificare la RNIC fisica e la porta:
- Identificatore di comunicazione locale (
LID) e identificatore univoco globale per l’adattatore di canale (GUID CA locale). Il GUID CA locale identifica la RNIC, mentre l’ID di comunicazione locale identifica la porta sulla NIC.
Il messaggio REQ contiene anche tutte le meta-informazioni relative alle coppie di code.
Numero QP locale (0x1234 5678)
Tipo di servizio QP (Connessione inaffidabile)
Numero di sequenza del pacchetto iniziale (PSN: 0x1882)
Valore della chiave di partizione (0x8012)
dimensione del carico utile (1024).
Il messaggio REP conferma la ricezione dei metadati QP. Infine, il client invia un messaggio Ready to Use (RTU) per confermare al server che la QP è stata stabilita. Una volta stabilita la sessione, l’applicazione sul CCN può avviare il processo di scrittura RDMA.

Terminologia:
CCN: nodo di calcolo client
SCN: nodo di calcolo del server
PD: Dominio di protezione
L_Key, R_Key: tasti locali e remoti
QP: Coppia di code (QP) = Coda di invio + Coda di ricezione.
CQ: Coda di completamento
RC: Connessione affidabile
UD: Datagramma inaffidabile
RICHIESTA: CCN invia ID locale, numero QP, P_Key e PSN.
Risposta: SCN risponde con ID, informazioni QP e PSN.
RTU: Pronto all’uso: CCN conferma la connessione.
WR: Richiesta di lavoro
Messaggio di richiesta di lavoro RDMA Link to heading
Da completare in seguito - non c’è nulla di eccezionale nei messaggi WR che valga la pena menzionare qui - se desideri maggiori dettagli, consulta Network Times di Toni Pasanen e InfiniBand Transport Protocol
RDMA dal punto di vista del trasferimento di rete Link to heading
Connessioni RDMA inaffidabili Link to heading
RDMA UC (Unreliable Connected) non esegue la ritrasmissione; si affida invece all’applicazione per gestire l’affidabilità e i pacchetti persi, poiché UC è un servizio di datagrammi senza connessione e non affidabile. La scheda di interfaccia di rete (NIC) scarta i pacchetti senza tentare la ritrasmissione e l’applicazione è responsabile del monitoraggio e della richiesta dei dati mancanti. Questo è in contrasto con i QP (Question Point) di connessione affidabile (RC), in cui l’hardware di rete gestisce le ritrasmissioni. Quindi, come fa un’applicazione RDMA UC a sapere se un pacchetto è andato perso?
- Rilevamento della perdita di pacchetti a livello di applicazione
Numeri di sequenza dei pacchetti (PSN): l’applicazione assegna un numero univoco e sequenziale a ciascun pacchetto inviato. Il ricevitore tiene traccia di questi numeri di sequenza. Un’interruzione nella sequenza dei numeri indica che uno o più pacchetti sono andati persi.
Timeout: Il protocollo a livello applicativo può implementare un meccanismo di timeout. Se una risposta o una conferma non viene ricevuta entro un determinato periodo, l’applicazione presume che il pacchetto sia andato perso e avvia una ritrasmissione.
- Ripristino della perdita di pacchetti a livello di applicazione

Se il ricevitore rileva la perdita di un pacchetto nella sequenza, deve informare il mittente affinché lo ritrasmetta. Se anche il pacchetto utilizzato per informare il mittente viene perso, la situazione può diventare piuttosto complessa.
Timeout: Il mittente si aspetta che il destinatario confermi la ricezione dei pacchetti. In caso contrario, il mittente reinvia proattivamente il pacchetto non ancora confermato.
Dobbiamo sempre creare un modulo di affidabilità separato sopra RDMA QP? Non necessariamente. In alcune situazioni, è accettabile considerare la perdita di un pacchetto come motivo per contrassegnare l’intera sessione come fallita, anziché limitarsi a reinviare il pacchetto mancante. Questo approccio funziona perché la rete sottostante è solitamente sufficientemente affidabile da garantire un’affidabilità estremamente elevata, ad esempio un solo errore ogni mille miliardi di pacchetti.
Controllo del flusso prioritario (PFC) e notifica esplicita di congestione (ECN) Link to heading
Il protocollo RDMA UC non è intrinsecamente in grado di rilevare la perdita di un pacchetto, poiché si tratta di un protocollo inaffidabile; pertanto, la gestione della perdita di pacchetti è affidata all’applicazione o a un livello superiore. La garanzia di “assenza di perdita” offerta da RDMA è ottenuta grazie a tecnologie di rete sottostanti come il Priority Flow Control (PFC) e l’Explicit Congestion Notification (ECN), che impediscono la perdita di pacchetti fin dall’inizio.
Questo protocollo incapsula il segmento dati RDMA nel segmento dati UDP, aggiunge l’intestazione UDP, quindi l’intestazione IP e infine l’intestazione Ethernet, formando un pacchetto dati a tre livelli. Può essere classificato utilizzando il campo PCP nella VLAN Ethernet o il campo DSCP nell’intestazione IP.
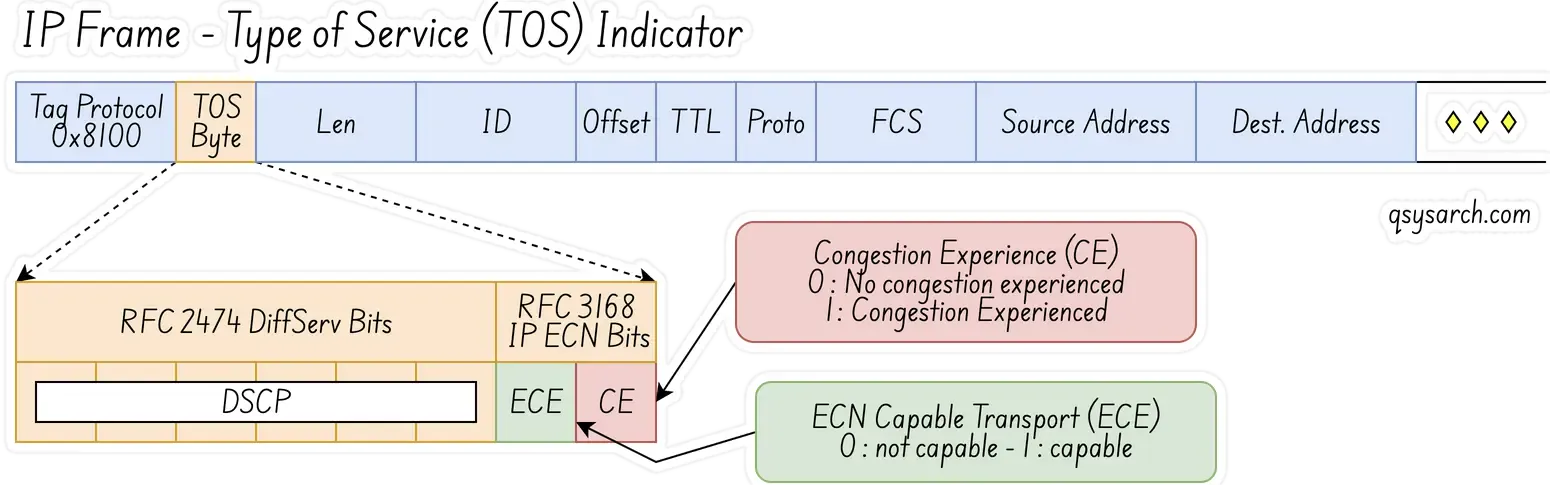
In termini semplici, nel caso di una rete di livello 2, il PFC utilizza il bit PCP nella VLAN per distinguere i flussi di dati. Nel caso di una rete di livello 3, il PFC può utilizzare sia PCP che DSCP, in modo che i diversi flussi di dati possano beneficiare di un controllo di flusso indipendente. Attualmente, la maggior parte dei data center utilizza reti di livello 3, quindi l’utilizzo di DSCP è più vantaggioso rispetto a PCP.
RDMA dal punto di vista del PCIe Link to heading
 L’analisi PCIe si basa sull’eccellente articolo: SmartIO: Zero-overhead Device Sharing through PCIe Networking di Dolphin.
Registri degli indirizzi base PCIe Link to heading
La caratteristica distintiva del PCIe è che i dispositivi vengono mappati nello stesso spazio di indirizzamento della CPU e della memoria di sistema, come illustrato nella figura a destra. Grazie a questa mappatura, una CPU può leggere e scrivere nella memoria del dispositivo nello stesso modo in cui accede alla memoria di sistema. Questo concetto è spesso indicato come I/O mappato in memoria (MMIO).
In fase di inizializzazione, quando il sistema controlla l’albero PCIe, viene riservato un intervallo di indirizzi di memoria (dal BIOS o dal kernel) per le regioni di memoria di ciascun dispositivo. Questo indirizzo riservato viene quindi scritto nei registri degli indirizzi di base (BAR) del dispositivo (https://stackoverflow.com/questions/30190050/what-is-the-base-address-register-bar-in-pcie). Un dispositivo può avere fino a sei BAR.
Interruzioni PCIe (MSI) Link to heading
Il PCIe utilizza interruzioni segnalate da messaggi (MSI) al posto delle linee di interruzione fisiche. I dispositivi che supportano MSI inviano una scrittura in memoria alla CPU, utilizzando un indirizzo e un payload specifici forniti dal sistema. La CPU legge questa scrittura in memoria e utilizza le informazioni per generare un’interruzione.
MSI-X è un’estensione di MSI che consente fino a 2048 diversi vettori di interrupt. Un vantaggio è che un interrupt MSI-X può indirizzare un core specifico della CPU nei sistemi multi-core. Inoltre, diversi vettori MSI-X possono segnalare diversi tipi di eventi.
Design ottimizzato per ConnectX-8 Link to heading
[1] Da GPU a GPU attraverso due socket CPU: nel design tradizionale questo percorso può incontrare colli di bottiglia della CPU host e tra socket, limitando a 25 GB/s o meno in base all’utilizzo del collegamento tra CPU. Al contrario, il design ottimizzato basato su CX8 consente fino a 50 GB/s per GPU di larghezza di banda I/O per tutta la comunicazione tra GPU all’interno del cluster, poiché NCCL instrada tutto il traffico direttamente attraverso la rete.
[2] Comunicazione GPU-NIC: l’architettura ottimizzata fornisce a ciascuna GPU una larghezza di banda di 50 GB/s in una configurazione GPU-NIC 2:1, indipendentemente dal fatto che la GPU o il sistema host supportino PCIe Gen5 o Gen6.
[3] Da GPU a GPU attraverso lo stesso switch PCIe: i sistemi dotati di PCIe Gen6 beneficiano di una larghezza di banda doppia rispetto a Gen5, accelerando significativamente i trasferimenti GPU peer-to-peer sullo stesso switch PCIe.
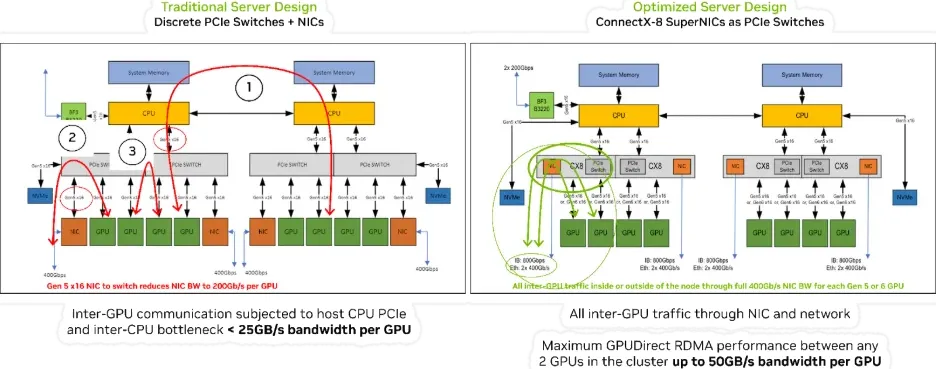
Riferimento: Architettura della piattaforma SuperNICs di NVIDIA ConnectX-8
RDMA da una prospettiva di API programmatica Link to heading
Questa sezione si basa sul tutorial Netdev 0x16 RDMA.
Impostare Link to heading
Creare gli oggetti richiesti, inclusi PD e CQ.
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
    .cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
Memoria dei registri Link to heading
Assegna un buffer per contenere i dati e registralo con libibverbs:
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
Stabilire la connessione con librdmacm Link to heading
Simile ai socket, con un’interfaccia asincrona basata sugli eventi. (Non strettamente necessario, ma fornisce un’astrazione che copre più protocolli di trasporto) Per prima cosa, crea un “canale eventi”:
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
Entrambi i lati risolvono l’indirizzo del server:
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
Il lato passivo (SCN) crea e associa un “ID” di ascolto e si mette in ascolto:
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
Il lato attivo crea l’ID e risolve l’indirizzo del server:
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
Ciclo di eventi per la gestione degli eventi di connessione:
struct rdma_cm_event *event;
while (true) {
    err = rdma_get_cm_event(test.channel, &event);
    switch (event->event) {
        case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
    }
    rdma_ack_cm_event(event);
}
Eventi importanti da gestire:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
Invia la richiesta di lavoro ricevuta Link to heading
Compilare un elenco scatter e una richiesta di lavoro in coda per ricevere la coda:
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
Compila l’elenco di raccolta e la richiesta di lavoro in coda per inviarla alla coda:
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
Sondaggio per il completamento Link to heading
Controllo non bloccante per le voci della coda di completamento
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
    end_flag = true;
    /* consume cq->status, cq->wr_id, etc */
    err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
RDMA da una prospettiva diretta GPU Link to heading
È qui che inizia a diventare… molto… confuso. Qual è la relazione tra “GPUDirect RDMA” e RDMA? Come accennato in un precedente post, la documentazione ufficiale di Nvidia afferma che non c’è alcuna relazione! Per capirne il motivo, dobbiamo tornare alle origini, quando era ancora una tecnologia Mellanox, intorno al 2016. Ecco cosa diceva la specifica a quel tempo:
L’ultima innovazione nelle comunicazioni GPU-GPU è GPUDirect RDMA. Questa nuova tecnologia fornisce un percorso dati P2P (Peer-to-Peer) diretto tra la memoria della GPU e/o i dispositivi NVIDIA HCA/NIC. Ciò si traduce in una significativa riduzione della latenza nelle comunicazioni GPU-GPU e alleggerisce completamente il carico sulla CPU, escludendola da tutte le comunicazioni GPU-GPU attraverso la rete.
GPUNetIO Link to heading
Dalle specifiche di GPUNetIO spec, viene menzionato che per abilitare l’interazione tra la memoria NIC e la GPU:
Per consentire alla scheda di rete di inviare e ricevere pacchetti utilizzando la memoria GPU, caricare il modulo del kernel NVIDIA nvidia-peermem, in genere incluso nell’installazione del CUDA Toolkit.
Un’applicazione di rete per l’elaborazione di pacchetti tramite GPU può essere suddivisa in due fasi fondamentali:
Fase di configurazione sulla CPU (configurazione dei dispositivi, allocazione della memoria, avvio dei kernel CUDA…)
Fase del percorso dati in cui GPU e NIC interagiscono per svolgere le loro funzioni
Durante la fase di configurazione sulla CPU, le applicazioni devono:
Prepara tutti gli oggetti sulla CPU.
Esporta un gestore GPU per loro.
Avvia un kernel CUDA passando il gestore GPU dell’oggetto per lavorare con l’oggetto durante il percorso dati.
Per questo motivo, DOCA GPUNetIO è composto da due librerie:
libdoca_gpunetio con funzioni invocate dalla CPU per preparare la GPU, allocare memoria e oggetti
libdoca_gpunetio_device con funzioni invocate dalla GPU all’interno dei kernel CUDA durante il percorso dati
Esempio: traffico di rete UDP
Questo è il caso d’uso più generico per la ricezione e l’analisi delle intestazioni dei pacchetti. Progettato per gestire un traffico di rete in entrata di 100 Gb/s, il kernel CUDA responsabile del traffico UDP dedica un blocco CUDA di 512 thread CUDA (file gpu_kernels/receive_udp.cu) a una diversa coda di ricezione Ethernet UDP.
Il ciclo del percorso dati è:
Ricevere pacchetti con la funzione GPUNetIO denominata
doca_gpu_dev_eth_rxq_receive_block.Ogni thread CUDA elabora un sottoinsieme dei pacchetti ricevuti.
Recupera il buffer DOCA che contiene il pacchetto.
Analizzare il payload del pacchetto per distinguere i pacchetti DNS dagli altri pacchetti UDP generici.
Cancella il payload del pacchetto per assicurarti che i pacchetti vecchi non vengano analizzati di nuovo.
Ogni blocco CUDA invia statistiche al thread della CPU utilizzando un semaforo DOCA GPUNetIO.
Il thread della CPU controlla i semafori per ottenere le statistiche e le stampa sulla console.
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
          struct doca_gpu_eth_rxq *rxq0,
          struct doca_gpu_eth_rxq *rxq1,
          struct doca_gpu_eth_rxq *rxq2,
          struct doca_gpu_eth_rxq *rxq3,
          int sem_num,
          struct doca_gpu_semaphore_gpu *sem0,
          struct doca_gpu_semaphore_gpu *sem1,
          struct doca_gpu_semaphore_gpu *sem2,
          struct doca_gpu_semaphore_gpu *sem3)
{
  __shared__ uint32_t rx_pkt_num;
  __shared__ uint64_t rx_buf_idx;
  __shared__ struct stats_udp stats_sh;

  doca_error_t ret;
  struct doca_gpu_eth_rxq *rxq = NULL;
  struct doca_gpu_semaphore_gpu *sem = NULL;
  struct doca_gpu_buf *buf_ptr;
  struct stats_udp stats_thread;
  struct stats_udp *stats_global;
  struct eth_ip_udp_hdr *hdr;
  uintptr_t buf_addr;
  uint64_t buf_idx = 0;
  uint32_t lane_id = threadIdx.x % WARP_SIZE;
  uint8_t *payload;
  uint32_t sem_idx = 0;

  if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
  else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
  else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
  else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

  if (threadIdx.x == 0) {
    DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
  }
  __syncthreads();

  while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
    stats_thread.dns = 0;

    /* No need to impose packet limit here as we want the max number of packets every time */
    ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
    /* If any thread returns receive error, the whole execution stops */
    if (ret != DOCA_SUCCESS) { ... }

    if (rx_pkt_num == 0) continue;

    buf_idx = threadIdx.x;
    while (buf_idx < rx_pkt_num) {
      doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
      doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
      raw_to_udp(buf_addr, &hdr, &payload);

      if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

      /* Double-proof it's not reading old packets */
      wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
      buf_idx += blockDim.x;
    }
    __syncthreads();

    for (int offset = 16; offset > 0; offset /= 2) {
      stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
      __syncwarp();
    }

    if (lane_id == 0) {
      atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
    }

    __syncthreads();

    if (threadIdx.x == 0 && rx_pkt_num > 0) {
      ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
      if (ret != DOCA_SUCCESS) { ... }

      DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
      DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
      doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
      __threadfence_system();

      sem_idx = (sem_idx + 1) % sem_num;

      DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
    }

    __syncthreads();
  }
}
Dov’è l’RDMA lì dentro? Link to heading
Nell’esempio precedente, RDMA non è effettivamente coinvolto. GPUNetIO permette semplicemente alla GPU di elaborare direttamente i dati dei pacchetti. L’unico aspetto che ricorda RDMA è che il pacchetto si sposta dalla scheda di rete alla GPU tramite un trasferimento DMA diretto, bypassando la memoria della CPU.
Prima di concludere, rimane un elemento di confusione: DOCA RDMA. Nella sezione precedente abbiamo esaminato DOCA GPUNetIO. Ma cos’è DOCA RDMA e in che modo si confronta con la precedente API “ibv”, che abbiamo analizzato in precedenza?
La risposta è semplice: DOCA RDMA è il framework software di NVIDIA per l’esecuzione di operazioni RDMA utilizzando la CPU o la GPU. IBV è la tradizionale libreria InfiniBand Verbs di basso livello, parte dell’API standard per la programmazione dell’hardware InfiniBand e RoCE. La differenza fondamentale è che DOCA RDMA è un SDK di livello superiore e più completo, che si basa sulle funzionalità di base dell’interfaccia Verbs, consentendo l’accelerazione GPU e il trasferimento delle attività RDMA dalla CPU alla GPU.
Ad esempio, questo è il codice per l’invio di un pacchetto RDMA:
doca_error_t rdma_send(struct rdma_config *cfg)
{
	struct rdma_resources resources = {0};
	union doca_data ctx_user_data = {0};
	const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
	const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
	struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
	doca_error_t result, tmp_result;

	/* Allocating resources */
	result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
					 doca_rdma_cap_task_send_is_supported,  &resources);

	result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
					rdma_send_error_callback, NUM_RDMA_TASKS);

	result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

	/* Include the program's resources in user data of context to be used in callbacks */
	ctx_user_data.ptr = &(resources);
	result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

	/* Create DOCA buffer inventory */
	result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

	/* Start DOCA buffer inventory */
	result = doca_buf_inventory_start(resources.buf_inventory);

	/* Start RDMA context */
	result = doca_ctx_start(resources.rdma_ctx);

	/*
	 * Run the progress engine which will run the state machine defined in
	 * rdma_send_state_change_callback(). When the context moves to idle, the context change
	 * callback call will signal to stop running the progress engine. */
	while (resources.run_pe_progress) {
		if (doca_pe_progress(resources.pe) == 0)
			nanosleep(&ts, &ts);
	}

	// ... cleanup
}
Pensare fuori dagli schemi: e se non fosse RDMA? Link to heading
Nella sezione precedente abbiamo esaminato vari aspetti dell’RDMA. L’obiettivo finale dell’RDMA è trasferire dati avanti e indietro tra CPU, GPU e Quantum Control Stack con una latenza di pochi microsecondi. C’è una grande quantità di informazioni da trasferire, che si tratti di dati di soft-readout I/Q, campioni di impulsi di controllo (“onde”) o semplicemente della configurazione parametrica degli impulsi, solitamente nel contesto di una rete neurale. È inoltre necessario trasferire informazioni più semplici, come i sindromi dei qubit logici, e richiamare da remoto un decodificatore QEC nell’unità di calcolo. In quest’ultimo caso, è lecito chiamare le cose con il loro nome e definire questo comportamento come “chiamata di procedura remota” o RPC.
 La cosa positiva è che c’è molta letteratura disponibile su RPC su RDMA, come mRPC, che presenta valori di latenza molto interessanti, basati sulla scheda di rete RoCE Mellanox Connect-X5 da 100 Gbps. C’è confusione nel documento, poiché afferma che “Su RDMA, mRPC velocizza eRPC di 1,3× e 1,4× in termini di latenza mediana e di coda (rispettivamente)” mentre la tabella indica che eRPC è più veloce di mRPC. Ma, per ora, si può presumere che i valori di latenza siano empiricamente possibili.
 La cosa più interessante è vedere il seguito di mRPC paper, dove un Compute Express Link (CXL) viene utilizzato per creare un RPC ancora più veloce che chiamano “HydraRPC”. I numeri parlano da soli, vedi la tabella a destra. La domanda da porsi è: come sarà tra 5 anni? A mio parere, anche NVLink sembra un’opportunità molto allettante…
Conclusion Link to heading
Ecco, mi ci è voluto più tempo per completare questo promemoria, e credo che mi abbia aiutato a capire un po’ meglio. Credo che la confusione tra RDMA e GPUDirect derivi dal fatto che RDMA è stato inizialmente sviluppato da Mellanox come un puro miglioramento della rete. Dopo l’acquisizione di Mellanox da parte di Nvidia, è stato esteso per “collegarsi” alla GPU, ma questa estensione non è mai stata concepita come un concetto iniziale, ed è finita per essere un componente aggiuntivo nell’ecosistema DOCA.

References:
- Mellanox - WinOF VPI Documentation v5.50.52000
- Nvidia - RDMA over Converged Ethernet
- Aruba - Remote Direct Memory Access (RDMA) Solution
- CERN - Implementing RoCEv2 in Verilog for FPGA
- Network Times - Remote Direct Memory Access - RDMA Basics
- High-Throughput, Resource-Efficient Implementation of the RoCEv2
- A Remote Direct Memory Access Protocol Specification
- Imperial College London - RDMA Tutoral
- InfiniBand: An Introduction + Simple IB verbs program with RDMA Write
- Netdev 0x16 - RDMA Tutorial
- Microsoft - Understanding RDMA Microarchitecture Resources for Performance Isolation
- RoGUE: RDMA over Generic Unconverged Ethernet
- DatenLord - RDMA blue design
- Using RDMA Efficiently for Key-Value Services
- An Extensible Software Transport Layer for GPU Networking
- Alibaba - Flor: An Open High Performance RDMA Framework Over Heterogeneous RNICs
- ConnectX comparison
- RR-Compound
- gRPC meets RDMA
- Accelerating TensorFlow with Adaptive RDMA-based gRPC
- Toward GPU-centric Networking on Commodity Hardware
DrawIO diagrams used in this memo: