Questo promemoria riprende i concetti di base delle GPU. Si concentra sull’operazione fondamentale del deep learning: la moltiplicazione di matrici. In primo luogo, descriverò l’implementazione di base e accademica. Successivamente, esaminerò le ottimizzazioni necessarie per utilizzare la GPU in modo efficiente.
Comprensione del moltiplicatore di matrici ingenuo Link to heading
Iniziamo con questo semplice esempio che si trova spesso nei libri di testo.
/**
 * Kernel to perform matrix multiplication C = A × B
 * A is of size N x M, B is M x N, and C is N x N
 * Each thread computes one element of matrix C.
 */

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

    // Calculate global row and column for this thread
    int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
    int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

    if (row < N && col < N) {
        float sum = 0.0f;
        for (int k = 0; k < M; k++) {
            // C[row][col] = sum(A[row][i] * B[i][col])
            sum += A[row * N + k] * B[k * N + col];
        }
        C[row * N + col] = sum;
    }

}
A prima vista, sembra facile. Basta calcolare ogni cella della matrice di output C. Questo codice kernel sembra funzionare. Ecco una rappresentazione più visiva del kernel.
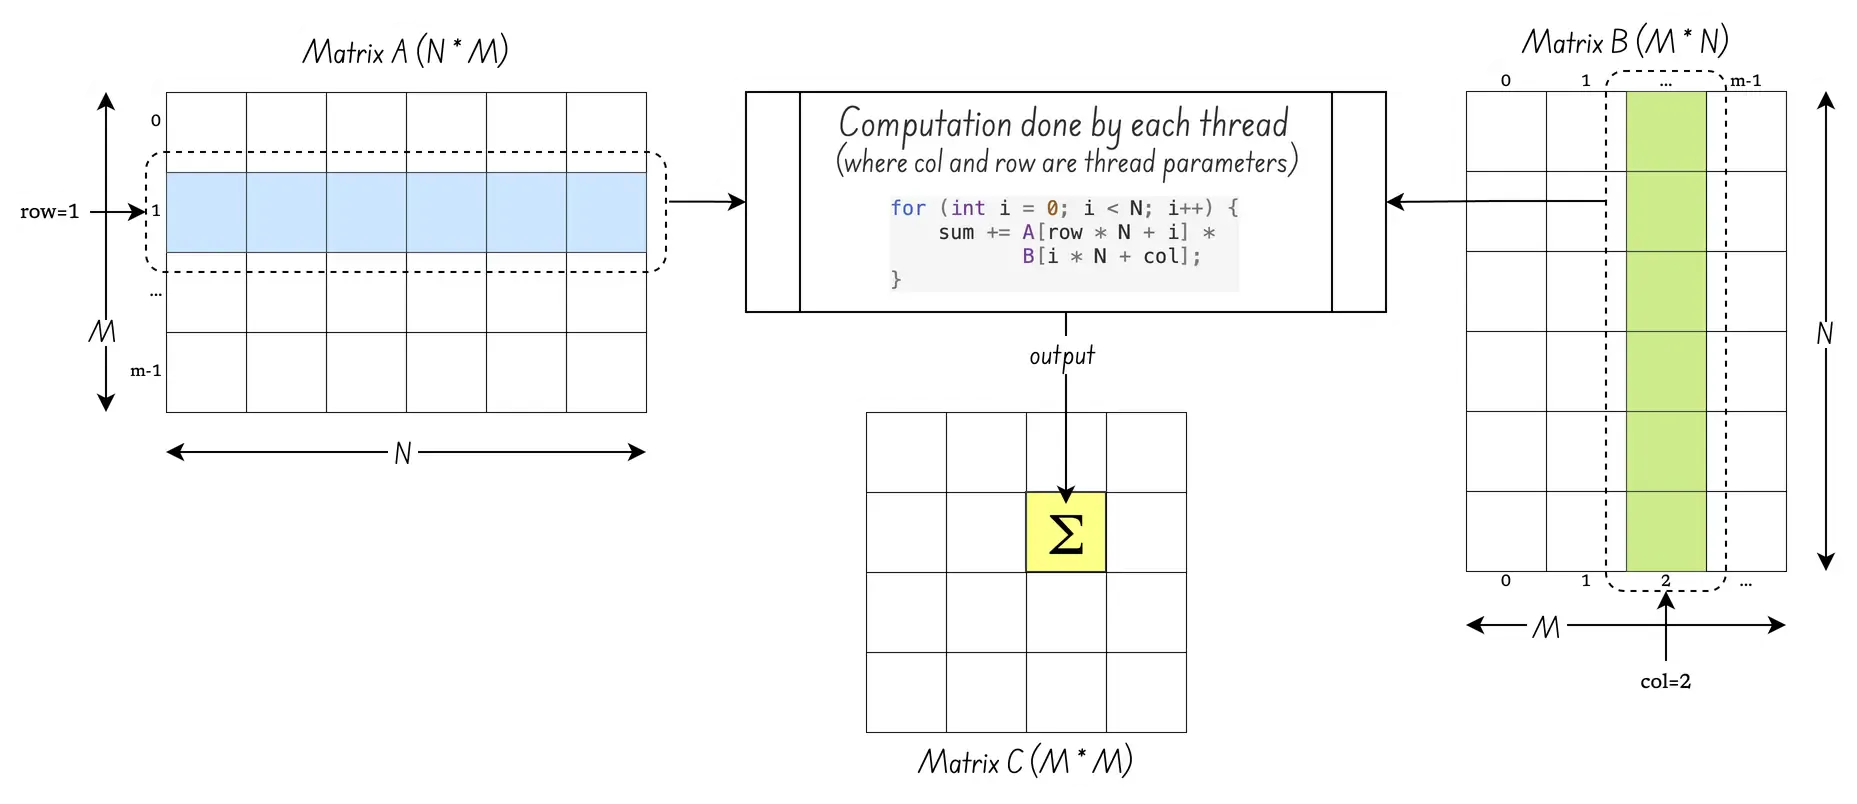
La realtà è un po’ più complessa. Come si interpretano blockIdx, blockDim e threadIdx? Per capirlo, bisogna tornare a come le GPU sono organizzate attorno a thread, warp e multiprocessori di streaming. Ecco una rappresentazione soggettiva della microarchitettura GPU “Hopper” H100 di Nvidia:
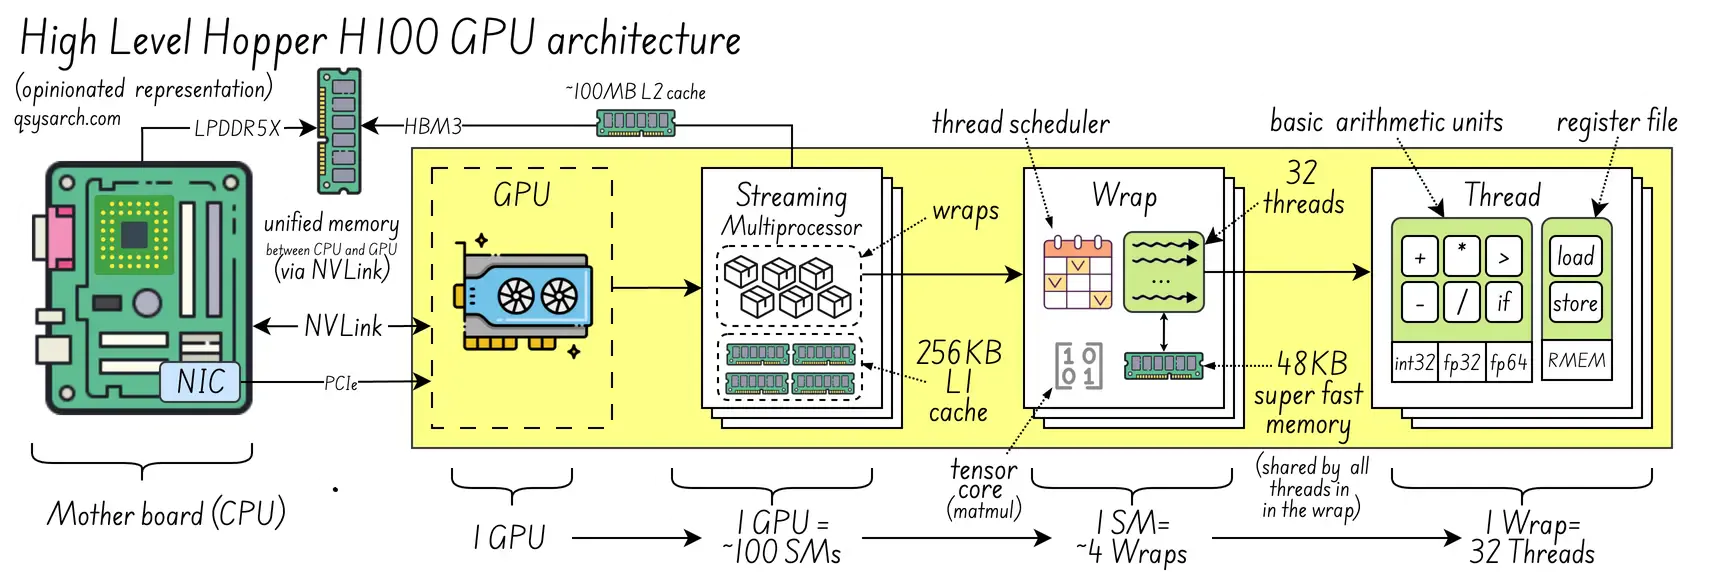
A grandi linee:
1 Multiprocessori di streaming = 4 ~ 64 wrap
1 avvolgimento = 32 ~ 64 fili
Ma, dunque, come viene associato il frammento di codice che calcola la somma a un thread, a un warp o persino a un multiprocessore in streaming? Dove vengono prese le decisioni di allocazione e mappatura? Innanzitutto, dobbiamo capire come è configurato il kernel:
int launch_kernel(float *d_A, *d_B, *d_C) {

    dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
    dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

    // 2. Launch the kernel with the specified dimensions
    naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
Questa configurazione gerarchica viene mappata sull’hardware della GPU nel modo seguente:

Con questa configurazione, è possibile moltiplicare una matrice di dimensione N pari a 16*4 = 64. Cosa succederebbe se N fosse 1000? In tal caso, basterebbe impostare la dimensione della griglia a (1000+15)/16.
E per quanto riguarda la mappatura sull’hardware effettivo? Significa che i blocchi vengono allocati ai warp? Cosa succede se il numero di thread nel blocco è maggiore del numero di thread hardware?
Bene, è qui che entra in gioco la pianificazione della GPU. In sintesi, se sono necessari più thread di quanti ne siano presenti sull’hardware fisico, la GPU allocherà diversi warp:
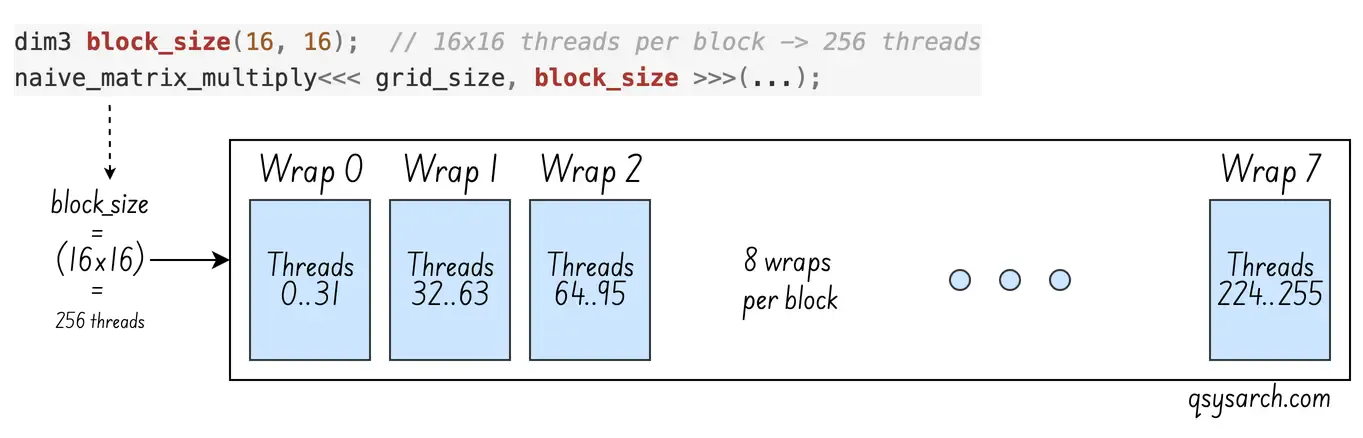
La domanda successiva riguarda il modo in cui gli 8 warp necessari per blocco vengono associati al multiprocessore di streaming, soprattutto quando quest’ultimo ha meno warp di quanti ne servano a un blocco. La risposta è geniale: un multiprocessore di streaming può avere più di 4 warp, che gestisce in alternanza: ogni volta che un warp si blocca a causa di un accesso alla memoria, il multiprocessore di streaming passa immediatamente a un altro warp. Questa tecnica è chiamata occultamento della latenza ed è la strategia fondamentale per le prestazioni delle GPU. Senza di essa, l’efficienza non sarebbe così elevata.
Consideriamo ora grid_size. grid_size è mappato direttamente alle risorse hardware? No. La griglia è solo un concetto logico. Garantisce che siano disponibili blocchi a sufficienza per coprire la matrice. grid_size non corrisponde all’hardware. I blocchi vengono allocati a ciascun SM in fase di esecuzione da una coda.
L’allocazione si basa sulle risorse necessarie al blocco (ogni wrapper ha un numero limitato di registri e deve assicurarsi che ogni blocco abbia il proprio set di registri allocati staticamente).
Quando un blocco ha terminato il suo calcolo, l’SM preleva un nuovo blocco dalla coda dello scheduler per sostituire quello completato. Una volta assegnato, il blocco viene bloccato su quell’SM e i suoi registri vengono allocati per l’esecuzione.
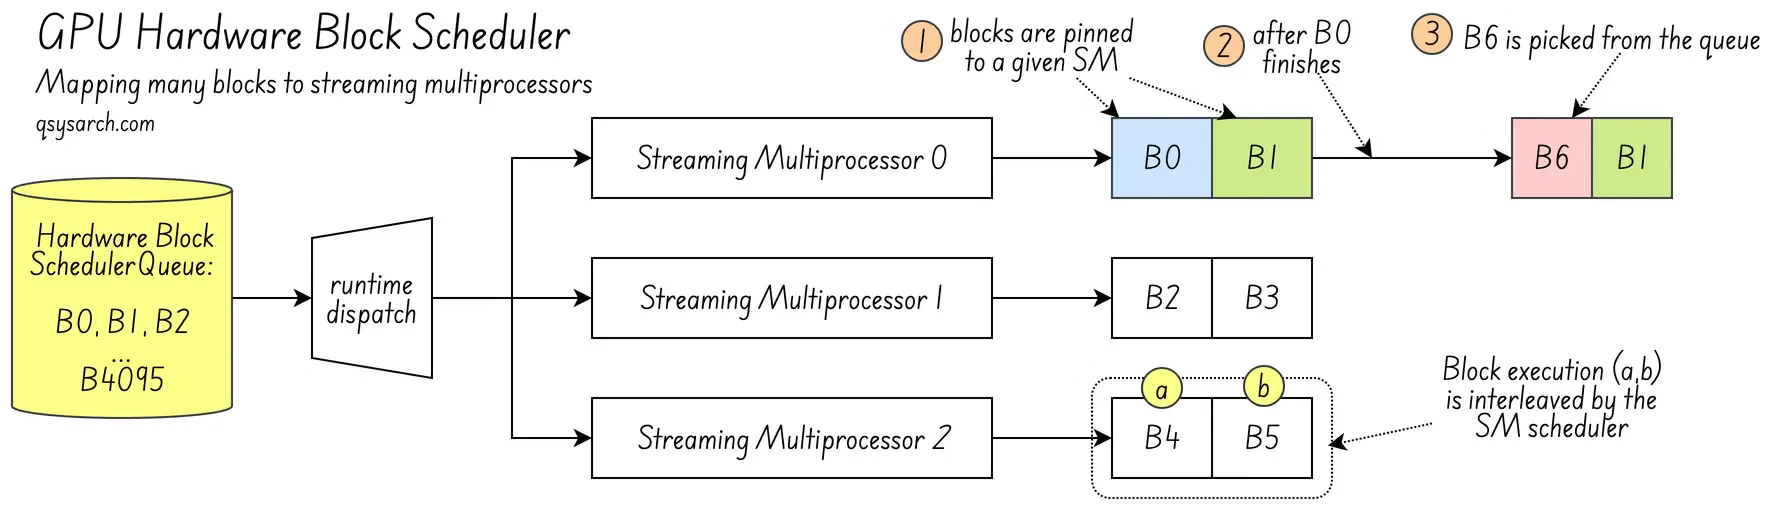
Un’ultima domanda: i blocchi sono vincolati all’SM o al warp? La memoria utilizzata dai thread nel blocco è allocata nel warp? In caso contrario, l’SM dovrebbe spostare la memoria tra i warp. Sì, all’interno dell’SM, i warp di un blocco sono vincolati. Se il blocco 0 è allocato al warp 0 e il blocco 1 al warp 1, sarà sempre così.
Miglioramento del moltiplicatore di matrici ingenuo Link to heading
Ora che abbiamo compreso l’esecuzione concorrente dei thread, consideriamo il kernel di moltiplicazione di matrici più semplice. Tutti i thread competono per l’accesso alla memoria delle matrici A e B. Ogni thread legge in streaming un’intera riga di A e una colonna di B dalla memoria globale. Non c’è riutilizzo. B viene acceduta colonna per colonna (B[i * N + col]), quindi l’accesso a raffica e la cache di memoria non possono essere utilizzati efficacemente.
La risposta più semplice è utilizzare la memoria condivisa. Innanzitutto, si carica parte della matrice nella memoria warp come un blocco di dimensioni T*T. Quindi, si permette ai thread di leggere solo da questa memoria locale. In questo modo, i thread non competono per l’accesso alla memoria. Utilizzando l’interleaving dei warp, l’SM garantisce che mentre un warp carica la memoria nella cache, l’altro warp calcola la somma. Ecco il kernel migliorato:
__global__ void matmul_tiled(float* A, float* B, float* C) {

    __shared__ float A_shared[T][T];
    __shared__ float B_shared[T][T];

    int tx = threadIdx.x,  ty = threadIdx.y;
    int row = blockIdx.y * T + ty;   // global row in C
    int col = blockIdx.x * T + tx;   // global col in C

    float accumulator = 0.0f;
    for (int t = 0; t < M; t += T) {

        // Read [T,T] subtile from matrix A and B.
        // Assume that M and N are multiples of T (no bound check)
        A_shared[ty][tx] = A[row * M + t + tx];
        B_shared[tx][ty] = B[(t + ty) * N + col];

        __syncthreads();   // wait all threads to finish loading

        for (int k = 0; k < TILE; ++k)
            accumulator += A_shared[ty][k] * B_shared[k][tx];

        __syncthreads();   // all threads are ready to load again
    }
    C[row * N + col] = accumulator;
}
Per semplicità, presumo che M e N siano multipli di T, quindi non viene effettuato alcun controllo dei limiti durante il caricamento della matrice globale in A_shared e B_shared.
C’è un pizzico di magia in questo codice. Tutti i thread nel blocco eseguono la stessa lettura di memoria: A[row * M + t + tx]. Poiché t è contiguo, i thread leggono dalla stessa regione di memoria. Questo abilita il burst di memoria e la cache. Il primo thread avvia la lettura burst. Gli altri thread utilizzano la cache popolata da quel burst. B non è trasposto, quindi il trucco non funziona per B. Inoltre, __syncthreads() sincronizza i thread all’interno di un blocco, assicurando che vengano eseguiti sullo stesso SM.
Con il precedente moltiplicatore ingenuo, la dimensione del blocco era arbitraria. Con l’approccio a tessere, la dimensione del blocco deve corrispondere alla dimensione della tessera T*T, come mostrato nel diagramma:
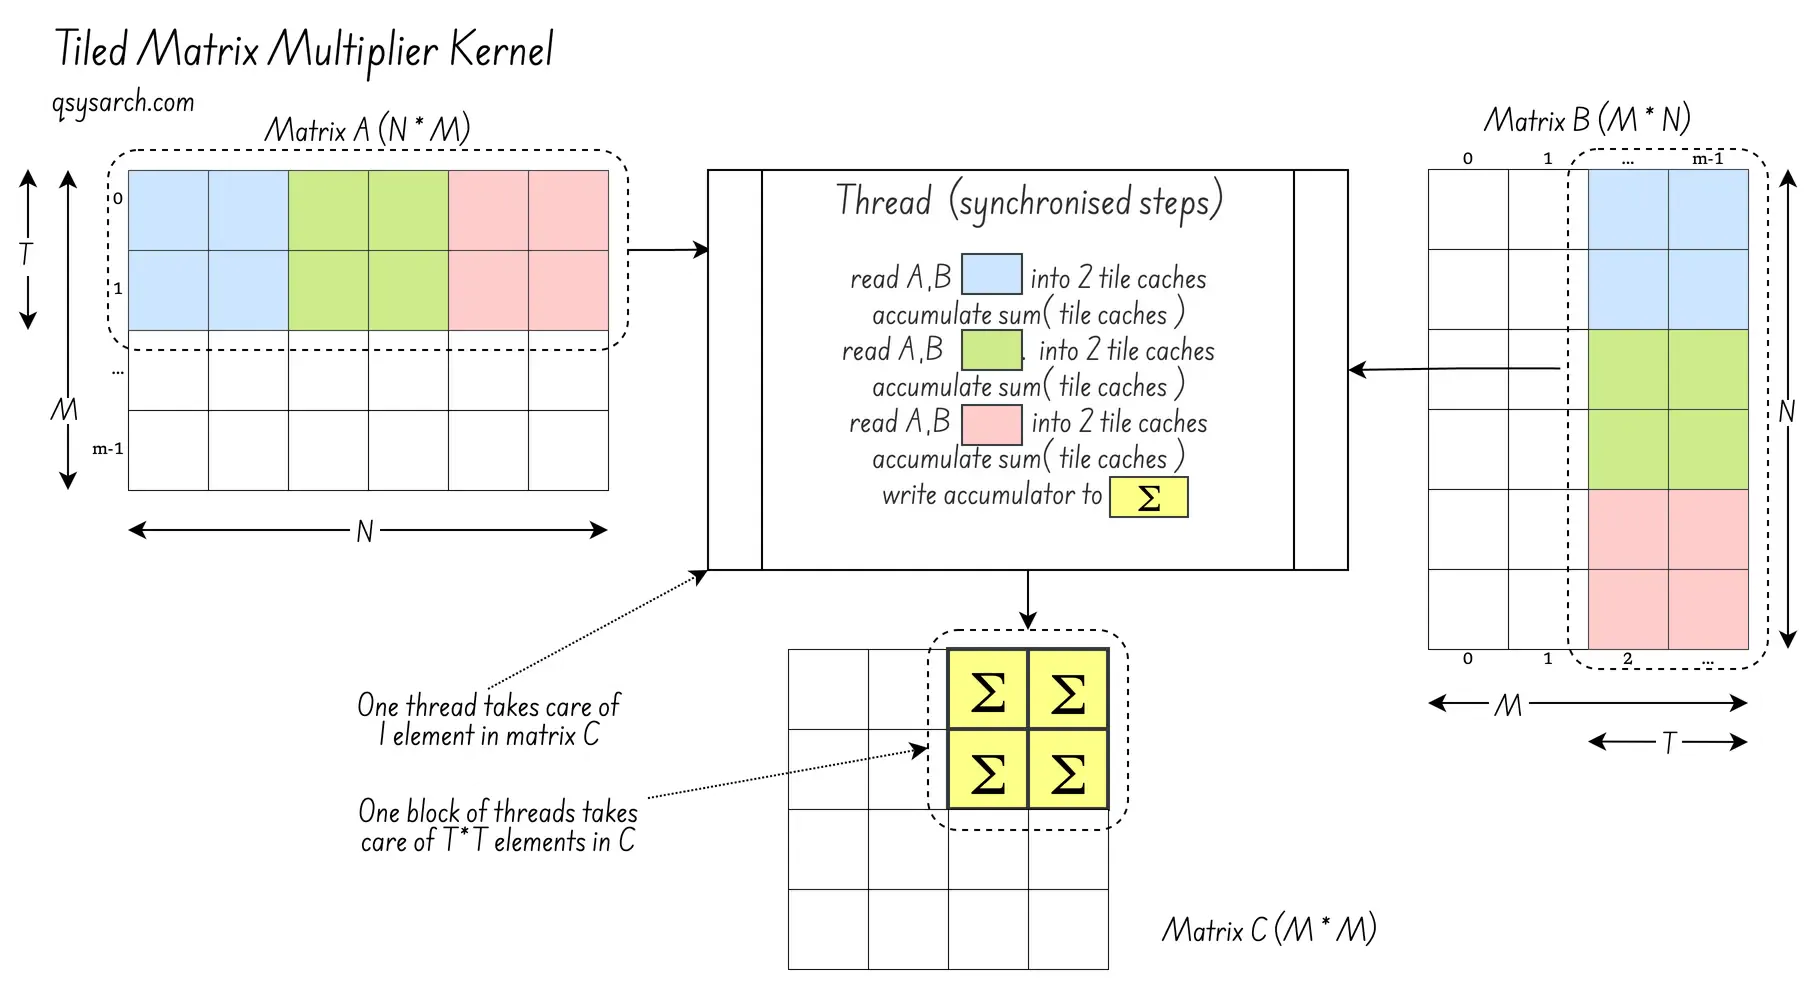
L’approccio a blocchi consente il caricamento di blocchi mentre altri eseguono calcoli. In questo caso, il calcolo può essere leggero e richiedere meno tempo del caricamento in memoria. Per risolvere questo problema, è necessario aumentare il carico di lavoro per thread durante il calcolo. Ogni thread può calcolare un insieme di elementi 2x2 invece di uno solo. Con K=2 e T un multiplo di K, ciò è possibile.
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

    __shared__ float A_shared[T][T];
    __shared__ float B_shared[T][T];

    int tx = threadIdx.x, ty = threadIdx.y;
    int rowBase = blockIdx.y * T * K + ty;
    int colBase = blockIdx.x * T * K + tx;

    float accumulators[K][K]; // That's register memory

    for (int t = 0; t < M; t += TILE) {

        A_shared[ty][tx] = A[row * M + t + tx];
        B_shared[tx][ty] = B[(t + ty) * N + col];

        __syncthreads();

        for (int k = 0; k < TILE; ++k)
            for (int wr = 0; wr < K; ++wr)
                for (int wc = 0; wc < K; ++wc)
                    acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

        __syncthreads();
    }

    // Write out the T×T accumulated result
    for (int wr = 0; wr < T; ++wr)
        for (int wc = 0; wc < T; ++wc) {
            int r = rowBase + wr * (T/K);
            int c = colBase + wc * (T/K);
            C[r * N + c] = acc[wr][wc];
        }
}
Conclusion Link to heading
Ecco fatto. Questo è fondamentalmente il funzionamento di un’unità GEMM (Moltiplicazione di Matrici Generali)!
Successivamente, dovrei introdurre hardware speciale come Tensor Core (NVIDIA) o Matrix Fused Multiply-Add (AMD). Si tratta di unità specializzate all’interno del multiprocessore di streaming che calcolano le moltiplicazioni accumulate T*T*K. Ne parlerò in un promemoria successivo!
References:
- The icons used in this memo are from Icons8
- eunomia.dev: cuda tutorial
- Inside NVIDIA GPUs: Anatomy of high performance matmul kernels
- CUDA – Threads, Blocks, Grids and Synchronization
DrawIO diagrams used in this memo:


