Quando si compila per le GPU NVIDIA, CUDA è spesso considerato il framework di compilazione di riferimento. Ma come funziona effettivamente il compilatore? Che tipo di architettura del set di istruzioni (ISA) deve generare il compilatore quando crea un “eseguibile” per la GPU? E come funziona effettivamente il compilatore? Che tipo di architettura viene utilizzata per generare codice che può essere avviato da una CPU ed eseguito su una GPU?
Questo promemoria di domenica mattina si propone di fornire una panoramica generale dell’architettura del compilatore GPU di NVIDIA. Tratta il set di istruzioni della GPU, il compilatore NVCC nel framework CUDA e, infine, le architetture alternative che si rivolgono al set di istruzioni della GPU.
Architettura GPU di basso livello Link to heading
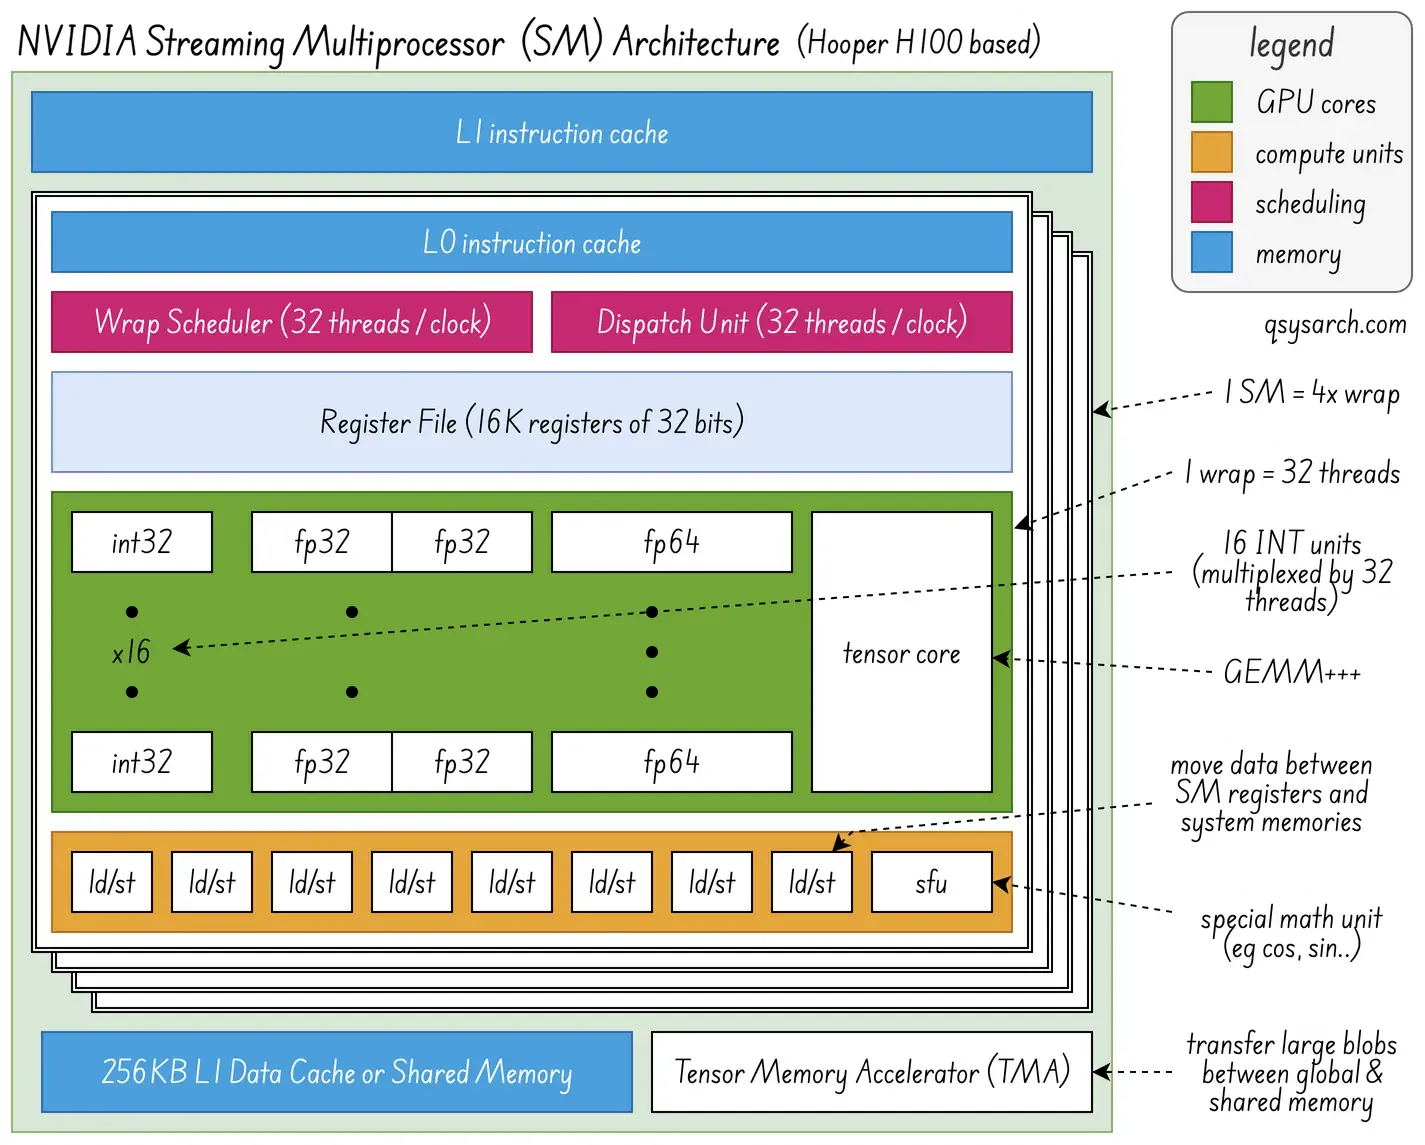
Quando si programma un dispositivo come una GPU, è necessario un set di istruzioni per gestirlo. Nel caso di NVIDIA, questo dispositivo è il multiprocessore di streaming (SM), rappresentato nel diagramma a destra. Ciò che è interessante nel diagramma è la presenza di numerose unità concorrenti, come gli addizionatori IN32, l’unità a funzioni speciali, il core tensoriale GEMM+++, e il fatto che il compilatore debba assicurarsi che vengano utilizzate (in pipeline) nel modo più efficiente possibile (dove l’efficienza è definita come la minimizzazione dei tempi di inattività).
Questa è la terminologia in uso:
ISA (Instruction Set Architecture): insieme di istruzioni.
Codice macchina: Rappresentazione compatta e binaria delle istruzioni
Assemblaggio (linguaggio): rappresentazione testuale meno compatta delle istruzioni
Esistono due ISA per le GPU NVIDIA:
PTX: Esecuzione di thread paralleli - Assembly intermedio utilizzato durante la compilazione dei kernel Cuda.
SASS: Streaming ASSembly. Assembly di livello inferiore, specifico per ogni architettura GPU
Supponiamo di voler compilare questo kernel:
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
    int i = blockIdx.x * blockDim.x + threadIdx.x;

    float vx = x[i], vy = y[i];
    float len2 = vx*vx + vy*vy;
    float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
    z[i] = invLen; // Normalized length
}
Il segreto sta nel fatto che rsqrtf deve essere inviato alla pipeline SFU. Come funziona? La riga float invLen = rsqrtf(len2); viene convertita in PTX come rsqrt.approx.ftz.f32 e poi in SASS come MUFU.RSQ, come mostrato nell’immagine sottostante tratta da godbolt.
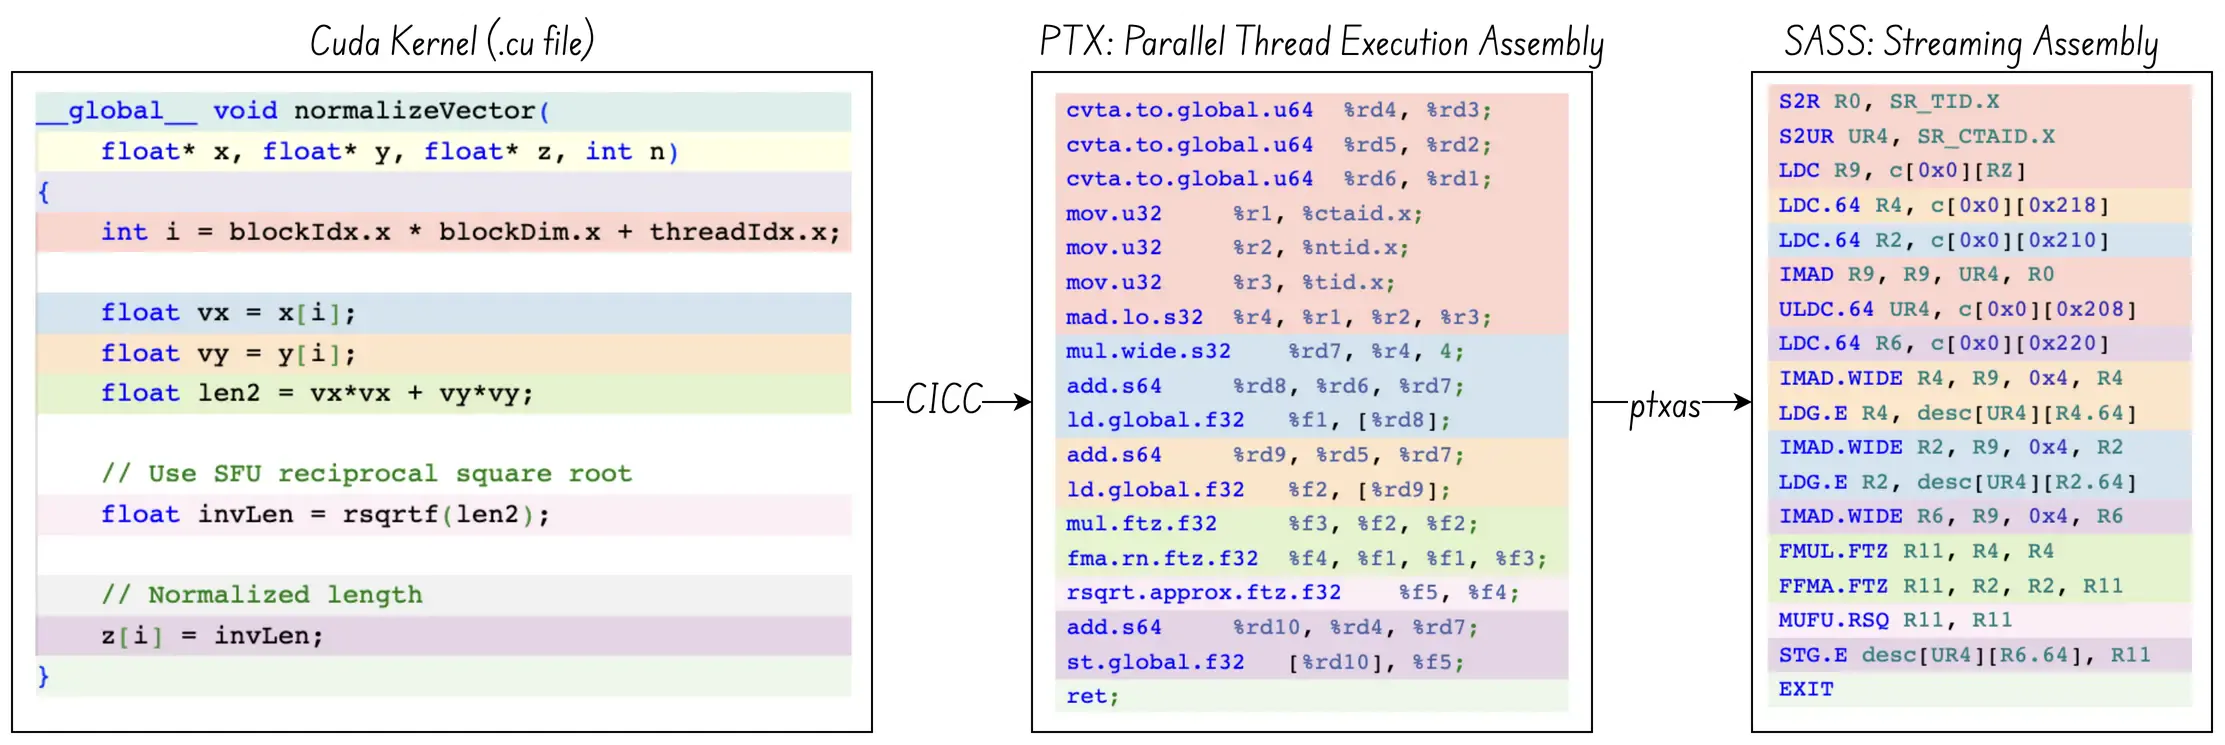
MUFU sta per unità multifunzione, nota anche come SFU, l’unità a funzione speciale. L’istruzione MUFU.RSQ invia il registro attraverso la “pipeline” Root Square dell’unità SFU. Nell’assembly SASS sono presenti molte altre istruzioni, come FMUL (Fused Multiply) o FFMA (Fused Multiply and Accumulate), che vengono invece inviate all’unità Tensor Core. L’unità di dispatch è responsabile dell’invio delle istruzioni all’unità pipeline corretta.
Ci sono tre cose degne di nota:
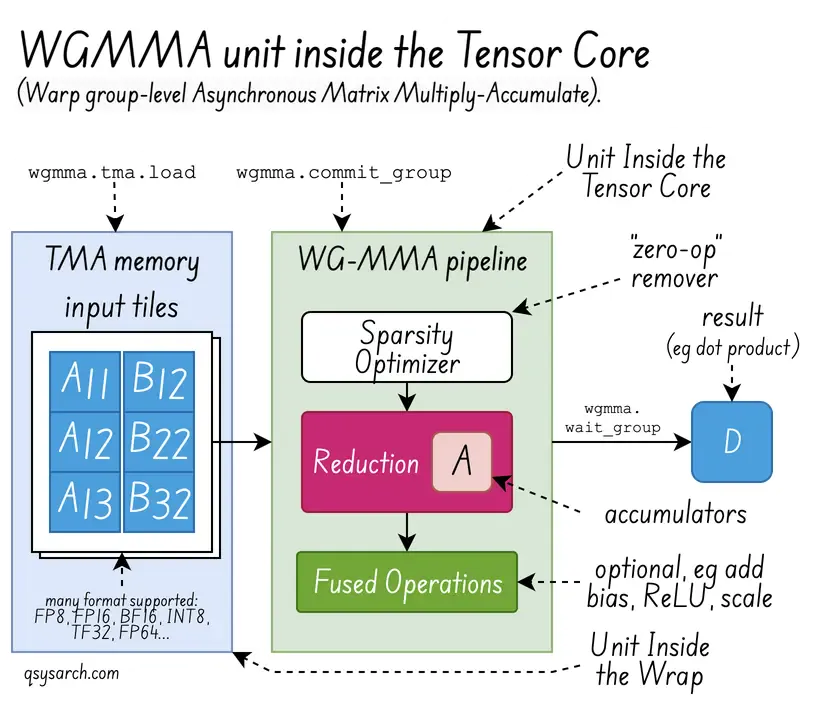
Il tensore è molto più di un moltiplicatore di matrici generale (GEMM): ad esempio, può eseguire operazioni di riduzione (somma, min/max, prodotto scalare) tramite un’unità MMA (moltiplicazione-accumulazione di matrici) all’interno del nucleo del tensore.
La differenza tra un’unità
INT32e un registro: l’unità è responsabile del calcolo (ad esempio, ADD, SHIFT, XOR, … o più in generale operazioni aritmetiche, o ALU), mentre il secondo è responsabile della memorizzazione dei valori.Ci sono solo 16 unità
INT32, ma 32 thread. Non si tratta di un errore: il motivo è che lo scheduler warp alternerà tra due set di thread a ogni ciclo. Quindi, nel ciclo 0, le unità eseguiranno operazioni ALU per i thread da 0 a 15, e nel ciclo 1, per i thread da 16 a 31.
Le istruzioni WGMMA (Asynchronous Warpgroup Level Matrix Multiply-Accumulate) sono piuttosto potenti. Puoi trovare maggiori informazioni nella documentazione NVIDIA e nel fantastico blog di Aleksa Gordić.
Architettura del compilatore NVIDIA CUDA
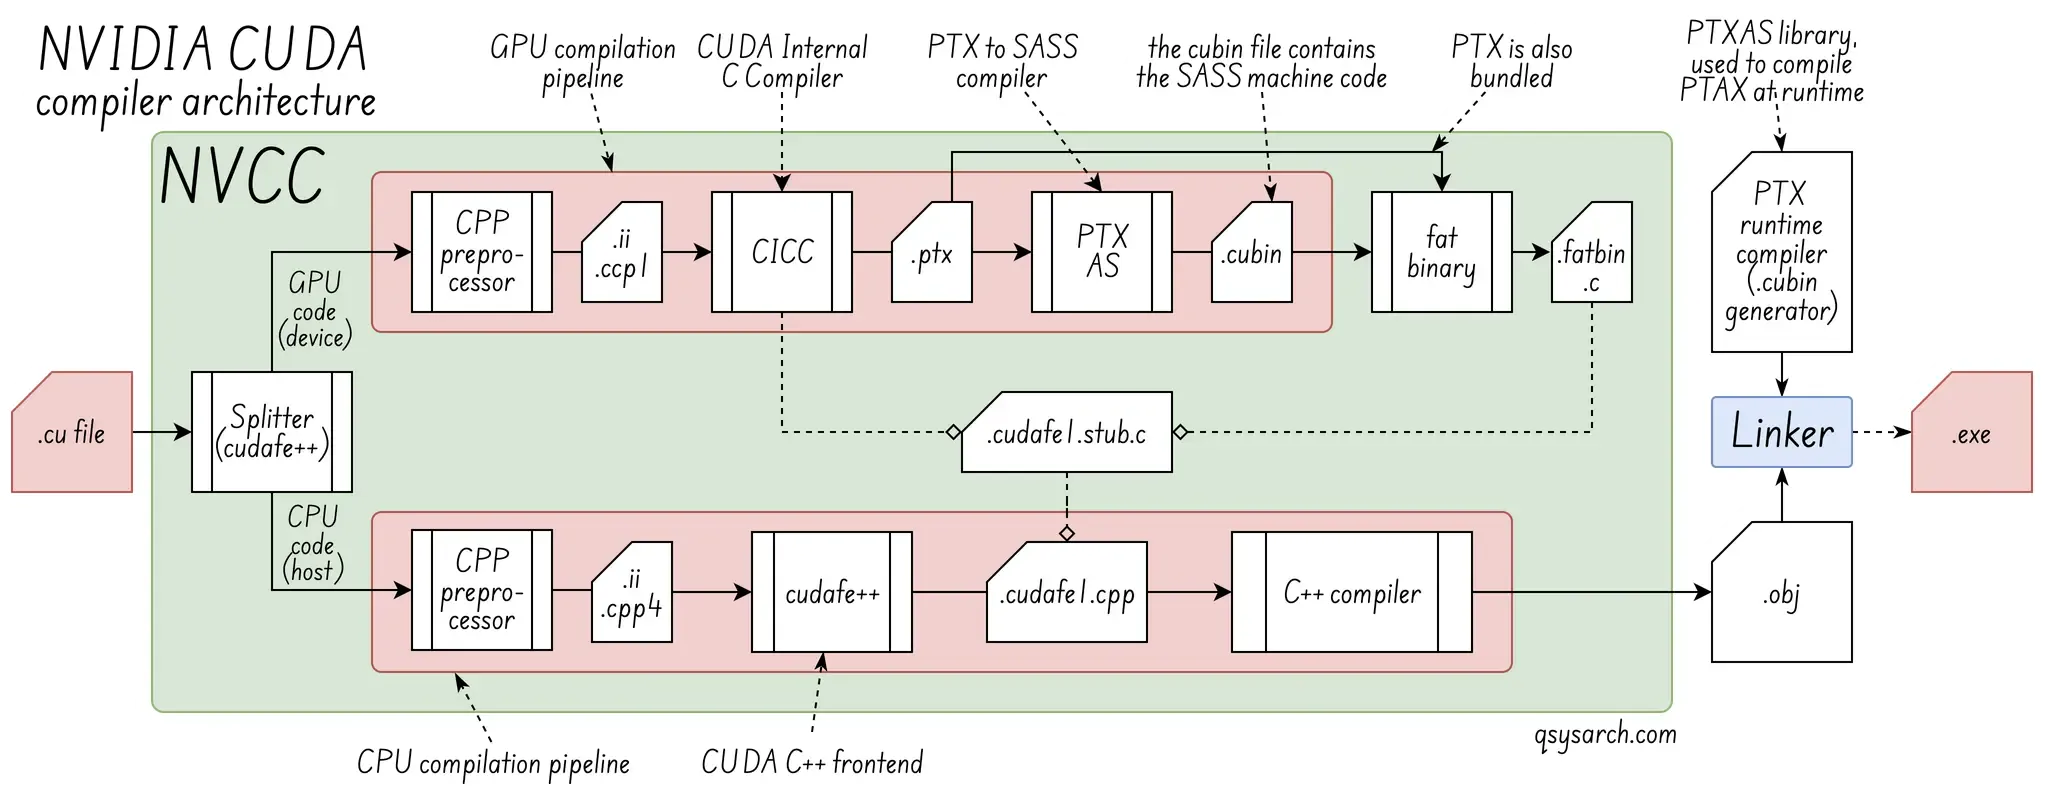
Ora che abbiamo compreso un po’ meglio l’ISA di basso livello della GPU per la programmazione del multiprocessore di streaming GPU, proviamo a capire come i kernel C++ di alto livello vengono compilati in SASS. Sappiamo che il compilatore utilizzato per convertire i kernel CUDA (file .cu) in PTX si chiama NVCC.
Qual è dunque la differenza tra NVCC e LLVM? NVCC è un driver di compilazione specializzato che utilizza l’infrastruttura del compilatore open-source LLVM come back-end. Al contrario, LLVM è un framework di compilazione flessibile, piuttosto che un compilatore pronto all’uso come NVCC.
Compilatore CUDA (NVCC) Link to heading
Programma driver: NVCC è un driver che gestisce il processo di compilazione del codice CUDA C/C++. Separa il codice host (CPU) dal codice del dispositivo (GPU).
Toolchain: NVCC è una toolchain che utilizza un compilatore C++ host (ad esempio GCC/Clang su Linux) per il codice CPU e un compilatore interno specifico di NVIDIA (ad esempio CICC) per il codice GPU (PTX e SASS).
Fat Binaries: NVCC produce in genere “fat binaries” che includono sia l’eseguibile host che il codice GPU compilato, spesso con più versioni per diverse architetture GPU.
LLVM Link to heading
Framework: LLVM è una raccolta di tecnologie, librerie e strumenti di compilazione gratuiti, aperti, modulari e riutilizzabili, progettati per costruire un’ampia varietà di compilatori e toolchain per linguaggi di programmazione.
Rappresentazione intermedia (IR): LLVM IR è un “livello intermedio” indipendente dalla macchina che funge da collegamento universale tra i front-end (C++, Go…) e i back-end ISA (x86, ARM…).
Ottimizzazione: l’ottimizzatore LLVM applica vari miglioramenti delle prestazioni (come lo srotolamento dei cicli e l’eliminazione del codice morto) all’IR, indipendentemente dal linguaggio sorgente o dall’architettura di destinazione.
Vale la pena notare che LLVM può compilare CUDA: il front-end Clang (parte del progetto LLVM) può gestire il codice CUDA con il back-end LLVM PTX, senza richiedere il driver nvcc.
Architettura del compilatore Triton Link to heading
Il linguaggio Triton è un potente linguaggio specifico di dominio (DSL) basato su Python, progettato per aiutare a creare algoritmi vettorizzati di alto livello che possono essere compilati in codice parallelizzato efficiente per architetture GPU.
Questo è un esempio del kernel più semplice, che carica i dati da un blocco di memoria e li scrive in un altro blocco. Il valore di offsets è [pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1]. La magia, che non è mostrata in questo frammento, è che Triton può operare in modo efficiente sul vettore v, ad esempio eseguendo operazioni math.
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(axis=0)
    offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    v = tl.load(x_ptr + offsets)
    tl.store(output_ptr + offsets, v)
Triton non si limita ai vettori 1D e può gestire più dimensioni utilizzando i tensori. Ad esempio:
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
    stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
    M , N , # Number of rows and columns
    BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
    # X and Y tile position
    pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
    # Ptr in memory based on the stride
    base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
    # Offsets for X and Y indices
    offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
    offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
    # 2D loading ...that's magic!
    loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
    return loaded_2d_tensor
Rispetto a CUDA, Triton può essere considerato un’astrazione di livello superiore, dedicata alla creazione di kernel per reti neurali (grazie all’approccio a blocchi tensoriali), in grado di generare codice GPU vettoriale e parallelo efficiente. Triton supporta inoltre più GPU di backend:
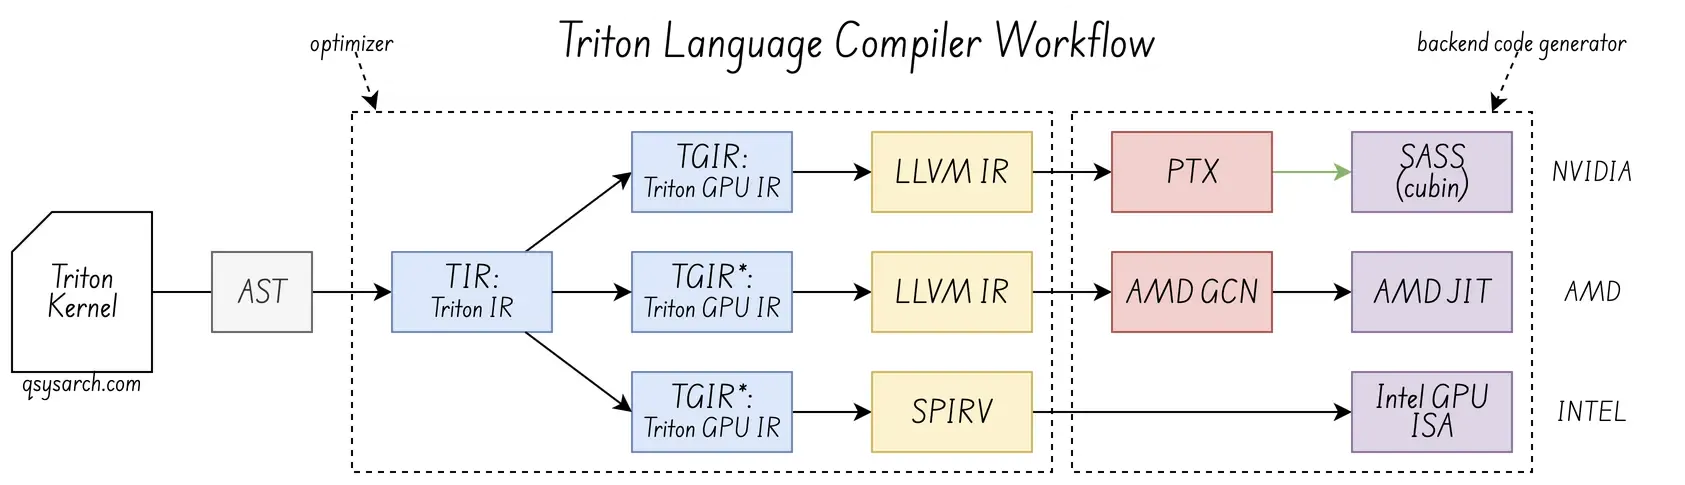
Triton non utilizza un proprio parser del linguaggio. Si basa invece sul runtime e sull’AST di Python, convertendo poi tale AST nelle proprie rappresentazioni intermedie, TIR e TGIR, prima di generare il codice per la GPU. Il collegamento tra il compilatore backend CUDA e il compilatore frontend Triton è il LLVMIR, universale, e per le GPU Intel si basa su SPIRV (anche se non sono sicuro se TGIR venga convertito direttamente in SPIRV, anziché passare attraverso l’intermedio LLVMIR).
Piastrellatura Link to heading
Ho scritto “algoritmi vettorializzati”, anche se il concetto centrale è più focalizzato su modelli a blocchi a tassellatura:
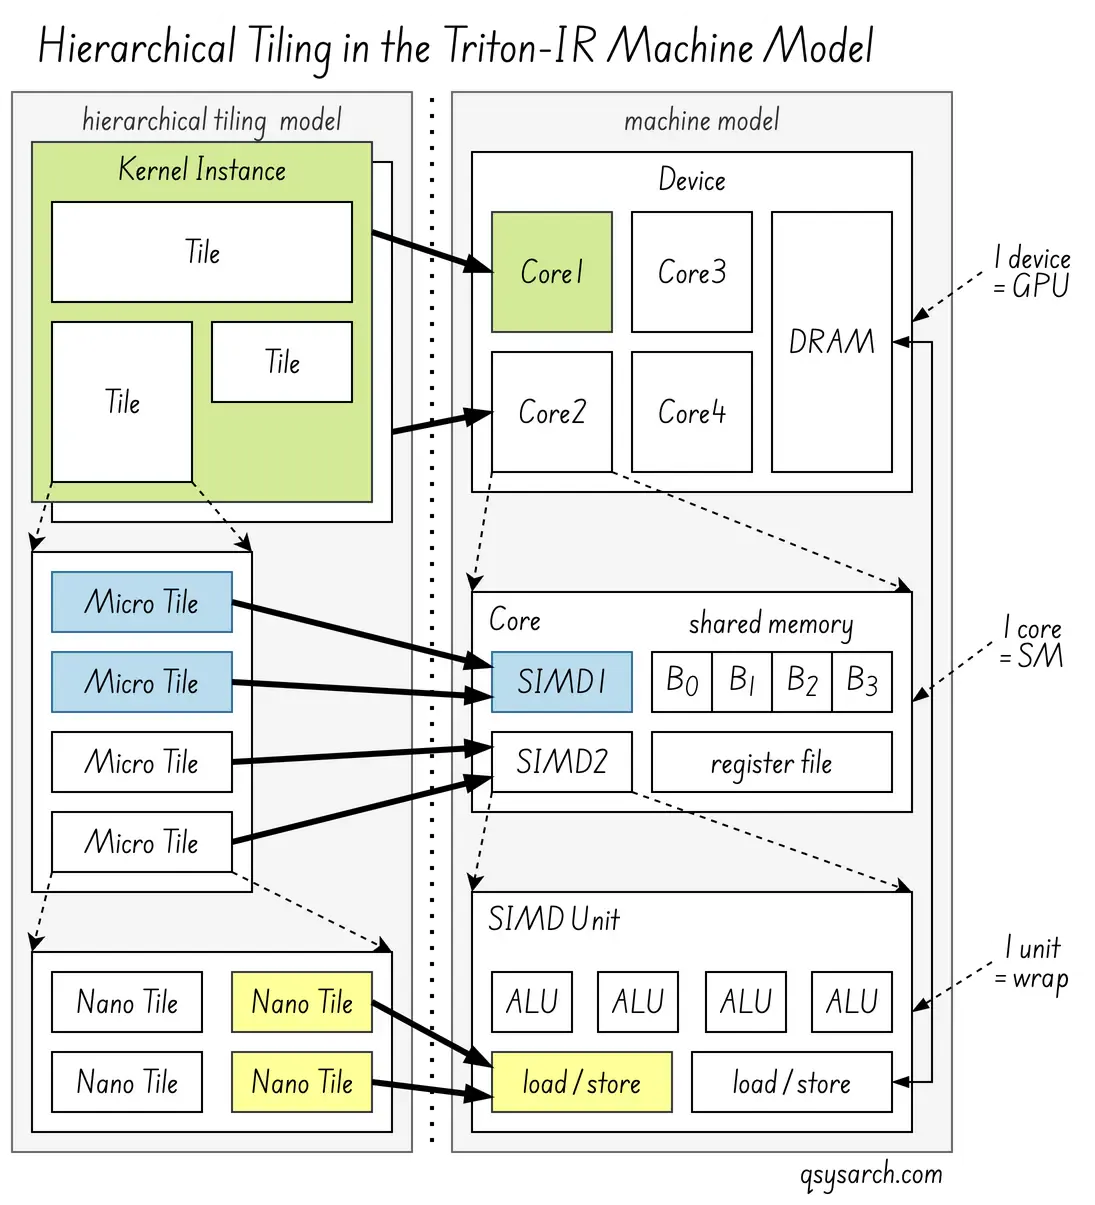
 La tassellatura è il meccanismo principale. Il modello mentale di Triton ruota attorno alla programmazione di operazioni su piccoli sottoarray multidimensionali statici, o “tessere”, che il compilatore parallelizza automaticamente sui core della GPU.
La vettorizzazione, intesa come caricamento/memorizzazione di più elementi di dati in una singola istruzione, è un’ottimizzazione: il compilatore la utilizza come strategia di ottimizzazione interna fondamentale per implementare in modo efficiente questi blocchi sull’hardware sottostante. Questo concetto si allinea con le strategie di suddivisione in blocchi annidati (vedi la figura a destra), che mirano a scomporre i blocchi in micro-blocchi e infine in nano-blocchi per adattarsi il più possibile alle capacità di calcolo e alla gerarchia di memoria di una macchina.
Triton Language Abbassamento delle fasi fino allo Streaming Assembly Link to heading
Analizziamo come l’istruzione di alto livello tt.load del linguaggio Triton viene tradotta in SASS. (Nota del lettore: il codice seguente è pseudocodice e non funziona correttamente).
Triton IR (TIR) Link to heading
La fase iniziale, dopo l’analisi sintattica dell’AST di Python, è rappresentata dal Triton IR indipendente dalla macchina (TIR, un dialetto MLIR). A questo livello, viene definita un’operazione tt.load su un tile, e l’operazione tt.load è un’istruzione di alto livello, non ottimizzata, che esprime un caricamento in memoria di un intero tile. Il tile può essere un singolo array, ma può anche essere un array bidimensionale, o persino uno di qualsiasi dimensione.
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
L’operazione di alto livello tt.load su un puntatore a tensore e un blocco di dati (tile). Il primo parametro di input %ptrs è tensor (array di n dimensioni) rappresentato da tensor <MxN, ptr<global f32> >. Restituisce un tensore della stessa dimensione, ma con valori anziché puntatori a valori.
In pratica, tt.load accetta anche un parametro di maschera e un valore predefinito, necessari per la lettura dai limiti della memoria (nel caso in cui le dimensioni del vettore non siano allineate sullo stride).
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
Triton-GPU IR (TTGIR / TGIT) Link to heading
Nella fase successiva, il Triton-GPU IR viene utilizzato per convertire i layout tensoriali generici in layout specifici per l’hardware, in particolare per quanto riguarda il layout della memoria e la sua distribuzione tra thread e warp. In altre parole, TGIT espande il carico n-dimensionale in operazioni di caricamento vettoriale per thread, più facili da ridurre a LLVM.
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
LLVM IR (LLIR) Link to heading
L’IR della GPU Triton viene quindi convertito in istruzioni per thread rappresentate nell’IR di LLVM. Questo IR di basso livello rappresenta fedelmente le istruzioni macchina finali e utilizza operazioni LLVM standard come l’aritmetica dei puntatori, i caricamenti in memoria e le primitive di sincronizzazione. L’astrazione tensoriale viene in gran parte eliminata, sostituita da singole operazioni di accesso alla memoria per ciascun thread.
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
Rappresentazione: Il caricamento del tile è suddiviso in una serie di singole istruzioni di caricamento con aritmetica dei puntatori per ogni elemento dati specifico del thread e, eventualmente, operazioni di memoria condivisa se la memoria condivisa è stata utilizzata come area di staging.
Assemblaggio PTX Link to heading
Quando il backend LLVM ha come target le GPU NVIDIA, il passo successivo è il passaggio a PTX. Le istruzioni di caricamento LLVM vengono mappate direttamente alle corrispondenti istruzioni di caricamento PTX.
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
SASS Link to heading
Infine, il compilatore del driver NVIDIA (ptxas) converte l’assembly PTX in SASS (Streaming Assembly), ovvero il codice macchina nativo effettivo eseguito dai core della GPU. Come visto in precedenza, questo passaggio viene solitamente eseguito Just-In-Time (JIT).
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
L’approccio di DeepSeek Link to heading
Un aspetto degno di nota è che CUDA rappresenta un metodo molto pratico per generare codice macchina per le GPU NVIDIA. Triton utilizza CUDA durante la conversione da PTX a SASS. Tale conversione a PTX viene effettuata tramite LLVM IR, ma richiede le librerie fornite con il toolkit CUDA (ad esempio, libdevice.bc).
 DeepSeek ha adottato un approccio diverso e ha optato per l’ottimizzazione manuale di PTX: gli helper del kernel PTX personalizzati sono stati scritti a mano, trattando PTX come linguaggio assembly per la GPU. DeepSeek non si è affidato a un compilatore generico per generare questo codice specifico e altamente non standard. Triton, al contrario, essendo un linguaggio generico, utilizza il back-end del compilatore LLVM standard con il target NVPTX per tradurre automaticamente la sua rappresentazione intermedia (Triton-IR/MLIR) in codice assembly PTX ottimizzato.
 Wrapper DeepSeek in csrc/kernels/utils.cuh utilizzando l’istruzione mbarrier.try_wait
Perché è importante? Citando il report tecnico di DeepSeek: Nello specifico, noi (DeepSeek) utilizziamo istruzioni PTX (Parallel Thread Execution) personalizzate e regoliamo automaticamente la dimensione del chunk di comunicazione, il che riduce significativamente l’utilizzo della cache L2 e l’interferenza con altri SM. Questo significa che il backend LLVM NVPTX non è efficiente in modo ottimale? Per me, questo significa che c’è spazio per ulteriori ottimizzazioni, non solo a livello LLVM, ma anche esponendo un ISA migliore a livello bare metal! È una situazione vantaggiosa per tutti!
Conclusion Link to heading
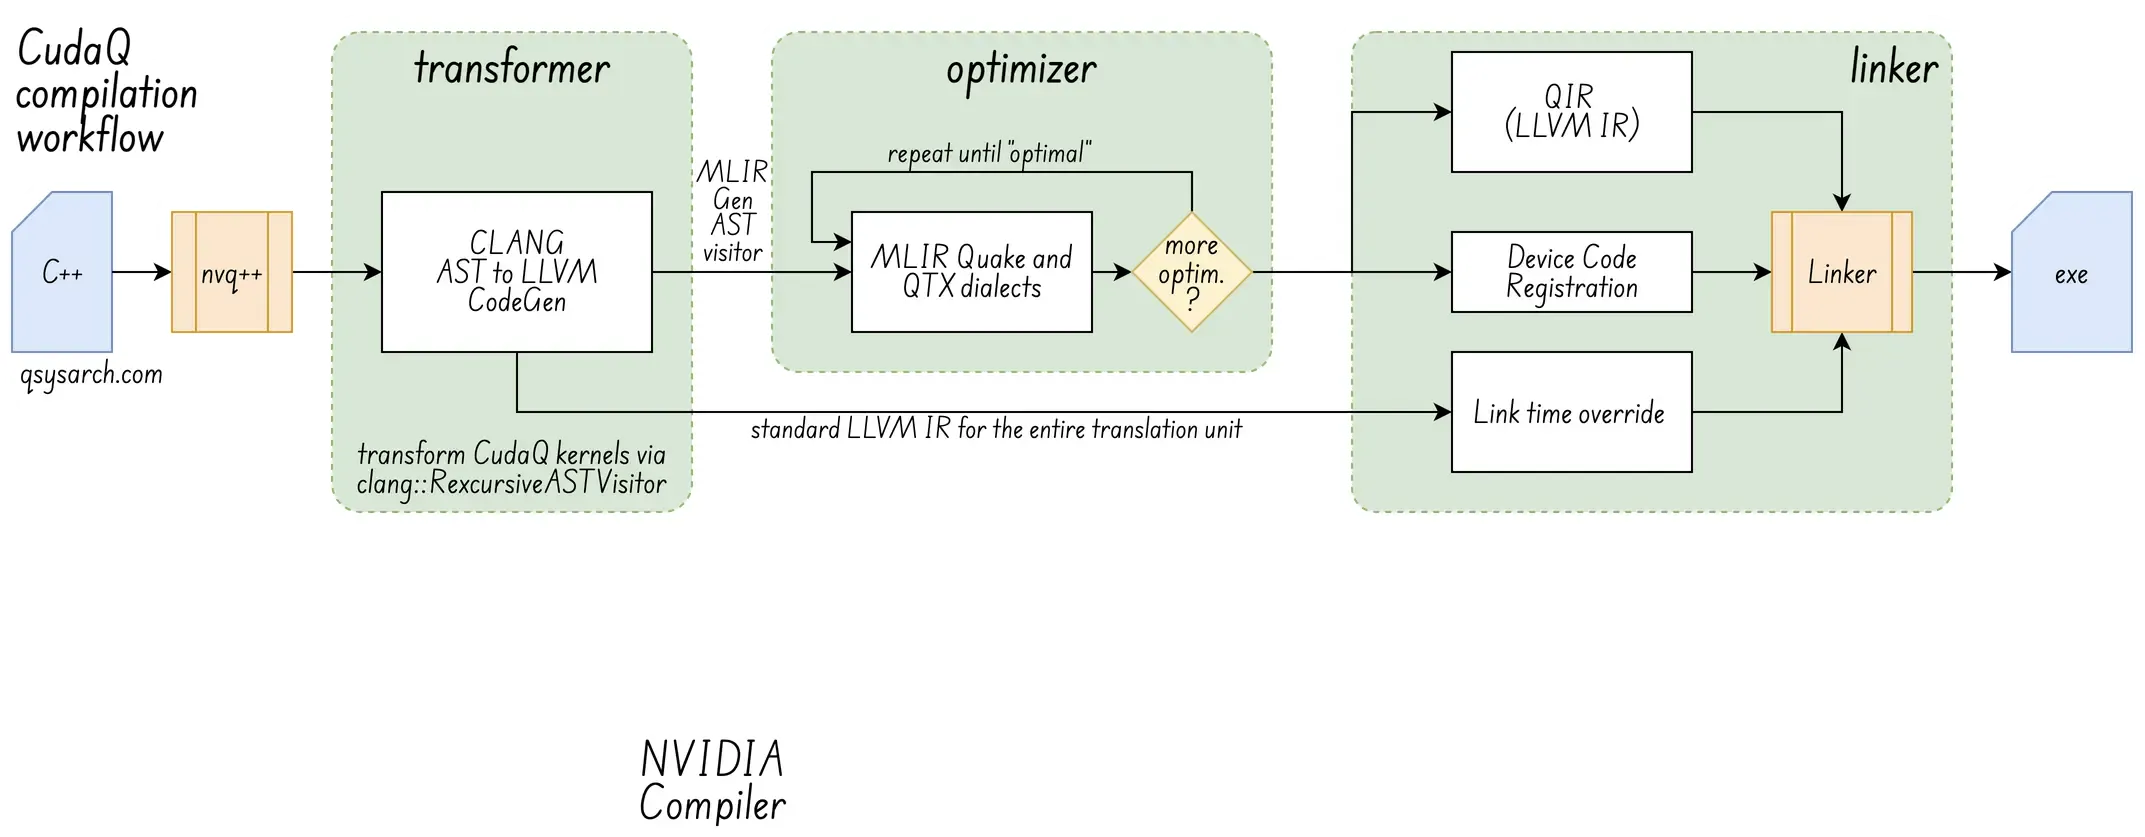
Ecco, anche questa nota informativa ha richiesto più tempo del previsto. Ma si tratta di un lavoro preliminare assolutamente necessario prima di introdurre l’architettura di Cuda-Q. Aggiornerò questo post non appena sarà pronta.
 (crediti immagine: LLVM MOS)
References Link to heading
- Deep Seek using baremetal PTX
- Usable assembly language for GPUs : a success story
- Debugging Your CUDA Applications With CUDA-GDB
- What is Streaming Assembler? SASS
- NVIDIA H100 Tensor Core GPU Architecture
- Inside NVIDIA GPUs: Anatomy of high performance matmul kernels
- The process of a CUDA program compilation using the NVCC toolchain
- Deep Dive into Triton Internals
- A Deep Dive Into AMD Triton Compilation
- Triton Kernel Compilation Stages
- Textual Alignment in SPMD Programs
- Compilers and IRs: LLVM IR, SPIR-V, and MLIR
DrawIO diagrams used in this memo: