Recentemente mi sono imbattuto nel concetto di Ingegneria della Capacità e dell’Efficienza, ovvero la disciplina che si occupa di progettare e gestire i sistemi in modo ottimale. È un pilastro fondamentale dell’architettura di sistema ed è particolarmente importante quando la scalabilità è un fattore cruciale, come nei sistemi di calcolo quantistico.
In sintesi, l’ingegneria della capacità e dell’efficienza è la scienza o la disciplina che si occupa di ottimizzare la produzione. Questo obiettivo viene raggiunto bilanciando la massima produzione (capacità) con il consumo delle risorse (efficienza).
Il vantaggio dell’ingegneria della capacità e dell’efficienza (CEE) è che si tratta di un ambito ben definito, ampiamente trattato in letteratura e supportato da pratiche ingegneristiche ben strutturate. Questo documento si propone di estrarre alcuni concetti chiave utilizzati nella CEE.
Pilastri dell’ingegneria della capacità e dell’efficienza Link to heading
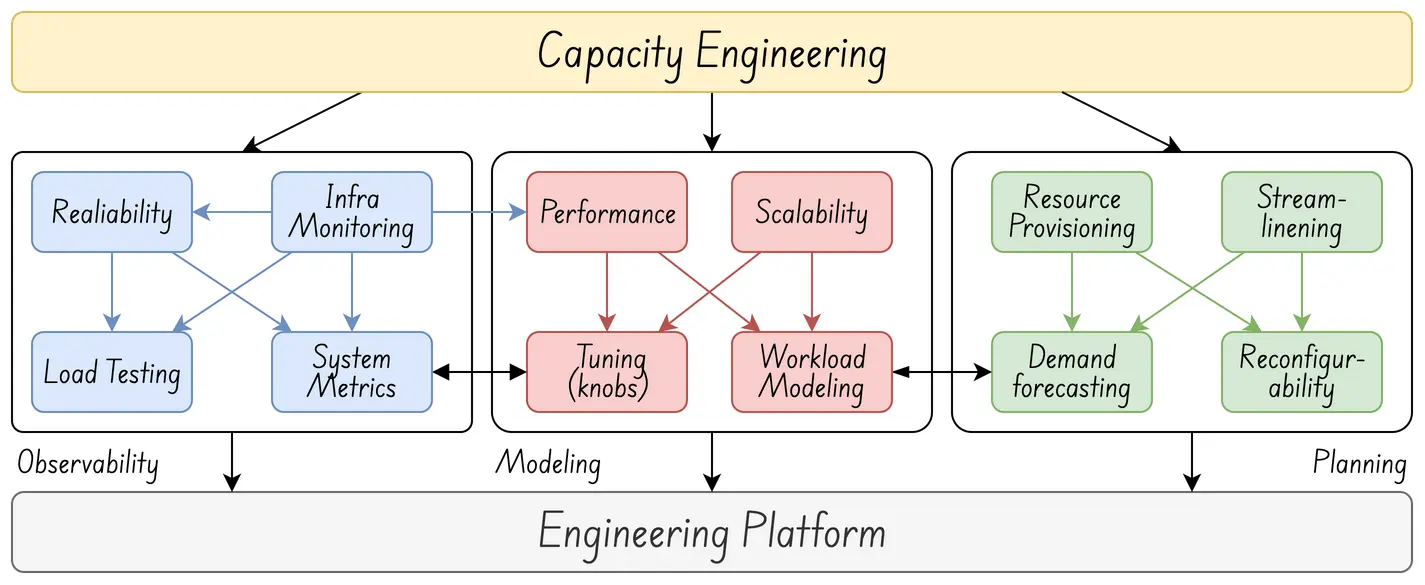
L’ingegneria della capacità e dell’efficienza si basa su tre pilastri fondamentali: osservabilità, modellazione e pianificazione.
Osservabilità
Modellazione
Pianificazione
L’obiettivo finale è creare un piano che possa essere simulato efficacemente utilizzando un modello. Il modello deve essere convalidato confrontandolo con osservazioni empiriche. Modellando la crescita, identificando i colli di bottiglia e allocando le risorse in modo strategico, il piano previene sovraccarichi o sottoutilizzo, garantendo così un funzionamento ottimale del sistema.
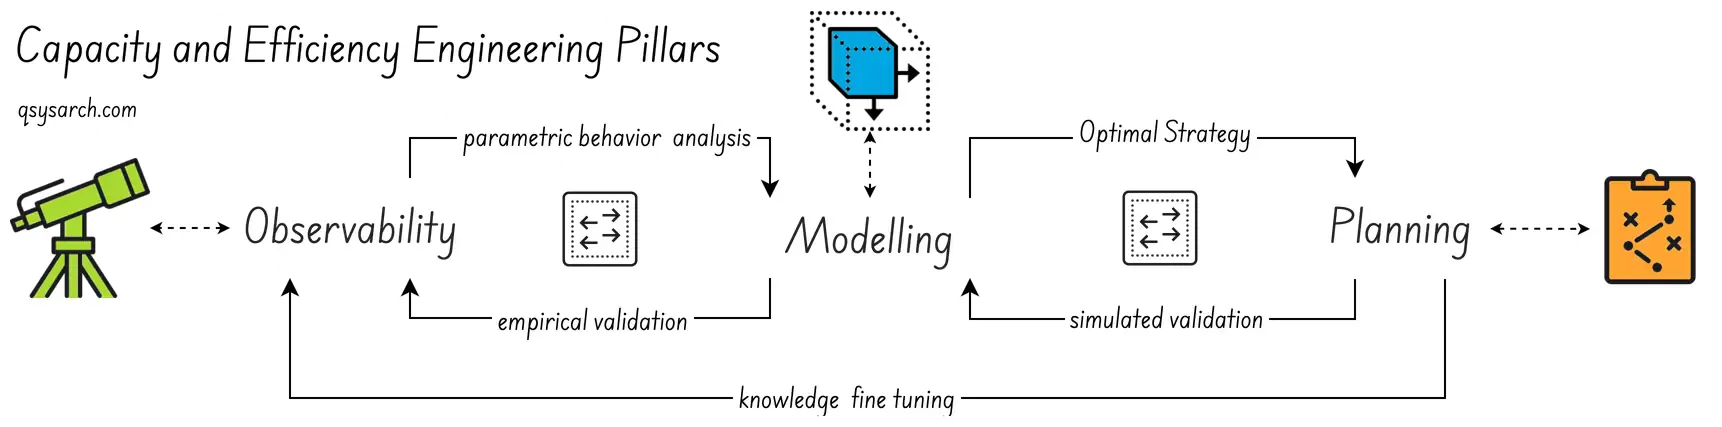
Va notato che la risorsa di sistema può essere qualsiasi cosa. Potrebbe variare da risorse IT come CPU o memoria a personale o macchinari. Infatti, il CEE può essere applicato in diversi ambiti. Ad esempio, può contribuire a ottimizzare l’allocazione delle risorse umane nella gestione dei progetti o a ridurre i costi di hosting cloud nella gestione delle infrastrutture.
Osservabilità
 Link to heading
L’osservabilità è l’analisi empirica di un sistema. Nei sistemi informatici, i log vengono spesso confusi con l’osservabilità, ma rappresentano solo una parte del quadro generale. Ad esempio, lo standard OpenTelemetry comprende molteplici segnali osservabili: log, metriche, tracce e dati di sistema. Per CEE, un’osservabilità efficace dovrebbe fornire:
Utilizzo delle risorse: Osservazione e monitoraggio del consumo delle risorse. L’osservazione deve specificare cosa, quando e da chi viene utilizzata la risorsa, e se si sono verificati errori.
Metriche di prestazione: Monitora gli indicatori chiave di prestazione (KPI) come la latenza e la velocità di elaborazione. Inclusi rendimento, sprechi o tassi di errore.
Identificazione dei colli di bottiglia: Individuare i vincoli del sistema che riducono la produttività.
La chiave sta nel poter eseguire un’analisi post-mortem del sistema in tutte le condizioni, sia durante i periodi di carico elevato, manutenzione o inattività. È fondamentale comprendere nel dettaglio cosa è successo, quando e perché. Senza tali elementi osservabili, sarebbe impossibile identificare le cause profonde del guasto del sistema.
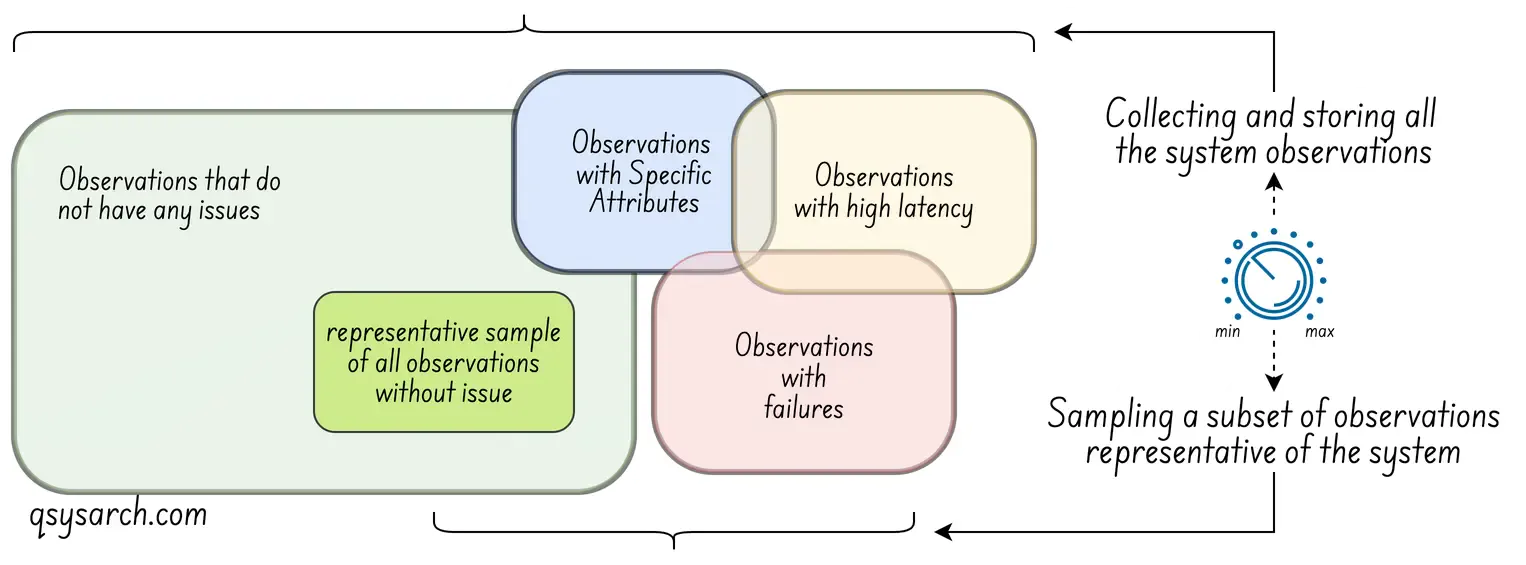
Naturalmente, raccogliere l’intera osservazione di un sistema completo presenta delle difficoltà: le osservazioni possono essere molto costose, o addirittura distruttive (come nel caso del calcolo quantistico, dove la misurazione di un sistema può modificarne lo stato, un fenomeno noto come effetto osservatore). Ciò significa che il semplice atto di osservare il sistema può alterarne il comportamento e degradarne le prestazioni. La soluzione a questo problema è il campionamento (raccolta di dati solo da alcuni eventi anziché da tutti). L’idea è di rendere la frequenza di campionamento (frequenza di raccolta dei dati) un parametro di sistema regolabile, come mostrato nel diagramma seguente (fonte: OpenTelemetry).

Per un sistema non informatico, un’osservabilità efficace consentirebbe, ad esempio, di spiegare il motivo del ritardo di un progetto. I dati osservabili sarebbero probabilmente i documenti tecnici e non tecnici previsti dalla norma ISO 9001 che illustrano le decisioni tracciabili prese durante ciascuna fase del progetto.
Modellazione
 Link to heading
Una volta stabilita l’osservabilità, si può iniziare a comprendere il comportamento parametrico analitico del sistema. Questo comportamento costituisce la base per il pilastro successivo: può essere descritto e tradotto in un modello parametrico. Il passo successivo consiste nel chiarire cosa tale modello deve fornire, dato un insieme di parametri o condizioni:
Prestazioni: Qual è la velocità di trasmissione e la latenza massime che il sistema può fornire?
Costo operativo: Qual è il costo di gestione del sistema, in termini di risorse allocate? Questo costo può variare a seconda dell’ora del giorno.
Riconfigurazione: Qual è l’impatto transitorio (effetti temporanei) dell’aggiornamento dei parametri di sistema? Ad esempio, quando si alloca un nuovo server o QPU e lo si configura correttamente.
La chiave sta nel simulare il comportamento del sistema e osservarne le prestazioni in diverse condizioni operative. Poiché il modello include i costi delle risorse, può mostrare i compromessi di costo in queste condizioni. Queste informazioni sono importanti per la fase di pianificazione.
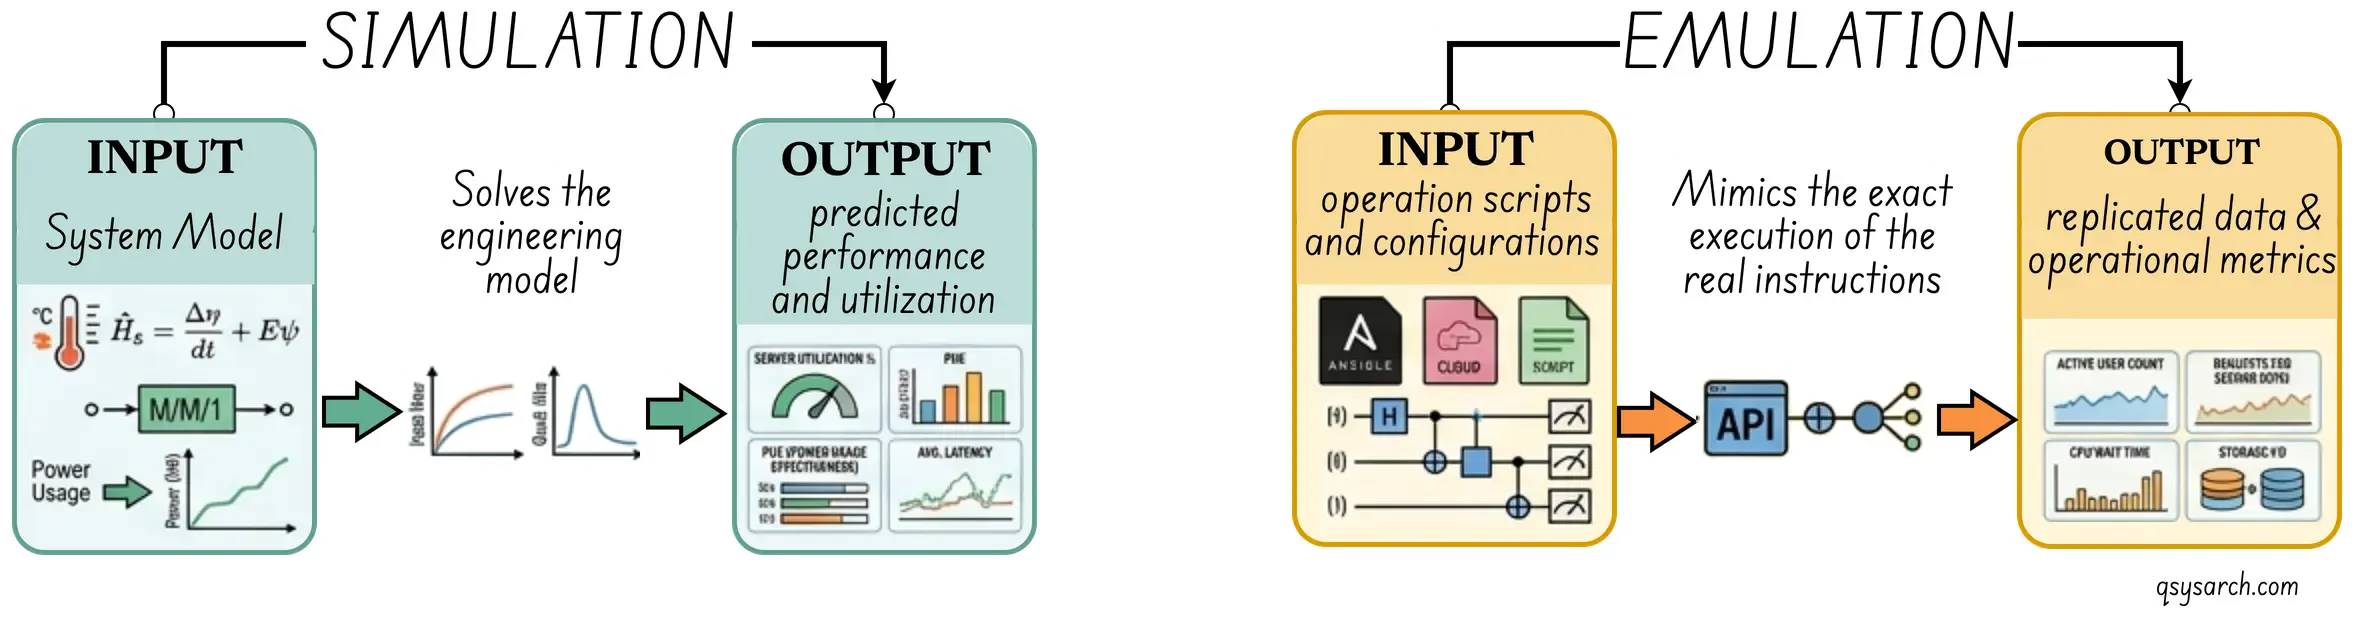
È opportuno precisare la differenza tra simulazione ed emulazione. In linea generale, l’emulazione crea una versione fittizia del sistema, mentre la simulazione opera su un modello astratto del sistema stesso. Con l’emulazione è possibile confrontare le prestazioni emulate con quelle reali, poiché gli input sono gli stessi. Presumo che nel contesto di CEE, il modello si riferisca principalmente a un simulatore.
Un buon modello per un sistema non informatico potrebbe prevedere gli effetti dell’aggiunta di ulteriori risorse a un progetto. E in effetti, a volte, l’aggiunta di risorse diminuisce le prestazioni del sistema. Questo risultato controintuitivo è noto come Legge di Brooks.
Pianificazione
 Link to heading
Con il modello a disposizione, è possibile iniziare a pianificare le operazioni di sistema. Utilizzate il modello per simulare diverse condizioni e individuare quelle ottimali. Sfruttate questi risultati per assegnare strategicamente le risorse in base alla domanda. Un buon piano dovrebbe prevedere la previsione della domanda, la gestione dei costi e i sistemi di sicurezza. La previsione stima l’utilizzo futuro, il traffico o le esigenze. Il controllo dei costi evita il sovradimensionamento, garantendo al contempo la capacità necessaria per i periodi di picco. I sistemi di sicurezza forniscono margini di sicurezza per gestire le richieste impreviste.
La chiave è far funzionare il sistema in modo efficiente e affidabile. Gestire i picchi di carico senza guasti. Garantire la redditività. La previsione della capacità consente una riconfigurazione proattiva. Fornire un margine di sicurezza sufficiente per far fronte a eventi imprevisti.
Il piano combina lo scenario migliore, in cui la domanda è conforme alle aspettative, e lo scenario peggiore, in cui la domanda è superiore o inferiore alle aspettative. Questo approccio consente di ottenere un’allocazione della capacità ottimale in termini di costi.
Messa a punto del modello Link to heading
Il dilemma dell’uovo e della gallina Link to heading
Progettare un buon modello è un problema del tipo “uovo o gallina”. Se non si sa cosa osservare e come osservarlo all’interno del sistema, è difficile costruire un modello efficiente e accurato. Senza un modello accurato, è improbabile che il piano produca buoni risultati.
Quando si verificano discrepanze tra il piano simulato e il comportamento reale, si cerca di individuare i parametri mancanti. Questo viene solitamente fatto analizzando a posteriori i log del sistema osservato. L’obiettivo è identificare nuovi parametri da monitorare.
Questo ciclo di apprendimento è rappresentato come affinamento della conoscenza nel diagramma sopra.
La piattaforma di ingegneria Link to heading
CEE di per sé non sarebbe sufficiente senza una piattaforma automatizzata a supporto dell’intero flusso di lavoro. Questa piattaforma di ingegneria è rappresentata nel diagramma sottostante.
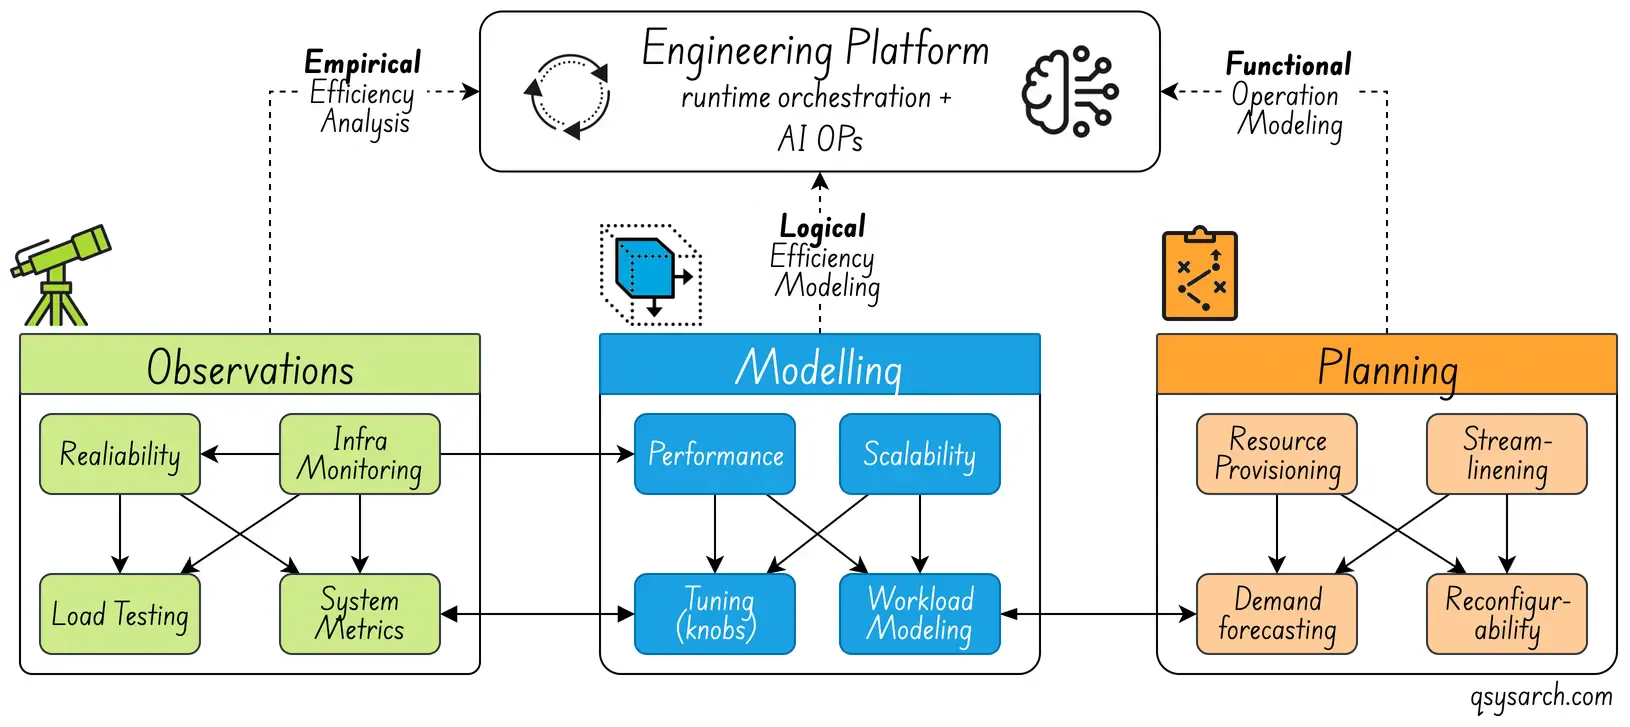
L’idea alla base della piattaforma di ingegneria non è solo quella di automatizzare il processo di scalabilità del sistema, che può essere delegato ad agenti Ai Ops. Si tratta anche di verificare continuamente l’adeguatezza del modello simulato rispetto alle osservazioni empiriche e di segnalare le discrepanze a un agente di apprendimento automatico (ML) in grado di perfezionare il modello. Questo agente è probabilmente basato sull’apprendimento per rinforzo, che dovrebbe essere governato se utilizzato in tempo reale.
Il costo di non riuscire a scalare abbastanza velocemente, ovvero il costo del ritardo. Link to heading
Affinché un sistema sia stabile e robusto, le prestazioni dovrebbero essere limitate a livelli stabili, non massimi. Come regola generale, le prestazioni stabili si aggirano intorno ai due terzi delle prestazioni massime. Oltre questa soglia, il sistema si degrada. Il costo dei tempi di inattività può quindi superare rapidamente, spesso in modo esponenziale, il costo del sovradimensionamento.
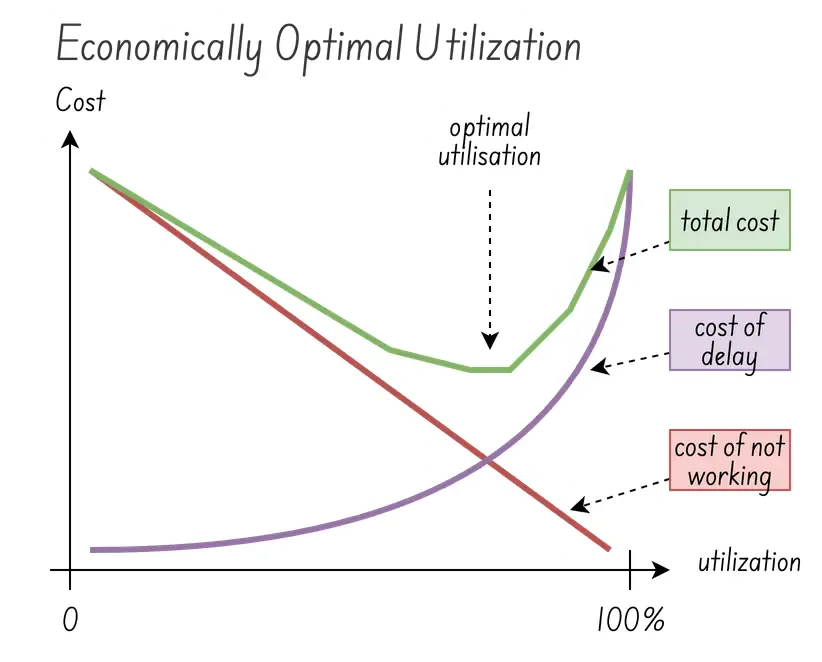
Nell’immagine a destra, il costo del ritardo può essere considerato come l’impatto finanziario derivante dall’impossibilità di soddisfare la domanda durante l’ampliamento del sistema (in tempo reale). Si tratta di un costo transitorio. Quando l’utilizzo è basso, il ritardo incide solo su poche richieste. Ma quando l’utilizzo è elevato, il ritardo incide su molte richieste e il costo del ritardo aumenta esponenzialmente.
Il punto ottimale è l’utilizzo ideale che minimizza sia il costo del ritardo sia il costo del mancato funzionamento (sovradimensionamento). La curva verde mostra il costo totale come somma di questi due fattori. Il minimo locale di questa curva, solitamente intorno ai 2/3 delle prestazioni massime, indica l’utilizzo ottimale. In realtà c’è molto altro da dire sul punto ottimale, che sicuramente alcuni sosterranno essere intorno all'80%. La chiave è capire che ridurre il costo del ritardo ottimizzando il sistema consente di innalzare il livello di utilizzo ottimale (immagine tratta da: show me the data).
Ottimizzazione del sistema Link to heading
Il costo del miglioramento Link to heading
Se ridurre il costo dei guasti di un sistema significa minimizzare il tempo necessario per la scalabilità, immaginiamo un sistema in grado di adattarsi in millisecondi, o addirittura microsecondi, per scalare e soddisfare la domanda. Certo, sviluppare un sistema del genere può essere molto costoso (si pensi all’HFT). Ma cosa succederebbe se il costo di sviluppo di un sistema simile fosse inferiore al beneficio derivante dalla possibilità di gestirlo a un livello di utilizzo più elevato?
Anche questa sfida rientra nel contesto del CEE (Configurazione Economica e Commerciale). Modellando il costo del miglioramento del sistema, è possibile creare un piano che bilanci i costi con i benefici. Si tratta meno di una sfida operativa e più di un investimento strategico. Tuttavia, è comunque guidata dagli stessi principi del CEE applicati alla strategia operativa dell’azienda, vista come un sistema.
Mappatura del flusso di valore Link to heading
La mappatura del flusso di valore (Value Stream Mapping, VSM), nel contesto dell’ingegneria della capacità e dell’efficienza, è comunemente utilizzata come strumento diagnostico per determinare dove viene consumata la capacità, consentendo l’identificazione delle cause profonde degli sprechi e dei colli di bottiglia.
Un flusso di valore (Value Stream, VSM) rappresenta ogni fase, o attività, del flusso di lavoro utilizzato dal sistema per erogare un servizio, e la mappa è una rappresentazione visiva di questo flusso end-to-end. Il VSM distingue tre tipi di attività:
Valore aggiunto (VA): Passaggi che contribuiscono direttamente al risultato desiderato dal cliente (ad esempio, il calcolo effettivo).
Attività non a valore aggiunto ma necessarie (NNVA): Passaggi richiesti dal sistema ma privi di valore diretto per il cliente (ad esempio, strette di mano).
Spreco (Muda, o 無駄, termine giapponese che significa “spreco”): Passaggi che consumano capacità senza aggiungere alcun valore.
L’obiettivo è eliminare i passaggi Muda, e VSM eccelle nell’identificarli. La forza di VSM risiede nella sua capacità di individuare le ottimizzazioni giuste che possono ridurre il lavoro in corso (WIP). Questo è importante a causa della Legge di Little, che afferma che il tempo medio di consegna (o tempo di ciclo) è uguale al lavoro in corso (WIP) medio diviso per la produttività media:
Questo significa che se il WIP raddoppia, anche i tempi di consegna raddoppiano, pur se la produttività rimane invariata. Il controllo del WIP rappresenta quindi una delle leve più dirette per migliorare la latenza di consegna (il “ritardo”) e, di conseguenza, l’efficienza del sistema.
Conclusion Link to heading
Ecco, questo breve promemoria domenicale sull’ingegneria della capacità e dell’efficienza (CEE) mi ha aiutato a comprendere meglio l’argomento. Per ora, ciò che voglio ricordare è che, quando un sistema presenta un’efficienza molto bassa, è molto probabile che il sistema, o i suoi flussi di lavoro, siano sovraccarichi di Muda. La risposta a questa sfida: investire nella riduzione del costo del ritardo piuttosto che sovradimensionare?
References:
- What Is Engineering Capacity Planning? (And why Most Teams Get it Wrong)
- Engineering Fundamentals Playbook
- Engineering Capacity Planning: Processes, Strategies, and Tools
- https://www.cloudbees.com/blog/measuring-engineering-efficiency
- The Capacity Utilization Myth – Why 100% Kills Efficiency
- Engineering — Efficiency vs Effectiveness vs Productivity
- How a Director of Engineering Measure Engineering Efficiency?
- The Capacity Utilization Myth – Why 100% Kills Efficiency
- OpenTelemetry
- Simulation vs Emulation
DrawIO diagrams used in this memo:


Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|---|---|---|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
| Key methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
| Unique angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
| Metrics emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |