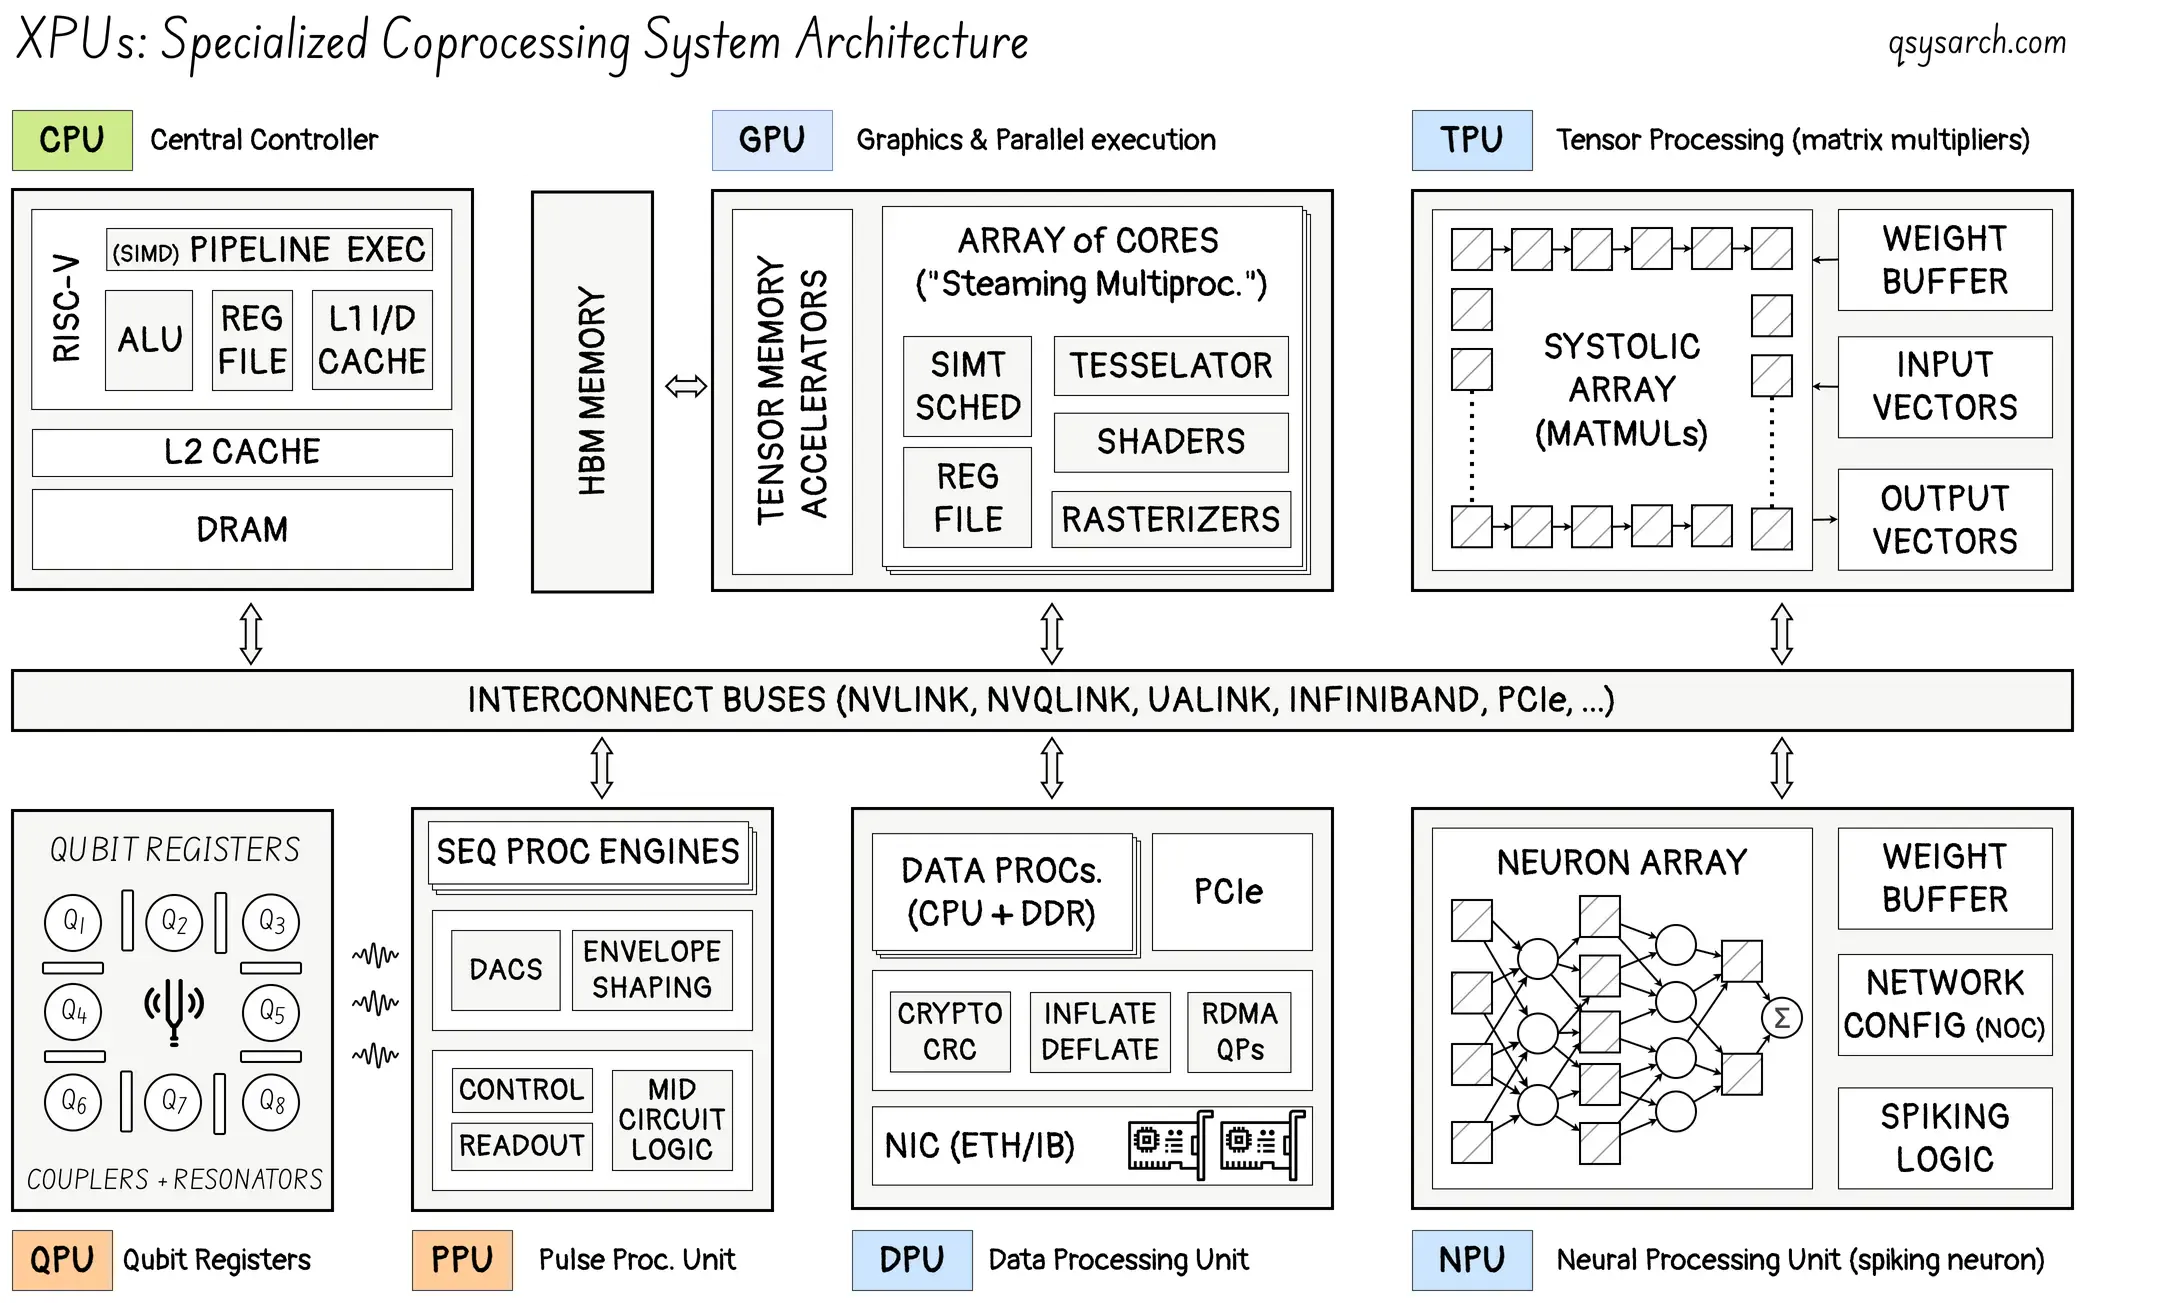
xPU: è un termine generico che indica un’unità di elaborazione (PU) specializzata, dove “x” può rappresentare qualsiasi architettura di calcolo personalizzata per uno specifico carico di lavoro. Le varianti più comuni includono GPU (grafica), TPU (tensoriali/IA), NPU (neurali), DPU (dati) o PPU (a impulsi, utilizzate principalmente per gli stack di controllo quantistico).
Questo brevissimo promemoria si propone di fornire spunti di riflessione sul panorama del mercato xPU applicato all’inferenza dell’IA.
Panorama del mercato Link to heading
Analizzando il panorama di mercato degli ASIC per l’inferenza AI, l’aspetto più utile potrebbe non essere la pura performance, bensì la sostenibilità della differenziazione di un fornitore su un orizzonte temporale di 3-5 anni. Da questa prospettiva, emergono tre cluster:
La piattaforma universale: NVIDIA e gli integratori verticali: AMD, Google
gli sfidanti attuali Groq, Cerebras, FuriosaAI, Positron, SambaNova, Axelera AI.
Le sfide future: Extropic, Normal Computing, Unconventional, Mottronix, Akhetonics
Piattaforma universale Link to heading
Architettura: GPU (architettura Blackwell nel 2024)
Punti di forza principali: vincolo all’ecosistema, profondità dello stack software, integrazione completa del sistema
Carico di lavoro target: Universale — Addestramento e inferenza LLM su larga scala - Shader grafici
Vulnerabilità: costi elevati, elevato consumo energetico; non ottimizzato per il calcolo sparso
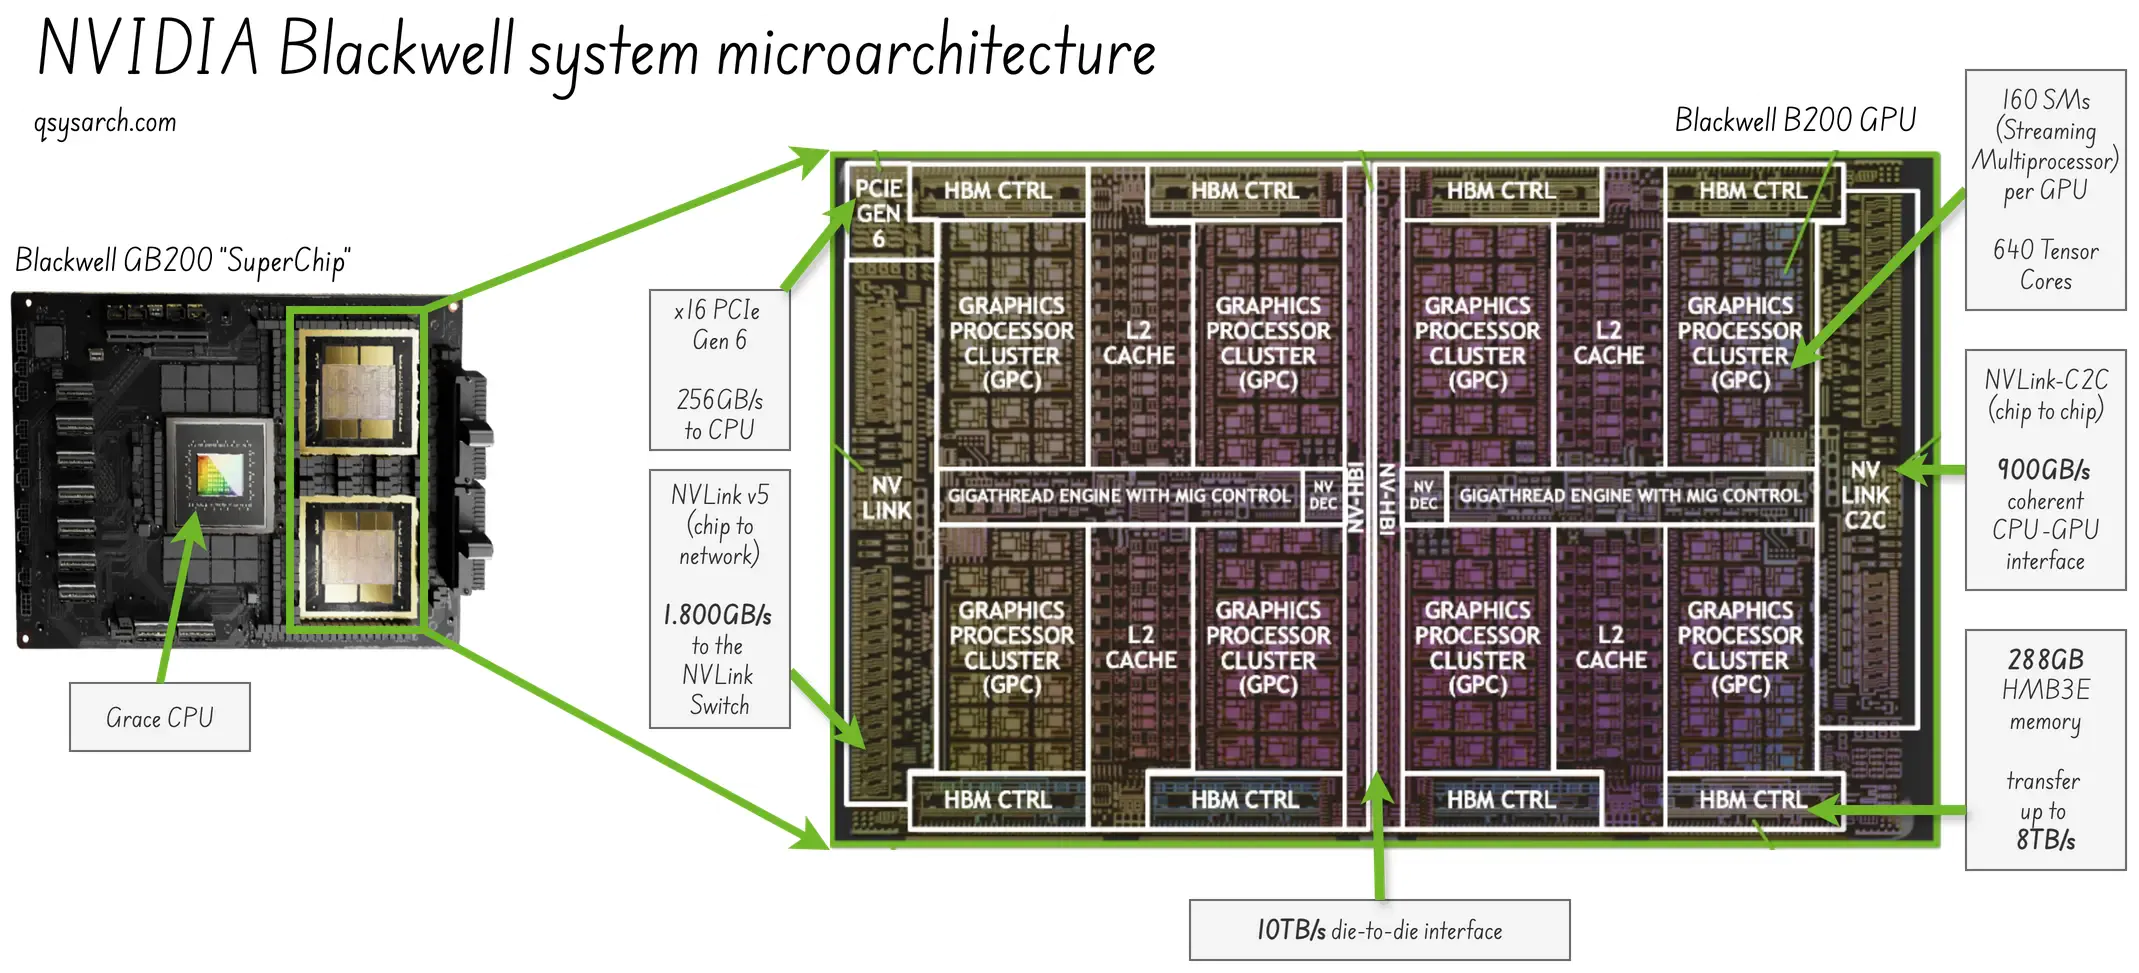
Integratori verticali Link to heading
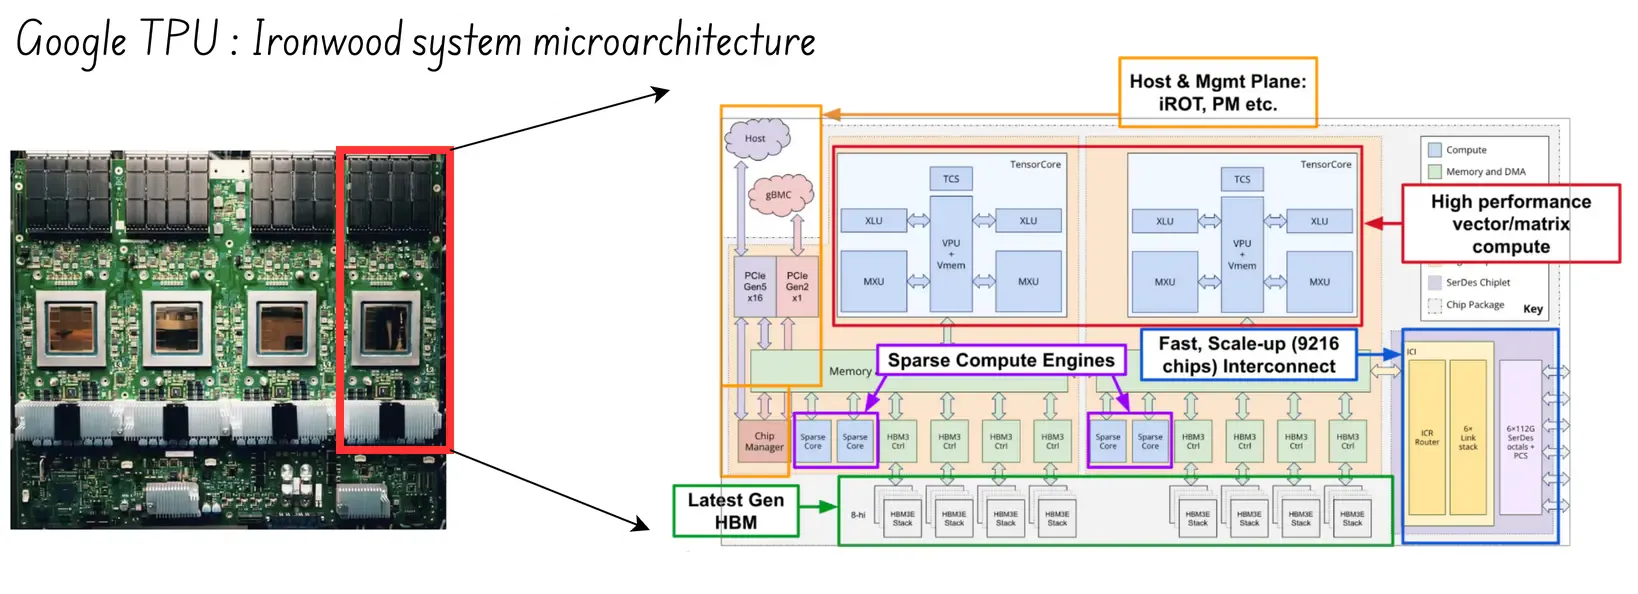
Architettura: TPU, ASIC personalizzato (sistolico)
Punto di forza principale: Integrazione verticale; costi più bassi su scala Google
Carico di lavoro di destinazione: carichi di lavoro di Google Cloud, inferenza Gemini
Vulnerabilità: disponibile solo da Google Cloud; non è possibile acquistare i core TPU da Google
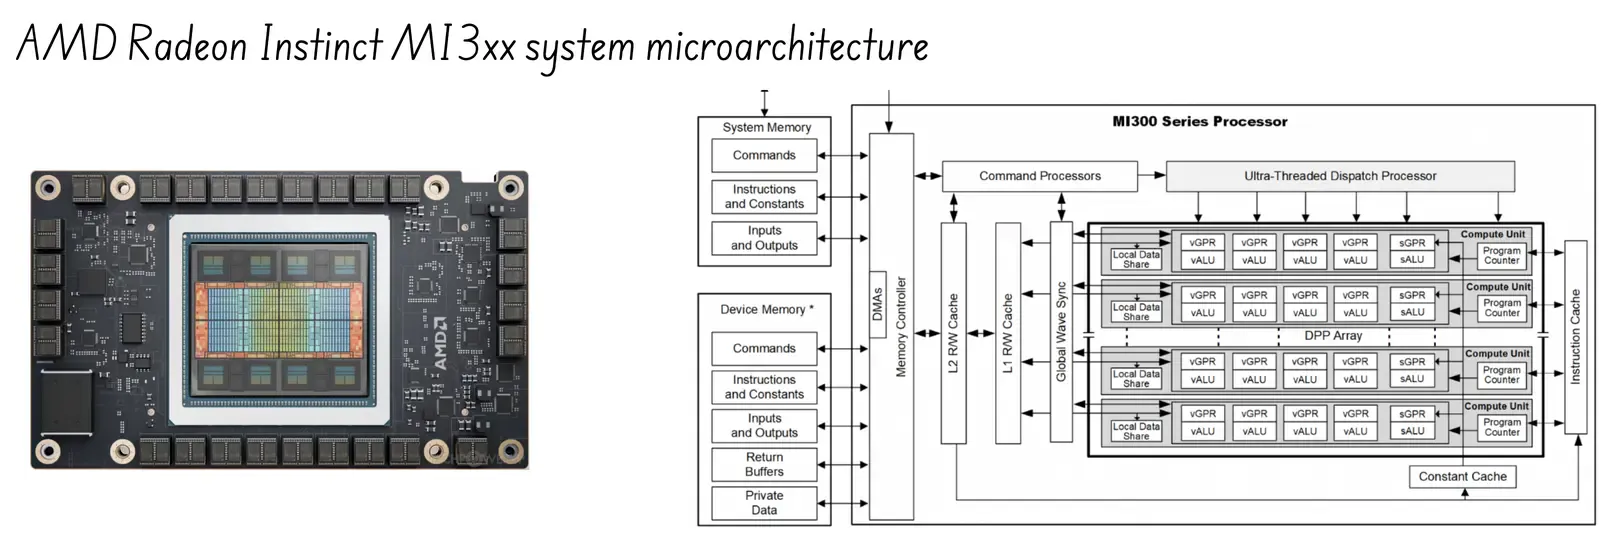
Architettura: MI300 Instinct + ROCm (CUDA proprietario di AMD)
Punti di forza principali: alternativa di prezzo CUDA; modello GPU familiare;
Carico di lavoro target: Calcolo ad alte prestazioni (HPC) e inferenza sensibili ai costi del cloud
Vulnerabilità: divario software rispetto a CUDA; ritardo rispetto all’ecosistema all’avanguardia (ad es. NVQLINK)
Gli sfidanti già acquisiti Link to heading
Groq (acquisita da NVIDIA)
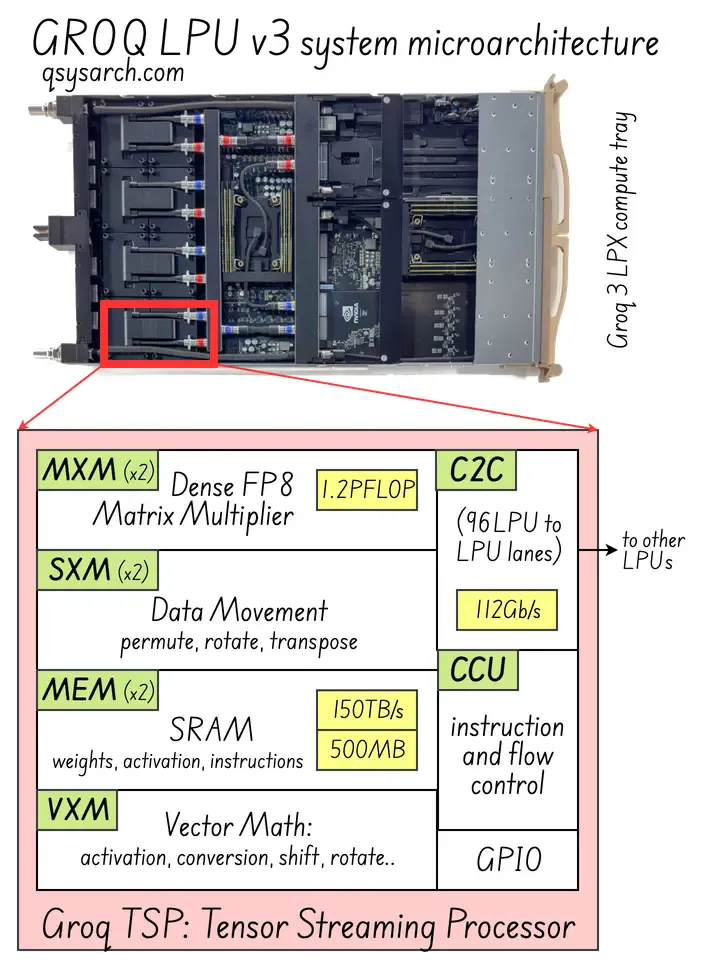
Architettura: LPU (Unità di elaborazione del linguaggio)
Principio di funzionamento: basato sull’architettura Tensor Streaming Processor (TSP), il tempo di esecuzione è completamente prevedibile fino al ciclo di clock esatto.
Punto di forza principale: Latenza ultra-bassa deterministica; nessun collo di bottiglia della memoria; tutto è “disciplinato” in anticipo dal compilatore.
Carico di lavoro di destinazione: inferenza in tempo reale
Vulnerabilità: sacrificare la velocità per lo spazio: non dispone di una grande memoria HBM (memoria ad alta larghezza di banda) ma solo di una piccola SRAM super veloce integrata (anche se questo la rende un ottimo complemento all’ecosistema Nvidia Blackwell ora che è stata acquisita da NVIDIA!).
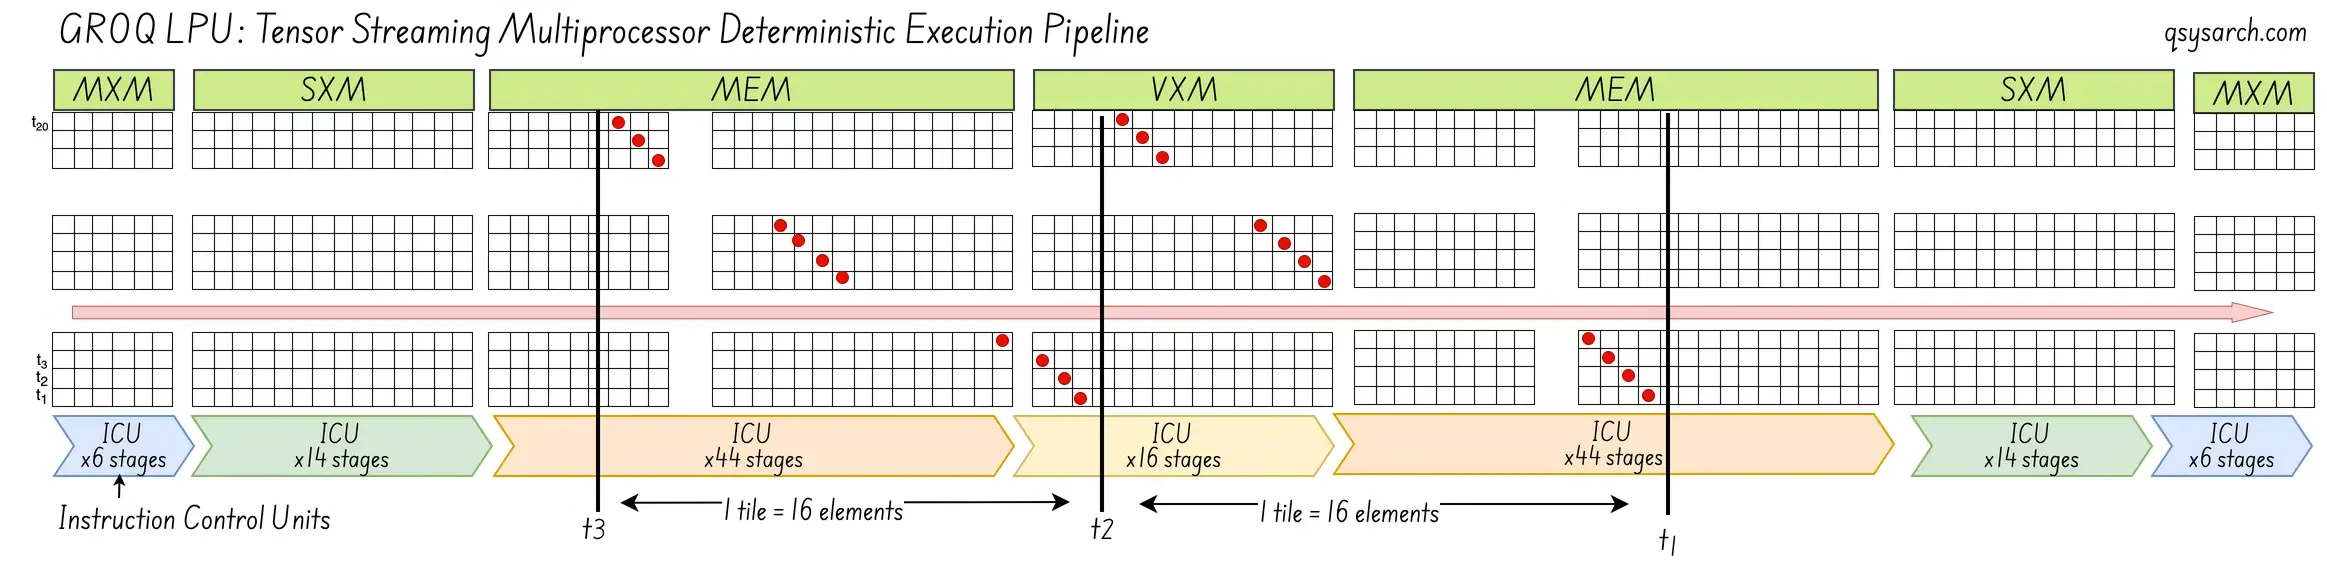
Si noti che l’architettura Groq LPU è stata presentata nel 2020, lanciata commercialmente nel 2024 e acquisita nel 2026. Questo offre una buona tempistica per le aspiranti aziende “unicorno”: 4 anni per lo sviluppo, 2 anni per confermare la penetrazione nel mercato e il jackpot se un player più grande sente la pressione della concorrenza!
Gli attuali sfidanti Link to heading
Uno studio approfondito delle soluzioni di seguito elencate potrebbe facilmente richiedere diversi giorni per ciascuno dei fornitori; tempo che non ho avuto a disposizione per redigere questa nota. Pertanto, vi prego di prendere la descrizione seguente con le dovute cautele, poiché potrebbe essere incompleta e/o soggettiva.
SambaNova [quasi acquisito da Intel]
- Architettura: RDU (unità di flusso dati riconfigurabile); consente pipeline di elaborazione dati integrate personalizzate per l’intero grafo computazionale, minimizzando il movimento dei dati e garantendo un elevato utilizzo dell’hardware. Il diagramma seguente mostra l’architettura dettagliata delle PCU (Pattern Compute Units) e PMU (Pattern Memory Units) utilizzate nel loro SN40L:
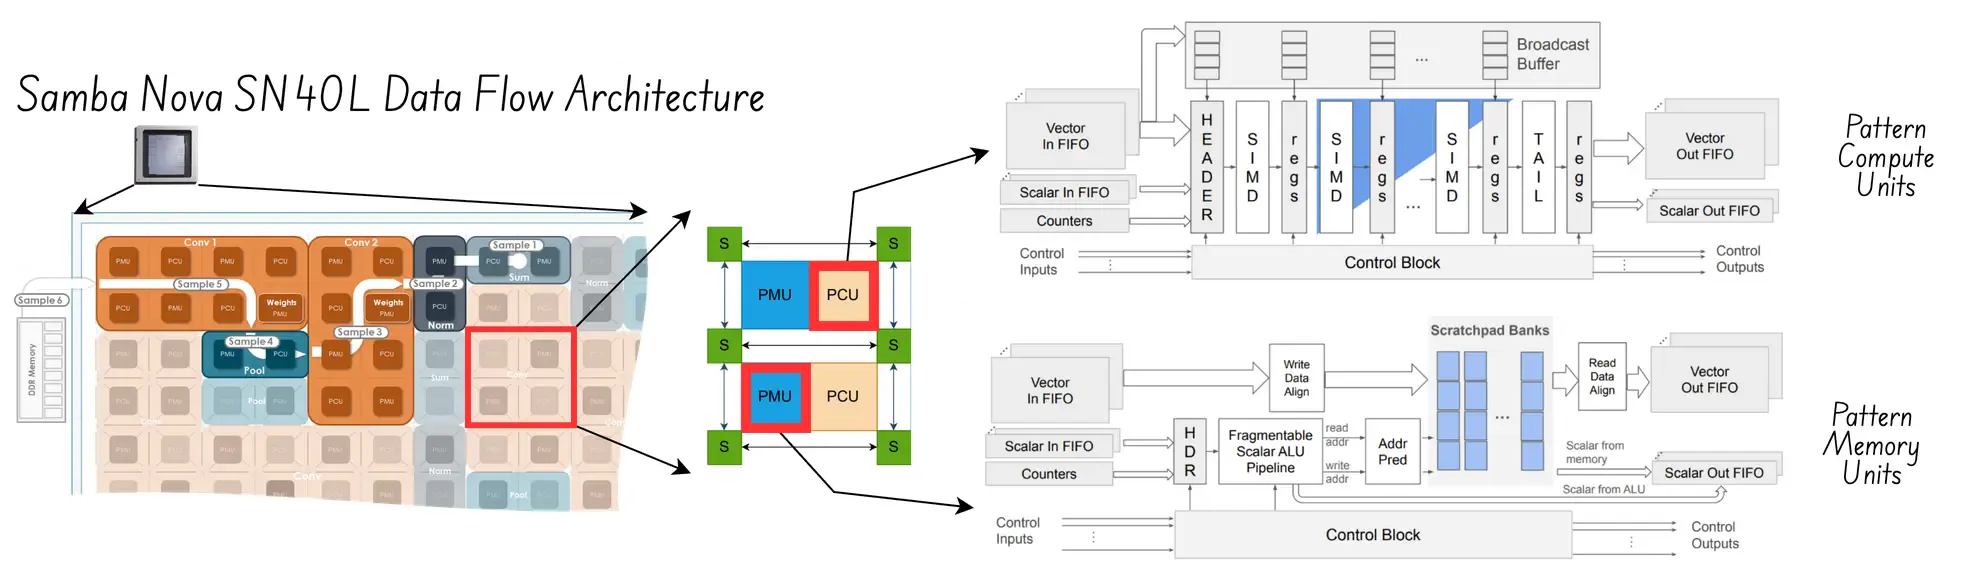
Punto di forza principale: garantisce il massimo utilizzo dell’hardware suddividendo attentamente i flussi di sistema tra le pipeline di inferenza concorrenti; include uno stack software completo, compresa un’integrazione di alto livello con Kubernetes, un compilatore per PyTorch e TensorFlow, nonché analizzatori DataFlow.
Carico di lavoro target: Aziende, ambienti verticali regolamentati on-premise.
Vulnerabilità: elevato costo iniziale del sistema per l’hardware, che deve essere ammortizzato su un lungo periodo di tempo affinché il costo totale di proprietà (TCO) risulti interessante.
Architettura: Wafer-Scale Engine (WSE) che funge da gigantesco moltiplicatore di matrici pipeline.
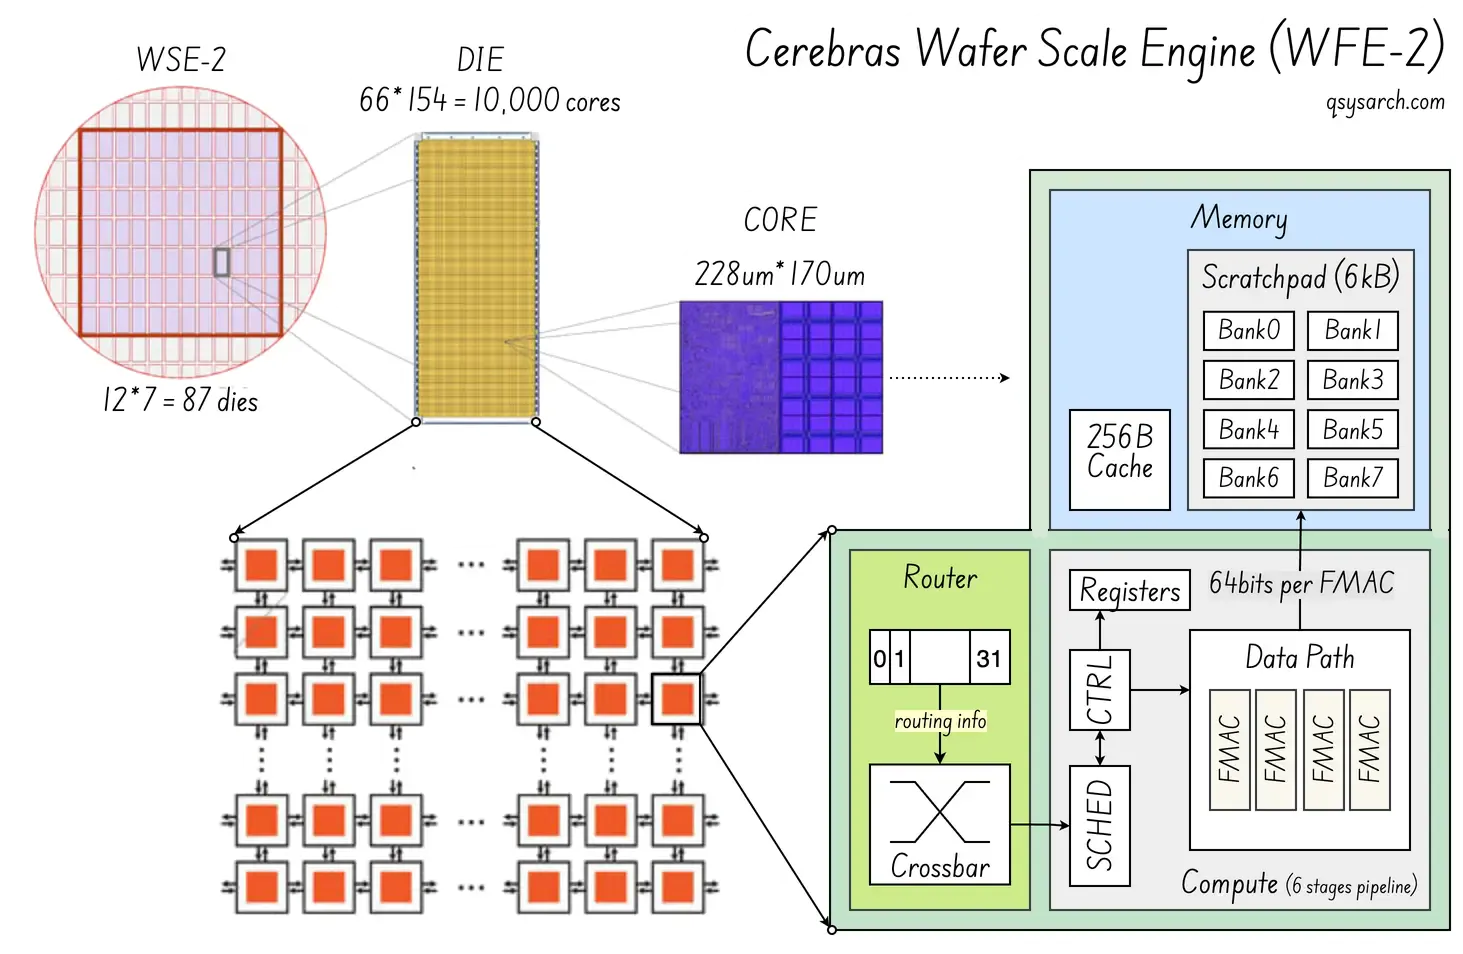
Punti di forza principali: SRAM on-chip di grandi dimensioni che elimina il collo di bottiglia HBM. Core indipendenti ad alta densità (fino a 850.000 per il WSE-2) in grado di “eseguire calcoli tensoriali in memoria”. Router fabric a latenza di clock singola tra i nodi sul wafer.
Carico di lavoro target: inferenza LLM di grandi dimensioni, in particolare modelli sparsi.
Vulnerabilità: richiede uno stack software di prim’ordine per sfruttare appieno la scalabilità massiccia (come per tutte le microarchitetture “PIM” o di elaborazione in memoria).
- Architettura: Tensor Contraction Processor (TCP), commercializzato come ASIC Renegade (RGND). Rispetto agli array sistolici TPU, che hanno una griglia fissa, l’architettura TCP di Furuisa utilizza piccole unità di calcolo configurabili che possono essere riorganizzate dinamicamente (come un NOC super intelligente).
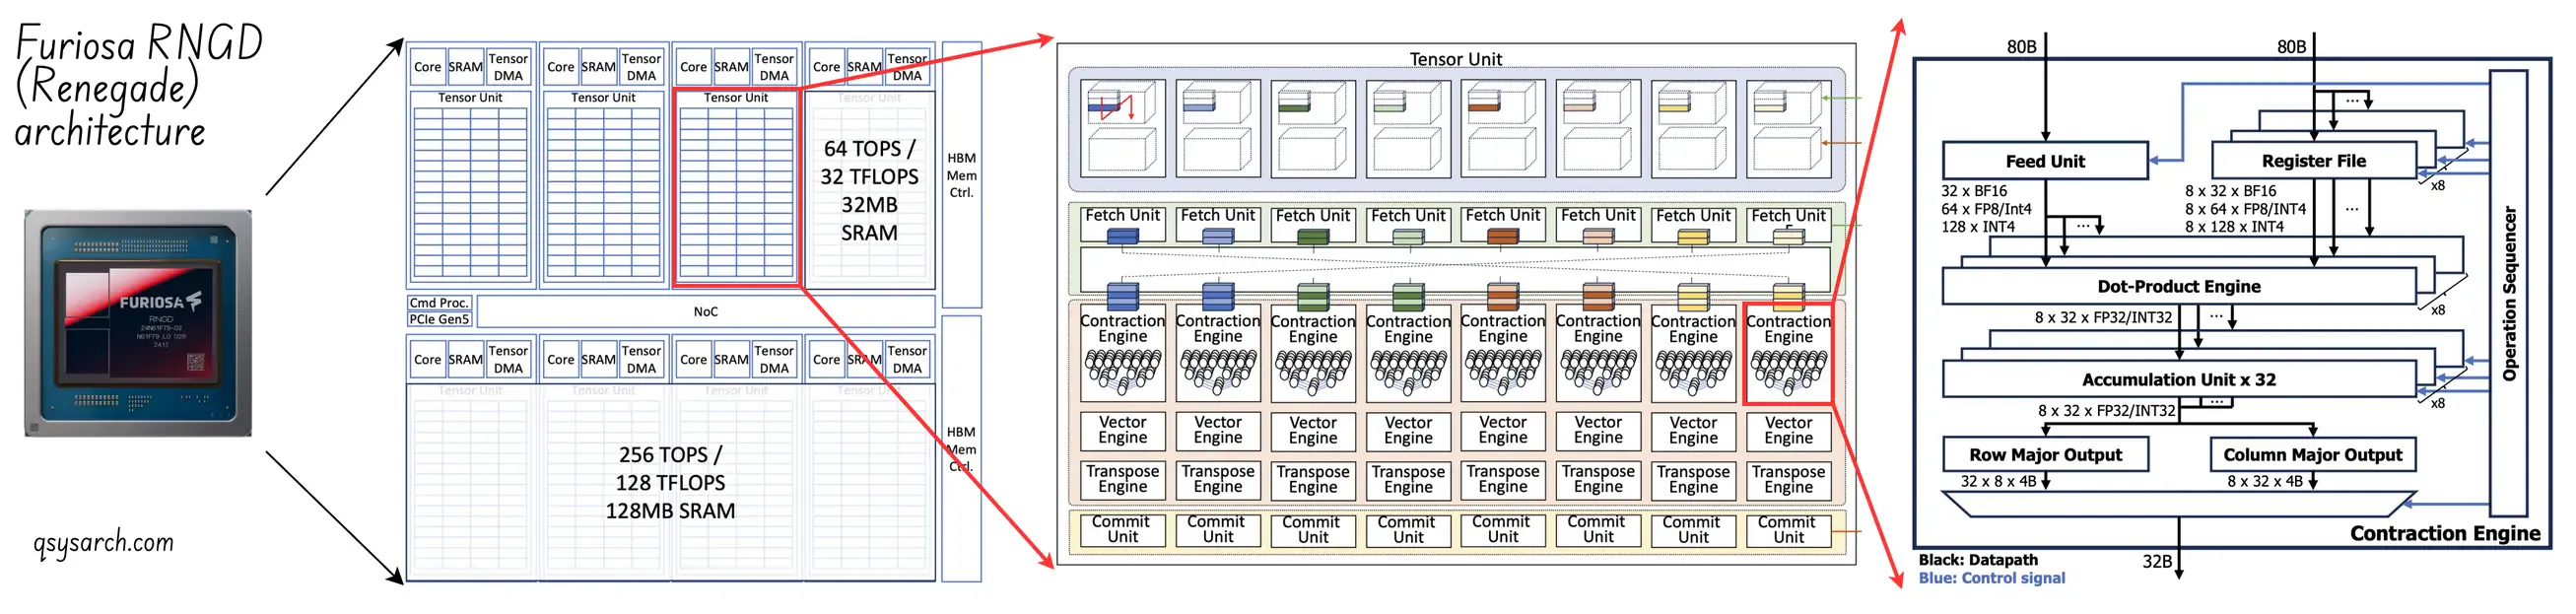
Punto di forza principale: Introducendo il NOC “fetch”, Furiosa introduce la programmabilità spazio-temporale della rete tensoriale TPU, portando il livello di efficienza a un livello superiore, adattandosi perfettamente al carico di lavoro di calcolo e ai processori di contrazione dei tensori.
Carico di lavoro target: LLM, VLM,..
Vulnerabilità: ecosistema limitato; rischio di concentrazione geografica (anche se questo potrebbe rivelarsi un vantaggio se riuscissero a conquistare una parte del mercato asiatico, il che li renderebbe un buon acquisto, ad esempio, per Intel, che mira ad acquisire maggiori quote di mercato).
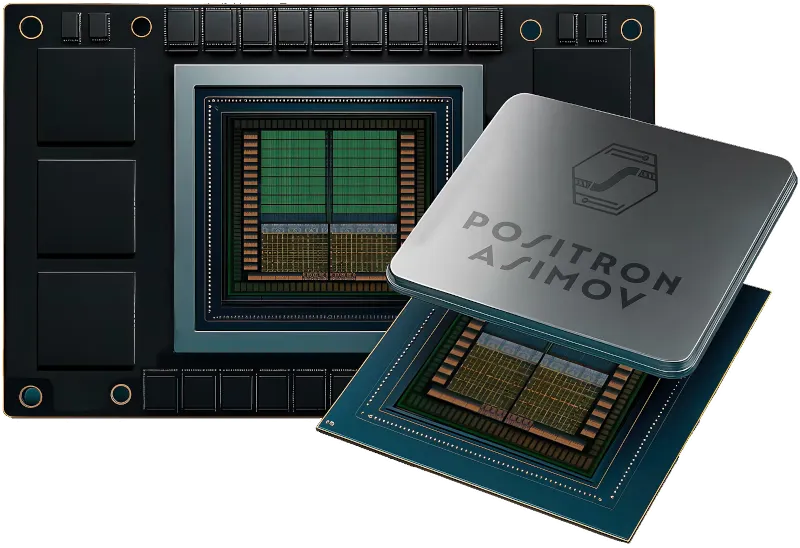
Architettura: Asimov ASIC - Non ci sono molte informazioni disponibili, ma il messaggio chiave di Positron è che la memoria è fondamentale: quindi, se riuscissero a integrare molta più memoria DDR5 standard nel loro ASIC, utilizzando l’impilamento di chiplet, potrebbero offrire una soluzione interessante rispetto al Blackwell di NVIDIA con una quantità di memoria inferiore.
Punto di forza principale: L’attenzione all’utilizzo della larghezza di banda della memoria elevata (MBU) piuttosto che alla larghezza di banda della memoria elevata standard (HBM). Ciò significa che possono aumentare il duty cycle o il tasso di utilizzo del bus di memoria e quindi fornire una potenza di memoria equivalente (o addirittura migliore) (larghezza di banda * duty cycle, come V*I = Watt per l’elettricità), potendo così superare la concorrenza che sarebbe ancora alle prese con memorie costose.
Carico di lavoro target: Sarà chiaro quando il primo ASIC sarà disponibile, ma si può presumere che punteranno ai LLM standard.
Vulnerabilità: Fase molto iniziale e necessità di trovare i partner di fonderia giusti; Molto probabilmente ci vorranno 2-4 anni prima che la disponibilità generale e le soluzioni commerciali siano disponibili - la memoria sarà ancora un collo di bottiglia a quel punto?
- Architettura: Metis e Europe AIPU; Si tratta di un’architettura di elaborazione in memoria con sistema di flusso dati di controllo basato su RiscV.
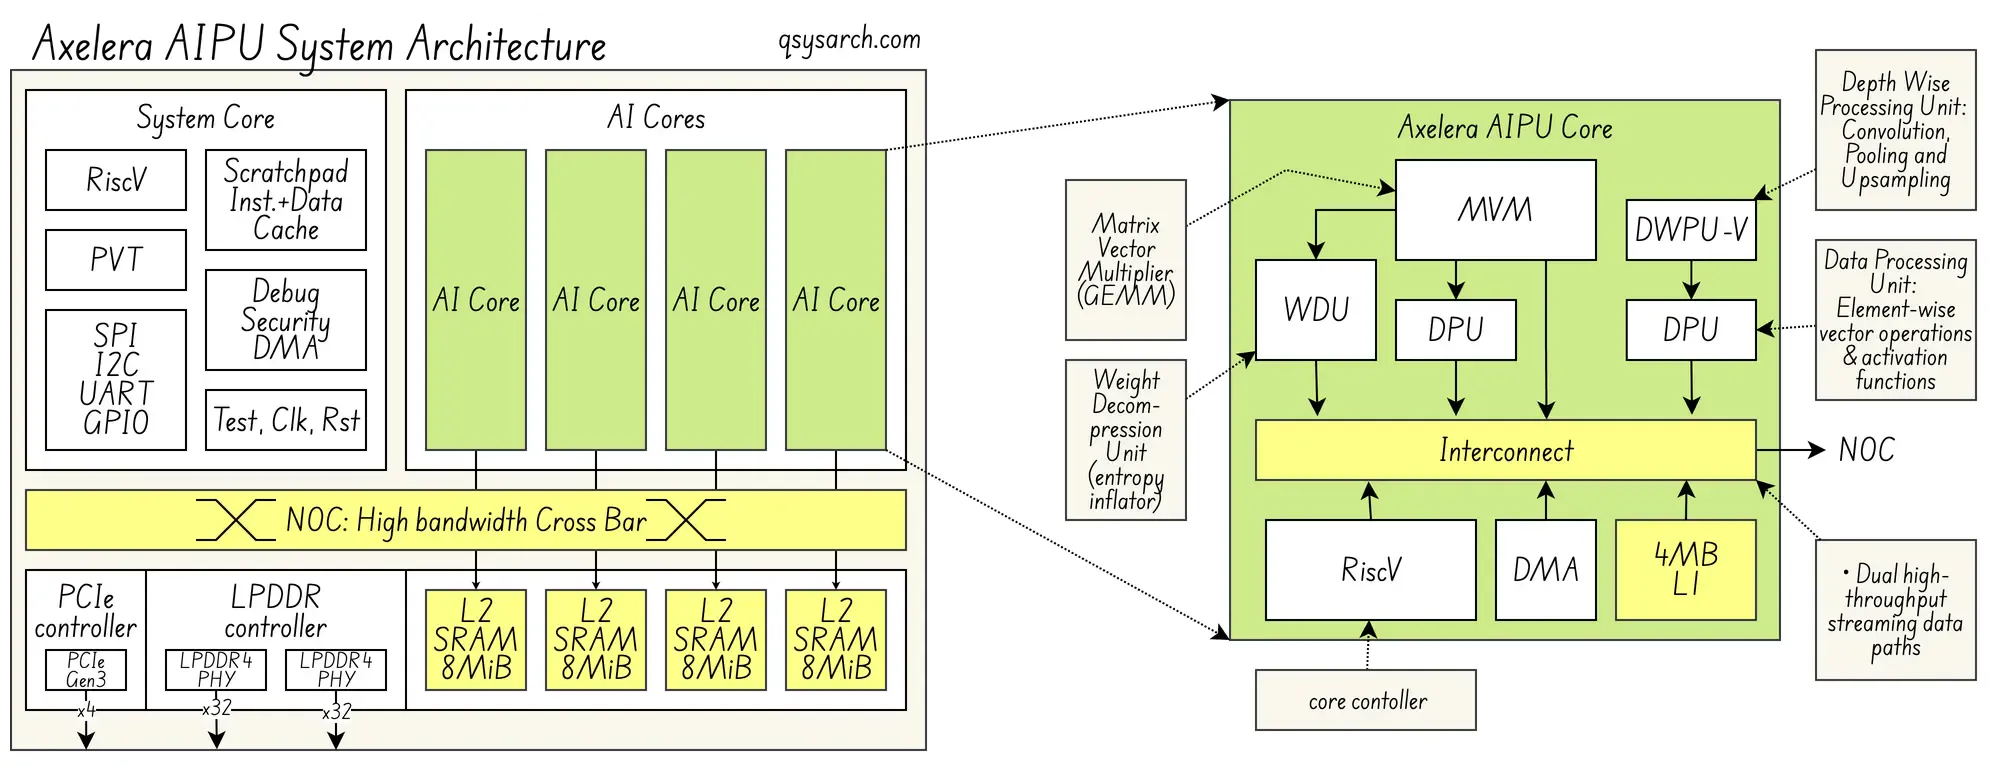
Punto di forza principale: grazie all’utilizzo del calcolo in memoria, è in grado di eseguire complesse moltiplicazioni matriciali direttamente all’interno delle celle di memoria digitale, eliminando così il trasferimento dei dati; ciò consente di raggiungere 15 TOPS/Watt (rispetto a circa 3 per NVIDIA Blackwell). Si tratta inoltre di una proprietà intellettuale interamente progettata in Europa, il che la rende una soluzione nazionale.
Carico di lavoro target: la prima generazione era focalizzata sulla visione artificiale/analisi video multi-stream; la generazione più recente (integrazione M2) può essere utilizzata anche per carichi di lavoro LLM e vLM edge.
Vulnerabilità: La vulnerabilità di Axelera non risiede nella sua ingegneria: la sua tecnologia è di livello mondiale. La sua vera vulnerabilità è rappresentata dalle difficoltà del mercato: riusciranno a entrare nel mercato senza diluire la loro attenzione?
I futuri sfidanti Link to heading
Mentre cercavo informazioni sulle aziende sopra menzionate, mi sono imbattuto in altri operatori del settore manifatturiero che potrebbero svolgere un ruolo significativo nei prossimi anni. E l’ultimo di questi, Unconventional AI, non è certo da meno, grazie al successo passato e alla visione del suo leader.

- Architettura: TSU (Unità di campionamento termodinamico) / SPU (Unità di elaborazione stocastica), utilizzate per operare sui “p-bit” (noti anche come bit probabilistici)
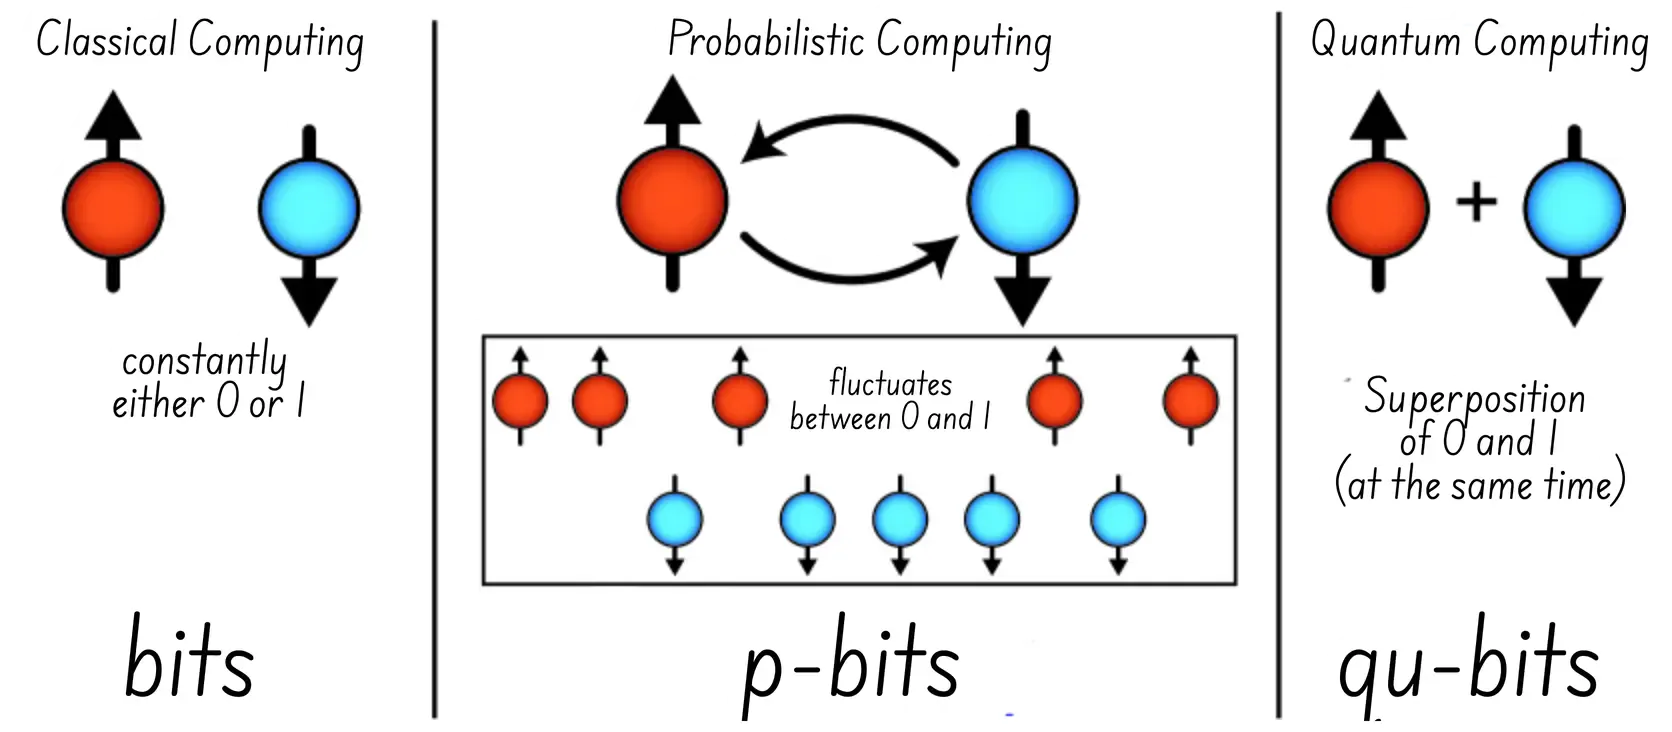
Perché è importante: affermano di essere 10.000 volte più efficienti delle GPU per specifici carichi di lavoro, come l’Aannealing. Questo potrebbe rappresentare una sfida significativa per i qubit.
Vulnerabilità: Essere in grado di utilizzare su scala richiede ancora parecchia ricerca
Architettura: SPU (rete neurale a impulsi) che utilizza memorie Mott (Mott-RAM).
Perché questo è importante: abbiamo bisogno di persone lungimiranti che prendano in considerazione memorie alternative, come la memoria resistiva (ReRAM) o, nel caso di Mottronix, la Mott RAM.
Vulnerabilità: Deve dimostrare di poter passare dalla fase di ricerca a quella di prodotto finito.
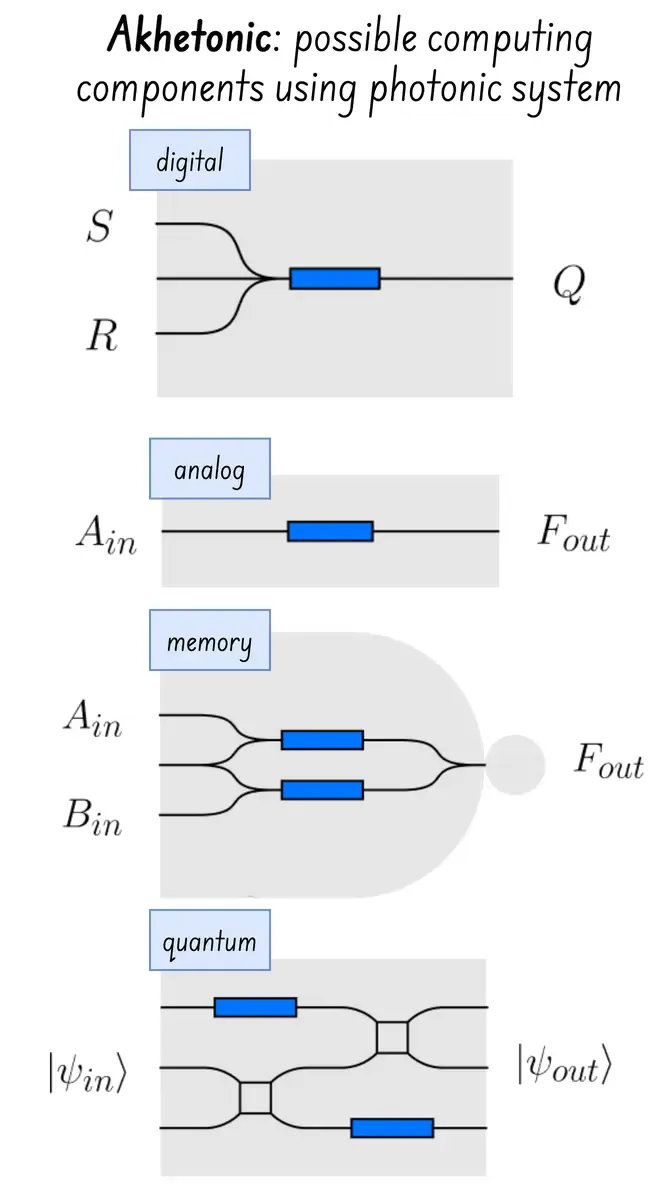
Architettura: RPU (Reasoning Processing Unit) che utilizza un processore digitale interamente ottico
Perché è importante: la resa dei circuiti integrati fotonici ha visto un enorme miglioramento nell’ultimo decennio - NVIDIA, ad esempio, è ora in grado di produrre commercialmente switch di rete fotonici al silicio - e applicare questa tecnologia ai carichi di lavoro di calcolo è un naturale passo successivo! (che consente anche il calcolo quantistico indirizzato otticamente!)
Vulnerabilità: Non è chiaro quale sia la differenza tra il calcolo quantistico OAQ e il calcolo di ragionamento RPU, ed entrambi i casi richiedono un’attenta calibrazione e messa a punto prima di poter essere scalati a soluzioni commerciali.
- Architettura: “JEF” come acceleratore AI fotonico, in grado di fornire riduzioni del consumo energetico da 10 a 30 volte - Le informazioni pubbliche su Arago sono molto limitate, ma sembra essere una soluzione ibrida di integrazione deterministica/classica + acceleratore fotonico, combinata con un SDK software full-stack e compatibile con PyTorch.
 Intelligenza artificiale non convenzionale
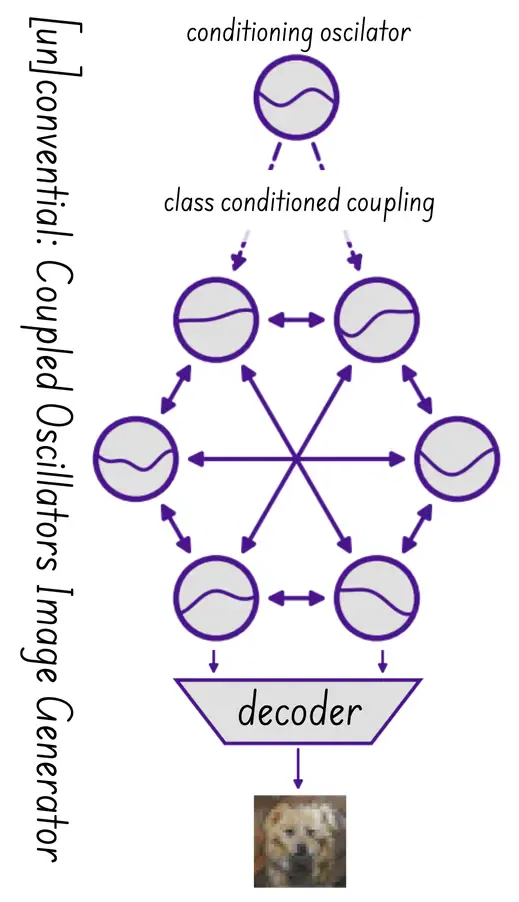
Architettura: [UN]CPU (Unità di elaborazione [non] convenzionale) che utilizza l’oscillatore Kuramoto
Perché questo è importante: Adoro quest’idea e, affinché si realizzi, l’esecuzione è fondamentale: avere il coraggio di pensare in modo diverso è solo metà della battaglia; chi cambia davvero il mondo si impegna quotidianamente per farlo. E per questo, hanno un leader con un’esperienza impressionante.
Vulnerabilità: sono ancora al giorno 0->1, quindi l’esecuzione è fondamentale.
Analisi retrospettiva del mercato a giugno 2026 Link to heading
Dove si trovano attualmente i veri fronti di battaglia che potrebbero cambiare il panorama del mercato?
L’ecosistema: NVIDIA contro AMD Link to heading
Il vantaggio strutturale di NVIDIA non risiede nella GPU, bensì nell’ecosistema CUDA creato negli ultimi 10 anni. Per vincere questa battaglia è necessario prevalere sul software, non solo sul silicio, ed è proprio qui che molte aziende innovative incentrate sull’hardware falliscono.
AMD è la minaccia più sottovalutata a breve termine per NVIDIA: non ha bisogno di battere CUDA, ha il suo strumento, e deve solo essere “sufficientemente buona” per gli acquirenti di servizi cloud sensibili al costo. ROCm 6.x sta colmando il divario più velocemente del previsto.
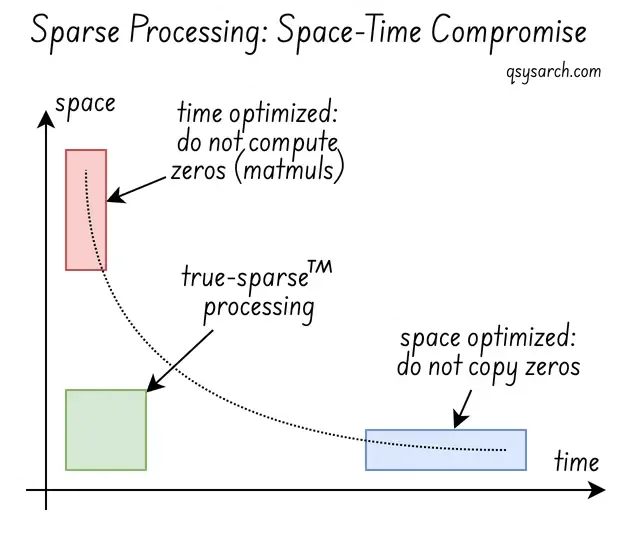
Gli innovatori: Il compromesso spazio-temporale
 Link to heading
- La maggior parte degli innovatori sta provando una variante del compromesso spazio-tempo; o mettendo più memoria localizzata ultraveloce; o consentendo un flusso di dati configurabile dinamicamente (pipeline); Al momento, il collo di bottiglia è nella RAM;
Forse i vincitori saranno coloro che riusciranno ad affrontare entrambi gli aspetti contemporaneamente, il che sarà ancora più rilevante per il calcolo di matrici sparse (con molti “zeri”), dove si vuole evitare sia il trasferimento di memoria degli zeri, sia il loro calcolo! Renegade potrebbe fare la differenza?
I Disruptor: Calcolo imperativo vs Calcolo dinamico Link to heading
I produttori di chip di nuova generazione guardano al problema del calcolo da un’altra prospettiva: forse la chiave sta nel modellare e alimentare un sistema dinamico piuttosto che moltiplicare imperativamente i numeri uno dopo l’altro?
Il confine potrebbe rappresentare una linea di demarcazione sensibile tra il calcolo quantistico e quello dinamico? Potrebbe risolvere sia la sfida della criogenia quantistica sia il problema della decoerenza dei qubit, introducendo un sistema intermedio che consenta il calcolo esponenziale senza incorrere nella decoerenza dei qubit?
Direzioni tecnologiche e di mercato (2026-2029) Link to heading
Il riepilogo che segue rappresenta una visione soggettiva degli orizzonti dal livello 1 al livello 3. Tre cambiamenti definiranno il prossimo ciclo. Sono elencati in ordine di impatto.
Memory Power™: La memoria, piuttosto che la capacità di calcolo, è il fattore abilitante della potenza quantitativa. Link to heading
I modelli lineari lineari (LLM) sono sempre più limitati dalla larghezza di banda della memoria piuttosto che dalla potenza di calcolo. Man mano che i modelli crescono e le finestre di contesto si estendono a oltre 1 milione di token, il costo e la latenza dello spostamento dei pesi da/verso la memoria HBM diventano predominanti. Il compromesso è tra la potenza di calcolo in prossimità della memoria con SRAM on-chip e una memoria di grandi dimensioni con larghezza di banda sufficiente: l’indicatore chiave di prestazione (KPI) critico potrebbe diventare la potenza della memoria, definita come larghezza di banda * duty cycle.
Anche i modelli Mixture-of-Experts che attivano solo una frazione dei parametri per token (utilizzando una matrice sparsa) rientrano in questa categoria: la maggior parte degli acceleratori non è ancora ottimizzata per i pattern di attivazione sparsi, ed è per questo che NVIDIA ha introdotto Tensor Core. Potrebbe non essere la soluzione definitiva, ma una “patch hardware” in attesa di qualcosa di più robusto e affidabile.
Coprocessori specializzati: Necessità di elaborare in modo efficiente parte della pipeline LLM Link to heading
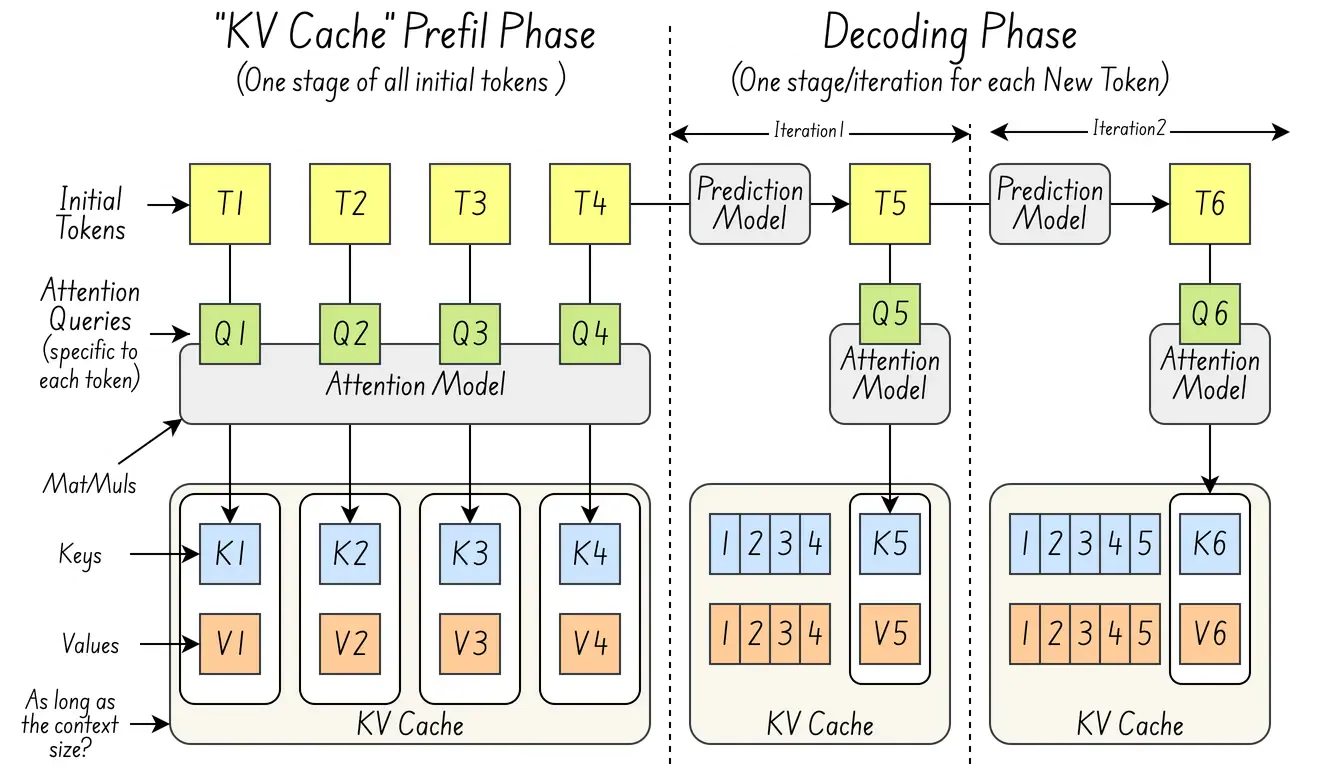
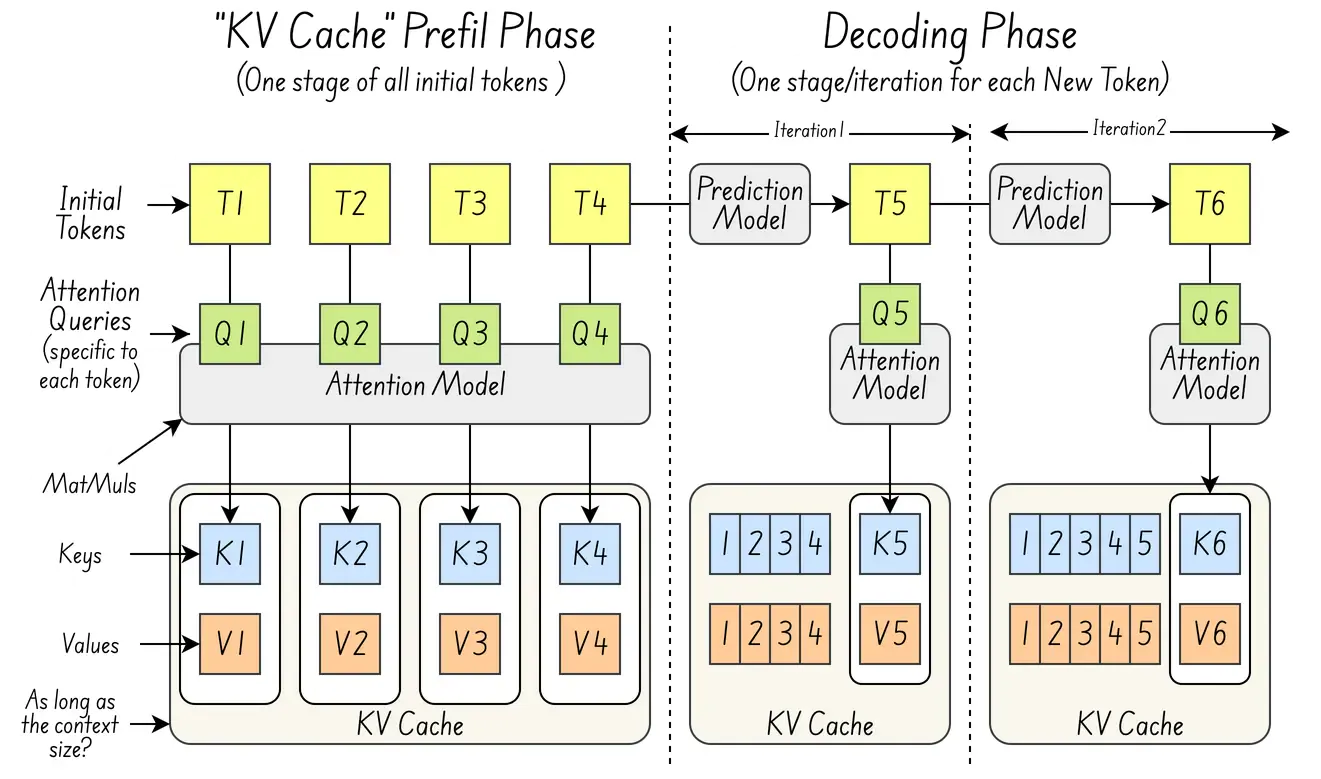 Ad esempio, ora è comune utilizzare la disaggregazione Prefill/Decode (PD) per separare le fasi di pre-riempimento (cache KV iniziale costruita da molti token) e decodifica (generazione di un token alla volta) di un LLM. Ciò apre la strada a coprocessori di inferenza appositamente progettati, poiché il pre-riempimento richiede una maggiore capacità di calcolo, mentre la decodifica richiede una maggiore potenza di memoria (dovendo caricare una nuova KVQ per ogni token).
Anche il core Tensor di NVIDIA per i modelli Mixture-of-Experts sparsi rientra in questa categoria.
Commoditizzazione dell’hardware: La pressione dell’indice di intelligenza spinge verso la mercificazione dell’hardware. Link to heading
Il prezzo dell’inferenza è calato di circa 10 volte in due anni. L’adozione dell’IA aziendale è frenata dal costo dell’inferenza, non dalla qualità del modello. Ciò implica che l’hardware di inferenza standard si posiziona al di sotto della fascia alta (NVIDIA H100/B200) per la distribuzione di modelli lineari lineari standard. È qui che i concorrenti hanno le maggiori possibilità di successo. Immaginate di poter eseguire GLM5.2 sul vostro hardware standard utilizzando il processore Positron Asimov!
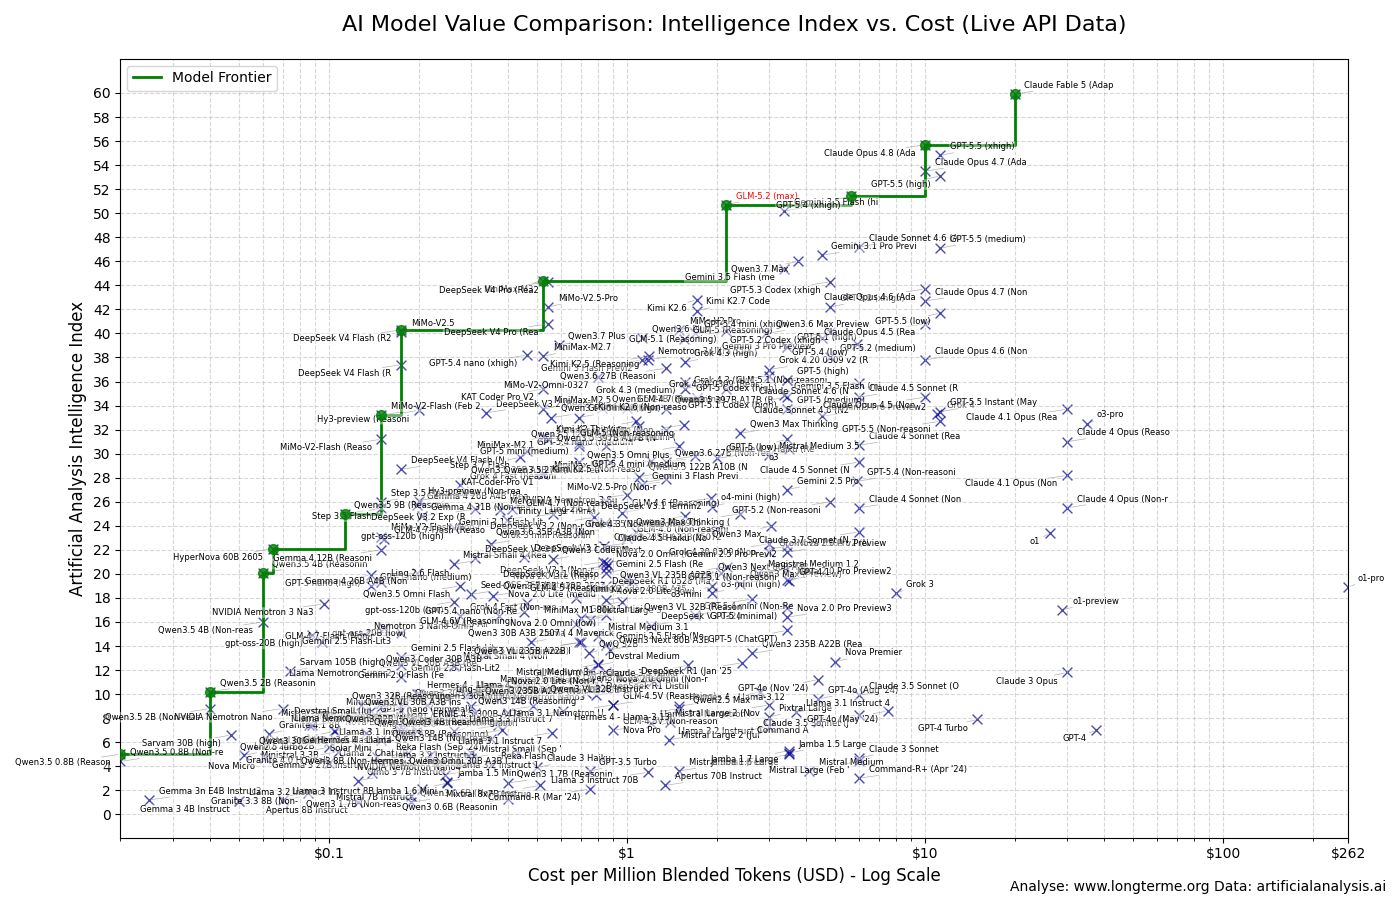 (fonte immagine: L’Observatoire du Long Terme - Z AI GLM5.2 è chiaramente un outsider in termini di intelligenza/costo, ma richiede quasi 200 GB di memoria)
Semplicità di implementazione: Ultimo ma non meno importante: facilità d’uso per HW to SW, UI & Tools Link to heading
Le aziende sottovalutano costantemente la complessità operativa. I fornitori che offrono soluzioni di “inferenza pronte all’uso” con runtime a configurazione zero (non solo chip) si aggiudicheranno una quota sproporzionata del mercato aziendale.
Questo problema sarà accentuato dalla necessità di inferenza on-premise a causa delle pressioni normative nell’UE e nell’area APAC, perché, sì, molte aziende non vogliono inferire le proprie conoscenze proprietarie su sistemi estranei.
Conclusioni Link to heading
Il mercato dell’inferenza nel periodo 2024-2026 assomiglia al mercato delle reti nel periodo 2000-2003. NVIDIA è come Cisco a quei tempi: dominante, sovradimensionata per molti casi d’uso e con prezzi elevati. La questione non è se sfidare NVIDIA nei suoi carichi di lavoro migliori, ma dove NVIDIA sta offrendo un servizio eccessivo al mercato e dove un’alternativa progettata appositamente può fornire l'80% delle prestazioni al 40% del costo.
Allo stesso tempo, NVIDIA sta investendo massicciamente nell’ecosistema e gli eccellenti contributi completamente open source come CudaQ e NVQLink, che NVIDIA offre gratuitamente alla community, renderanno più difficile per qualsiasi concorrente di NVIDIA conquistare queste community.
Ecco, questo era un breve e superficiale promemoria di domenica mattina. Dovrò approfondire i dettagli architettonici dei futuri sfidanti e, fortunatamente, potrò preparare un promemoria per almeno due di loro entro quest’estate. Nel frattempo, il prossimo promemoria tratterà l’argomento tanto atteso (che molti lettori mi hanno chiesto di affrontare): la correzione degli errori quantistici in poche parole!
References Link to heading
- Benchmarking the Cerebras Wafer Scale Engine-2 Architecture
- Cerebras Architecture Deep Dive
- Groq LPU design
- A Thorough Investigation of Groq https://api-docs.deepseek.com/news/news260424
- MegaTrain: Full Precision Training of 100B+ Parameter Large Language Models on a Single GPU
- Think Fast: A Tensor Streaming Processor (TSP) for Accelerating Deep Learning Workloads
- Evolution Strategies at the Hyperscale
- HiSparse: Turbocharging Sparse Attention with Hierarchical Memory
- AscendNPU-IR
- AscendCraft: Automatic Ascend NPU Kernel Generation via DSL-Guided Transcompilation
- Fast Switching Serial and Parallel Paradigms of SNN Inference on Multi-core Heterogeneous Neuromorphic Platform SpiNNaker2
- Neuromorphic hardware for sustainable AI data centres
- A Framework for Benchmarking Neuromorphic Computing Algorithms and Systems
- Fast Switching Serial and Parallel Paradigms of SNN Inference on Multi-core Heterogeneous Neuromorphic Platform SpiNNaker2
- Revolutionizing AI Workloads with Digital In-Memor y C omputing and RISC-V technology
- Computation as a Universal and Fundamental Concept
DrawIO diagrams used in this memo: