Raph Levien è famoso per la sua implementazione ultra-efficiente del motore di rendering dei glifi più veloce al mondo, utilizzando un’ingegnosa architettura SIMD basata su Rust. Il suo lavoro mi ha ispirato molto quando stavo progettando una GPU SIMD presso Bestechnics nel 2023. Successivamente, Raph Levien ha lavorato anche a una versione per GPU di questo motore di rendering dei glifi.
Così, quando mi sono imbattuto nel suo ultimo intervento su “Come Rust ha vinto: la ricerca di un software performante e affidabile”, ho deciso di dedicare un’ora del mio tempo a guardarlo e a cogliere tutti gli spunti utili.
Dichiarazione del problema Link to heading
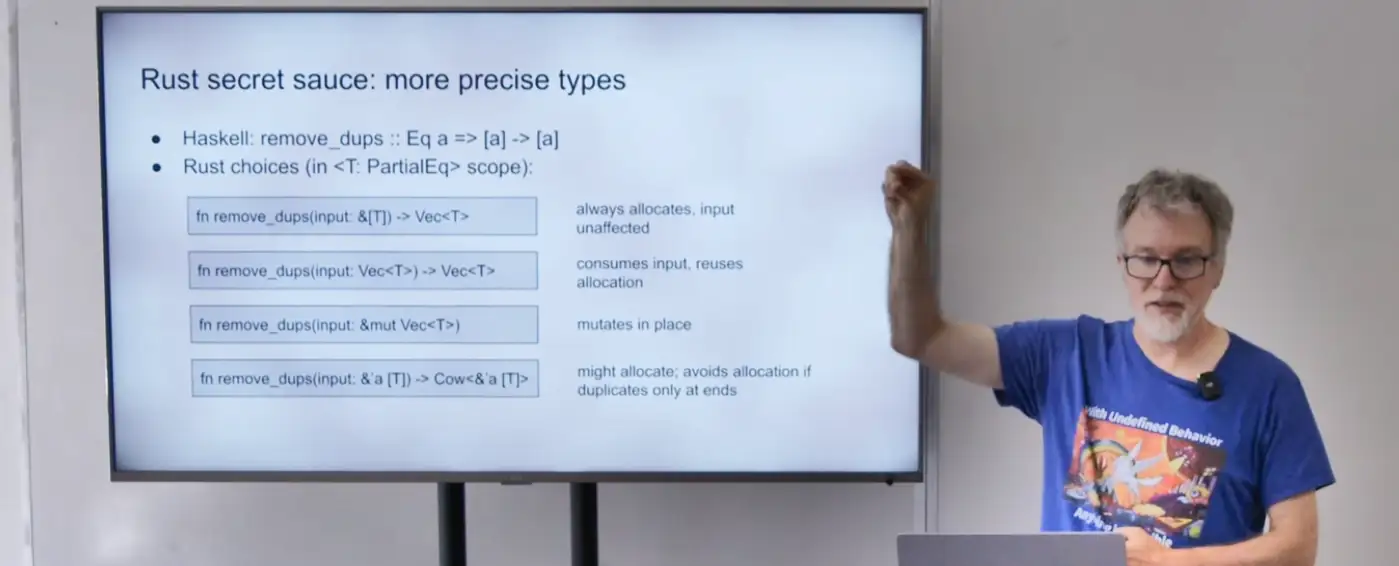
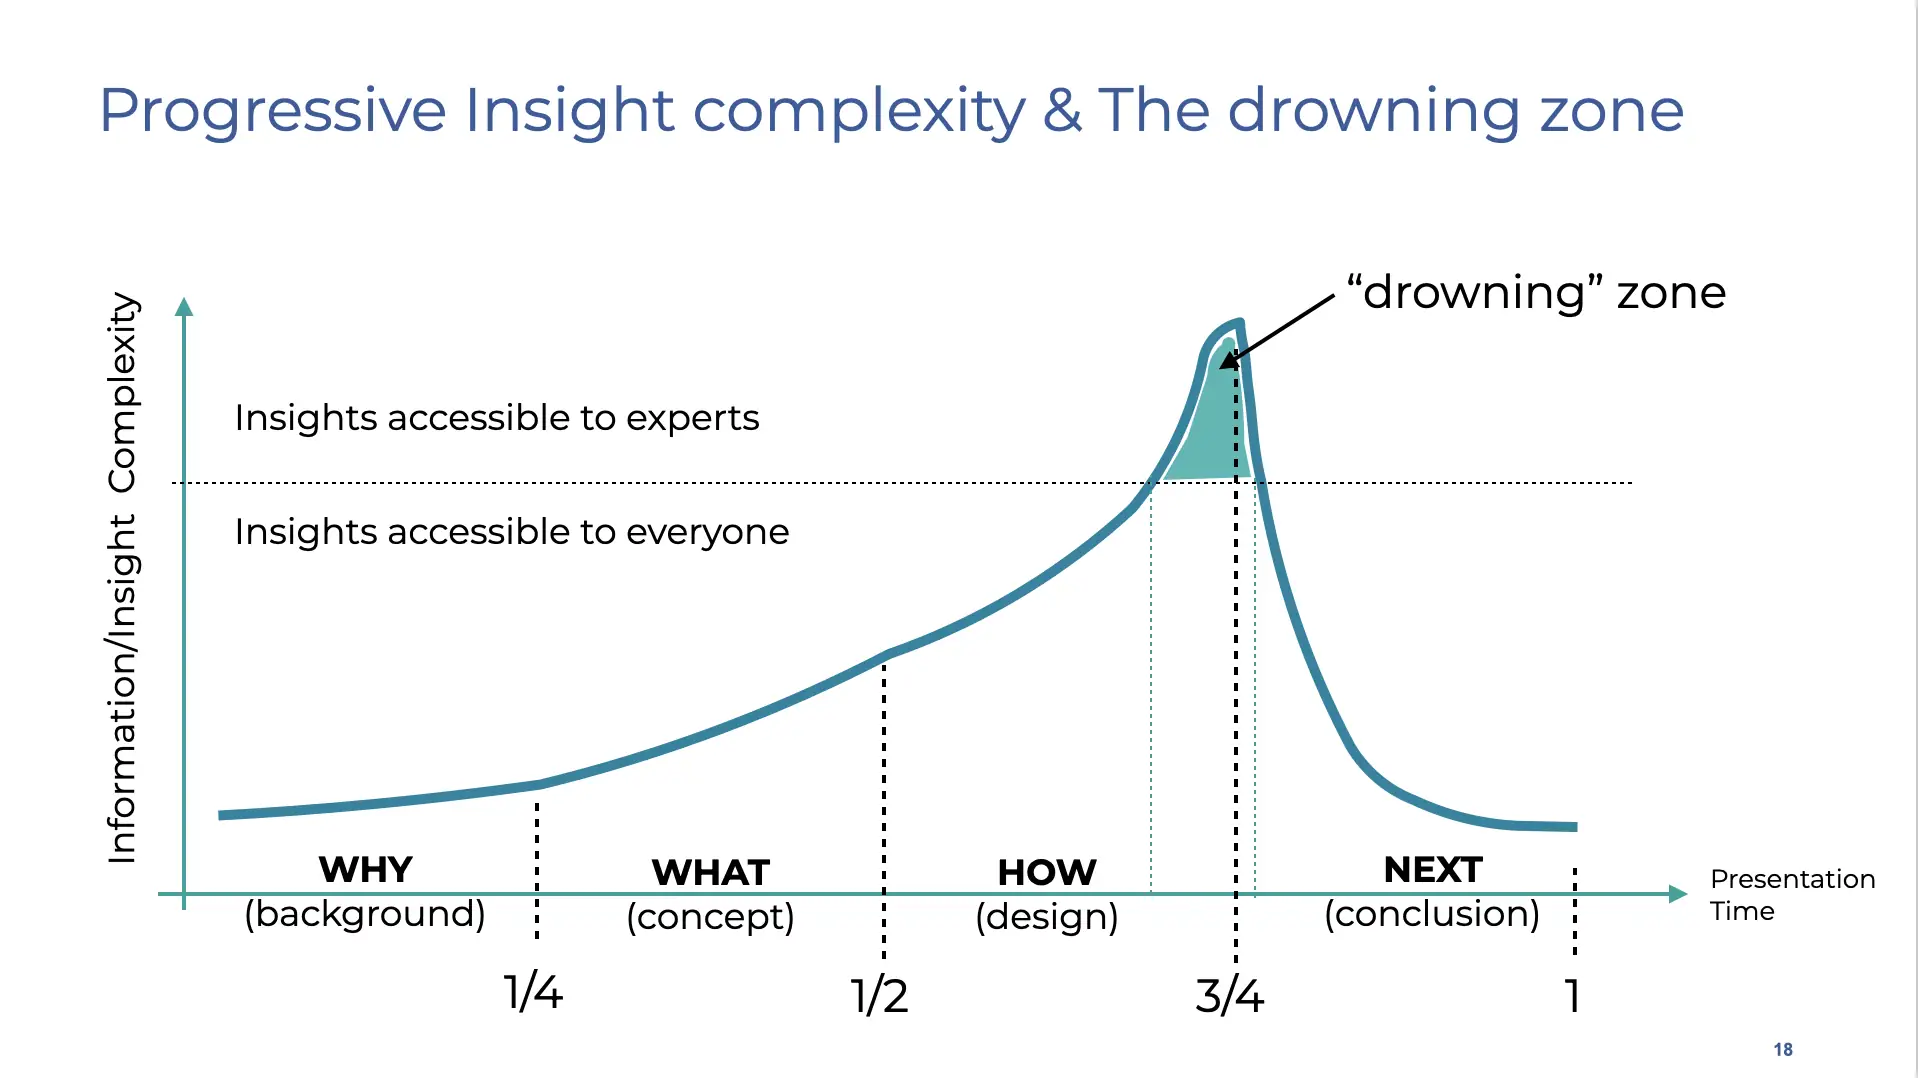
La parte più intensa (nota anche come zona di annegamento) inizia intorno al minuto 55:00, con una diapositiva intitolata La salsa segreta della ruggine: un tipo più preciso.
Al minuto 56:50, Raph dice: “È qui che entra in gioco il tipo affine; si vuole modellare (la clonabilità) come ’esiste un’istanza di questo’; e il tipo permette di specificare attentamente, nella firma della funzione, come verrà gestita tale proprietà; e salterò l’ultimo esempio, ma è divertente, vero…
Non pretendo assolutamente di essere un esperto di Rust e ammetto di avere una leggera preferenza per Go, quindi la domanda è: posso capire cosa significa realmente il tipo affine? E può essere spiegato in parole semplici senza dovermi immergere in un mare di nozioni?
Un’altra questione, sollevata nei commenti di YouTube: a quanto pare, il tipo di ritorno per l’ultima funzione dovrebbe essere Cow<'a, [T]> invece di Cow<&'a [T]>. Onestamente, mi sembra ancora più complicato degli algoritmi quantistici. Ma forse non deve esserlo per forza!
Analizziamo quindi più da vicino questi esempi di “ingrediente segreto più preciso”:
fn α( l: &[T] ) → Vec<T>: alloca sempre, input non influenzatofn β( l: Vec<T> ) → Vettore<T>: consuma l’input e riutilizza l’allocazione.fn δ( l: &mut Vec<T> ): nessuna allocazione, modifica semplicemente il vettore di inputfn ω( l: &'a [T]) → Cow<'a,[T]>: potrebbe allocare; evitare l’allocazione se i duplicati sono presenti solo alle estremità
Prima sfida: i farmaci generici Link to heading
La prima questione da verificare nel template generico T? Funziona davvero? Queste funzioni possono essere compilate in questo modo? Proviamo con la versione più semplice della funzione:
// fails with: error cannot find type T in this scope
fn α( l: &[T] ) -> Vec<T> { vec![] }
Questo ovviamente non funziona e fallisce con l’errore impossibile trovare il tipo T in questo ambito. Se hai familiarità con C++, ti aspetteresti che il tipo T debba essere dichiarato con il nome della funzione, quindi dichiarando α<T> invece di α.
// all right with the T declaration
fn α<T>( l: &[T] ) -> Vec<T> { vec![] }
In questo modo funziona bene! Ma quando si aggiunge un’implementazione di base (che converte solo in vec, senza rimuovere i duplicati), il compilatore fallisce con il vincolo di tratto T: Clone non è soddisfatto.
// fails with: the trait bound `T: Clone` is not satisfied
fn α<T>( l: &[T] ) -> Vec<T> { l.to_vec() }
Fortunatamente, Rust ha un’ottima documentazione sui tratti generici e traits, e dopo una lettura di 10 minuti, diventa ovvio che dobbiamo cambiare α<T> ad α<T: Clone> come mezzo per esprimere il limite di tratto di tipo T.
// all right with the trait bound
fn α<T: Clone>( l: &[T] ) -> Vec<T> { l.to_vec() }
Il passo successivo è implementare una soluzione per rimuovere i duplicati. Per questo, un approccio è usare un HashSet. Innanzitutto, l’array viene convertito in un iteratore (let iterator: std::slice::Iter<T> = l.iter();), e quindi costruiamo un hash set da questo iteratore (HashSet::from_iter(iterator)), e infine convertiamo l’hashset in un vettore set.into_iter().collect().
//Fails with: the trait bound `T: Eq` is not satisfied
use std::collections::HashSet;
fn α<T: Clone>( l: &[T] )  -> Vec<T> {
    let array_iterator: std::slice::Iter<T> = l.iter();
    let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
    hash_set.into_iter().collect()
}
Senza alcuna sorpresa, questo fallisce! Ed è normale, perché se avessi passato 10 minuti a leggere la documentazione di Rust trait, sapresti che HashSet probabilmente richiede qualcosa che possa “confrontare” gli elementi di tipo T. Questo è ciò che fa il trait Eq - quindi, aggiungiamolo semplicemente al vincolo del trait (da α<T: Clone> ad `α<T: Clone + Eq> );
//Fails with: the trait bound `T: Hash` is not satisfied
use std::collections::HashSet;
fn α<T: Clone + Eq>( l: &[T] )  -> Vec<T> {
    let array_iterator: std::slice::Iter<T> = l.iter();
    let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
    hash_set.into_iter().collect()
}
Fallisce ancora, e il motivo è che abbiamo dimenticato di menzionare che il tipo T deve essere convertibile in un valore hash. Questo è ciò che fa il tratto Hash. Quindi, cambiamo da α<T: Clone + Eq> ad α<T: Clone + Eq + Hash>
//Fails with: a value of type `Vec<T>` cannot be built from an iterator over elements of type `&T`
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
    let array_iterator: std::slice::Iter<T> = l.iter();
    let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
    hash_set.into_iter().collect()
}
È qui che entra in gioco la parte interessante della clonabilità: l’hash set è una struttura che contiene puntatori agli elementi che erano inizialmente nella lista e che sono stati passati per valore (per essere precisi, l’array è stato passato per puntatore e l’array conteneva elementi referenziati per valore). Quindi, dobbiamo dire all’hash set di creare una copia di quegli elementi, cosa che può essere fatta aggiungendo cloned() prima dell’ultimo collect (collect viene utilizzato per trasformare l’iteratore in una collezione di vettori).
// all right!
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
    let array_iterator: std::slice::Iter<T> = l.iter();
    let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
    hash_set.into_iter().cloned().collect()
}
Ed ecco, siamo pronti con il primo esempio di funzione:
fn main() {
   println!("{:?}", α(&["A","A","B","D"]));
   println!("{:?}", α(&[1,1,2,4]));
}
Onestamente, questo è allo stesso tempo complesso e non complesso. Complesso perché il compilatore impone regole rigide, che devono essere dichiarate esplicitamente anziché derivate implicitamente, rendendo la curva di apprendimento ripida. Non complesso perché, una volta che si sono dedicati i “10 minuti” alla lettura della documentazione, beh, dovrebbe essere più facile. Forse il problema non è che ci vogliano 10 minuti per leggere il documento, ma piuttosto che ci vogliano 10 ore per comprenderne il contenuto. Questa è una sensazione di déjà vu…
Seconda sfida: tipo affine Link to heading
Ho ancora una domanda sulla clonabilità. Potremmo restituire un vettore che contiene solo riferimenti agli elementi passati nell’array? A prima vista, basterebbe cambiare Vec<T> a Vec<&T> … e gestire correttamente i vincoli di tipo affine? Proviamoci:
// All right - works fine
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<&T> {
    let array_iterator: std::slice::Iter<T> = l.iter();
    let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
    hash_set.into_iter().collect()
}
Bene, funziona! E nessuna lamentela sulla durata? Voglio dire, non siamo forse nel caso in cui stiamo prendendo in prestito gli elementi, quindi la durata dovrebbe essere controllata? Il problema è che la nostra funzione main è troppo semplice? Allora, proviamo qualcosa di più complesso:
// fails with expected named lifetime parameter
fn limited_lifetime() -> vec<&str> {
    let l = ["A","A","B","D"];
    α(&l)
}

fn main() {
    let v = limited_lifetime();
    println!("{:?}",v);
}
Questa volta fallisce: il compilatore si lamenta della mancanza di un parametro di durata, quindi dedichiamo quei 10 minuti extra alla lettura della documentazione di Rust sulla validazione dei riferimenti con i parametri di durata. A prima vista, dobbiamo solo aggiungere ‘a ?
//  fais with: mismatched types; expected `&[str]`, found `&[&str; 4]`
fn limited_lifetime<'a>() -> Vec<&'a str> { ... }
Ma no, non funziona. Proviamo a convertire la “str immutabile” in una “String” dinamica:
// fails with: cannot return value referencing local variable `l`
fn limited_lifetime<'a>() -> Vec<&'a String> {
    let l = ["A".into(),"A".into(),"B".into(),"D".into()];
    α(&l)
}
Ok, questo è proprio l’errore che ci aspettavamo: il borrow checker funziona correttamente. Ma come possiamo comunicare al compilatore che vogliamo che la proprietà di queste variabili allocate localmente venga trasferita? Per fare ciò, dobbiamo informare il compilatore che vogliamo che l’array l venga allocato nell’heap. E per questo, dobbiamo usare un vec al posto dell’array.
// this works
fn β<T: Clone + Eq + std::hash::Hash>( l: Vec<T> )  -> Vec<T> {
    let hash_set: HashSet<_> = l.into_iter().collect();
    hash_set.into_iter().collect()
}

fn limited_lifetime<'a>() -> Vec<&'a str> {
    let l2 = vec!["A","B","B","D"];
    β(l2)
}

fn main() {
    println!("{:?}",limited_lifetime());
}
Questa versione funziona effettivamente perché la nuova funzione β prende un vettore di elementi e restituisce lo stesso elemento anziché un puntatore ad esso. Quindi, gli elementi vengono clonati. Cosa succederebbe se, invece, volessimo che la funzione β restituisse un puntatore agli elementi di input?
Terza sfida: clonare su scrittura Link to heading
Ricordate la “mucca” nell’ultima funzione omega?
fn ω( l: &’a [T]) → Cow<&’a [T]>Cow è in realtà un’enumerazione. Può contenere un riferimento immutabile (preso in prestito) o un clone mutabile dello stesso. Ad esempio:
use std::borrow::Cow;
fn trim_input(input: &str) -> Cow<str> {
    if input.ends_with(' ') {
        Cow::Owned(input.trim_end().to_string())
    }
    else  Cow::Borrowed(input)
}
Quindi, dobbiamo scrivere Cow<'a [T]> o Cow<&'a [T]>? Beh, a prima vista, dato che l’input è un puntatore & con una durata 'a a un oggetto di tipo [T], anche l’output è un puntatore a un oggetto dello stesso tipo. La differenza è che Cow<> sta anche per puntatore. Quindi, sì, significa che la risposta corretta dovrebbe essere Cow<'a, [T]>.
fn ω<'a, T>( l: &'a [T]) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }La parte interessante è che, in Rust, gli array hanno una lunghezza fissa in fase di compilazione. Quindi, come potremmo, in fase di esecuzione, allocare un nuovo array con una dimensione dinamica? Beh, a quanto pare, secondo questo commento su Stack Overflow non è possibile. Forse Ralf intendeva usare un vec al posto di vec?
fn ωx<'a, T: Clone + Eq + std::hash::Hash>( l: &'a Vec<T>) -> Cow<'a, Vec<T>> {
    let hash_set: HashSet<_> = l.into_iter().collect();
    if hash_set.len()==l.len() {
        return Cow::Borrowed(l);
    }
    let own_copy = hash_set.into_iter().cloned().collect();
    return Cow::Owned(own_copy);
}
Digression Link to heading
Onestamente, devo ammettere a me stesso di essermi perso nella sintassi “fn ω<‘a, T>( l: &‘a [T]) -> Cow<‘a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }”, che dovrebbe semplicemente significare “un clone dello stesso”.
Se consideriamo che &'a T può essere riscritto come Ptr<'a,T>, allora possiamo anche riscrivere la funzione come:
fn ω<'a, T>( l: Ptr<'a, [T]>) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }Se omettiamo il fatto che T è un array, il codice sopra può essere riscritto come
fn ω<'a, T: ToOwned>( l: Ptr<'a, T>) -> Cow<'a, T> { Cow::Borrowed(l) }E se riscrivessimo il tipo come un’espressione basata su macro anziché come una sintassi?
fn ω<'a, T>( l: Ptr<'a, T> ) -> !Cow(l) { Cow::Borrowed(l) }Consentendo la riscrittura, la macro !Cow(l) può rendere implicito che il tipo T debba essere associato al tratto ToOwned. Pensando in questo modo, potremmo prevedere che 'a e T siano tipi generici che non necessitano di essere specificati esplicitamente quando si utilizza il tratto Ptr.
fn ω( l: Ptr ) -> !Cow(l) { Cow::Borrowed(l) }Ciò che crea confusione è che specifichiamo sia il tipo in fase di compilazione che l’implementazione in fase di esecuzione senza alcuna distinzione. Ma forse è proprio questo il senso di Rust?
Conclusion Link to heading
Credo che il “segreto del successo” di Ralf meriti un’ora di spiegazione e una presentazione a parte, non solo 3 minuti in un intervento di un’ora. Sarebbe anche utile analizzarlo in modo critico: forse non tutto è così piacevole? Forse c’è un eccesso di complessità che sta allontanando molti sviluppatori? E forse è proprio questo che si intende con “divertimento”? In ogni caso, cercherò di preparare qualche slide per una presentazione di un’ora nelle prossime settimane.
Tornando alla sfida del calcolo quantistico, la domanda è: abbiamo bisogno di un livello di complessità simile per far funzionare i sistemi di calcolo quantistico? Forse questa è la sfida odierna? Sebbene apparentemente complessi, gli algoritmi quantistici sono piuttosto semplici rispetto a questa barbara sintassi in Rust. Forse dobbiamo pensare un passo avanti per risolvere la sfida dell’“utilità” del calcolo quantistico? E che, senza questa complessità aggiuntiva, saremo comunque in grado di eseguire solo calcoli di base?
Partendo dal presupposto che tutto ruoti attorno alla semantica degli oggetti che vogliamo manipolare, forse dobbiamo renderci conto che esiste un livello di astrazione logica al di sopra dei qubit, che non è ancora evidente perché l’industria sta ancora faticando a far sì che i qubit si comportino come previsto.