L’utilisation de l’IA, et plus précisément des réseaux de neurones (RN), est non seulement une évidence, mais aussi une composante quasi indispensable de tout système en 2025. Sans surprise, de nombreux articles de recherche ont été publiés sur ce sujet. Cependant, les recherches les plus récentes ont repoussé les limites en permettant l’intégration très performante des réseaux de neurones au sein du système de contrôle quantique.
Je base cet article sur les travaux du Singapore Centre for Quantum Technologies CQT/NUS, et plus précisément sur les recherches d’Arthur Strauss, avec qui j’ai eu le grand honneur de discuter et d’échanger des idées lors du dernier événement SQA.
L’apprentissage par renforcement à la rescousse
Link to heading
Leur idée est fascinante : utiliser l’apprentissage par renforcement pour optimiser le contrôle des qubits (ou portes quantiques) grâce à un système de récompenses visant à maximiser l’efficacité de ce contrôle. En quoi est-ce important ? Comme expliqué dans l’article précédent (link), les qubits sont des « entités » très sensibles qui requièrent une attention particulière. C’est là que le réseau de neurones intervient, en permettant de quantifier la qualité de cette attention, parfois appelée fidélité.
Comment cela fonctionne-t-il ? L’apprentissage par renforcement est basé sur un cycle d’observations/actions appris via un système de récompense itératif Environnement -> Agent (« a » sur le diagramme ci-dessous), généralement exécuté avec un GPU, puis, une fois appris, exécuté sur un matmul étroitement couplé (ou non !) sur le système de contrôle quantique (« b » sur le diagramme ci-dessous).
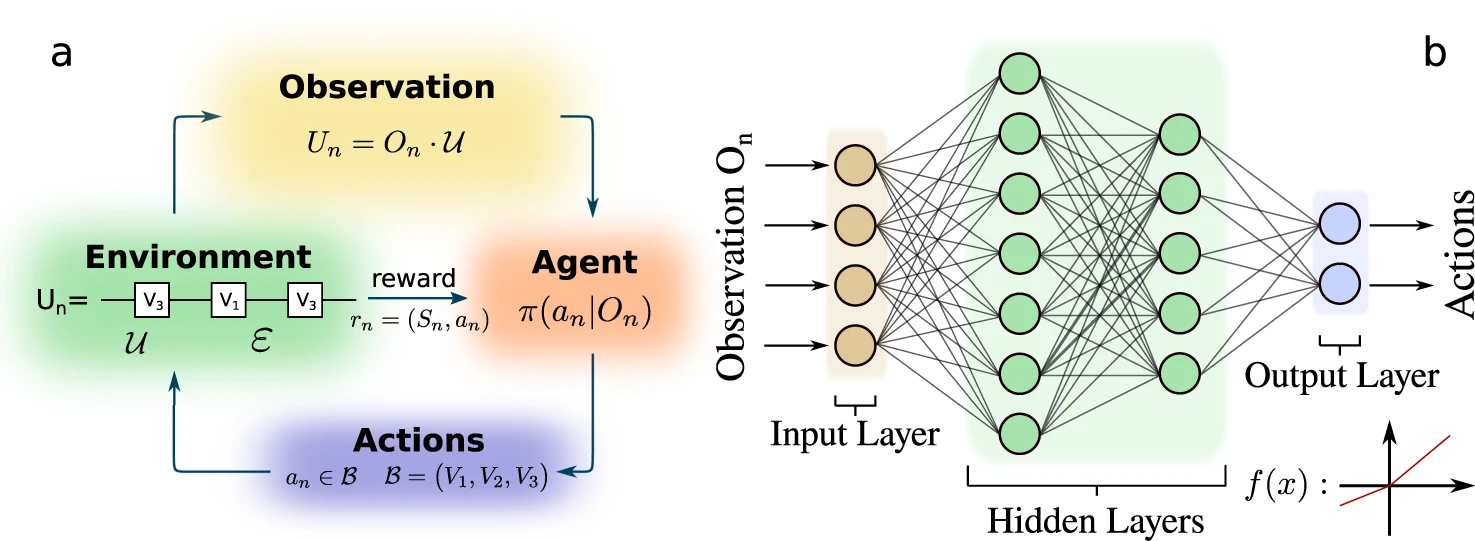 Crédits : Nature
Notez que puisque l’observation (également appelée lecture du qubit) détruit l’état quantique, le cycle d’apprentissage réinitialise d’abord l’état du qubit, effectue une porte de contrôle, lit l’état du qubit et transmet l’information à l’agent.
Examinons en détail les 4 composantes de l’apprentissage par renforcement :
L’environnement est le contrôleur quantique et le qubit lui-même.
Les actions consistent à ajuster les différents « boutons » ou paramètres d’impulsion du moteur générateur RF.
L’observation correspond aux caractéristiques du qubit après manipulation par l’environnement.
L’agent est celui qui apprend la politique qui réagit aux caractéristiques observées du qubit et adapte les paramètres d’impulsion en conséquence.
Systèmes d’apprentissage par renforcement : Méthodes d’apprentissage
Link to heading
Les méthodes d’apprentissage par renforcement peuvent généralement être classées en deux grandes catégories : celles basées sur les valeurs et celles basées sur le gradient de politique.
Les méthodes basées sur la valeur se concentrent sur l’estimation d’une fonction de valeur et la déduction de politiques à partir de celle-ci. Les méthodes basées sur le gradient de politique optimisent directement la politique en maximisant la récompense cumulée attendue par la méthode du gradient ascendant.
L’avantage de l’itération de politique est qu’elle converge beaucoup plus rapidement que les approches basées sur les valeurs, bien qu’elle soit plus coûteuse en calcul. C’est là qu’interviennent les algorithmes de gradient de politique, qui permettent de réduire la complexité de calcul. Exemple d’algorithme de gradient de politique, notamment l’algorithme reinforce :
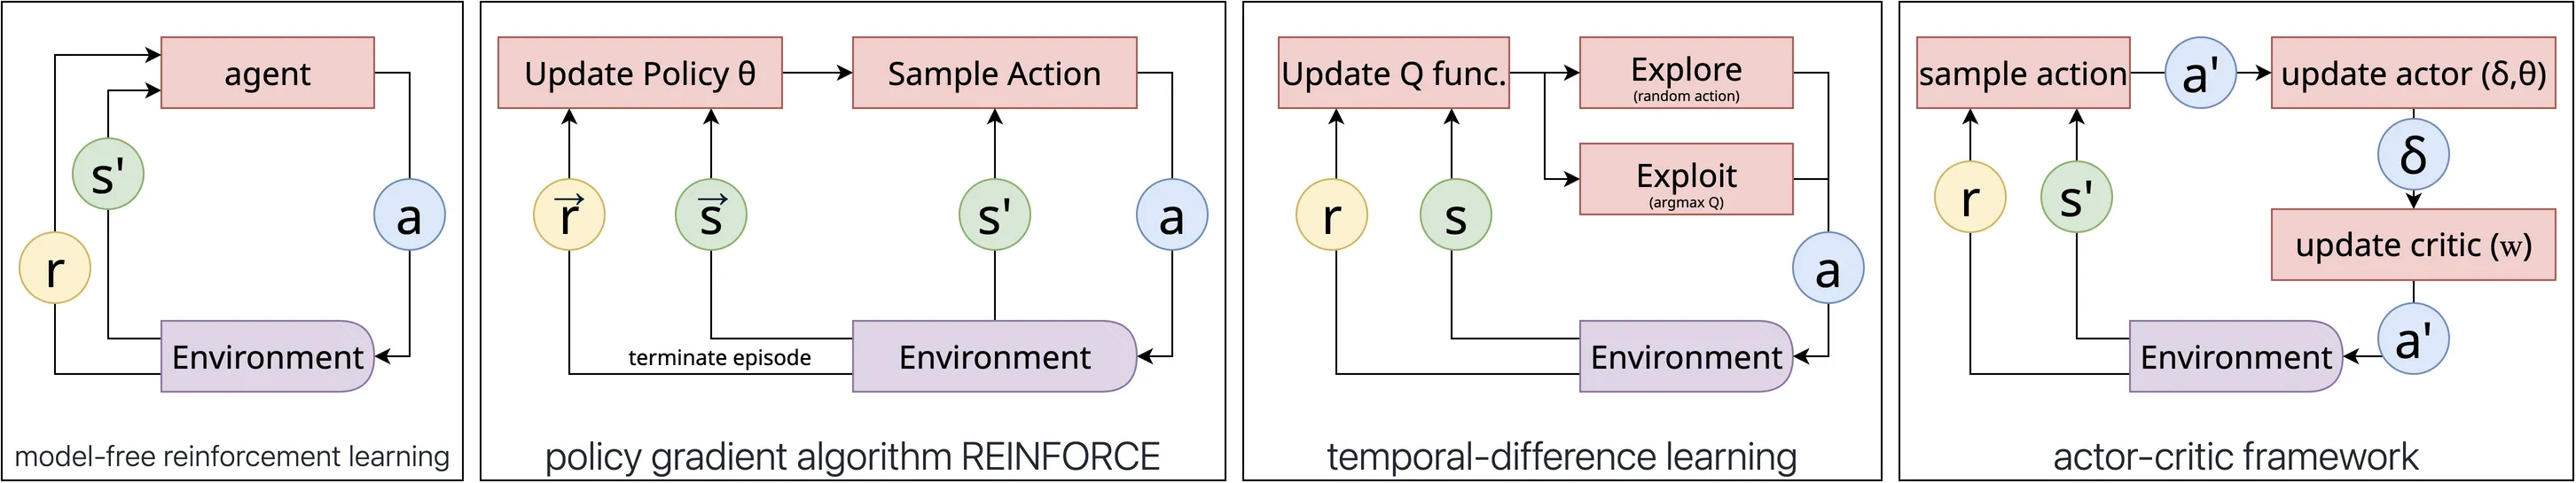
Dans les diagrammes ci-dessus, s représente l’état, a l’action et r la récompense.
Systèmes d’apprentissage par renforcement : Itération vs Épisodes
Link to heading
En apprentissage par renforcement, un épisode et une itération sont des concepts différents :
Épisode :
Un épisode est une séquence complète d’interactions entre l’agent et l’environnement, commençant à partir d’un état initial et se terminant à un état terminal (ou après un horizon temporel maximal).
Exemple : Dans une partie d’échecs, un épisode correspond à une partie complète — depuis l’échiquier de départ jusqu’à l’échec et mat, la nulle ou l’abandon.
Itération :
Dans certains articles/codes, une itération peut signifier une étape temporelle de l’interaction agent-environnement (état → action → récompense → état suivant).
Dans le contexte de l’optimisation, une itération peut correspondre à une étape de mise à jour de l’algorithme d’apprentissage (par exemple, une étape de descente de gradient, qui peut être basée sur plusieurs épisodes ou transitions).
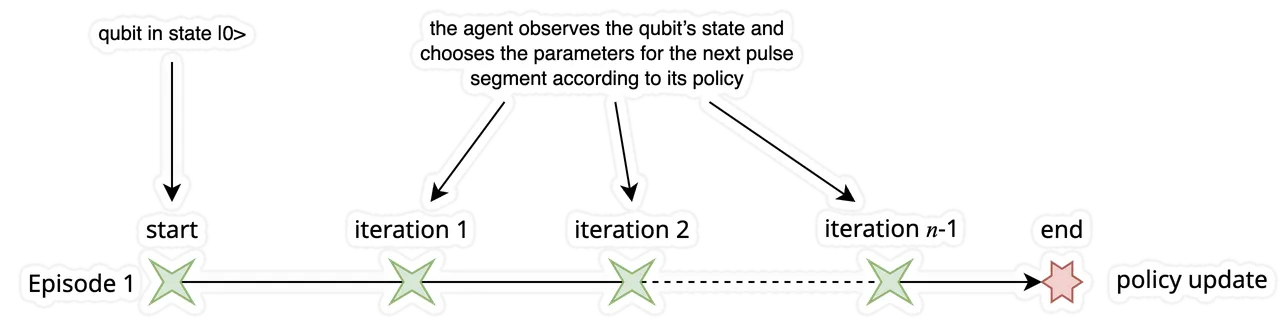
Mettons en œuvre ces idées une par une, en commençant par l’échantillonnage des épisodes.
Les épisodes commencent avec le qubit dans l’état |O>.
Démarrer la boucle observer-agir
l’agent observe l’état du qubit
et choisit les paramètres du prochain segment d’impulsion selon sa politique.
Explorez en testant l’action :
Au lieu de choisir de manière déterministe la « meilleure » action (par exemple celle ayant la plus forte probabilité), l’échantillonnage signifie que l’agent tirera au hasard une action de cette distribution, en fonction des probabilités.
Cet échantillonnage est essentiel dans la méthode de renforcement.
Calculer la fonction score :
mesurer dans quelle mesure l’action choisie devient plus (ou moins) probable si les paramètres du réseau sont modifiés dans une direction particulière.
En d’autres termes, évaluez ∇(𝜃) pour l’action échantillonnée.
Calculer sa récompense lorsque la fin du programme d’impulsions est atteinte.
Le score et la récompense, ensemble, pilotent la mise à jour de l’apprentissage dans l’apprentissage par renforcement du gradient de politique :
Exploration pratique et approfondie : Flax et Jax
Link to heading
à terminer
Désolé, ce blog se voulait léger, mais il s’avère bien plus complexe. Je dois peut-être encore continuer à simplifier l’équation. Quoi qu’il en soit, qu’avons-nous appris ? Le processus d’optimisation pour quantifier de manière optimale la qualité des qubits est multidimensionnel et, sans surprise, les réseaux de neurones excellent dans ce domaine. Dans ce blog, nous nous sommes concentrés sur l’optimisation de la fidélité d’un seul qubit. Mais imaginez deux qubits ou plus : il faut alors prendre en compte l’impact de la diaphonie. De nombreuses questions et défis se posent, notamment concernant la méthode d’apprentissage : globale au niveau de plusieurs qubits, locale au niveau des paires de qubits, voire hiérarchique au niveau des qubits logiques. Autant de questions que j’aborderai dans le prochain article consacré à la correction d’erreurs quantiques.
Lectures complémentaires et liens :