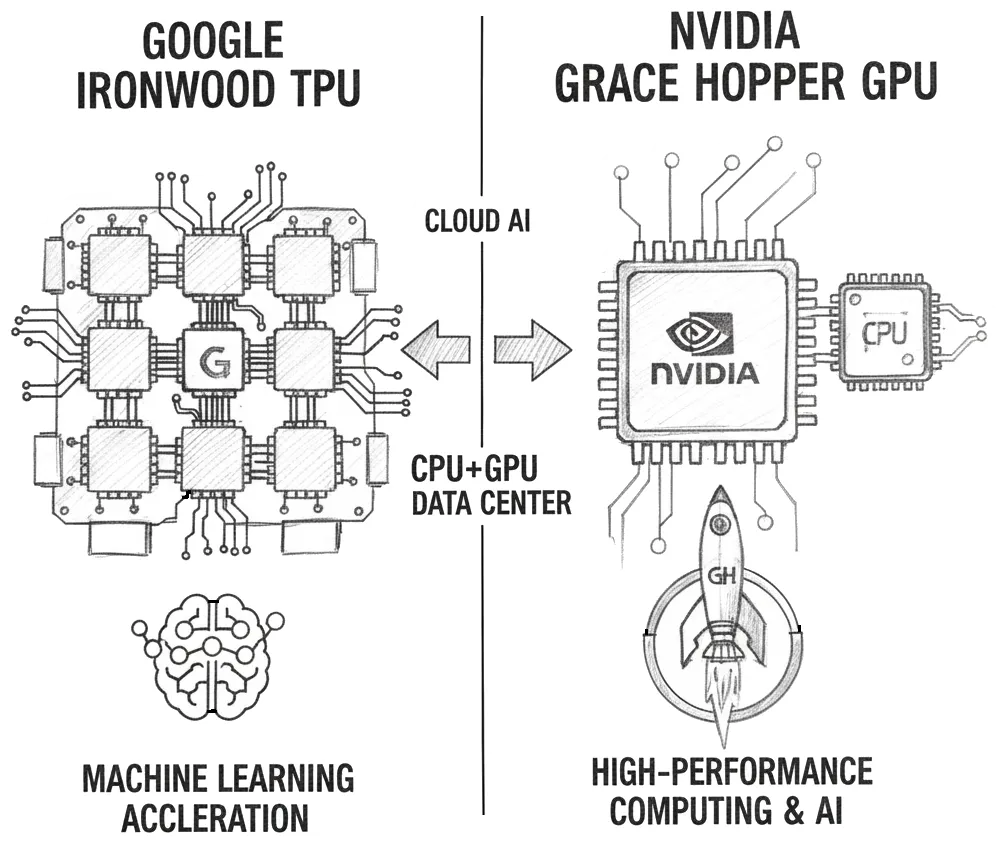
Dans un monde où l’IA est très énergivore, l’unité de traitement tensoriel (TPU) change la donne. Il s’agit d’une puce conçue sur mesure par Google spécifiquement pour les tâches d’apprentissage automatique.
Cette note de service rapide vise à fournir une vue d’ensemble de l’architecture des TPU et de leur évolution depuis leur création en 2016.
Je tenterai également de répondre à cette question essentielle : pourquoi avons-nous besoin de TPU alors que nous disposons déjà de GPU ? Quels avantages offrent-elles par rapport aux GPU ? Comment se comparent-elles aux circuits intégrés neuromorphiques ? Existe-t-il une architecture alternative aux TPU et aux GPU ?
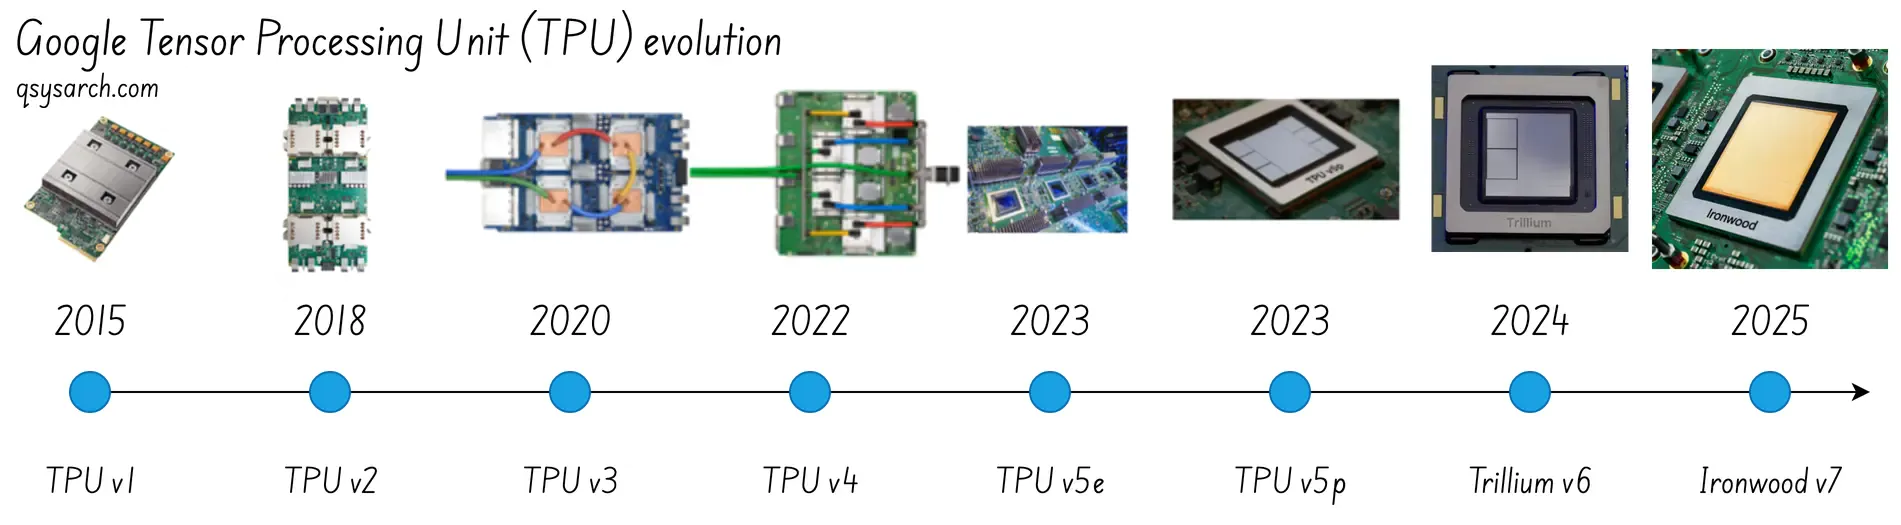 (Source : Google Cloud)
Pourquoi le TPU existe-t-il — et quels problèmes résout-il ?
Link to heading
Les TPU partagent le même objectif que les GPU : surmonter la limitation introduite par le ralentissement de la loi de Moore, en permettant un parallélisme massif : contrairement aux CPU traditionnels qui peuvent être utilisés pour gérer des calculs génériques et qui, dans une certaine mesure, bénéficient d’un certain niveau de parallélisme grâce au concept de multicœur (grâce à la loi de Dennard), les TPU et les GPU sont des matériels spécialisés conçus pour gérer des tâches simples et spécifiques, mais d’une manière beaucoup plus efficace que n’importe quel CPU.
En résumé, on peut dire qu’ils offrent des performances et une efficacité bien supérieures aux processeurs ou GPU à usage général en privilégiant la performance à la généralité.
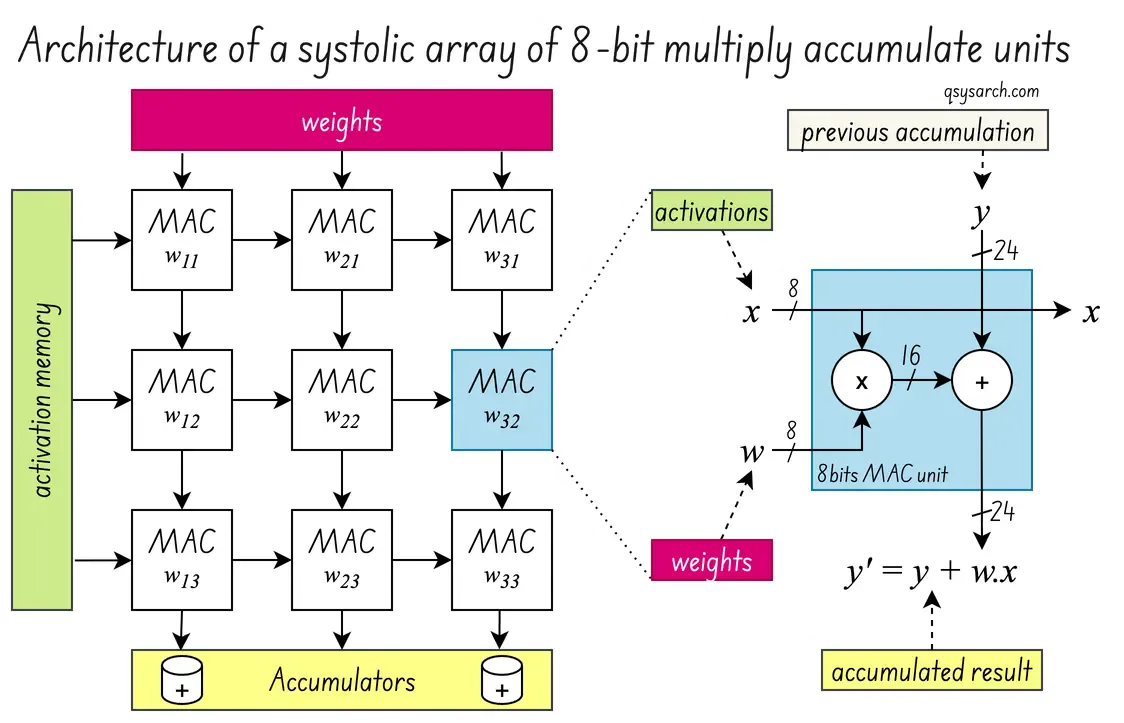
Le TPU est fondamentalement conçu pour les tâches d’algèbre linéaire lourdes, telles que les multiplications de matrices et les opérations tensorielles, utilisées par les réseaux neuronaux.
Au cœur du TPU se trouve le réseau systolique, une matrice d’éléments de traitement (généralement appelés PE, notés MAC sur le schéma de droite) qui peut effectuer des calculs parallèles.
Dans le cas du TPU, cette unité de traitement, ou MAC, est un simple multiplicateur 8 bits qui multiplie et accumule les valeurs d’activation (l’embedding) avec les poids du réseau neuronal. C’est uniquement grâce à l’exécution massivement parallèle de cette opération que le TPU atteint un débit bien supérieur à celui d’un CPU. Et c’est également le cas des GPU ! Mais avant cela, examinons l’évolution du TPU au fil du temps.
Évolution du TPU au fil du temps
Link to heading
TPUv1 : la première génération de TPU
Link to heading
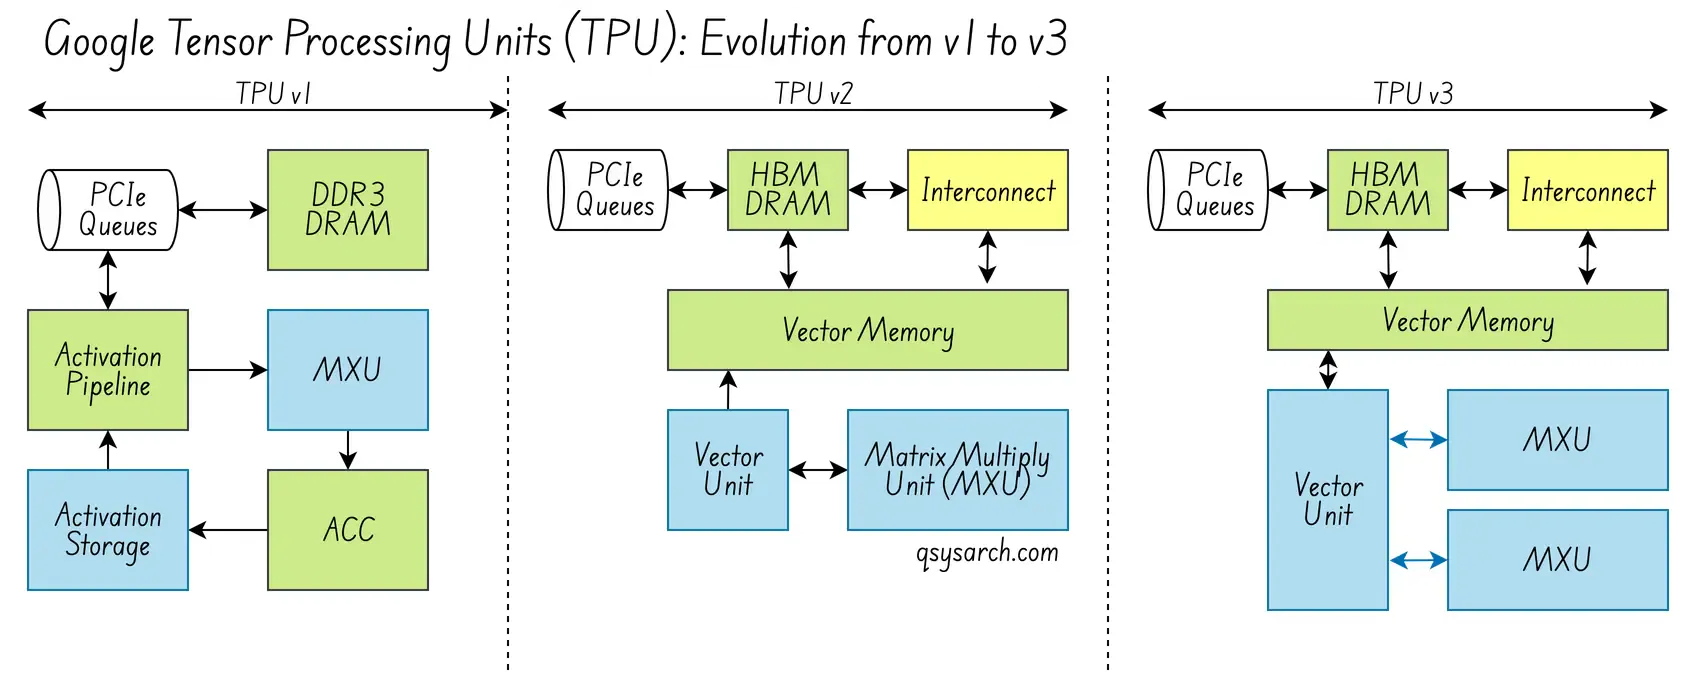
Le TPUv1 a été développé en seulement 15 mois, avec pour objectif principal d’améliorer l’inférence des réseaux neuronaux (et non l’apprentissage). Pour ce faire, Google avait besoin de multiplicateurs matriciels et devait non seulement atteindre une vitesse élevée, mais aussi réduire la consommation d’énergie. La clé de cette réduction résidait dans l’amélioration de la localité de la mémoire, c’est-à-dire la réduction des transferts de données inutiles entre la mémoire externe et la mémoire du TPU. Ceci permettait d’accroître l’intensité arithmétique par unité de contrôle, et donc de réduire le temps d’inactivité du TPU en attente de données.
Du point de vue matériel, la conception du TPU v1 était simple mais d’une efficacité élégante :
coprocesseur monothread sur une carte PCIe standard.
Pas de cache multiniveau, pas de multithreading, pas de prédiction de branchement.
Calculs mathématiques déterministes rapides sur des entiers 8 bits via l’unité MXU, ou unité de multiplication matricielle.
La matrice systolique est composée de 256 * 256 * MXU
La complexité a été transférée au planificateur logiciel, avec deux responsabilités principales :
Maintenir le pipeline occupé, en programmant les opérations de manière à ce que l’unité MXU ne soit jamais inactive.
Doubler la mémoire tampon, afin de masquer la latence d’accès à la mémoire
TPUv2 et v3 : Amélioration de la mémoire et de l’interconnexion
Link to heading
Les concepts clés des versions 2 et 3 consistent à entraîner la prochaine génération de modèles qui nécessitent la rétropropagation, une précision plus élevée et un plus grand nombre de TPU distribués et interconnectés.
Du point de vue du traitement matériel, ils ont introduit plusieurs concepts intéressants :
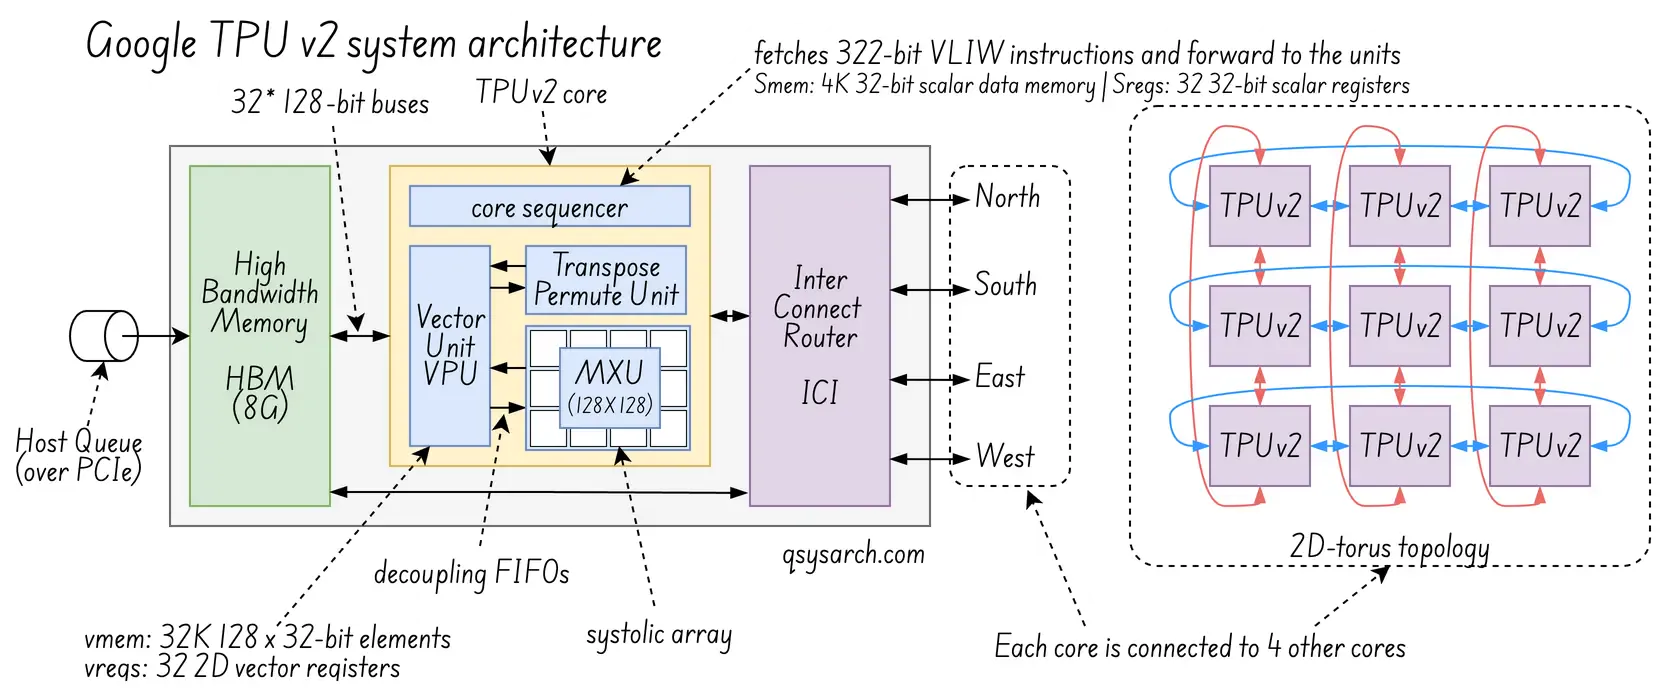
une puce à double cœur, par exemple une TPUv2 est composée de deux TPU
Chaque TPU possédait un réseau systolique quatre fois plus grand, composé de 128*128 MXU,
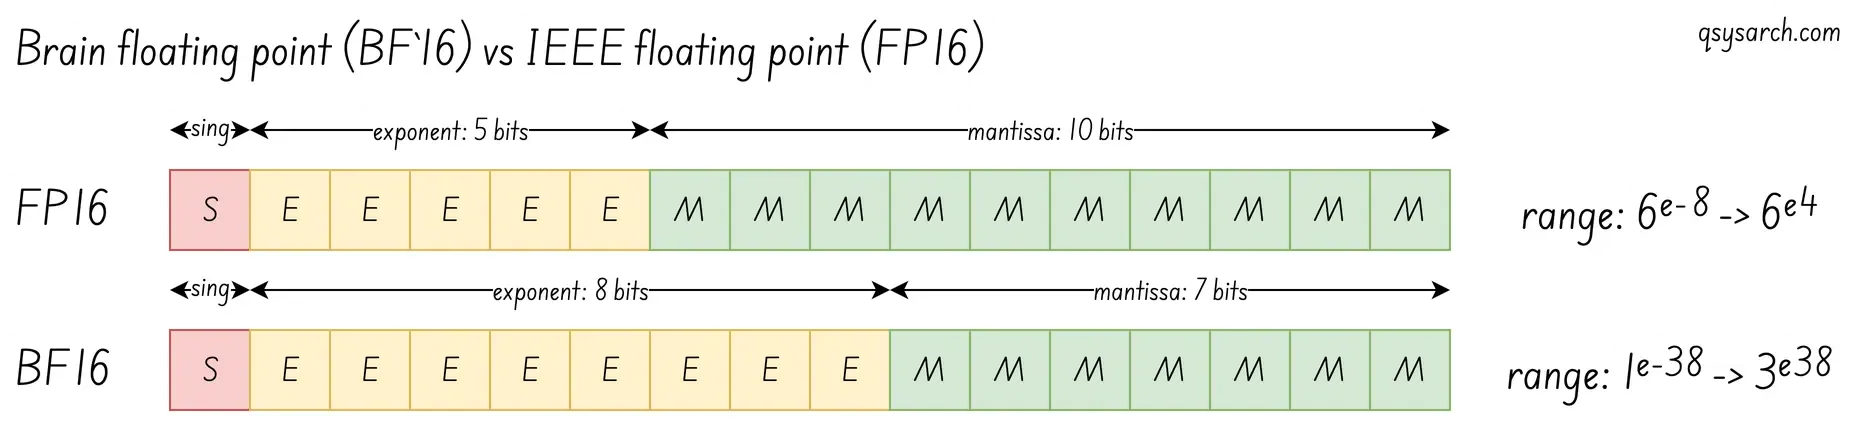
Capacité à gérer les valeurs à virgule flottante, en utilisant le format Brain Floating Point (BF16), une version améliorée du format à virgule flottante standard IEEE 754 FP16.
Une nouvelle mémoire à large bande passante (HBM) au sein du TPU pour réduire la latence d’accès à la mémoire ; (le TPUv1 ne dispose que d’une DRAM de base, avec un temps d’accès lent, tandis que la HBM est beaucoup plus rapide)
Du point de vue de la connectivité matérielle,
- Une interconnexion inter-cœurs (ICI), la structure à large bande passante qui permet l’évolutivité, via un réseau torique 2D 16x16 (réseau en anneau) - Module de supercalculateur de 256 puces.
Du point de vue logiciel, un compilateur puissant :
- Compilateur XLA : le cerveau générant les instructions VLIW utilisées par le séquenceur principal (TCS).
TPUv4 : IA à très grande échelle
Link to heading
Le concept clé de la v4 était la capacité d’exécuter des modèles d’IA à très grande échelle. Cela signifiait que le principal indicateur de performance était le coût total de possession (TCO).
Les dernières générations sont conçues pour l’entraînement à grande échelle. Les puces sont connectées en racks ou en modules, avec des systèmes de mémoire et d’interconnexion avancés. Elles prennent en charge les opérations sur les tenseurs de grande taille, l’entraînement distribué, la synchronisation et le partage efficace des données entre de nombreuses puces.
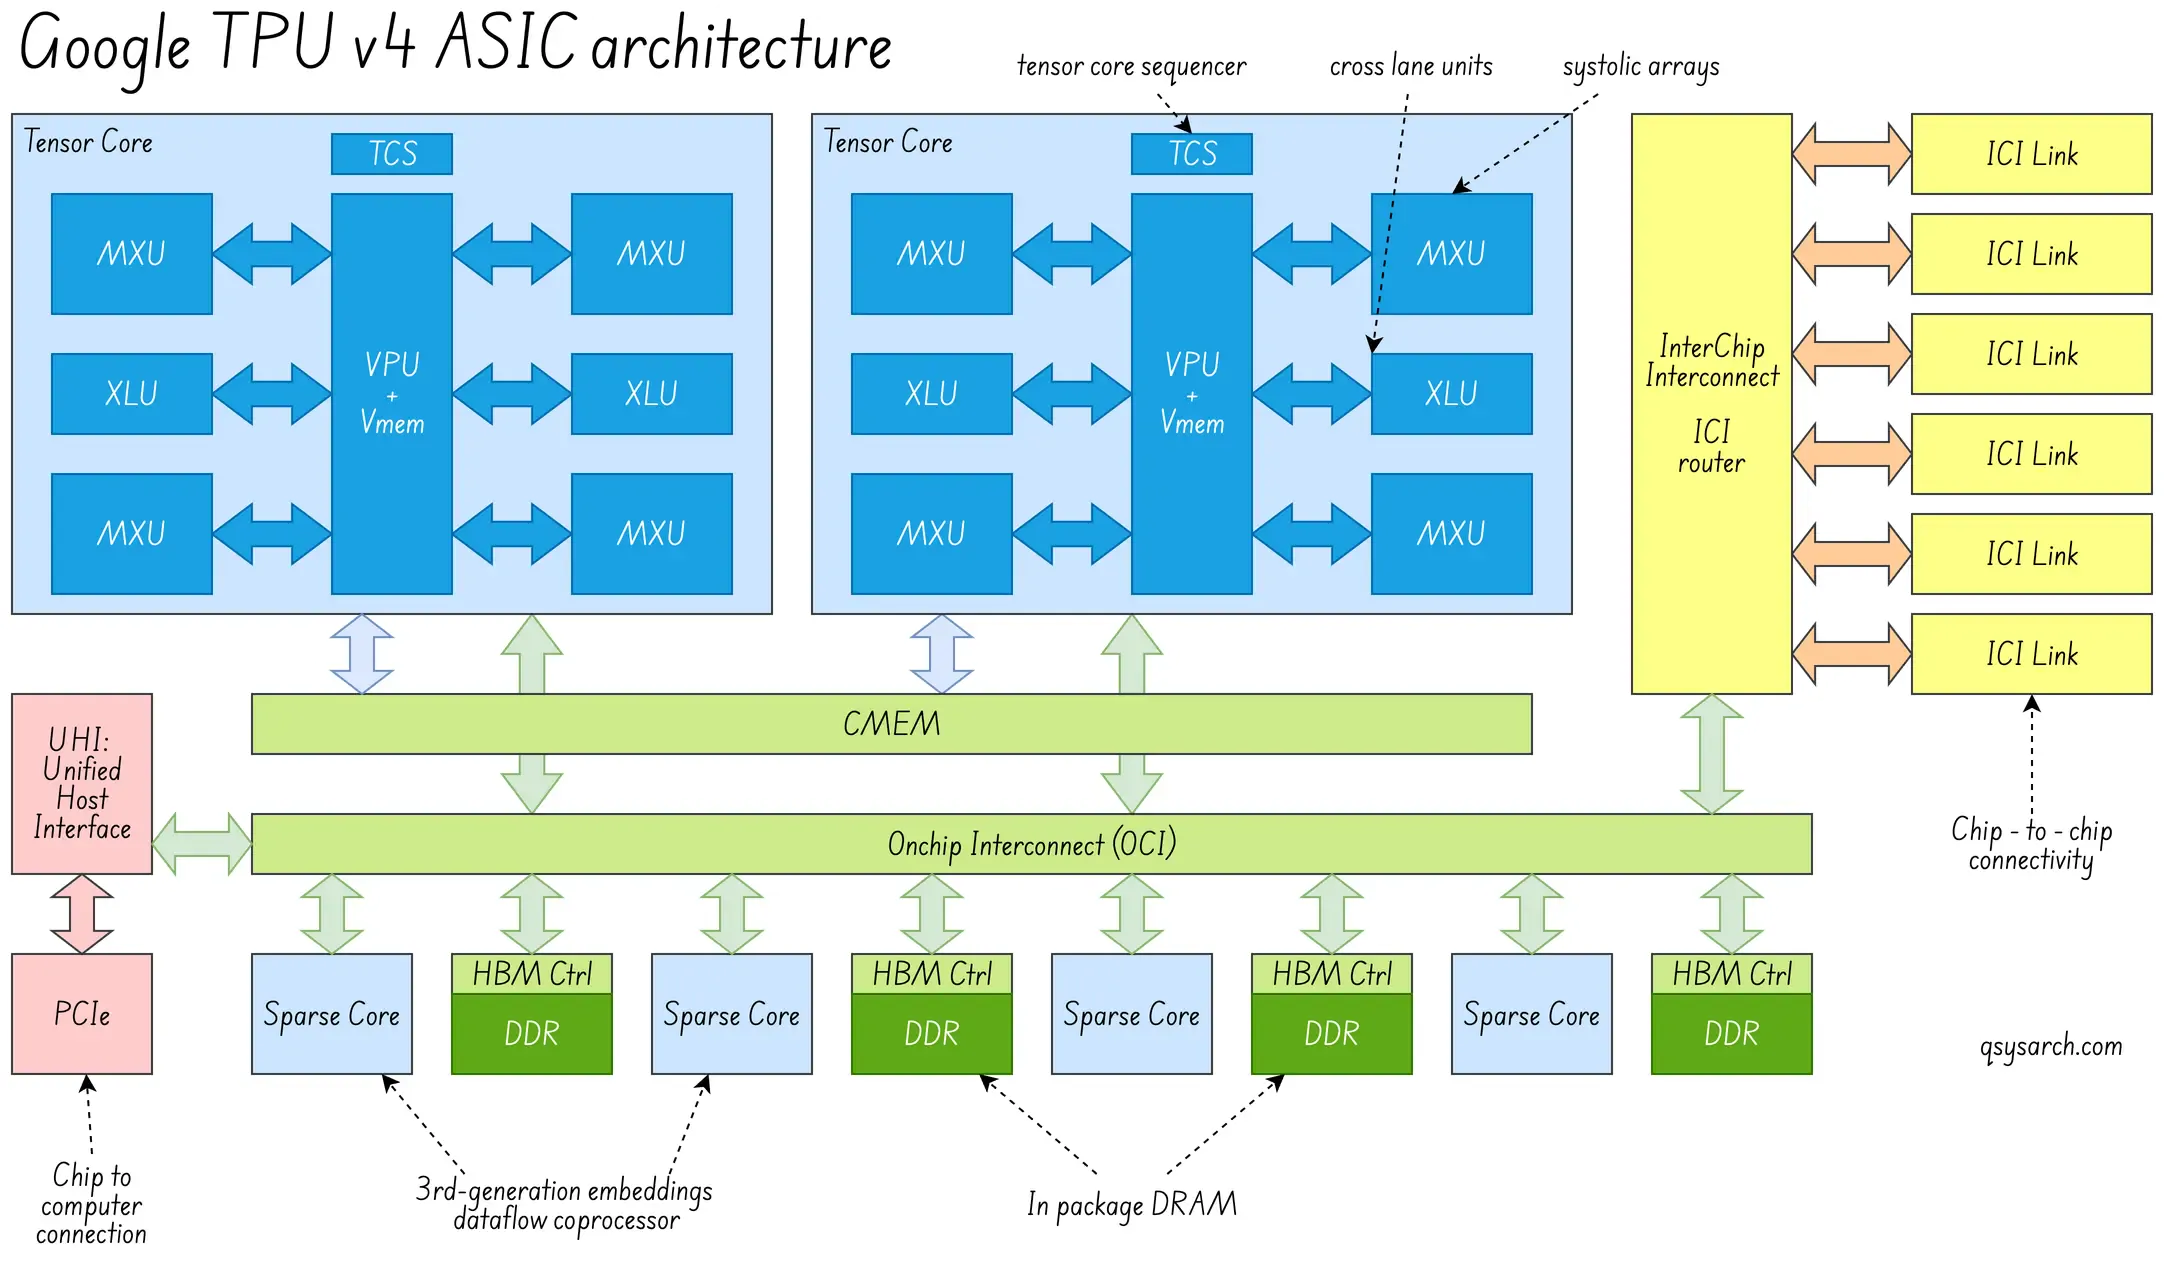
Du point de vue du traitement matériel, ils ont introduit plusieurs concepts intéressants :
Du point de vue de la connectivité matérielle,
- Le TPUv4, tout comme le TPUv2 et le v3, utilise toujours un routeur d’interconnexion (ICI), implémenté comme une liaison électrique à haut débit entre les TPU au sein du même rack.
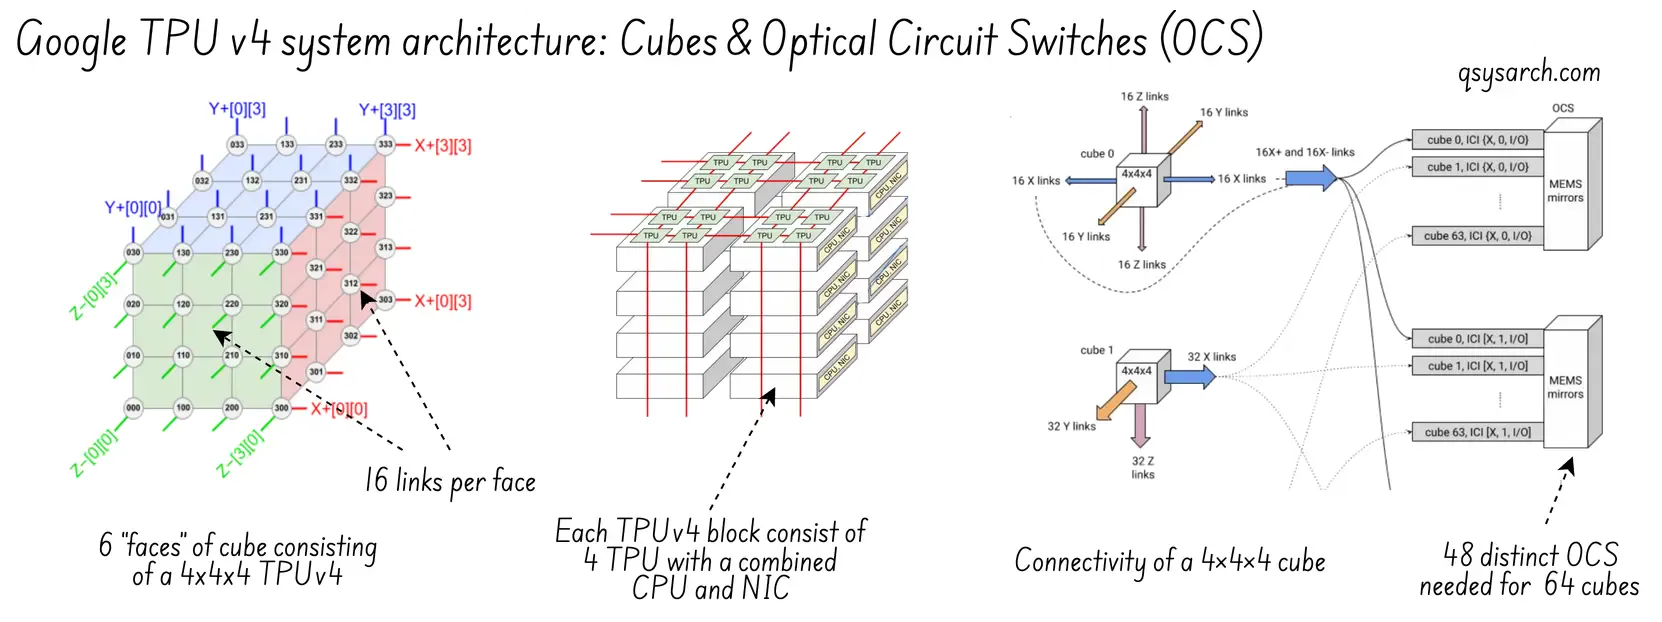
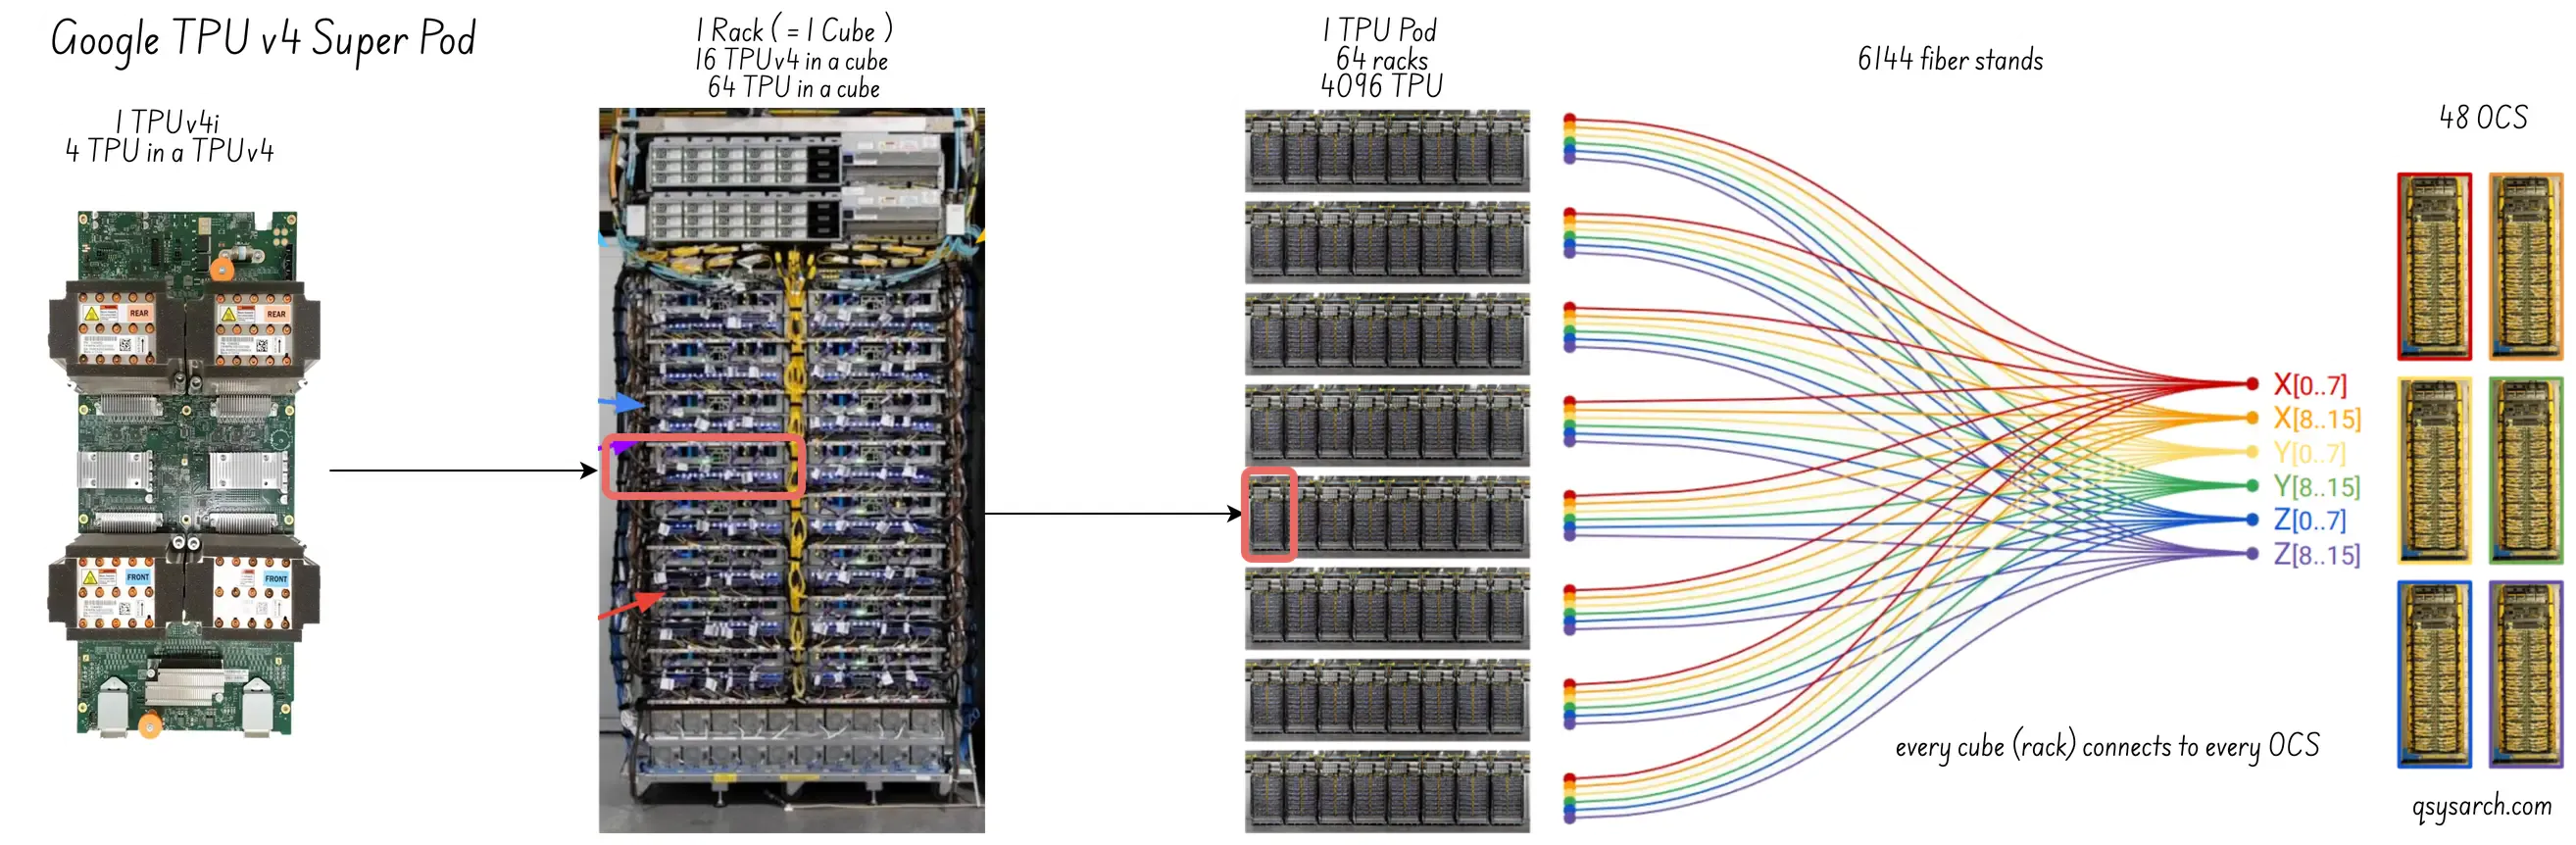
Cependant, la TPUv4 bénéficie d’une liaison optique supplémentaire entre les racks, appelée commutation de circuits optiques (OCS). Cela permet d’augmenter le nombre de TPU dans un pod jusqu’à 4 000 (contre 64 dans un seul rack), et d’atténuer les pannes en reconfigurant le routage OCS.
Enfin, et surtout, le routage devient désormais tridimensionnel grâce à la mise en œuvre d’un tore 3D, ce qui présente l’avantage non négligeable d’améliorer considérablement l’efficacité de la communication par rapport au tore 2D.
Du point de vue du Sud-Ouest :
- Introduction de nouveaux outils : Borg comme gestionnaire de cluster ; gestionnaire de pods pour configurer l’OCS ; et Libpunet pour configurer les tables de routage ICI et gérer la tolérance aux pannes.
Compilateur SPMD (Advanced Single Program Multiple Data) : ce compilateur génère plusieurs threads, chacun correspondant à un programme s’exécutant sur une TPU différente, au sein ou non du même rack. Il est comparable au concept SIMT des GPU, où le compilateur génère du code pour les threads au sein d’un warp GPU.
- Étant donné que de nombreuses TPU exécutent le même programme, l’orchestrateur Borg doit s’assurer que toutes les TPU sont co-synchrones - c’est le rôle du Gang Scheduler.
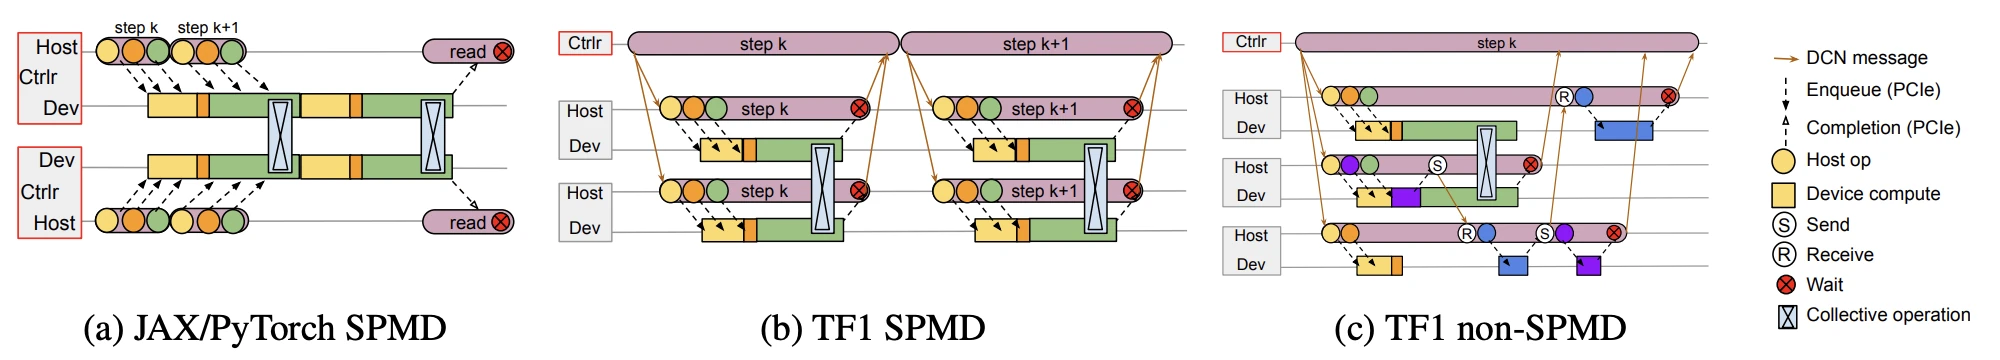
- Expliquer le concept de « chemins », nécessaires pour gérer le flux de données asynchrone pour le ministère de l’Éducation.
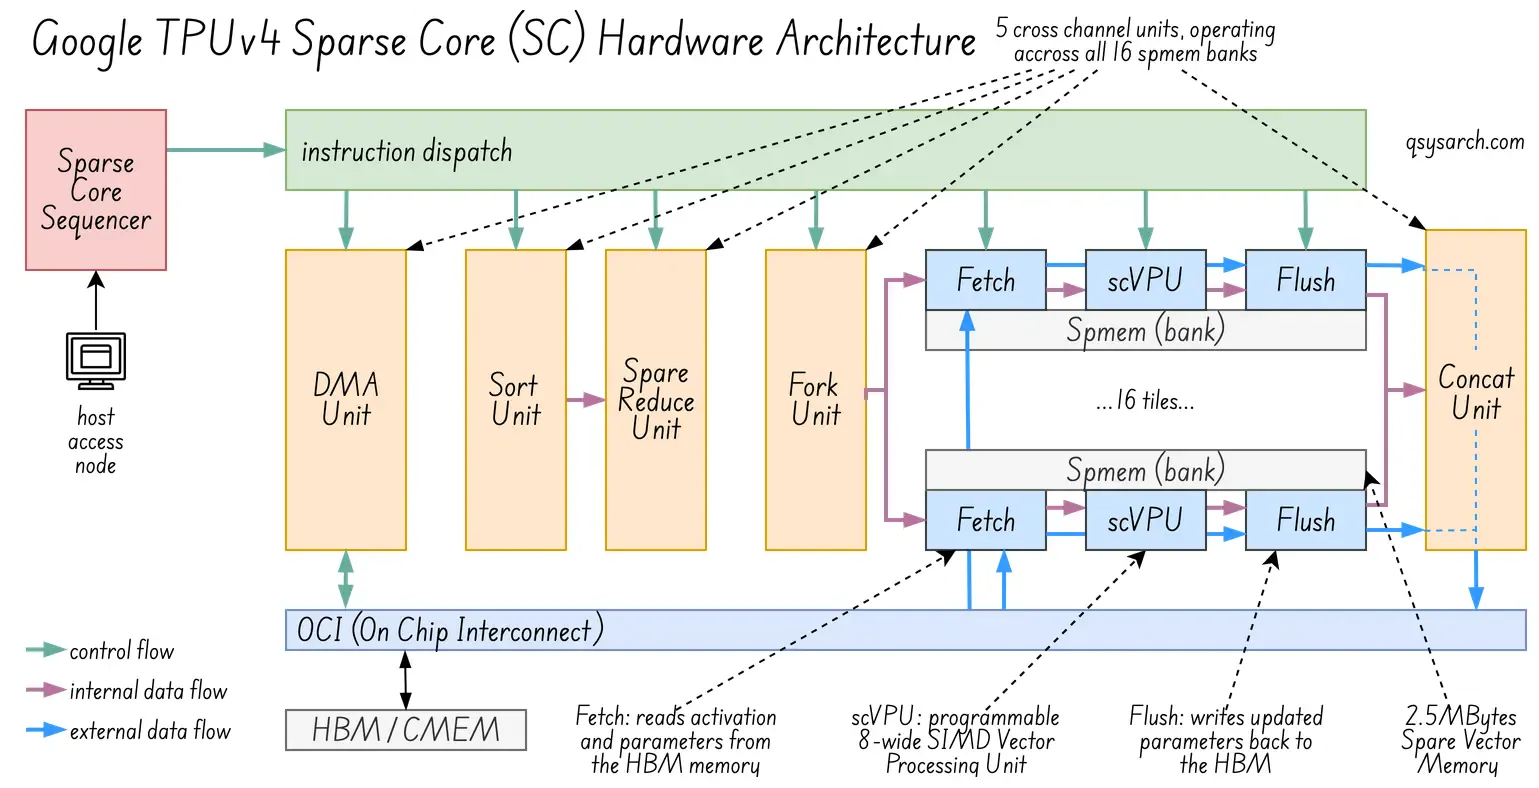
Le SparseCore (ou SC) des TPUv4 accélère les charges de travail utilisant des matrices creuses, où la plupart des valeurs sont nulles ou redondantes (comme c’est le cas pour les plongements présents dans les LLM). Il s’agit d’un optimiseur de recherche de plongements, et chaque TPUv4 intègre quatre processeurs SparseCore.
 (image adaptée de la source de l’image)
Le séquenceur SparseCore (en rouge, en haut à gauche) est l’orchestrateur chargé de distribuer les instructions aux 5 unités de traitement croisé (en orange), ainsi qu’aux 3 unités SIMD « fetch/process/flush » (en bleu). Chaque unité SIMD fonctionne sur sa propre mémoire tampon de 2,5 Mo étroitement couplée (en gris).
Sachant que chaque unité SIMD de récupération/traitement/vidage exploite 8 voies de données simultanément (SIMD=8), et qu’un processeur à cœurs clairsemés en contient 16, il s’agit d’une unité de traitement très puissante, presque comme un mini GPU intégré au GPU ! Ou, plus précisément, comme 4 mini GPU intégrés à une TPU !
Il serait vraiment intéressant d’examiner l’ISA utilisée pour programmer cette puissante unité de traitement SparseCore, mais je n’ai trouvé aucune information en ligne. C’est probablement parce qu’il s’agit plutôt d’un puissant « ordinateur DMA compatible SIMD synchrone » avec des instructions tellement spécifiques qu’il est logique de fournir une abstraction de plus haut niveau, telle que la bibliothèque JAX.
En pratique, l’utilisateur écrit le code fonctionnel de haut niveau, et le compilateur XLA (Accelerated Linear Algebra) identifie les modèles qui correspondent aux capacités matérielles du SparseCore.
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
@nn.compact
def __call__(self, indices):
embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
Que se passe-t-il en coulisses ? La méthode model.apply appelle le compilateur XLA, qui convertit le code en SparseCore. Pour cela, il effectue une correspondance avec nn.Embed (une opération gather) et génère les « pseudo-instructions » suivantes :
Dedup : XLA détecte que les valeurs 42 et 105 apparaissent deux fois dans votre entrée. Il génère des instructions SparseCore pour les dédupliquer avant la récupération.
DMA: Génère les instructions SC-scalaires pour calculer les décalages mémoire pour les ID 105, 42 et 28.
Push : Déplace le tenseur 5*128 résultant dans la mémoire commune (CMEM).
Le compilateur XLA doit également gérer le placement des données. En particulier, puisque le Sparse Core doit accéder aux indices nn.Embed, ces indices doivent être placés dans une zone mémoire accessible par le Sparse Core. Il pourrait les placer dans la CMEM, mais celle-ci étant relativement petite (128 Mo), il utilise généralement la HBM, plus grande (32 Go pour TPUv4). Le résultat du traitement par le Sparse Core est cependant replacé dans la CMEM, car il ne s’agit que d’une portion des données.
Il convient également de noter que l’architecture SparseCore a évolué dans les générations v6 et suivantes.
Mélange d’experts et de parcours du ministère de l’Éducation
Link to heading
Le modèle de mix d’experts (MME), contrairement au modèle conventionnel…
Le concept de chemins fait référence aux itinéraires physiques et logiques empruntés par les jetons lorsqu’ils sont répartis entre des experts résidant sur différentes puces TPU.
 (source de l’image)
À partir de 2023 : v5, v6 (Trillum) et v7 (Ironwood)
Link to heading
On ne dispose pas de beaucoup d’informations sur les nouvelles générations, ce sont donc les phares principaux qui restent à éclaircir :
v5e : 16 Gio HBM3e par puce ;
v5p : 95 Gio HBM3e par puce ;
v6 : 32 Gio de mémoire HBM3e par puce ; performances BF16 améliorées
v7 : 192 Gio HBM3e ; Nouvelle précision FP8
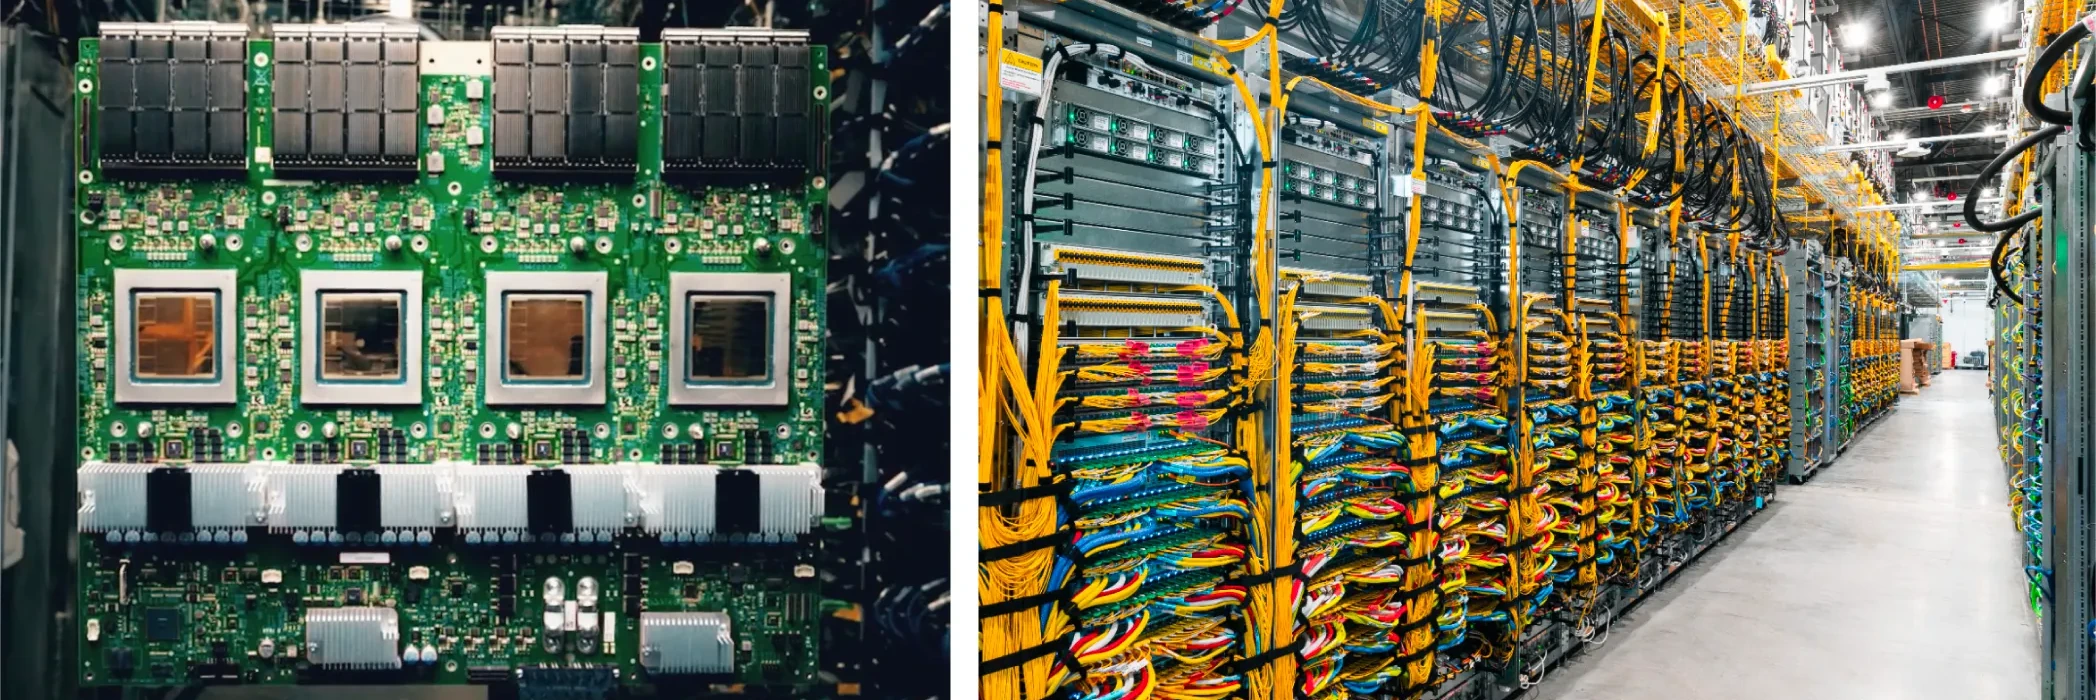
Avec Ironwood v7, un super pod est composé d’environ 9 000 TPU.
Alors, pourquoi avons-nous encore besoin de GPU si nous avons des TPU ?
La conception du TPU, qui optimise la mémoire, la puissance de calcul, la consommation d’énergie et la communication de données, démontre que la construction de systèmes d’IA haute performance à grande échelle ne se résume pas à l’utilisation de puces rapides. Elle exige également une coordination entre le matériel, les logiciels, les systèmes et les connexions réseau.
Traitement des pixels vs traitement des matrices
Link to heading
Bien que les charges de travail en IA soient aujourd’hui plus variées, couvrant l’inférence, l’entraînement, les modèles clairsemés et les systèmes de recommandation, les TPU ne sont pas conçus pour traiter les pixels. Les GPU, en revanche, sont peu utilisés aujourd’hui car Nvidia a exposé un modèle de programmation et une expérience de développement permettant aux GPU de se comporter comme une TPU.
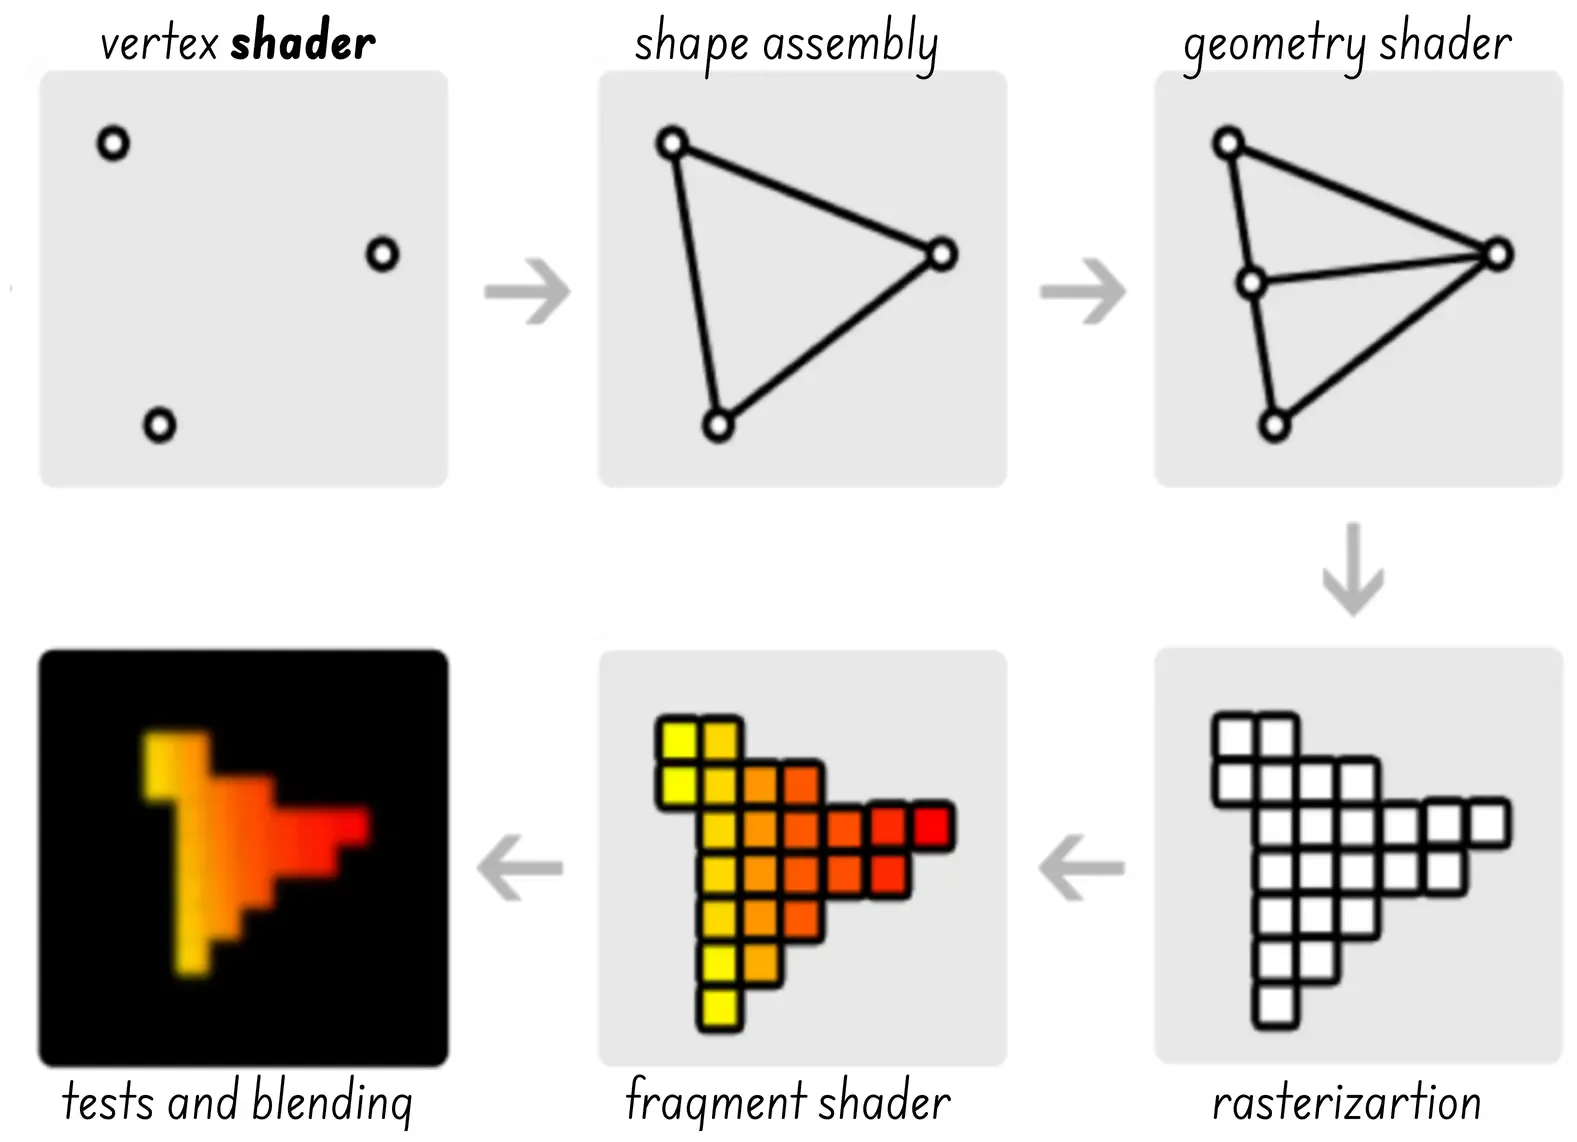
Cela signifie-t-il que les GPU sont supérieurs ? Pas nécessairement : pour des charges de travail très spécifiques, les TPU peuvent être plus efficaces que les GPU, notamment en termes de consommation d’énergie et de performances par watt. Et dans le monde actuel, où les centres de données d’IA consomment toujours plus d’énergie, les TPU pourraient bien faire toute la différence.
Qu’en est-il des CI neuromorphiques analogiques ?
Link to heading
Et qu’en est-il des circuits intégrés neuromorphiques ? Comparés aux TPU, ils visent une consommation d’énergie encore plus faible grâce à l’utilisation du calcul analogique et du traitement événementiel à basse fréquence. Que faudra-t-il pour que les circuits intégrés neuromorphiques se généralisent et atteignent la même échelle que les super-modules TPUv7 ?
L’un des défis que je dois encore relever est de mieux comprendre la consommation d’énergie relative du réseau systolique (MXU + Spares Core) par rapport au reste du TPU (y compris ICI, OCI, TCS), et comment ce ratio se compare au réseau neuronal à impulsions neuromorphiques (SNN) par rapport à la logique de contrôle (RiscV et Spike copro).
De plus, si les circuits intégrés neuromorphiques atteignaient l’échelle des TPUv7, un investissement similaire en logiciels, systèmes et connexions réseau serait probablement nécessaire. Sinon, on pourrait envisager d’intégrer un réseau de neurones à impulsions (SNN) à un TPU et d’utiliser la logique de contrôle de ce dernier pour gérer la communication entre le SNN et le reste du TPU/Rack/Pad. Mais est-ce vraiment nécessaire ? Quel problème cherchons-nous à résoudre ? Il faudrait peut-être envisager une autre approche.
Retour vers le futur : l’unité de traitement du langage
Link to heading
Cette note ne serait pas complète sans mentionner l’Unité de traitement du langage, un nouveau type de processeur conçu pour optimiser l’inférence de grands modèles de langage.
Je devrai rédiger une note de service dédiée à ce sujet précis. Pour l’instant, il s’agit donc d’une simple comparaison générale visant à déterminer si le LPU représente plus qu’une réinvention du TPUv1, qui était uniquement axé sur l’inférence et non sur l’entraînement.
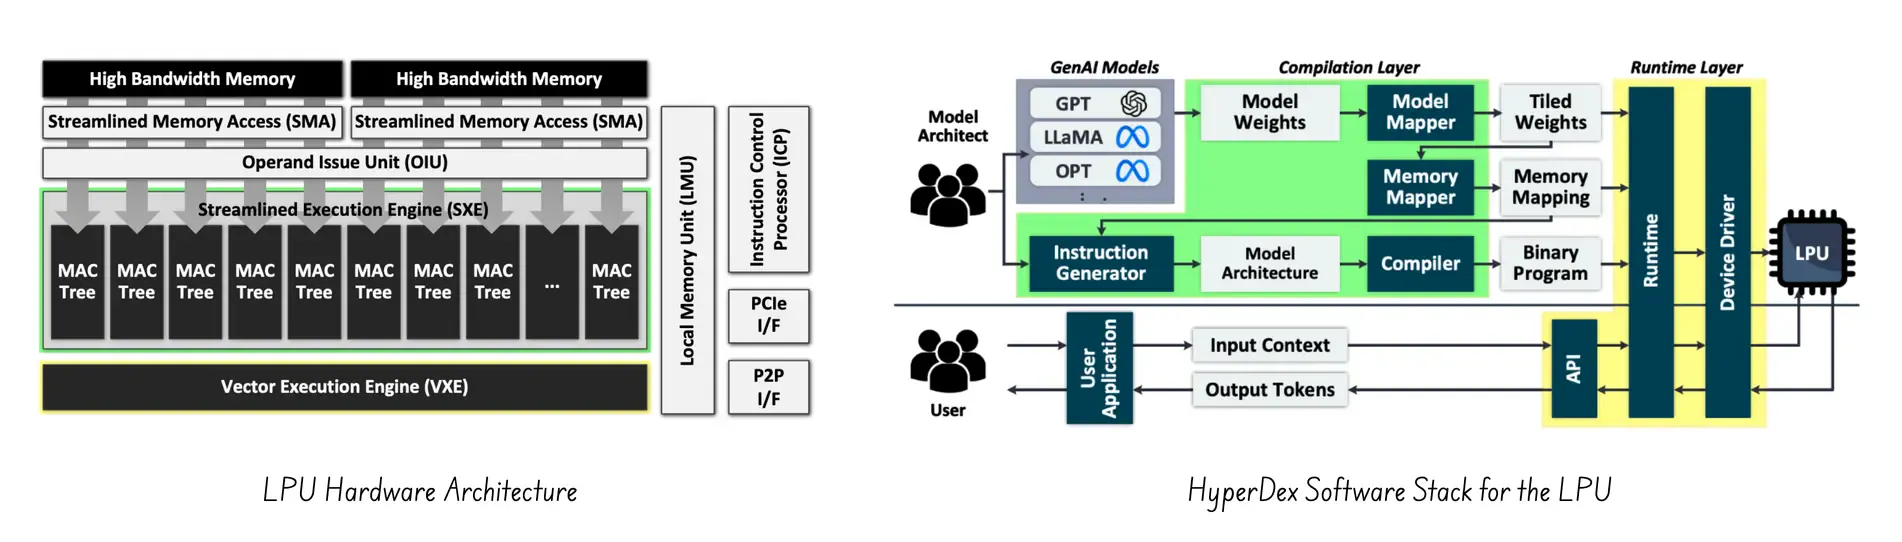
De manière générale, oui, les TPU et les LPU partagent le besoin d’effectuer certaines tâches très efficacement et à grande échelle, grâce à une architecture dédiée (DSA). Cependant, en termes d’implémentation et d’optimisation concrètes, le LPU est une technologie très différente, avec une approche différente.
La principale différence réside dans le fait que le TPUv1 a été conçu avant même l’existence du LLM (rappelons que la première version de ChatGPT date de 2022) et était axé sur l’inférence générale des réseaux neuronaux profonds (DNN). Cela impliquait de garantir le débit et les performances par watt pour les opérations massives et à haut volume, grâce à une architecture sous-jacente de MXU systolique.
L’unité de traitement du langage (LPU), quant à elle, est conçue pour optimiser l’inférence des grands modèles de langage (LLM). Son objectif principal est de réduire la latence par jeton. Pour ce faire, elle nécessite une architecture de traitement du signal (ISA) prenant en charge une architecture multipipeline VLIW entièrement déterministe et à ordonnancement statique. Certes, on pourrait objecter que la TPUv4 introduit une ISA VLIW similaire pour le TCS. Cependant, la principale différence réside dans le fait que l’ISA de la LPU est une machine VLIW entièrement déterministe, où chaque chargement, calcul et stockage est ordonnancé cycle par cycle. En revanche, pour la TPU, l’unité de traitement du signal (MXU) est un réseau systolique « auto-piloté ».
Voilà, c’est une brève note qui, une fois de plus, a pris plus de temps que prévu. Ce qui ressort clairement de cette analyse approfondie, c’est que l’évolution de l’architecture TPU démontre que la conception d’accélérateurs d’IA est une tâche complexe qui exige de prendre en compte de nombreux facteurs.
La conception du TPU, qui optimise la mémoire, la puissance de calcul, la consommation d’énergie et la communication de données, démontre que la construction de systèmes d’IA haute performance à grande échelle ne se résume pas à l’utilisation de puces rapides. Elle exige également une coordination entre le matériel, les logiciels, les systèmes et les connexions réseau.
J’ai un peu l’impression d’un déjà-vu. Se pourrait-il que l’unité de traitement quantique (QPU) soit la prochaine étape de l’évolution des accélérateurs d’IA ?
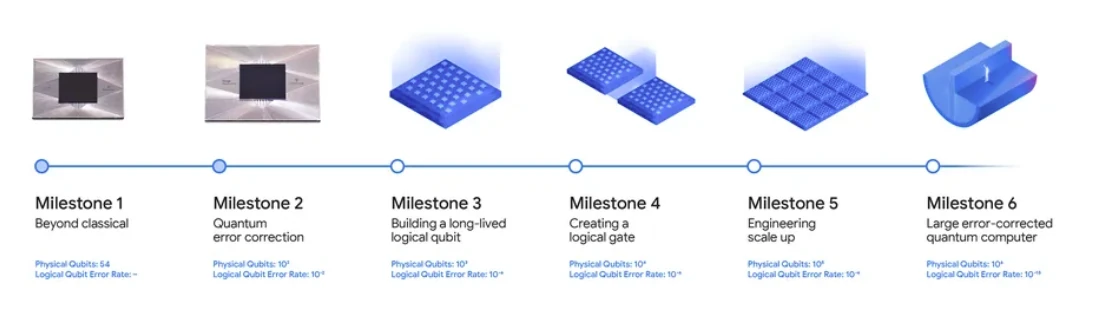 (source de l’image : Google Willow)
Diagrammes DrawIO utilisés dans cette note :