J’ai travaillé chez Spirent, une entreprise spécialisée dans les systèmes de test et de mesure pour les réseaux haute performance. Le produit s’appelait Test Center (https://www.spirent.com/products/testcenter-hardware), et avec une équipe très talentueuse, nous développions le système de test des systèmes RoCEv2. Je me concentrais plus particulièrement sur le contrôle de flux prioritaire (PFC) et son activation pour l’analyseur et générateur de paquets (PGA) 800 Gbit/s basé sur un FPGA.
Cependant, je n’ai jamais eu l’occasion d’examiner la couche 4, et cette note tente de combler cette lacune en articulant les éléments clés de la couche de transport InfiniBand (L4) et en les visualisant à l’aide de quelques diagrammes.
Commençons par le châssis RoCEv2 proprement dit :
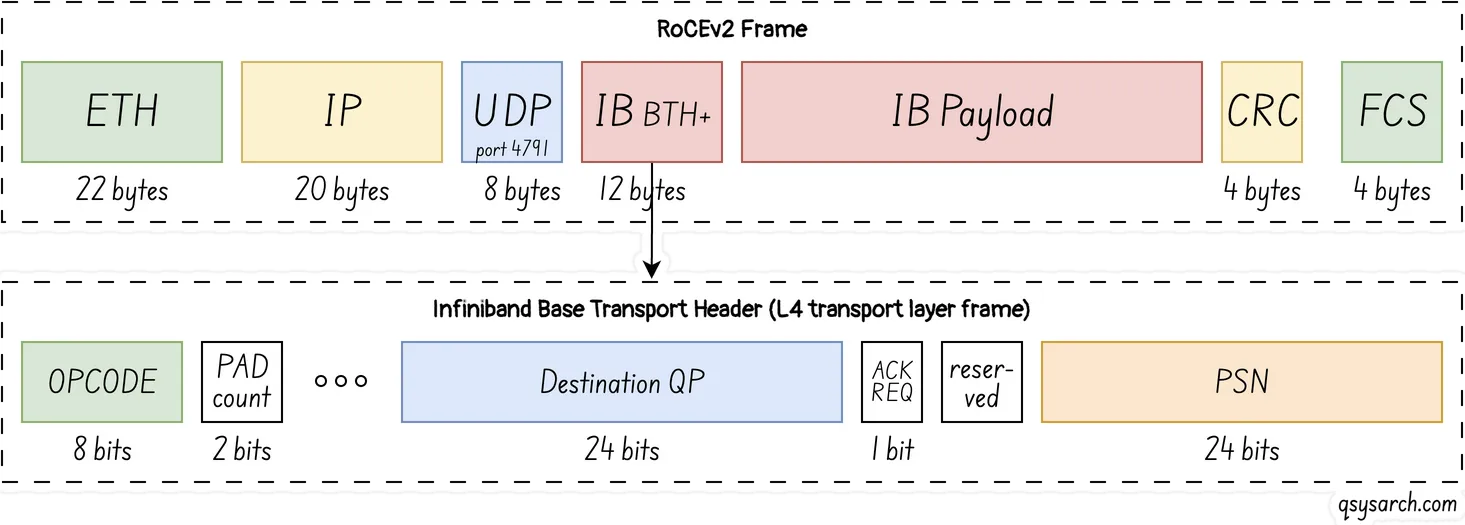
En-tête de transport de base (BTH)
Link to heading
Principaux champs inclus dans l’en-tête BTH :
Code d’opération : utilisé pour spécifier le type d’opération RDMA, tel que RDMA_WRITE, RDMA_READ, …
QP de destination : Utilisé pour distinguer les différentes paires de files d’attente de destination pour un paquet.
Demande d’accusé de réception : indique si le destinataire doit renvoyer un accusé de réception pour ce paquet.
Numéro de séquence de paquet (PSN) : utilisé dans le suivi de la séquence de paquets pour une livraison fiable.
Le protocole UDP étant peu fiable, des trames peuvent être perdues, désordonnées ou dupliquées ; le PSN est donc utilisé pour garantir leur bonne transmission. Cela implique également que l’IBTL puisse demander la retransmission des trames. Cette fonction est assurée par l’en-tête AETH, décrit ci-dessous.
En-tête de transport étendu (ETH)
Link to heading
La couche transport InfiniBand comporte plusieurs en-têtes étendus, utilisés pour des fonctions spécifiques. Dans le cas du RDMA, les deux plus importants sont RETH et AETH.
En-tête de transport étendu RDMA (RETH)
Link to heading
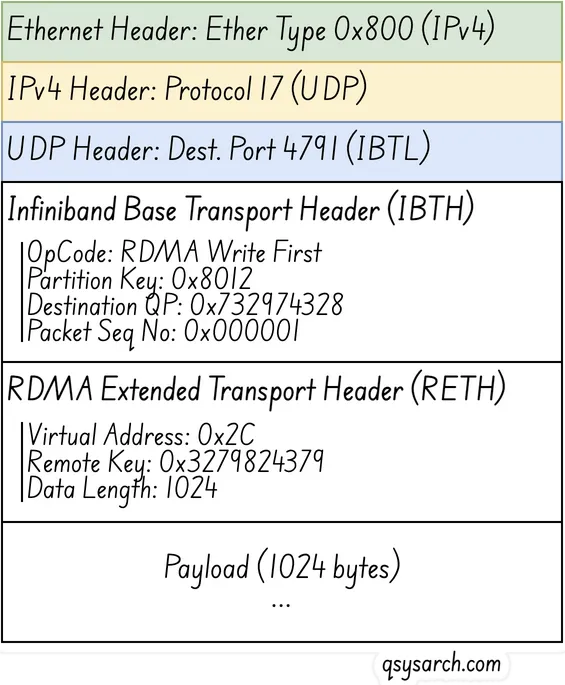
L’opération RDMA_WRITE requiert plusieurs éléments, représentés dans les champs de l’en-tête étendu RETH. Cet en-tête informe le matériel de réception des détails de l’opération d’écriture, notamment :
Adresse virtuelle : l’adresse mémoire de destination où les données seront écrites
Clé distante (R_Key) : Clé d’accès qui valide les autorisations d’accès à la région mémoire
Longueur : Taille des données à transférer
ACK En-tête de transport étendu (AETH)
Link to heading
Comme expliqué précédemment, l’IBTL doit notifier l’expéditeur en cas de transmission non fiable. Ceci est réalisé grâce à l’extension EATH, qui contient le champ suivant :
Syndrome : Champ contenant des codes de réponse indiquant la réussite (ACK), les erreurs (NAK) ou l’état « récepteur non prêt » (RNR), ainsi que des informations de contrôle de flux.
Numéro de séquence du message (MSN) : indique le numéro de séquence du message le plus récemment traité, ce qui signifie que tous les messages dont le numéro de séquence est inférieur ont été reçus avec succès.
La spécification IBTL (voir chapitre 9) contient en effet un certain nombre d’extensions, dont certaines ont retenu mon attention :
Compare And Swap : Permet d’effectuer une synchronisation sans verrouillage.
Envoi vs écriture : le premier peut être utilisé pour le flux de contrôle, tandis que le second est utilisé pour le flux de données.
Extension immédiate : Autorisation de l’échange de métadonnées par canal auxiliaire en même temps que la mémoire à transférer.
Je me suis également demandé comment déterminer les extensions présentes dans l’en-tête. La réponse est simple : pour chaque opcode, il existe une liste d’extensions à analyser ; cette liste est définie statiquement, dans la spécification.
Comme l’indique Toni Pasanen dans son blog The Network Times :
La communication entre GPU génère des flux de données massifs, que les cartes réseau compatibles RDMA transmettent à pleine vitesse. Ces flux peuvent facilement provoquer une congestion sur le réseau dorsal.
La capacité du RDMA à générer du trafic à débit maximal est remarquable. Cependant, cela pose également un problème concernant la taille des flux (taille du flux entre deux périodes d’inactivité consécutives) : la probabilité d’accéder à un intervalle d’inactivité diminue considérablement avec les flux RDMA de grande taille.
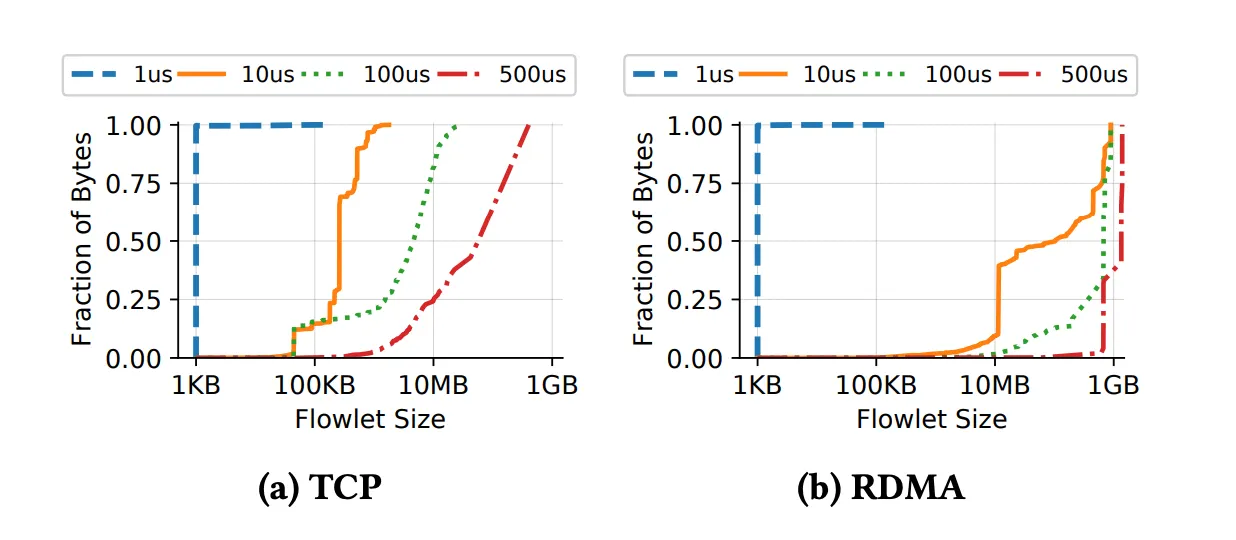 Image tirée de : Équilibrage de charge réseau avec prise en charge du réordonnancement interne pour RDMA
Le défi de l’équilibrage de charge
Link to heading
L’autre complexité réside dans l’équilibrage de charge avec les topologies spine-leaf, où les paquets peuvent être reçus dans le désordre sur une seule paire de files d’attente lorsque l’équilibrage de charge par pulvérisation de paquets est utilisé. Ceci engendre une complexité que Nvidia a résolue en introduisant une nouvelle opération RDMA appelée « RDMA Write Only ».
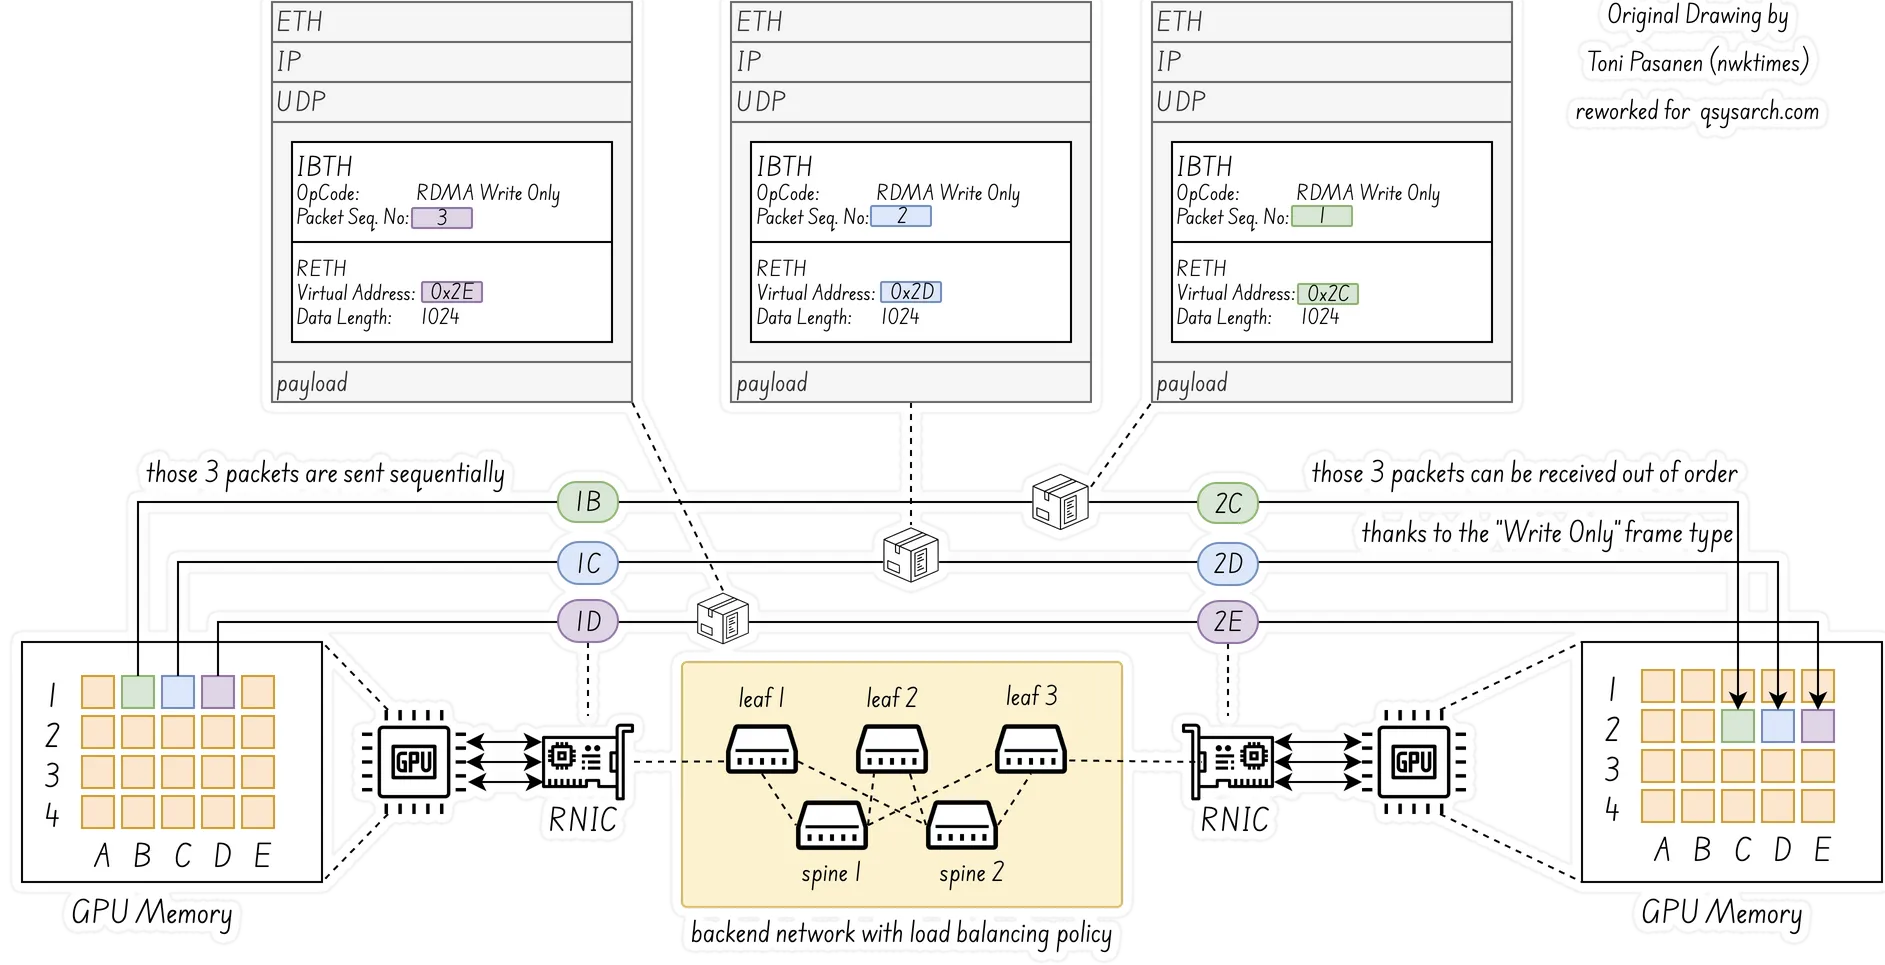 Image originale : The Network Times
Il s’agit d’une note de service « active » que je continuerai à mettre à jour au fur et à mesure que je trouverai plus d’informations sur l’IBTL.
Aucune conclusion n’a encore été tirée, si ce n’est que le RDMA est une solution très élégante au problème de l’efficacité du réseau, et qu’il soulève un ensemble de nouveaux défis.
References: