
De nombreux termes techniques sont associés à la technologie RDMA dans le contexte des GPU : GPU-direct, NVLink, NVLink Fusion, InfiniBand, Quantum InfiniBand, GPUNetIO et DOCA. De quoi s’y perdre ! Mais peut-être que ça ne devrait pas l’être ?
Cet article est rédigé sous forme de note personnelle, tentant d’exposer les différentes technologies et de les visualiser à l’aide de quelques schémas.
GPU Direct et RDMA : Marketing vs. Technologie.
Link to heading
Commençons in medias res, avec la page confuse GPUNetIO de la documentation officielle de Nvidia :
Notez que l’acronyme RDMA désigne le protocole permettant l’accès direct à distance à la mémoire d’un ordinateur vers celle d’un autre, sans intervention du système d’exploitation de l’un ou l’autre. Il ne faut pas le confondre avec GPUDirect RDMA, qui est un protocole indépendant.
C’est clair, GPUDirect RDMA n’est pas la même chose que le protocole RDMA ! Mais GPUDirect RDMA utilise-t-il au moins le protocole RDMA ? Je l’espère ; sinon, ce serait vraiment déroutant.
GPUDirect RDMA est une technologie de la famille GPUDirect de NVIDIA. Elle permet à la carte réseau d’envoyer et de recevoir des données directement en accédant à la mémoire du GPU, sans passer par le CPU ni le système d’exploitation. GPUDirect RDMA est compatible avec tous les frameworks réseau prenant en charge Ethernet, InfiniBand et RoCE.
D’accord, au moins c’est clair : GPUDirect RDMA peut être implémenté sur n’importe quelle couche transport, qu’il s’agisse d’Ethernet (ETH) ou d’InfiniBand (IB). Mais alors, qu’est-ce que GPUNetIO et quel est son lien avec RDMA ? La réponse est simple. GPUNetIO est, comme son nom l’indique, une implémentation réseau de GPU Direct RDMA sur une carte réseau. Cela ne signifie pas que GPU Direct doit être piloté par une carte réseau, mais simplement que GPUNetIO est une version spécialisée pour ce type de carte réseau.
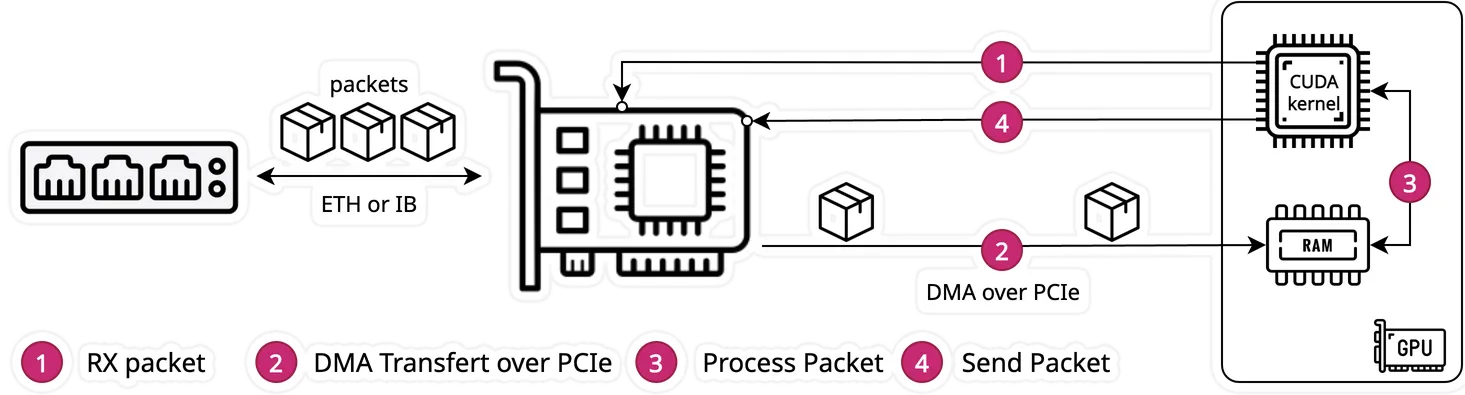
Dans le schéma ci-dessus de la documentation GPUNetIO (https://docs.nvidia.com/doca/sdk/doca+gpunetio/index.html), la mention « CUDA » est quelque peu déroutante. Je suppose qu’il s’agit d’un noyau s’exécutant sur le GPU, mais vérifions ce que dit la documentation :
Les approches traditionnelles reposent souvent sur un modèle centré sur le processeur, où ce dernier se coordonne avec la carte réseau pour recevoir les paquets en mémoire GPU via GPUDirect RDMA. Ensuite, le processeur notifie un noyau CUDA sur le GPU pour le traitement des paquets. DOCA GPUNetIO relève ce défi en proposant une solution centrée sur le GPU qui élimine le processeur du chemin critique.
Pour moi, ce n’est toujours pas tout à fait clair : il est indiqué « centré sur le GPU » pour le chemin critique, mais de quel chemin critique s’agit-il ? S’agit-il des étapes (1) à (4) mentionnées dans le diagramme ? Et à quoi sert encore le CPU ? Pour trouver la réponse, il faut examiner le mode « asynchrone initié par le noyau », qui est décrit comme la possibilité pour « un noyau CUDA GPU de contrôler les communications réseau pour envoyer ou recevoir des données ». GPUDirect IKA permet :
Le GPU peut contrôler les communications Ethernet (Ethernet/IP/UDP/TCP/ICMP)
Le GPU peut contrôler les communications RDMA (InfiniBand ou RoCE sont pris en charge).
L’intervention du processeur est inutile dans le chemin critique de l’application
Donc, c’est parfaitement clair :
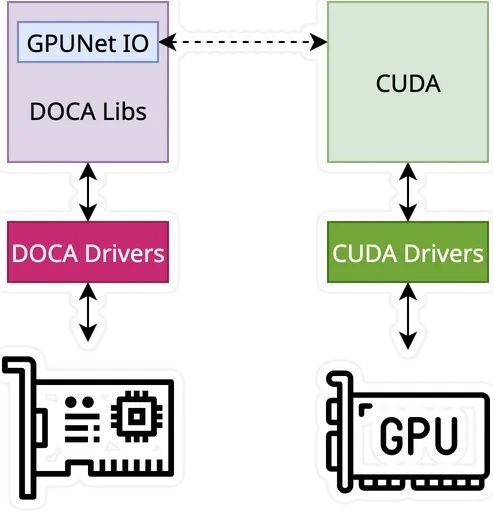
GPU Direct RDMA « permet des transferts de données directs vers/depuis la mémoire GPU sans copies intermédiaires sur le CPU.
GPU Direct AKI permet au GPU de « contrôler » la carte réseau.
GPUNetIO est un composant logiciel qui gère à la fois les technologies GPU Direct RDMA et AKI.
DOCA est le SDK fourni par Nvidia pour programmer le matériel compatible GPUNetIO (entre autres).
Je suppose que la confusion provient du fait que « AKI » devrait être mentionné comme « GPU Direct RDMA + AKI », car il complète la capacité RDMA qui permet de contourner le processeur.
Nous comprenons désormais que GPU Direct RDMA, commercialisé par Nvidia sous l’appellation GPUNetIO, est une solution basée sur une carte réseau (NIC), qui connecte le GPU à la NIC via une interface PCIe. Examinons plus en détail cette connexion PCIe, faisons abstraction de la partie GPUNetIO et concentrons-nous sur la partie RDMA :
Dans la documentation officielle de CUDA GPUDirect RDMA, il est indiqué que la seule exigence est un complexe racine PCIe :
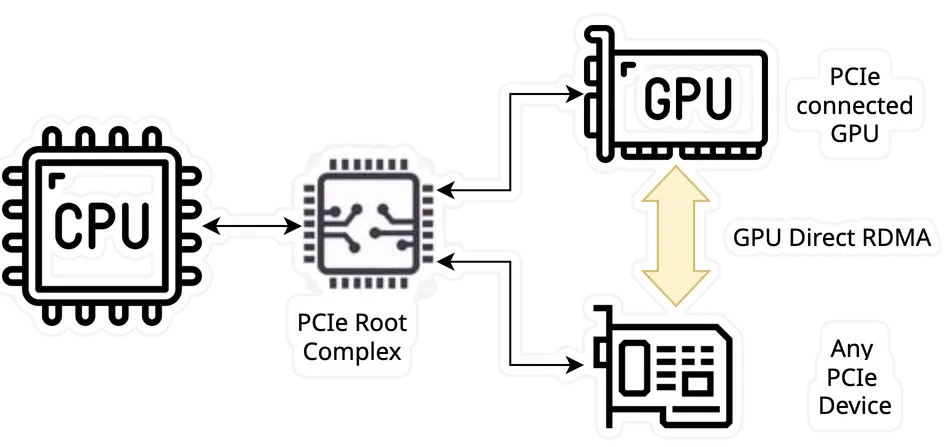
GPUDirect RDMA est une technologie introduite dans les GPU de classe Kepler et CUDA 5.0 qui permet un échange direct de données entre le GPU et un périphérique tiers via les fonctionnalités standard de PCI Express. Plusieurs limitations s’appliquent, la principale étant que les deux périphériques doivent partager le même complexe racine PCI Express en amont.
GPUDirect RDMA est une solution permettant à tout périphérique PCIe de communiquer directement avec le GPU, à condition qu’il appartienne au même système de contrôle racine. Ainsi, bien que principalement commercialisée par Nvidia comme une solution pour les cartes réseau PCIe, elle peut concerner n’importe quelle carte PCIe, par exemple une carte PCIe pour caméra haute vitesse. C’est intéressant, mais essayons de comprendre comment cela fonctionne.
Lors de la configuration d’une communication GPUDirect RDMA entre deux périphériques homologues, toutes les adresses physiques sont identiques du point de vue des périphériques PCI Express. Cet espace d’adressage physique est divisé en fenêtres linéaires appelées BAR PCI. Chaque périphérique possède au maximum six registres BAR, ce qui lui permet d’avoir jusqu’à six régions BAR 32 bits actives. Les BAR 64 bits utilisent deux registres BAR. Le périphérique PCI Express effectue des opérations de lecture et d’écriture sur les adresses BAR du périphérique homologue de la même manière qu’il le fait pour la mémoire système.
Traditionnellement, les ressources telles que les fenêtres BAR sont mappées dans l’espace d’adressage utilisateur ou noyau à l’aide de l’unité de gestion de la mémoire (MMU) du processeur, sous forme d’adresses d’E/S mappées en mémoire (MMIO). Cependant, les systèmes d’exploitation actuels ne disposant pas de mécanismes suffisants pour l’échange de régions MMIO entre pilotes, le pilote noyau NVIDIA exporte des fonctions permettant d’effectuer les traductions et mappages d’adresses nécessaires.
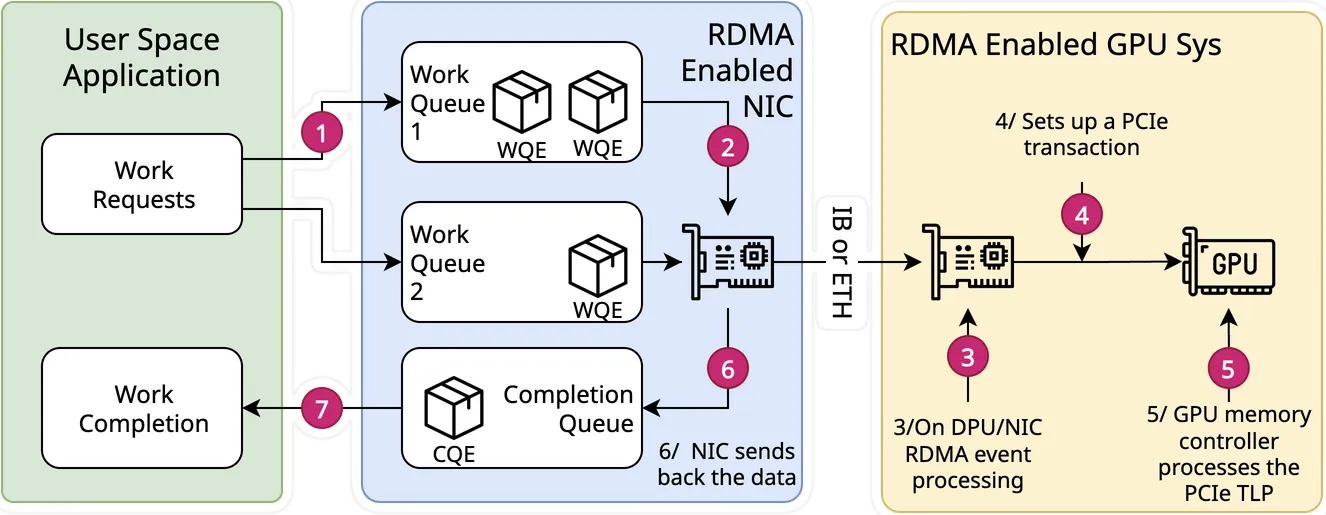
Ce qui peut prêter à confusion, c’est que le terme « DMA » peut sembler plus approprié que « RDMA » lorsqu’on considère un système intra-PCIe connectant des périphériques hétérogènes. Or, c’est précisément là le point crucial. Le DMA est la solution de transfert de données, tandis que le RDMA, situé au-dessus, est le protocole utilisé pour définir la sémantique des données transférées, à l’aide de verbes. Ainsi, le DMA correspond en réalité aux étapes (4) et (5) du schéma ci-dessous, tandis que le protocole RDMA côté matériel (réception) ne correspond qu’à l’étape (3).
Il convient de noter que Nvidia précise que ce n’est pas une chose simple ; par conséquent, pour obtenir les meilleures performances, il est probablement préférable d’utiliser une plateforme de test connue :
Bien que la seule condition théorique pour que GPUDirect RDMA fonctionne entre un périphérique tiers et un GPU NVIDIA soit qu’ils partagent le même complexe racine, il existe des bugs (principalement dans les chipsets) qui peuvent entraîner de mauvaises performances, voire l’empêcher de fonctionner du tout dans certaines configurations.
Il subsiste une confusion manifeste dans la terminologie, notamment entre Ethernet, InfiniBand et RoCE : le fait que RoCE soit basé sur Ethernet.

L’association professionnelle InfiniBand décrit cette technologie en termes simples comme une évolution, illustrée dans le schéma ci-dessus. Notez que j’ai volontairement utilisé l’appellation « 100G + PFC » plutôt que « DCB » (ou Data Center Bridging). Si je comprends bien, le DCB englobe le PFC (ou priority flow control), et l’idée est que le fonctionnement du DCB/PFC nécessite une infrastructure réseau, notamment des commutateurs, capable de prendre en charge ces technologies. Dans le cas contraire, on retombe dans l’utilisation d’Ethernet.
Cette note serait incomplète sans mentionner NVLink. La question qui se pose est de savoir si NVLink et InfiniBand sont identiques ou liés. En résumé, ils sont complémentaires, et non concurrents.

NVLink : Communication intra-nœud rapide (au sein d’un serveur, entre GPU).
InfiniBand : Communication inter-nœuds rapide (entre les serveurs d’un cluster)
Sur le schéma de droite, on voit clairement que les flèches vertes servent à interconnecter les GPU entre eux. La connexion entre les cartes réseau est quant à elle de type InfiniBand.
Il est intéressant de noter que le NVLink est intégré au matériel Nvidia et non exposé à l’extérieur, contrairement aux connecteurs InfiniBand, comme illustré dans le schéma ci-dessous. Notez que le Quantum InfiniBand X800 est un dispositif très puissant, offrant des liaisons à 800 Gbit/s et intégrant la photonique sur silicium, mais il n’a aucun lien avec l’informatique quantique.
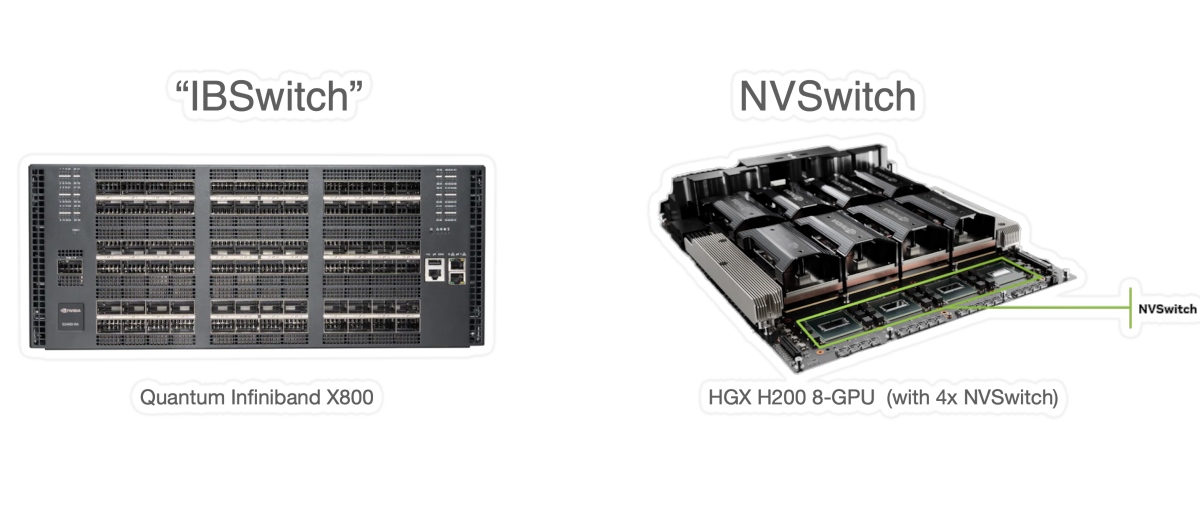
Un dernier point important : Nvidia a introduit NVLink Fusion afin d’ouvrir le standard NVLink. Demain, nous verrons probablement des intégrations personnalisées, nécessitant peut-être toujours une carte de circuit imprimé comme « commutateur » (plutôt qu’un câble), mais avec un SoC, qui pourrait ne pas être un SoC Nvidia. Il convient également de mentionner qu’AMD a répondu au standard de Nvidia en introduisant UALink.
En résumé, RDMA n’est pas si complexe :
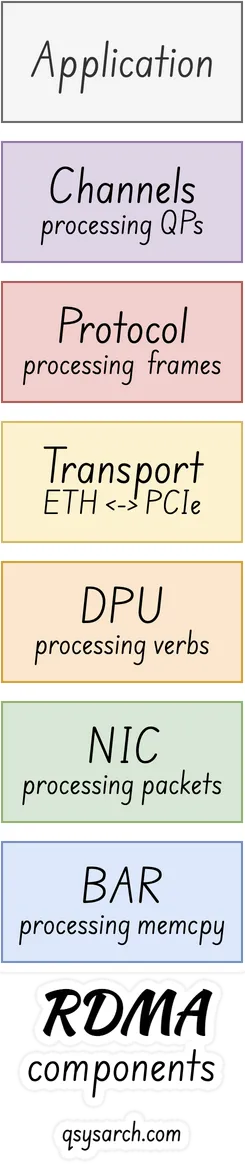
RDMA BAR : en tant que mappage BAR PCIe : Au niveau physique, un périphérique PCIe se connecte au GPU via le même complexe racine PCIe et mappe la BAR mémoire de tous les périphériques.
Carte réseau RDMA : en tant que carte réseau matérielle (NIC) : Cette carte PCIe est généralement une carte réseau, mais ce n’est pas obligatoire. Cependant, il semble n’exister qu’une seule carte réseau sur le marché compatible RDMA.
RMDA DPU : en tant que processeur de verbes matériel : Pour rendre la carte PCIe compatible RDMA, le matériel doit pouvoir traiter les verbes RDMA directement dans le matériel, généralement à l’aide d’un processeur appelé DPU.
Transport RDMA : en tant que couche de transport pour le réseau : le périphérique PCIe est exposé, côté réseau, comme un transport qui peut être Ethernet, Better Ethernet (RoCev2) et Infiniband.
Protocole RDMA : format de trame : Le protocole utilisé pour communiquer sur la liaison réseau est également appelé RDMA. Je n’ai pas examiné les détails du format de trame, mais il est décrit dans la RFC5040.
Canaux RDMA : moyen de communication via QP : Le logiciel/pilote/SDK utilisé sur l’hôte pour communiquer avec le périphérique RDMA est également appelé RDMA, mais est défini comme Queue Paris et Channels.
Voilà. Je crois que je comprends un peu mieux le RDMA maintenant.
Revenons au défi de l’informatique quantique : pourquoi s’intéresser au RDMA ? Eh bien, c’est parce que Nvidia a appelé son commutateur InfinBand « Quantum InfiniBand » !
Pourtant, malgré les performances exceptionnelles de leur dernier processeur Quantum-X800, il n’a rien à voir avec l’informatique quantique. Mais il pourrait peut-être jouer un rôle clé dans l’interconnexion du contrôle quantique au GPU, pour le défi de l’apprentissage par renforcement challenge ?