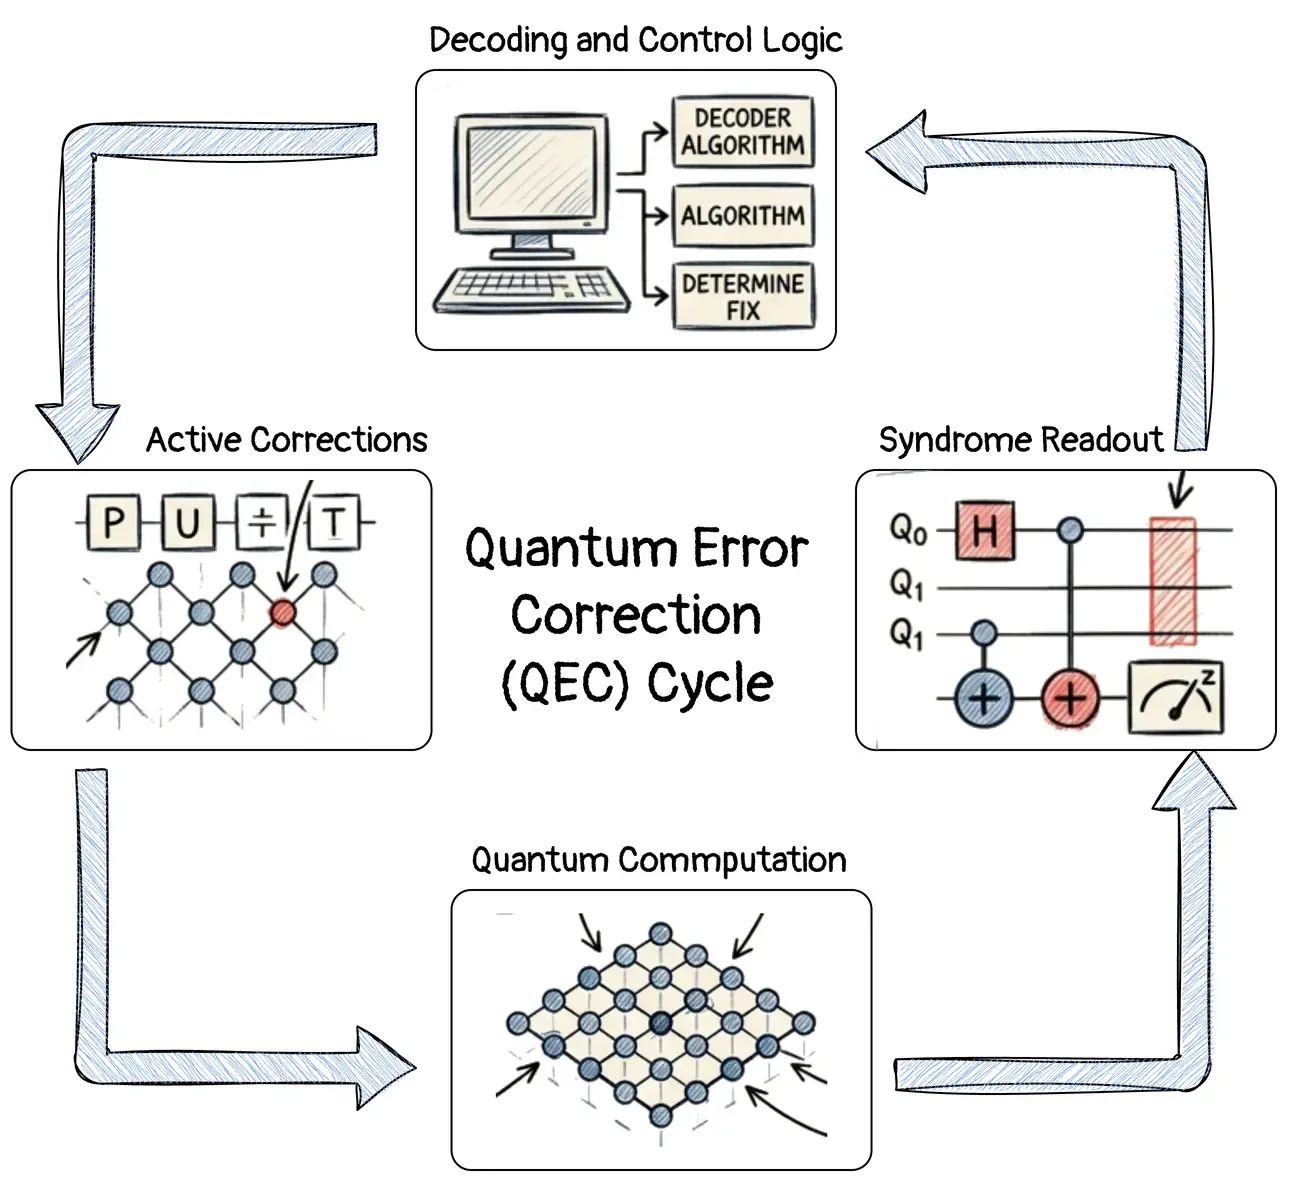
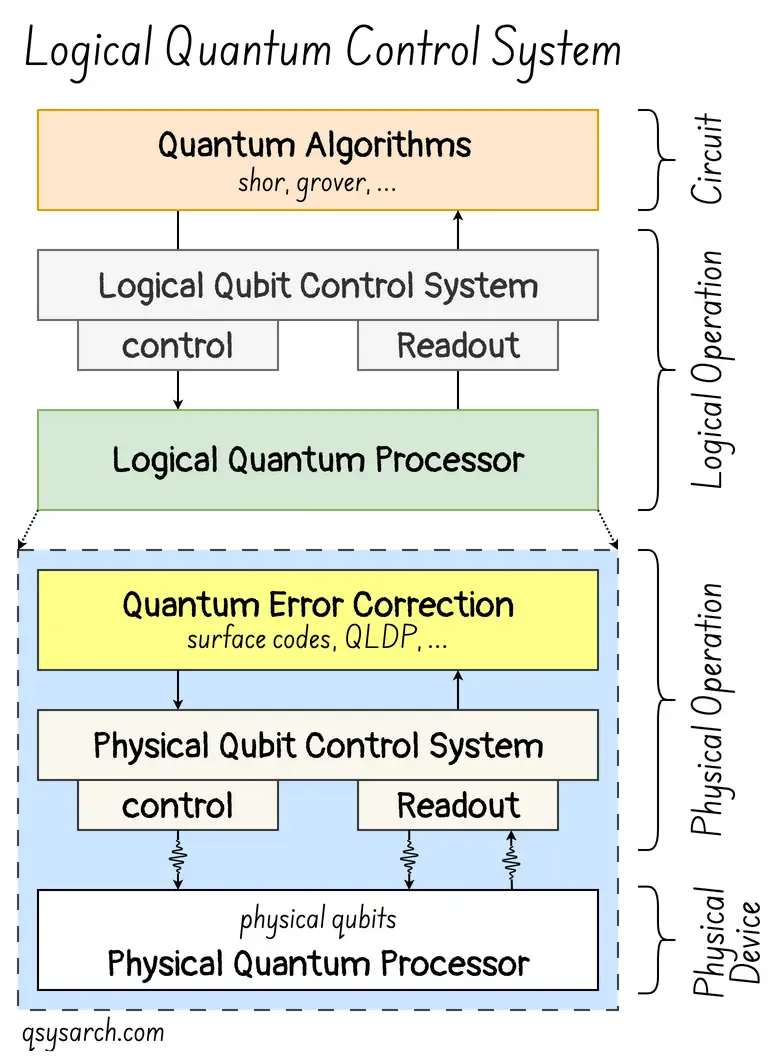
À première vue, la correction d’erreurs quantiques semble simple : regrouper des qubits physiques en un qubit logique, appliquer une méthode pour maintenir la cohérence entre eux, puis faire fonctionner des circuits quantiques à l’aide de ces qubits logiques.
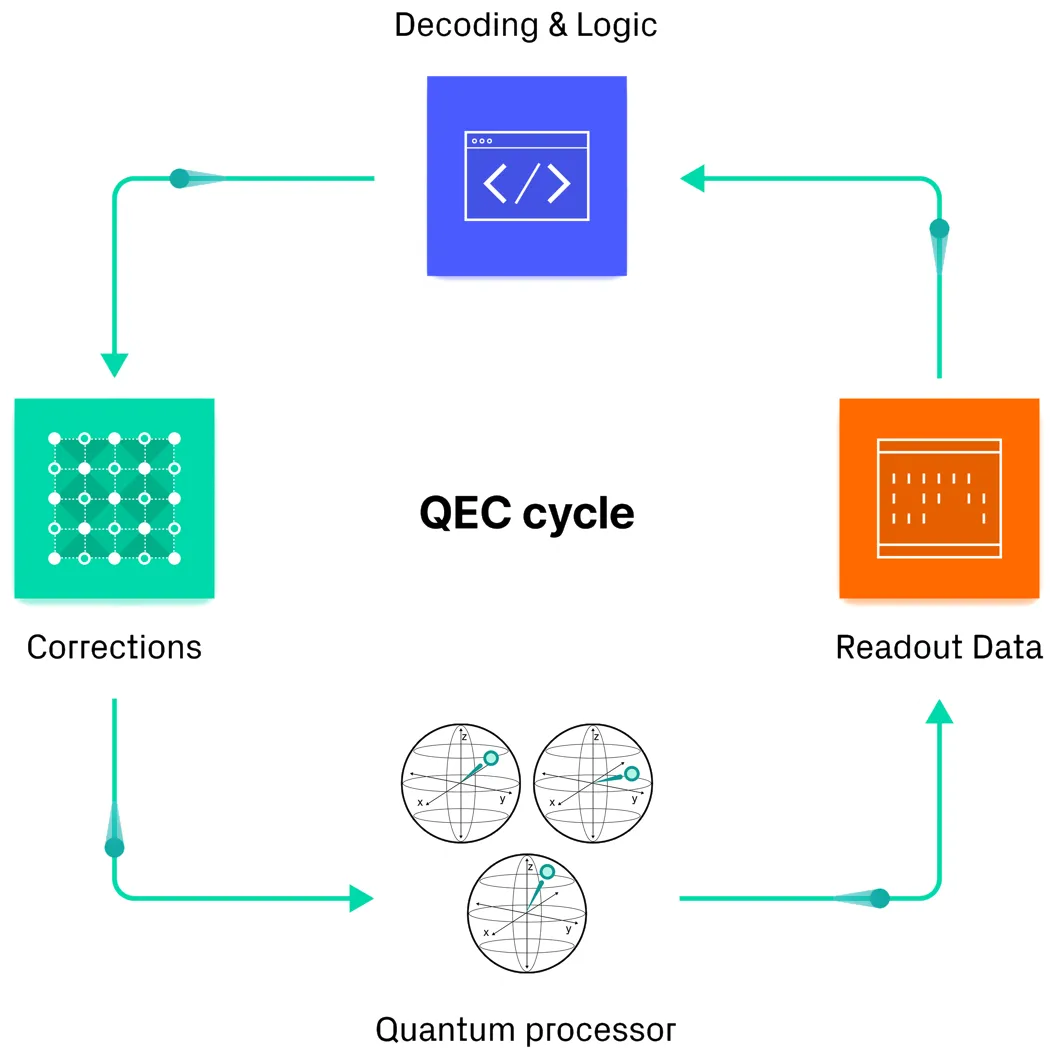 Source de l'image : Riverlane
En pratique, cette première étape est loin d’être évidente. Comment créer et maintenir ces qubits logiques ? Par exemple, du point de vue d’un système de contrôle quantique (SCQ) (comme QM OPX1000 , ZQCS de ZI ou le cluster Qblox Q1 ), comment « faire fonctionner » ou « orchestrer » un qubit logique ? Et une fois ce qubit logique « prêt » à être utilisé, comment l’exploiter pour effectuer des calculs quantiques, via des circuits quantiques composés de portes à 1 et 2 qubits ? Cette question, en apparence simple, concerne non seulement le système de contrôle matériel, mais aussi la pile logicielle, et notamment les compilateurs : avons-nous besoin de plusieurs compilateurs, un pour les qubits physiques et un autre pour les qubits logiques ? Et en matière de passage à l’échelle, comment les compilateurs peuvent-ils gérer la complexité croissante liée à la manipulation de 10 000 qubits physiques dans un environnement hétérogène composé de GPU/QPU hybrides et de SCQ ? Ce sont des questions simples, avec des réponses non triviales !
Ce document est le premier d’une série consacrée à la correction d’erreurs quantiques du point de vue des systèmes de contrôle quantique. Ce premier document concis présente les concepts fondamentaux nécessaires à la « création » d’un qubit logique cohérent au niveau physique.
Formation de qubits logiques Link to heading
Qu’est-ce qui définit un « qubit logique » ? La création de qubits logiques commence par le regroupement de qubits physiques, chacun se voyant attribuer un rôle spécifique. Certains servent de qubits auxiliaires, tandis que d’autres fonctionnent comme qubits de données ou qubits principaux.
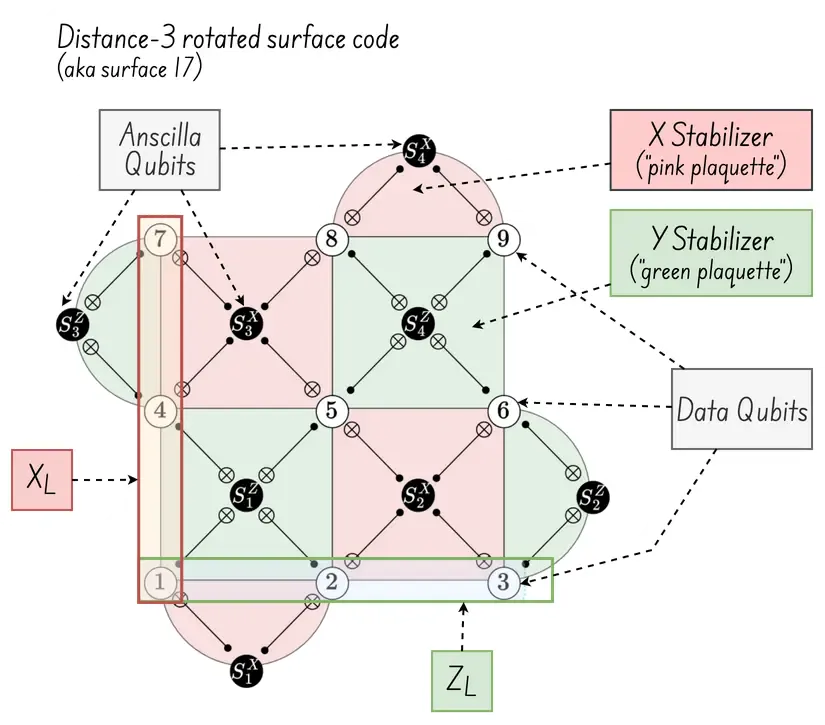
Ce groupement est souvent représenté par le diagramme de droite, qui montre un « code de surface 17 basé sur la distance 3 » (crédit image : Irréversible Inc ).
Voici la structure de base, applicable aux codes de surface :
Les qubits de données (cercles blancs) contiennent l’information quantique. La surface 17 contient 9 qubits de données.
Les qubits auxiliaires (cercles noirs) effectuent des contrôles de parité non destructifs. La surface 17 contient 8 qubits auxiliaires.
QEC en tant que protocole Link to heading
L’interaction entre les données et les qubits auxiliaires est spécifique à chaque « plaquette » :
Les plaquettes (faces vertes et roses) définissent la relation typologique de contrôle d’erreur entre le qubit auxiliaire au milieu et ses qubits de données voisins.
Le stabilisateur : Chaque qubit auxiliaire est utilisé pour mesurer un opérateur de Pauli, ou stabilisateur : Les codes de surface ont deux stabilisateurs : le type Z détecte les erreurs de basculement de bit (X), tandis que le type X détecte les erreurs de basculement de phase (Z).
La mesure du stabilisateur est la mesure d’un seul stabilisateur, mise en œuvre en couplant séquentiellement un qubit auxiliaire aux qubits de données voisins, puis en mesurant l’auxiliaire.
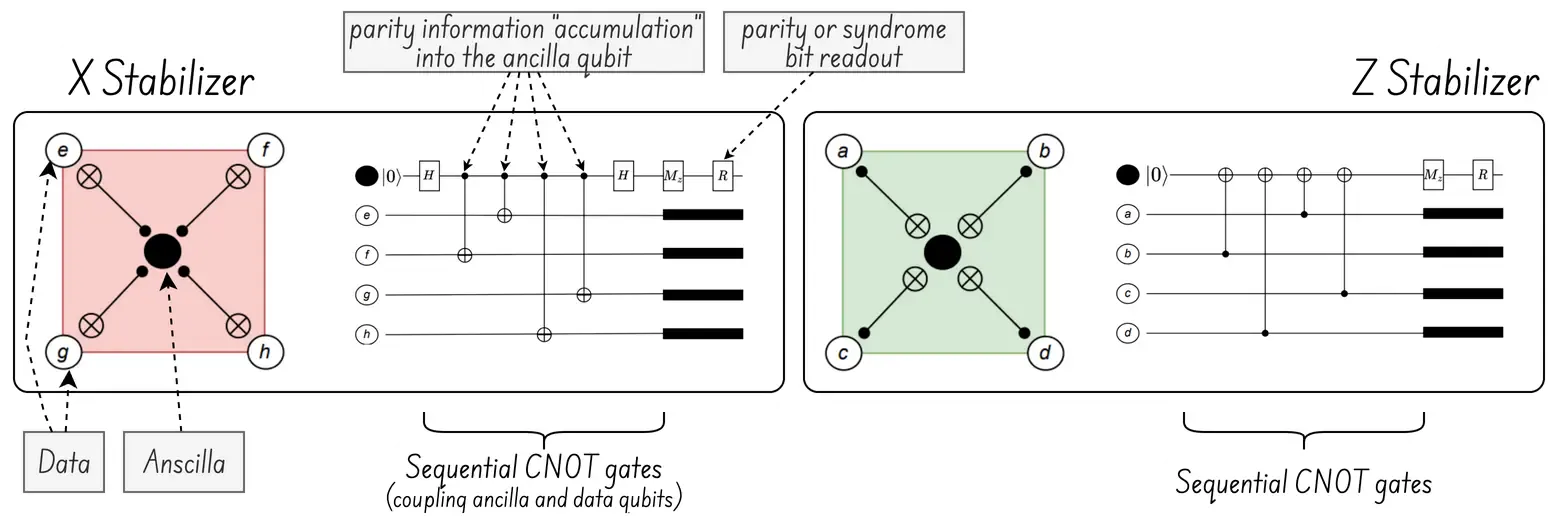
Les bits de syndrome correspondent au résultat de la mesure de l’opérateur de stabilisation de parité. Un bit de syndrome est produit à chaque cycle de mesure.
- L’extraction du syndrome est le processus complet d’exécution de toutes les mesures du stabilisateur dans un cycle de correction d’erreur afin d’obtenir le syndrome d’erreur complet.
Un petit quiz : Qui est le coupable parmi les qubits ? Link to heading
Dans ce contexte, considérons le diagramme ci-dessous (crédit : Laurent Prost d’ Alice & Bob ). Z₁Z₂ et Z₂Z₃ représentent les mesures conjointes de contrôle de parité (stabilisateur) entre le qubit 1 et le qubit 2, et entre le qubit 2 et le qubit 3, respectivement. Contrairement aux plaquettes bidimensionnelles précédentes, ce diagramme suppose que chaque qubit physique est lié à un seul autre qubit, ce qui indique un code de répétition unidimensionnel.
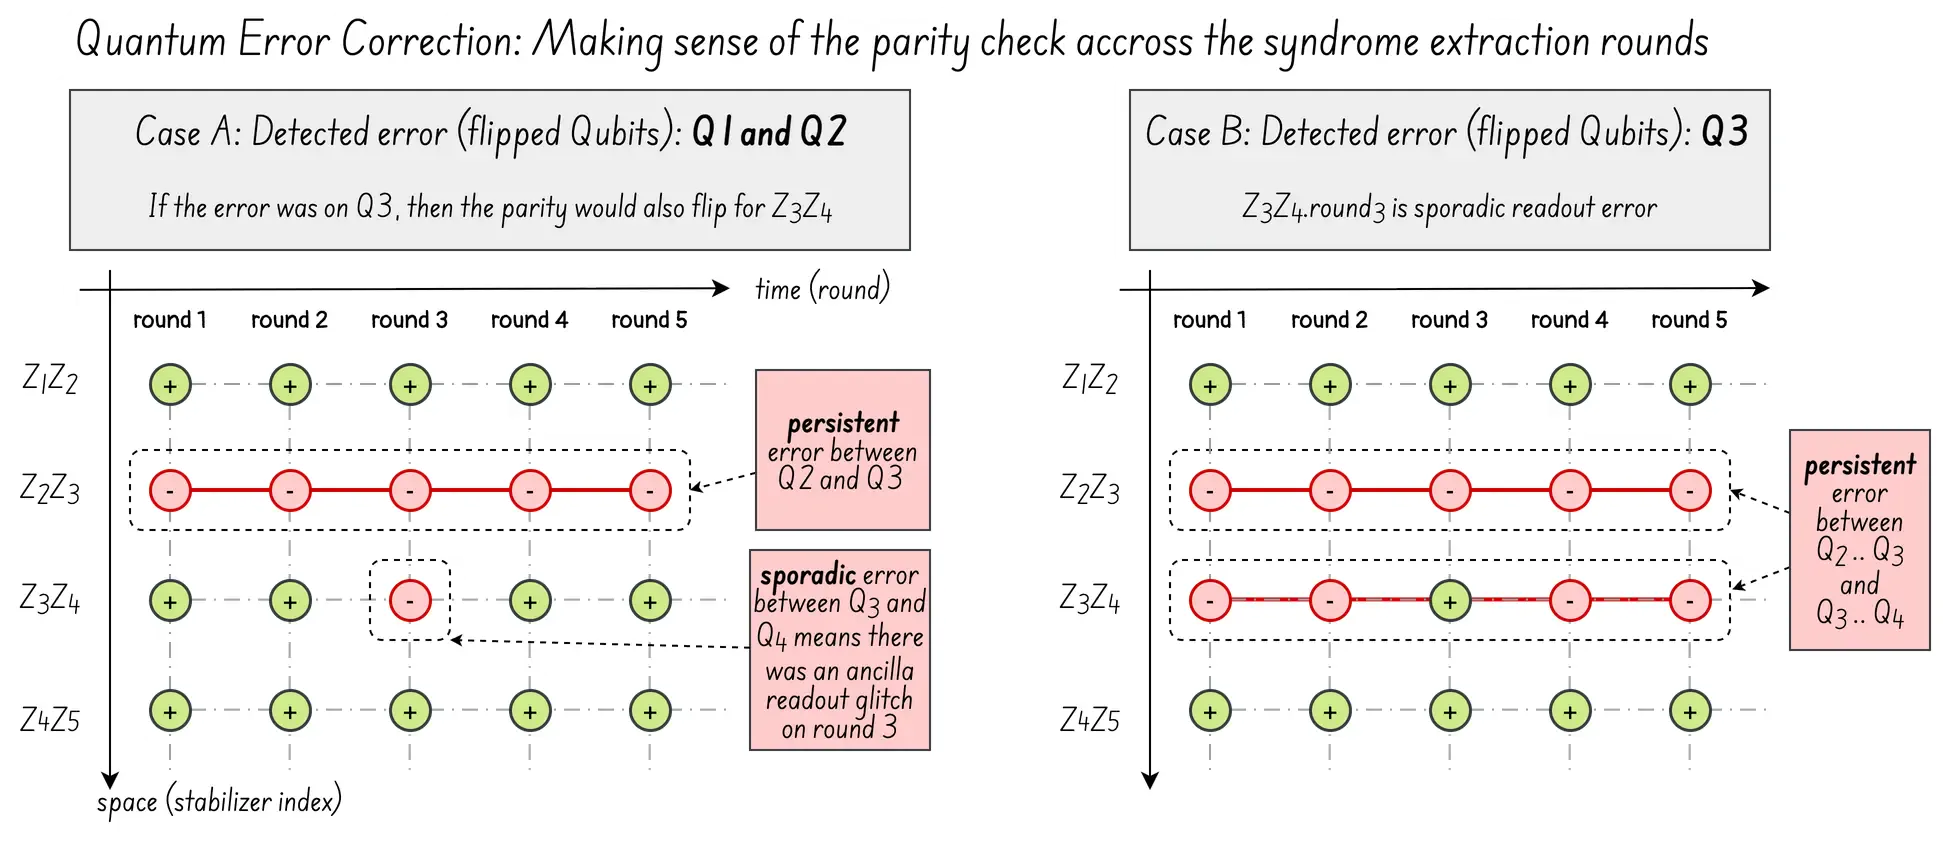
Dans le diagramme de gauche (cas A), l’erreur semble se situer sur le qubit de données 3, mais elle concerne en réalité les qubits de données 1 et 2. La ligne horizontale rouge indique que l’erreur se produit uniquement dans Z₂Z₃ . Si l’erreur se situait sur le qubit 3 , Z₃Z₄ serait également inversé. Par conséquent, Z₁Z₂ représente une erreur byzantine , ce qui signifie que Q₁ et Q₂ sont tous deux inversés. Le diagramme de droite (cas B) illustre le résultat attendu si l’erreur se situait sur le qubit 3.
Dans les coulisses : La « magie » du QEC Link to heading
Cette deuxième section est un peu plus dense, mais elle est essentielle à la compréhension des notes suivantes concernant l’orchestration des qubits physiques au sein d’un groupe logique. J’ai essayé de la rendre aussi accessible que possible, sans entrer dans les détails mathématiques complexes que mes collègues du département de QEC seraient bien plus à même d’expliquer !
Murs de domaine et erreurs dégénérées Link to heading
L’erreur biszantine Q1 + Q2 est en réalité un problème courant appelé erreur dégénérée. Plus précisément, elle désigne une situation où deux erreurs physiquement distinctes ou plus produisent exactement le même bit de syndrome, rendant ainsi impossible la distinction entre les erreurs.
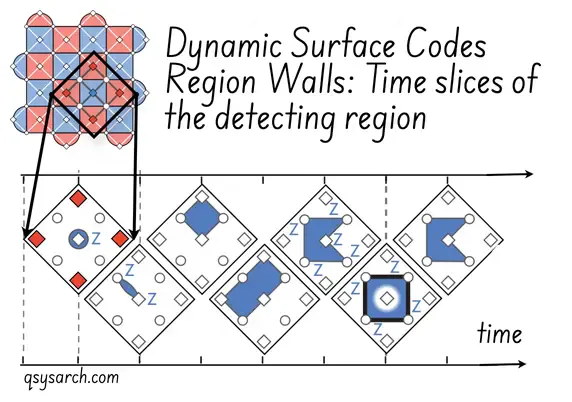 Cependant, cela ne pose pas de problème en correction d’erreurs quantiques : les stabilisateurs ne servent pas à détecter directement les erreurs. Ils sont plutôt utilisés pour identifier les frontières physiques des qubits (aussi appelées murs de domaine) où un syndrome d’erreur se manifeste. Ensuite, en augmentant la redondance pour chevaucher ces frontières, on peut identifier précisément les erreurs individuelles (ou bien utiliser le code de surface dynamique temporel de Google AI , comme illustré dans le schéma de droite).
Concevoir cette redondance dans les systèmes quantiques est fondamentalement complexe et exige de solides connaissances en mathématiques. Pour comprendre le concept général, il faut revenir aux fondamentaux : comment fonctionne concrètement le contrôle de parité ?
Comment fonctionne réellement le contrôle de parité ? Link to heading
De prime abord, le fonctionnement du contrôle de parité peut sembler obscur, car le calcul de la parité nécessite la connaissance du bit de syndrome attendu, qui dépend de l’état du qubit de données. Or, connaître à l’avance l’état du qubit de données irait à l’encontre du principe même du calcul quantique. Autrement dit :
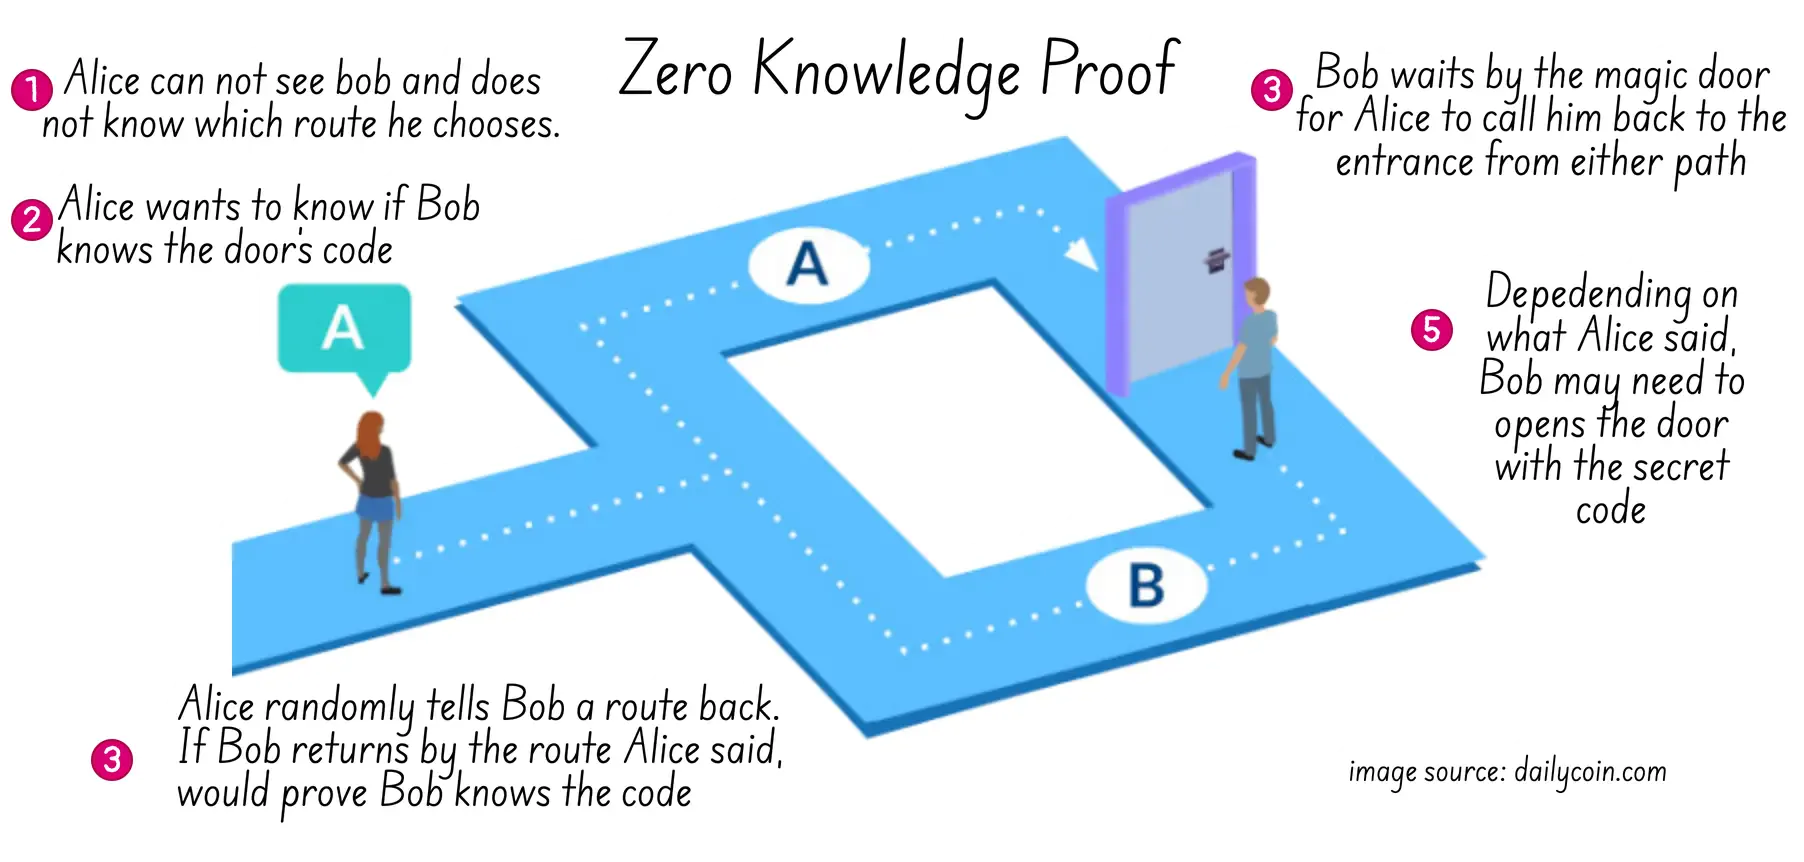 Pour relever ce défi, la clé consiste à se référer à la même astuce que celle utilisée pour la preuve « à divulgation nulle de connaissance » employée dans l’expérience de la grotte d’Alibaba : il suffit de poser des questions spécifiques dont les réponses sont connues, quelle que soit l’information quantique encodée (crédits image : dailycoin )
Ces questions spécifiques correspondent aux opérateurs de stabilisation de Pauli. Le bit de syndrome, ou résultat de la mesure, peut être interprété comme un chemin A ou B. En correction d’erreurs quantiques (QEC), le chemin A représente l’état valide, tandis que le chemin B indique une erreur. Le « moteur » de la QEC doit construire le circuit quantique qui opère sur le qubit logique de manière à préserver cette contrainte, également appelée « état protégé ».
Encodage des états protégés Link to heading
C’est là que l’ingénierie devient cruciale. Pour garantir que la mesure du syndrome renvoie toujours le chemin A en l’absence d’erreur, et le chemin B dans le cas contraire, les informations de parité multiqubit doivent être encodées de manière à ce que les relations entre les qubits soient fixes pour chaque état encodé valide.
C’est la fonction du circuit d’encodage. Son but est de transformer un état d’entrée simple et non corrompu (tel qu’un seul qubit physique \(|ψ> = α|0> + β|1>\) avec des ancillas vides \(|00...0>\) en un état de qubit logique hautement intriqué \(|ψ_L>\) protégé par une correction d’erreurs quantiques.
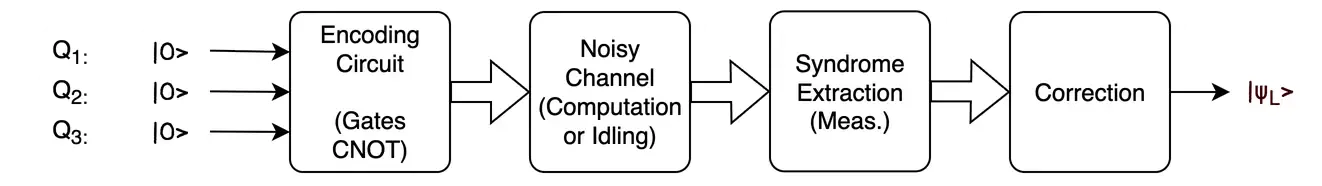
Je détaillerai le circuit d’encodage dans une note ultérieure. Pour l’heure, on peut le considérer comme un circuit quantique spécialisé, conçu spécifiquement pour initialiser le qubit logique dans l’état protégé.
Code de distance Link to heading
Pour corriger les erreurs dégénérées (c’est-à-dire les syndromes « byzantins » Q₁ + Q₂ ), il est possible d’accroître la redondance en augmentant ce qu’on appelle la distance de code \( d \). En résumé, on pourrait dire que la distance de code \( d \) détermine la robustesse de la protection contre les erreurs.
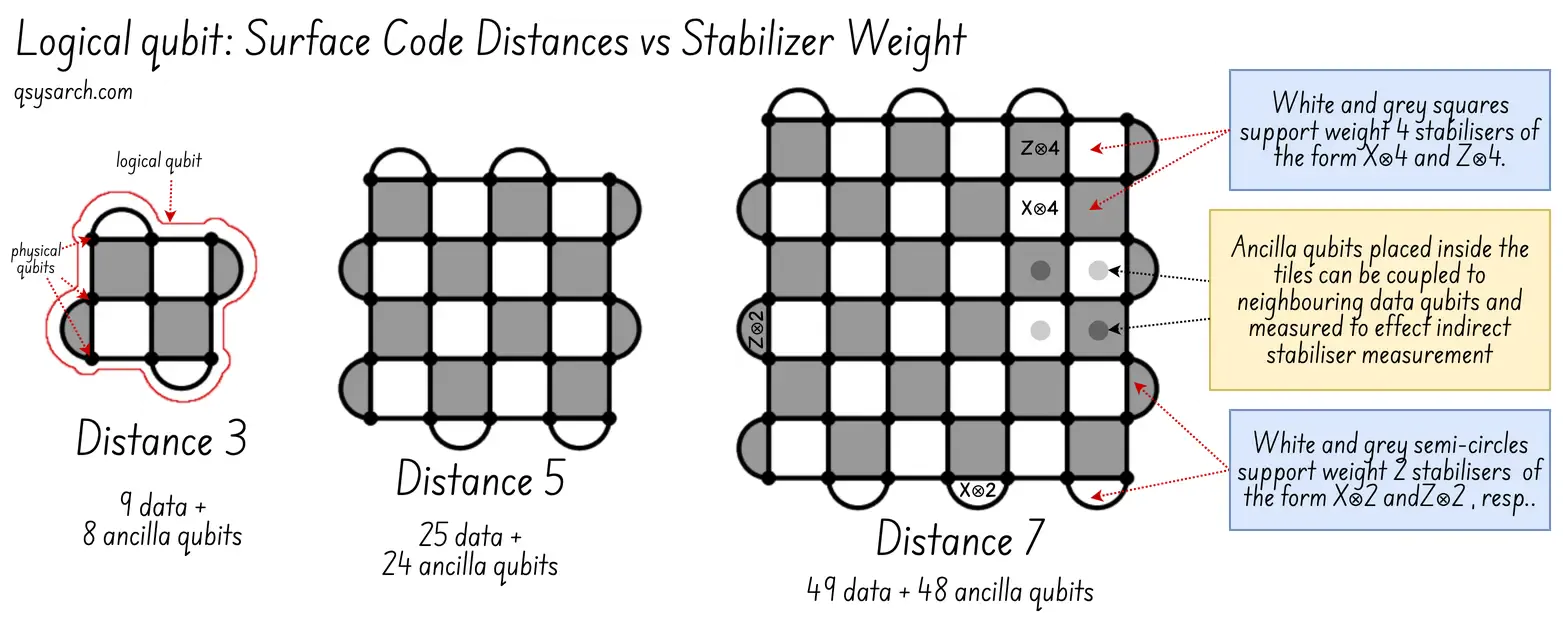
Si la distance de code est de \( d=3 \), l’inversion de deux qubits adjacents détruit l’information, et le QEC ne parvient pas à corriger le qubit logique, c’est-à-dire à le maintenir dans l’état protégé. Avec une distance de code plus grande, par exemple \( d =5 \), le décodeur QEC peut garantir que même si Q1 et Q2 s’inversent et se masquent mutuellement lors du contrôle Z1Z2 , la mesure du stabilisateur d’augmentation fournira au décodeur suffisamment de contexte pour identifier Q1 et Q2 comme une double panne. Mathématiquement, cela s’écrit :
Le théorème du seuil Link to heading
Si la redondance résout le problème, pourquoi ne pas utiliser un code de surface de plus grande dimension ? Le problème est que, pour chaque qubit physique supplémentaire (afin d’accroître la redondance), il faut mesurer davantage de stabilisateurs. Or, plus de mesures signifient plus de risques d’erreurs physiques.
Ce qui conduit au théorème dit du seuil .
En termes simples, le théorème du seuil signifie que tant que le taux d’erreur des qubits physiques \(p\) est inférieur à un seuil \(p_{th}\), il est possible d’ajouter plus de qubits physiques pour améliorer la correction d’erreur, et que le nombre de qubits supplémentaires est en complexité \(N.log(N)\).
Pourquoi est-ce important ? Parce que cela signifie que même si les qubits « ne se comportent pas correctement » en permanence, pourvu que cela ne se produise pas trop souvent, il est possible d’obtenir qu’un plus grand ensemble de qubits se comporte mieux que la somme des qubits individuels, ouvrant ainsi la voie à l’ère post-NISQ, c’est-à-dire l’ère du FTQC, ou informatique quantique tolérante aux pannes.
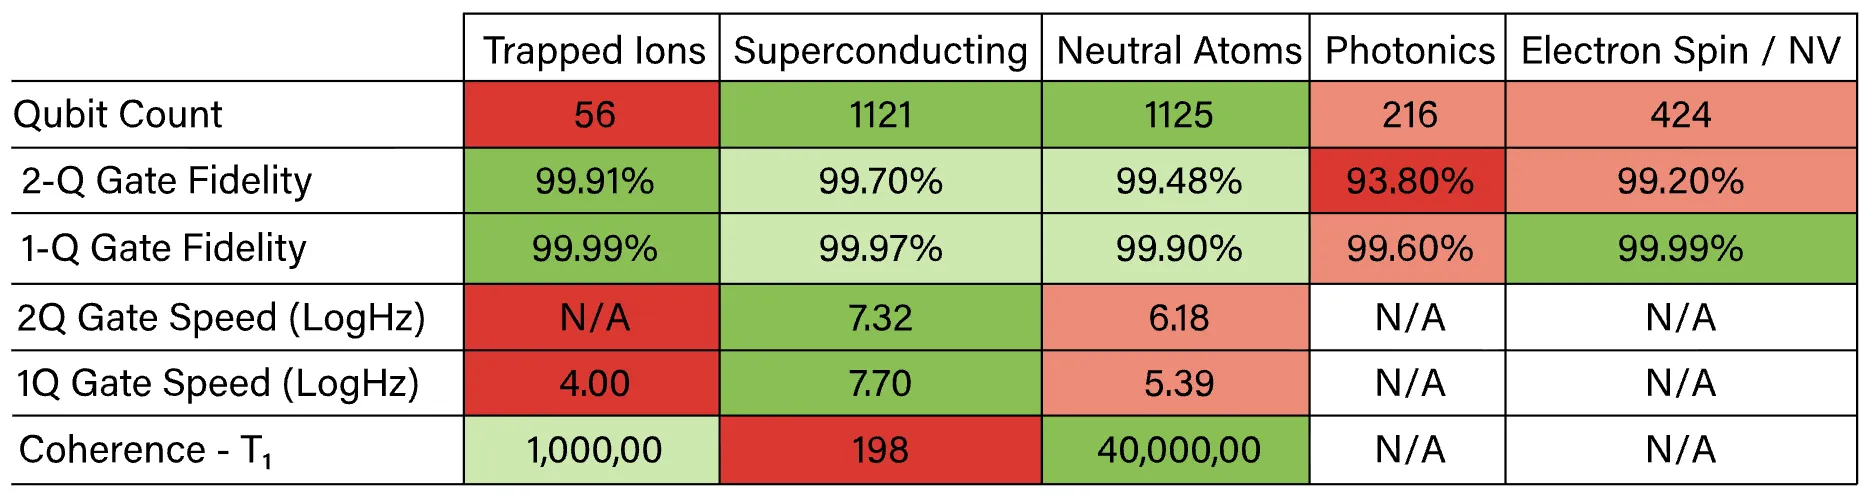
Bien entendu, la question essentielle ici est de savoir quelle est cette valeur de seuil \ (p _ {th} ). Elle se situe entre 0,1 % et 1 %, et bien que cela puisse paraître faible, ce n’est pas un problème puisque les qubits modernes peuvent déjà atteindre une fidélité de 99,9 % (pour les portes à un qubit).
Conclusion Link to heading
Voilà, cette brève note de service pose les bases des concepts utilisés dans la correction d’erreurs quantiques.
Les deux notes suivantes seront plus pratiques. La seconde analysera concrètement ce que signifie, pour le système de contrôle quantique (et le décodeur d’erreurs), la conversion d’un qubit physique en qubit logique, en termes de contrôle, de lecture et de séquencement. La troisième note portera sur le système de décodage, ainsi que sur la faible latence et la liaison en temps réel entre le décodeur et le système de contrôle.
Ce mémo est en réalité le premier d’une série. Les prochains mémos du QEC porteront sur les sujets suivants :
Orchestrer l’extraction du syndrome du point de vue du système de contrôle quantique
Décodage d’erreurs en temps réel : ASIC, GPU et réseaux neuronaux à latence ultra-faible.
Qubits intelligents co-conçus : le cas des qubits protégés contre les erreurs d’Alice et Bob
Compilateurs de code de surface à grande échelle : maximiser la tolérance aux pannes pour des milliards d’opérations physiques
Architectures de décodage hiérarchiques : principe de localité et traitement multi-couches
Orchestration logique des qubits : chirurgie et tressage de réseaux
Au-delà des codes de surface : le passage aux codes qLDPC
Distillation à l’état magique et rotations analogiques
Il semblerait que cela va m’occuper pendant les 6 prochains mois !
References:
- Real-time Surface-Code Error Correction Using an FPGA-based Neural-Network Decoder
- Real-Time Quantum Error Correction System Stack: Architecture, Algorithms, and Engineering Practice
- Reinforcement learning control of quantum error correction
- Riverlane Deltaflow: The Quantum Error Correction Stack
- Quantum Machine: QEC decoding
- How IQM is tackling quantum error correction
- Q-CTRL: Towards practical Quantum Error Correction
- Building logical qubits in a superconducting quantum computing system
- The Quantum Leap That Needs Error Correction
- Error budgeting for quantum error correction
- How Space and Time Could Be a Quantum Error-Correcting Code
- Quantum error correction in the presence of biased noise
- What Makes a “Logical Qubit” Actually Logical?
- Hybrid Multiplexing with Dynamic Qubit Grouping for Low-cost and Scalable Quantum Wiring
- Defining the Logical Qubit: Five Criteria to Benchmark Logical Qubit Claims
- Real-Time Decoding for Fault-Tolerant Quantum Computing: Progress, Challenges and Outlook
- Why do quantum computers need QEC?
- To reset, or not to reset—that is the question
- A memristive neural decoder for cryogenic fault-tolerant quantum error correction
- Decoupling AI for Quantum Control and Calibration
- A high performance compiler for very large surface code computations
- All about quantum error correction: distillation, mitigation, self-correction and beyond
- StreamingQEC: Streaming Quantum Error Correction in Tightly Integrated Quantum-Classical Systems via Certified Recurrence
- A real-time, scalable, fast and highly resource efficient decoder for a quantum computer
- Constraint-Optimal Driven Allocation for Scalable QEC Decoder Scheduling
- Comparison of spin-qubit architectures for quantum error-correcting codes
DrawIO diagrams used in this memo: