Je suis extrêmement heureux de faire partie de l’équipe de Qblox qui a travaillé et travaille toujours activement avec Nvidia pour promouvoir la norme NVQLink, comme moyen d’interconnecter des systèmes hétérogènes calculés sur des GPU, des CPU et des QPU (processeurs quantiques, y compris les contrôleurs quantiques initiaux que Qblox développe).
NVQLink n’est pas un simple « câble » de plus pour connecter les GPU aux processeurs quantiques, mais plutôt un cadre complet permettant d’interconnecter des dispositifs hétérogènes, du réseau à la pile logicielle :
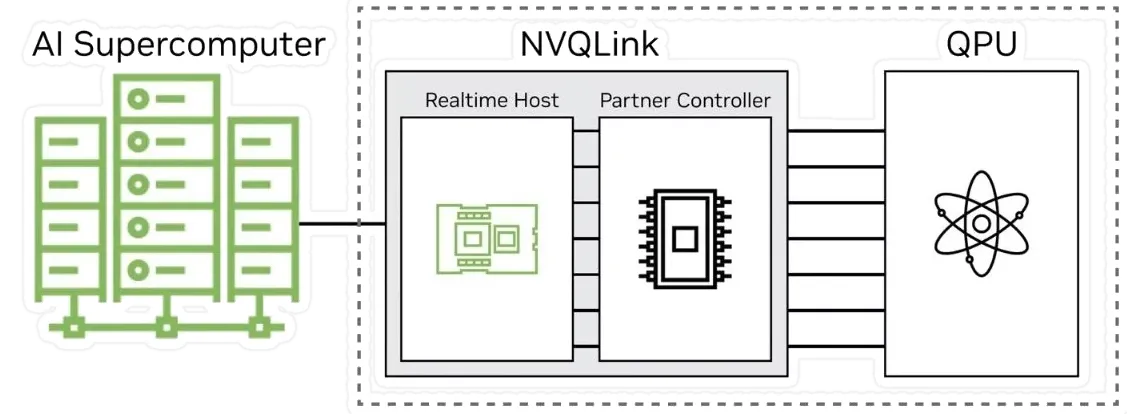 Crédit image : Nannod
Les principales spécifications « matérielles » mettent l’accent sur les performances des ressources réseau et informatiques :
Débit réseau : jusqu’à 400 Gb/s du GPU au QPU.
Latence réseau : latence aller-retour (FPGA → GPU → FPGA) inférieure à 4,0 microsecondes.
Matériel GPU : Hôte temps réel basé sur les superpuces NVIDIA GB200 Grace Blackwell, avec un grand nombre de TFLOPS.
Pourquoi NVQLink est nécessaire
Link to heading
Vous vous demandez peut-être : « Pourquoi est-ce important ? »
Il crée une norme ouverte pour intégrer étroitement le matériel quantique au calcul accéléré par GPU.
Il permet des flux de travail hybrides : étalonnage de réseaux neuronaux, correction d’erreurs quantiques (QEC), etc.
Elle fournit une plateforme ouverte qui intègre le logiciel et le matériel comme un seul, permettant à quiconque d’interagir avec les ordinateurs quantiques, sans avoir à se noyer dans un océan de connaissances, grâce à Cuda-Q.
Spécifications NVQLink : Conception architecturale
Link to heading
Le livre blanc de NVQLink est désormais disponible à l’adresse https://arxiv.org/abs/2510.25213. Examinons donc en détail l’architecture proposée :
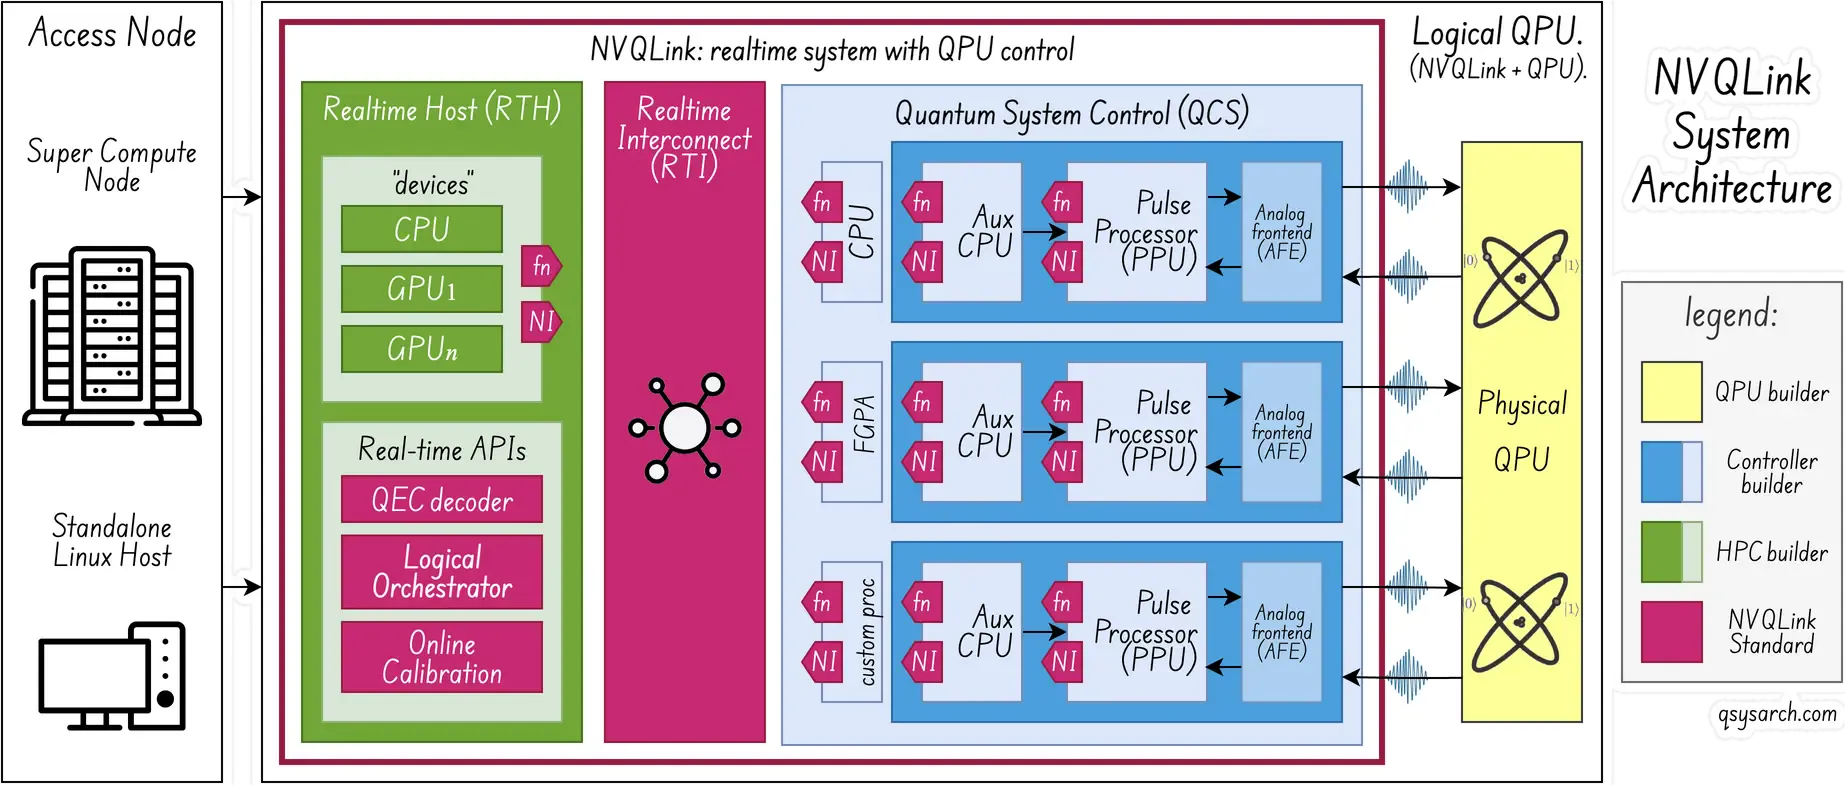 (Schéma système adapté de l’image originale du livre blanc)
Comme prévu, les détails correspondent à la présentation générale de Nannod. Du point de vue des composants, l’architecture NVQLink comprend l’hôte temps réel (RTH) et le système de contrôle QPU (QSC). Ces deux composants sont interconnectés par une interconnexion temps réel (RTI) évolutive et à faible latence. Le RTH dispose de ressources de calcul HPC classiques, telles que des CPU et des GPU. Quant au QSC, il inclut généralement les unités de traitement d’impulsions (PPU) qui contrôlent le QPU.
Ce diagramme introduit deux mots-clés importants : fn et NI. Dans le modèle mental NVQLink (« modèle de programmation »), chaque CPU, GPU, PPU (ou autre circuit intégré spécialisé/FPGA) est appelé « périphérique », et NVQLink permet d’effectuer des appels de procédure à distance (« callbacks » ou fn) vers n’importe lequel de ces périphériques. Il s’agit d’une solution très performante, où NVQLink assure l’interopérabilité du système hétérogène. L’implémentation concrète de l’environnement d’exécution fn est hautement optimisée, au point que le marshalling est même pris en charge. De cette manière, on peut garantir des latences de quelques microsecondes. Quant à NI, il signifie « Interface réseau » et désigne une carte/interface/câble réseau « petite » et optionnelle que tous les acteurs peuvent utiliser pour créer un système unifié et interconnecté.
NVQLink introduit également le concept très important de domaines temporels : ceci est nécessaire car toutes les « unités de traitement » impliquées dans le système ne sont pas censées suivre la « même horloge ».
Il existe 4 catégories d’horloges, ou domaines temporels, de la plus rapide à la plus lente :

Domaine temporel physique (PTD) : Généralement l’horloge du QPU.
Domaine temporel déterministe (DTD) : Généralement l’horloge QSC/FPGA, capable de fonctionner avec des échelles de temps cohérentes quantiques.
Domaine temps réel (RTD) : généralement exécuté sur un CPU ou un GPU classique. Peut se situer dans le temps de cohérence quantique, ou entre deux expériences de cohérence quantique.
Domaine temporel de l’application (ATD) : généralement l’ordinateur portable sur lequel Jupyter Notebook est exécuté !
Sans surprise, NVQLink utilise RDMA et GPUDirect pour éviter tout traitement CPU inutile et garantir une latence optimale. Comme indiqué dans la spécification : « Grâce à ces deux technologies, seuls la carte réseau et le GPU interviennent lors du traitement des paquets en provenance et à destination du QSC, sans aucune intervention de l’hôte. »
La spécification recommande également d’utiliser le mode RDMA « Connexion non fiable », car le coût en latence à payer pour les RC (Connexions fiables) peut être excessif par rapport à un réseau correctement conçu.
La spécification fournit une preuve de concept pour l’architecture réseau, permettant de vérifier la latence potentiellement atteignable. Le module Holoscan Sensor Bridge est utilisé ; il assure la transmission de données entre un FPGA et une carte réseau via le protocole RDMA over Converged Ethernet (RoCE), et gère les étapes d’énumération et les signaux de contrôle. Grâce à cette architecture, la spécification démontre qu’il est possible d’atteindre une latence aller-retour inférieure à 4 microsecondes pour une charge utile RDMA de 32 octets, équivalente à une trame Ethernet de 92 octets.
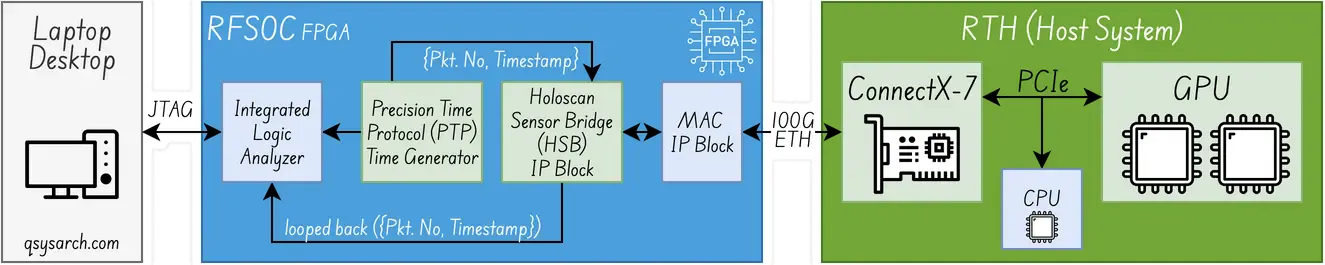 (diagramme adapté de l’image originale picture du livre blanc)
Architecture de compilation (alias modèle de programmation CudaQ+NVQLink)
Link to heading
NVQLink distingue les modalités lentes et rapides, et j’examinerai plus particulièrement l’impact de l’architecture des modalités rapides dans cette section (appelée « sensibilité à la haute latence »). La principale différence avec les modalités lentes réside dans le fait que cette architecture permet la compilation à la volée (JIT) ainsi qu’une éventuelle médiation RTH pendant l’exécution.
Pour que CudaQ + NVQLink fonctionne avec les modes rapides, la spécification stipule que les programmes ISA complets doivent être chargés à l’avance sur les FPGA et exécutés de manière atomique, avec une communication interactive minimale avec l’hôte temps réel pendant l’exécution. La compilation à la volée (JIT) est une technologie vraiment intéressante, il est donc dommage qu’elle ne puisse pas être utilisée pour les modes rapides. Cependant, la spécification indique clairement que les FPGA sont autorisés à recevoir des mises à jour dynamiques de l’hôte temps réel (via une file d’attente d’instructions), à condition que cette file d’attente reste non vide jusqu’à la fin du programme. Cela ressemble à une planification « juste à temps ».
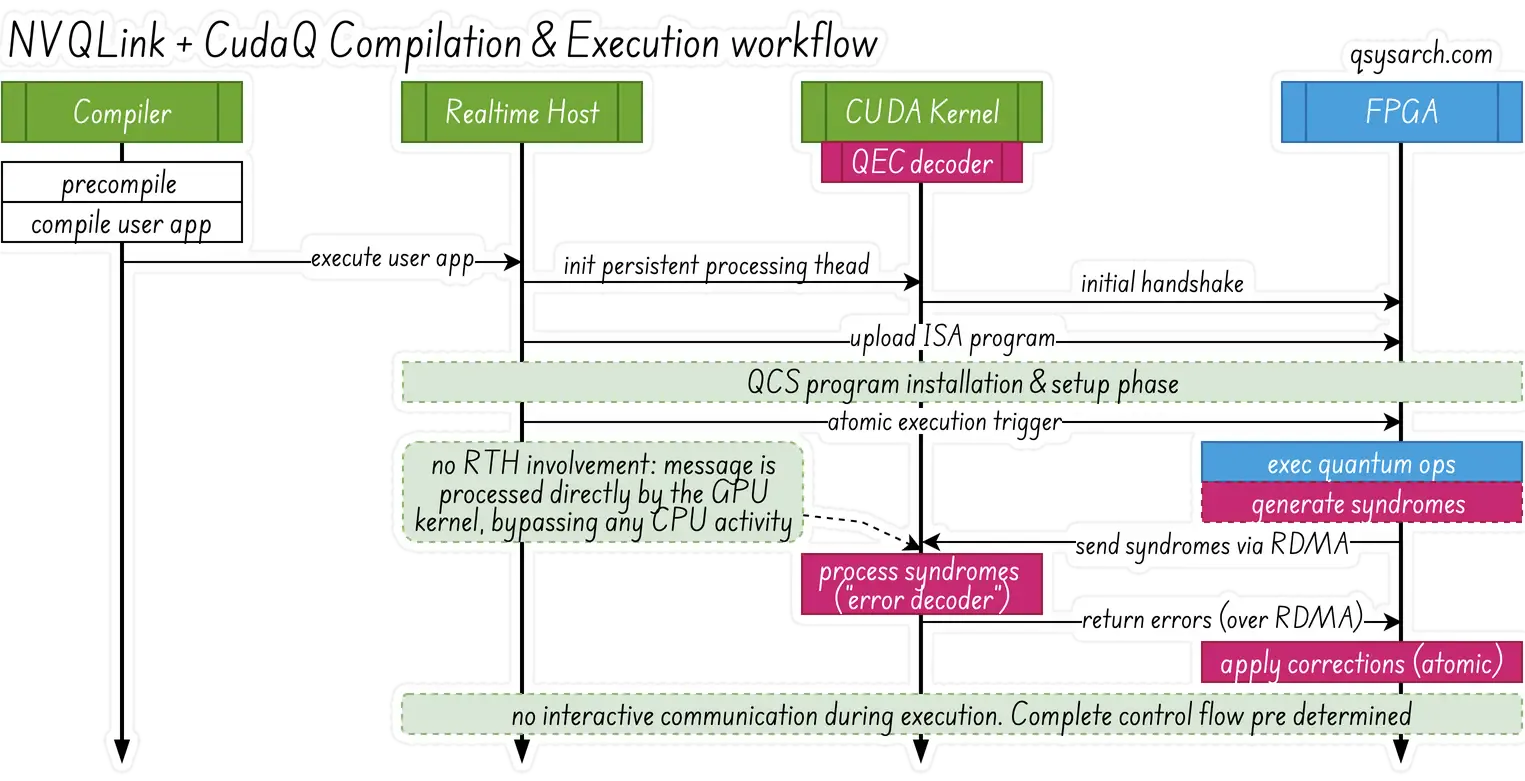
Sans surprise, la spécification indique clairement que la compilation doit effectuer des optimisations a priori poussées ; c’est d’ailleurs une pratique courante chez tous les fournisseurs de piles de contrôle quantiques. Il est également précisé que si une fonction de rappel doit être exécutée sur le GPU, le noyau CUDA du GPU doit être préinitialisé et en attente d’événements ; rien d’exceptionnel, il s’agit du flux de travail standard DOCA GPUNetIO.
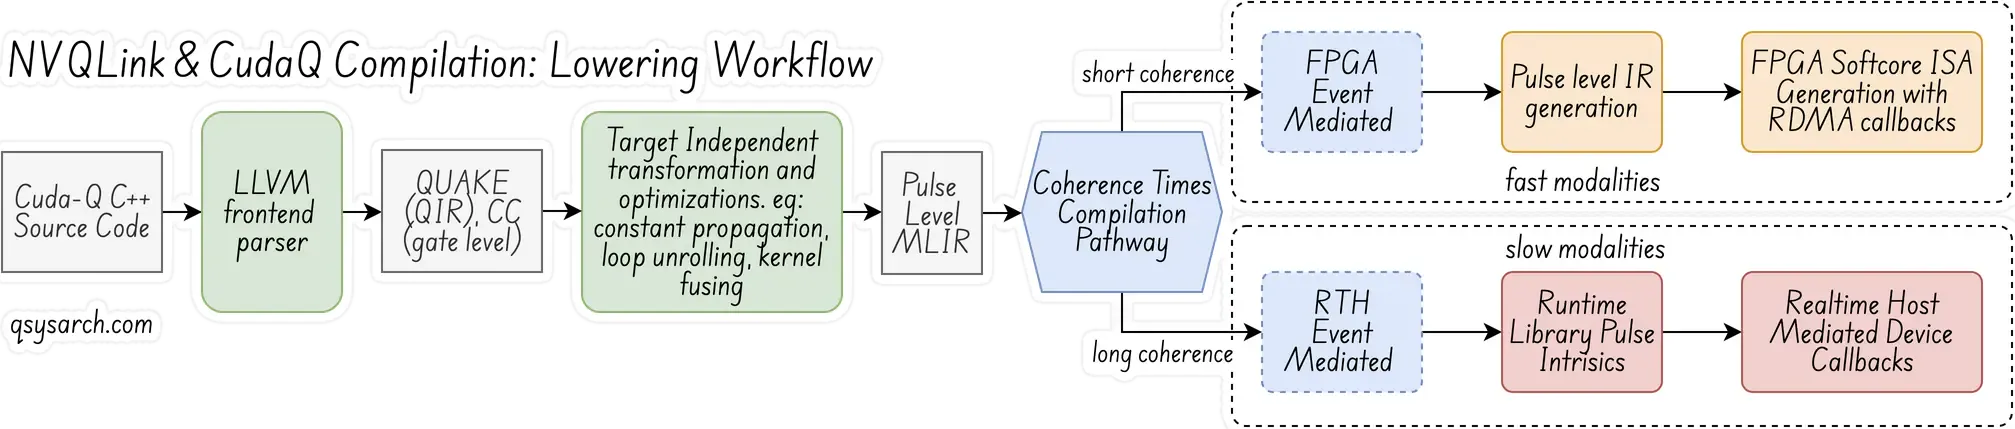
Le processus de compilation et d’abaissement CUDA=Q vers l’architecture NVQLink repose sur l’architecture LLVM MLIR standard (voir schéma ci-dessus). La première étape consiste à analyser les noyaux CUDA et à générer les IR quantiques (également appelées QIR ou QUAKE) et les IR intermédiaires CC (calcul classique), abstraites au niveau des portes logiques. Une phase ultérieure introduit l’optimisation et la fusion des noyaux nécessaires, produisant un dialecte au niveau des impulsions. Enfin, selon le type de modalité, la phase d’abaissement suivante utilise la médiation RTH ou FPGA.
Le « noyau quantique » est identifié par le préfixe __qpu__.
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
cudaq::qubit q;
h(q); // Operate an H gate on qubit q
auto readout = mz(q); // Read the Z axis of qubit q
return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
Lors de la phase de compilation, il est d’abord converti (« abaissé ») en un mélange de représentations intermédiaires (RI) QUAKE (dialecte quantique) et CC (dialecte de calcul classique), ou dialectes :
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
%0 = quake.null_wire
%1 = quake.h %0 : (!quake.wire) -> !quake.wire
%measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
%2 = quake.discriminate %measOut : (!quake.measure) -> i1
%3 = cc.cast unsigned %2 : (i1) -> i32
%4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
return %4 : i32
}
Architecture d’exécution : métaprogrammation avec traits
Link to heading
Conformément au concept de copie nulle profondément ancré dans RDMA, l’environnement d’exécution NVQLINK favorise également des performances élevées et une abstraction sans surcharge, obtenues grâce à deux concepts clés essentiels :
Composition basée sur les traits : Il s’agit d’un moyen, au moment de la compilation, d’exprimer le comportement de n’importe quel périphérique, et NVQLink propose un ensemble de traits standard.
Polymorphisme statique : Il s’agit d’un moyen, au moment de la compilation, pour le compilateur d’instancier la méthode appropriée sans avoir besoin d’une indirection par table virtuelle.
Il existe 4 caractéristiques essentielles :
explicit_data_marshalling_trait : permet d’allouer et de transférer des données à travers le système.
device_callback_trait : permet d’invoquer des fonctions de périphérique (« RPC »)
quantum_control_trait : signifie télécharger et démarrer un programme sur le QCS
rdma_trait : permet d’initialiser efficacement une structure à partir d’une mémoire tampon brute.
En pratique, ces caractéristiques exploitent le langage C++ à un niveau extrêmement avancé. C’est le cas, par exemple, de la caractéristique de sérialisation des données.
template <typename Derived> class explicit_data_marshaling_trait {
public:
void *resolve_pointer(device_ptr &devPtr);
device_ptr malloc(size_t size) const;

template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

void free(device_ptr &d);

template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
void free(Ptrs &&...d) { (free(d), ...);
}
void send(device_ptr &dest, const void *src);
void recv(void *dest, const device_ptr &src);
};
Cette syntaxe recèle de nombreux aspects à explorer et est, à mon avis, encore plus puissante que la syntaxe Rust (par exemple, cow). Également connue sous le nom de métaprogrammation, elle désigne, dans le contexte de NVQLINQ, le polymorphisme statique (ou à la compilation). Examinons la ligne template <typename… Sizes, enable_if_t<(conjunction_v<is_integral …>),int> = 0> plus de détails :
est_intégral<Sizes> as α: true si Sizes est un type entier ie int,float,bool, etc…
conjunction_v<α...> as β: true si toutes les valeurs de α... sont vraies
enable_if_t<(β),int> as δ: a group 2 conditionnel qui devrait échouer si β était faux.
modèle<typename... Sizes, δ = 0> : Une construction SFINAE qui empêche δ d’échouer.
Grâce à cette syntaxe, il devient possible d’effectuer une allocation mémoire spécialisée de plusieurs blocs simultanément :
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
Vous vous demandez peut-être pourquoi c’est important. C’est tout simplement parce que cela permet une spécialisation optimale à la compilation. Dans ce cas, l’implémentation de malloc peut regrouper les tampons mémoire de manière contiguë, ce qui la rend adaptée aux échanges RDMA et au marshalling atomique de plusieurs données. Plutôt pratique, non ?
Architecture d’exécution : noyaux
Link to heading
NVQLink fournit un ensemble d’interfaces standard pour la compilation, le chargement et l’exécution (déclenchement) des noyaux quantiques. Une image valant mille mots, je résumerai cette section par le schéma suivant :
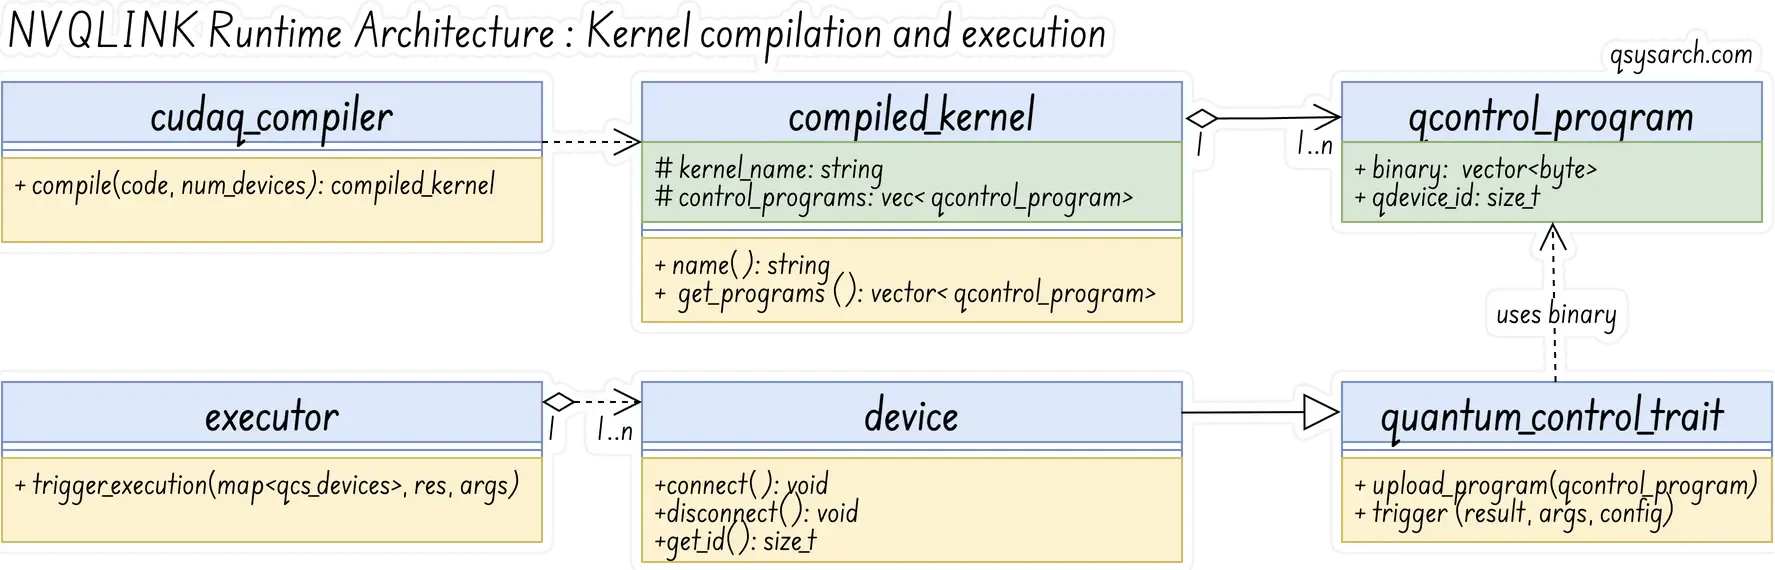
Il est important de noter qu’un système de contrôle quantique (QCS) est composé de plusieurs unités de traitement d’impulsions (PPU). Par conséquent, lors de la compilation d’un noyau, il peut être nécessaire de l’exécuter de manière cosynchrone sur plusieurs PPU. (Notez que NVQLink est indépendant de la cosynchronisation, mais chaque fournisseur de QCS propose sa propre solution, comme SYNQ pour Qblox).
Dans le contexte des interfaces NVQLINK, le concept d’unités de traitement du signal (PPU) est abstrait et remplacé par celui de dispositif quantique générique (QCS). Ainsi, lors de la compilation d’un noyau, NVQLINK génère plusieurs programmes, un pour chaque QCS.
Architecture d’exécution : Abstraction de niveau supérieur « bibliothèque »
Link to heading
Étant donné que le code expliqué dans la section précédente peut être assez complexe à comprendre et à utiliser, NVQLINK fournit un ensemble d’API de plus haut niveau, sous forme de fonctions :
La bibliothèque contient des fonctions permettant de gérer l’initialisation et l’arrêt de base, l’utilisation des API de modification de données spécifiques au périphérique (comme memcpy), le transfert de données vers et depuis le QPU logique, ainsi que le chargement et l’exécution. Voici une version simplifiée de ces fonctions :
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
Exemple d’application : Téléportons-nous
Link to heading
à terminer
NVQLINK est une abstraction système puissante qui permet l’interconnexion de systèmes hétérogènes avec un environnement d’exécution hautement performant et optimisé. Son principal atout par rapport aux autres frameworks réside dans sa composition : le système NVQLINK repose sur des piles standard, notamment RDMA pour le réseau, LLVM pour le compilateur, ainsi que des traits et des API standardisées pour l’exécution.
Avec NVQLINK, les développeurs et intégrateurs n’ont plus à se soucier de l’interconnexion. Ils peuvent ainsi se concentrer sur la conception de leur système hétérogène et la compilation de leurs noyaux multi-périphériques au sein d’un environnement unique. Le runtime NVQLINK orchestre l’exécution des différents « périphériques », comme s’il s’agissait d’un seul système. Il gère la mise en réseau, le marshalling et les appels entre périphériques, vous libérant ainsi de toute contrainte.
C’est un bond en avant considérable : combiné à CudaQ, il permettra aux ingénieurs quantiques de créer des applications puissantes, à l’instar des applications de réseaux neuronaux performantes permises par Nvidia CUDA. Imaginez un master en sciences et technologies, enrichi d’une dimension quantique…
Consigne : dessinez une image d’un « modèle à grands qubits » calculé sur un GPU adjacent connecté via le système NVQLINK. ChatGPT n’a pas compris que NVLINK n’est pas NVQLINK.
Consigne : Pouvez-vous dessiner une image de style cartoon d’un système NVQLINK, interconnectant un « Large Qubit Model » connecté à un GPU adjacent ? ChatGPT ne semble toujours pas comprendre que NVQLINK n’est pas un « câble », mais un framework système permettant de composer des noyaux exécutés sur plusieurs périphériques hétérogènes. Et que ce câble devrait, pour l’instant, être un RDMA (car c’est une norme), mais pourrait très bien être NVLink d’ici 5 ans.
References
DrawIO diagrams used in this memo: