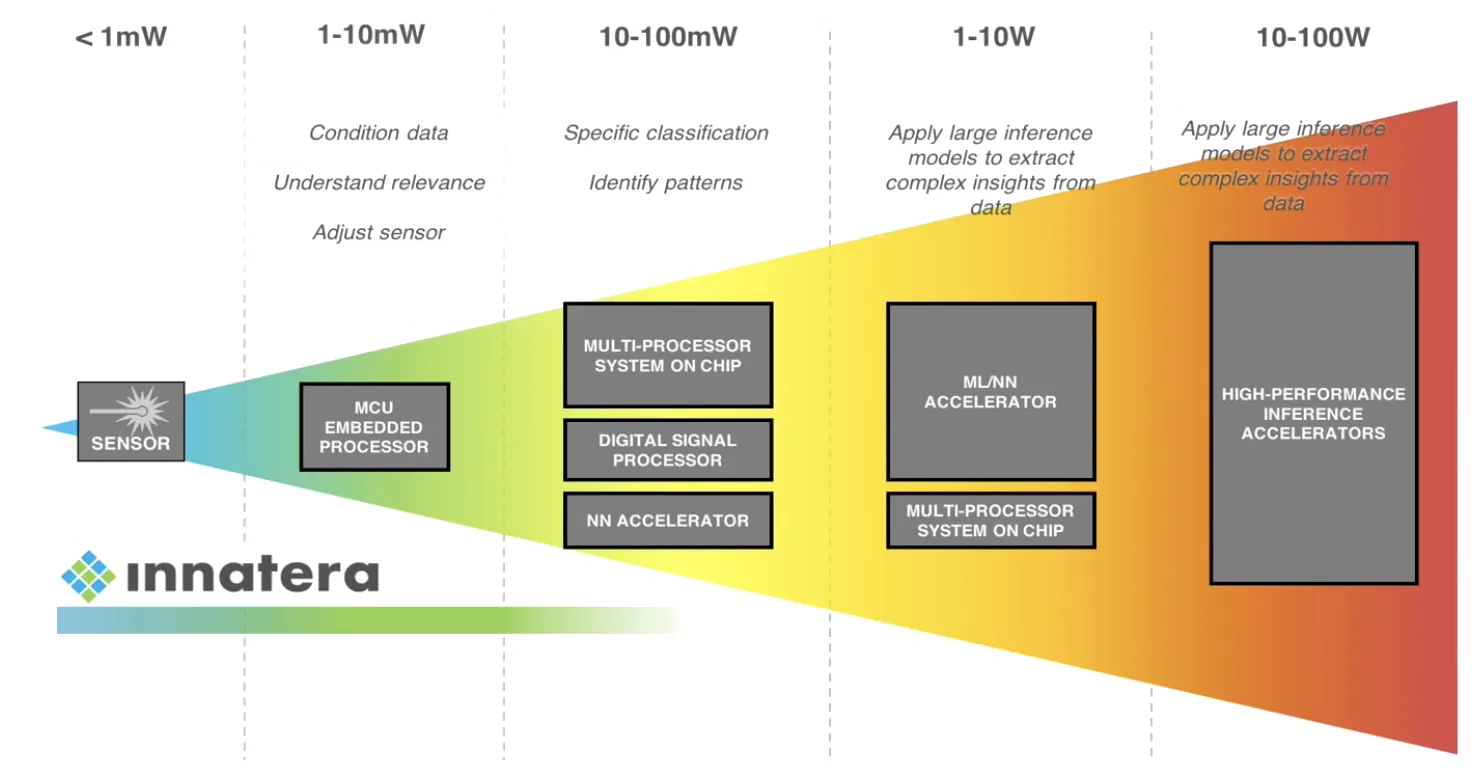
J’ai récemment entendu parler des unités de traitement neuromorphiques (NPU) lors d’une discussion sur Neuralink. Ces NPU n’ont rien à voir avec l’informatique quantique, mais j’ai pensé qu’il serait intéressant de me pencher sur cette nouvelle architecture de traitement. De fait, l’un des principaux fournisseurs de circuits intégrés dans ce domaine est une entreprise néerlandaise nommée Innatera. Son dernier circuit intégré, Pulsar, est basé sur des réseaux de neurones à impulsions basse consommation (voir l’image à droite).
Dans cette note, je vais tenter de reconstituer autant d’informations que possible sur l’architecture de ces circuits intégrés neuromorphiques, la conception des réseaux neuronaux à impulsions et la pile logicielle exposée pour programmer ces dispositifs.
Il s’agit d’une tentative de redessiner le schéma d’architecture du circuit intégré Pulsar (image originale image, complétée par des informations tirées du livre blanc) :
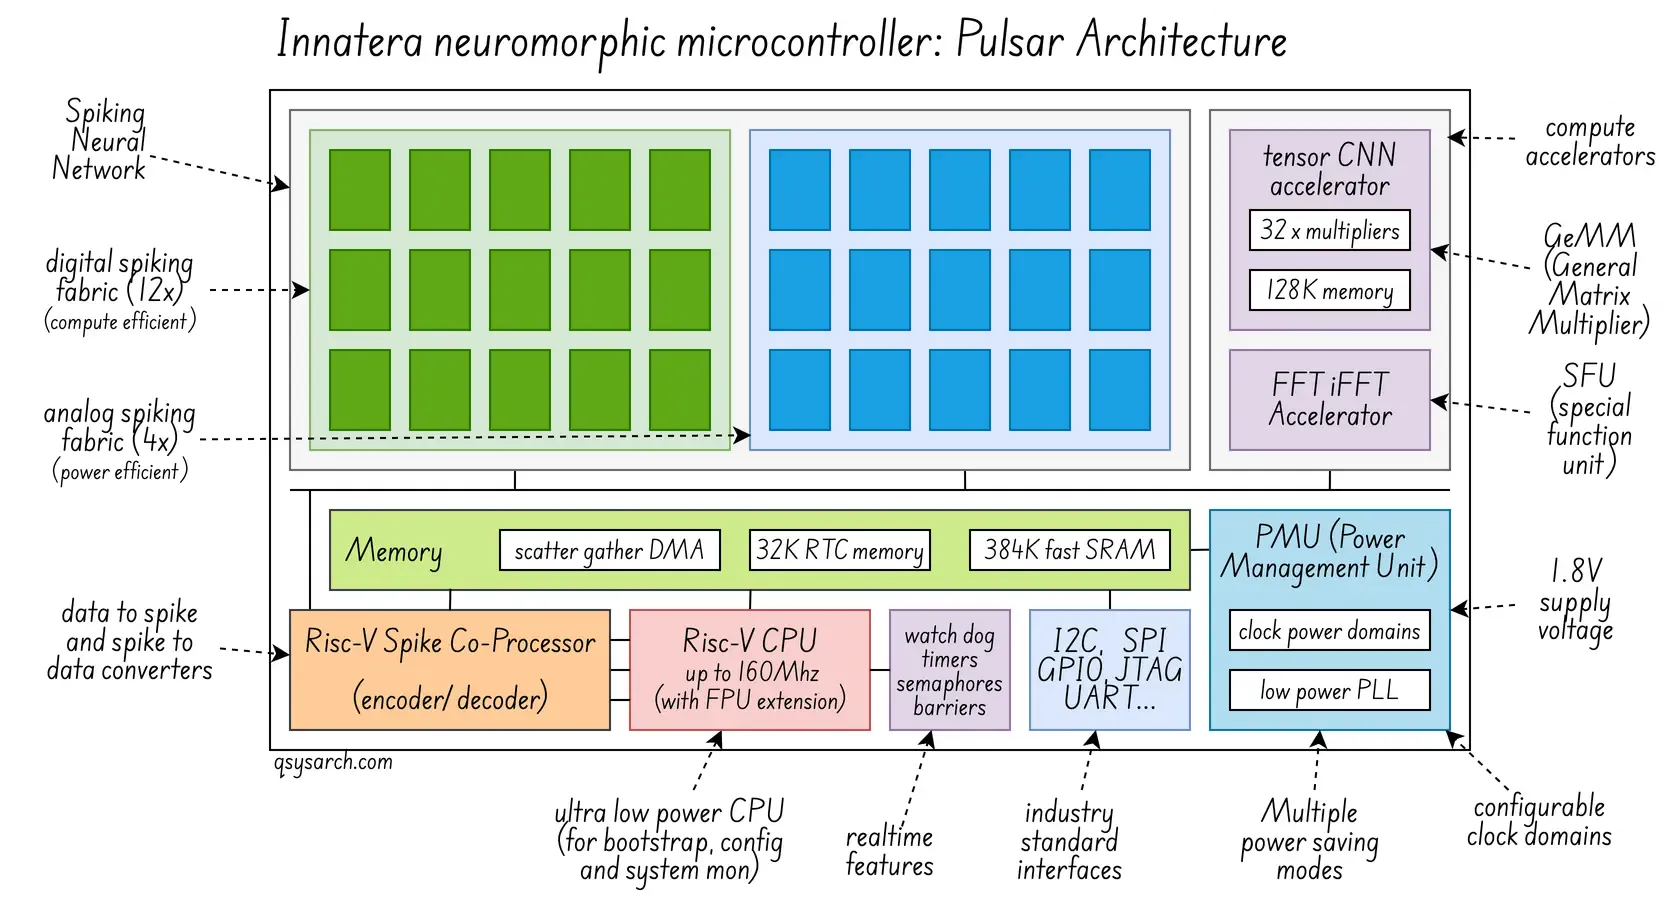
J’apprécie l’idée d’utiliser un processeur RISC-V ; c’est un signe clair que l’équipe d’Innatera a fait le bon choix d’architecture dès le départ. Sur l’un des schémas de la puce T1 d’Innatera, le processeur RISC-V est fourni avec une extension F (prise en charge du calcul en virgule flottante).
Le circuit intégré intègre de nombreuses interfaces standard (SPI, I2C, etc.) et une unité de gestion de l’alimentation (PMU) qui active et désactive certaines parties du circuit lors du passage en mode veille ou en mode économie d’énergie. Malheureusement, je n’ai trouvé aucune donnée sur la consommation électrique réelle, hormis une estimation approximative de « moins de 1 mW ». Avec une tension d’alimentation de 1,8 V, cela correspondrait à moins de 500 µA (I = W/V). Je me demande également si la consommation par cycle est pertinente : dans ce cas, avec une fréquence de 100 Hz (période de mise à jour synaptique), cela représenterait en moyenne 5 µA par mise à jour synaptique.
Le dernier schéma de Pulsar présente deux accélérateurs : un CNN et une FFT. Je pense qu’on pourrait les décrire plus précisément comme un GEMM (multiplicateur de matrice général, élément clé du calcul du réseau de neurones) et une SFU (unité de fonction spéciale, utilisée pour accélérer le calcul de la FFT). Consultez l’article post sur l’architecture GPU pour plus d’informations. On y trouve également un encodeur-décodeur de pics, qui semble avoir été développé comme coprocesseur pour RISC-V, mais je n’ai pas trouvé plus de détails.
Architecture de réseau neuronal à impulsions
Link to heading
La question qui reste concerne le réseau neuronal à impulsions, ou SNN : comment cela fonctionne-t-il ?
J’ai demandé à Gemini de me donner une métaphore pour un enfant de 8 ans sur les réseaux de neurones à impulsions. Voici l’histoire que j’ai reçue :
Imaginez le cerveau comme un bureau de poste géant, et les « neurones » comme les petits messagers qui transportent les messages.
- Messagers et notes :
Dans un programme informatique classique, chaque messager échange constamment des chiffres. En revanche, dans un réseau de neurones à impulsions, les messagers sont très discrets et économes en énergie : ils n’envoient qu’un bref message « Hey ! » lorsqu’un événement important se produit, comme une minuscule impulsion électrique.
- Le compteur d’étincelles :
Chaque messager possède une jauge qui se remplit lorsqu’il entend « Hé ! » de la part des autres. Lorsque la jauge est suffisamment pleine (atteint le seuil), le messager s’excite et crie à son tour « Hé ! ». Immédiatement après avoir crié, sa jauge se réinitialise, l’empêchant ainsi de crier à nouveau (période réfractaire).
- Le timing est primordial :
Si un messager entend plusieurs « Hé ! » rapidement, cela signifie que le message est extrêmement important (comme « Au feu ! »). Si un messager crie « Hé ! » un peu plus tôt que les autres, il s’agit peut-être d’un signe secret annonçant un événement particulier (comme « Un tigre approche ! »). Les messagers doivent donc être attentifs au temps.
- L’apprentissage est la clé :
Les messagers apprennent comme vous : si le messager A crie « Hey ! » juste avant que le messager B ne crie « Hey ! » (parce que quelque chose les a tous deux enthousiasmés), leur amitié se renforce et le message du messager A aide le messager B à remplir sa jauge plus rapidement la prochaine fois.
Les réseaux de neurones à impulsions (SNN) sont particuliers car ils sont conçus pour être incroyablement rapides et efficaces. Ils ne gaspillent pas d’énergie à communiquer en permanence ; ils ne s’activent que lorsqu’ils ont un pic d’informations à transmettre ! Ils aident les ordinateurs à comprendre le rythme, à reconnaître des schémas et à consommer très peu d’énergie.
La véritable conception sous le capot
Link to heading
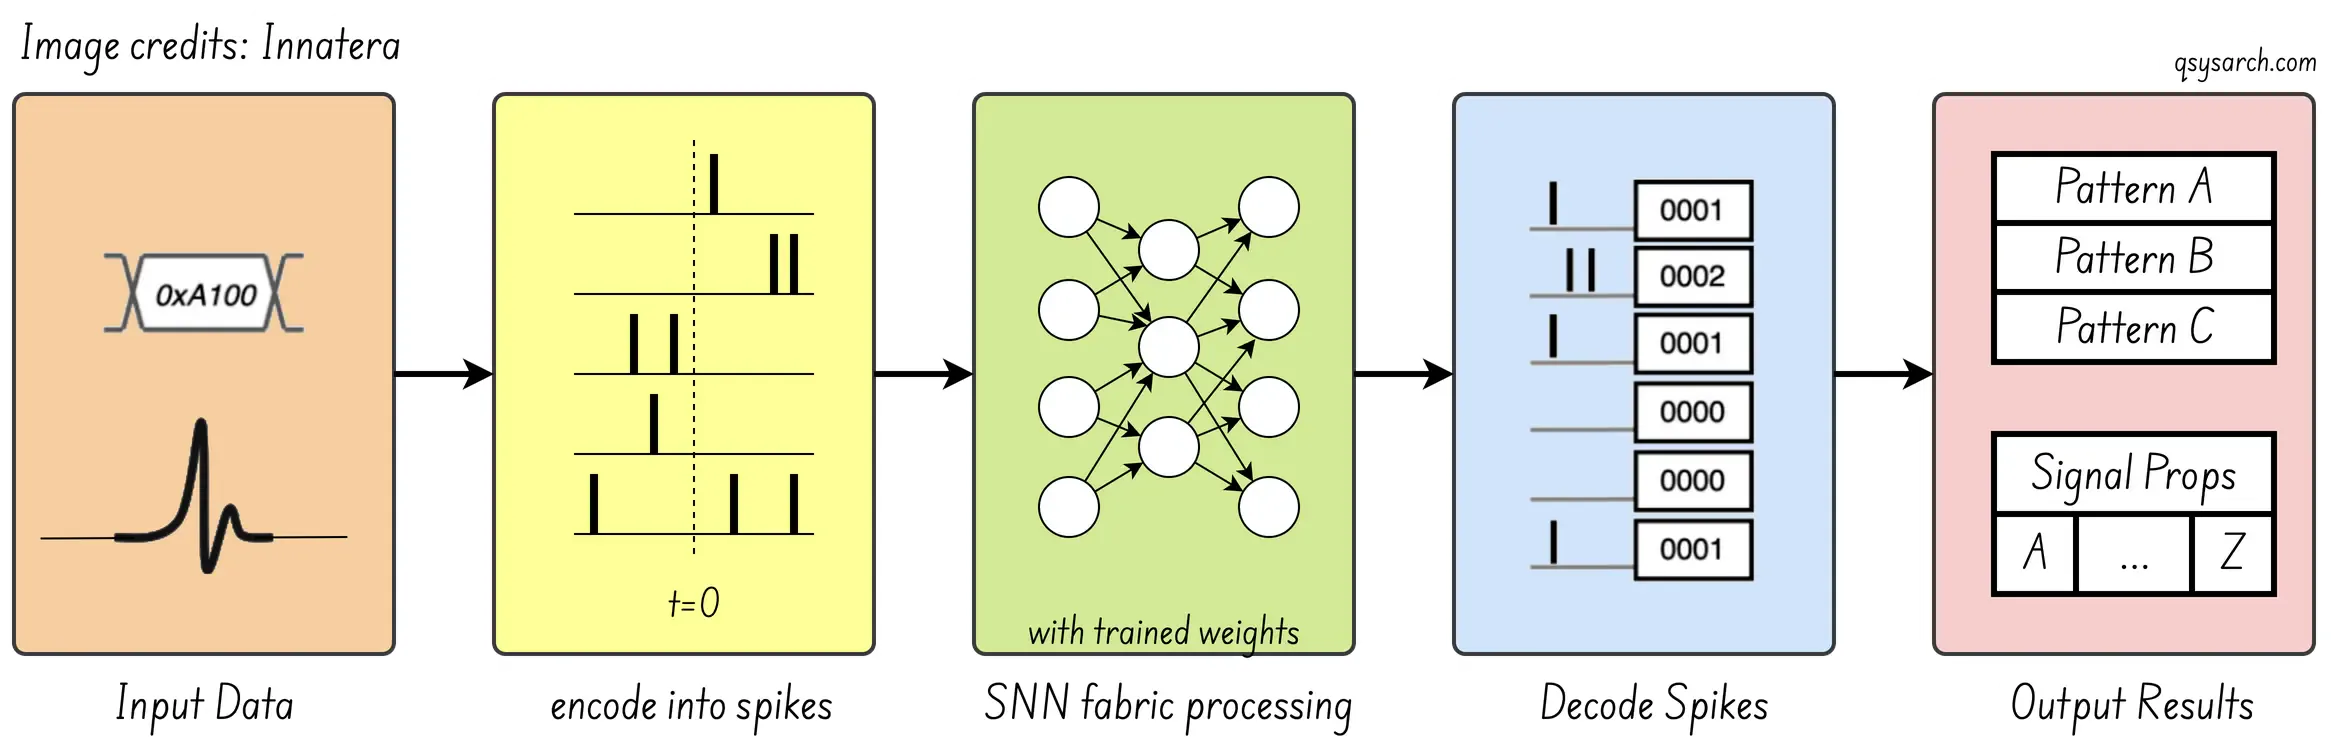
Le blog d’Innatera, Thinking in Pulses, offre un bon aperçu de la mise en œuvre matérielle de cette approche. Les signaux « hey » sont encodés en valeurs binaires, traités par un réseau de neurones, puis les caractéristiques sont extraites. Jusque-là, rien d’extraordinaire ; il s’agit d’un processus classique de réseau de neurones.
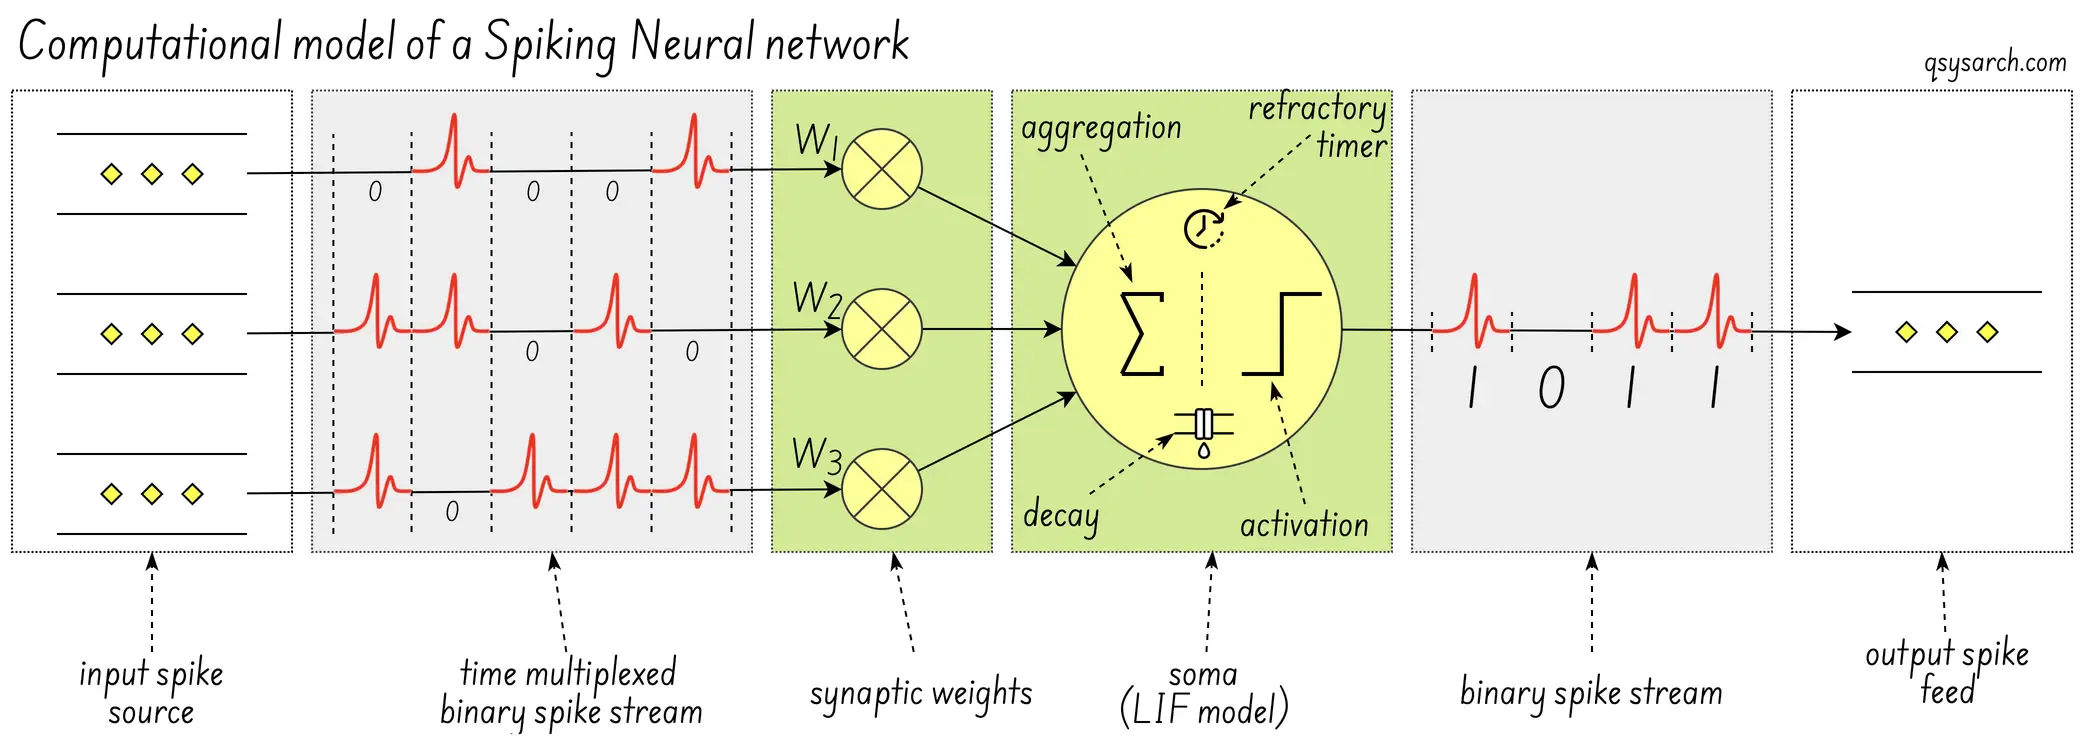
La question la plus intéressante est celle de la mise en œuvre de ce réseau de neurones à impulsions (SNN). L’image ci-dessous semble être un « modèle computationnel » classique du neurone numérique (image source) ; j’y ai ajouté la notion explicite de « leaky integrate-and-fire » (LIF) au sein du SOMA.
Qu’est-ce qui rend l’implémentation matérielle basse consommation ?
Link to heading
À compléter : explications nécessaires pour
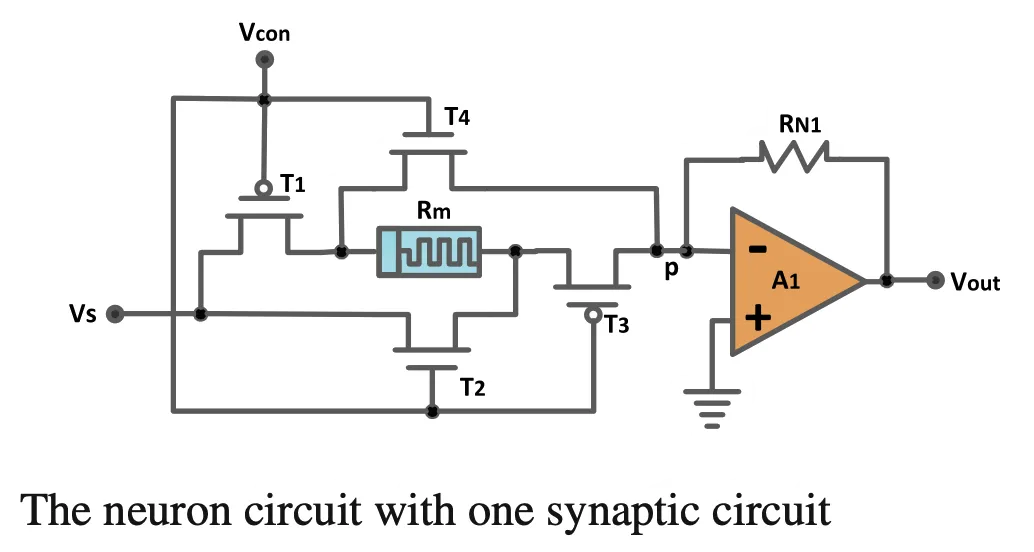
le gain de performance (10x, 1000x ou plus ?)
les latences de propagation NN réalisables
les compromis et les limites
performances des conceptions analogiques et numériques.
consommation d’énergie relative aux GPU/TPU
Une question soulevée par la conception du Pulsar est la suivante : pourquoi deux réseaux de neurones à impulsions (SNN) ? La réponse est que la matrice SNN analogique (propriétaire, à signaux mixtes analogiques) d’Innatera est optimisée pour une efficacité énergétique maximale et un traitement des événements très rapide et à très faible consommation. La matrice SNN numérique, quant à elle, offre une conception plus programmable et flexible, prenant en charge des réseaux plus configurables moyennant une consommation légèrement supérieure. (Source)
Le site web d’Innatera ne contient pas beaucoup d’informations sur l’architecture interne de leur réseau neuronal à impulsions, mais heureusement, ils possèdent quelques brevets que nous pouvons essayer de rétro-ingénierer !
| Date de dépôt | Numéro de publication | Titre (abrégé) |
| 2021-02-09 | US20220230051A1 | Réseau neuronal à impulsions |
| 2021-12-09 | EP4505212A1 | Méthode de prétraitement radar efficace |
| 2022-01-26 | EP4323923B1 | Réseau neuronal à impulsions multi-segments hiérarchique reconfigurable |
| 14 février 2022 | EP4238006A2 | Structure computationnelle synaptique multicomposante distribuée |
| 2022-03-22 | EP4226281B8 | Adaptation des réseaux neuronaux spontanés par synchronisation transitoire |
| 2022-04-08 | EP4548260A1 | Calibrage des réseaux de neurones à impulsions |
| 2022-06-03 | EP4562540A | Système et méthode pour codeurs analogiques à picots efficaces et centrés sur les caractéristiques |
| 2022-06-24 | EP4573485A1 | Machine neuronale séquentielle pour l'inférence optimisée en mémoire |
| 2022-09-08 | WO2024038102A1 | Système et méthode de calcul neurosynaptique modulaire reconfigurable… |
| 18 octobre 2022 | WO2024153705A1 | Synthétisable à anticipation auto-cadencée et technologiquement évolutive, à signaux mixtes… |
| 18 mai 2023 | WO2024175770A1 | Modules et méthodes de traitement audio neuromorphique permanent |
| 2023-05-24 | WO2024175767A1 | Système et méthode de cartographie des réseaux de neurones à impulsions sur des interfaces neuromorphiques… |
| 19 juin 2023 | WO2025012331A1 | Méthode d'entraînement de modèles d'apprentissage automatique pour substrats stochastiques |
| 2023-06-22 | WO2025017094A1 | Méthode de construction et de déploiement de réseaux neuronaux à impulsions sur un dispositif matériel |
| 2023-10-23 | WO2025021573A1 | Système et méthode de détection d'occupation utilisant un capteur à cadre |
| 2023-12-06 | WO2025062034A1 | Extraction et encodage de caractéristiques de réseaux de neurones à impulsions à l'aide de réseaux convolutionnels |
| 2024-03-08 | WO2023242374A1 | Interconnexion Spike sur puce multidiffusion à paquet unique |
C’est un nombre impressionnant de brevets pour une start-up ! Par souci de concision, je n’ai examiné que le premier et le dernier brevet de cette liste.
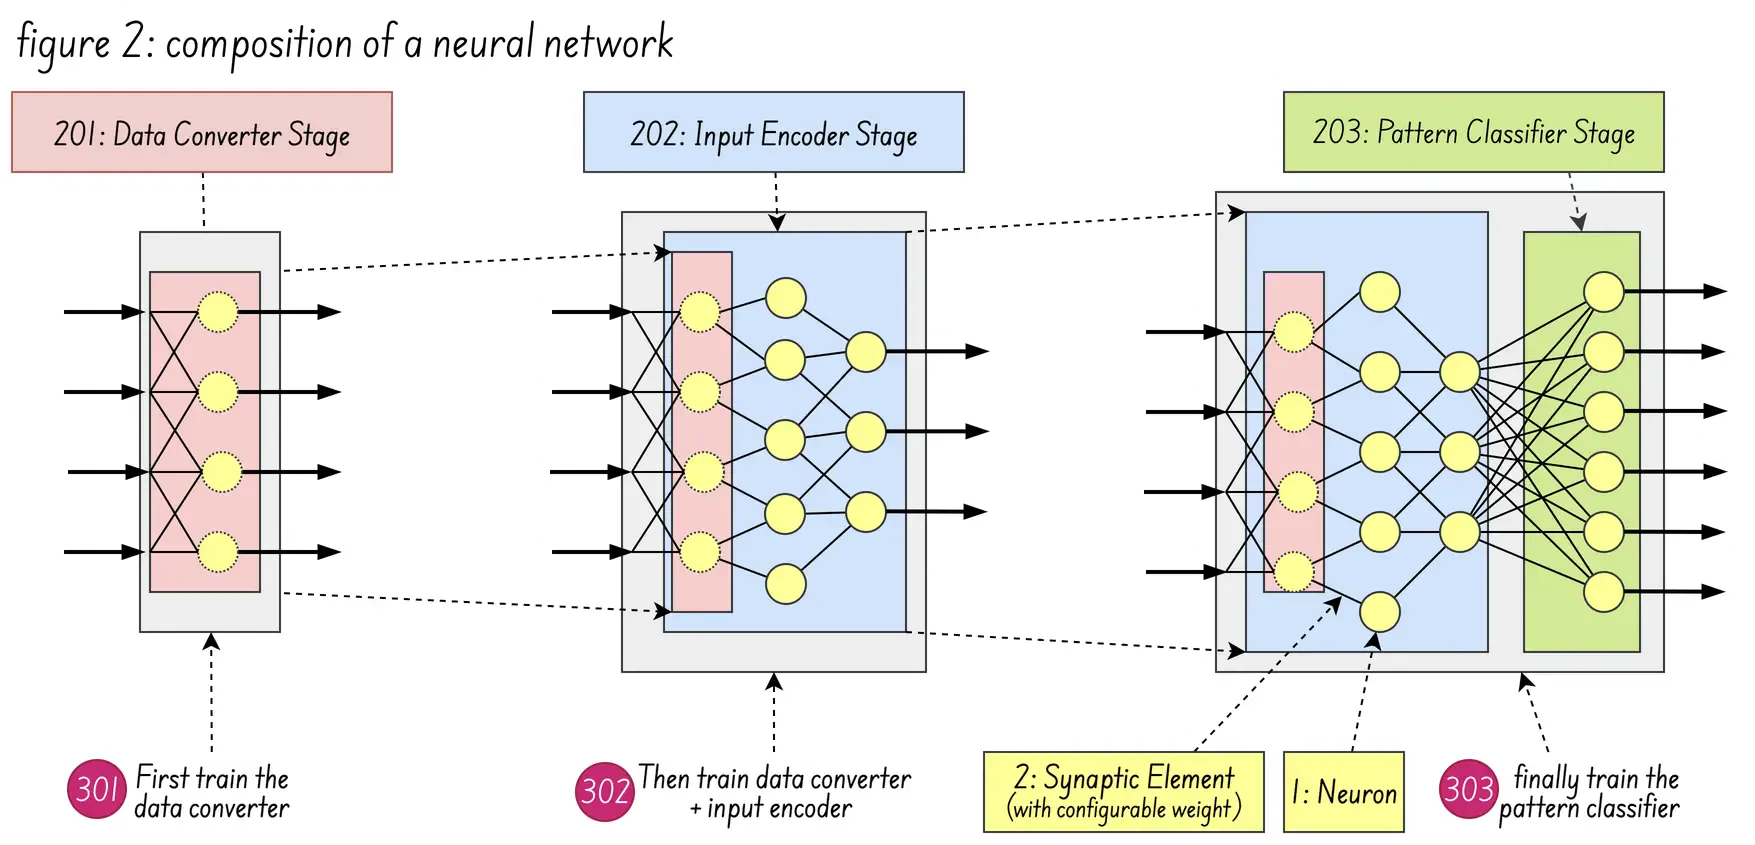
Commençons par le premier brevet US20220230051A1, qui semble être le plus proche de décrire l’implémentation matérielle réelle du SNN : le brevet est centré sur une méthodologie de composition pour construire des SNN à partir de sous-réseaux spécialisés pré-entraînés (« cellules ») utilisant un principe de « réponse unique ».
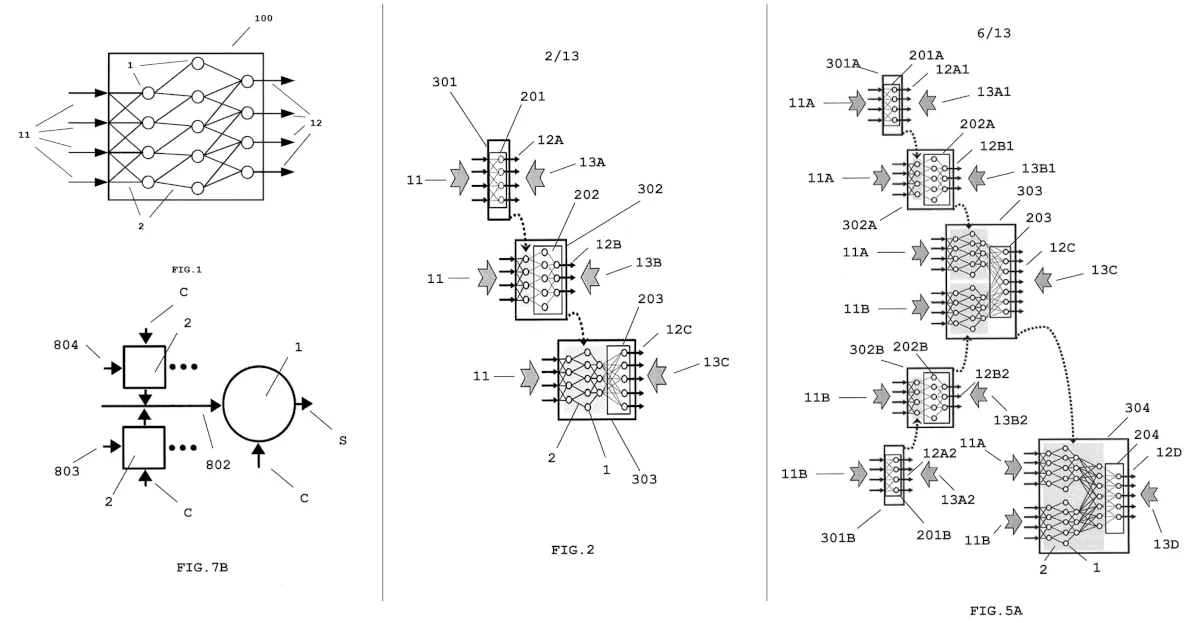
La figure 2 (ci-dessous) illustre la composition d’un réseau neuronal formé par l’intégration d’un étage de conversion de données 201, d’un étage d’encodage d’entrée 202 et d’un étage de classification de motifs 203. Quant à la figure 5B (ci-dessus), elle montre comment plusieurs trains d’impulsions temporelles sont fusionnés en un seul train d’impulsions fusionné.
Quant au dernier brevet WO2023242374A1, il décrit l’architecture de réseau neuronal à impulsions d’Innatera, utilisée pour implémenter efficacement la multidiffusion par paquet unique à l’aide de réseaux sur puce. L’objectif est de réduire la duplication, la latence et la surcharge dans les systèmes multicœurs/à nombreux cœurs pour la communication multidiffusion.
Le schéma ci-dessous (figure 5 du brevet) illustre le fonctionnement de l’arbitrage NOC. L’objectif est d’éviter l’envoi simultané de deux pics (ou plus) vers le même port de sortie. Il s’agit d’une méthode efficace pour acheminer les pics à chaque cycle. Je me demande toutefois quelle est la profondeur des FIFO dans le matériel.
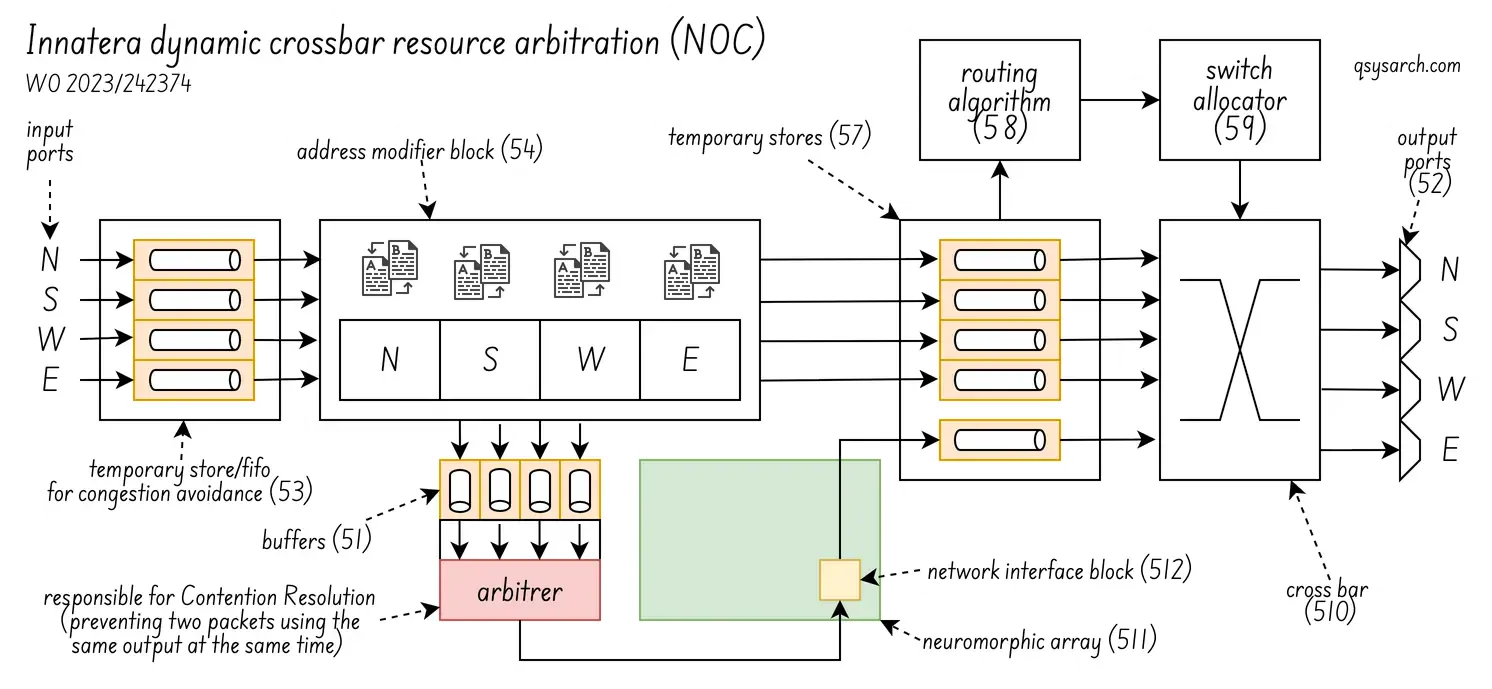
Ce qui n’est pas clair pour moi, c’est comment le réseau central et le réseau de potentiels d’action s’articulent : combien de neurones composent un réseau central ? Les neurones du réseau central sont-ils interconnectés ou fonctionnent-ils de concert ? Ou s’agit-il d’unités indépendantes capables de traiter des classifications indépendantes en parallèle ?
Autres conceptions de noyaux neuronaux
Link to heading
Je ne connais pas l’architecture exacte d’Innera, mais de nombreux articles de recherche détaillent les implémentations possibles. L’article « a system design perspective on neuromorphic computer processors » est particulièrement intéressant car il compare plusieurs architectures.
L’une de ces architectures est le « système neuromorphique reconfigurable et très efficace », ou RAVENS, qui est représenté dans le schéma ci-dessous :
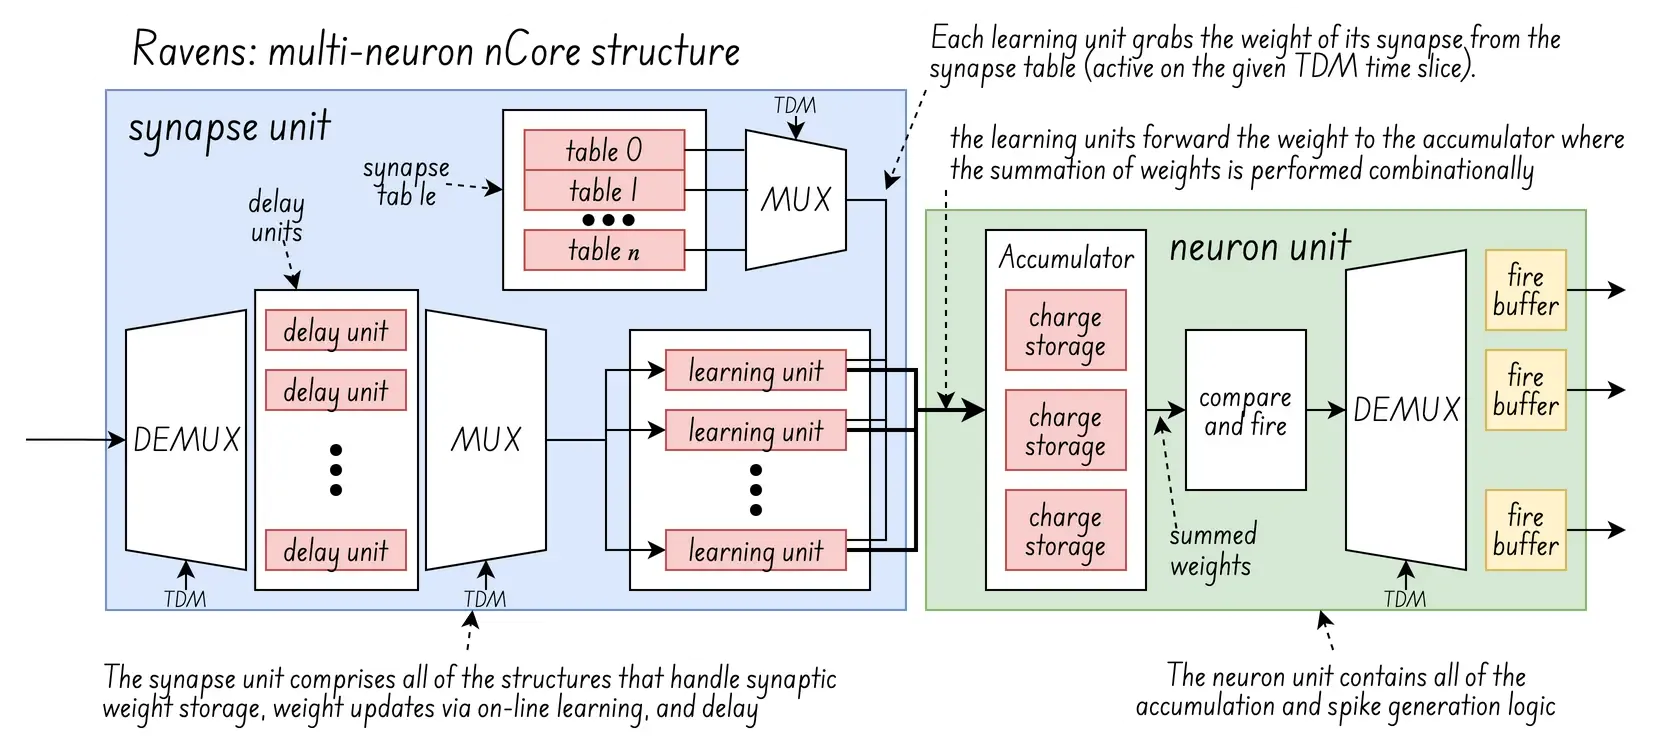 (diagramme mis à jour à partir de l’image originale : )
L’idée derrière RAVENS est de chaîner plusieurs « neurones virtuels » à l’aide du multiplexage temporel (TDM), dans un processus en deux étapes : l’accumulation et la mise à jour.
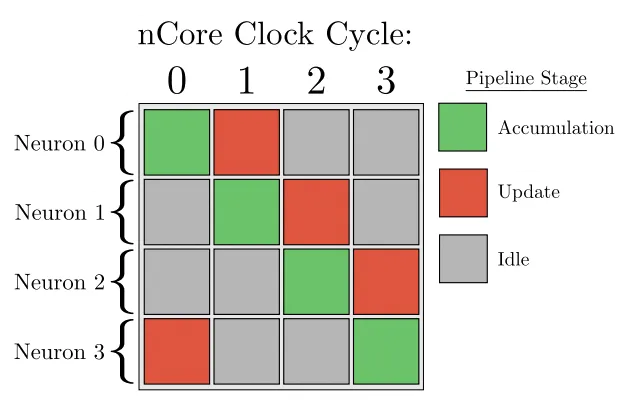
Phase d’accumulation : un neurone accumule des charges provenant des synapses d’entrée auxquelles il est connecté et détermine si un potentiel d’action doit se produire ou non en fonction de son seuil programmé et de son état réfractaire.
Étape de mise à jour : inclure les modifications d’apprentissage en ligne des poids synaptiques, les fuites de charge, les incréments des compteurs réfractaires et les variations de charge accumulée dues à la sortie d’une période réfractaire
La partie intéressante ici est l’apprentissage en ligne : dans les IC neuromorphiques, l’apprentissage en ligne modifie les poids synaptiques en utilisant des algorithmes comme l’apprentissage hebbien ou l’apprentissage par renforcement](/posts/3-when-ai-solves-the-quantum-challenge/) pour ajuster la force synaptique en temps réel en fonction des entrées des neurones pré- et post-synaptiques.
Dans le cas des cœurs analogiques, cet ajustement est physiquement réalisé par des dispositifs tels que les memristors ou les jonctions tunnel magnétiques (MTJ), dont la résistance ou la conductance est modulée par l’activité neuronale, représentant et stockant directement les poids synaptiques. Dans le cas des cœurs numériques, il s’effectue via les tables de synapses, du moins pour RAVENS.
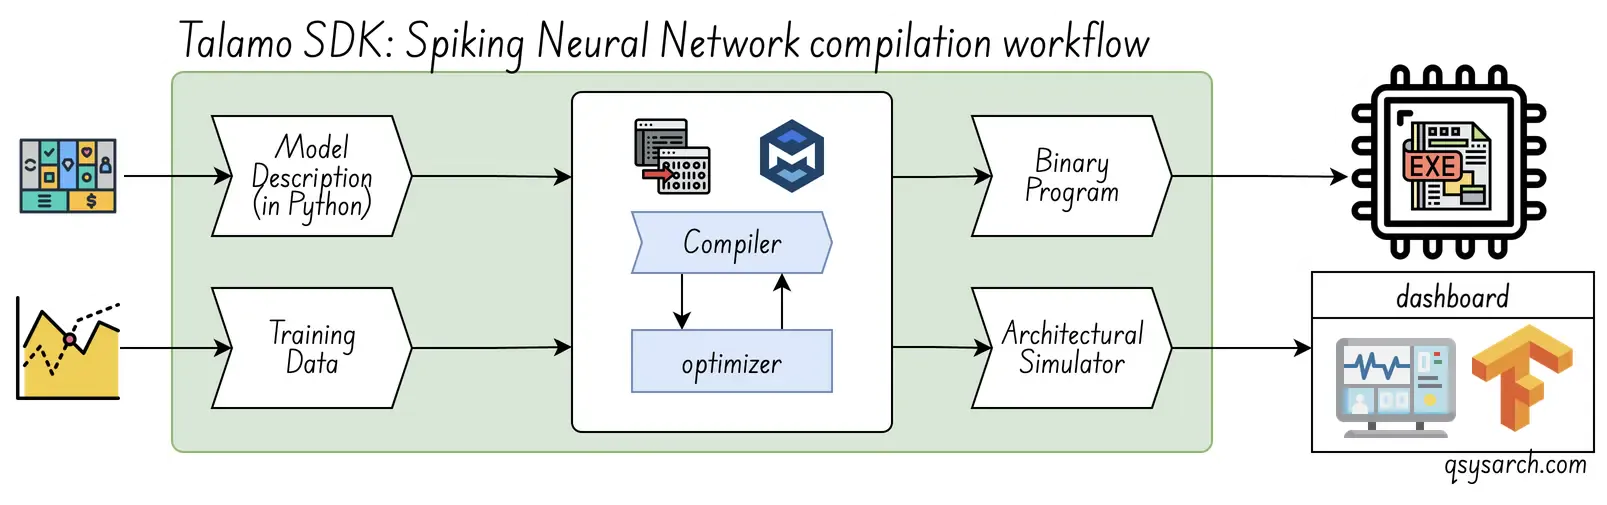
L’offre d’Innatera inclut un kit de développement logiciel (SDK) Talamo intégré, qui ne requiert aucune expertise en réseaux de neurones à impulsions (SNN), prend en charge les applications complètes et utilise un flux de travail standard pour l’apprentissage profond. Le kit Talamo permet aux développeurs de créer des modèles à impulsions à partir de zéro dans un environnement basé sur PyTorch. Il s’agit d’une solution clé en main.
Le processus de compilation est très standard. Le diagramme ci-dessous est une version légèrement mise à jour du matériel original d’Innatera, en supposant que le compilateur soit l’élément central du processus. Je me demande également si le simulateur utilise l’exécutable binaire comme entrée, auquel cas il serait appelé émulateur. Il serait très utile d’obtenir davantage d’informations sur le processus d’optimisation et sur la possibilité pour l’utilisateur d’ajuster certains paramètres (comme la réduction des poids à 1,58 bits).
Une fois le programme binaire généré, ce flux d’exécution est utilisé et suit plus ou moins le processus défini dans le brevet WO2023242374A1.
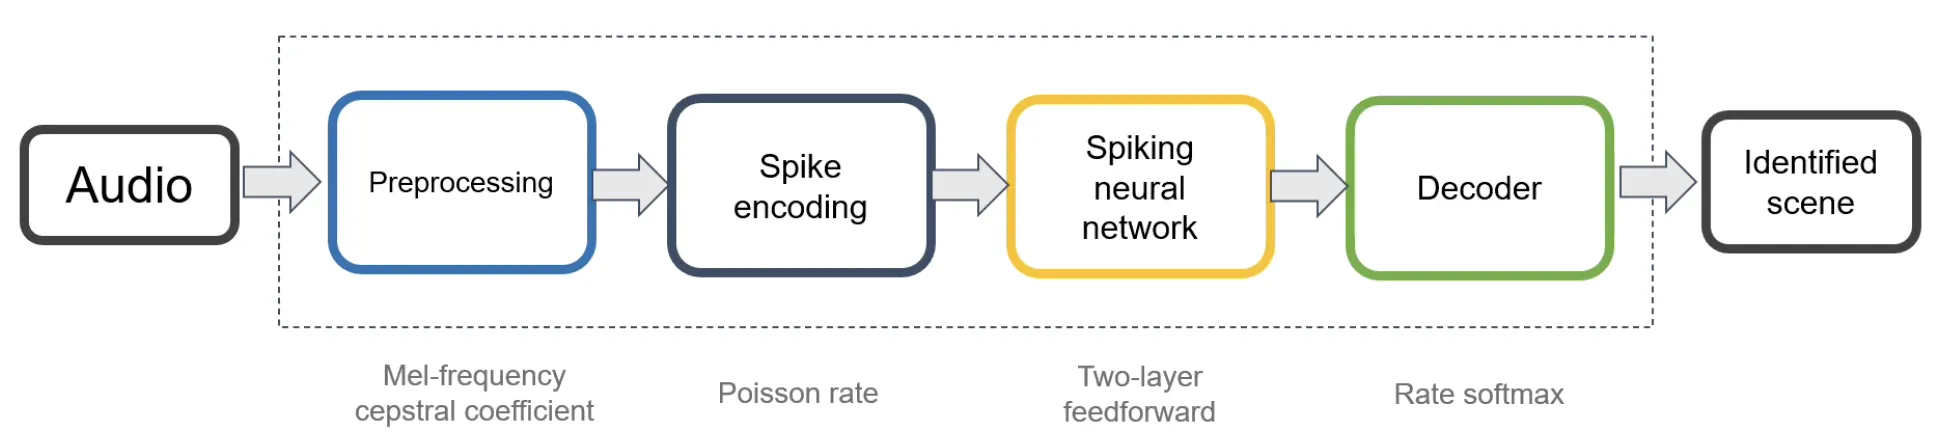
L’infrastructure matérielle d’Innatera comprend un puissant processeur RISC-V, un processeur GEM performant et un accélérateur de calcul SFU. Certains utilisateurs avancés pourraient préférer un accès direct au matériel plutôt que le simple chargement de poids dans une bibliothèque C compatible avec l’architecture d’Innatera.
Il serait peut-être judicieux de proposer un kit de développement logiciel (SDK) de firmware open source. On pourrait également envisager CudaNN, offrant une expérience de processeur neuronal à usage général (GPNPU), à l’instar de Cuda-Q pour l’industrie quantique. De même, un NVNLink, similaire à NVQLink, permettrait de déployer des réseaux NPU à grande échelle et des architectures hybrides.
C’est peut-être ce que signifie l’article « La voie du succès commercial des technologies neuromorphiques » [https://www.nature.com/articles/s41467-025-57352-1] : « Ce n’est qu’avec l’avènement de modèles et d’outils de programmation simples, et simultanément à un accès API direct au matériel, que les processeurs de tenseurs ont connu une large adoption. » Il suffirait donc de remplacer « processeurs de tenseurs » par « unités de traitement neuromorphiques (NPU) ».
Pour moi, tout se résume à l’expérience utilisateur (UX) et à l’expérience développeur (DX). Et je suis convaincu que la facilité d’utilisation et l’expérience développeur sont des facteurs clés, voire des piliers stratégiques, pour créer des expériences produit véritablement exceptionnelles.
 (Crédits image : archi monarch)
Voilà qui conclut cette brève présentation de l’architecture générale des circuits intégrés neuromorphiques. Cette architecture matérielle représente sans aucun doute une technologie alternative et puissante, dotée d’un potentiel considérable. On pourrait toutefois arguer que les circuits intégrés neuromorphiques manquent d’une application phare. Mais n’est-ce pas là tout l’intérêt de ces circuits ? Faut-il pour autant créer l’univers qui leur est associé ?
Je suis convaincu que l’équipe d’Innetera fait partie de ceux qui ont une vision novatrice. Face à la forte consommation énergétique des centres de données d’IA, les circuits intégrés neuromorphiques ne constituent-ils pas une réponse à la question essentielle : comment obtenir plus de valeur avec moins d’énergie ? Si tel est le cas, comment adapter la puissance de calcul des circuits intégrés neuromorphiques aux besoins des centres de données d’IA ?
Par ailleurs, je me demande si l’ajout de quelques éléments de photonique sur silicium au réseau de neurones à impulsions (SNN) serait bénéfique. Cela pourrait améliorer le calcul neuronal, mais aussi permettre de créer un vaste réseau d’interconnexion entre les circuits intégrés du SNN.
Diagrammes DrawIO utilisés dans cette note :