
Cette note vise à comprendre le fonctionnement interne du RDMA, et en particulier ce qu’il faut pour créer une « carte réseau compatible RDMA » qui s’interconnecte avec un sous-système PCIe, tel que le connectX-7 200Gb intégré au DGX Spark (image à droite).
RDMA en tant que protocole « client-serveur »
Link to heading
Commençons cette note par un aperçu du protocole RDMA.
Lors de la configuration des canaux de données RDMA, les tampons mémoire doivent être enregistrés auprès de la carte réseau avant de pouvoir être utilisés. Le processus d’enregistrement comprend les étapes suivantes :
Fixer la mémoire de manière à ce qu’elle ne puisse pas être permutée par le système d’exploitation.
Stockez les informations de traduction d’adresse dans la carte réseau.
Définir les autorisations pour la région mémoire.
Créez des clés distantes et locales, utilisées par la carte réseau lors de l’exécution des verbes RDMA.
Paires de files d’attente RDMA
Link to heading
La communication RDMA repose sur un ensemble de trois files d’attente.
SQ : File d’attente d’envoi
RQ : File d’attente de réception
CQ : File d’attente d’achèvement
La paire de files d’attente RDMA, ou QP, fait référence à la file d’attente d’envoi + la file d’attente de réception.
Éléments de la file d’attente de travail RDMA
Link to heading
Les applications émettent une tâche à l’aide d’une requête de travail, également appelée élément de file d’attente de travail (WQE). Une requête de travail est une petite structure contenant un pointeur vers une mémoire tampon :
Dans une file d’attente d’envoi, il s’agit d’un pointeur vers un message à envoyer.
Dans une file d’attente de réception, cela indique où un message entrant doit être placé.
Une fois qu’une demande de travail est terminée, l’adaptateur crée un élément de file d’attente d’achèvement et l’ajoute à la file d’attente d’achèvement.
Exemple simple d’écriture RDMA
Link to heading
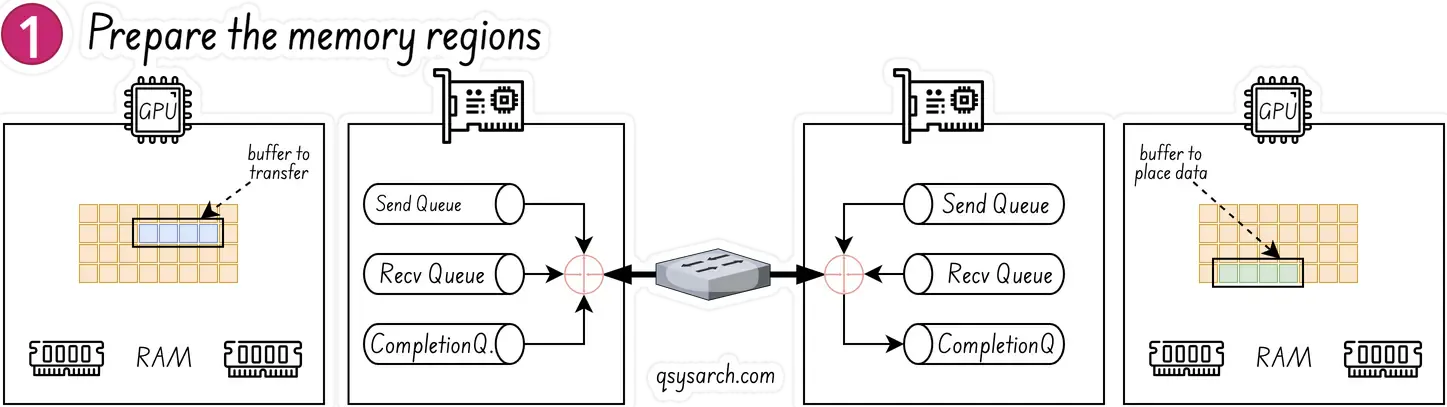
L’émetteur (à gauche) et le récepteur (à droite) ont créé leurs paires de files d’attente et leurs files d’attente de complétion, et ont réservé des zones mémoire pour le transfert RDMA. L’émetteur identifie une mémoire tampon qu’il souhaite transférer vers le récepteur. Le récepteur dispose d’une mémoire tampon vide pour y placer les données.
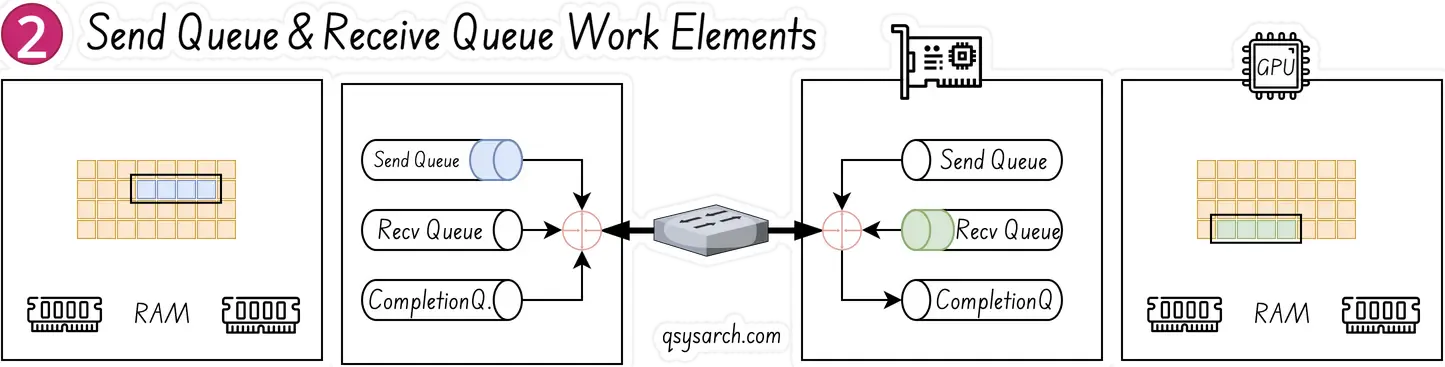
L’entité réceptrice à droite crée un élément de file d’attente de travail WQE WOOKIE et l’ajoute à la file d’attente de réception. Cet élément WQE contient un pointeur vers la mémoire tampon où les données seront placées. L’entité émettrice à gauche crée également un élément WQE qui pointe vers la mémoire tampon qui sera transmise.
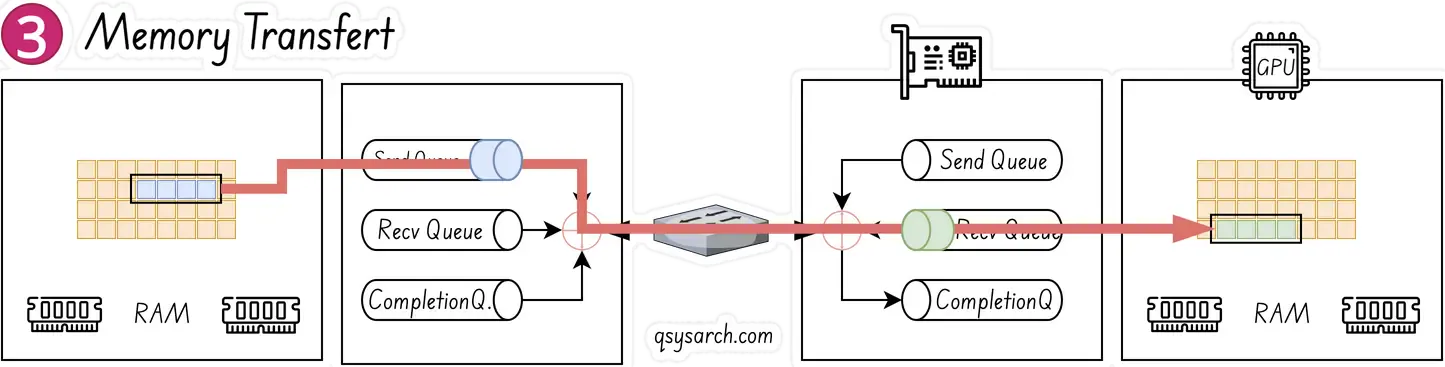
La carte réseau (considérée comme la carte réseau matérielle compatible RDMA, également appelée RNIC) interroge en permanence la file d’attente d’envoi à la recherche d’événements WQE. Cette opération s’effectue sans intervention du GPU ni du CPU ; l’interrogation n’affecte que la RNIC. Dès qu’un événement WQE est transmis par le CPU, la RNIC le traite sur l’entité émettrice et commence à transférer les données de la zone mémoire vers l’entité réceptrice. À l’arrivée des données sur l’entité réceptrice, la RNIC traite l’événement WQE présent dans la file d’attente de réception afin de déterminer où placer les données.
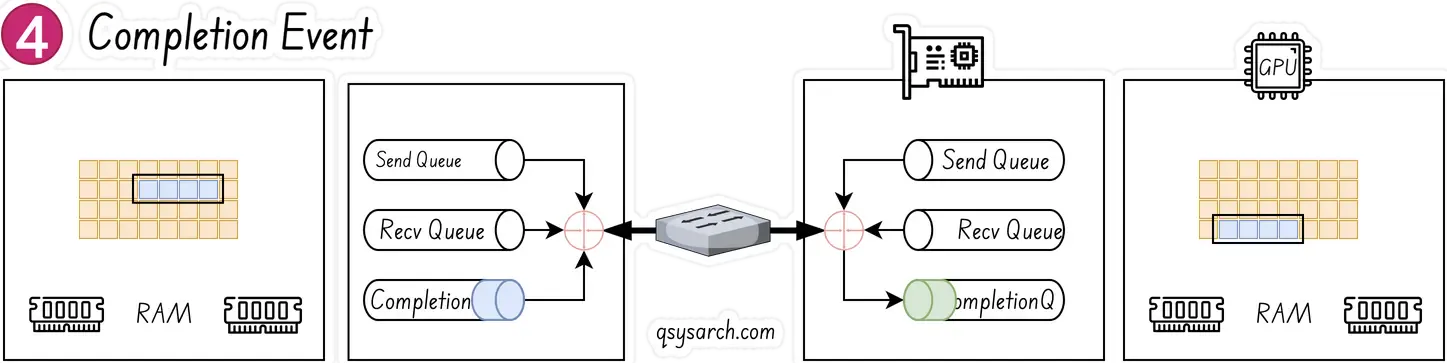
Dernière étape : une fois le transfert de données terminé, l’interface RNIC crée un événement de fin de transaction (CQE) « COOKIE », placé dans la file d’attente de fin de transaction. Cet événement indique que la transaction est terminée. Un CQE est généré pour chaque WQE consommé.
Crédits image
Il est important de noter que seul l’émetteur est actif ; le récepteur est passif ; le côté passif n’effectue aucune opération, n’utilise aucun cycle CPU et ne reçoit aucune indication qu’une « lecture » ou une « écriture » a eu lieu.
Pour effectuer une lecture ou une écriture RDMA, la demande de travail doit inclure :
Cela signifie que la partie active doit obtenir au préalable l’adresse et la clé de la partie passive.
RDMA du point de vue des paquets réseau
Link to heading
Cette partie est basée sur l’excellent travail de Toni Pasanen de Network Times
Établissement d’une session RDMA
Link to heading
L’application sur le nœud de calcul client (alias CCN) initie l’établissement de la connexion en envoyant un message de demande de communication (REQ) à l’application sur le nœud de calcul serveur (SCN).
Le message REQ comprend un moyen d’identifier la carte réseau physique (RNIC) et le port :
- Identifiant de communication local (LID) et identifiant unique global de l’adaptateur de canal (GUID de l’autorité de certification locale). Le GUID de l’autorité de certification locale identifie la carte réseau distante (RNIC), tandis que l’identifiant de communication local identifie le port sur la carte réseau.
Le message REQ contient également toutes les métadonnées relatives aux paires de files d’attente.
Numéro QP local (0x1234 5678)
Type de service QP (Connexion non fiable)
Numéro de séquence du paquet de départ (PSN : 0x1882)
Valeur de la clé de partition (0x8012)
taille de la charge utile (1024).
Le message REP accuse réception des métadonnées QP. Enfin, le client renvoie un message Ready to Use (RTU) pour confirmer au serveur que la connexion QP est établie. Une fois la session établie, l’application sur le CCN peut démarrer le processus d’écriture RDMA.

Terminologie:
CCN : nœud de calcul client
SCN : nœud de calcul du serveur
PD : Domaine de protection
L_Key, R_Key : touches locales et distantes
QP : Paire de files d’attente (QP) = File d’attente d’envoi + File d’attente de réception.
CQ : File d’attente d’achèvement
RC : Connexion fiable
UD : Datagramme non fiable
REQ : CCN envoie l’identifiant local, le numéro QP, la clé P et le PSN.
Réponse : SCN répond avec les identifiants, les informations QP et le PSN.
RTU : Prêt à l’emploi : CCN confirme la connexion.
WR : Demande de travail
Message de demande de travail RDMA
Link to heading
À compléter ultérieurement – les messages WR ne présentent rien d’exceptionnel à signaler ici – pour plus de détails, consultez l’article de Toni Pasanen dans Network Times et la documentation sur le Protocole de transport InfiniBand.
RDMA du point de vue du transfert réseau
Link to heading
Le protocole RDMA UC (Unreliable Connected) ne gère pas la retransmission ; il s’appuie sur l’application pour assurer la fiabilité et traiter les paquets perdus, car UC est un service de datagrammes sans connexion et non fiable. La carte d’interface réseau (NIC) abandonne les paquets sans tenter de retransmission, et c’est à l’application qu’il incombe de suivre et de redemander les données manquantes. Ceci contraste avec les QP (Questions Processing) à connexion fiable (RC), où le matériel réseau gère les retransmissions. Dès lors, comment une application RDMA UC détecte-t-elle la perte d’un paquet ?
- Détection des pertes de paquets au niveau applicatif
Numéros de séquence des paquets (PSN) : L’application attribue un numéro unique et séquentiel à chaque paquet qu’elle envoie. Le récepteur conserve la trace de ces numéros de séquence. Un intervalle entre les numéros de séquence indique qu’un ou plusieurs paquets ont été perdus.
Délais d’attente : Le protocole de niveau application peut implémenter un mécanisme de délai d’attente. Si aucune réponse ou aucun accusé de réception n’est reçu dans un certain délai, l’application considère que le paquet a été perdu et lance une retransmission.
- Récupération des pertes de paquets au niveau de l’application

Si le récepteur détecte un paquet perdu dans la séquence, il doit en informer l’émetteur afin que celui-ci le retransmette. Or, si le paquet servant à informer l’émetteur est lui aussi perdu, la situation peut se complexifier considérablement.
- Délai d’attente : L’expéditeur attend que le destinataire accuse réception des paquets reçus. Dans le cas contraire, l’expéditeur renvoie proactivement le paquet non encore acquitté.
Faut-il toujours implémenter un module de fiabilité distinct (https://www.usenix.org/system/files/osdi23-li-qiang.pdf) en plus de RDMA QP ? Pas nécessairement. Dans certains cas, il est acceptable de considérer la perte d’un paquet comme un motif d’échec de la session entière, plutôt que de simplement renvoyer le paquet manquant. Cette approche est efficace car le réseau sous-jacent est généralement suffisamment fiable pour garantir une fiabilité extrêmement élevée, par exemple une seule erreur pour mille milliards de paquets.
Contrôle de flux prioritaire (PFC) et notification explicite de congestion (ECN)
Link to heading
Le protocole RDMA UC ne détecte pas intrinsèquement la perte de paquets, car il s’agit d’un protocole non fiable ; la gestion des pertes de paquets est donc assurée par l’application ou une couche supérieure. La garantie d’absence de perte en RDMA repose sur des technologies réseau sous-jacentes telles que le contrôle de flux prioritaire (PFC) et la notification explicite de congestion (ECN), qui empêchent les pertes de paquets.
Ce protocole encapsule le segment de données RDMA dans un segment de données UDP, ajoute l’en-tête UDP, puis l’en-tête IP et enfin l’en-tête Ethernet, formant ainsi un paquet de données à trois couches. Il peut être identifié à l’aide du champ PCP dans le VLAN Ethernet ou du champ DSCP dans l’en-tête IP.
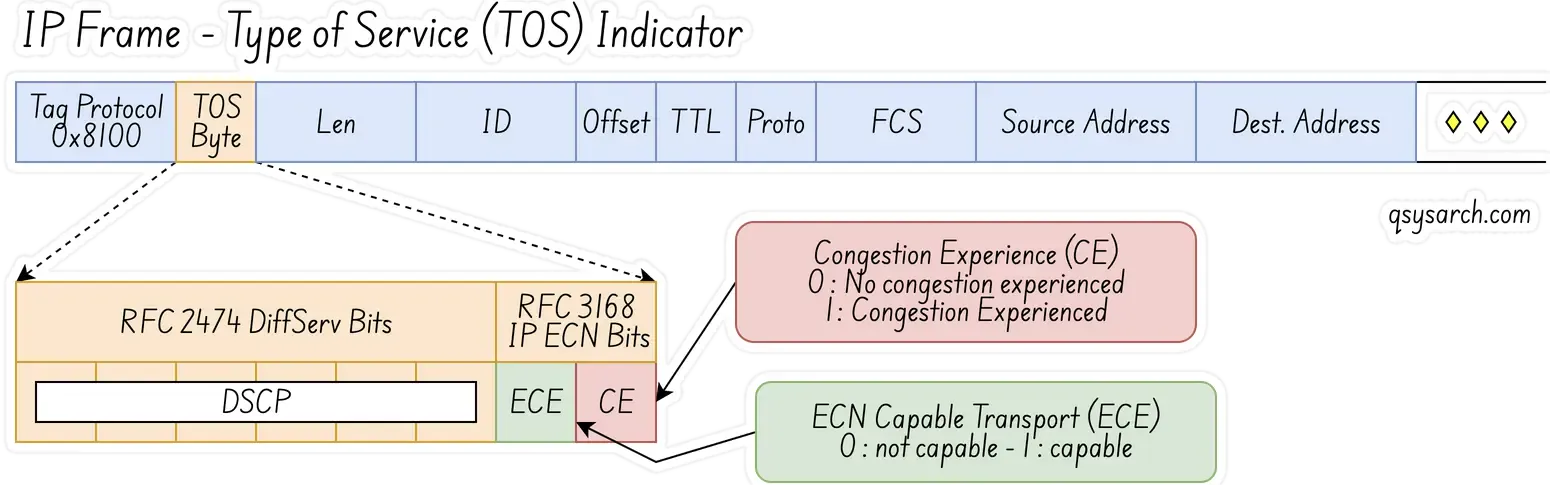
En termes simples, dans le cas d’un réseau de couche 2, le PFC utilise le bit PCP du VLAN pour distinguer les flux de données. Dans le cas d’un réseau de couche 3, le PFC peut utiliser à la fois PCP et DSCP, permettant ainsi à différents flux de données de bénéficier d’un contrôle de flux indépendant. Actuellement, la plupart des centres de données utilisent des réseaux de couche 3 ; par conséquent, l’utilisation de DSCP est plus avantageuse que celle de PCP.
Crédits image
 L’analyse PCIe est basée sur l’excellent article : SmartIO : Zero-overhead Device Sharing through PCIe Networking de Dolphin.
Registres d’adresse de base PCIe
Link to heading
La caractéristique principale du PCIe est que les périphériques sont mappés dans le même espace d’adressage que le processeur et la mémoire système, comme illustré sur la figure de droite. Grâce à ce mappage, le processeur peut lire et écrire dans la mémoire du périphérique de la même manière qu’il accède à la mémoire système. On parle alors d’E/S mappées en mémoire (MMIO).
Lors de l’initialisation, lorsque le système vérifie l’arborescence PCIe, une plage d’adresses mémoire est réservée (par le BIOS ou le noyau) pour les régions mémoire de chaque périphérique. Cette adresse réservée est ensuite écrite dans les registres d’adresse de base (BAR) du périphérique. Un périphérique peut posséder jusqu’à six BAR.
Le protocole PCIe utilise des interruptions signalées par message (MSI) au lieu de lignes d’interruption physiques. Les périphériques compatibles MSI envoient une instruction d’écriture en mémoire au processeur, en utilisant une adresse et une charge utile spécifiques fournies par le système. Le processeur lit cette instruction et utilise ces informations pour déclencher une interruption.
MSI-X est une extension de MSI qui permet jusqu’à 2 048 vecteurs d’interruption différents. L’un de ses avantages est qu’une interruption MSI-X peut cibler un cœur de processeur spécifique dans les systèmes multicœurs. De plus, différents vecteurs MSI-X peuvent signaler différents types d’événements.
Conception optimisée pour ConnectX-8
Link to heading
[1] Communication GPU-à-GPU entre deux sockets CPU : dans une architecture traditionnelle, ce chemin peut rencontrer des limitations au niveau du CPU hôte et des liaisons inter-sockets, limitant le débit à 25 Go/s, voire moins, en fonction de l’utilisation des liaisons inter-CPU. En revanche, l’architecture optimisée basée sur CX8 permet d’atteindre une bande passante d’E/S de 50 Go/s par GPU pour toutes les communications inter-GPU au sein du cluster, grâce au routage direct de tout le trafic via NCCL sur le réseau.
[2] Communication GPU-NIC : L’architecture optimisée fournit à chaque GPU une bande passante de 50 Go/s dans une configuration GPU-NIC 2:1, que le GPU ou le système hôte prenne en charge PCIe Gen5 ou Gen6.
[3] Transferts GPU à GPU via le même commutateur PCIe : Les systèmes équipés de PCIe Gen6 bénéficient d’une bande passante deux fois supérieure à celle de Gen5, accélérant considérablement les transferts GPU pair à pair via le même commutateur PCIe.
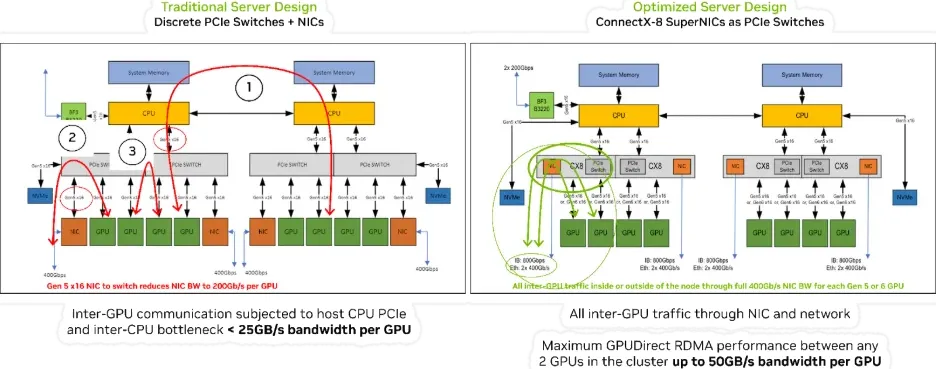
Référence : Architecture de la plateforme NVIDIA ConnectX-8 SuperNICs
RDMA du point de vue d’une API programmatique
Link to heading
Cette section est basée sur Netdev 0x16 RDMA tutorial.
Créez les objets requis, notamment PD et CQ.
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
.cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
Allouer un tampon pour stocker les données et l’enregistrer auprès de libibverbs :
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
Établissement de la connexion avec librdmacm
Link to heading
De type socket, avec une interface asynchrone pilotée par les événements. (Non strictement requis, mais fournit une abstraction qui couvre plusieurs protocoles de transport.) Commencez par créer un « canal d’événements » :
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
Les deux parties résolvent l’adresse du serveur :
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
Le côté passif (SCN) crée et lie un « ID » d’écoute et écoute :
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
Le côté actif crée un identifiant et résout l’adresse du serveur :
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
Boucle d’événements pour la gestion des événements de connexion :
struct rdma_cm_event *event;
while (true) {
err = rdma_get_cm_event(test.channel, &event);
switch (event->event) {
case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
}
rdma_ack_cm_event(event);
}
Événements notables à gérer :
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
Publication de la demande de travail
Link to heading
Remplissez une liste dispersée et mettez en file d’attente les demandes de travail pour recevoir la file d’attente :
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
Remplissez une liste de collecte et mettez en file d’attente les demandes de travail à envoyer :
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
Vérification non bloquante des entrées de la file d’attente de fin
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
end_flag = true;
/* consume cq->status, cq->wr_id, etc */
err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
RDMA du point de vue du GPU direct
Link to heading
C’est là que ça devient… très… compliqué. Quel est le lien entre « GPUDirect RDMA » et RDMA ? Comme mentionné dans un précédent article, la documentation officielle de Nvidia indique qu’il n’y en a aucun ! Pour comprendre pourquoi, il faut remonter aux origines, lorsque cette technologie était encore développée par Mellanox, vers 2016. Voici ce que disait la spécification à l’époque :
La dernière avancée en matière de communication GPU-GPU est GPUDirect RDMA. Cette nouvelle technologie établit un chemin de données P2P (pair à pair) direct entre la mémoire GPU et les périphériques NVIDIA HCA/NIC. Elle permet de réduire considérablement la latence de communication GPU-GPU et de décharger complètement le processeur, le soustrayant ainsi à toutes les communications GPU-GPU sur le réseau.
D’après la spécification GPUNetIO spec, il est indiqué que pour activer l’interaction entre la carte réseau et la mémoire GPU :
Pour permettre à la carte réseau d’envoyer et de recevoir des paquets en utilisant la mémoire GPU, chargez le module noyau NVIDIA nvidia-peermem, généralement inclus avec l’installation du kit d’outils CUDA.
Une application réseau de traitement de paquets GPU peut être divisée en deux phases fondamentales :
Phase de configuration du processeur (configuration des périphériques, allocation de mémoire, lancement des noyaux CUDA…)
Phase de traitement des données où le GPU et la carte réseau interagissent pour exercer leurs fonctions
Lors de la phase d’installation sur le processeur, les applications doivent :
Préparer tous les objets sur le processeur.
Exportez un gestionnaire GPU pour eux.
Lancer un noyau CUDA en passant le gestionnaire GPU de l’objet pour travailler avec celui-ci pendant le traitement des données.
C’est pourquoi DOCA GPUNetIO est composé de deux bibliothèques :
libdoca_gpunetio avec des fonctions appelées par le CPU pour préparer le GPU, allouer de la mémoire et des objets
libdoca_gpunetio_device avec des fonctions invoquées par le GPU au sein des noyaux CUDA pendant le chemin de données
Il s’agit du cas d’utilisation le plus courant de la réception et de l’analyse des en-têtes de paquets. Conçu pour gérer un trafic réseau entrant de 100 Gbit/s, le noyau CUDA responsable du trafic UDP alloue un bloc CUDA de 512 threads CUDA (fichier gpu_kernels/receive_udp.cu) à une file d’attente de réception UDP Ethernet distincte.
La boucle du chemin de données est :
Recevez des paquets avec la fonction GPUNetIO appelée doca_gpu_dev_eth_rxq_receive_block.
Chaque thread CUDA traite un sous-ensemble des paquets reçus.
Récupérer le tampon DOCA contenant le paquet.
Analyser la charge utile du paquet pour distinguer les paquets DNS des autres paquets UDP génériques.
Effacer la charge utile du paquet pour s’assurer que les anciens paquets ne soient pas analysés à nouveau.
Chaque bloc CUDA envoie des statistiques au thread du processeur à l’aide d’un sémaphore DOCA GPUNetIO.
Le thread du processeur vérifie les sémaphores pour obtenir les statistiques et les affiche sur la console.
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
struct doca_gpu_eth_rxq *rxq0,
struct doca_gpu_eth_rxq *rxq1,
struct doca_gpu_eth_rxq *rxq2,
struct doca_gpu_eth_rxq *rxq3,
int sem_num,
struct doca_gpu_semaphore_gpu *sem0,
struct doca_gpu_semaphore_gpu *sem1,
struct doca_gpu_semaphore_gpu *sem2,
struct doca_gpu_semaphore_gpu *sem3)
{
__shared__ uint32_t rx_pkt_num;
__shared__ uint64_t rx_buf_idx;
__shared__ struct stats_udp stats_sh;

doca_error_t ret;
struct doca_gpu_eth_rxq *rxq = NULL;
struct doca_gpu_semaphore_gpu *sem = NULL;
struct doca_gpu_buf *buf_ptr;
struct stats_udp stats_thread;
struct stats_udp *stats_global;
struct eth_ip_udp_hdr *hdr;
uintptr_t buf_addr;
uint64_t buf_idx = 0;
uint32_t lane_id = threadIdx.x % WARP_SIZE;
uint8_t *payload;
uint32_t sem_idx = 0;

if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

if (threadIdx.x == 0) {
DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}
__syncthreads();

while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
stats_thread.dns = 0;

/* No need to impose packet limit here as we want the max number of packets every time */
ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
/* If any thread returns receive error, the whole execution stops */
if (ret != DOCA_SUCCESS) { ... }

if (rx_pkt_num == 0) continue;

buf_idx = threadIdx.x;
while (buf_idx < rx_pkt_num) {
doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
raw_to_udp(buf_addr, &hdr, &payload);

if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

/* Double-proof it's not reading old packets */
wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
buf_idx += blockDim.x;
}
__syncthreads();

for (int offset = 16; offset > 0; offset /= 2) {
stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
__syncwarp();
}

if (lane_id == 0) {
atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
}

__syncthreads();

if (threadIdx.x == 0 && rx_pkt_num > 0) {
ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
if (ret != DOCA_SUCCESS) { ... }

DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
__threadfence_system();

sem_idx = (sem_idx + 1) % sem_num;

DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}

__syncthreads();
}
}
Dans l’exemple ci-dessus, RDMA n’est pas utilisé. GPUNetIO permet simplement au GPU de traiter directement les données des paquets. Le seul point commun avec RDMA est que le paquet passe directement de la carte réseau au GPU par un transfert DMA, sans passer par la mémoire du processeur.
Avant de conclure, un point reste obscur : DOCA RDMA. Dans la section précédente, nous avons examiné DOCA GPUNetIO. Mais qu’est-ce que DOCA RDMA, et comment se compare-t-il à l’API « ibv » que nous avons étudiée précédemment ?
La réponse est simple : DOCA RDMA est le framework logiciel NVIDIA permettant d’effectuer des opérations RDMA sur le CPU ou le GPU. IBV est la bibliothèque InfiniBand Verbs traditionnelle, de bas niveau, qui fait partie de l’API standard pour la programmation des matériels InfiniBand et RoCE. La principale différence réside dans le fait que DOCA RDMA est un SDK de plus haut niveau et plus complet, qui s’appuie sur les fonctionnalités fondamentales de l’interface Verbs, permettant l’accélération GPU et le déchargement des tâches RDMA du CPU vers le GPU.
Par exemple, voici le code pour l’envoi d’un paquet RDMA :
doca_error_t rdma_send(struct rdma_config *cfg)
{
struct rdma_resources resources = {0};
union doca_data ctx_user_data = {0};
const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
doca_error_t result, tmp_result;

/* Allocating resources */
result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
doca_rdma_cap_task_send_is_supported,  &resources);

result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
rdma_send_error_callback, NUM_RDMA_TASKS);

result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

/* Include the program's resources in user data of context to be used in callbacks */
ctx_user_data.ptr = &(resources);
result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

/* Create DOCA buffer inventory */
result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

/* Start DOCA buffer inventory */
result = doca_buf_inventory_start(resources.buf_inventory);

/* Start RDMA context */
result = doca_ctx_start(resources.rdma_ctx);

/*
* Run the progress engine which will run the state machine defined in
* rdma_send_state_change_callback(). When the context moves to idle, the context change
* callback call will signal to stop running the progress engine. */
while (resources.run_pe_progress) {
if (doca_pe_progress(resources.pe) == 0)
nanosleep(&ts, &ts);
}

// ... cleanup
}
Sortir des sentiers battus : Et si ce n’était pas RDMA ?
Link to heading
Dans la section précédente, nous avons examiné différents aspects du RDMA. Son objectif principal est de transférer des données entre les CPU, les GPU et la pile de contrôle quantique, avec une latence de quelques microsecondes. De nombreuses informations doivent être transférées : données de lecture logicielle I/Q, échantillons d’impulsions de contrôle (« ondes ») ou encore la configuration paramétrique des impulsions, généralement dans le contexte d’un réseau neuronal. Il est également nécessaire de transférer des informations plus simples, comme les syndromes des qubits logiques, et d’appeler à distance un décodeur QEC dans l’unité de calcul. Dans ce dernier cas, on peut simplement appeler ce comportement « appel de procédure distante » (RPC).
L’avantage est qu’il existe une abondante documentation sur les RPC sur RDMA, notamment mRPC, qui présente des résultats de latence très intéressants, basés sur la carte réseau Mellanox Connect-X5 RoCE 100 Gbit/s. L’article comporte une confusion : il affirme que « sur RDMA, mRPC accélère eRPC de 1,3× et 1,4× en termes de latence médiane et de latence de queue (respectivement) », alors que le tableau indique qu’eRPC est plus rapide que mRPC. Cependant, on peut supposer pour l’instant que ces résultats de latence sont plausibles.
 Plus intéressant encore est le document [https://www.usenix.org/system/files/atc24-ma.pdf] faisant suite à mRPC, où un Compute Express Link (CXL) est utilisé pour créer un RPC encore plus rapide, baptisé « HydraRPC ». Les chiffres parlent d’eux-mêmes ; voir le tableau à droite. La question qui se pose est : quel sera l’état de cette technologie dans 5 ans ? À mon avis, NVLink représente également une opportunité très intéressante…
Voilà, j’ai mis plus de temps à rédiger cette note, et je pense que cela m’a permis de mieux comprendre. Je crois que la confusion entre RDMA et GPUDirect vient du fait que RDMA a été initialement développé par Mellanox comme une simple amélioration du réseau. Après le rachat de Mellanox par Nvidia, son fonctionnement a été étendu pour permettre la connexion au GPU, mais cette extension n’a jamais été conçue dès le départ et s’est finalement transformée en un module complémentaire de l’écosystème DOCA.

References:
DrawIO diagrams used in this memo: