Ce document revient sur les fondamentaux du GPU. Il se concentre sur l’opération de base du deep learning : la multiplication matricielle. Je décrirai d’abord l’implémentation de base et académique, puis j’examinerai les optimisations nécessaires pour une utilisation efficace du GPU.
Comprendre le multiplicateur matriciel naïf
Link to heading
Commençons par cet exemple simple que l’on retrouve souvent dans les manuels scolaires.
/**
* Kernel to perform matrix multiplication C = A × B
* A is of size N x M, B is M x N, and C is N x N
* Each thread computes one element of matrix C.
*/

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

// Calculate global row and column for this thread
int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

if (row < N && col < N) {
float sum = 0.0f;
for (int k = 0; k < M; k++) {
// C[row][col] = sum(A[row][i] * B[i][col])
sum += A[row * N + k] * B[k * N + col];
}
C[row * N + col] = sum;
}

}
À première vue, cela semble simple. Il suffit de calculer chaque cellule de la matrice de sortie C. Ce code noyau semble fonctionner correctement. Voici une représentation plus visuelle du noyau.
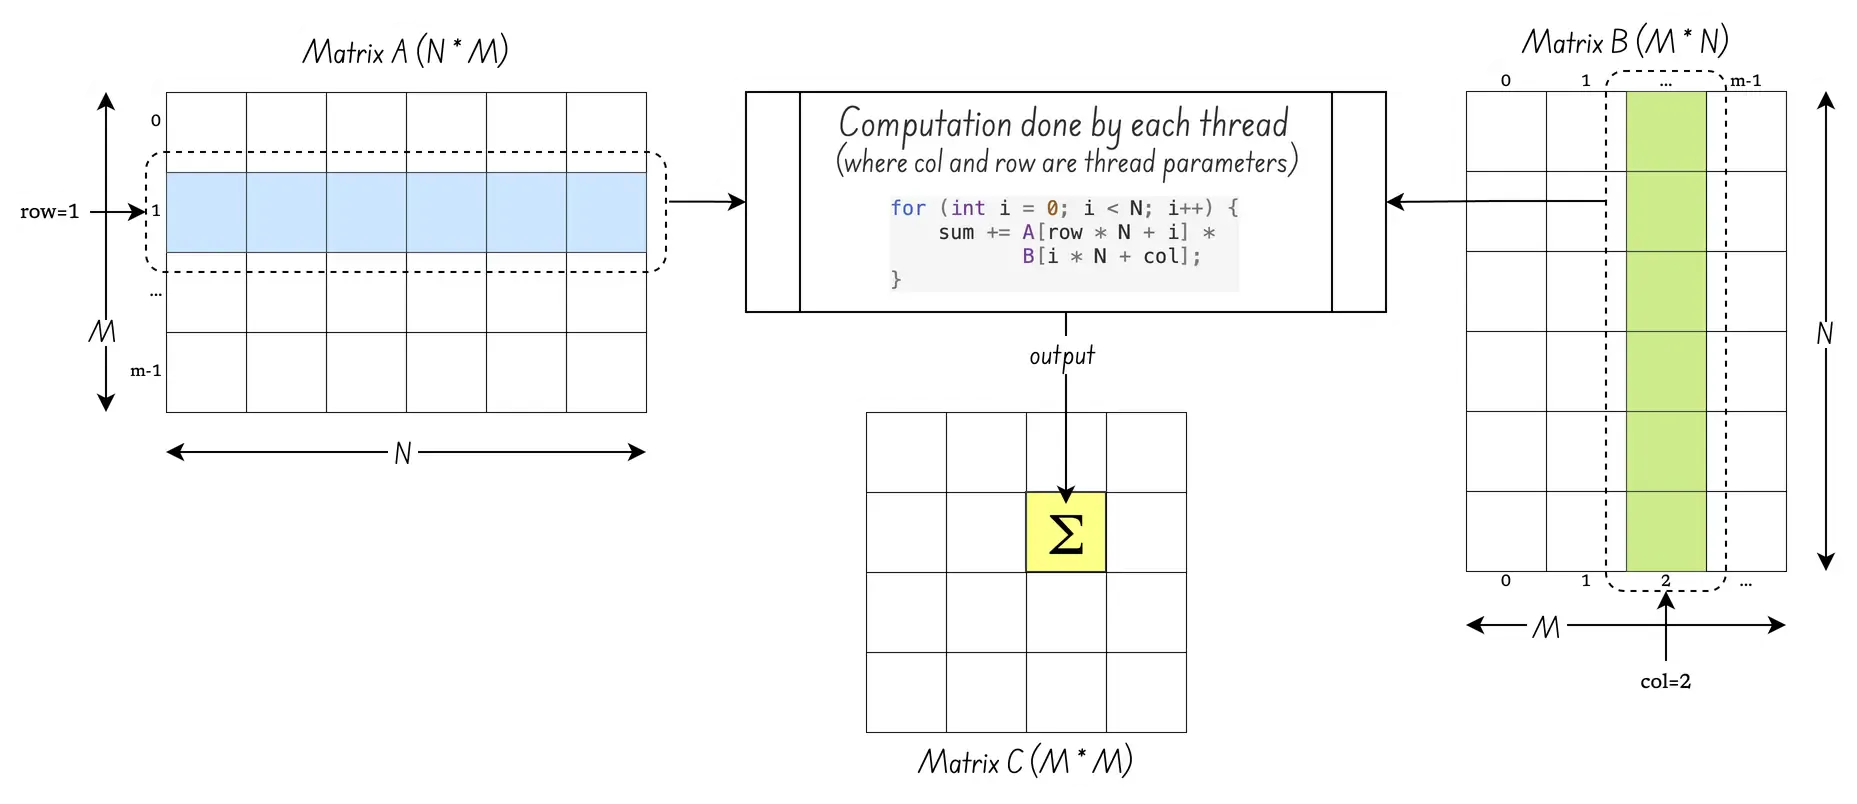
La réalité est un peu plus complexe. Comment interpréter blockIdx, blockDim et threadIdx ? Pour le comprendre, revenons à l’architecture des GPU, organisée autour des threads, des warps et des multiprocesseurs de flux. Voici une représentation subjective de la microarchitecture GPU « Hopper » H100 de Nvidia :
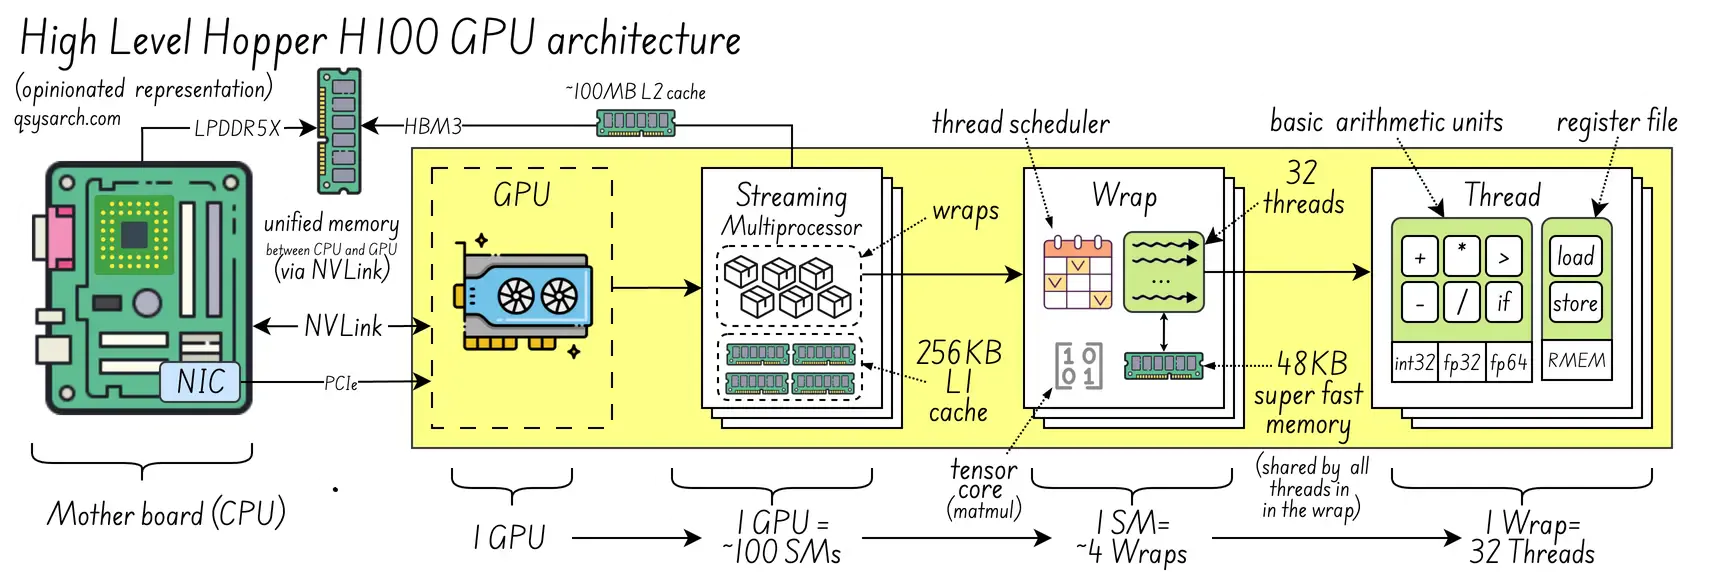
De manière générale :
1 GPU = 10 à 100 multiprocesseurs de flux
1 multiprocesseur de flux = 4 à 64 encapsulations
1 tour = 32 à 64 fils
Mais alors, comment le fragment de code qui calcule sum est-il associé à un thread, un warp, voire un multiprocesseur de flux ? Où sont prises les décisions d’allocation et de mappage ? Il faut d’abord comprendre comment le noyau est configuré :
int launch_kernel(float *d_A, *d_B, *d_C) {

dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

// 2. Launch the kernel with the specified dimensions
naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
Cette configuration hiérarchique est mappée sur le matériel GPU comme suit :

Avec cette configuration, il est possible de multiplier une matrice de taille N égale à 16*4 = 64. Que se passe-t-il si N vaut 1000 ? Dans ce cas, il suffit de définir la taille de la grille à (1000+15)/16.
Qu’en est-il de la correspondance avec le matériel physique ? Cela signifie-t-il que des blocs sont alloués aux warps ? Que se passe-t-il si le nombre de threads dans le bloc est supérieur au nombre de threads matériels ?
C’est là qu’intervient la planification des tâches du GPU. En résumé, si le nombre de threads nécessaires dépasse le nombre de threads disponibles sur le matériel physique, le GPU allouera plusieurs warps :
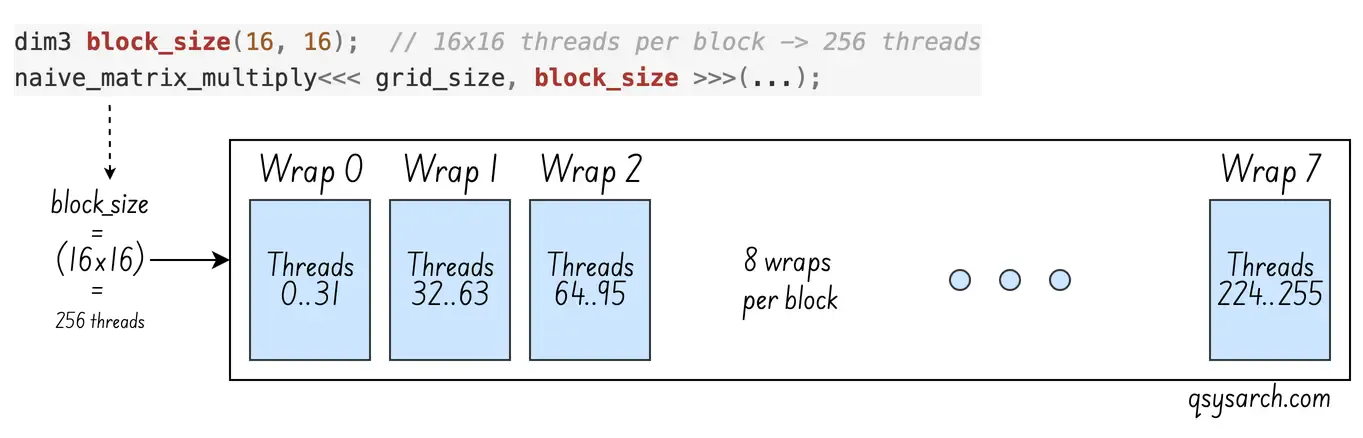
La question suivante est de savoir comment les 8 warps nécessaires par bloc sont associés au multiprocesseur de flux, notamment lorsque ce dernier possède moins de warps que nécessaire pour un bloc. La réponse est remarquable : un multiprocesseur de flux peut gérer plus de 4 warps, qu’il planifie en alternance. Dès qu’un warp est bloqué par un accès mémoire, le multiprocesseur de flux bascule immédiatement vers un autre warp. Ce mécanisme, appelé masquage de latence, est la stratégie fondamentale pour optimiser les performances du GPU. Sans lui, l’efficacité ne serait pas aussi élevée.
Considérons maintenant grid_size. Est-ce que grid_size est directement associé à des ressources matérielles ? Non. La grille est un concept logique. Elle garantit la disponibilité de suffisamment de blocs pour couvrir la matrice. grid_size ne correspond pas à du matériel. Les blocs sont alloués à chaque SM à l’exécution, à partir d’une file d’attente.
L’allocation est basée sur les ressources nécessaires au bloc (chaque enveloppe a un nombre limité de registres, et il faut s’assurer que chaque bloc dispose de son propre ensemble de registres alloués statiquement).
Lorsqu’un bloc a terminé son calcul, le SM extrait un nouveau bloc de la file d’attente du planificateur pour le remplacer. Une fois affecté, le bloc est lié à ce SM et ses registres sont alloués pour l’exécution.
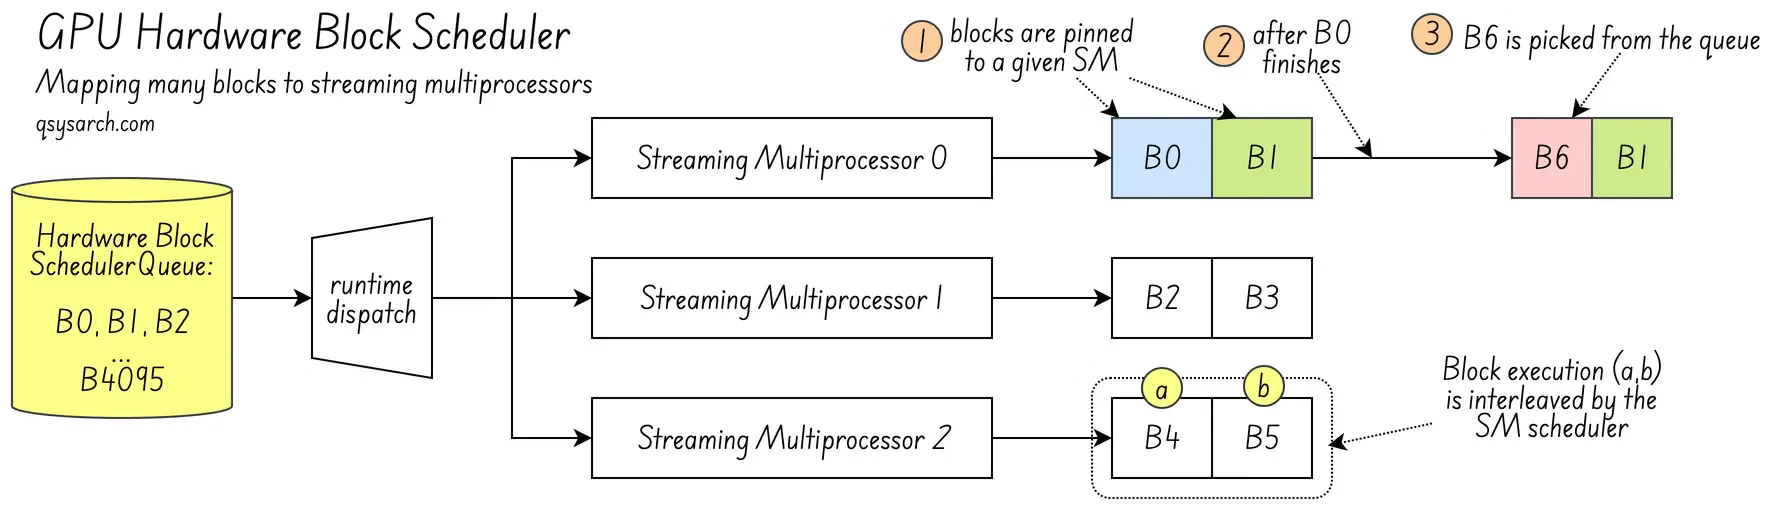
Une dernière question : les blocs sont-ils rattachés au SM ou au warp ? La mémoire utilisée par les threads du bloc est-elle allouée dans le warp ? Si ce n’est pas le cas, le SM devrait déplacer la mémoire entre les warps. Oui, au sein du SM, les warps d’un bloc sont rattachés. Si le bloc 0 est alloué au warp 0 et le bloc 1 au warp 1, ce sera toujours le cas.
Amélioration du multiplicateur matriciel naïf
Link to heading
Maintenant que nous comprenons l’exécution concurrente des threads, considérons le noyau de multiplication matricielle simple. Tous les threads se disputent l’accès mémoire aux matrices A et B. Chaque thread extrait une ligne entière de A et une colonne de B de la mémoire globale. Il n’y a pas de réutilisation. B est accédée colonne par colonne (B[i * N + col]), ce qui rend l’accès en rafale et la mise en cache mémoire inefficaces.
La solution la plus simple consiste à utiliser la mémoire partagée. Commencez par charger une partie de la matrice dans la mémoire du warp sous forme de tuile de taille T*T. Ensuite, autorisez les threads à lire uniquement à partir de cette mémoire locale. Ainsi, les threads n’entrent pas en concurrence pour l’accès à la mémoire. Grâce à l’entrelacement des warps, le SM garantit que pendant qu’un warp charge des données dans le cache, l’autre warp calcule la somme. Voici le noyau amélioré :
__global__ void matmul_tiled(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x,  ty = threadIdx.y;
int row = blockIdx.y * T + ty;   // global row in C
int col = blockIdx.x * T + tx;   // global col in C

float accumulator = 0.0f;
for (int t = 0; t < M; t += T) {

// Read [T,T] subtile from matrix A and B.
// Assume that M and N are multiples of T (no bound check)
A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();   // wait all threads to finish loading

for (int k = 0; k < TILE; ++k)
accumulator += A_shared[ty][k] * B_shared[k][tx];

__syncthreads();   // all threads are ready to load again
}
C[row * N + col] = accumulator;
}
Par souci de simplicité, je suppose que M et N sont des multiples de T, il n’y a donc pas de vérification des limites lors du chargement de la matrice globale dans A_shared et B_shared.
Ce code recèle une petite astuce. Tous les threads du bloc exécutent la même lecture mémoire : A[row * M + t + tx]. Comme t est contigu, les threads lisent dans la même zone mémoire. Ceci permet l’accès rapide à la mémoire et la mise en cache. Le premier thread initie la lecture rapide. Les autres threads utilisent le cache ainsi rempli. B n’étant pas transposé, cette astuce ne fonctionne pas pour B. De plus, __syncthreads() synchronise les threads au sein d’un bloc, garantissant qu’ils s’exécutent sur le même SM.
Avec le multiplicateur naïf précédent, la taille des blocs était arbitraire. Avec l’approche par tuiles, la taille des blocs doit correspondre à la taille des tuiles T*T, comme le montre le diagramme :
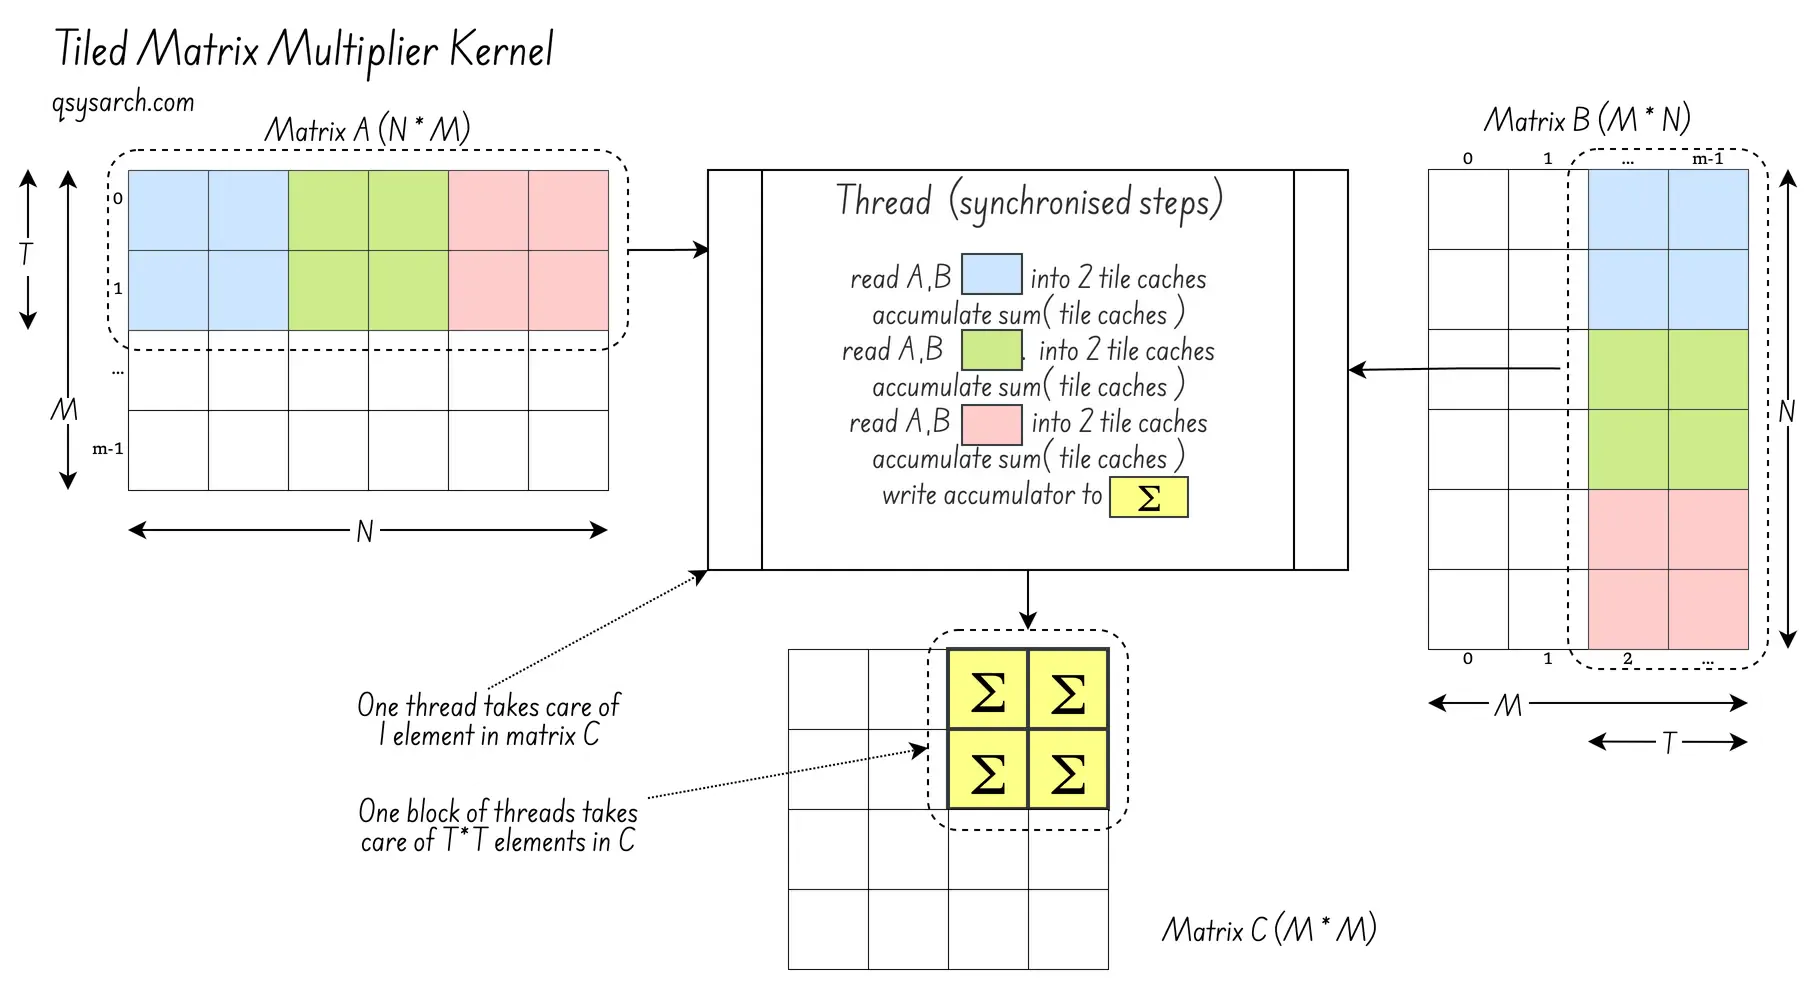
L’approche par blocs permet le chargement pendant que d’autres effectuent le calcul. Dans ce cas, le calcul peut être léger et prendre moins de temps que le chargement en mémoire. Pour résoudre ce problème, il faut augmenter la charge de travail par thread pendant le calcul. Chaque thread peut calculer un ensemble d’éléments 2x2 au lieu d’un seul. Avec K=2 et T multiple de K, cela est possible.
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x, ty = threadIdx.y;
int rowBase = blockIdx.y * T * K + ty;
int colBase = blockIdx.x * T * K + tx;

float accumulators[K][K]; // That's register memory

for (int t = 0; t < M; t += TILE) {

A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();

for (int k = 0; k < TILE; ++k)
for (int wr = 0; wr < K; ++wr)
for (int wc = 0; wc < K; ++wc)
acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

__syncthreads();
}

// Write out the T×T accumulated result
for (int wr = 0; wr < T; ++wr)
for (int wc = 0; wc < T; ++wc) {
int r = rowBase + wr * (T/K);
int c = colBase + wc * (T/K);
C[r * N + c] = acc[wr][wc];
}
}
Voilà ! C’est en gros comme ça que fonctionne une unité GEMM (Multiplication Matricielle Générale) !
Ensuite, je devrais présenter des composants matériels spécifiques comme le Tensor Core (NVIDIA) ou le Matrix Fused Multiply-Add (AMD). Ce sont des unités spécialisées du multiprocesseur de flux qui calculent les multiplications cumulées T*T*K. J’en reparlerai dans une note ultérieure !
References:
DrawIO diagrams used in this memo: