Lors de la compilation pour les GPU NVIDIA, CUDA est souvent considéré comme le framework de compilation de référence. Mais comment fonctionne-t-il concrètement ? Quel type d’architecture de jeu d’instructions (ISA) doit-il générer pour créer un exécutable pour le GPU ? Et comment fonctionne-t-il précisément ? Quelle architecture est utilisée pour générer du code pouvant être lancé depuis un CPU et exécuté sur un GPU ?
Cette note de service du dimanche matin offre une vue d’ensemble de l’architecture du compilateur GPU NVIDIA. Elle aborde le jeu d’instructions GPU, le compilateur NVCC dans l’environnement CUDA et, enfin, les architectures alternatives ciblant le jeu d’instructions GPU.
Architecture GPU de bas niveau
Link to heading
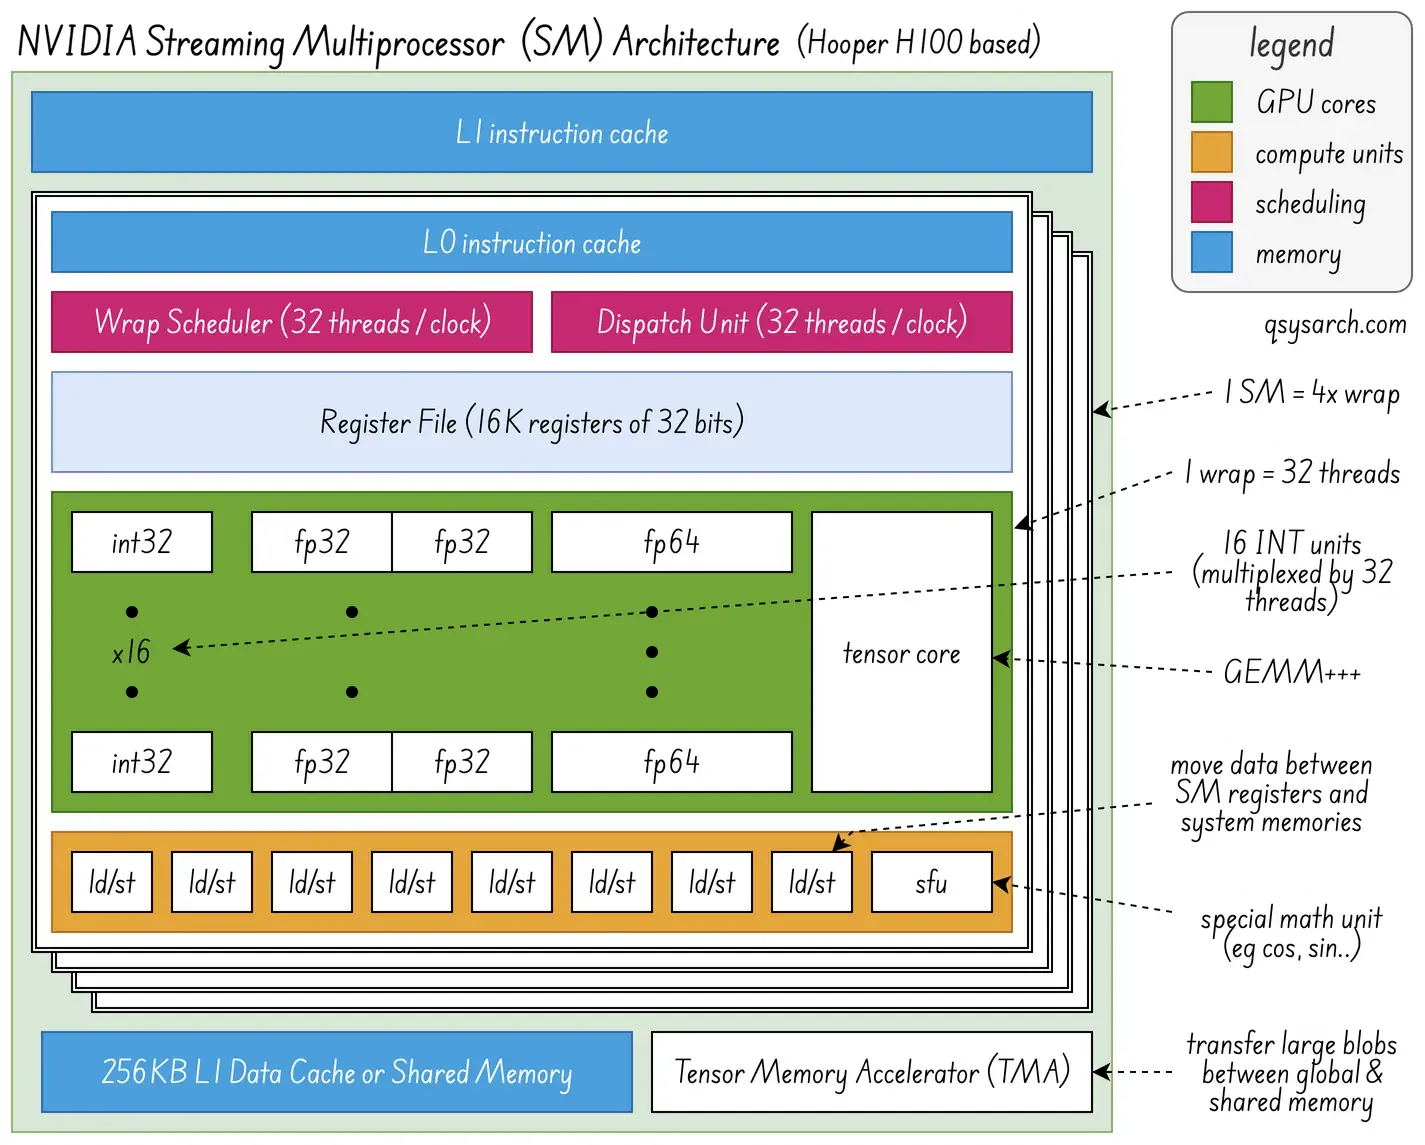
Lorsqu’on cible un périphérique comme un GPU, il faut un jeu d’instructions pour le programmer. Chez NVIDIA, ce périphérique est le multiprocesseur de flux (SM), représenté dans le schéma de droite. Ce schéma met en évidence la présence de nombreuses unités concurrentes, telles que les additionneurs IN32, l’unité de fonctions spéciales et le cœur tensoriel GEMM+++. Le compilateur doit veiller à ce que ces unités soient utilisées (pipelinées) de la manière la plus efficace possible (l’efficacité étant définie comme la minimisation du temps d’inactivité).
Voici la terminologie utilisée :
ISA (Instruction Set Architecture) : ensemble d’instructions.
Code machine : représentation compacte et binaire des instructions
Assemblage (langage) : représentation textuelle moins compacte des instructions
Il existe deux ISA pour les GPU NVIDIA :
PTX: Exécution de threads parallèles - Assemblage intermédiaire utilisé lors de la compilation des noyaux Cuda.
SASS : Assemblage en flux continu. Assemblage de bas niveau, spécifique à chaque architecture GPU.
Supposons que nous voulions compiler ce noyau :
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
int i = blockIdx.x * blockDim.x + threadIdx.x;

float vx = x[i], vy = y[i];
float len2 = vx*vx + vy*vy;
float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
z[i] = invLen; // Normalized length
}
Le secret réside dans le fait que rsqrtf doit être traité par le pipeline SFU. Comment cela fonctionne-t-il ? La ligne float invLen = rsqrtf(len2); est convertie en PTX sous la forme rsqrt.approx.ftz.f32, puis en SASS sous la forme MUFU.RSQ, comme illustré dans l’image ci-dessous provenant de [godbolt](https://godbolt.org/#g:!((g:!((g:!((h:codeEditor,i:(filename:'1',fontScale:14,fontUsePx:'0',j:1,lang:cuda,selection:(endColumn:2,endLineNumber:15,positionColumn:2,positionLineNumber:15,selectionStartColumn:2,selectionStartL numéro_ligne:15,colonne_début:2,numéro_ligne_début:15),source:’global+void+normalizeVector(float*+x,+float*+y,+float*+z,+int+n)%0A%7B%0A++++int+i+%3D+blockIdx.x++blockDim.x+%2B+threadIdx.x%3B%0A%0A++++float+vx+%3D+x%5Bi%5D%3B%0A++++float +vy+%3D+y%5Bi%5D%3B%0A++++float+len2+%3D+vxvx+%2B+vyvy%3B%0A%0A++++//+Utiliser+SFU+rapide+réciproque+carré+racine%0A++++flo at+invLen+%3D+rqrtf(len2)%3B+%0A%0A++++//+Normaliser+le+vecteur%0A++++x%5Bi%5D+%3D+vx++invLen%3B%0A++++y%5Bi%5D+%3D+ vy+*+invLen%3B%0A%7D’),l:‘5’,n:‘0’,o:‘CUDA+C%2B%2B+source+%231’,t:‘0’)),k:33.333333333333336,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:compiler,i:(compiler:nvcc130u2,filters:(b:‘0’,binary:‘1’,binaryObject:‘1’,commentOnly:‘0’,debugCalls:‘1’, demangle:‘0’,directives:‘0’,execute:‘1’,intel:‘0’,libraryCode:‘0’,trim:‘1’,verboseDemangling:‘0’),flagsViewOpen:‘1’,fontScale:14,fontUsePx:‘0’,j:1,lang:cuda,libs:!(),options:’-arch+sm_90+-use_fast_math+-O3’,overrides:!(),selection:(en dColumn:1,endLineNumber:1,positionColumn:1,positionLineNumber:1,selectionStartColumn:1,selectionStartLineNumber:1,startColumn:1,startLineNumber:1),source:1),l:‘5’,n:‘0’,o:’+NVCC+13.0.2+(Editor+%231)’,t:‘0’)),k:33.333333333333336,l:‘4’ ,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:device,i:(compilerName:‘NVCC+13.0.2’,device:‘SASS+(sm_90)’,editorid:1,fontScale:14,fontUsePx:‘0’,j:1,selection:(endColumn:6,endLineNumber:21,positionColumn:1,positionLineNumber:1,selectionStartColumn:6,s electionStartLineNumber:21,startColumn:1,startLineNumber:1),treeid:0),l:‘5’,n:‘0’,o:‘Device+Viewer+NVCC+13.0.2+(Editor+%231,+Compiler+%231)’,t:‘0’)),k:33.33333333333333,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’)),l:‘2’,n:‘0’,o:’’,t:‘0’)),version:4).
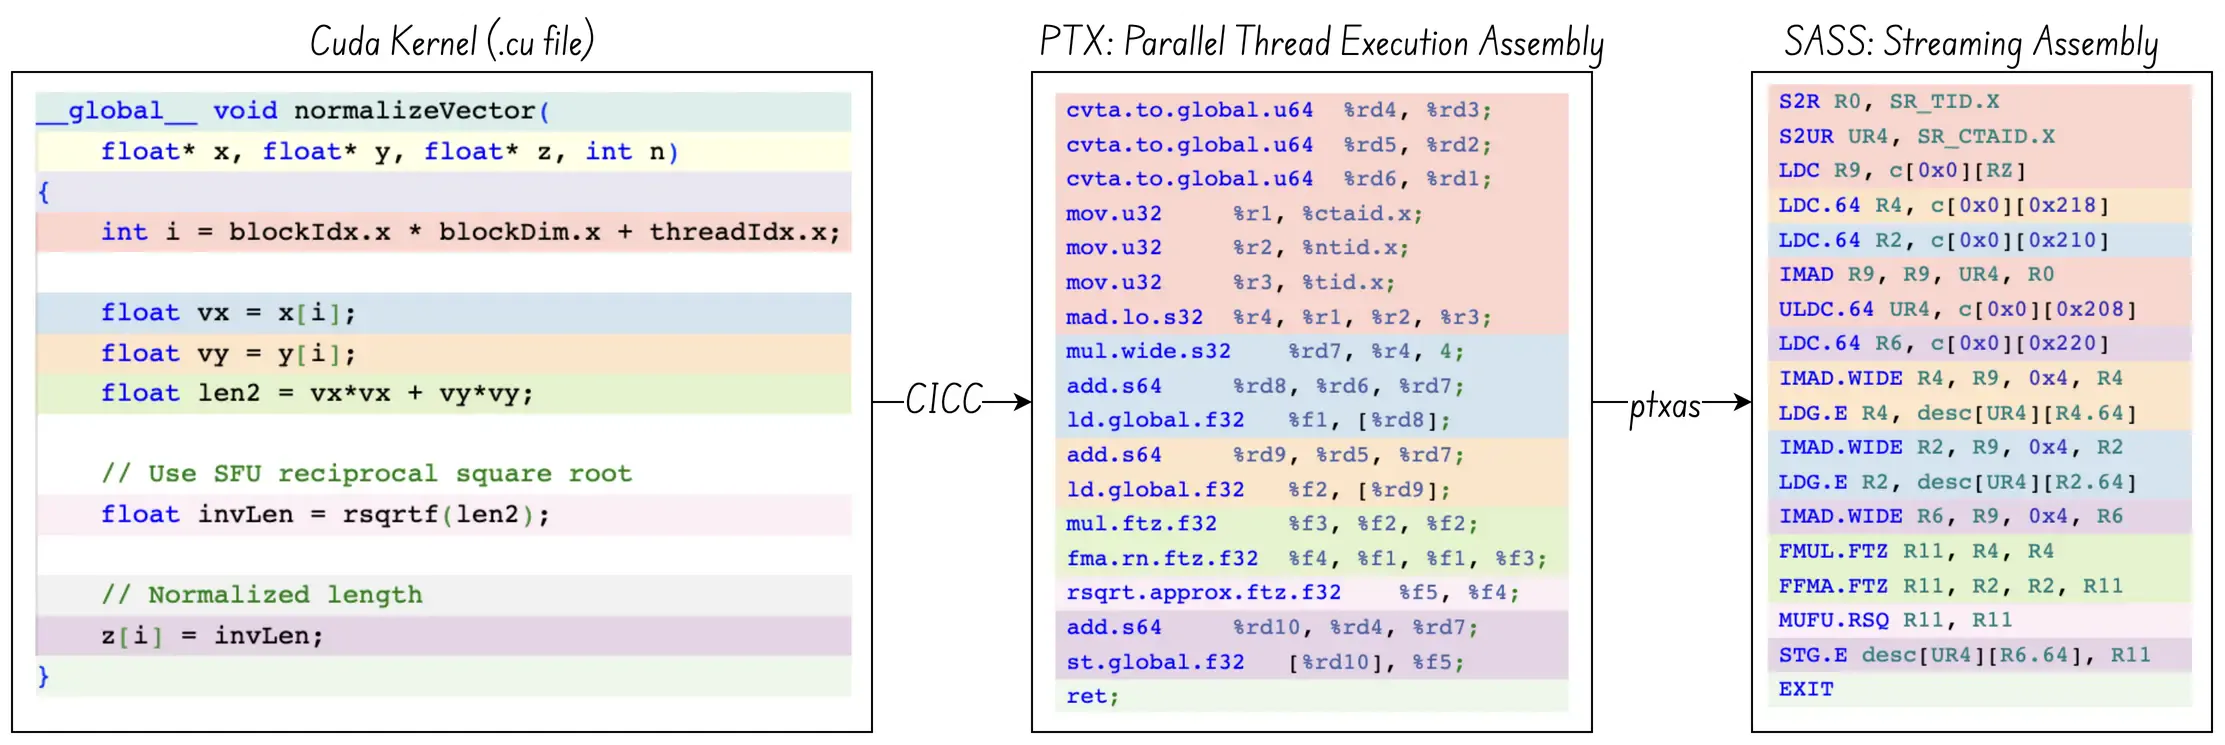
MUFU signifie unité multifonction, également connue sous le nom de SFU, l’unité de fonction spéciale. L’instruction MUFU.RSQ achemine le registre à travers le pipeline de calcul de la racine carrée de l’unité SFU. De nombreuses autres instructions en assembleur SASS, telles que FMUL (Fused Multiply) ou FFMA (Fused Multiply and Accumulate), sont quant à elles envoyées à l’unité de calcul du tenseur. L’unité de distribution est chargée d’envoyer les instructions à l’unité de pipeline appropriée.
Il y a trois points à noter :
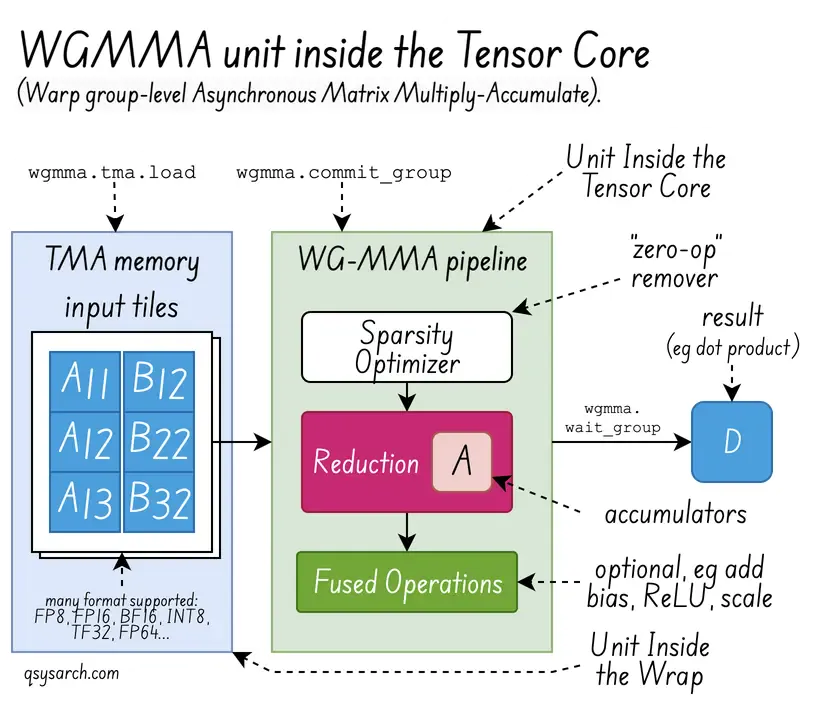
Le tenseur est bien plus qu’un multiplicateur de matrice général (GEMM) : par exemple, il peut effectuer des opérations de réduction (somme, min/max, produit scalaire) via une unité MMA (multiplication-accumulation de matrices) à l’intérieur du noyau du tenseur.
La différence entre une unité INT32 et un registre : l’unité est responsable du calcul (par exemple, ADD, SHIFT, XOR, … ou plus généralement des opérations arithmétiques, ou ALU) tandis que le registre est responsable du stockage des valeurs.
Il n’y a que 16 unités INT32, mais 32 threads. Ce n’est pas une erreur : le planificateur de warp alterne entre deux ensembles de threads à chaque cycle. Ainsi, au cycle 0, les unités effectuent les opérations ALU pour les threads 0 à 15, et au cycle 1, pour les threads 16 à 31.
Les instructions WGMMA (Asynchronous Warpgroup Level Matrix Multiply-Accumulate Instructions) sont extrêmement puissantes. Pour en savoir plus, consultez la documentation NVIDIA ainsi que l’excellent blog d’Aleksa Gordić.
Architecture du compilateur NVIDIA CUDA
Link to heading
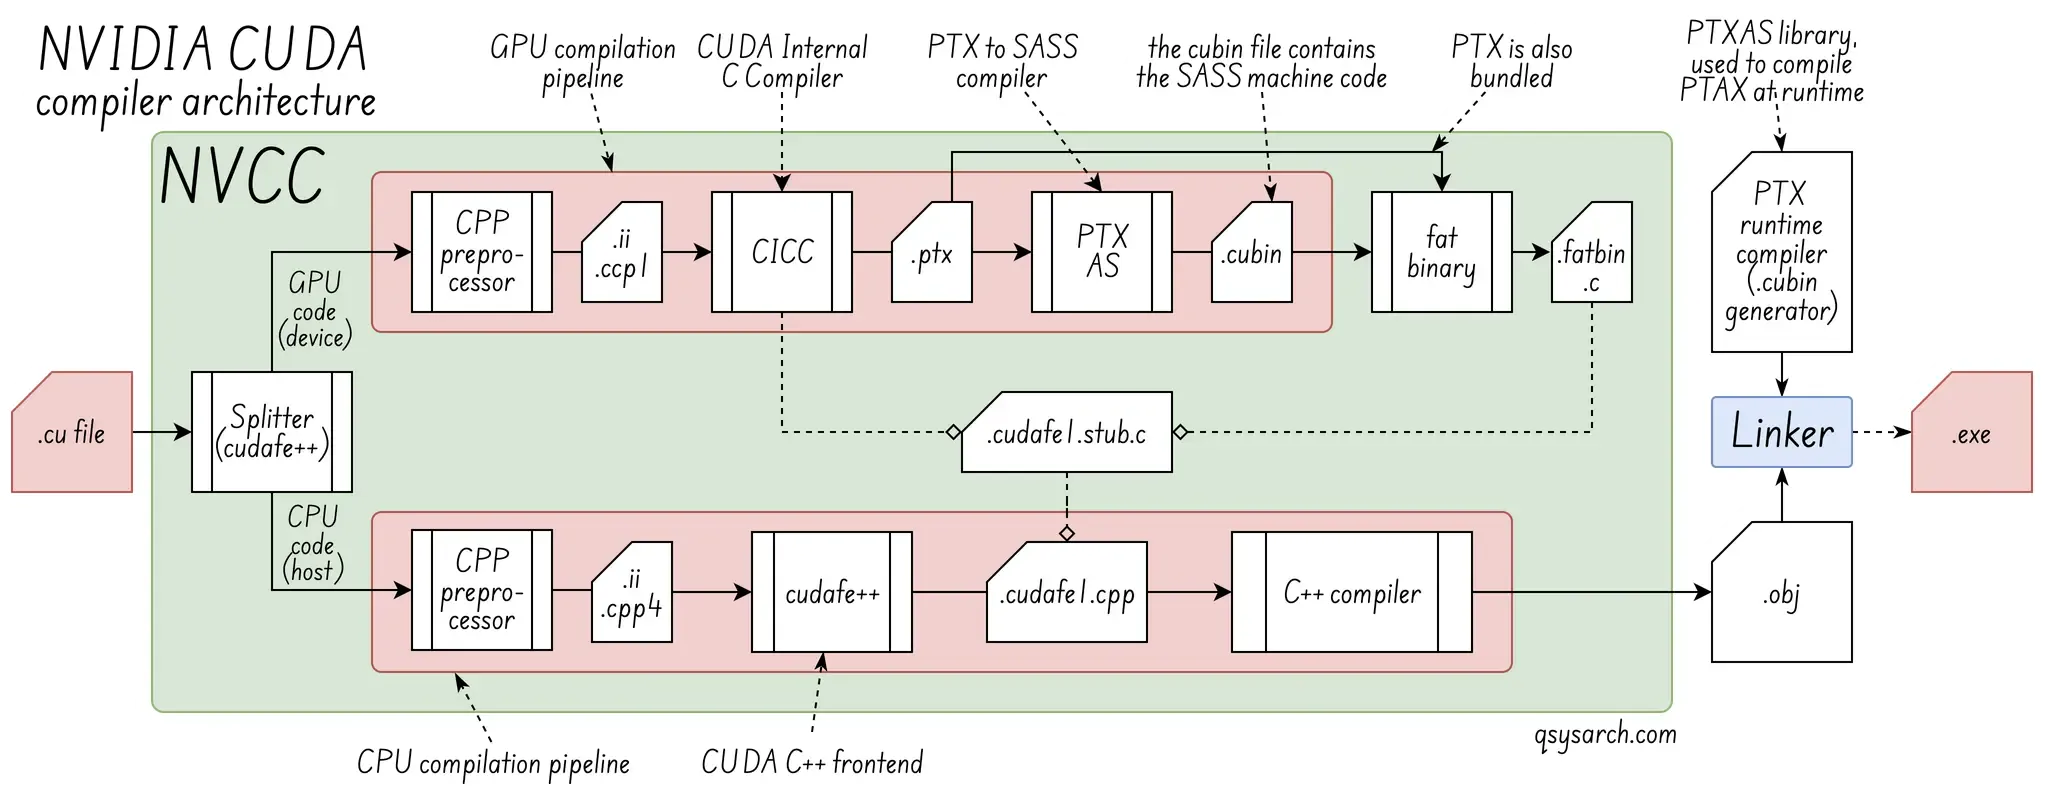
Maintenant que nous comprenons mieux l’ISA de bas niveau du GPU pour la programmation du multiprocesseur de flux GPU, essayons de comprendre comment les noyaux C++ de haut niveau sont compilés en SASS. Nous savons que le compilateur utilisé pour convertir les noyaux CUDA (fichiers .cu) en PTX s’appelle NVCC.
Quelle est donc la différence entre NVCC et LLVM ? NVCC est un pilote de compilation spécialisé qui utilise l’infrastructure de compilation open source LLVM comme moteur. À l’inverse, LLVM est un framework de compilation flexible, et non un compilateur prêt à l’emploi comme NVCC.
Programme pilote : NVCC est un pilote qui gère le processus de compilation du code CUDA C/C++. Il sépare le code hôte (CPU) du code périphérique (GPU).
Chaîne d’outils : NVCC est une chaîne d’outils qui utilise un compilateur C++ hôte (par exemple GCC/Clang sous Linux) pour le code CPU et un compilateur interne spécifique à NVIDIA (par exemple CICC) pour le code GPU (PTX et SASS).
Binaires volumineux : NVCC produit généralement des « binaires volumineux » qui incluent à la fois l’exécutable hôte et le code GPU compilé, souvent avec plusieurs versions pour différentes architectures GPU.
Cadre de développement : LLVM est une collection de technologies, de bibliothèques et d’outils de compilation libres, ouverts, modulaires et réutilisables, conçus pour construire une grande variété de compilateurs et de chaînes d’outils de langage.
Représentation intermédiaire (IR) : LLVM IR est une « couche intermédiaire » indépendante de la machine qui sert de lien universel entre les frontaux (C++, Go…) et les backaux ISA (x86, ARM…).
Optimisation : L’optimiseur LLVM applique diverses améliorations de performances (comme le déroulement de boucle et l’élimination du code mort) à l’IR, indépendamment du langage source ou de l’architecture cible.
Il convient de noter que LLVM peut compiler CUDA : le front-end Clang (qui fait partie du projet LLVM) peut gérer le code CUDA avec le back-end LLVM PTX, sans nécessiter le pilote nvcc.
Architecture du compilateur Triton
Link to heading
Le langage Triton est un puissant langage spécifique au domaine (DSL) basé sur Python, conçu pour aider à créer des algorithmes vectorisés de haut niveau qui peuvent être compilés en code parallélisé efficace pour les cibles GPU.
Voici un exemple de noyau très simple, qui charge des données depuis un bloc mémoire et les écrit dans un autre. La valeur de offsets est [pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1]. La magie, non visible dans cet extrait de code, réside dans la capacité de Triton à opérer efficacement sur le vecteur v, notamment en effectuant des opérations mathématiques.
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
pid = tl.program_id(axis=0)
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
v = tl.load(x_ptr + offsets)
tl.store(output_ptr + offsets, v)
Triton ne se limite pas aux vecteurs 1D et peut gérer plusieurs dimensions grâce aux tenseurs. Par exemple :
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
M , N , # Number of rows and columns
BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
# X and Y tile position
pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
# Ptr in memory based on the stride
base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
# Offsets for X and Y indices
offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
# 2D loading ...that's magic!
loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
return loaded_2d_tensor
Comparé à CUDA, Triton peut être considéré comme une abstraction de plus haut niveau, dédiée à la construction de noyaux de réseaux neuronaux (grâce à l’approche par blocs tensoriels), et capable de générer du code GPU vectorisé et parallèle efficace. Triton prend également en charge plusieurs GPU backend.
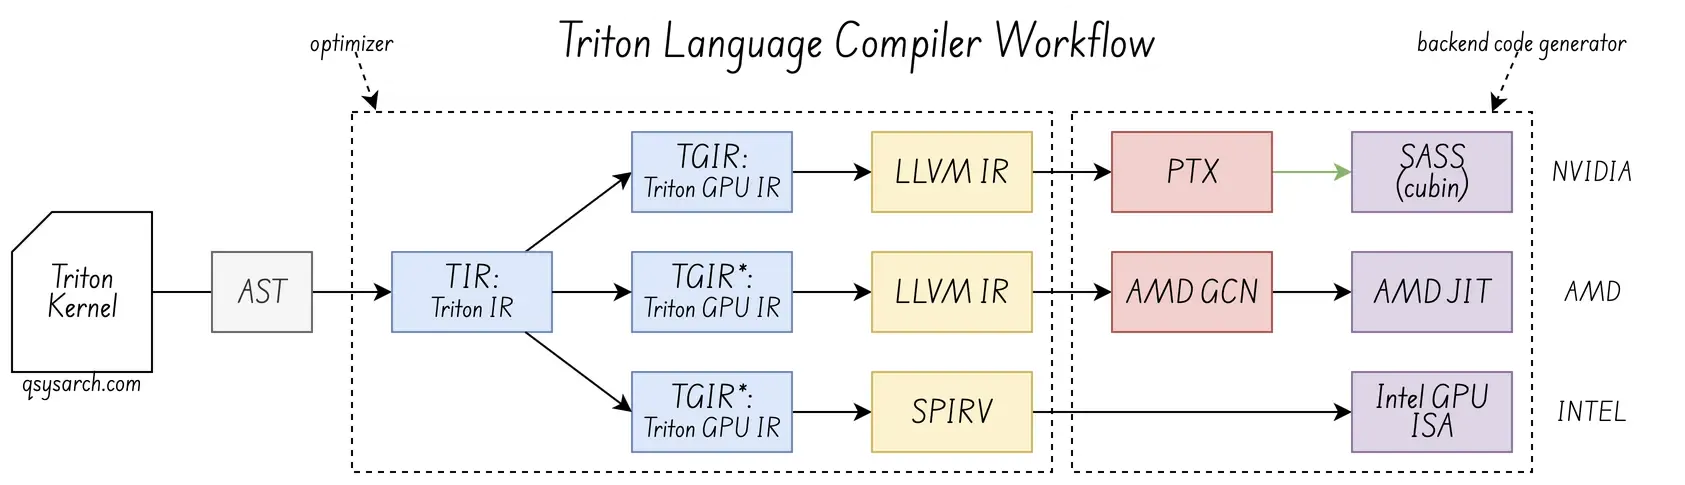
Triton n’utilise pas son propre analyseur syntaxique. Il s’appuie plutôt sur l’environnement d’exécution et l’AST de Python, puis convertit cet AST en ses propres représentations intermédiaires, TIR et TGIR, avant de générer le code GPU. Le lien entre le compilateur CUDA et le compilateur Triton est assuré par le compilateur universel LLVMIR (https://mcyoung.xyz/2023/08/01/llvm-ir/), et pour les GPU Intel, il est basé sur SPIRV (https://www.khronos.org/spirv/) (bien que je ne sache pas si TGIR est directement converti en SPIRV, sans passer par LLVMIR).
J’ai écrit « algorithmes vectorisés », bien que le concept de base soit davantage axé sur les modèles tuilés au niveau des blocs :
 Le tuilage est le mécanisme principal. Le modèle mental de Triton repose sur la programmation d’opérations sur de petits sous-tableaux multidimensionnels de forme statique, ou « tuiles », que le compilateur parallélise automatiquement sur les cœurs du GPU.
La vectorisation, qui consiste à charger et stocker plusieurs éléments de données en une seule instruction, est une optimisation : le compilateur l’utilise comme stratégie d’optimisation interne clé pour implémenter efficacement ces blocs de données sur le matériel sous-jacent. Ce concept s’aligne sur les stratégies de tuilage imbriqué (voir la figure de droite), qui visent à décomposer les blocs en micro-blocs, puis en nano-blocs, afin d’adapter au mieux les ressources aux capacités de calcul et à la hiérarchie mémoire de la machine.
Langage Triton : Réduction des étapes jusqu’à l’assemblage en flux continu
Link to heading
Voyons comment l’instruction de haut niveau tt.load du langage Triton est traduite en SASS. (Note au lecteur : le code ci-dessous est un pseudo-code et ne fonctionne pas tel quel.)
Après l’analyse syntaxique de l’AST Python, la première étape consiste à utiliser la fonction Triton IR (TIR, un dialecte MLIR) indépendante de la machine. À ce niveau, une opération tt.load est définie sur une tuile. Cette opération, non optimisée, est une instruction de haut niveau qui exprime le chargement en mémoire de la tuile entière. La tuile peut être un tableau simple, un tableau 2D ou même un tableau de dimensions quelconques.
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
L’opération de haut niveau tt.load sur un pointeur de tenseur et un bloc de données (tuile). Le premier paramètre d’entrée %ptrs est un tenseur (tableau à n dimensions) représenté par tensor. <MxN, ptr Elle renvoie un tenseur de même dimension, mais avec des valeurs au lieu d’un pointeur vers des valeurs.
En pratique, la fonction tt.load prend également un paramètre de masque et de valeur par défaut, nécessaires pour la lecture à partir des limites de la mémoire (au cas où les dimensions du vecteur ne seraient pas alignées sur le pas).
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
Dans l’étape suivante, l’IR Triton-GPU est utilisé pour convertir les structures tensorielles génériques en structures spécifiques au matériel, notamment en ce qui concerne l’organisation et la distribution de la mémoire entre les threads et les warps. Autrement dit, TGIT décompose la charge à n dimensions en opérations de chargement vectoriel par thread, plus faciles à convertir en LLVM.
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
Le code intermédiaire (IR) du GPU Triton est ensuite converti en instructions par thread, représentées dans le code intermédiaire LLVM. Ce code intermédiaire de bas niveau représente fidèlement les instructions machine finales et utilise des opérations LLVM standard telles que l’arithmétique des pointeurs, les chargements de mémoire et les primitives de synchronisation. L’abstraction des tenseurs est largement supprimée et remplacée par des opérations d’accès mémoire individuelles pour chaque thread.
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
Représentation : Le chargement des tuiles est décomposé en une série d’instructions de chargement individuelles avec arithmétique de pointeur pour chaque élément de données spécifique du thread, et éventuellement des opérations de mémoire partagée si la mémoire partagée a été utilisée comme zone de transit.
Lorsque le backend LLVM cible les GPU NVIDIA, l’étape suivante consiste à passer au format PTX. Les instructions de chargement LLVM sont directement mappées sur les instructions de chargement PTX correspondantes.
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
Enfin, le compilateur de pilotes NVIDIA (ptxas) convertit le code assembleur PTX en SASS (Streaming Assembly), le code machine natif exécuté par les cœurs du GPU. Comme indiqué précédemment, cette étape est généralement effectuée à la volée (JIT).
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
L’approche de DeepSeek
Il est important de noter que CUDA est une méthode très pratique pour générer du code machine pour les GPU NVIDIA. Triton utilise CUDA lors de la conversion de PTX en SASS. Cette conversion est effectuée par LLVM IR, mais nécessite les bibliothèques fournies avec le kit d’outils CUDA (par exemple, libdevice.bc).
 DeepSeek a opté pour une approche différente, en choisissant une optimisation PTX manuelle : des fonctions d’assistance au noyau PTX personnalisées ont été écrites à la main, considérant PTX comme le langage assembleur du GPU. DeepSeek n’a pas utilisé de compilateur généraliste pour générer ce code spécifique et très peu standard. Triton, en revanche, étant un langage générique, utilise le compilateur LLVM standard avec la cible NVPTX pour traduire automatiquement sa représentation intermédiaire (Triton-IR/MLIR) en code assembleur PTX optimisé.
 Wrapper DeepSeek dans csrc/kernels/utils.cuh utilisant l’instruction mbarrier.try_wait
Pourquoi est-ce important ? Extrait du rapport technique de DeepSeek : « Plus précisément, nous (DeepSeek) utilisons des instructions PTX (Parallel Thread Execution) personnalisées et ajustons automatiquement la taille des blocs de communication, ce qui réduit considérablement l’utilisation du cache L2 et les interférences avec les autres SM. » Cela signifie-t-il que le backend NVPTX de LLVM n’est pas optimal ? Pour moi, cela signifie qu’il existe des marges d’optimisation, non seulement au niveau de LLVM, mais aussi en exposant une meilleure interface bare metal (ISA) ! C’est tout bénéfice !
Voilà, cette note a encore une fois pris plus de temps que prévu. Mais il s’agit d’une étude préliminaire indispensable avant de présenter l’architecture de Cuda-Q. Je mettrai cet article à jour dès qu’elle sera prête.
 (crédit image : LLVM MOS)
Diagrammes DrawIO utilisés dans cette note :