J’ai récemment découvert le concept d’ingénierie de la capacité et de l’efficacité, qui est la discipline consistant à concevoir et à exploiter les systèmes de manière optimale. C’est un pilier fondamental de l’architecture système, particulièrement important lorsque l’échelle est un facteur critique, comme dans les systèmes d’informatique quantique.
En bref, l’ingénierie des capacités et de l’efficacité est la science ou la discipline qui consiste à optimiser la production. Elle y parvient en équilibrant la production maximale (capacité) et la consommation des ressources (efficacité).
L’avantage de l’ingénierie des capacités et de l’efficacité (ICE) réside dans le fait qu’il s’agit d’un domaine bien défini, largement documenté et étayé par des pratiques d’ingénierie rigoureuses. Cette note vise à présenter quelques concepts clés utilisés en ICE.
Piliers de l’ingénierie des capacités et de l’efficacité
Link to heading
L’ingénierie des capacités et de l’efficacité repose sur trois piliers fondamentaux : l’observabilité, la modélisation et la planification.
Observabilité
Modélisation
Planification
L’objectif ultime est d’élaborer un plan simulable efficacement à l’aide d’un modèle. Ce modèle doit être validé par des observations empiriques. En modélisant la croissance, en identifiant les points de blocage et en allouant les ressources de manière stratégique, le plan prévient la surcharge et la sous-utilisation, garantissant ainsi un fonctionnement optimal du système.
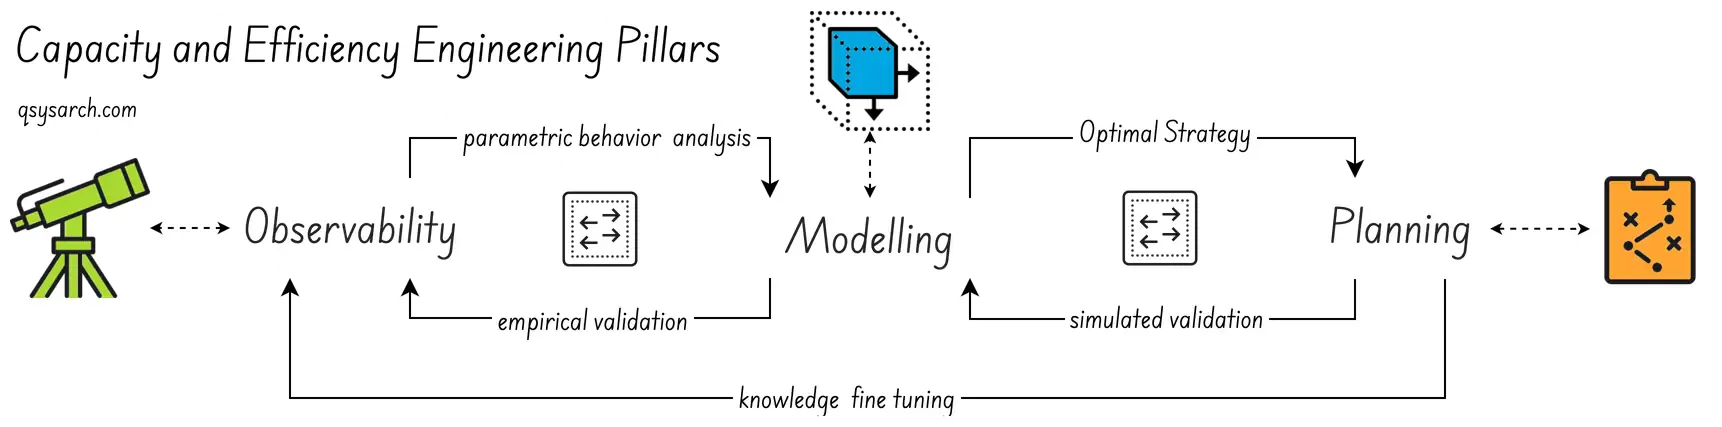
Il convient de noter que la ressource système peut être de toute nature. Il peut s’agir de ressources informatiques telles que le processeur ou la mémoire, de personnel ou de machines. En effet, l’ingénierie des ressources humaines (IEH) peut être appliquée dans divers domaines. Par exemple, elle peut contribuer à optimiser l’affectation du personnel dans la gestion de projet ou à réduire les coûts d’hébergement cloud dans la gestion d’infrastructure.
L’observabilité est l’analyse empirique d’un système. Dans les systèmes informatiques, les journaux sont souvent confondus avec l’observabilité, mais ils n’en représentent qu’une partie. Par exemple, la norme OpenTelemetry englobe plusieurs signaux observables : journaux, métriques, traces et données résiduelles. Pour les systèmes d’information critiques (SIC), une observabilité efficace doit fournir :
Utilisation des ressources : Observation et suivi de la consommation des ressources. L’observation doit préciser la nature, la date et l’utilisateur de la ressource, ainsi que la survenue éventuelle d’erreurs.
Indicateurs de performance : Suivre les indicateurs clés de performance (KPI) tels que la latence et le débit, y compris le rendement, les pertes ou les taux d’erreur.
Identification des goulots d’étranglement : Détermination des contraintes du système qui dégradent le débit.
L’essentiel est de pouvoir réaliser une analyse post-mortem du système, et ce, dans toutes les conditions : en pleine charge, lors de la maintenance ou pendant les périodes d’inactivité. Il est important de comprendre en détail ce qui s’est passé, quand et pourquoi. Sans ces observations, il serait impossible d’identifier les causes profondes de la défaillance du système.
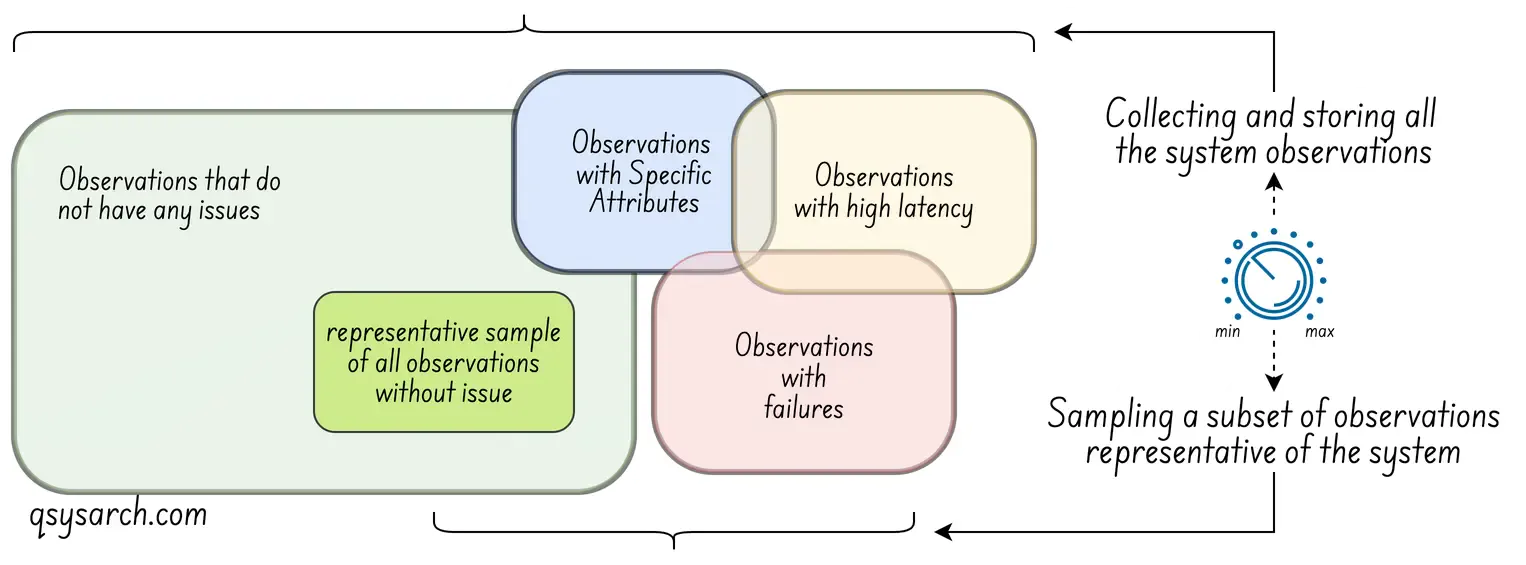
Bien sûr, la collecte de l’intégralité des observations d’un système complet présente un défi : les observations peuvent être très coûteuses, voire destructives (comme dans le cas de l’informatique quantique, où la mesure d’un système peut modifier son état – un phénomène connu sous le nom d’effet d’observation). Autrement dit, le simple fait d’observer le système peut altérer son comportement et dégrader ses performances. La solution consiste à utiliser l’échantillonnage (collecte de données uniquement pour certains événements). L’idée est de faire de la fréquence d’échantillonnage (fréquence de collecte des données) un paramètre ajustable du système, comme illustré dans le schéma ci-dessous (crédits : OpenTelemetry).
Pour un système non informatique, une observabilité efficace permettrait, par exemple, d’expliquer les raisons d’un retard de projet. Les données observables seraient vraisemblablement les documents techniques et non techniques exigés par la norme ISO 9001 (https://en.wikipedia.org/wiki/ISO_9000_family#Contents_of_ISO_9001) qui expliquent les décisions traçables prises à chaque phase du projet.
L’observabilité étant établie, on peut commencer à comprendre le comportement paramétrique analytique du système. Ce comportement constitue le fondement de l’étape suivante : il peut être décrit et traduit en un modèle paramétrique. L’étape suivante consiste à préciser ce qu’un tel modèle doit fournir, étant donné un ensemble de paramètres ou de conditions.
Performances : Quel est le débit et la latence maximum que le système peut fournir ?
Coût d’exploitation : Quel est le coût d’exploitation du système, en fonction du nombre de ressources allouées ? Ce coût peut varier selon le moment de la journée.
Reconfiguration : Quel est l’impact transitoire (effets temporaires) de la mise à jour des paramètres système ? Par exemple, lors de l’attribution d’un nouveau serveur ou d’une nouvelle unité de traitement du quai (QPU) et de sa configuration.
L’essentiel est de simuler le comportement du système et d’observer ses performances dans différentes conditions de fonctionnement. Le modèle intégrant les coûts des ressources, il permet de mettre en évidence les compromis de coûts dans ces conditions. Ces informations sont cruciales pour la phase de planification.
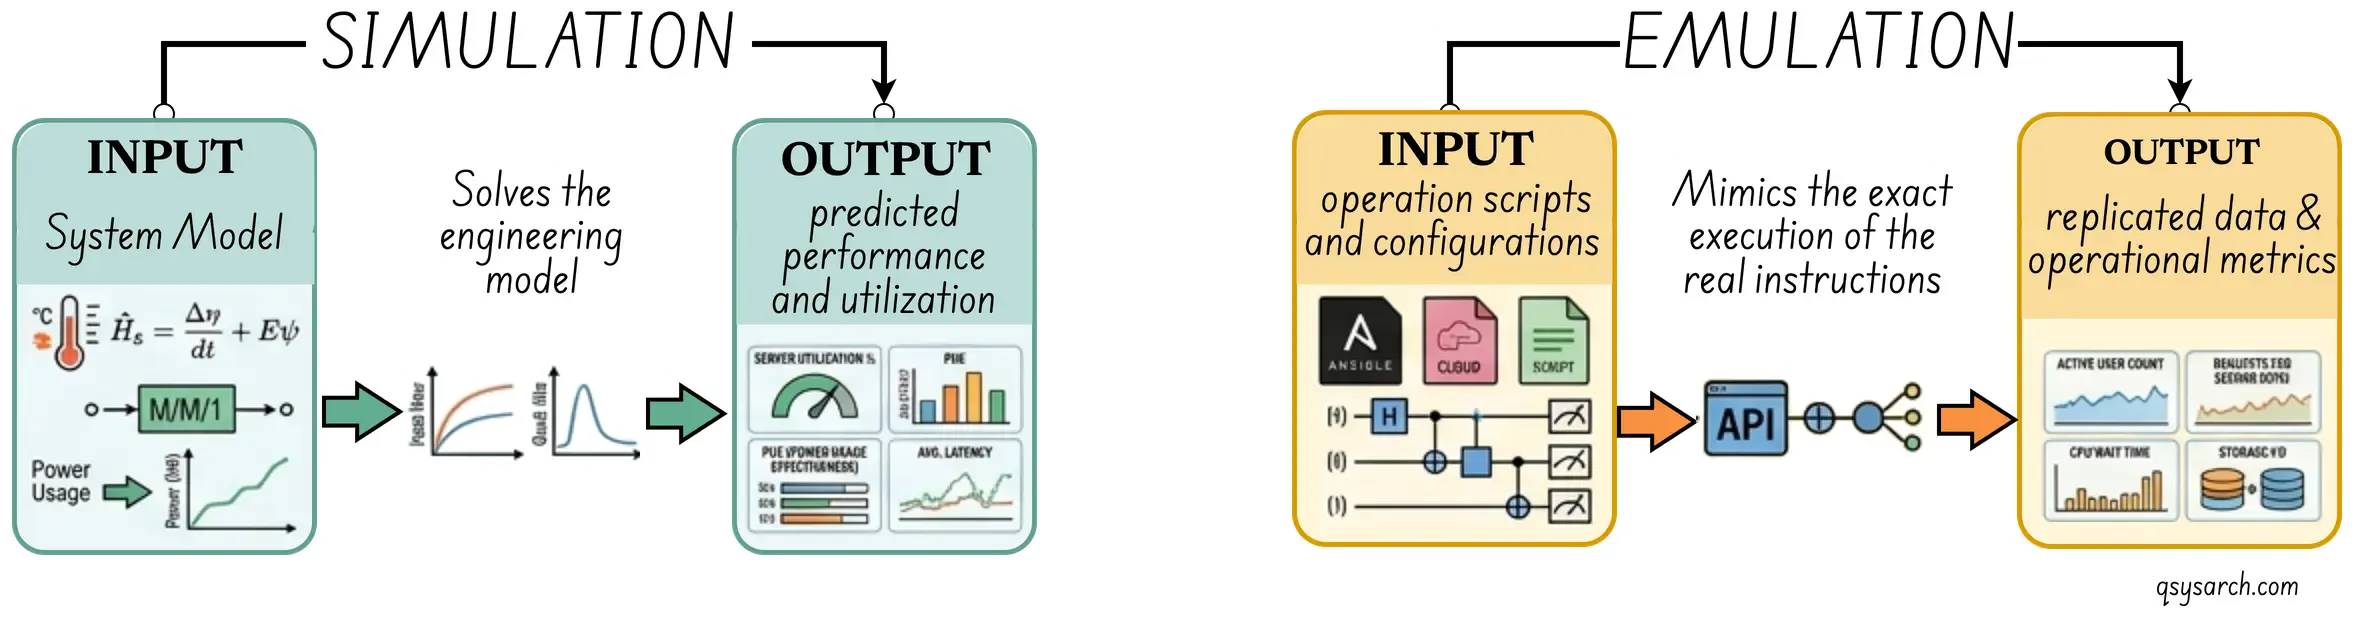
Il convient de mentionner ici la différence entre simulation et émulation. De manière générale, l’émulation crée une version factice du système, tandis que la simulation opère sur un modèle abstrait de celui-ci. L’émulation permet de comparer les performances simulées aux performances réelles, car les entrées sont identiques. Je suppose que, dans le contexte de l’ingénierie électrique et informatique (IEC), le terme « modèle » désigne principalement un simulateur.
Un bon modèle pour un système non informatique pourrait prédire les effets de l’ajout de ressources à un projet. Or, il arrive que l’ajout de ressources diminue les performances du système. Ce résultat contre-intuitif est connu sous le nom de loi de Brooks.
Grâce au modèle, vous pouvez commencer à planifier l’exploitation du système. Utilisez-le pour simuler différentes conditions et identifier les conditions optimales. Ces résultats vous permettront d’affecter stratégiquement les ressources à la demande. Un bon plan doit prévoir la prévision de la demande, la gestion des coûts et des mécanismes de sécurité. La prévision permet d’anticiper l’utilisation, le trafic et les besoins futurs. La gestion des coûts permet d’éviter le surdimensionnement tout en maintenant la capacité nécessaire pour les périodes de pointe. Les mécanismes de sécurité offrent des marges de manœuvre pour absorber les demandes imprévues.
L’essentiel est d’exploiter le système de manière efficace et fiable. Gérer les pics de charge sans défaillance. Garantir la rentabilité. La prévision des capacités permet une reconfiguration proactive. Prévoir une marge de sécurité suffisante pour faire face aux imprévus.
Ce plan combine le scénario le plus favorable, où la demande est conforme aux prévisions, et le scénario le plus défavorable, où la demande est supérieure ou inférieure aux prévisions. Cette approche permet une allocation optimale des capacités en termes de coûts.
Le dilemme de la poule et de l’œuf
Link to heading
Concevoir un bon modèle est un problème de la poule et de l’œuf. Sans savoir quoi observer et comment l’observer dans le système, il est difficile de construire un modèle efficace et précis. Sans modèle précis, le plan a peu de chances de donner de bons résultats.
En cas d’écart entre le plan simulé et le comportement réel, on cherche à identifier les paramètres manquants. Cela se fait généralement en analysant a posteriori les journaux d’événements du système observé. L’objectif est de déterminer de nouveaux paramètres à observer.
Cette boucle d’apprentissage est représentée comme un ajustement fin des connaissances dans le diagramme ci-dessus.
L’ingénierie environnementale et informatique (CEE) ne suffirait pas sans une plateforme automatisée prenant en charge l’ensemble de son flux de travail. Cette plateforme d’ingénierie est représentée dans le schéma ci-dessous.
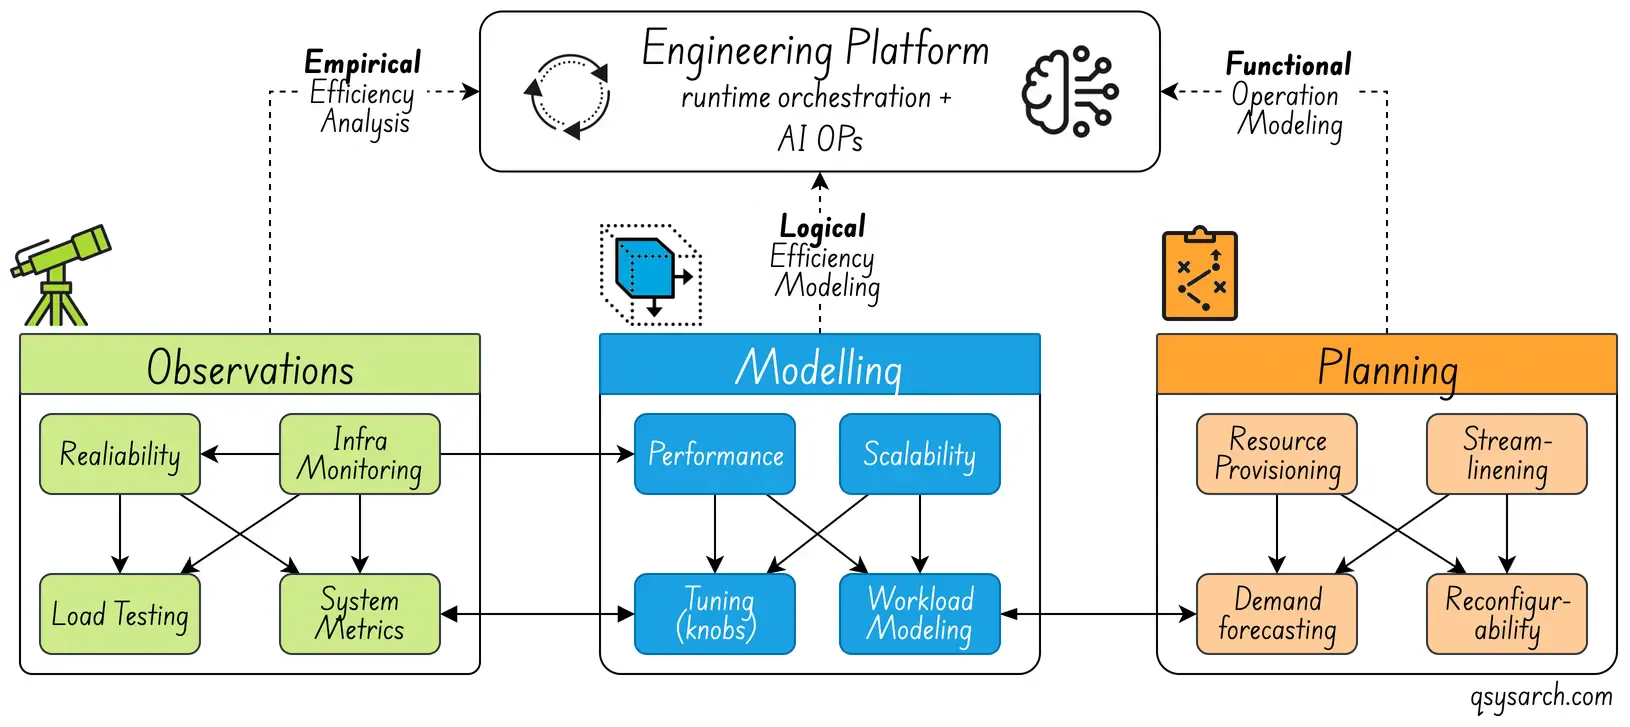
L’objectif de la plateforme d’ingénierie n’est pas seulement d’automatiser la mise à l’échelle du système (à la hausse comme à la baisse), une tâche pouvant être déléguée à des agents d’IA (AiOps). Il s’agit également de vérifier en continu la pertinence du modèle simulé par rapport aux observations empiriques et de transmettre les écarts à un agent d’apprentissage automatique capable d’affiner le modèle. Cet agent, vraisemblablement basé sur l’apprentissage par renforcement, devrait être encadré (gouverné) s’il est utilisé en temps réel.
Le coût de l’incapacité à évoluer suffisamment vite, autrement dit le coût du retard.
Link to heading
Pour qu’un système soit stable et robuste, ses performances doivent être plafonnées à des niveaux stables, et non à des niveaux maximaux. En règle générale, les performances stables se situent aux deux tiers des performances maximales. Au-delà de ce seuil, le système se dégrade. Le coût des interruptions de service peut alors rapidement – souvent de façon exponentielle – dépasser celui du surdimensionnement.
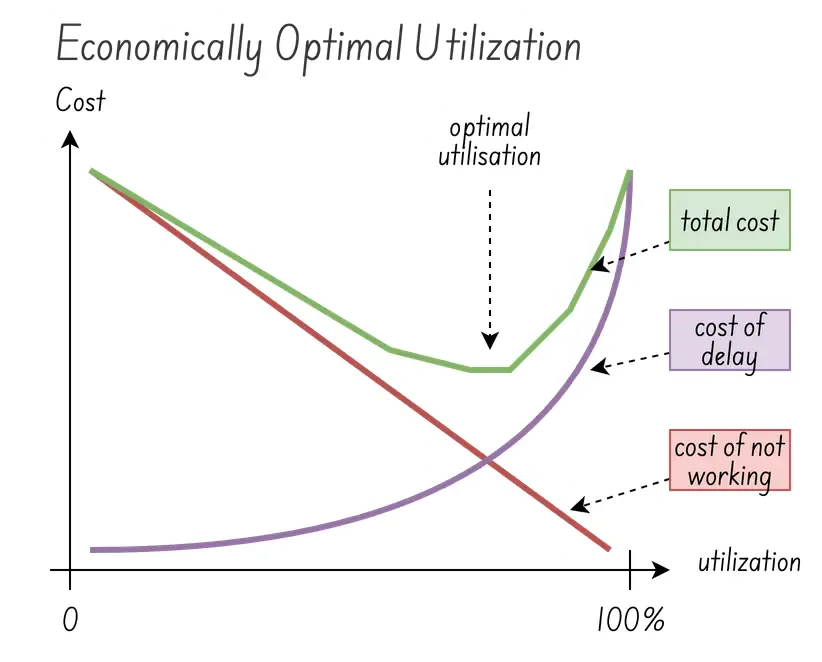
Sur l’image de droite, le coût du délai correspond à l’impact financier de l’incapacité à répondre à la demande pendant la montée en charge du système (en temps réel). Ce coût est transitoire. En cas de faible utilisation, le délai n’affecte que quelques demandes. En revanche, en cas de forte utilisation, le délai impacte de nombreuses demandes et son coût augmente de façon exponentielle.
Le point d’équilibre optimal correspond à l’utilisation qui minimise à la fois le coût des retards et celui des pannes (surdimensionnement). La courbe verte représente le coût total, somme de ces deux facteurs. Le minimum local de cette courbe, généralement aux alentours des deux tiers de la performance maximale, marque l’utilisation optimale. Il y aurait en réalité beaucoup plus à dire sur ce point d’équilibre, que certains estiment sans doute aux alentours de 80 %. L’essentiel est de comprendre que la réduction du coût des retards par l’optimisation du système permet d’améliorer l’utilisation optimale (crédits image : show me the data).
Si réduire le coût des défaillances d’un système peut passer par la réduction du temps de mise à l’échelle, imaginez un système capable de s’adapter en quelques millisecondes, voire microsecondes, pour augmenter sa capacité et répondre à la demande. Bien sûr, développer un tel système peut s’avérer très coûteux (pensons au trading haute fréquence). Mais que se passerait-il si le coût de développement était inférieur au bénéfice d’une utilisation accrue du système ?
Ce défi relève également de l’analyse comparative de l’efficacité (ACE). En modélisant le coût d’amélioration du système, il devient possible d’élaborer un plan qui équilibre ce coût et les bénéfices attendus. Il s’agit moins d’un défi opérationnel que d’un investissement stratégique. Il reste néanmoins guidé par les mêmes principes de l’ACE appliqués à la stratégie opérationnelle de l’entreprise, appréhendée comme un système.
Cartographie de la chaîne de valeur
Link to heading
La cartographie de la chaîne de valeur (VSM), dans le contexte de l’ingénierie des capacités et de l’efficacité, est couramment utilisée comme outil de diagnostic pour déterminer où la capacité est consommée, permettant ainsi d’identifier les causes profondes du gaspillage et des goulots d’étranglement.
Un flux de valeur correspond à chaque étape, ou activité, du flux de travail utilisé par le système pour fournir un service. La cartographie du flux de valeur (VSM) en est une représentation visuelle de bout en bout. La VSM distingue trois types d’activités :
Valeur ajoutée (VA) : Étapes qui contribuent directement au résultat souhaité par le client (par exemple, le calcul proprement dit).
Étapes sans valeur ajoutée mais nécessaires (NNVA) : Étapes requises par le système mais sans valeur directe pour le client (par exemple, les poignées de main).
Gaspillage (Muda, ou 無駄, un terme japonais signifiant « gaspillage ») : Étapes qui consomment de la capacité sans ajouter de valeur.
L’objectif est d’éliminer les étapes inutiles (Muda), et la cartographie de la chaîne de valeur (VSM) excelle dans leur identification. La force de la VSM réside dans sa capacité à identifier les optimisations pertinentes permettant de réduire les travaux en cours (WIP). Ceci est important en raison de la loi de Little, qui stipule que le délai moyen (ou temps de cycle) est égal aux travaux en cours moyens (WIP) divisés par le débit moyen.
Délai de livraison = Travaux en cours / DébitCela signifie que si l’encours de production double, le délai de livraison double également, même si le débit reste inchangé. La maîtrise de l’encours est donc l’un des leviers les plus directs pour améliorer la latence de livraison (le « délai ») et, par conséquent, l’efficacité du système.
Voilà, cette brève note du dimanche matin sur l’ingénierie des capacités et de l’efficacité (ECE) m’a permis de mieux comprendre le sujet. Pour l’instant, je retiens que lorsqu’un système affiche une très faible efficacité, c’est très probablement le signe que le système, ou ses flux de travail, sont saturés de ressources inutiles (Muda). La solution à ce problème : investir dans la réduction du coût des délais plutôt que dans le surdimensionnement ?
References:
DrawIO diagrams used in this memo:
Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
Key
methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
Unique
angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
Metrics
emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |