xPU : terme générique désignant une unité de traitement (PU) spécialisée, où « x » peut représenter n’importe quelle architecture informatique adaptée à une charge de travail spécifique. Parmi les variantes courantes, on trouve les GPU (graphiques), les TPU (tenseurs/IA), les NPU (neuronaux), les DPU (données) et les PPU (impulsions, principalement utilisées pour les piles de contrôle quantiques).
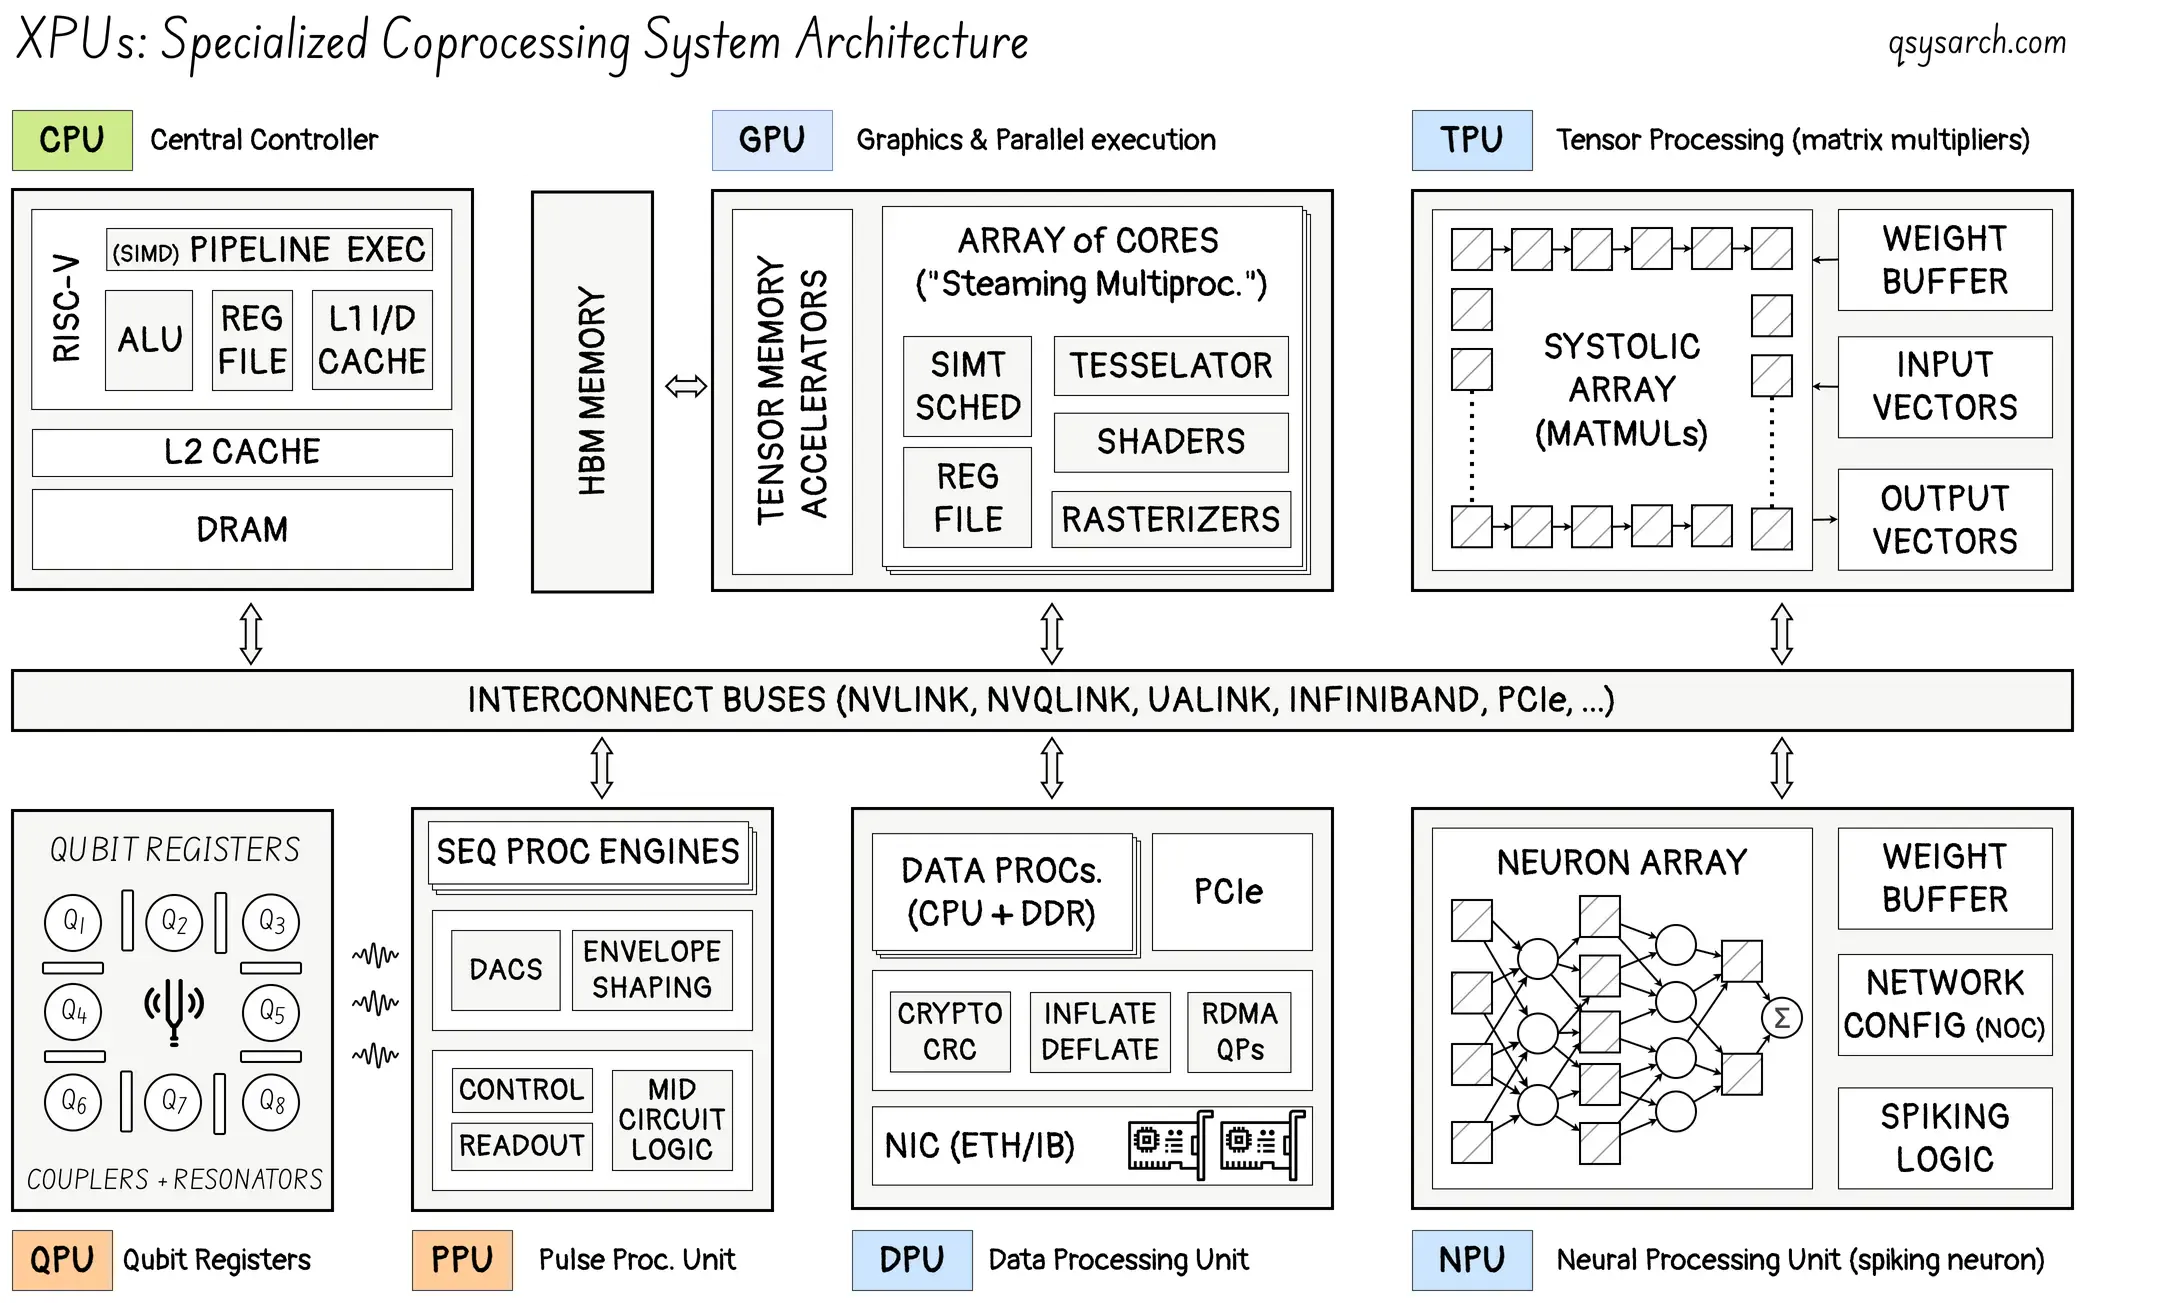
Cette note très concise vise à donner un aperçu du paysage du marché des xPU appliqué à l’inférence en IA.
Lorsqu’on analyse le marché des ASIC d’inférence IA, le critère le plus pertinent n’est peut-être pas la performance brute, mais plutôt la capacité d’un fournisseur à se différencier sur un horizon de 3 à 5 ans. De ce point de vue, trois groupes se dégagent :
La plateforme universelle : NVIDIA et les intégrateurs verticaux : AMD, Google
les challengers actuels Groq, Cerebras, FuriosaAI, Positron, SambaNova, Axelera AI.
Les défis futurs : Extropic, Normal Computing, Unconventional, Mottronix, Akhetonics
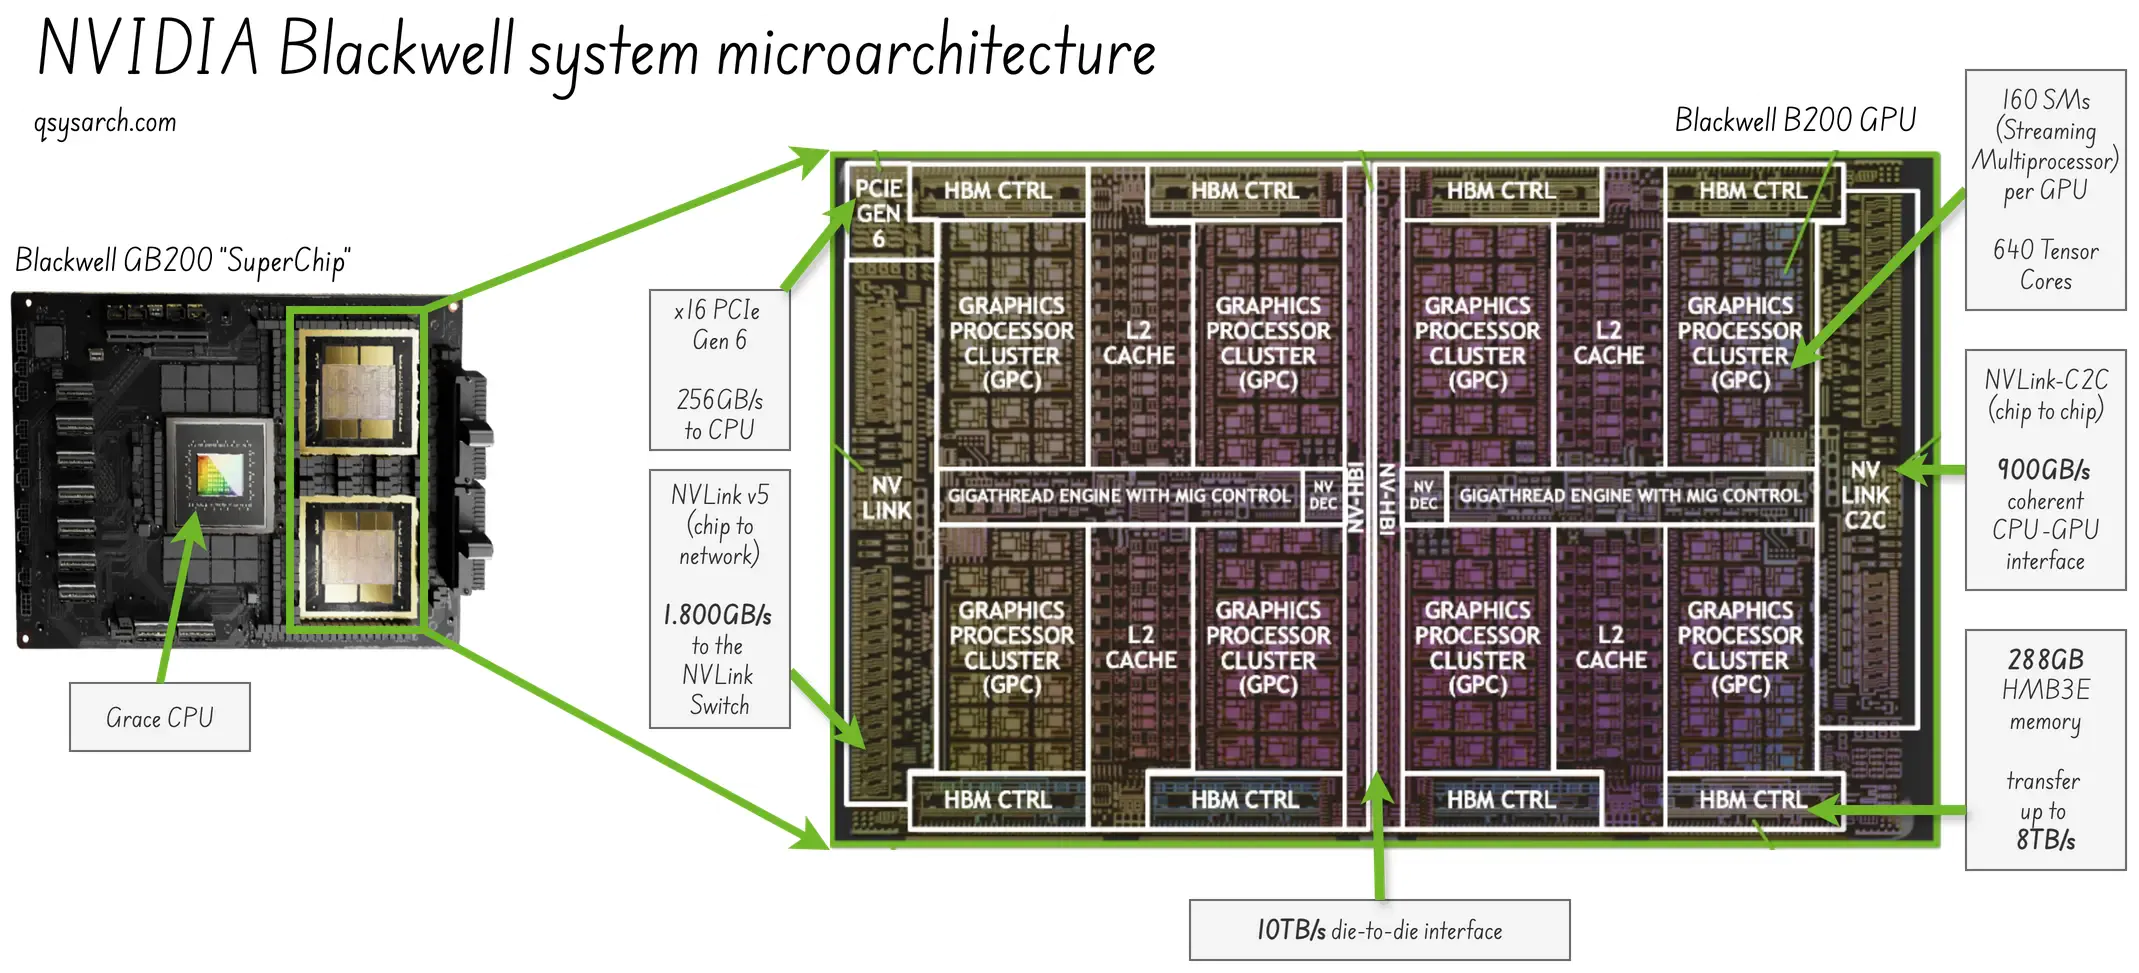
NVIDIA
Architecture : GPU (architecture Blackwell en 2024)
Points forts : Forte dépendance à l’écosystème, profondeur de la pile logicielle, intégration système complète
Charge de travail cible : Universelle — Entraînement et inférence LLM à grande échelle — Shaders graphiques
Vulnérabilité : Coût et consommation énergétique élevés ; non optimisé pour les calculs épars
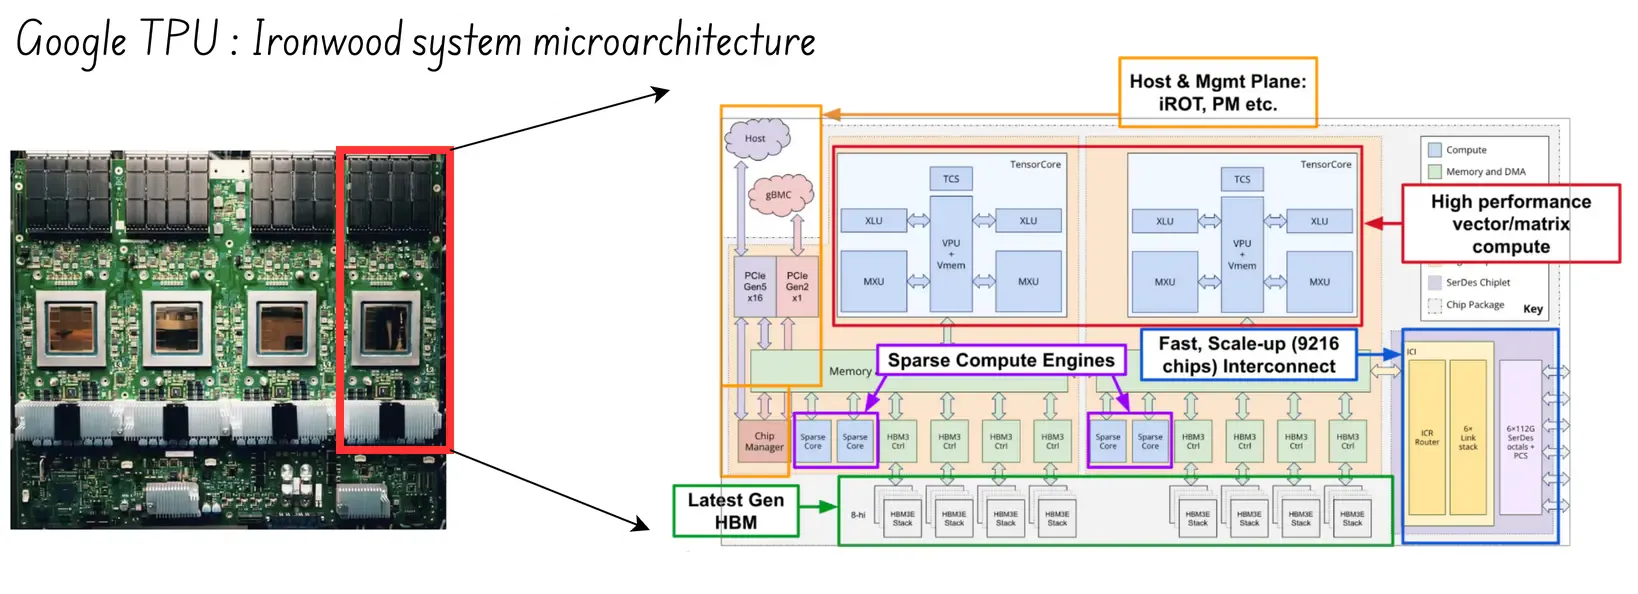
Google
Architecture : TPU, ASIC personnalisé (systolique)
Atout majeur : Intégration verticale ; coûts minimaux à l’échelle de Google
Charge de travail cible : charges de travail Google Cloud, inférence Gemini
Vulnérabilité : Disponible uniquement sur Google Cloud ; il est impossible d’acheter les cœurs TPU auprès de Google.
AMD
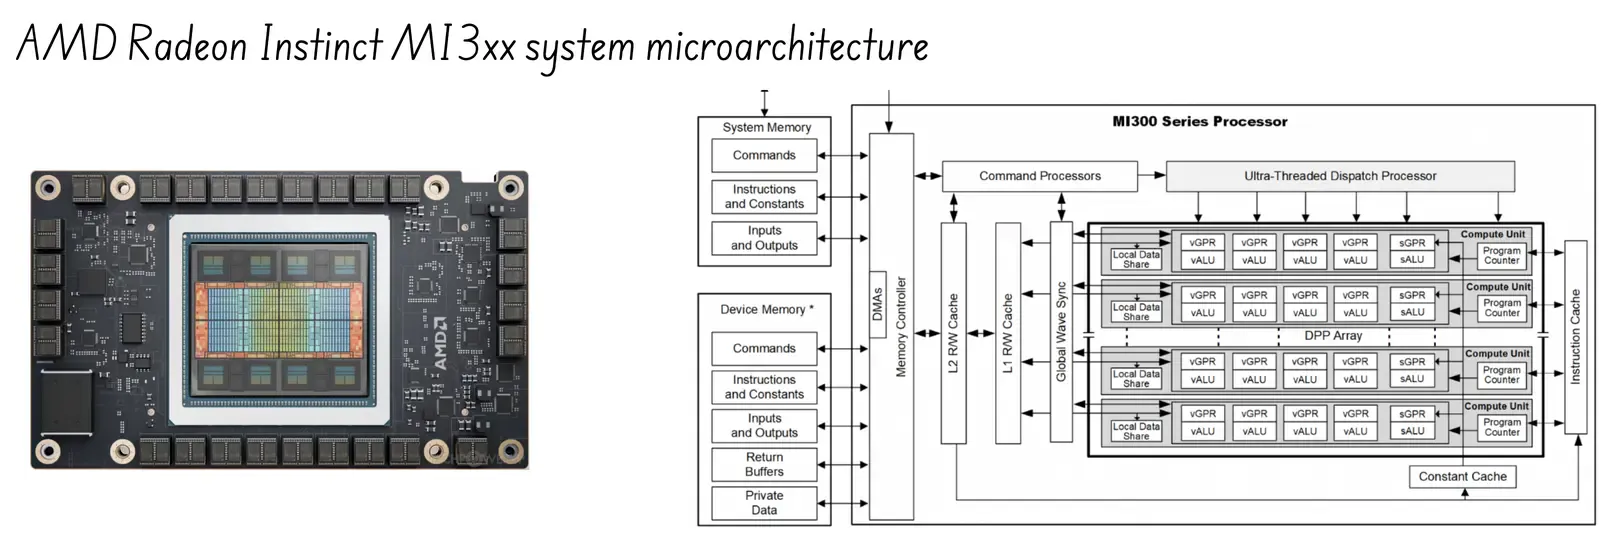
Architecture : MI300 Instinct + ROCm (CUDA propriétaire d’AMD)
Points forts : alternative tarifaire à CUDA ; modèle de GPU familier ;
Charge de travail cible : HPC et inférence sensibles aux coûts du cloud
Vulnérabilité : Écart logiciel par rapport à CUDA ; Retard par rapport à l’écosystème de pointe (ex. : NVQLINK)
Groq (acquis par NVIDIA)
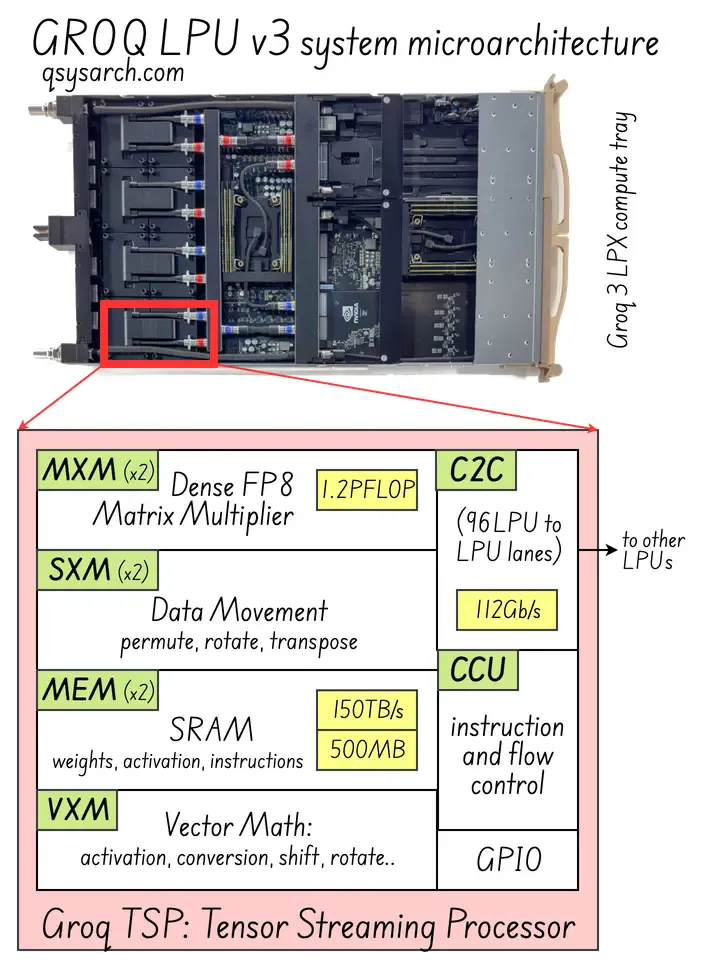
Architecture : LPU (Unité de traitement du langage)
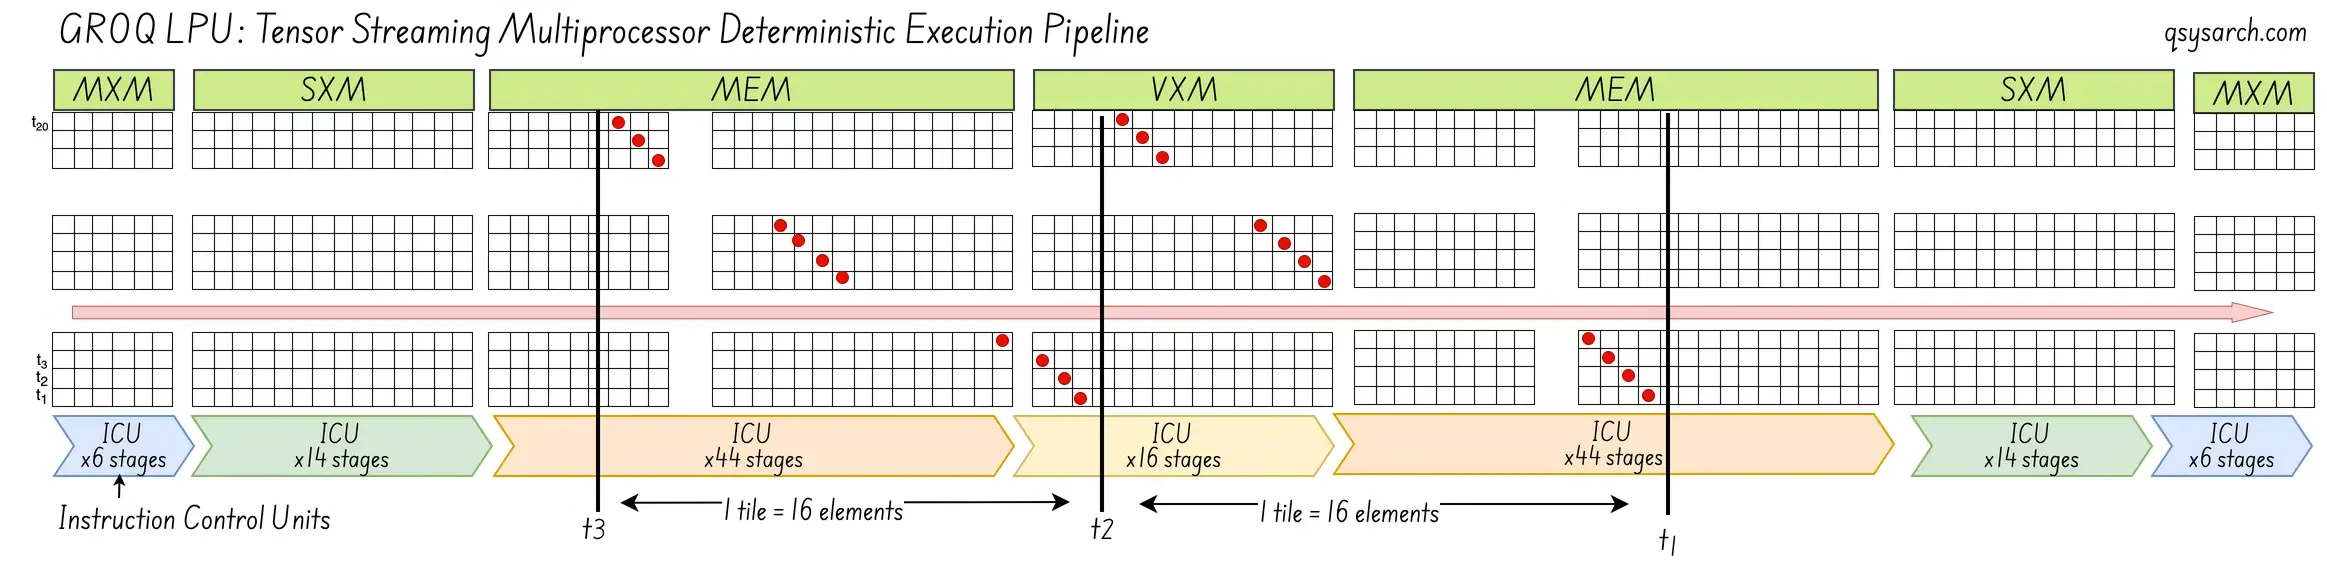
Principe de fonctionnement : construit autour de l’architecture de base du processeur de flux tenseur (TSP), le temps d’exécution est entièrement prévisible jusqu’au cycle d’horloge exact.
Atout majeur : latence ultra-faible et déterministe ; aucun goulot d’étranglement de la mémoire ; tout est « discipliné » à l’avance par le compilateur.
Charge de travail cible : Inférence en temps réel
Vulnérabilité : Compromis entre vitesse et espace : Pas de mémoire HBM (mémoire à large bande passante) de grande capacité, mais seulement de la SRAM embarquée ultra-rapide de petite taille (ce qui en fait toutefois un bon complément à l’écosystème Nvidia Blackwell maintenant qu’il a été racheté par NVIDIA !).
À noter que l’architecture Groq LPU a été présentée en 2020, lancée commercialement en 2024 et acquise en 2026. Cela donne un bon calendrier aux aspirants licornes : 4 ans de développement, 2 ans pour confirmer la traction du marché et le jackpot si un acteur plus important ressent la pression de la rivalité !
L’étude approfondie des solutions ci-dessous pourrait facilement prendre quelques jours pour chacun des fournisseurs ; temps dont je ne disposais pas pour rédiger cette note – par conséquent, veuillez prendre la description ci-dessous avec des pincettes, car elle pourrait être incomplète et/ou subjective.
SambaNova [presque acquis par Intel]
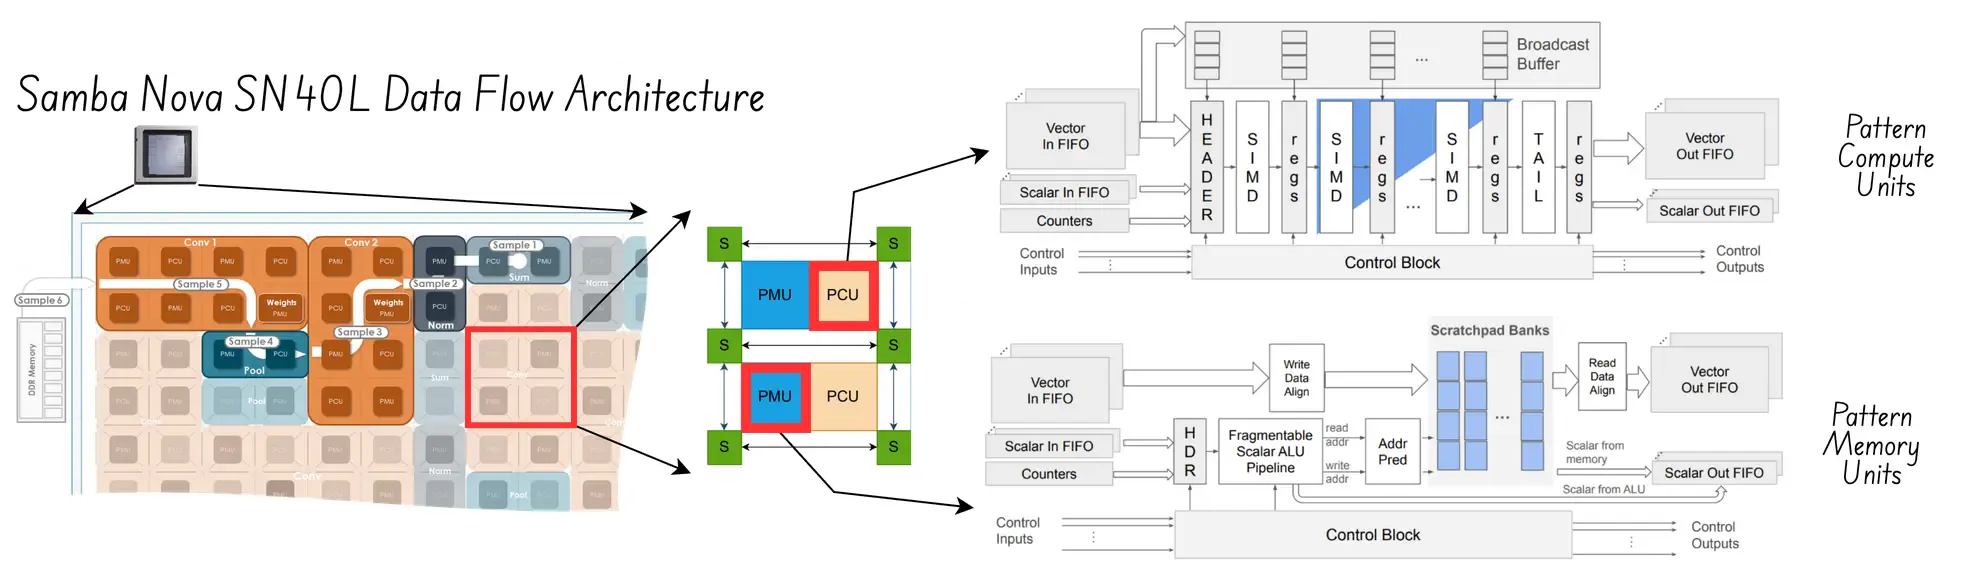
Architecture : RDU (unité de flux de données reconfigurable) ; permet des pipelines de données et de traitement intégrés et personnalisés pour l’ensemble du graphe de calcul, minimisant les déplacements de données et optimisant l’utilisation du matériel. Le schéma ci-dessous illustre l’architecture détaillée des PCU (unités de calcul de motifs) et des PMU (unités de mémoire de motifs) utilisées dans leur SN40L :
Atout majeur : Permet d’assurer une utilisation matérielle maximale grâce à une répartition précise des flux système entre les pipelines d’inférence concurrents ; est fourni avec une suite logicielle complète, incluant une intégration k8s de haut niveau, un compilateur pour PyTorch et TensorFlow, ainsi que des analyseurs de flux de données.
Charge de travail cible : Entreprises, environnements réglementés sur site.
Vulnérabilité : coût initial élevé du système pour le matériel, qui doit être amorti sur une longue période pour que le coût total de possession soit intéressant.
Cerebras
Architecture : Moteur à l’échelle de la plaquette (WSE) fonctionnant comme un multiplicateur matriciel pipeliné géant.
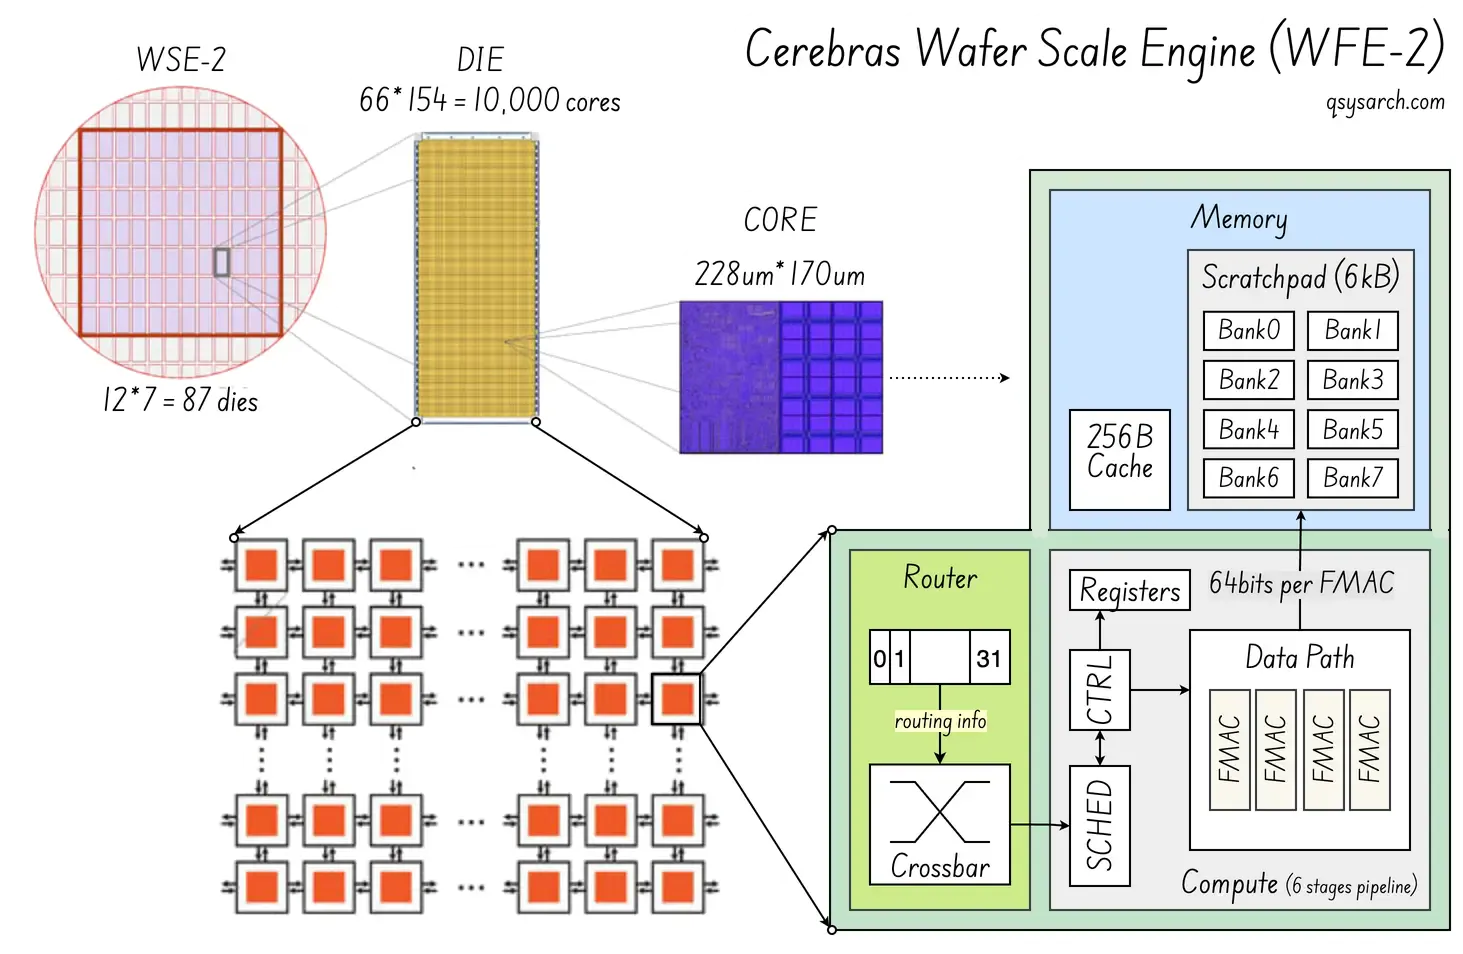
Atout majeur : Mémoire SRAM massive intégrée éliminant le goulot d’étranglement de la mémoire HBM. Cœurs indépendants haute densité (jusqu’à 850 000 pour le WSE-2) capables de réaliser des calculs tensoriels en mémoire. Routeur de fabric à latence d’horloge unique sur l’ensemble des nœuds de la plaquette.
Charge de travail cible : Inférence LLM importante, en particulier les modèles clairsemés.
Vulnérabilité : Nécessite une pile logicielle de pointe pour tirer pleinement parti de l’échelle massive (comme pour toutes les microarchitectures « PIM » ou de traitement en mémoire).
FuriosaAI
Architecture : Processeur de contraction tensorielle (TCP), commercialisé sous le nom d’ASIC Renegade (RGND). Contrairement aux réseaux systoliques TPU, qui possèdent une grille fixe, l’architecture TCP de Furuisa utilise de petites unités de calcul configurables et réorganisables dynamiquement (à l’instar d’un NOC ultra-intelligent).
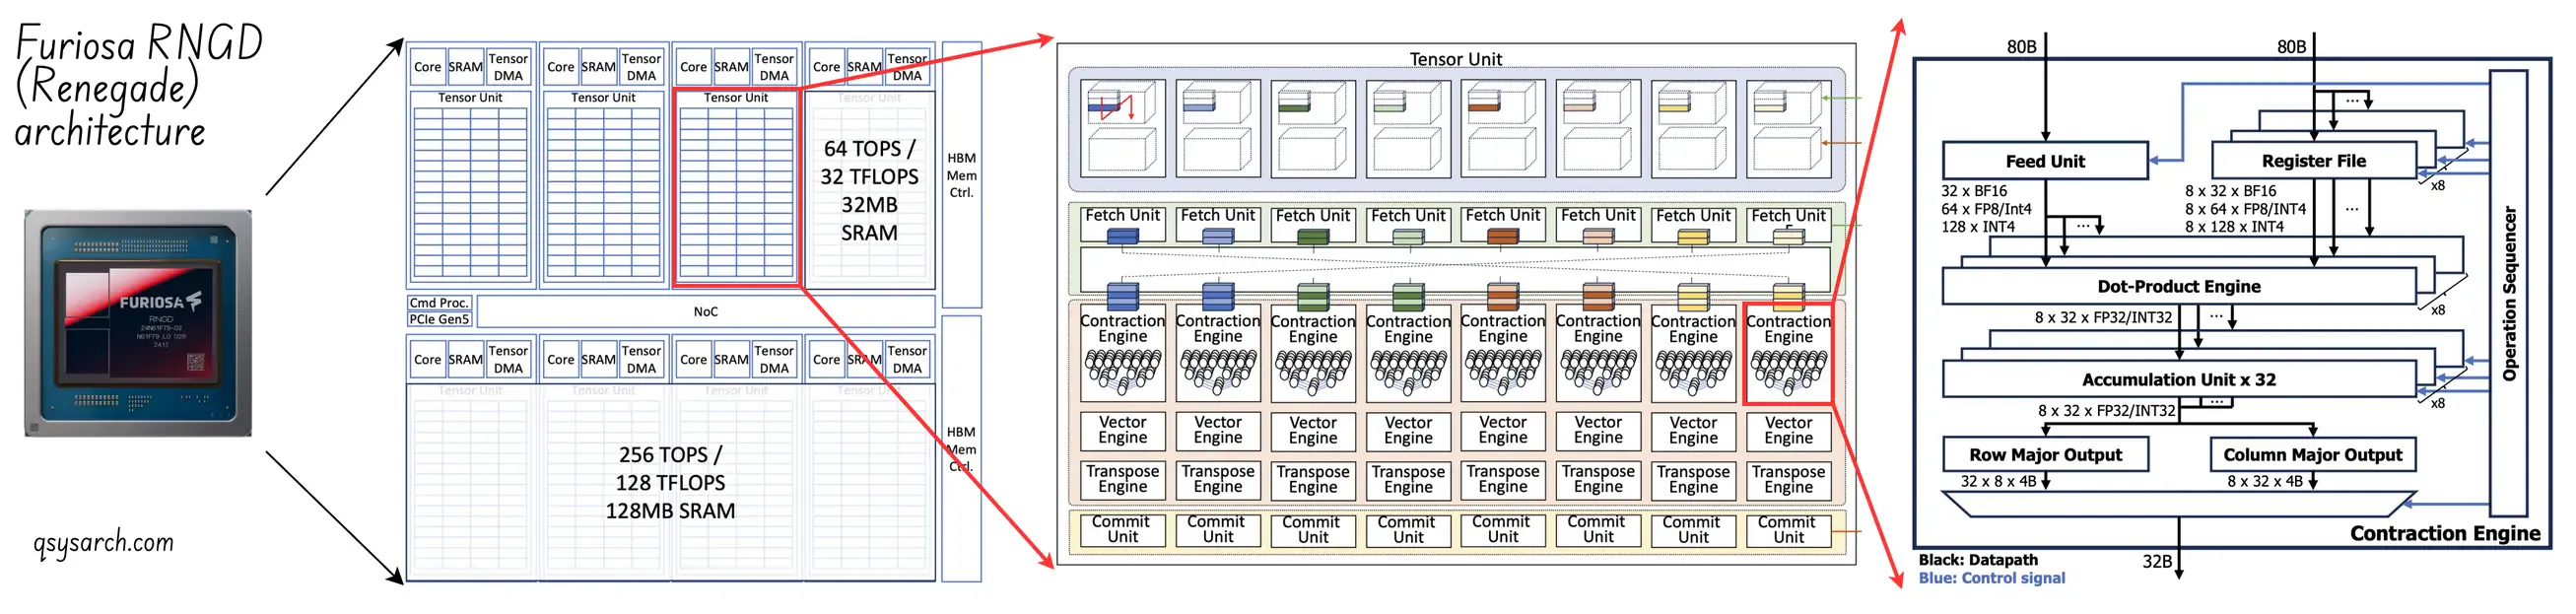
Atout majeur : En introduisant le NOC « fetch », Furiosa introduit la programmabilité spatio-temporelle du réseau de tenseurs TPU, faisant passer le niveau d’efficacité à un niveau supérieur, en adaptant parfaitement la charge de travail de calcul et les processeurs de contraction des tenseurs.
Charge de travail cible : LLM, VLMS,..
Vulnérabilité : Écosystème limité ; risque de concentration géographique (bien que cela puisse s’avérer avantageux s’ils s’emparent d’une partie du marché asiatique – ce qui en ferait une bonne acquisition pour Intel, par exemple, cherchant à gagner des parts de marché).
Positron
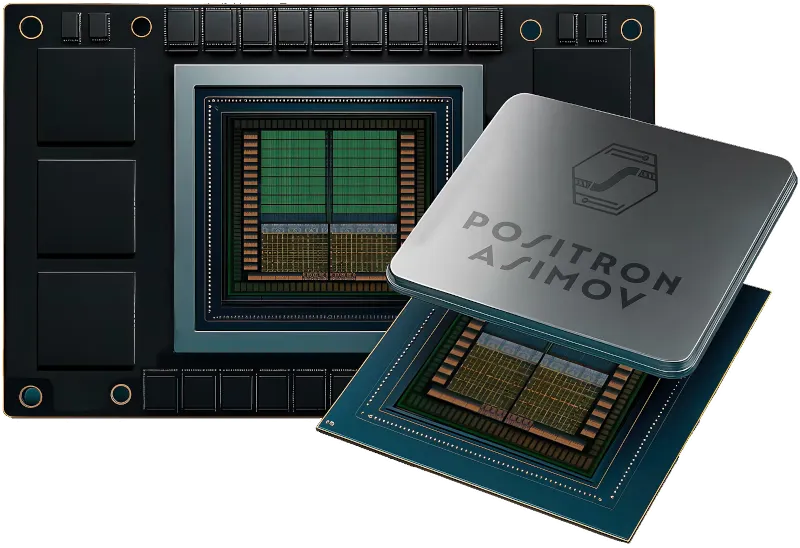
Architecture : ASIC Asimov - Peu d’informations sont disponibles, mais le message clé de Positron est que la mémoire est primordiale : s’ils parviennent à intégrer beaucoup plus de mémoire DDR5 standard dans leur ASIC, grâce à l’empilement de chiplets, ils pourront proposer une offre très compétitive par rapport au NVIDIA Blackwell, malgré une capacité mémoire inférieure.
Atout majeur : L’accent est mis sur l’utilisation optimale de la bande passante mémoire (MBU) plutôt que sur la bande passante mémoire standard (HBM). Cela signifie qu’ils peuvent augmenter le rapport cyclique ou le taux d’utilisation du bus mémoire et, par conséquent, offrir une puissance mémoire équivalente (voire supérieure) (bande passante * rapport cyclique, comme dans V*I = Watts pour l’électricité). Ils pourraient ainsi surpasser la concurrence qui peine encore à rivaliser avec des mémoires onéreuses.
Charge de travail cible : à déterminer lors de la disponibilité du premier ASIC, mais on peut supposer qu’elle ciblera les LLM standard.
Vulnérabilité : Stade très précoce et nécessité de trouver les bons partenaires fondeurs ; disponibilité générale et solutions commerciales probablement dans 2 à 4 ans - la mémoire sera-t-elle toujours un goulot d’étranglement d’ici là ?
Axelera AI :
- Architecture : Metis et Europe AIPU ; Il s’agit d’une architecture de calcul en mémoire avec un système de flux de données de contrôle basé sur RiscV.
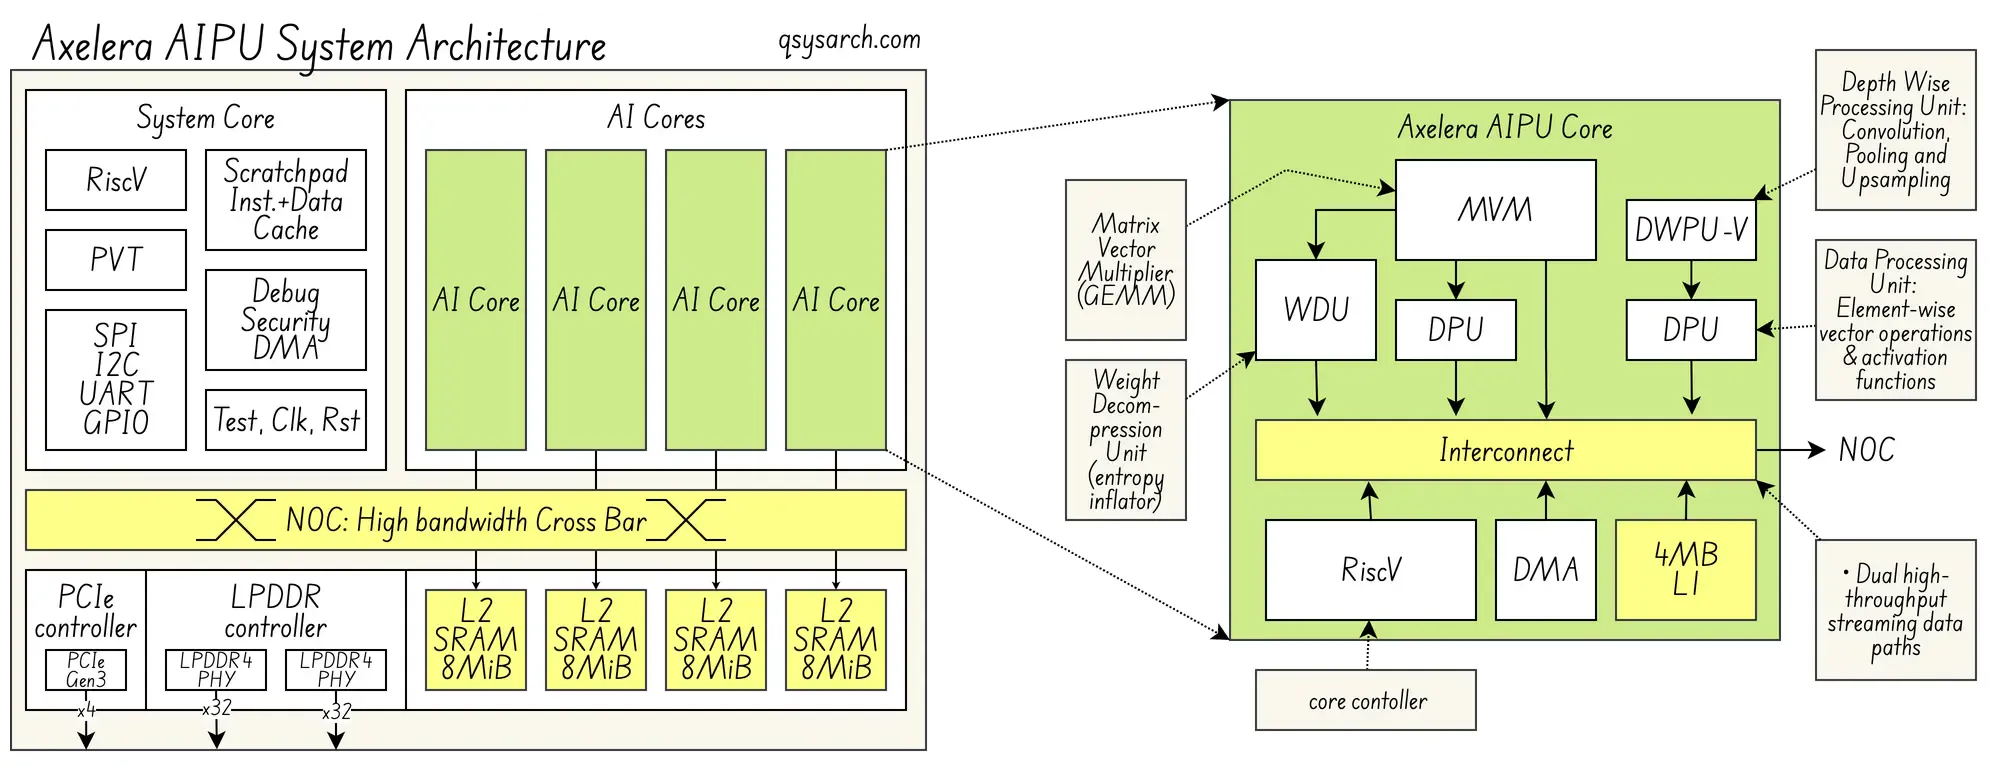
Atout majeur : Grâce au calcul en mémoire, elle peut effectuer des multiplications mathématiques complexes directement dans les cellules de mémoire numérique, éliminant ainsi les transferts de données. Ceci permet d’atteindre 15 TOPS/Watt (contre environ 3 pour NVIDIA Blackwell). De plus, il s’agit d’une propriété intellectuelle entièrement conçue en Europe, ce qui en fait une solution souveraine.
Charge de travail cible : La première génération était axée sur la vision par ordinateur / l’analyse vidéo multi-flux ; la nouvelle génération (intégration M2) peut également être utilisée pour les charges de travail LLM et vLM en périphérie.
Vulnérabilité : La vulnérabilité d’Axelera ne réside pas dans son ingénierie – sa technologie est de classe mondiale. Sa véritable vulnérabilité est la friction du marché : peut-elle s’y imposer sans diluer son expertise ?
En recherchant des informations sur les entreprises mentionnées ci-dessus, je suis tombé sur d’autres acteurs disruptifs du secteur manufacturier qui pourraient jouer un rôle important dans les années à venir. Parmi eux, Unconventional AI, qui mérite toute notre attention, notamment grâce au succès et à la vision de son dirigeant, Naveengrao.

Extropic et Normal Computing
- Architecture : TSU (unités d’échantillonnage thermodynamique) / SPU (unité de traitement stochastique), utilisées pour manipuler les « p-bits » (également appelés bits probabilistes).
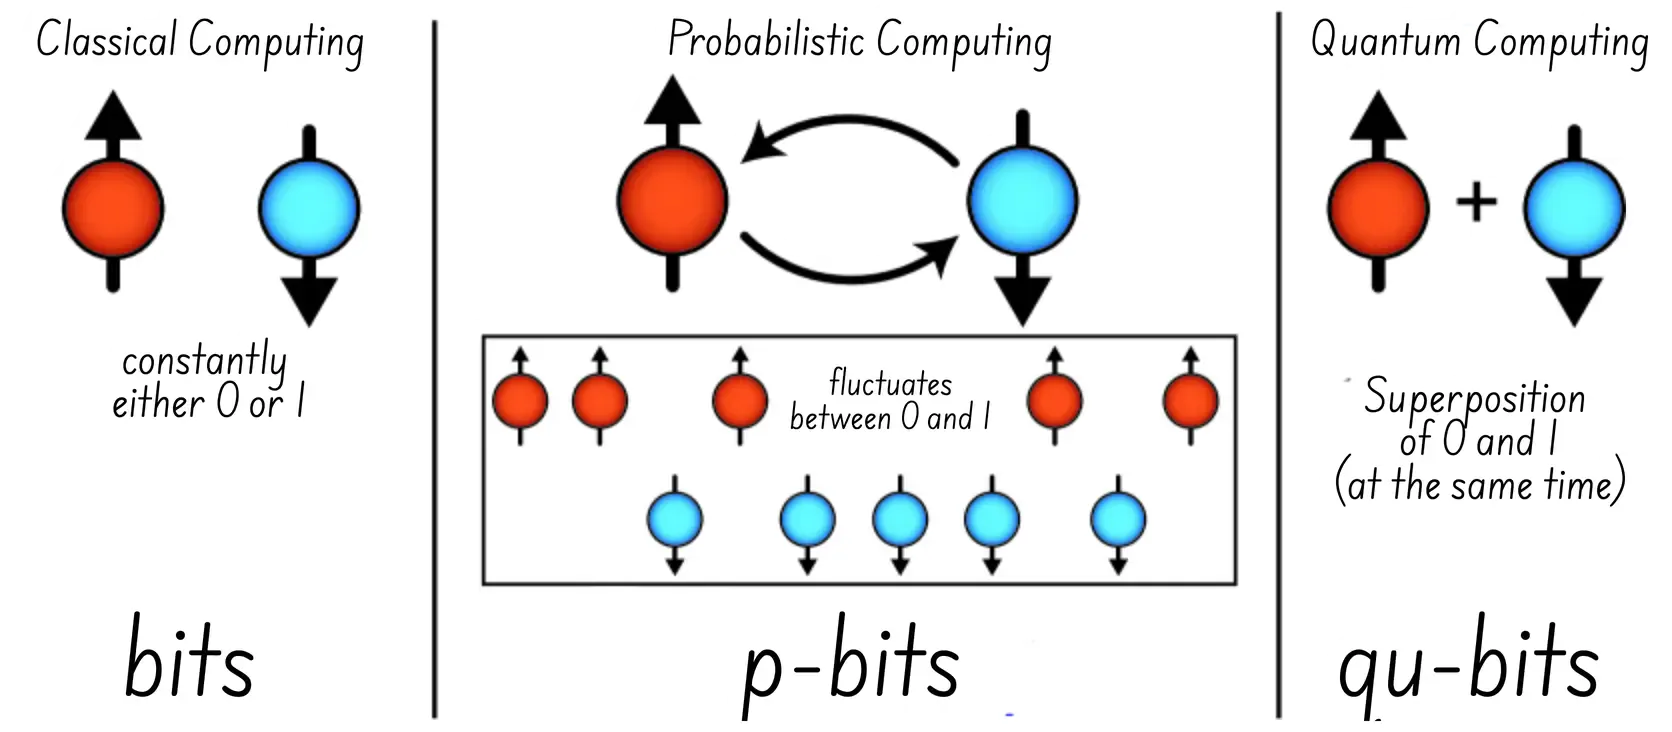
Pourquoi c’est important : Ils affirment que c’est 10 000 fois plus efficace que le GPU pour certaines charges de travail, comme le recuit simulé. Cela pourrait représenter un défi de taille pour les bits quantiques.
Vulnérabilité : Son utilisation à grande échelle nécessite encore des recherches approfondies.
Mottronix
Architecture : SPU (réseau neuronal à impulsions) utilisant des mémoires Mott (Mott-RAM).
Pourquoi cela est important : Nous avons besoin de personnes visionnaires pour examiner des mémoires alternatives, telles que la mémoire résistive (ReRAM), ou, dans le cas de Mottronix, la Mott RAM.
Vulnérabilité : Doit prouver qu’elle peut passer de la recherche à la commercialisation des circuits intégrés.
Akhetonics
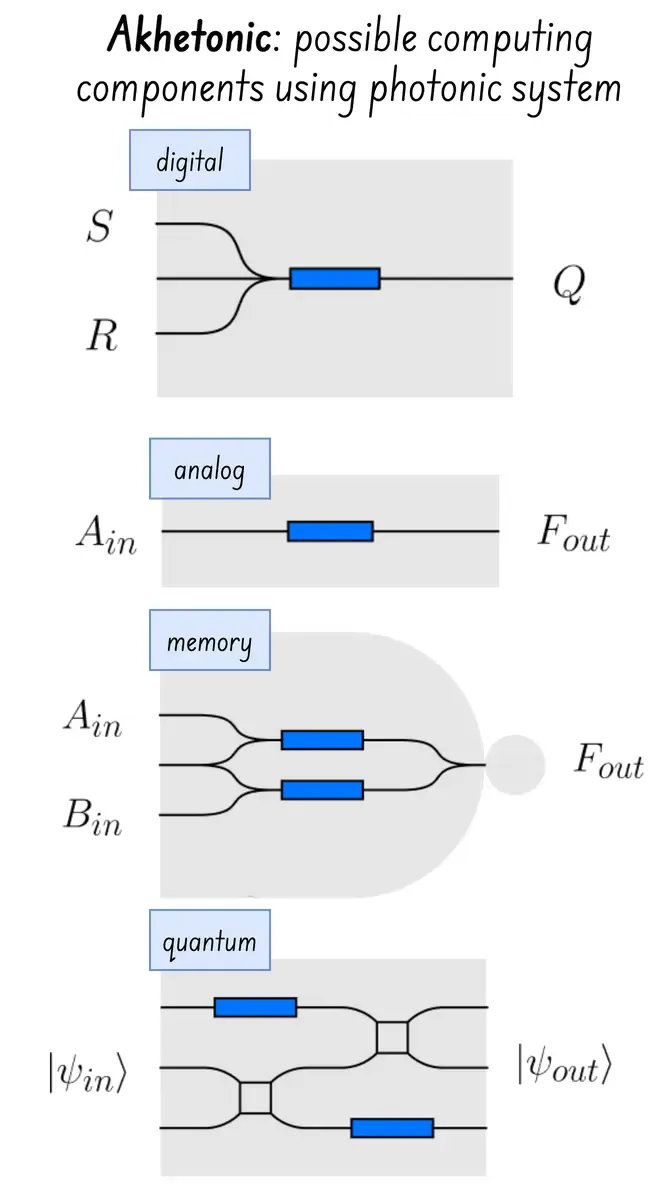
Architecture : RPU (unité de traitement du raisonnement) utilisant un processeur numérique tout optique
Pourquoi c’est important : Le rendement des circuits intégrés photoniques a connu une amélioration spectaculaire au cours de la dernière décennie. NVIDIA, par exemple, est désormais capable de produire commercialement des commutateurs réseau photoniques sur silicium. Appliquer cette technologie au calcul haute performance est une suite logique ! (Ce qui permet également le calcul quantique à adressage optique !)
Vulnérabilité : La différence entre le calcul quantique OAQ et le calcul de raisonnement RPU n’est pas claire, et dans les deux cas, un étalonnage et une mise au point minutieux sont nécessaires avant toute mise à l’échelle vers des solutions commerciales.
Arago
- Architecture : « JEF » en tant qu’accélérateur d’IA photonique, capable de réduire la consommation d’énergie de 10 à 30 fois - Les informations publiques concernant Arago sont très limitées, mais il semble s’agir d’une solution d’intégration hybride déterministe/classique + accélérateur photonique, combinée à un SDK logiciel complet et compatible avec PyTorch.
 IA non conventionnelle
- Architecture : CPU non conventionnelle utilisant l’oscillateur Kuramoto
Pourquoi c’est important : J’adore cette idée, et pour qu’elle se concrétise, la mise en œuvre est essentielle : oser penser différemment ne représente que la moitié du chemin ; ceux qui changent véritablement le monde travaillent au quotidien pour y parvenir. Et pour cela, ils ont un leader doté d’une expérience impressionnante.
- Vulnérabilité : Ils en sont encore au jour 0->1, donc l’exécution est la clé.
Rétrospective du marché en juin 2026
Link to heading
Où se situent les véritables lignes de bataille susceptibles de modifier le paysage actuel du marché ?
L’avantage structurel de NVIDIA ne réside pas dans le GPU, mais dans l’écosystème CUDA qu’elle a développé au cours des dix dernières années. Pour remporter cette bataille, il est indispensable de s’imposer par le logiciel, et pas seulement par le silicium ; c’est là que beaucoup d’entreprises innovantes, centrées sur le matériel, échouent.
AMD représente la menace la plus sous-estimée à court terme pour NVIDIA : inutile de surpasser CUDA, car AMD dispose de son propre outil, et il suffit que ce dernier soit « suffisamment performant » pour les acheteurs de solutions cloud sensibles au coût. ROCm 6.x comble l’écart plus rapidement que prévu.
La plupart des innovateurs tentent une variante du compromis temps-espace ; soit en ajoutant de la mémoire localisée ultra-rapide, soit en autorisant un flux de données configurable dynamiquement (pipelines) ; à l’heure actuelle, le goulot d’étranglement se situe au niveau de la RAM ;
Peut-être que les gagnants seront ceux qui parviendront à gérer les deux simultanément, ce qui sera d’autant plus pertinent pour le calcul de matrices creuses (avec de nombreux zéros), où l’on souhaite éviter à la fois le transfert de zéros en mémoire et leur calcul ! Renegade pourrait-il faire la différence ?
- Les fabricants de puces de nouvelle génération abordent le problème de l’informatique sous un autre angle : la clé réside peut-être dans la modélisation et l’alimentation d’un système dynamique plutôt que dans la multiplication impérative de nombres les uns après les autres ?
Cette frontière pourrait-elle constituer une ligne de démarcation sensible entre l’informatique quantique et l’informatique dynamique ? Pourrait-elle résoudre à la fois le défi de la cryogénie quantique et le problème de la décohérence des qubits en introduisant un système intermédiaire permettant un calcul exponentiel sans décohérence des qubits ?
Orientation technologique et commerciale (2026-2029)
Link to heading
Le résumé ci-dessous présente une vision subjective des horizons allant du niveau 1 au niveau 3. Trois changements majeurs définiront le prochain cycle. Ils sont classés par ordre d’importance.
Puissance de la mémoire™ : C’est la mémoire, et non la puissance de calcul, qui permet de quantifier la puissance.
Link to heading
Les modèles linéaires à longue portée (LLM) sont de plus en plus limités par la bande passante mémoire plutôt que par la puissance de calcul. À mesure que les modèles s’agrandissent et que les fenêtres de contexte dépassent le million de jetons, le coût et la latence des transferts de poids vers/depuis la mémoire HBM deviennent prépondérants. Le compromis réside entre le calcul à proximité de la mémoire grâce à la SRAM intégrée et une mémoire de grande capacité avec une bande passante suffisante : l’indicateur clé de performance (KPI) critique pourrait devenir la consommation mémoire, définie comme le produit de la bande passante par le facteur d’utilisation.
Les modèles de type « mixte d’experts » qui n’activent qu’une fraction des paramètres par jeton (à l’aide d’une matrice creuse) appartiennent également à cette catégorie : la plupart des accélérateurs ne sont pas encore optimisés pour les schémas d’activation clairsemés, et c’est pourquoi NVIDIA a introduit Tensor Core. Il ne s’agit peut-être pas de la solution définitive, mais plutôt d’un correctif matériel en attendant une solution plus robuste et constante.
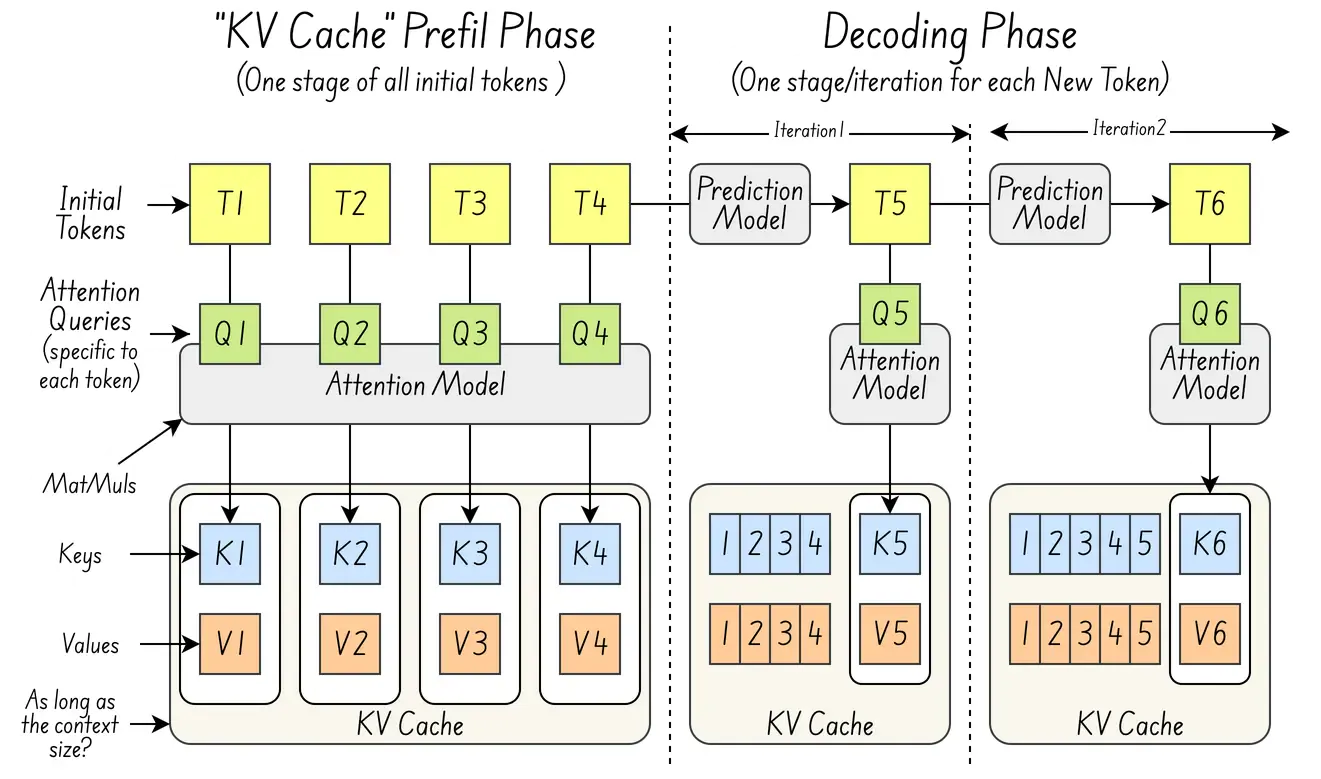 Par exemple, il est désormais courant d’utiliser la désagrégation préremplissage/décodage (PD) pour séparer les étapes de préremplissage (constitution du cache KV initial à partir de nombreux jetons) et de décodage (génération jeton par jeton) d’un modèle linéaire à longue portée (LLM). Ceci ouvre la voie à des coprocesseurs d’inférence dédiés, car le préremplissage exige une plus grande puissance de calcul tandis que le décodage requiert une plus grande capacité de mémoire (le chargement d’un nouveau cache KV étant nécessaire pour chaque jeton).
Le cœur NVIDIA Tensor pour les modèles Mixture-of-Experts épars entre également dans cette catégorie.
Le prix de l’inférence a été divisé par dix environ en deux ans. L’adoption de l’IA en entreprise est freinée par le coût de l’inférence, et non par la qualité des modèles. Conséquence : du matériel d’inférence standard apparaît en dessous du haut de gamme (NVIDIA H100/B200) pour les applications LLM classiques. C’est là que les nouveaux acteurs ont la plus grande opportunité. Imaginez pouvoir exécuter GLM5.2 sur votre matériel standard grâce au processeur Positron Asimov !
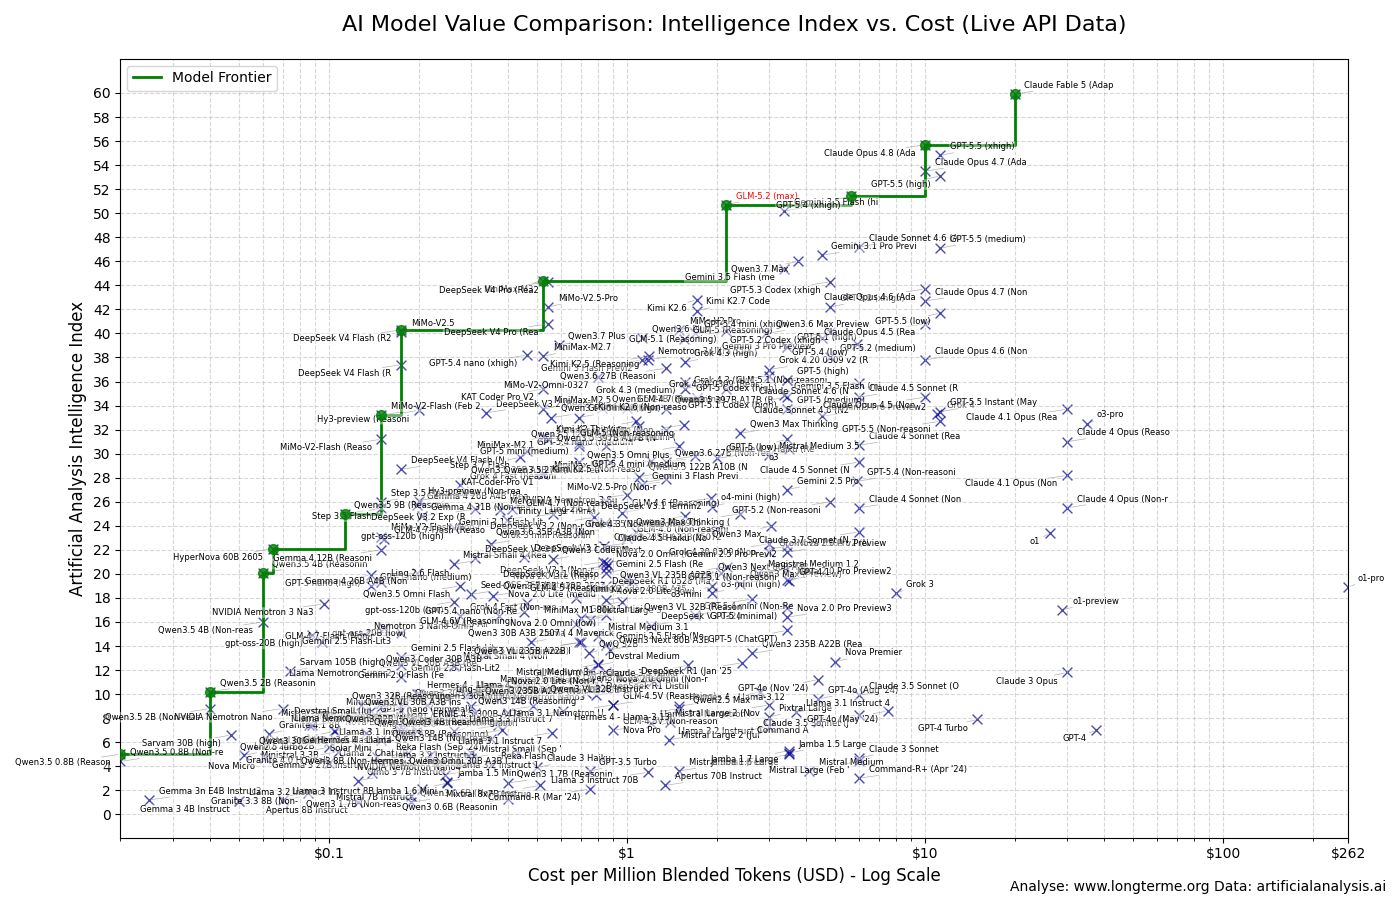 (source de l’image : L’Observatoire du Long Terme - Z AI GLM5.2 est clairement un outsider sur le rapport intelligence/coût - mais nécessite près de 200 Go de mémoire)
Simplicité du déploiement : Enfin, et surtout : facilité d’utilisation pour le matériel, le logiciel, l’interface utilisateur et les outils
Link to heading
Les entreprises sous-estiment systématiquement la complexité opérationnelle. Les fournisseurs proposant des solutions d’inférence clés en main avec un environnement d’exécution sans configuration (et pas seulement des puces) capteront une part disproportionnée du budget des entreprises.
Ce phénomène sera accentué par la nécessité d’une inférence sur site en raison des pressions réglementaires dans l’UE et la région Asie-Pacifique, car, en effet, de nombreuses entreprises ne souhaitent pas inférer leurs connaissances propriétaires sur un système étranger.
Le marché de l’inférence en 2024-2026 ressemble au marché des réseaux de 2000-2003. NVIDIA est l’équivalent de Cisco à l’époque : dominant, surdimensionné pour de nombreux cas d’utilisation et proposé à un prix élevé. La question n’est pas de savoir s’il faut concurrencer NVIDIA sur ses meilleures charges de travail, mais plutôt d’identifier les domaines où NVIDIA propose des solutions surdimensionnées et ceux où une alternative dédiée peut offrir 80 % des performances pour 40 % du coût.
Dans le même temps, NVIDIA investit massivement dans l’écosystème, et les excellentes contributions entièrement open source comme CudaQ et NVQLink qu’elle offre gratuitement à la communauté rendront plus difficile pour tout concurrent de NVIDIA de conquérir ces communautés.
Voilà, c’était une brève et superficielle note du dimanche matin. Je devrai approfondir les détails architecturaux des futurs concurrents, et heureusement, je pourrai rédiger une note pour au moins deux d’entre eux d’ici la fin de l’été. En attendant, la prochaine note portera sur le sujet tant attendu (que plusieurs lecteurs m’ont demandé d’aborder) : la correction d’erreurs quantiques en bref !
https://api-docs.deepseek.com/news/news260424
Inférence SNN sur une plateforme neuromorphique hétérogène multicœur SpiNNaker2](https://arxiv.org/pdf/2406.17049)
Diagrammes DrawIO utilisés dans cette note :