Ralf Levien est célèbre pour son implémentation ultra-efficace du moteur de rendu de glyphes le plus rapide au monde, grâce à une conception SIMD très ingénieuse basée sur Rust. Son travail m’a beaucoup inspiré lorsque je concevais un GPU SIMD chez Bestechnics en 2023. Par la suite, Ralf Levien a également travaillé sur une version GPU de ce moteur de rendu de glyphes.
Alors, lorsque je suis tombé sur sa dernière conférence intitulée « Comment Rust a gagné : la quête d’un logiciel performant et fiable », j’ai simplement décidé de consacrer une heure de mon temps à regarder la conférence et à en tirer des enseignements intéressants.
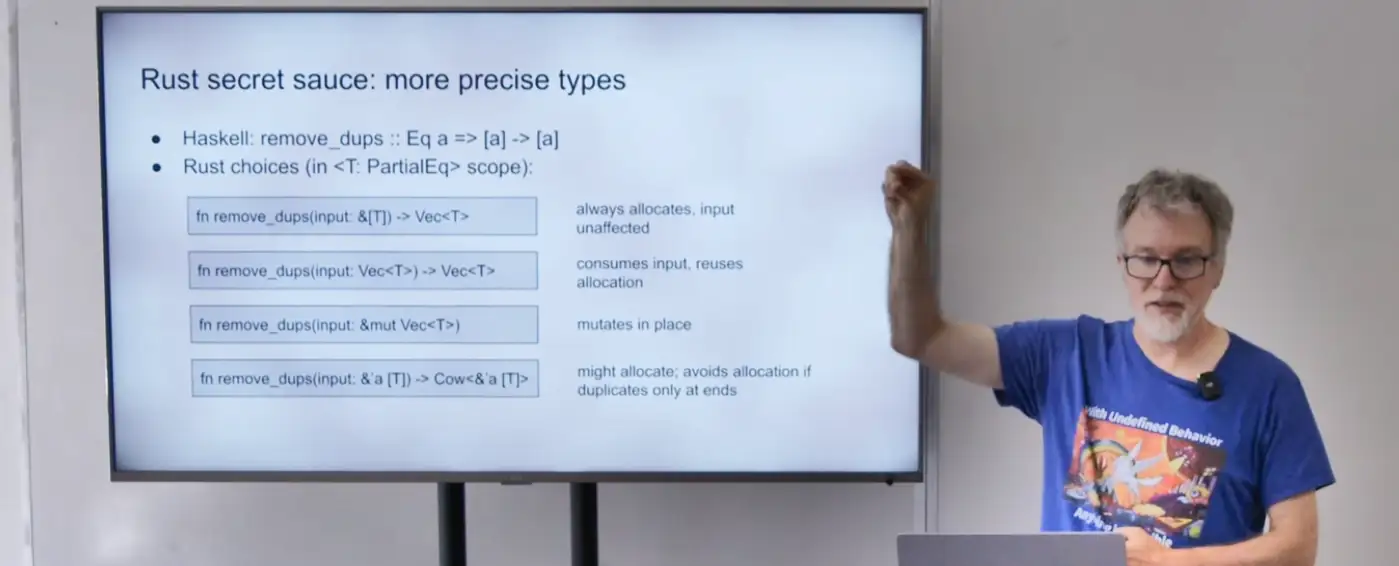
La partie intense (également connue sous le nom de zone de noyade) commence vers 55:00, avec une diapositive intitulée La sauce secrète de Rust : un type plus précis.
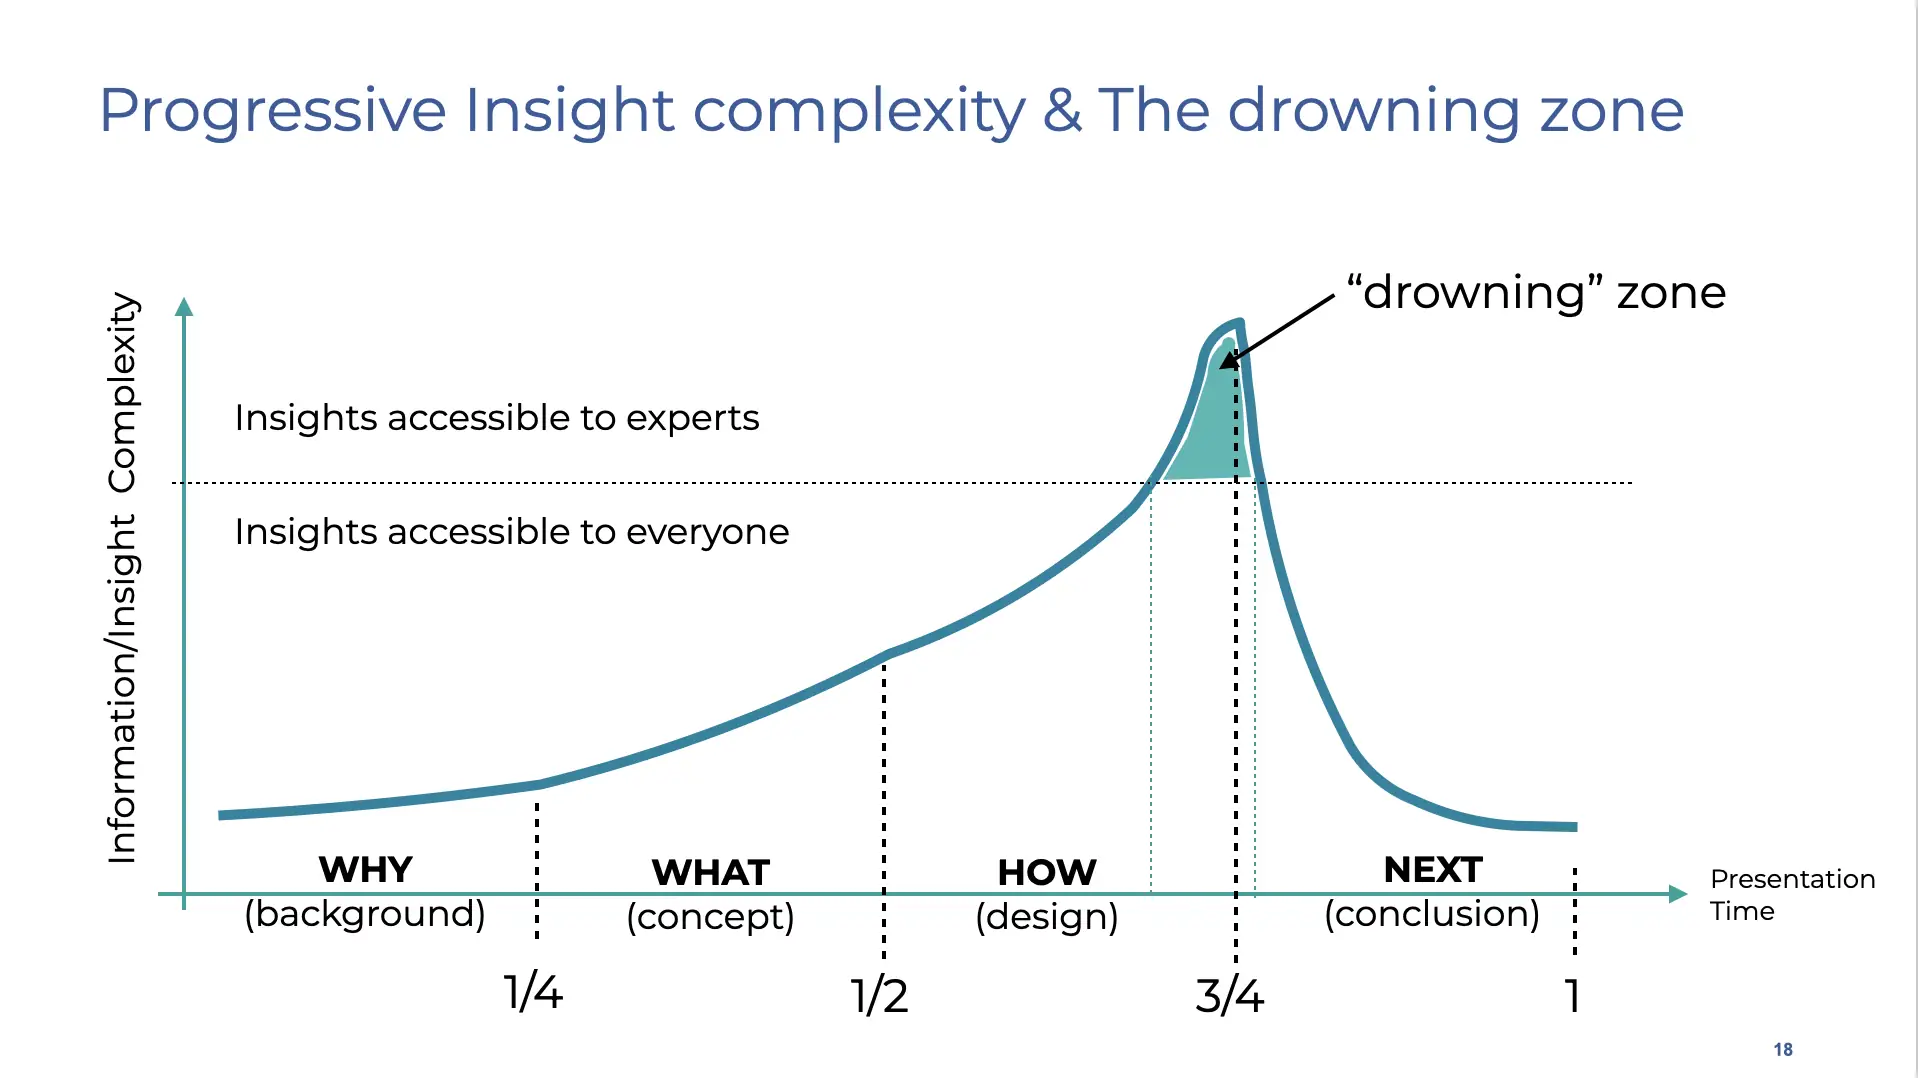
À 56:50, Raph dit : « C’est là que le type affine entre en jeu ; vous souhaitez modéliser (la clonabilité) comme « il existe une instance de ceci » ; et le type vous permet de spécifier précisément, dans la signature de la fonction, comment cette propriété sera gérée ; et je passerai sur le dernier exemple, mais c’est amusant, non ? »
Je ne prétends absolument pas être un expert en Rust, et j’avoue avoir une légère préférence pour Go. Ma question est donc la suivante : puis-je comprendre ce que signifie concrètement le terme « type affine » ? Et est-il possible de me l’expliquer simplement, sans avoir à me noyer sous un flot de connaissances ?
Une autre question, soulevée dans les commentaires YouTube : il semblerait que le type de retour de la dernière fonction devrait être Cow<'a, [T]> au lieu de Cow<&'a [T]>. Franchement, ça me paraît encore plus compliqué que les algorithmes quantiques. Mais peut-être que ce n’est pas forcément le cas !
Examinons donc de plus près ces exemples de « recette secrète pour une typographie plus précise » :
fn α( l: &[T] ) → Vec<T> : alloue toujours, l’entrée reste inchangée
fn β( l: Vec<T> ) → Vec<T> : consomme l’entrée et réutilise l’allocation.
fn δ( l: &mut Vec<T> ) : aucune allocation, modifie simplement le vecteur d’entrée
fn ω( l: &'a [T]) → Cow<'a,[T]>: peut allouer de la mémoire ; évitez l’allocation si les doublons ne se trouvent qu’aux extrémités.
Le premier point à vérifier concernant le modèle générique T ? Fonctionne-t-il correctement ? Ces fonctions peuvent-elles être compilées telles quelles ? Essayons avec la version la plus simple de la fonction :
// fails with: error cannot find type T in this scope
fn α( l: &[T] ) -> Vec<T> { vec![] }
Cela ne fonctionne évidemment pas et échoue avec l’erreur « type T introuvable dans cette portée ». Si vous êtes familier avec le C++, vous vous attendez à ce que le type T soit déclaré avec le nom de la fonction, donc déclarer α<T> au lieu de α.
// all right with the T declaration
fn α<T>( l: &[T] ) -> Vec<T> { vec![] }
Cela fonctionne parfaitement ainsi ! Mais lorsqu’on ajoute une implémentation de base (qui se contente de convertir en vecteur, sans supprimer les doublons), le compilateur échoue avec l’erreur suivante : « La contrainte de trait T: Clone n’est pas satisfaite ».
// fails with: the trait bound `T: Clone` is not satisfied
fn α<T>( l: &[T] ) -> Vec<T> { l.to_vec() }
Heureusement, Rust possède une très bonne documentation sur les génériques et les traits, et après une lecture de 10 minutes, il devient évident que nous devons modifier le α<T> à α<T: Clone> comme moyen d’exprimer la limite du trait de type T.
// all right with the trait bound
fn α<T: Clone>( l: &[T] ) -> Vec<T> { l.to_vec() }
L’étape suivante consiste à implémenter une solution pour supprimer les doublons. Pour cela, une approche possible est d’utiliser un HashSet. Tout d’abord, le tableau est converti en un itérateur (let iterator: std::slice::Iter<T> = l.iter();), et nous construisons ensuite un ensemble de hachage à partir de cet itérateur (HashSet::from_iter(iterator)), et enfin nous convertissons l’ensemble de hachage en un vecteur set.into_iter().collect().
//Fails with: the trait bound `T: Eq` is not satisfied
use std::collections::HashSet;
fn α<T: Clone>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Sans surprise, cela échoue ! Et c’est normal, car si vous aviez passé les 10 minutes à lire la documentation Rust sur les traits, vous sauriez que HashSet requiert probablement une méthode pour « comparer » les éléments de type T. C’est le rôle du trait Eq ; ajoutons-le donc à la contrainte de trait (de α).<T: Clone> àα<T: Clone + Eq> `):
//Fails with: the trait bound `T: Hash` is not satisfied
use std::collections::HashSet;
fn α<T: Clone + Eq>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Cela échoue toujours, et la raison est que nous avons oublié de préciser que le type T doit pouvoir être converti en une valeur de hachage. C’est le rôle du trait Hash. Donc, changeons α.<T: Clone + Eq> àα<T: Clone + Eq + Hash> `
//Fails with: a value of type `Vec<T>` cannot be built from an iterator over elements of type `&T`
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
C’est là que la clonabilité devient intéressante : l’ensemble de hachage est une structure contenant des pointeurs vers les éléments initialement présents dans la liste et passés par valeur (plus précisément, le tableau a été passé par pointeur et contenait des éléments référencés par valeur). Il faut donc indiquer à l’ensemble de hachage de créer une copie de ces éléments, ce qui se fait en ajoutant cloned() avant le dernier [collect](https://doc.rust-lang.org/std/iter/trait.Iterator.html#method.collect) (la méthode collect sert à transformer l’itérateur en une collection de vecteurs).
// all right!
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().cloned().collect()
}
Et voilà, nous sommes prêts avec le premier exemple de fonction :
fn main() {
println!("{:?}", α(&["A","A","B","D"]));
println!("{:?}", α(&[1,1,2,4]));
}
Honnêtement, c’est à la fois complexe et simple. Complexe car le compilateur impose des règles strictes, qui doivent être déclarées explicitement plutôt que d’être déduites implicitement, ce qui rend l’apprentissage difficile. Simple, car une fois qu’on a passé les « 10 minutes » à lire la documentation, ça devrait être plus facile. Le problème n’est peut-être pas qu’il faille 10 minutes pour lire la documentation, mais plutôt 10 heures pour comprendre ce qui est écrit. J’ai une impression de déjà-vu…
J’ai encore une question concernant la clonabilité. Pourrions-nous renvoyer un vecteur contenant uniquement des références aux éléments passés dans le tableau ? À première vue, il suffirait de modifier Vec<T> à Vec<&T> … et gérer correctement les contraintes de type affine ? Essayons :
// All right - works fine
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<&T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Eh bien, ça fonctionne ! Et aucune plainte concernant la durée de vie ? Je veux dire, n’empruntons-nous pas les éléments, auquel cas la durée de vie devrait être vérifiée ? Le problème vient-il du fait que notre fonction main est trop simple ? Essayons donc quelque chose de plus complexe :
// fails with expected named lifetime parameter
fn limited_lifetime() -> vec<&str> {
let l = ["A","A","B","D"];
α(&l)
}

fn main() {
let v = limited_lifetime();
println!("{:?}",v);
}
Cette fois-ci, ça ne marche pas : le compilateur signale l’absence d’un paramètre de durée de vie. Prenons donc dix minutes supplémentaires pour consulter la documentation Rust concernant la validation des références avec des durées de vie (Validating References with Lifetimes). À première vue, il suffit d’ajouter le ‘a ?
//  fais with: mismatched types; expected `&[str]`, found `&[&str; 4]`
fn limited_lifetime<'a>() -> Vec<&'a str> { ... }
Mais non, cela ne fonctionne pas. Essayons de convertir la chaîne immuable en une chaîne dynamique :
// fails with: cannot return value referencing local variable `l`
fn limited_lifetime<'a>() -> Vec<&'a String> {
let l = ["A".into(),"A".into(),"B".into(),"D".into()];
α(&l)
}
D’accord, c’est bien l’erreur attendue : le vérificateur d’emprunt fonctionne correctement. Mais comment indiquer au compilateur que nous souhaitons transférer la propriété de ces variables allouées localement ? Pour cela, nous devons lui préciser que nous voulons allouer le tableau l sur le tas. Et pour cela, nous devons utiliser un vec au lieu d’un tableau.
// this works
fn β<T: Clone + Eq + std::hash::Hash>( l: Vec<T> )  -> Vec<T> {
let hash_set: HashSet<_> = l.into_iter().collect();
hash_set.into_iter().collect()
}

fn limited_lifetime<'a>() -> Vec<&'a str> {
let l2 = vec!["A","B","B","D"];
β(l2)
}

fn main() {
println!("{:?}",limited_lifetime());
}
Cette version fonctionne car la nouvelle fonction β prend un vecteur d’éléments et renvoie l’élément lui-même plutôt qu’un pointeur vers celui-ci. Les éléments sont donc clonés. Que se passerait-il si, au contraire, nous voulions que la fonction β renvoie un pointeur vers les éléments d’entrée ?
Troisième défi : Cloner sur écriture
Link to heading
Vous vous souvenez de la « vache » dans la dernière fonction oméga ?
fn ω( l: &’a [T]) → Cow<&’a [T]>
Cow est en réalité une énumération. Elle peut contenir soit une référence immuable (empruntée), soit un clone mutable de cette même référence. Par exemple :
use std::borrow::Cow;
fn trim_input(input: &str) -> Cow<str> {
if input.ends_with(' ') {
Cow::Owned(input.trim_end().to_string())
}
else  Cow::Borrowed(input)
}
Faut-il donc écrire Cow<'a [T]> ou Cow<&'a [T]> ? À première vue, puisque l’entrée est un pointeur & avec une durée de vie 'a vers un objet de type [T], la sortie est également un pointeur vers un objet du même type. La différence réside dans le fait que Cow<> représente aussi un pointeur. Donc, oui, la réponse correcte est bien Cow<'a, [T]>.
fn ω<'a, T>( l: &'a [T]) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
Le plus intéressant, c’est qu’en Rust, la longueur des tableaux est fixée à la compilation. Comment pourrait-on alors allouer, à l’exécution, un nouveau tableau de taille dynamique ? Apparemment, d’après ce commentaire sur Stack Overflow (https://stackoverflow.com/a/34684869/5102743), ce n’est pas possible. Ralf voulait peut-être plutôt utiliser un vec ?
fn ωx<'a, T: Clone + Eq + std::hash::Hash>( l: &'a Vec<T>) -> Cow<'a, Vec<T>> {
let hash_set: HashSet<_> = l.into_iter().collect();
if hash_set.len()==l.len() {
return Cow::Borrowed(l);
}
let own_copy = hash_set.into_iter().cloned().collect();
return Cow::Owned(own_copy);
}
Honnêtement, je dois admettre que je me suis noyé sous la syntaxe “fn ω<‘a, T>( l: &‘a [T]) -> Cow<‘a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }”, qui devrait simplement signifier “un clone du même”.
Si l’on considère que &'a T peut être réécrit comme Ptr<'a,T>, alors on peut également réécrire la fonction comme suit :
fn ω<'a, T>( l: Ptr<'a, [T]>) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
Si l’on omet le fait que T est un tableau, le code ci-dessus peut être réécrit comme suit :
fn ω<'a, T: ToOwned>( l: Ptr<'a, T>) -> Cow<'a, T> { Cow::Borrowed(l) }
Et si l’on réécrivait le type sous forme d’expression basée sur une macro plutôt que sur une syntaxe ?
fn ω<'a, T>( l: Ptr<'a, T> ) -> !Cow(l) { Cow::Borrowed(l) }
En autorisant la réécriture, la macro !Cow(l) peut sous-entendre que le type T doit être lié au trait ToOwned. De ce fait, on peut supposer que a et T sont des types génériques qui n’ont pas besoin d’être spécifiés explicitement lors de l’utilisation du trait Ptr.
fn ω( l: Ptr ) -> !Cow(l) { Cow::Borrowed(l) }
Ce qui est déroutant, c’est que l’on spécifie à la fois le type à la compilation et l’implémentation à l’exécution sans aucune distinction. Mais peut-être est-ce là l’essence même de Rust ?
Je pense que le « secret » de Ralf mériterait une heure d’explication et une présentation PowerPoint dédiée, et non pas trois minutes dans une conférence d’une heure. Il serait également pertinent d’en avoir un regard critique : tout n’est-il pas aussi plaisant qu’on le croit ? Peut-être y a-t-il une complexité excessive qui rebute certains développeurs ? Et est-ce là le véritable sens du terme « amusant » ? Quoi qu’il en soit, je vais essayer de préparer quelques diapositives pour une présentation d’une heure dans les prochaines semaines.
Revenons au défi de l’informatique quantique : faut-il un niveau de complexité similaire pour que les systèmes fonctionnent ? N’est-ce pas là le véritable enjeu aujourd’hui ? Malgré leur apparente complexité, les algorithmes quantiques sont relativement simples comparés à cette syntaxe rudimentaire. Devrions-nous anticiper pour résoudre le problème de l’utilité de l’informatique quantique ? Et si, sans cette complexité supplémentaire, nous ne pouvions toujours effectuer que des calculs élémentaires ?
Partant du principe que tout cela concerne la sémantique des objets que nous voulons manipuler, il nous faut peut-être réaliser qu’il existe un niveau d’abstraction logique au-dessus des qubits, qui n’est pas encore évident car l’industrie peine encore à faire en sorte que les qubits se comportent correctement.