El uso de la IA, o más precisamente de las redes neuronales (RN), no solo es obvio, sino que se convertirá en una parte casi indispensable de cualquier sistema en 2025. No es de extrañar que se hayan publicado numerosos artículos de investigación sobre este tema. Sin embargo, la investigación más reciente ha llevado los límites a un nivel superior al permitir la integración de alto rendimiento de redes neuronales dentro del sistema de control cuántico.
Este artículo se basa en el trabajo del Centro de Tecnologías Cuánticas de Singapur CQT/NUS, y más específicamente en la investigación de Arthur Strauss, con quien tuve el gran honor de conversar e intercambiar ideas durante el último evento de la SQA.
El aprendizaje por refuerzo al rescate
Link to heading
Su idea es fascinante: utilizar un enfoque de aprendizaje por refuerzo para ayudar al sistema de control cuántico a ajustar el control de los cúbits (también conocidos como puertas lógicas), basándose en un sistema de recompensas que busca maximizar la eficiencia del control. Quizás se pregunten por qué esto es importante. Pues bien, como se explica en el artículo anterior (link), los cúbits son “entidades” muy sensibles que requieren una atención cuidadosa. Y aquí es donde entra en juego la red neuronal, ayudando a cuantificar la calidad de esta atención, que a veces también se denomina fidelidad.
¿Cómo funciona esto? El aprendizaje por refuerzo se basa en un ciclo de Observación/Acciones que se aprenden a través de un sistema iterativo de recompensa Entorno -> Agente (“a” en el diagrama a continuación), generalmente ejecutado con una GPU, y luego, una vez aprendido, ejecutado en una matriz de matrices estrechamente acoplada (¡o no!) en el sistema de control cuántico (“b” en el diagrama a continuación).
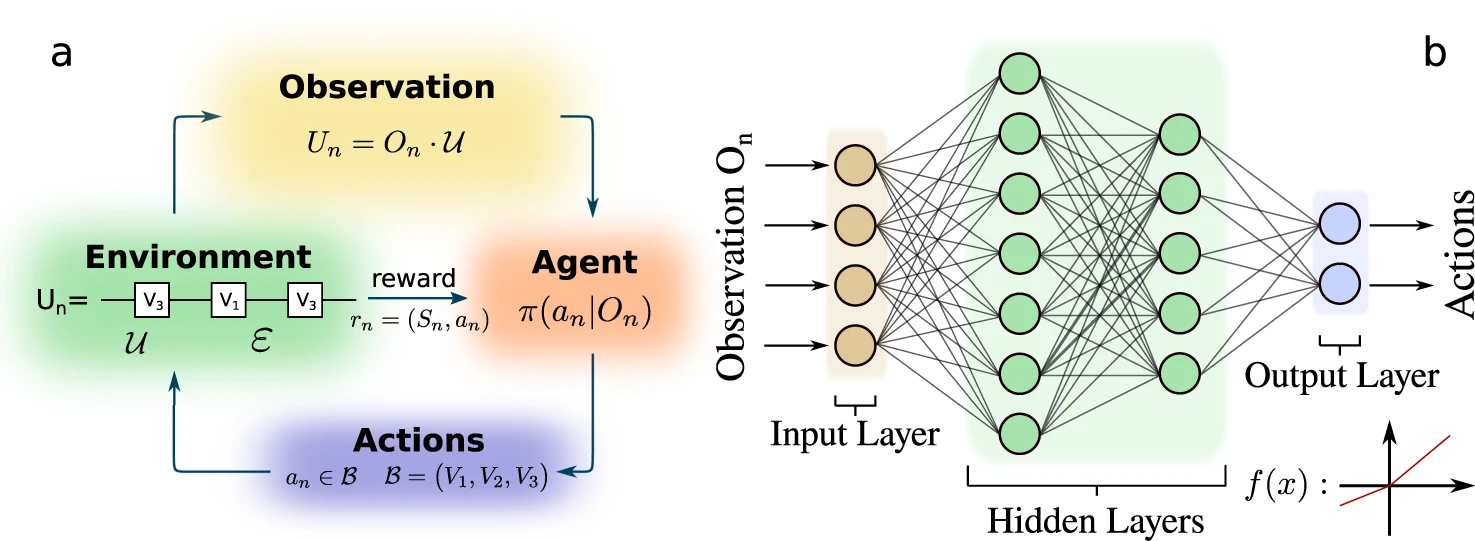 Créditos: Nature
Cabe señalar que, dado que la observación (también llamada lectura del cúbit) destruye el estado cuántico, el ciclo de aprendizaje primero restablece el estado del cúbit, realiza una puerta de control, lee el estado del cúbit y alimenta la información al agente.
Sistemas RL: Componentes clave
Link to heading
Analicemos en detalle los 4 componentes del aprendizaje por refuerzo:
El entorno es el controlador cuántico y el cúbit en sí.
Las acciones consisten en ajustar los diferentes “perillas” o parámetros de pulso del motor del generador de RF.
La observación son las características del cúbit después de haber sido manipulado por el entorno.
El agente es el que aprende la política que reacciona a las características observadas del cúbit y adapta los parámetros del pulso en consecuencia.
Sistemas de aprendizaje por refuerzo: Métodos de aprendizaje
Link to heading
Los métodos de aprendizaje por refuerzo generalmente se pueden clasificar en dos grandes categorías: basados en valores y basados en gradientes de política.
Los métodos basados en valores se centran en estimar una función de valor y derivar políticas a partir de ella. Los métodos basados en políticas optimizan directamente la política maximizando la recompensa acumulada esperada mediante el ascenso de gradiente.
La ventaja de la iteración de políticas es que converge mucho más rápido que la basada en valores, aunque es computacionalmente más costosa. Y ahí es donde entran en juego los algoritmos de gradiente de políticas, al reducir la complejidad computacional. Ejemplo de algoritmos de gradiente de políticas, incluido el algoritmo reinforce:
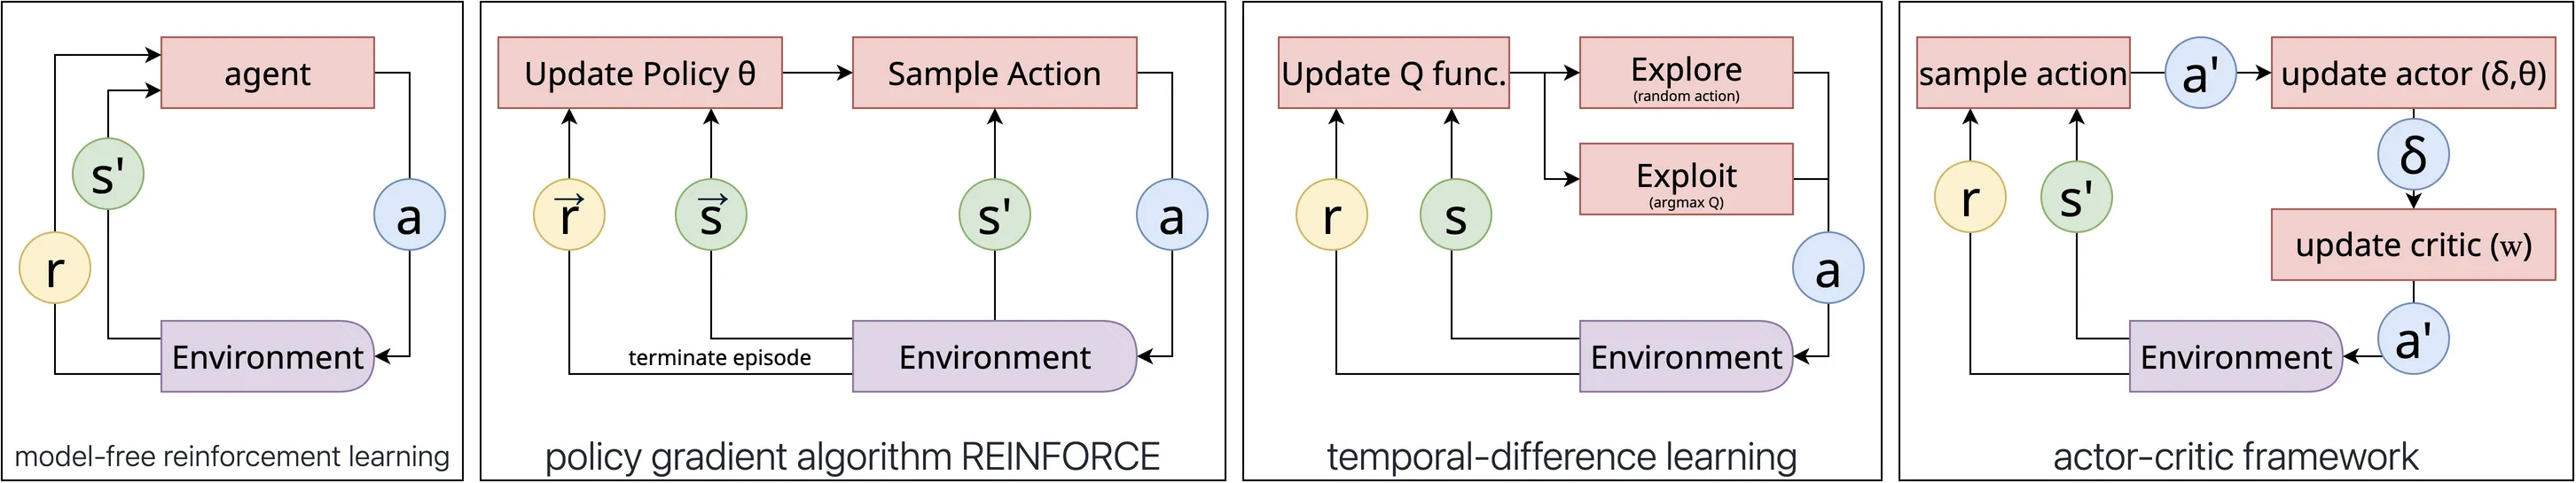
En los diagramas anteriores, s representa el estado, a la acción y r la recompensa.
Sistemas de aprendizaje por refuerzo: Iteración vs. Episodios
Link to heading
En el aprendizaje por refuerzo, un episodio y una iteración son conceptos diferentes:
Episodio:
Un episodio es una secuencia completa de interacciones entre el agente y el entorno, que comienza en un estado inicial y termina en un estado terminal (o después de un horizonte temporal máximo).
Ejemplo: En una partida de ajedrez, un episodio es una partida completa, desde el tablero inicial hasta el jaque mate, las tablas o la rendición.
Iteración:
En algunos documentos/código, una iteración puede significar un paso de tiempo de interacción agente-entorno (estado → acción → recompensa → siguiente estado).
En contextos de optimización, una iteración puede significar un paso de actualización del algoritmo de aprendizaje (por ejemplo, un paso de descenso de gradiente, que podría basarse en múltiples episodios o transiciones).
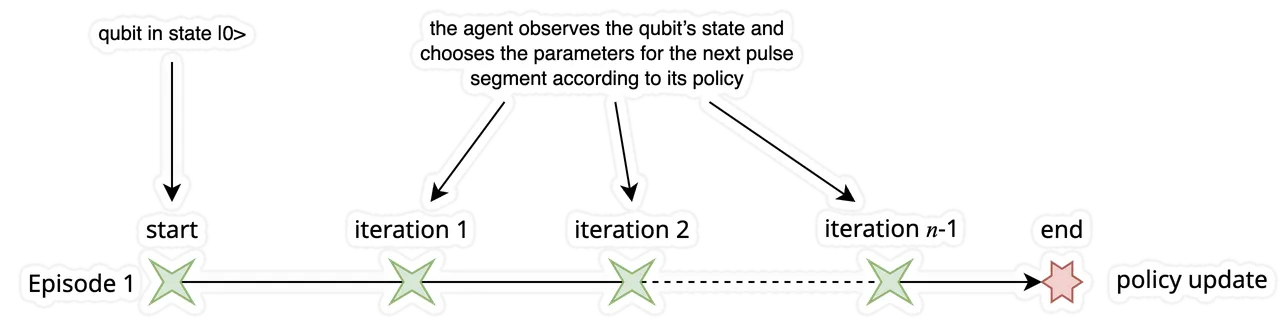
Vamos a implementar estas ideas una por una, comenzando por el muestreo de episodios.
Los episodios comienzan con el cúbit en el estado |O>.
Iniciar el ciclo de observación-acción
el agente observa el estado del cúbit
y elige los parámetros para el siguiente segmento de pulso de acuerdo con su política.
Explora probando la acción:
En lugar de elegir de forma determinista la “mejor” acción (por ejemplo, la que tiene la mayor probabilidad), el muestreo significa que el agente extraerá aleatoriamente una acción de esa distribución, de acuerdo con las probabilidades.
Este muestreo es esencial en el método reforzar.
Calcular la función puntuación:
medir cuánto más (o menos) probable se vuelve la acción elegida si los parámetros de la red se modifican en una dirección particular.
En otras palabras, evalúe ∇(𝜃) para la acción muestreada.
Calcula su recompensa cuando se alcanza el final del programa de pulsos.
La puntuación y la recompensa, en conjunto, impulsan la actualización del aprendizaje en el aprendizaje por refuerzo de gradiente de política:
por completar
Lo siento, se suponía que este sería un blog ligero, y resulta ser mucho más complejo. Quizás aún deba seguir “simplificando la ecuación”. En cualquier caso, ¿qué aprendimos aquí? El proceso de optimización para cuantificar de forma óptima la calidad de los cúbits tiene demasiadas dimensiones y, como era de esperar, las redes neuronales son muy buenas para resolver este desafío. En este blog, nos hemos centrado en la optimización de la fidelidad de un solo cúbit. Pero pensemos en dos o más cúbits: entonces necesitamos aprender el impacto de la diafonía. Hay muchas preguntas y desafíos, especialmente en cuanto a cómo aprender: globalmente a nivel de muchos cúbits, o localmente, y a nivel de pares de cúbits. Quizás incluso jerárquicamente a nivel de cúbit lógico. Muchas preguntas, que abordaré en el próximo blog sobre corrección de errores cuánticos.
Para más información y enlaces: