En un mundo donde la IA consume mucha energía, la Unidad de Procesamiento Tensorial (TPU) supone un cambio radical. Se trata de un chip diseñado a medida por Google específicamente para tareas de aprendizaje automático.
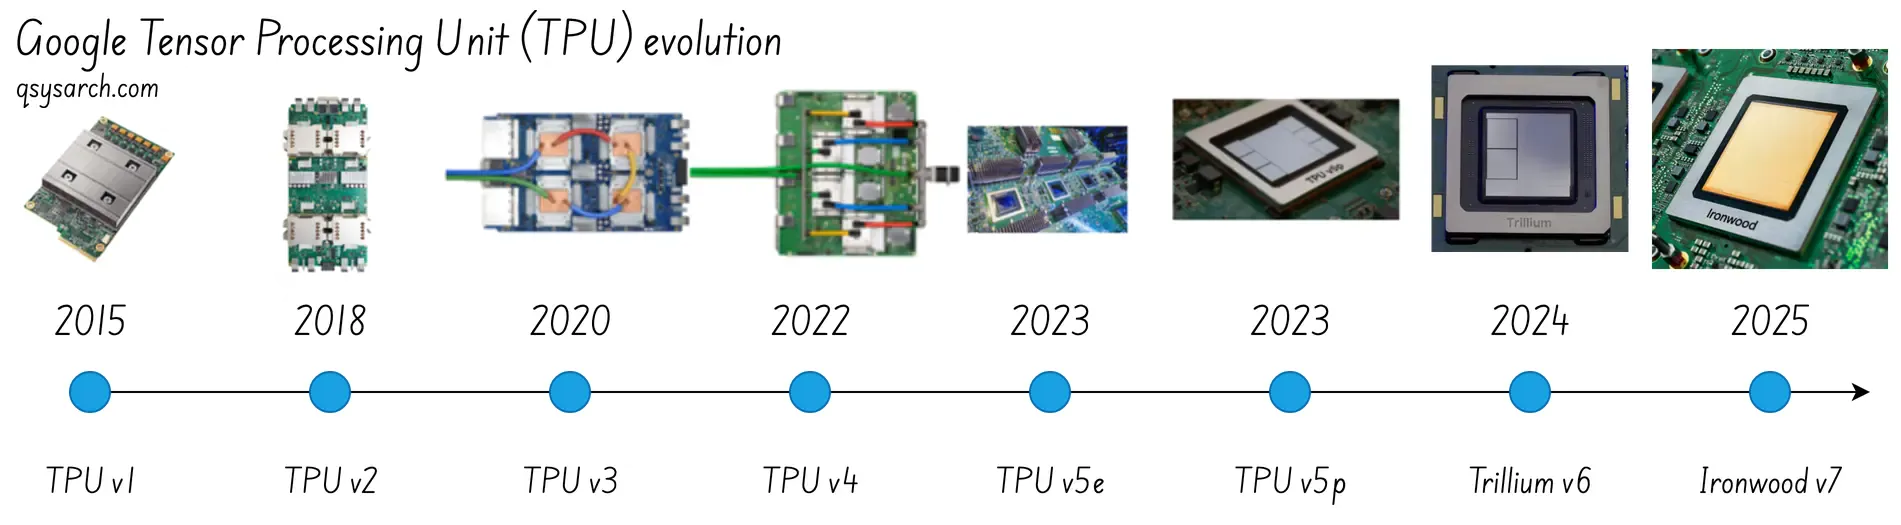
Este breve memorándum pretende ofrecer una visión general del sistema, a alto nivel, de la arquitectura de las TPU y de cómo han evolucionado desde su creación en 2016.
También intentaré responder a esta pregunta fundamental: ¿por qué necesitamos TPU si ya tenemos GPU? ¿Qué ventajas ofrecen que las GPU no tengan? ¿Cómo se comparan con los circuitos integrados neuromórficos? ¿Y existe alguna arquitectura alternativa a las TPU y las GPU?
 (Fuente: Google Cloud)
Por qué existe la TPU y qué problemas resuelve
Link to heading
La TPU comparte el mismo objetivo que la GPU: superar la limitación introducida por la ralentización de la Ley de Moore, al permitir un paralelismo masivo: a diferencia de la CPU tradicional que se puede utilizar para manejar cálculos genéricos y que, hasta cierto punto, tiene un nivel de paralelismo a través del concepto de multinúcleo (gracias a la ley de escalado de Dennard), la TPU y la GPU son hardware especializado diseñado para manejar tareas simples y específicas, pero de una manera mucho más eficiente que cualquier CPU.
En términos generales, se puede decir que ofrecen un rendimiento y una eficiencia mucho mejores que las CPU o GPU de propósito general al “intercambiar generalidad por rendimiento”.
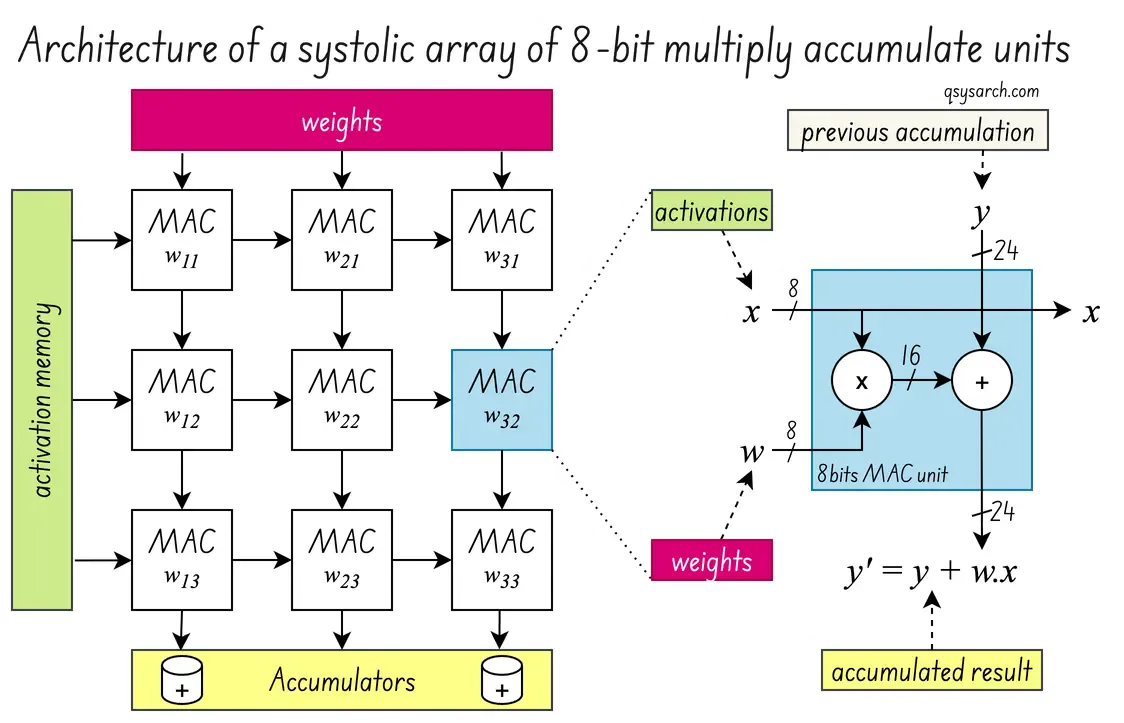
La TPU está diseñada fundamentalmente para tareas complejas de álgebra lineal, como multiplicaciones de matrices y operaciones con tensores, que son las que utilizan las redes neuronales.
En el núcleo de la TPU se encuentra la matriz sistólica, una matriz de elementos de procesamiento (generalmente llamada PE, representada como MAC en el diagrama de la derecha) que puede realizar cálculos en paralelo.
En el caso de la TPU, esta unidad de procesamiento, o MAC, es un simple multiplicador de 8 bits que multiplica y acumula los valores de activación (la incrustación) con los pesos de la red neuronal. Solo al realizar esta operación de forma masivamente paralela, la TPU logra un rendimiento mucho mayor que una CPU. ¡Y lo mismo ocurre con las GPU! Pero primero, veamos la evolución de la TPU a lo largo del tiempo.
Evolución de la TPU a lo largo del tiempo
Link to heading
TPUv1: la primera generación de TPU
Link to heading
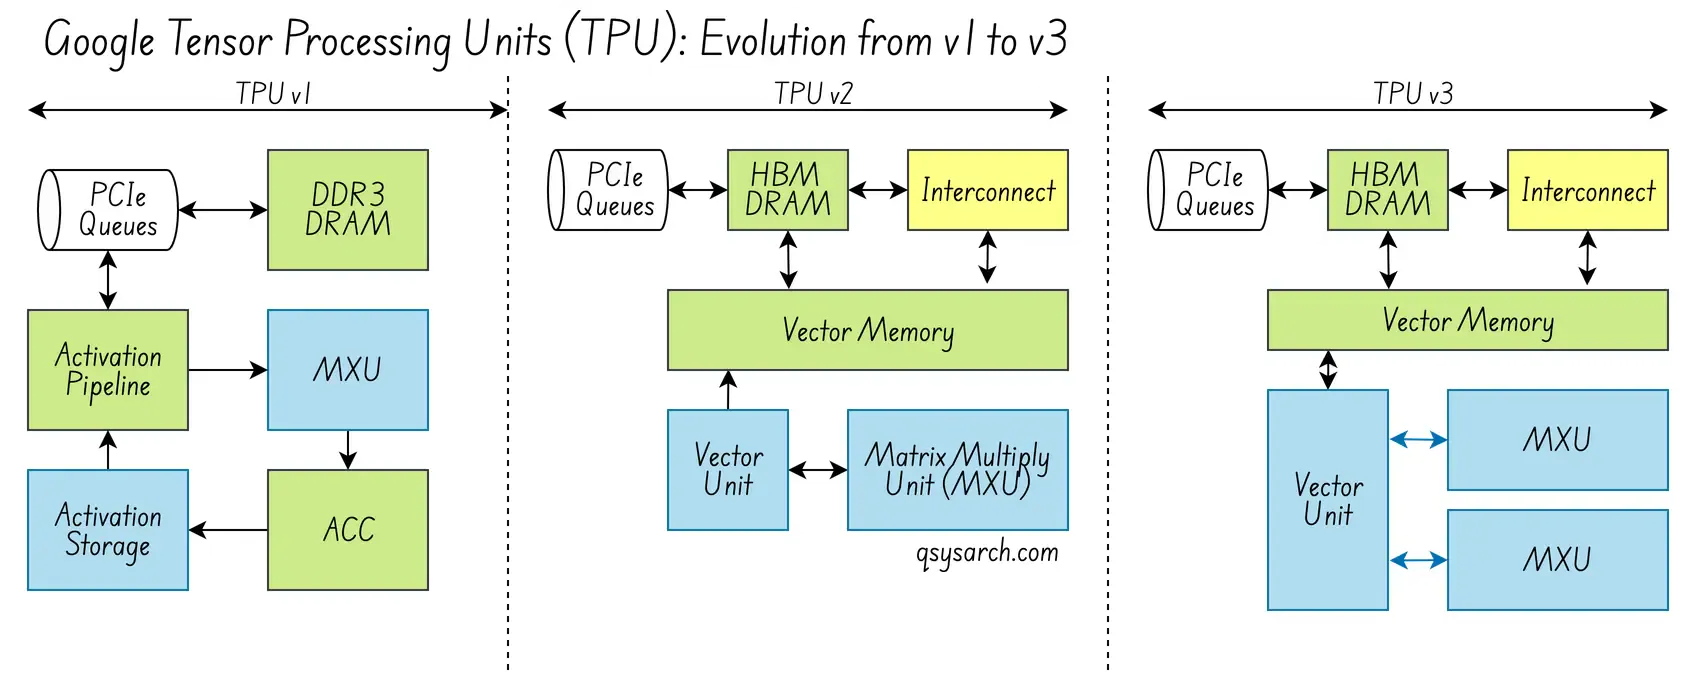
El TPUv1 se desarrolló en tan solo 15 meses, con el objetivo principal de mejorar la inferencia de redes neuronales (no el aprendizaje, sino únicamente la inferencia). Para ello, Google necesitaba multiplicadores de matrices y tenía limitaciones no solo para lograr alta velocidad, sino también para reducir el consumo de energía. La clave para reducir el consumo de energía radicaba en mejorar la localidad de la memoria, es decir, reducir el movimiento innecesario de datos entre la memoria externa y la memoria del TPU. Esto permitiría aumentar la intensidad aritmética por unidad de control, lo que reduciría el tiempo de inactividad del TPU esperando datos.
Desde la perspectiva del hardware, el diseño de la TPU v1 era sencillo pero elegantemente eficaz:
Coprocesador de un solo hilo en una tarjeta PCIe estándar.
Sin caché multinivel, sin multihilo, sin predicción de bifurcaciones.
Cálculos matemáticos deterministas rápidos en enteros de 8 bits a través de la MXU, o unidad de multiplicación de matrices.
La matriz sistólica consta de 256 * 256 * MXU
La complejidad se trasladó al planificador de software, con dos responsabilidades principales:
Mantener la tubería en funcionamiento, programando las operaciones de manera que la MXU nunca esté inactiva.
Doble búfer de memoria, como medio para ocultar la latencia del acceso a la memoria.
TPUv2 y v3: Mejora de la memoria y la interconexión
Link to heading
Los conceptos clave en las versiones v2 y v3 son el entrenamiento de la próxima generación de modelos que requieren retropropagación, mayor precisión y muchas más TPU distribuidas e interconectadas.
Desde la perspectiva del procesamiento del núcleo de hardware, introdujeron bastantes conceptos interesantes:
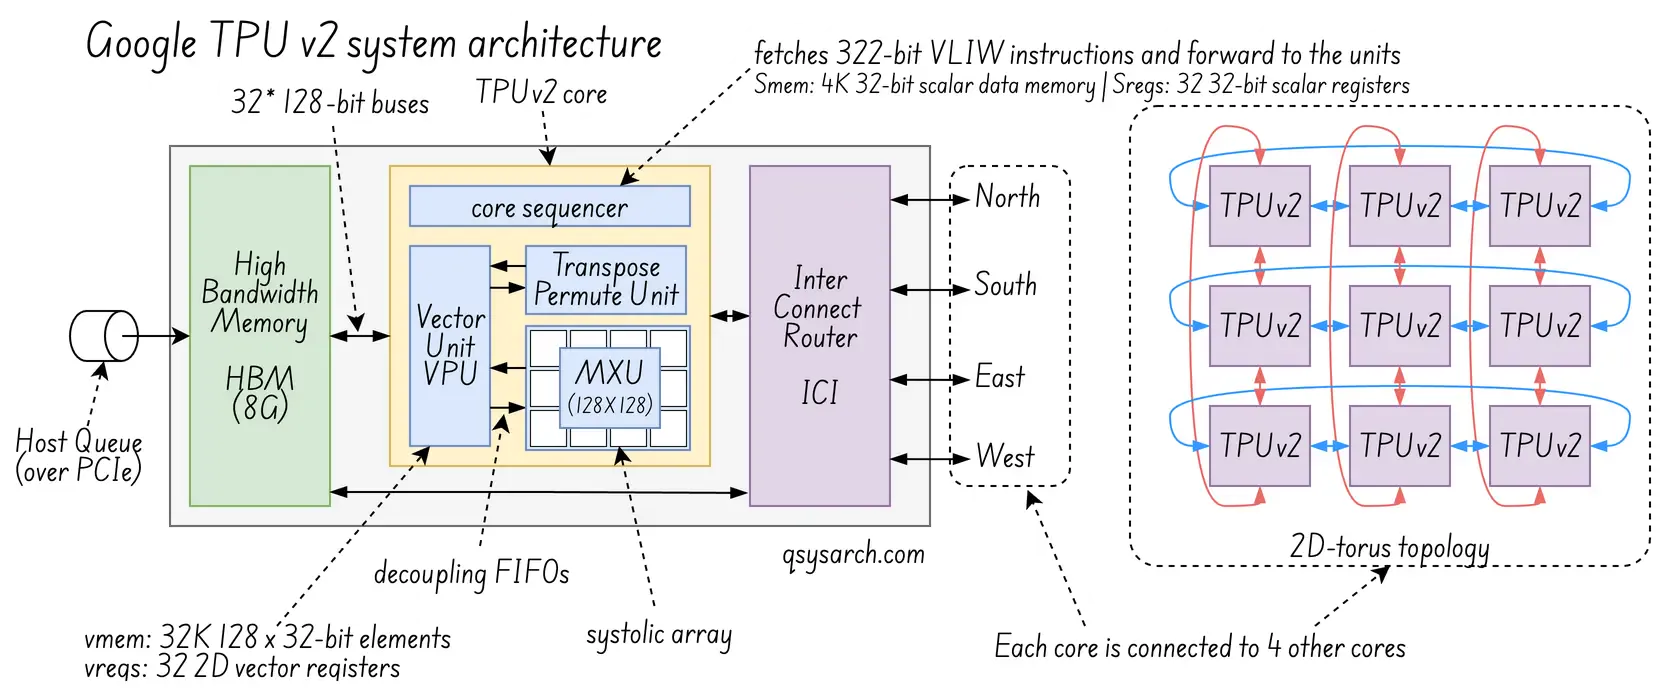
un chip de doble núcleo, por ejemplo, un TPUv2 está compuesto por dos TPU.
Cada TPU tenía una matriz sistólica cuatro veces mayor, compuesta por 128*128 MXU,
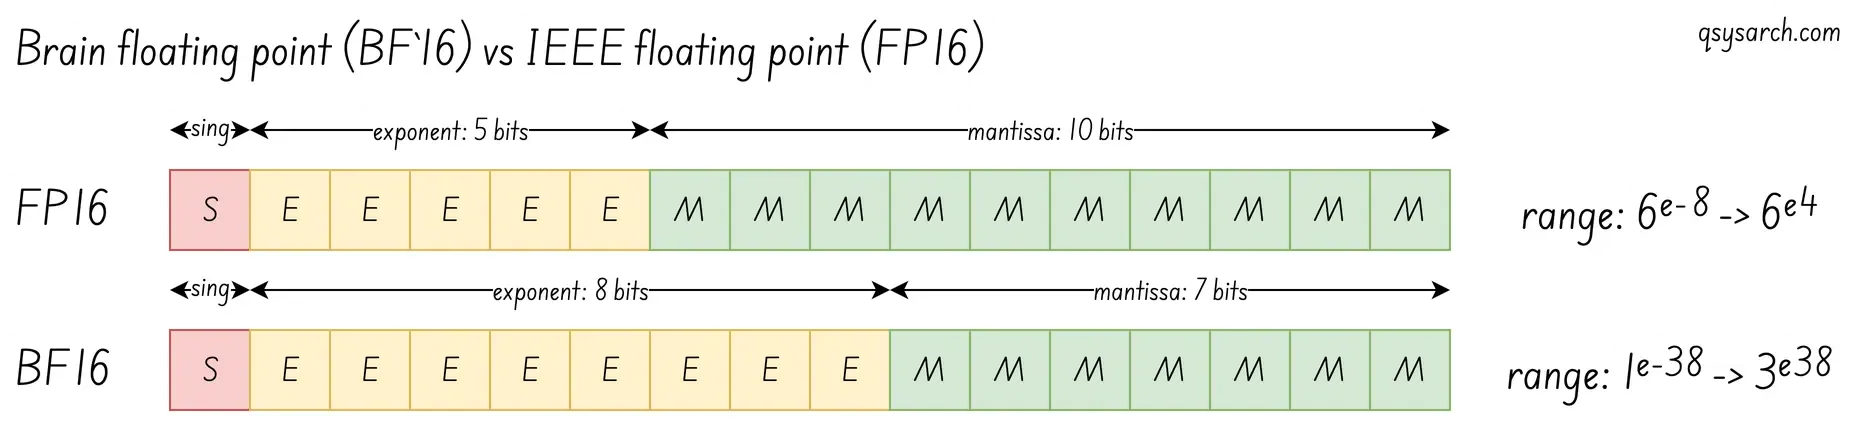
Capacidad para manejar valores de punto flotante, utilizando el formato de punto flotante Brain (BF16), una versión mejorada del formato de punto flotante estándar IEEE 754 FP16.
Una nueva memoria de alto ancho de banda (HBM) dentro de la TPU para reducir la latencia de acceso a la memoria; (TPUv1 solo tiene una DRAM básica, con un tiempo de acceso lento, mientras que la HBM es mucho más rápida)
Desde la perspectiva de la conectividad de hardware,
- Una interconexión entre núcleos (ICI), el tejido de alto ancho de banda que permite la escalabilidad, a través de una red toroidal 2D de 16x16 (red en anillo) - Módulo de supercomputadora de 256 chips.
Desde la perspectiva del software, un compilador potente:
- Compilador XLA: el cerebro que genera las instrucciones VLIW utilizadas por el secuenciador principal (TCS).
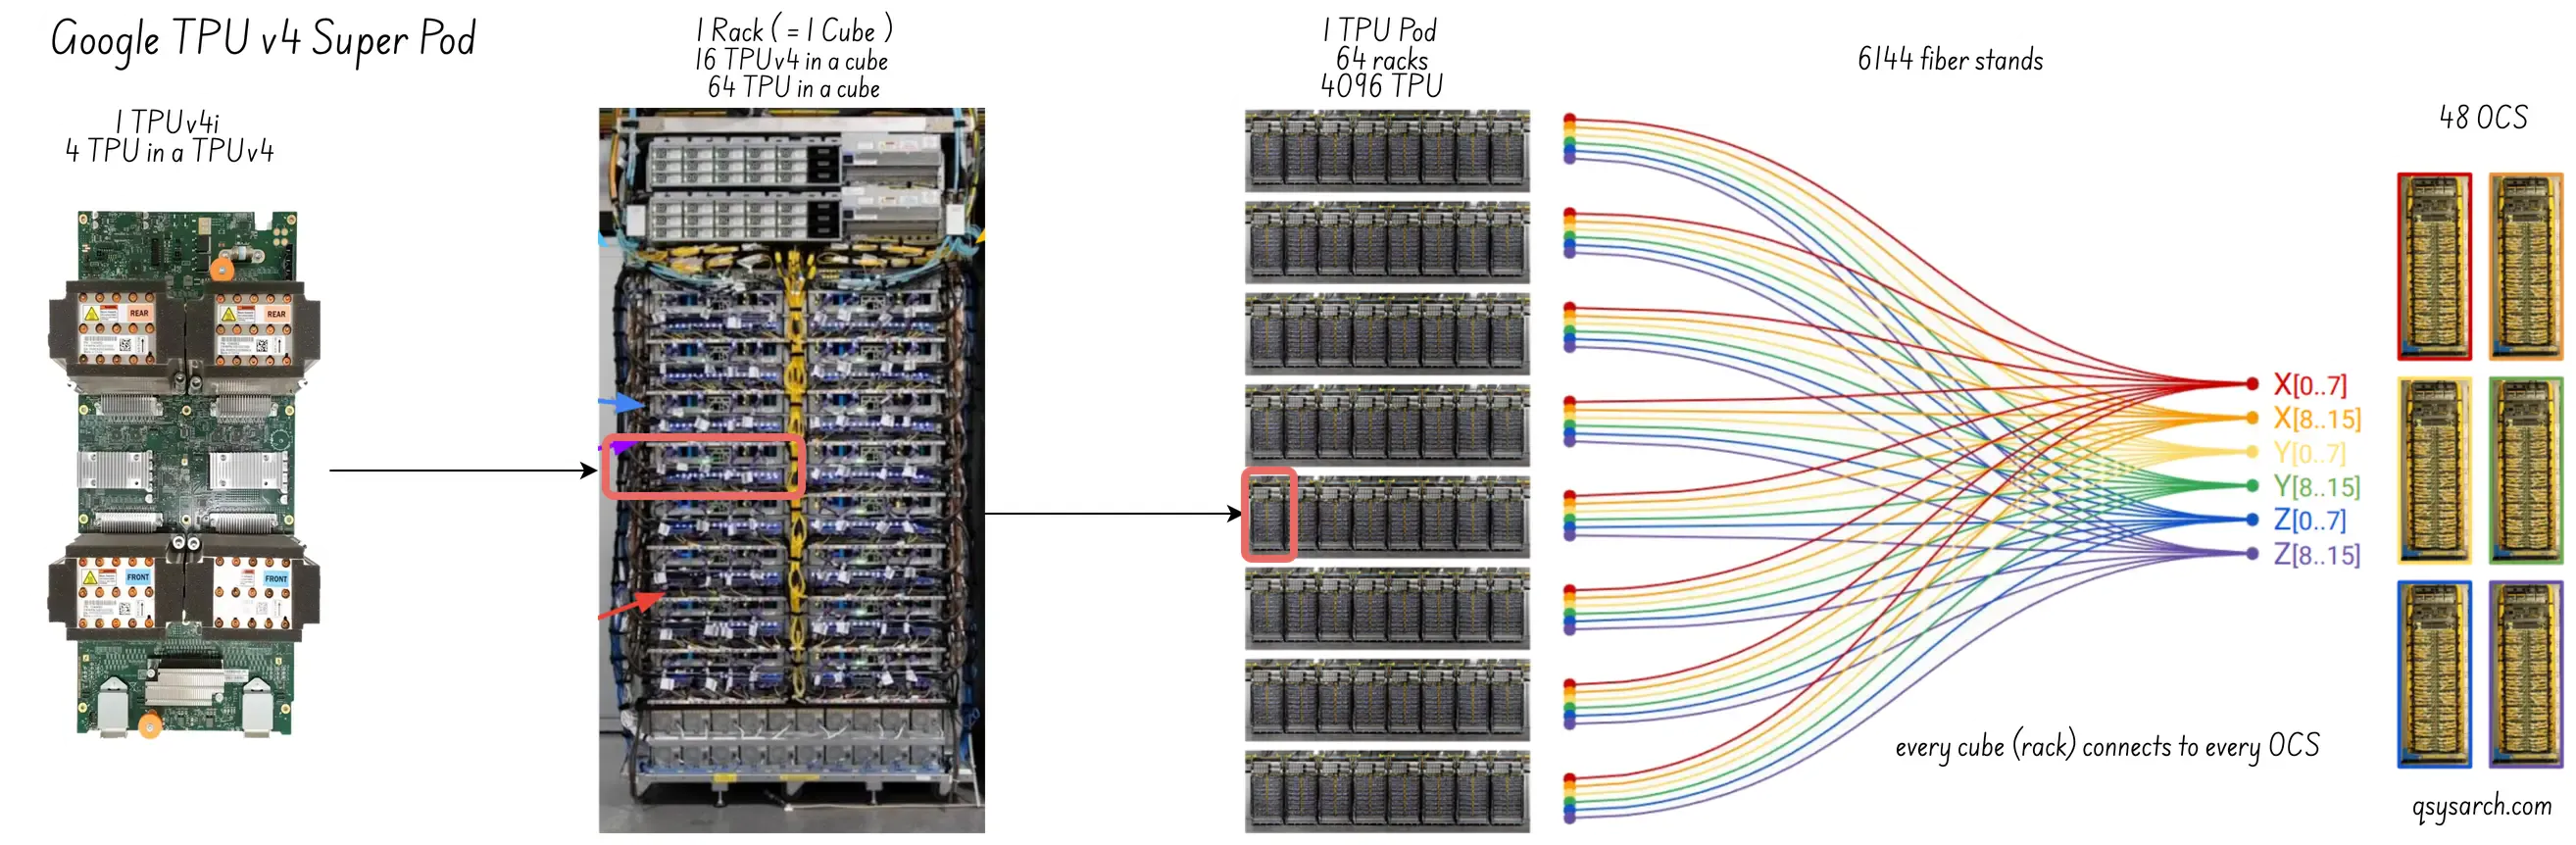
El concepto clave en la versión 4 era la capacidad de ejecutar modelos de IA a hiperescala. Esto significaba que la métrica principal era el costo total de propiedad (TCO).
Las generaciones más recientes están diseñadas para el entrenamiento a gran escala. Los chips se conectan en bastidores o módulos, con sistemas de memoria e interconexiones avanzadas. Admiten operaciones con tensores de gran tamaño, entrenamiento distribuido, sincronización y compartición eficiente de datos entre múltiples chips.
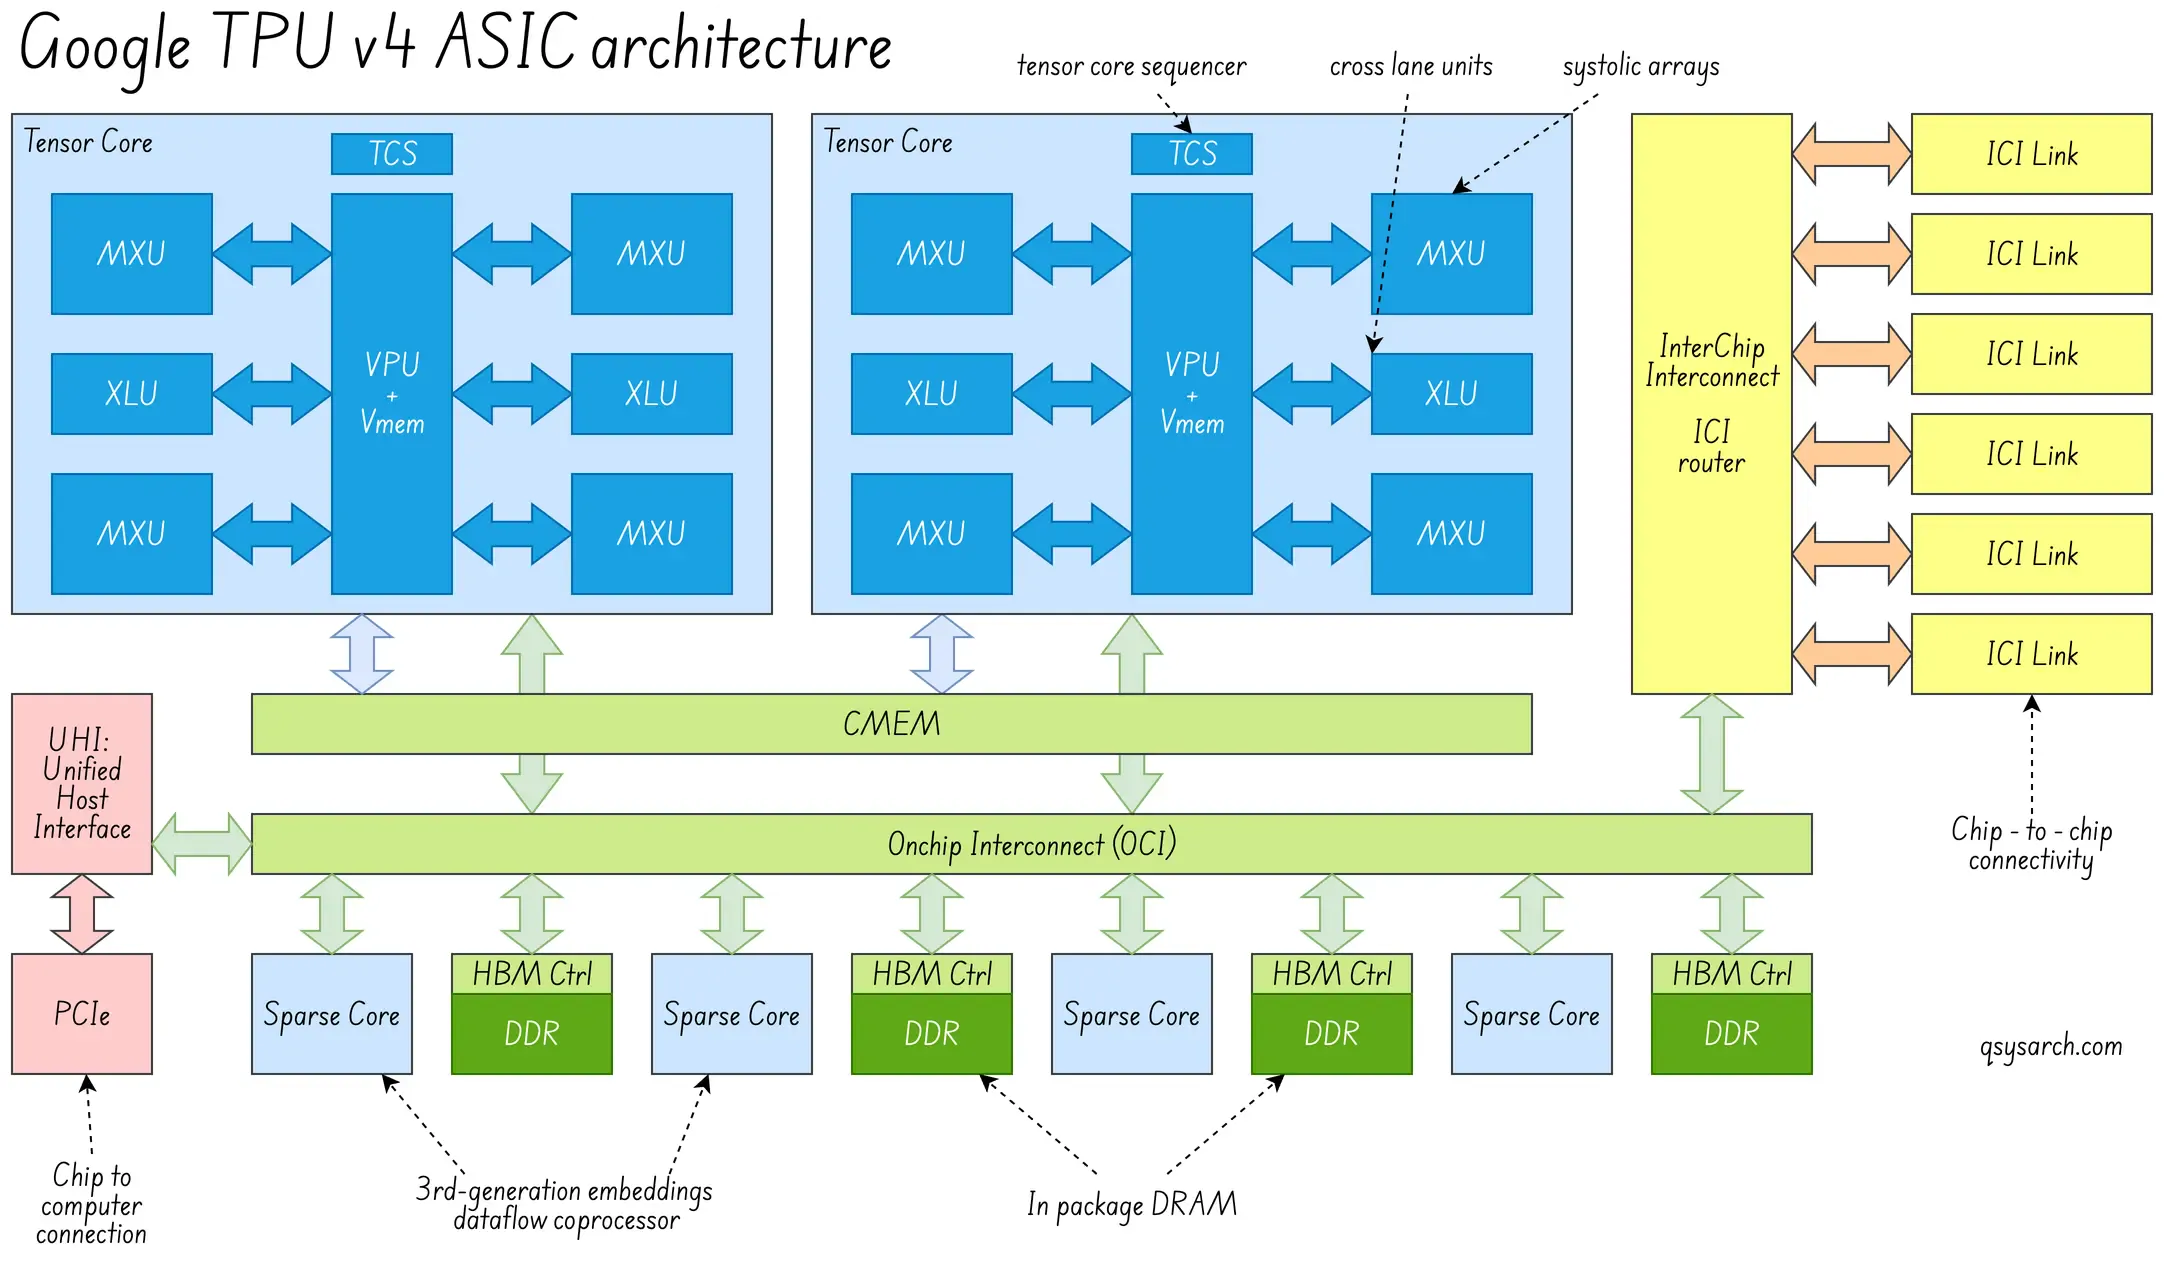
Desde la perspectiva del procesamiento del núcleo de hardware, introdujeron bastantes conceptos interesantes:
Desde la perspectiva de la conectividad de hardware,
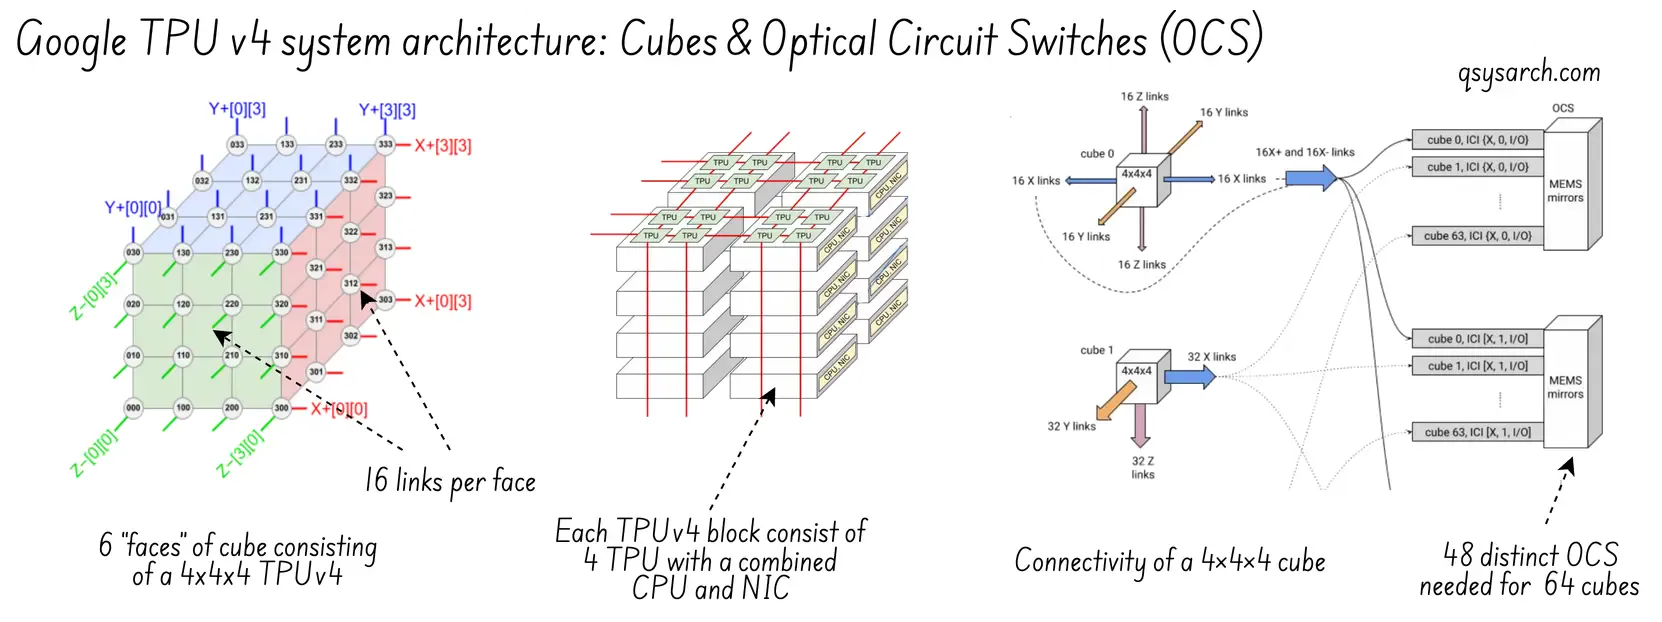
- El TPUv4, al igual que el TPUv2 y el v3, sigue utilizando un enrutador de interconexión (ICI), implementado como un enlace eléctrico de alta velocidad entre los TPU dentro del mismo rack.
Sin embargo, la TPUv4 incorpora un enlace óptico adicional entre los racks, denominado Conmutación de Circuitos Ópticos (OCS). Esto permite aumentar el número de TPU en un módulo a 4000 (en comparación con las 64 de un solo rack), así como mitigar los fallos mediante la reconfiguración del enrutamiento OCS.
- Por último, pero no menos importante, el enrutamiento ahora se vuelve tridimensional, mediante la implementación de un toroide 3D, lo que tiene la ventaja no despreciable de escalar la eficiencia de la comunicación mucho mejor que el toroide 2D.
Desde la perspectiva del software:
Introducción de nuevas herramientas: Borg como gestor de clústeres; gestor de pods para configurar el OCS; y Libpunet para configurar las tablas de enrutamiento ICI y gestionar la tolerancia a fallos.
Compilador avanzado de programa único y datos múltiples (SPMD): Este compilador genera múltiples hilos, donde cada hilo es un programa que se ejecuta en una TPU diferente, ya sea dentro del mismo rack o no. Es similar al concepto SIMT de la GPU, donde el compilador genera código para los hilos dentro de un warp de GPU.
Dado que muchas TPU están ejecutando el mismo programa, el orquestador Borg necesita asegurarse de que todas las TPU sean cosincrónicas; esa es la función del Gang Scheduler.
- Explique el concepto de “rutas” necesarias para gestionar el flujo de datos asíncrono para MoE.
El SparseCore (también conocido como SC) en TPUv4 es responsable de acelerar las cargas de trabajo con matrices dispersas, donde la mayoría de los valores son ceros o redundantes (como ocurre con las incrustaciones que se encuentran en los LLM). Se describe como un optimizador de “búsqueda de incrustaciones”, y cada TPUv4 incluye cuatro procesadores SparseCore.
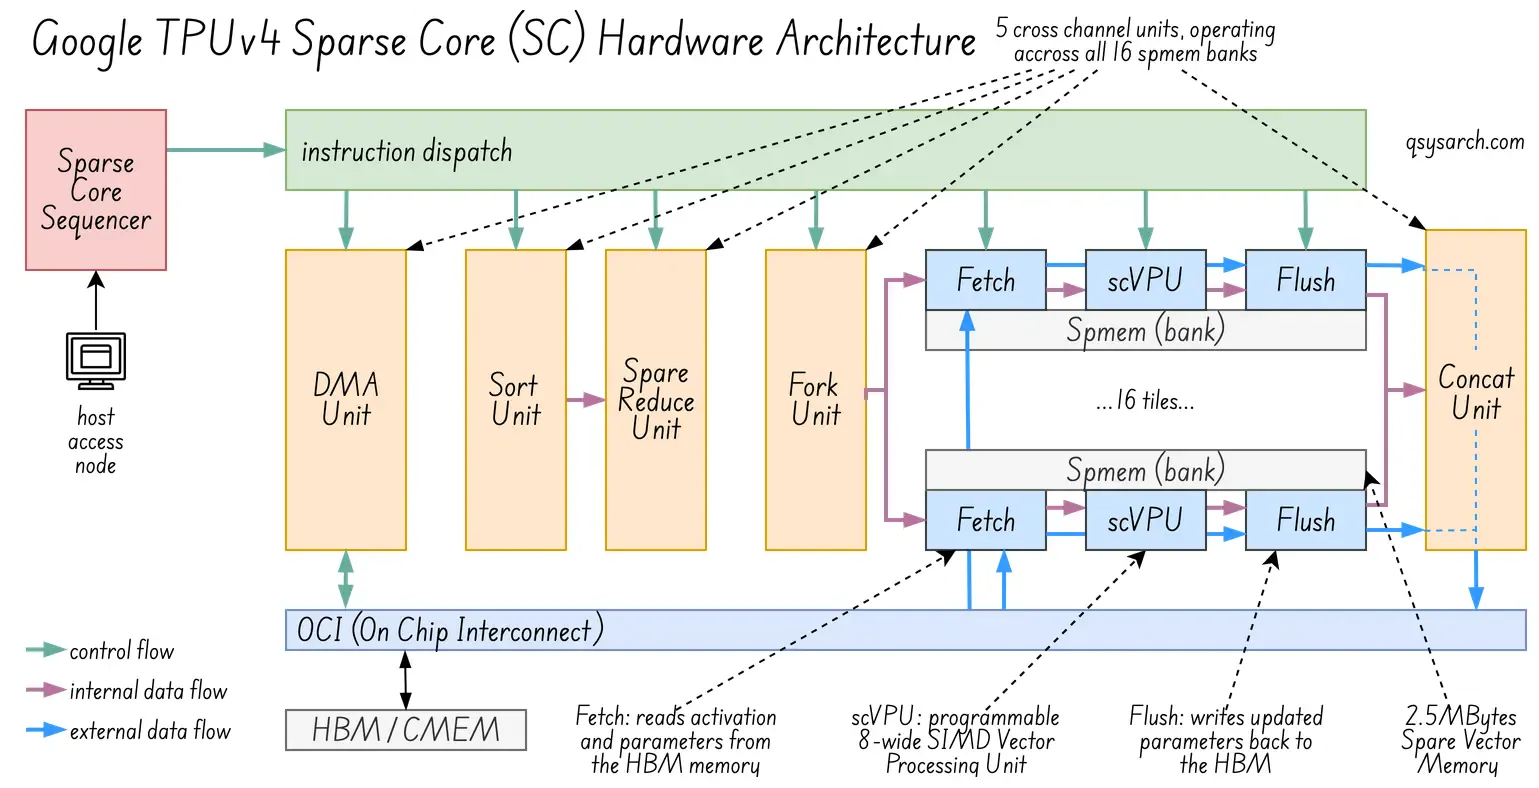 (imagen adaptada de la fuente de la imagen original)
El secuenciador SparseCore (en rojo en la esquina superior izquierda) es el orquestador responsable de enviar instrucciones a las 5 unidades de canal cruzado (en naranja), así como a las 3 unidades SIMD de “búsqueda/procesamiento/vaciado” (en azul). Cada unidad SIMD opera en su propio área de memoria temporal de 2,5 MB de acoplamiento estrecho (en gris).
Dado que cada unidad SIMD de búsqueda/procesamiento/vaciado opera 8 líneas de datos a la vez (SIMD=8), y que hay 16 de esas unidades SIMD en un procesador Sparse Core, esto lo convierte en una unidad de procesamiento muy potente, ¡casi como una pequeña GPU dentro de la GPU! O, para ser precisos, ¡4 pequeñas GPU dentro de una TPU!
Sería muy útil examinar el conjunto de instrucciones (ISA) utilizado para programar esta potente unidad de procesamiento SparseCore, pero no he podido encontrar ninguna información en línea. Probablemente se deba a que se asemeja más a un potente “ordenador DMA con capacidad SIMD síncrona” con instrucciones tan específicas que lo lógico es proporcionar una abstracción de nivel superior, como la biblioteca JAX.
En la práctica, el usuario escribe el código funcional de alto nivel, y el compilador XLA (Álgebra Lineal Acelerada) identifica patrones que coinciden con las capacidades de hardware de SparseCore.
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
@nn.compact
def __call__(self, indices):
embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
¿Qué sucede internamente? El método model.apply llama al compilador XLA, que reduce el código al SparseCore. Para ello, hace coincidir nn.Embed (una operación gather) y genera las siguientes “pseudoinstrucciones”:
Dedup: XLA detecta que 42 y 105 aparecen dos veces en su entrada. Genera instrucciones SparseCore para eliminar estos duplicados antes de la obtención de datos.
DMA: Genera las instrucciones SC-scalar para calcular los desplazamientos de memoria para los ID 105, 42 y 28.
Push: Mueve el tensor resultante de 5*128 de vuelta a la Memoria Común (CMEM).
El compilador XLA también debe encargarse de la ubicación de los datos. En particular, dado que el Sparse Core necesitará acceder a los índices nn.Embed, estos índices deben ubicarse en una memoria accesible para el Sparse Core. Podría colocarlos en la CMEM, pero esta es bastante pequeña (128 MB), por lo que generalmente coloca la incrustación en la HBM grande (32 GB para TPUv4). Sin embargo, el resultado del procesamiento del Sparse Core se vuelve a colocar en la CMEM, ya que solo se trata de una porción de los datos.
También cabe destacar que la arquitectura SparseCore ha evolucionado en las siguientes generaciones v6+.
Mezcla de expertos y vías del Ministerio de Educación
Link to heading
La mezcla de expertos (MoE), a diferencia de los métodos convencionales…
El concepto de pathways se refiere a las rutas físicas y lógicas que siguen los tokens a medida que se distribuyen entre expertos que residen en diferentes chips TPU.
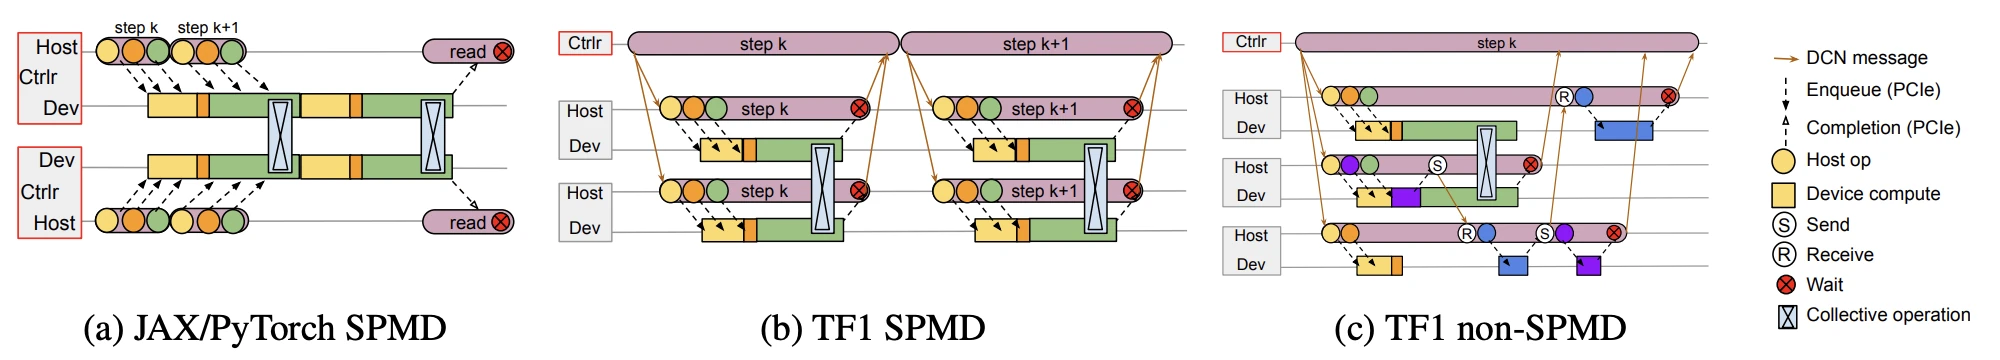 (fuente de la imagen)
A partir de 2023: v5, v6 (Trillum) y v7 (Ironwood)
Link to heading
No hay mucha información disponible sobre las generaciones más recientes, así que esos son los faros principales:
v5e: 16 GiB HBM3e por chip;
v5p: 95 GiB HBM3e por chip;
v6: 32 GiB HBM3e por chip; rendimiento BF16 mejorado
v7: 192 GiB HBM3e; Nueva precisión FP8
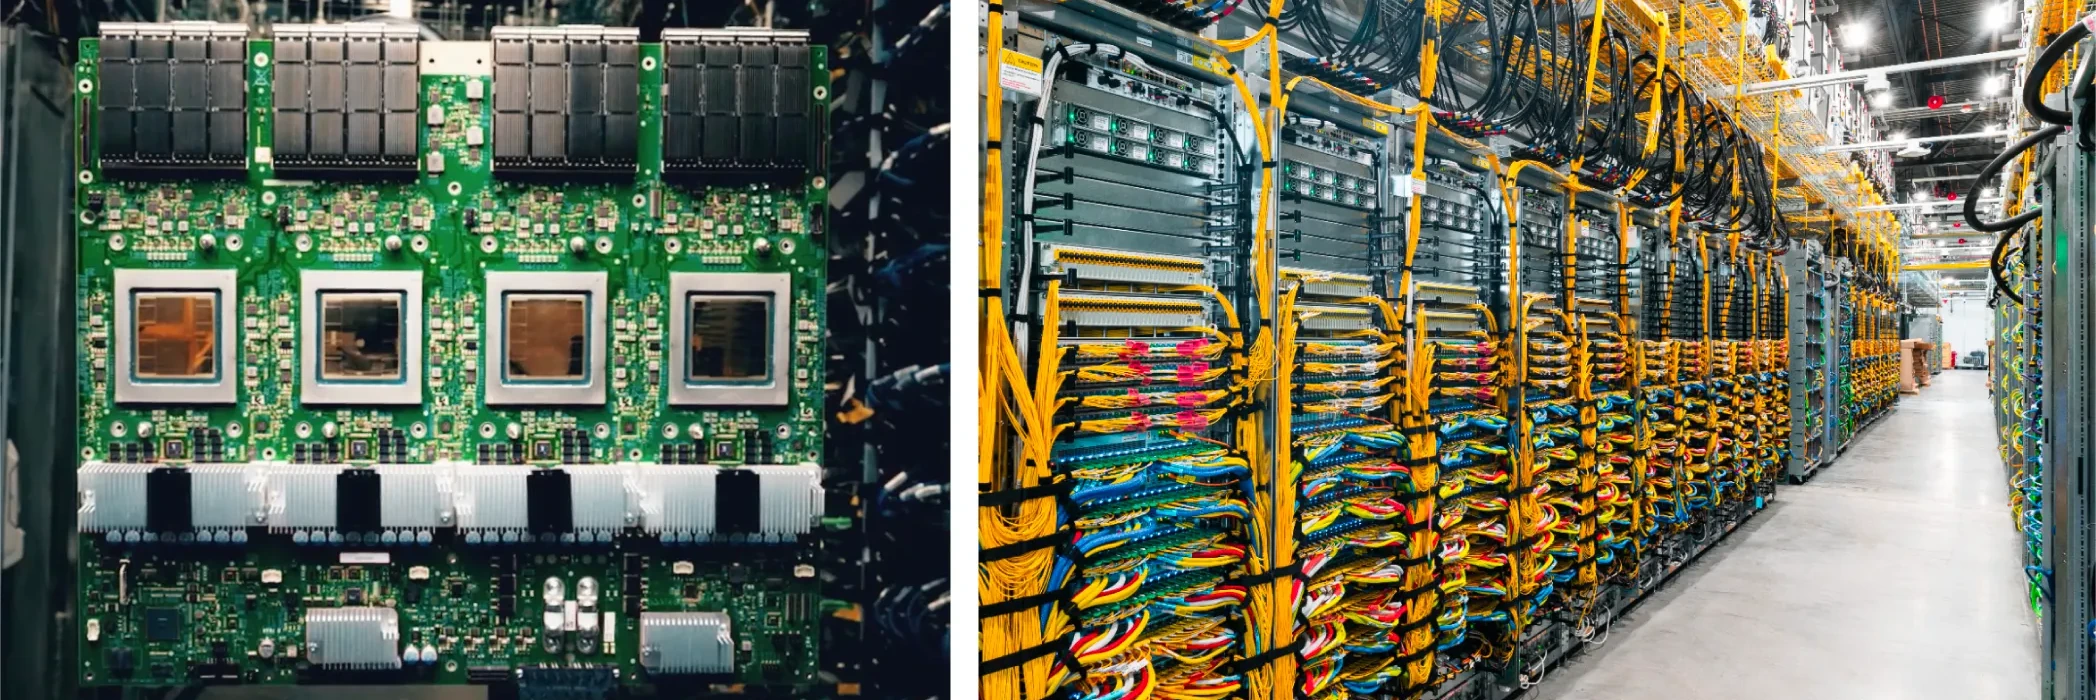
Con Ironwood v7, un super pod consta de aproximadamente 9000 TPUs.
Entonces, ¿por qué seguimos necesitando GPU si tenemos TPU?
Link to heading
El diseño de la TPU, que equilibra la memoria, la potencia de cálculo, el consumo de energía y la comunicación de datos, demuestra que construir sistemas de IA de alto rendimiento a gran escala no se trata solo de tener chips rápidos. También requiere coordinación entre hardware, software, sistemas y conexiones de red.
Procesamiento de píxeles frente a procesamiento de matrices
Link to heading
Aunque las cargas de trabajo de IA son más variadas hoy en día, abarcando inferencia, entrenamiento, modelos dispersos y sistemas de recomendación, las TPU no están diseñadas para procesar píxeles. Sin embargo, las GPU no son populares actualmente porque Nvidia expuso un modelo programático y una experiencia de desarrollador que permitieron que las GPU se comportaran como una TPU.
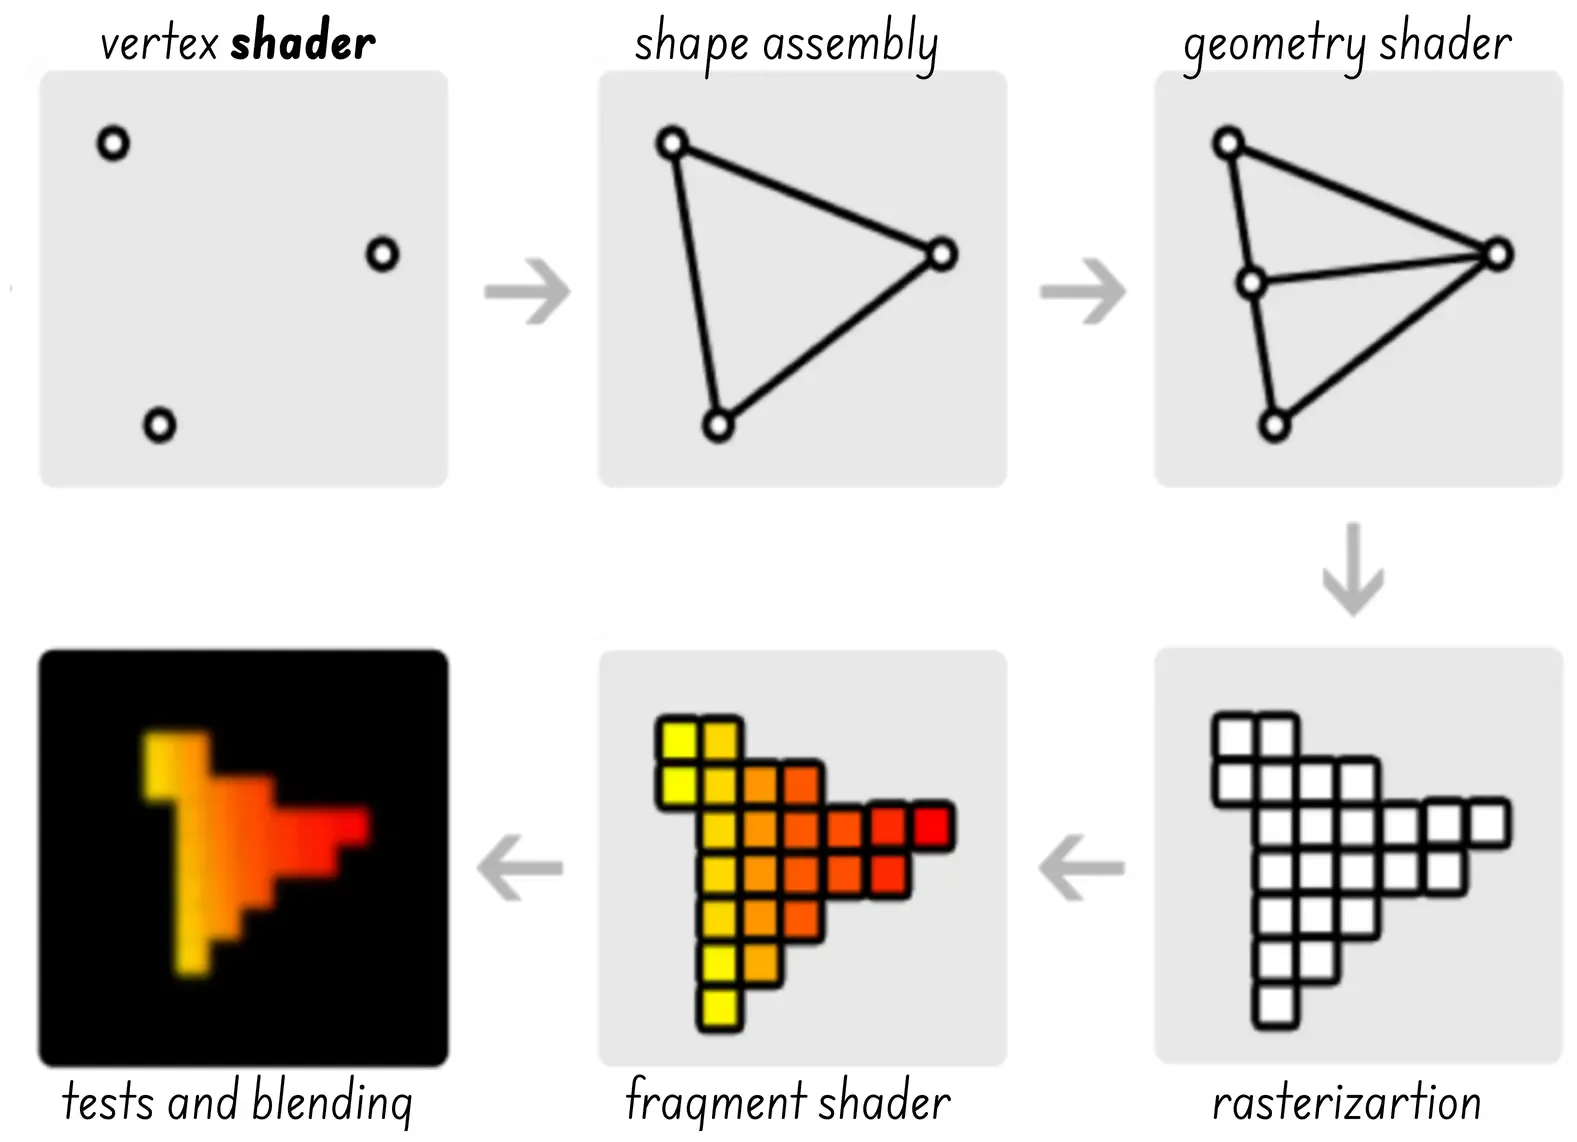
¿Significa esto que las GPU son superiores? No necesariamente. Para cargas de trabajo muy específicas, las TPU pueden ser más eficientes que las GPU, especialmente en términos de consumo de energía y rendimiento por vatio. Y en el mundo actual, donde los centros de datos de IA consumen cada vez más energía, las TPU pueden marcar la diferencia.
¿Qué hay de los circuitos integrados neuromórficos analógicos?
Link to heading
¿Y qué hay de los circuitos integrados neuromórficos? En comparación con las TPU, buscan un consumo de energía aún menor mediante el uso de computación analógica y procesamiento de eventos de baja frecuencia. ¿Qué se necesita para que los circuitos integrados neuromórficos se generalicen y alcancen la misma escala que los superpods TPUv7?
Uno de los retos que aún tengo es comprender mejor el consumo de energía relativo del conjunto sistólico (MXU + Spares Core) frente al resto de la TPU (incluidos ICI, OCI, TCS), y cómo se compara esta proporción con la red neuronal de impulsos neuromórfica (SNN) frente a la lógica de control (RiscV y Spike copro).
Además, si los circuitos integrados neuromórficos alcanzaran la escala de TPUv7, probablemente requerirían una inversión similar en software, sistemas y conexiones de red. De lo contrario, se podría considerar conectar una red neuronal de estado sólido (SNN) a una TPU y usar la lógica de control de esta última para gestionar la comunicación entre la SNN y el resto de la TPU/Rack/Pad. Pero, ¿es realmente necesario esto? ¿Qué problema estamos resolviendo? Quizás debamos replantearnos la situación.
Regreso al futuro: la Unidad de Procesamiento del Lenguaje
Link to heading
Este memorándum no estaría completo sin mencionar la Unidad de Procesamiento del Lenguaje, un nuevo tipo de procesador diseñado para optimizar la inferencia de grandes modelos de lenguaje.
Necesitaré crear un memorándum específico para este tema, así que por ahora, esto es solo una comparación general, tratando de entender si la LPU es más que una reinvención de la TPUv1, que solo se centraba en la inferencia y no en el entrenamiento.
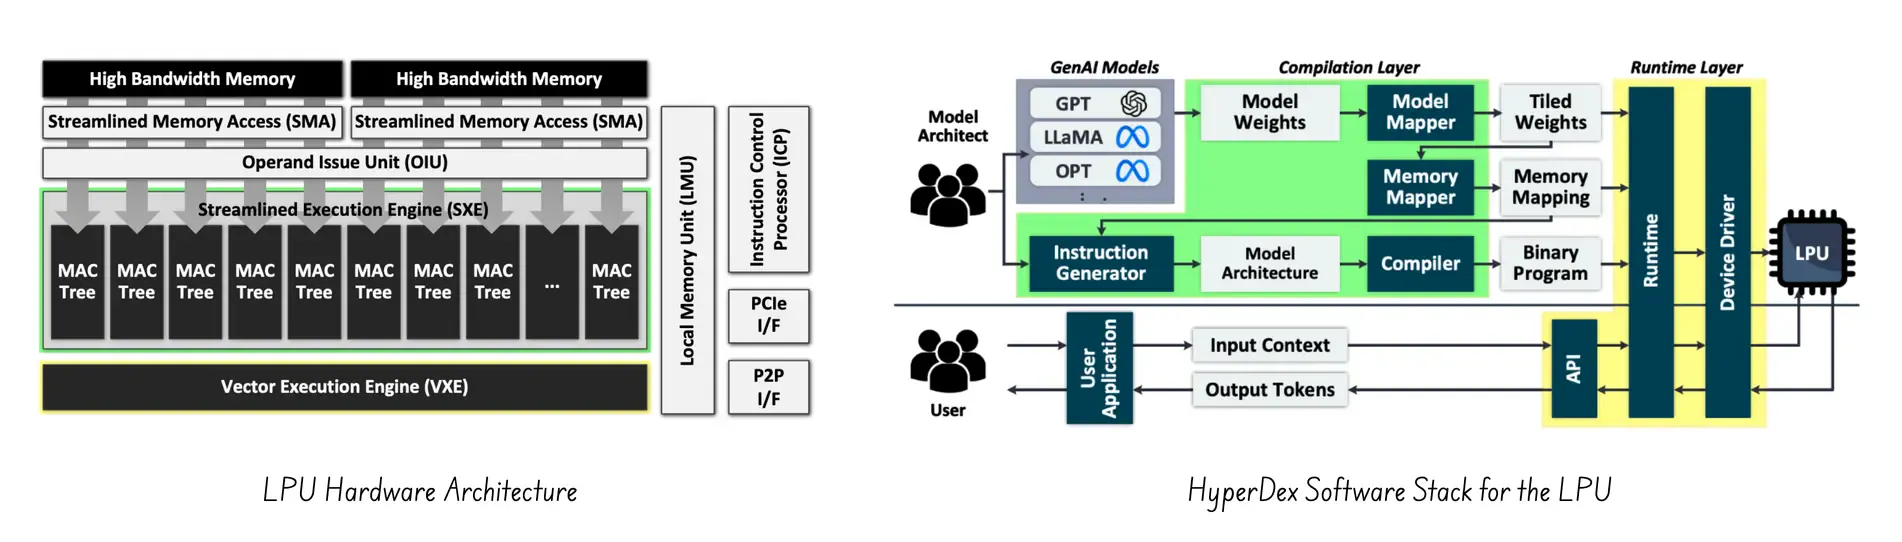
En términos generales, sí, las TPU y las LPU comparten la necesidad de realizar algunas tareas de manera muy eficiente y a gran escala, utilizando una arquitectura específica de dominio (DSA). Pero en lo que respecta a la implementación y optimización específicas, la LPU es un caso muy distinto, con un enfoque diferente.
La principal diferencia radica en que el TPUv1 se diseñó antes incluso de que existiera el LLM (recordemos que el lanzamiento inicial de ChatGPT fue en 2022) y se centró en la inferencia general de redes neuronales profundas (DNN). Esto implicaba garantizar el rendimiento y la eficiencia por vatio para operaciones masivas de alto volumen, implementadas mediante una matriz sistólica MXU subyacente.
Por otro lado, la LPU está diseñada para optimizar la inferencia de grandes modelos de lenguaje (LLM). Su objetivo es mejorar la latencia por token. Para ello, necesita una ISA que admita una arquitectura multipipeline basada en VLIW, totalmente determinista y con programación estática. Si bien se podría argumentar que la TPUv4 introduce una ISA VLIW similar para la TCS, la principal diferencia radica en que la ISA de la LPU es una máquina VLIW totalmente determinista, donde cada carga, cálculo y almacenamiento se programa ciclo a ciclo. En cambio, para la TPU, la MXU es una matriz sistólica “autogestionada”.
He aquí un breve memorándum que, una vez más, tomó más tiempo del esperado. Lo que queda claro tras este análisis exhaustivo es que la evolución de la arquitectura TPU demuestra que diseñar aceleradores de IA es una tarea compleja que requiere equilibrar muchos factores.
El diseño de la TPU, que equilibra la memoria, la potencia de cálculo, el consumo de energía y la comunicación de datos, demuestra que construir sistemas de IA de alto rendimiento a gran escala no se trata solo de tener chips rápidos. También requiere coordinación entre hardware, software, sistemas y conexiones de red.
Esto me da una sensación de déjà vu. ¿Podría ser que la Unidad de Procesamiento Cuántico (QPU) sea el siguiente paso en la evolución de los aceleradores de IA?
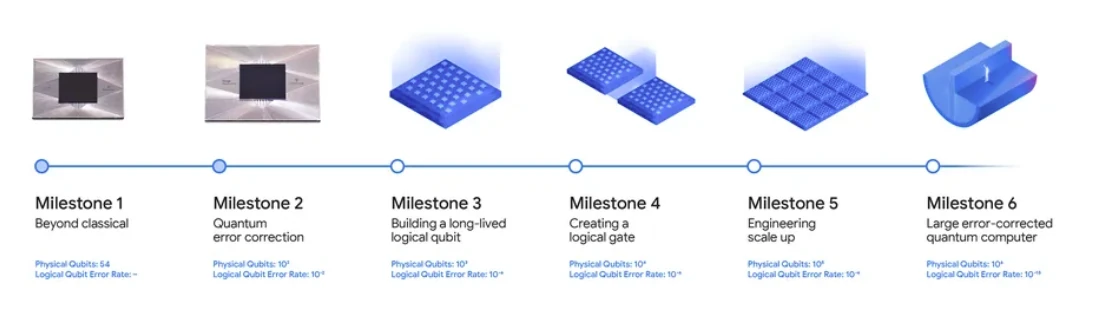 (Fuente de la imagen: Google Willow)
Diagramas de DrawIO utilizados en este memorándum: