Antes trabajaba en Spirent, una empresa de pruebas y mediciones que desarrolla sistemas de prueba para redes de alto rendimiento. El producto se llamaba Test Center y, junto con un equipo muy talentoso, desarrollábamos el sistema utilizado para probar los sistemas RoCEv2. Mi trabajo se centraba especialmente en el control de flujo de prioridad (PFC) y en cómo habilitarlo para el analizador y generador de paquetes (PGA) basado en FPGA de 800 Gbps.
Sin embargo, nunca tuve la oportunidad de examinar la Capa 4 en detalle, y este documento intenta subsanar esta deficiencia al explicar los elementos clave de la Capa de Transporte InfiniBand (L4) y visualizarlos mediante algunos diagramas.
Comencemos con el fotograma RoCEv2 propiamente dicho:
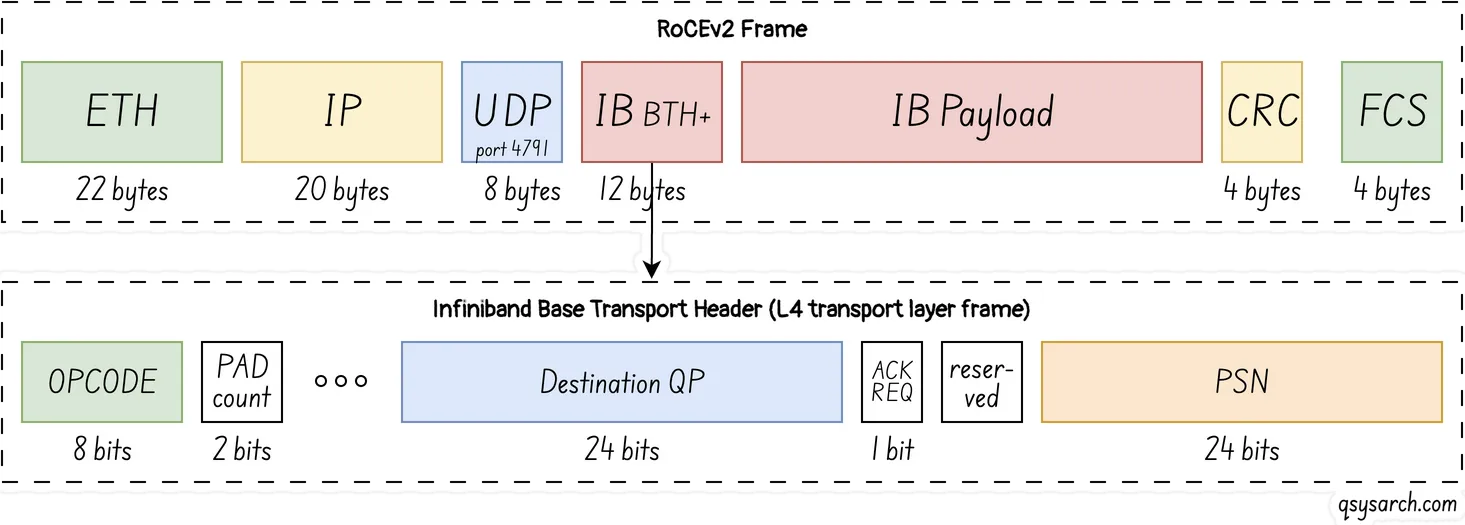
Encabezado de transporte base (BTH)
Link to heading
Campos clave incluidos en el encabezado BTH:
Opcode: Se utiliza para especificar el tipo de operación RDMA, como RDMA_WRITE, RDMA_READ, …
QP de destino: Se utiliza para distinguir entre diferentes pares de colas de destino para un paquete.
Solicitud de acuse de recibo: Indica si el extremo receptor debe devolver un ACK para este paquete.
Número de secuencia de paquete (PSN): se utiliza en el seguimiento de la secuencia de paquetes para una entrega fiable.
Dado que UDP es un protocolo poco fiable, donde las tramas pueden perderse, desordenarse o duplicarse, se utiliza el PSN para garantizar la entrega correcta. Sin embargo, esto también implica que debe existir un mecanismo para que el IBTL solicite la retransmisión de la trama. Esto se logra mediante la cabecera AETH, que se describe a continuación.
Encabezado de transporte extendido (ETH)
Link to heading
La capa de transporte InfiniBand cuenta con varias cabeceras extendidas, utilizadas para funciones específicas. En el caso de RDMA, las dos más interesantes son RETH y AETH.
Encabezado de transporte extendido RDMA (RETH)
Link to heading
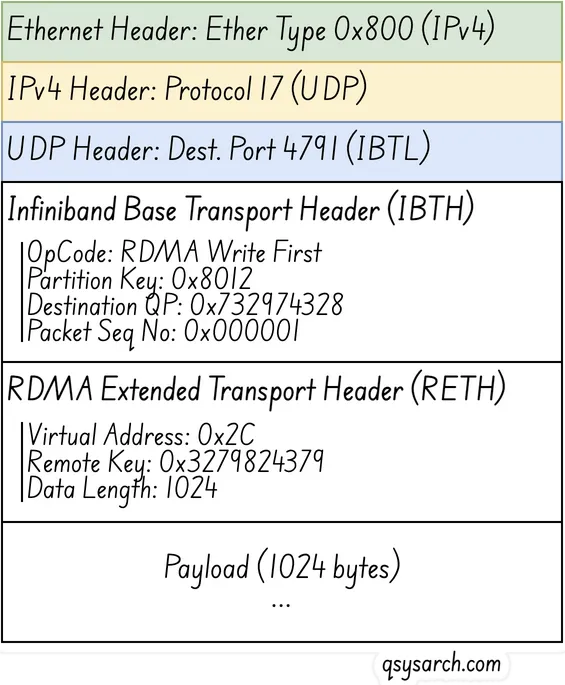
La operación RDMA_WRITE requiere varios elementos, que están representados en los campos del encabezado extendido RETH. Este encabezado informa al hardware receptor sobre los detalles de la operación de escritura, incluyendo:
Dirección virtual: La dirección de memoria de destino donde se escribirán los datos.
Clave remota (R_Key): La clave de acceso que valida los permisos para la región de memoria.
Longitud: El tamaño de los datos que se van a transferir
ACK Encabezado de transporte extendido (AETH)
Link to heading
Como se explicó anteriormente, es necesario que el IBTL notifique al remitente en caso de transmisión no confiable. Esto se realiza mediante la extensión EATH, que contiene el siguiente campo:
Síndrome: Un campo que contiene códigos de respuesta que indican éxito (ACK), condiciones de error (NAK) o estado de receptor no listo (RNR), junto con información de control de flujo.
Número de secuencia del mensaje (MSN): Indica el número de secuencia del mensaje completado más recientemente, lo que implica que todos los mensajes con números de secuencia inferiores se han recibido correctamente.
La especificación IBTL (consulte el Capítulo 9) contiene bastantes extensiones, algunas de las cuales me llamaron la atención:
Comparar e intercambiar: Permite realizar una sincronización sin bloqueo.
Enviar vs. Escribir: El primero se puede usar para el flujo de control, mientras que el segundo se usa para el flujo de datos.
Extensión inmediata: Permite el intercambio de metadatos por canal lateral junto con la memoria que se va a transferir.
También me he preguntado cómo se sabe qué extensiones están presentes en la cabecera. La respuesta es sencilla: para cada código de operación, existe una lista de extensiones que deben analizarse; esta lista se define de forma estática, como parte de la especificación.
El desafío del flujo de elefante
Link to heading
Como afirma Toni Pasanen en su blog The Network Times:
La comunicación entre GPU crea flujos masivos de datos, que las tarjetas de red compatibles con RDMA transmiten a velocidad de línea. Estos flujos pueden provocar fácilmente congestión en la red de backend.
Esta capacidad de RDMA para generar tráfico a velocidad de línea es asombrosa. Pero esto también crea un problema con el tamaño del flowlet (tamaño del flujo entre dos tiempos de inactividad consecutivos), donde la probabilidad de obtener acceso a un “intervalo de inactividad” se reduce significativamente al usar flujos de gran tamaño de RDMA.
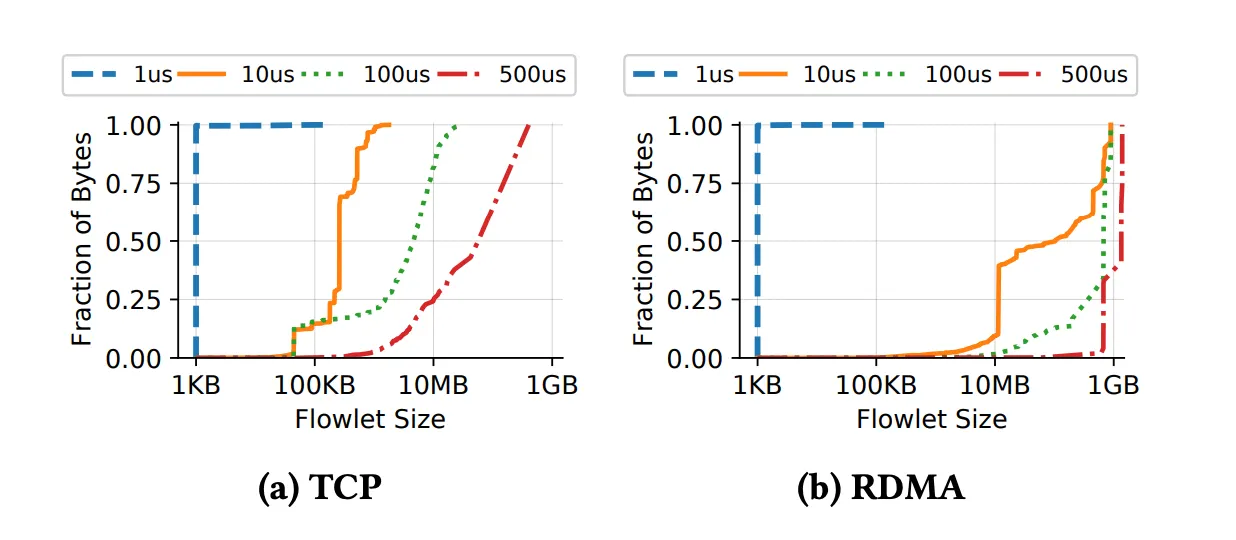 Imagen de: Balanceo de carga de red con soporte de reordenamiento en red para RDMA
El desafío del equilibrio de carga
Link to heading
La otra complejidad radica en el equilibrio de carga con topologías spine-leaf, donde los paquetes pueden recibirse fuera de orden en un único par de colas cuando se utiliza el equilibrio de carga Packet Spraying. Esto genera una complejidad que Nvidia ha resuelto mediante la introducción de una nueva operación RDMA denominada “RDMA Write Only”.
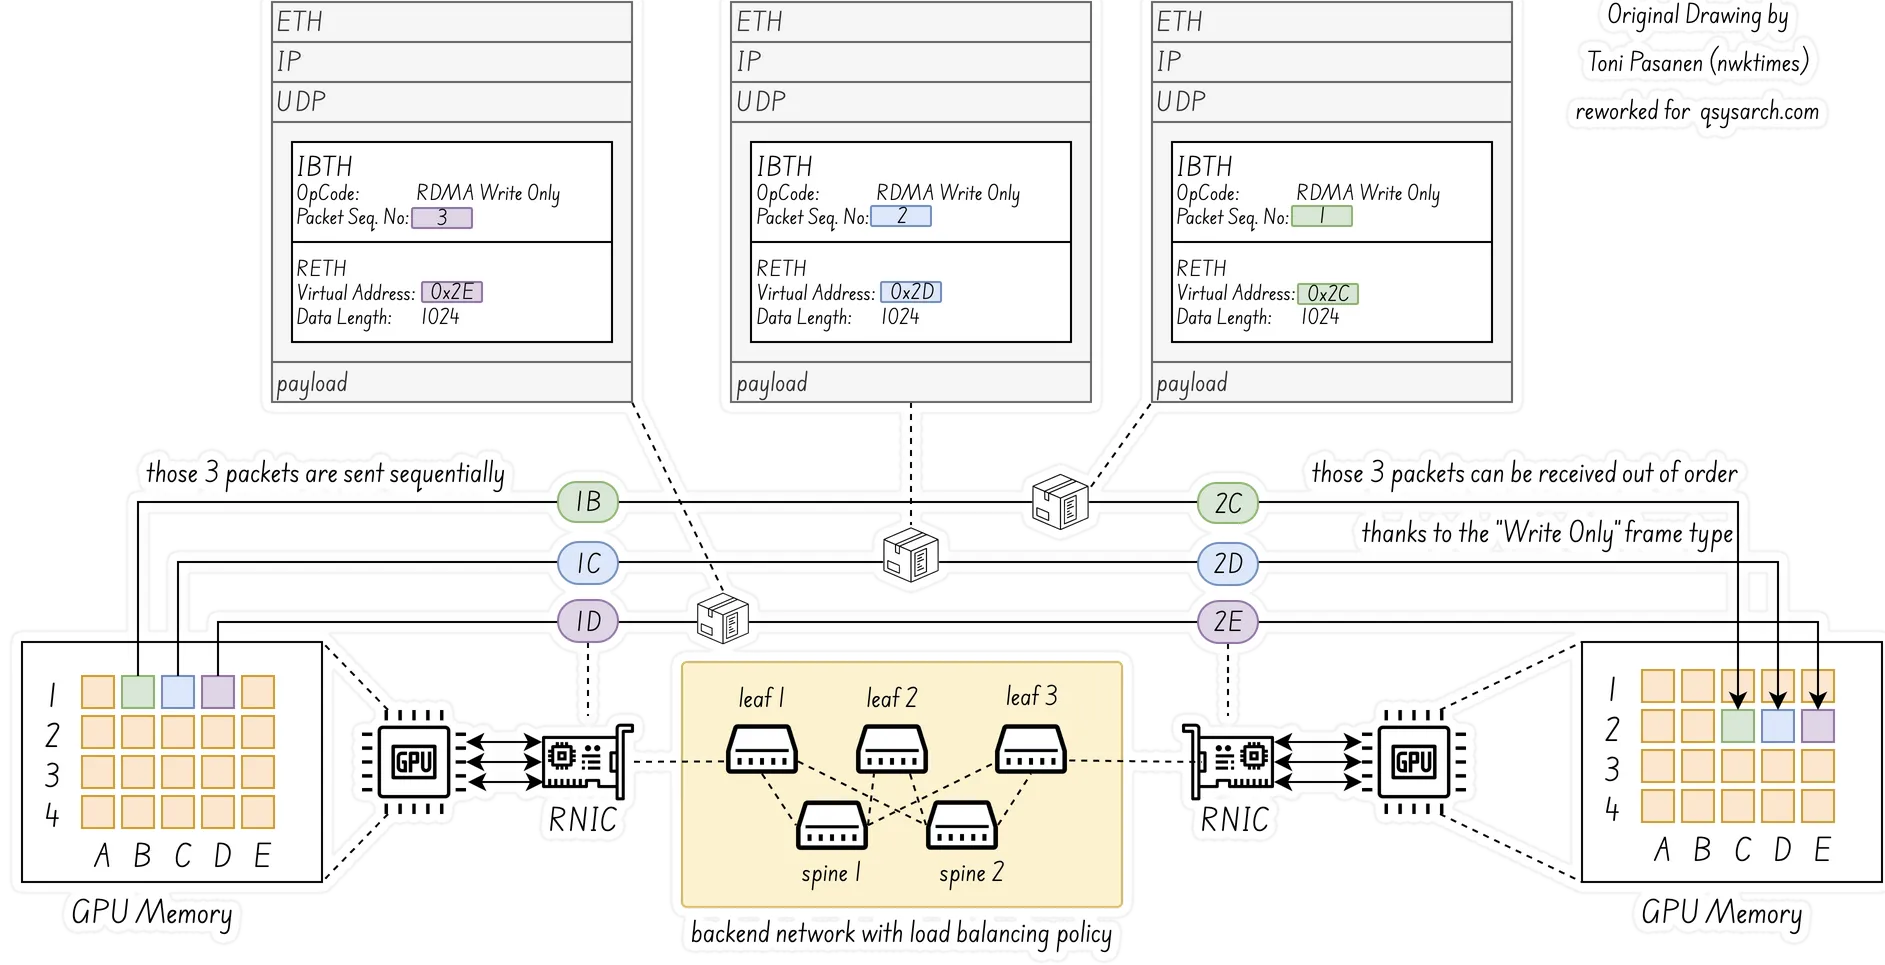 Imagen original de: The Network Times
Este es un memorándum “activo” que seguiré actualizando a medida que encuentre más información sobre el IBTL.
Aún no hay conclusiones definitivas, salvo que RDMA es una solución muy elegante para el desafío de la eficiencia de la red, y que también plantea nuevos retos.
References: