
En el contexto de las GPU, RDMA está asociado a numerosos términos técnicos: GPU-direct, NvLink, NVLink Fusion, InfiniBand, Quantum InfiniBand, GPUNetIO y DOCA. Esto puede resultar confuso, pero ¿quizás no tenga por qué serlo?
Este artículo está escrito en forma de nota personal, con el objetivo de explicar las diversas tecnologías y visualizarlas mediante algunos diagramas.
GPU Direct y RDMA: Marketing vs. Tecnología.
Link to heading
Empecemos in medias-res, con la confusa página GPUNetIO de la documentación oficial de Nvidia:
Cabe destacar que el acrónimo RDMA describe el protocolo que permite el acceso directo y remoto a la memoria de un ordenador a la de otro sin la intervención del sistema operativo de ninguno de ellos. No debe confundirse con GPUDirect RDMA, que no guarda relación con el protocolo RDMA.
Está claro, ¡GPUDirect RDMA no es lo mismo que el protocolo RDMA! Pero, ¿GPUDirect RDMA utiliza al menos el protocolo RDMA? Espero que sí; de lo contrario, sería muy confuso.
GPUDirect RDMA es una de las tecnologías habilitadas por NVIDIA dentro de la familia de tecnologías GPUDirect. Permite que la tarjeta de red envíe o reciba datos accediendo directamente a la memoria de la GPU, evitando las copias de memoria de la CPU y las rutinas del sistema operativo. GPUDirect RDMA puede habilitarse mediante cualquier marco de red que funcione con Ethernet, InfiniBand o RoCE.
Bien, al menos está claro: GPUDirect RDMA se puede implementar en cualquier capa de transporte, ya sea Ethernet (ETH) o InfiniBand (IB). Pero, ¿qué es GPUNetIO y cómo se relaciona con RDMA? La respuesta es sencilla. GPUNetIO es, como su nombre indica, una implementación de GPU Direct RDMA basada en red sobre una tarjeta de red. Esto no significa que GPU Direct deba ejecutarse desde una tarjeta de red, sino que GPUNetIO es una versión especializada para ese tipo de tarjeta de red.
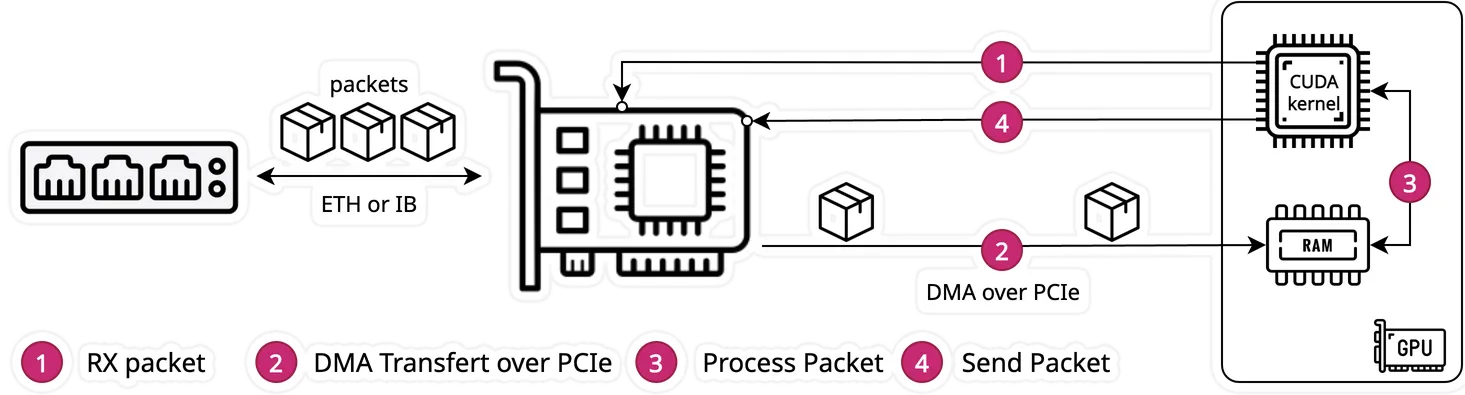
En el diagrama anterior de la documentación de GPUNetIO (https://docs.nvidia.com/doca/sdk/doca+gpunetio/index.html), el recuadro “CUDA” resulta un tanto confuso. Supongo que se trata de un kernel que se ejecuta en la GPU, pero veamos qué dice la documentación:
Los enfoques tradicionales suelen basarse en un modelo centrado en la CPU, donde esta se coordina con la tarjeta de red para recibir paquetes en la memoria de la GPU mediante GPUDirect RDMA. Posteriormente, la CPU notifica a un kernel CUDA en la GPU para que procese los paquetes. DOCA GPUNetIO aborda este problema ofreciendo una solución centrada en la GPU que elimina la CPU de la ruta crítica.
Para mí, esto aún no está del todo claro: se indica que la ruta crítica está centrada en la GPU, pero ¿cuál es la ruta crítica? ¿Se refiere a los pasos (1) a (4) mencionados en el diagrama? ¿Y para qué se sigue necesitando la CPU? Para encontrar la respuesta, debemos analizar el modo “Async Kernel-Initiated”, que se describe como la posibilidad de que “un kernel CUDA de GPU controle las comunicaciones de red para enviar o recibir datos”. GPUDirect IKA permite:
La GPU puede controlar las comunicaciones Ethernet (Ethernet/IP/UDP/TCP/ICMP)
La GPU puede controlar las comunicaciones RDMA (se admiten InfiniBand o RoCE).
La intervención de la CPU no es necesaria en la ruta crítica de la aplicación.
Por lo tanto, esto está 100% claro:
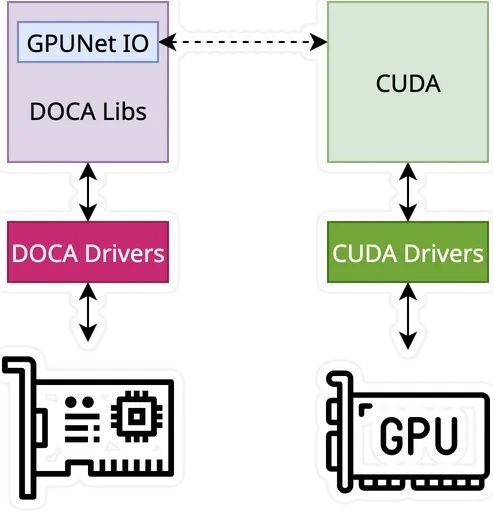
GPU Direct RDMA “permite transferencias directas de datos hacia/desde la memoria de la GPU sin copias intermedias de la CPU.
GPU Direct AKI ofrece la posibilidad de que la GPU “controle” la tarjeta de red.
GPUNetIO es un componente de software que gestiona las tecnologías GPU Direct RDMA y AKI.
DOCA es el SDK que Nvidia proporciona para programar hardware habilitado para GPUNetIO (entre otros).
Supongo que la confusión surge del hecho de que “AKI” debería mencionarse como “GPU Direct RDMA + AKI”, ya que complementa la capacidad RDMA que permite omitir la CPU.
Ahora entendemos que GPU Direct RDMA, comercializado por Nvidia bajo la marca GPUNetIO, es una solución basada en la tarjeta de red (NIC), que conecta la GPU a la NIC mediante una conexión PCIe. Analicemos en detalle esta conexión PCIe, abstraigamos la parte de GPUNetIO y centrémonos en la parte de RDMA:
En la documentación oficial de CUDA GPUDirect RDMA (https://docs.nvidia.com/cuda/gpudirect-rdma/index.html), se indica que el único requisito es un complejo raíz PCIe:
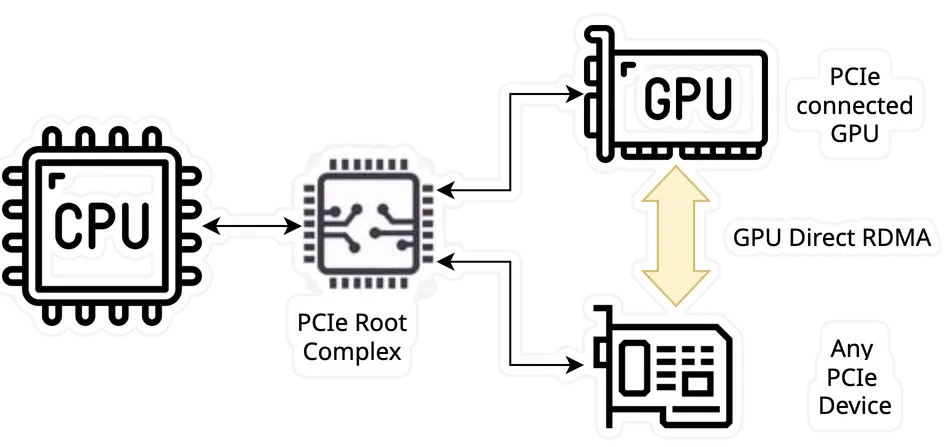
GPUDirect RDMA es una tecnología introducida en las GPU de clase Kepler y CUDA 5.0 que permite una ruta directa para el intercambio de datos entre la GPU y un dispositivo par de terceros utilizando las características estándar de PCI Express. … Pueden aplicarse varias limitaciones, la más importante es que los dos dispositivos deben compartir el mismo complejo raíz PCI Express ascendente.
GPUDirect RDMA es una solución que permite que cualquier dispositivo PCIe se comunique directamente con la GPU, siempre que esté bajo el mismo complejo raíz. Por lo tanto, aunque Nvidia la comercializa principalmente como una solución para tarjetas de red, podría ser cualquier tarjeta PCIe, por ejemplo, una tarjeta PCIe para cámaras de alta velocidad. Eso está muy bien, pero veamos cómo funciona.
Al configurar la comunicación GPUDirect RDMA entre dos dispositivos, todas las direcciones físicas son idénticas desde la perspectiva de los dispositivos PCI Express. Dentro de este espacio de direcciones físicas existen ventanas lineales denominadas PCI BAR. Cada dispositivo dispone de un máximo de seis registros BAR, por lo que puede tener hasta seis regiones BAR activas de 32 bits. Las regiones BAR de 64 bits consumen dos registros BAR. El dispositivo PCI Express realiza lecturas y escrituras en las direcciones BAR de un dispositivo par del mismo modo que lo hace en la memoria del sistema.
Tradicionalmente, los recursos como las ventanas BAR se asignan al espacio de direcciones del usuario o del kernel utilizando la MMU de la CPU como direcciones de E/S mapeadas en memoria (MMIO). Sin embargo, debido a que los sistemas operativos actuales no cuentan con mecanismos suficientes para intercambiar regiones MMIO entre controladores, el controlador del kernel de NVIDIA exporta funciones para realizar las traducciones y asignaciones de direcciones necesarias.
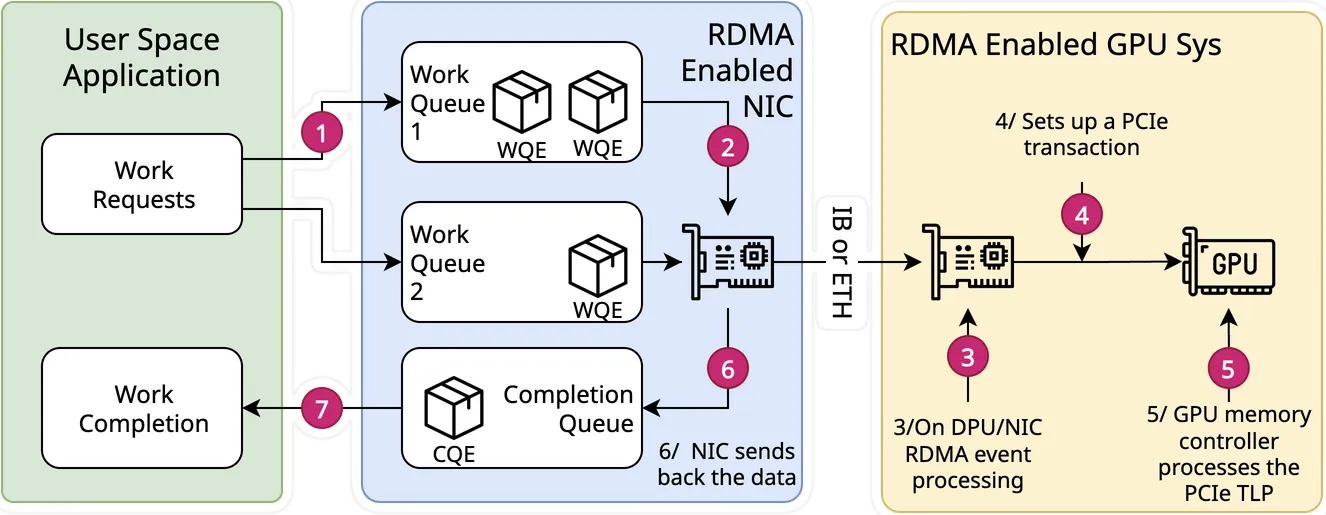
Lo que puede resultar confuso es que el término “DMA” parezca más apropiado que “RDMA” al considerar un sistema intra-PCIe que conecta dispositivos heterogéneos. Pero ese es precisamente el punto. DMA es la solución para transferir datos, y RDMA, por encima de ella, es el protocolo utilizado para definir la semántica de los datos transferidos mediante verbos. Por lo tanto, DMA se limita a los pasos (4) y (5) del diagrama siguiente, mientras que el protocolo RDMA en el hardware del lado receptor se limita al paso (3).
Un aspecto a tener en cuenta es que Nvidia deja claro que esto no es algo sencillo, por lo que, para lograr el mejor rendimiento, probablemente sea mejor utilizar una plataforma de pruebas conocida:
Aunque el único requisito teórico para que GPUDirect RDMA funcione entre un dispositivo de terceros y una GPU NVIDIA es que compartan el mismo complejo raíz, existen errores (principalmente en los chipsets) que provocan un mal rendimiento o que no funcione en absoluto en ciertas configuraciones.
Todavía existe una confusión evidente en la terminología, específicamente entre Ethernet, InfiniBand y RoCE: el hecho de que RoCE se basa en Ethernet.

La asociación comercial de InfiniBand lo describe en términos sencillos como una evolución, representada en el diagrama anterior. Nótese que he usado deliberadamente el nombre “100G + PFC” en lugar de la mención original de “DCB” (también conocido como Data Center Bridging). Si entiendo correctamente, DCB es un superconjunto de PFC (también conocido como priority flow control), y la idea es decir que para que DCB/PFC funcione, se necesita la infraestructura de red, incluidos los conmutadores, para implementar esas tecnologías. De lo contrario, se vuelve a la categoría Ethernet.
Este memorándum no estaría completo sin mencionar NVLink. La pregunta inmediata es si NVLink e InfiniBand son lo mismo o si están relacionados de alguna manera. En resumen, son complementarios, no compiten entre sí.

NVLink: Comunicación rápida dentro del nodo (dentro de un servidor, entre GPU).
InfiniBand: Comunicación rápida entre nodos (entre servidores en un clúster)
En el diagrama de la derecha, se observa claramente que las flechas verdes se utilizan para interconectar las GPU entre sí. La conexión entre las NIC es InfiniBand.
Lo interesante es que el NVLink es interno al hardware de Nvidia y no está expuesto al exterior, a diferencia de los conectores InfiniBand, como se muestra en el diagrama a continuación. Cabe destacar que el Quantum InfiniBand X800 es una bestia de potencia, con enlaces de 800 Gb/s y fotónica de silicio integrada, pero no tiene nada que ver con la computación cuántica.
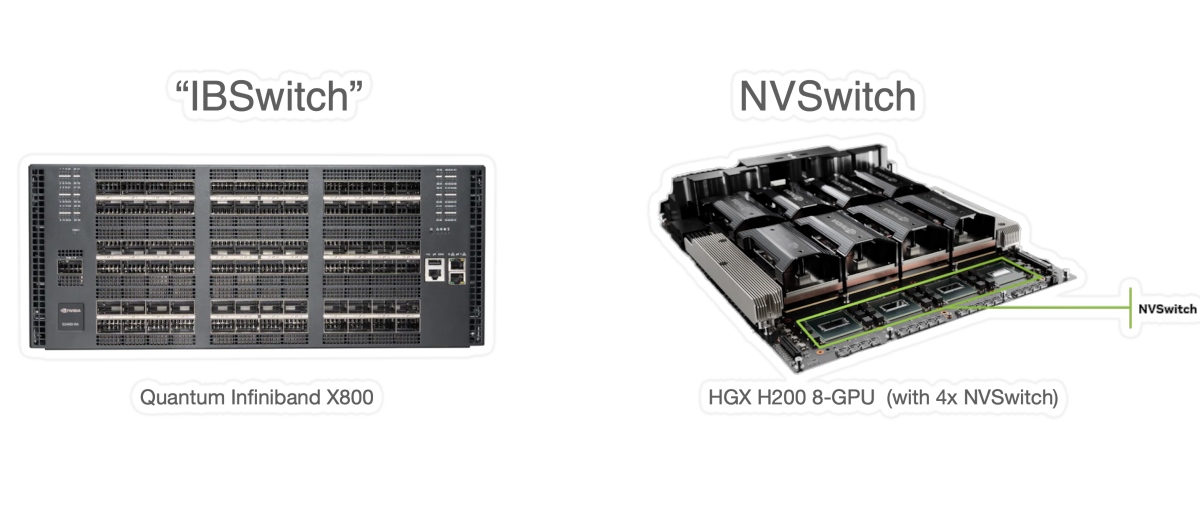
Un último punto a destacar: Nvidia ha presentado NVlink Fusion como una forma de abrir el estándar NVLink. Por lo tanto, mañana probablemente veremos una integración personalizada, que tal vez aún requiera una placa de circuito impreso como “conmutador” (en lugar de un cable), pero con un SoC, que podría no ser un SoC de Nvidia. También cabe mencionar que AMD ha respondido al estándar de Nvidia presentando UALink.
En resumen, RDMA no es muy complejo:
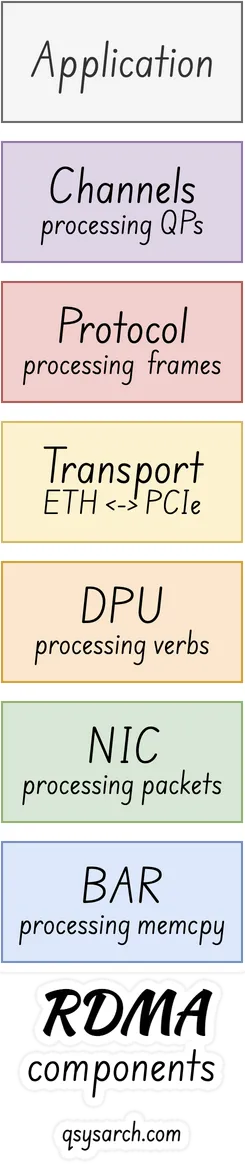
RDMA BAR: como una asignación PCIe BAR: En la capa física, hay un dispositivo PCIe que se conecta a la GPU a través del mismo complejo raíz PCIe y asigna la BAR de memoria de todos los dispositivos.
Tarjeta de red RDMA: como tarjeta de red de hardware (NIC): Esta tarjeta PCIe suele ser una tarjeta de red, pero no necesariamente. Sin embargo, parece que solo existe una tarjeta de red en el mercado con capacidad RDMA.
RMDA DPU: como procesador de verbos en el hardware: Para que la tarjeta PCIe sea compatible con RDMA, el hardware debe poder procesar los verbos RDMA directamente en el hardware, generalmente utilizando un procesador llamado DPU.
Transporte RDMA: como capa de transporte para la red loink: El dispositivo PCIe se expone, en el lado de la red, como un transporte que puede ser Ethernet, mejor Ethernet (RoCev2) e Infiniband.
Protocolo RDMA: como el formato de trama: El protocolo utilizado para comunicarse a través del enlace de red también se llama RDMA. No revisé los detalles del formato de trama, pero está en RFC5040.
Canales RDMA: como la forma de comunicarse a través de QP: El SW / controlador / SDK utilizado en el host para comunicarse con el dispositivo RDMA también se llama RDMA, pero se define como Queue Paris y Channels.
¡Listo! Creo que ahora entiendo un poco mejor RDMA.
Volviendo al desafío de la computación cuántica, la pregunta es: ¿por qué nos interesa RDMA? Bueno, ¡porque Nvidia llamó a su conmutador InfinBand “Quantum InfiniBand”!
Pero, aun así, a pesar de que su último Quantum-X800 es una bestia, no tiene nada que ver con la computación cuántica. Pero quizás podría desempeñar un papel clave en la interconexión del control cuántico con la GPU, para el desafío del aprendizaje por refuerzo.