A primera vista, la corrección de errores cuánticos parece sencilla: agrupar los cúbits físicos en un cúbit lógico, aplicar un método para mantener la coherencia entre ellos y, a continuación, operar circuitos cuánticos utilizando estos cúbits lógicos.
Pero en la práctica, este primer paso dista mucho de ser obvio. ¿Cómo se crean y mantienen esos cúbits lógicos? Por ejemplo, desde la perspectiva de un Sistema de Control Cuántico (SCC) (como QM OPX1000, ZI ZQCS o Qblox Q1 Cluster), ¿qué se necesita para “operar” u “orquestar” el cúbit lógico? Y una vez que este cúbit lógico está “listo” para ser operado, ¿qué se necesita para usarlo para realizar computación cuántica, a través de los circuitos cuánticos compuestos por puertas de 1 y 2 cúbits? Esta sencilla pregunta no se refiere únicamente al sistema de control de hardware, sino también a la pila de software, especialmente a los compiladores: ¿Tenemos ahora varios compiladores, uno para los cúbits físicos y otro para los cúbits lógicos? Y en lo que respecta a la escalabilidad, ¿qué se necesita para que los compiladores puedan gestionar la complejidad que supone el procesamiento de 10 000 cúbits físicos en un entorno heterogéneo compuesto por GPU/QPU híbridas y QCS? ¡Son preguntas sencillas, pero con respuestas complejas!
Este memorándum es el primero de una serie sobre corrección de errores cuánticos desde la perspectiva de los sistemas de control cuántico. Este primer memorándum breve introduce los conceptos básicos necesarios para “crear” un cúbit lógico consistente en la capa física.
¿Qué define a un “qubit lógico”? La creación de qubits lógicos comienza con la agrupación de qubits físicos, a cada uno de los cuales se le asigna una función específica. Algunos sirven como qubits auxiliares o de apoyo, mientras que otros funcionan como qubits de datos o principales.
Esta agrupación suele representarse mediante el diagrama de la derecha, que muestra un “Código de superficie 17 basado en la distancia 3” (crédito de la imagen: Irréversible Inc).
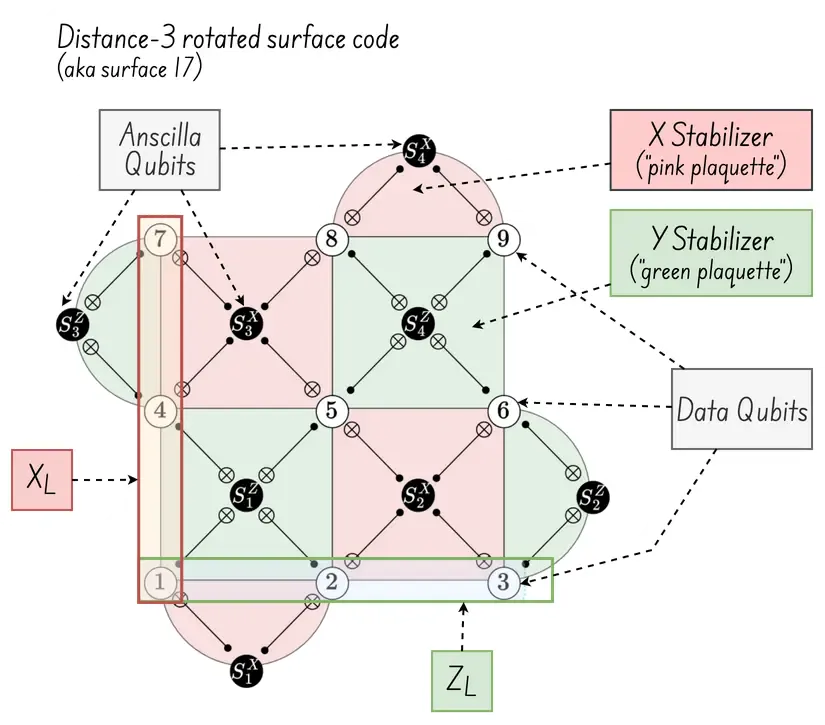
Esta es la estructura básica, aplicable a códigos de superficie:
Los cúbits de datos (círculos blancos) almacenan la información cuántica. La superficie 17 contiene 9 cúbits de datos.
Los cúbits auxiliares (círculos negros) realizan comprobaciones de paridad no destructivas. La superficie 17 contiene 8 cúbits auxiliares.
La interacción entre los cúbits de datos y ancilla es específica de cada “plaqueta”:
Las plaquetas (caras verdes y rosas) definen la relación tipológica de verificación de errores entre el cúbit auxiliar en el medio y sus cúbits de datos vecinos.
El estabilizador: Cada cúbit auxiliar se utiliza para medir un operador de Pauli, o estabilizador: Los códigos de superficie tienen dos estabilizadores: los de tipo Z detectan errores de inversión de bits (X), mientras que los de tipo X detectan errores de inversión de fase (Z).
La medición del estabilizador es la medición de un único estabilizador, implementada mediante el acoplamiento secuencial de un cúbit auxiliar a los cúbits de datos vecinos y la posterior medición del cúbit auxiliar.
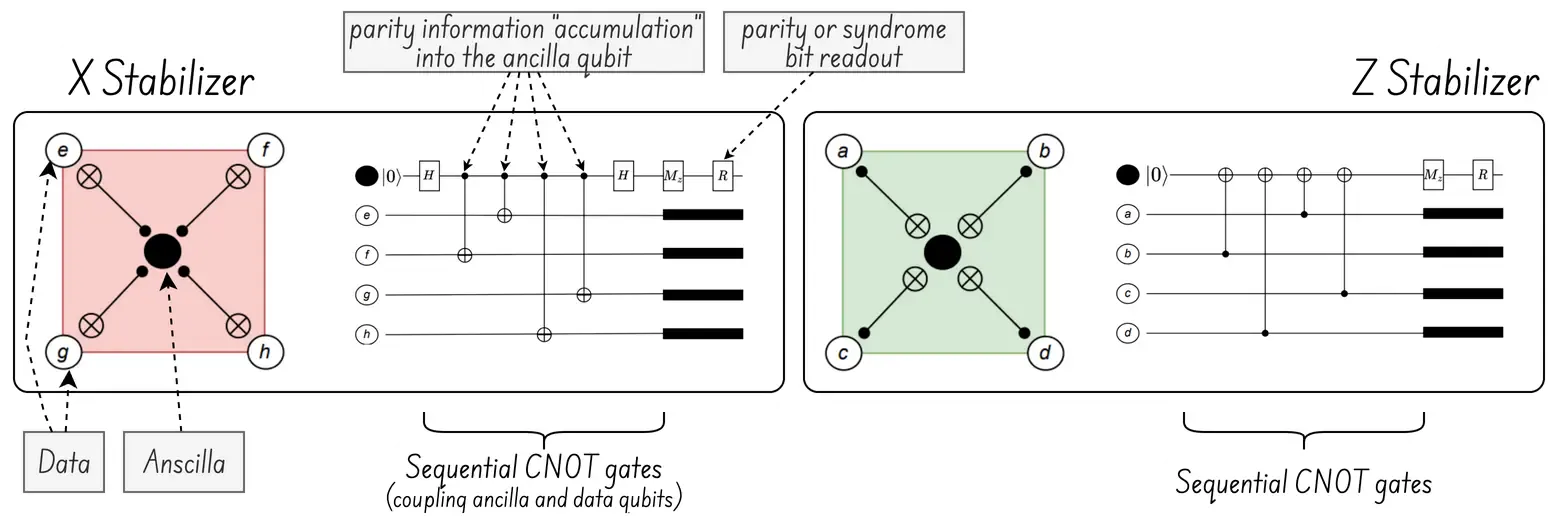
Los bits de síndrome corresponden al resultado de la medición del operador estabilizador de verificación de paridad. Se produce un bit de síndrome por cada ciclo de medición.
La extracción del síndrome es el proceso completo de realizar todas las mediciones del estabilizador en un ciclo de corrección de errores para obtener el síndrome de error completo.
Un pequeño cuestionario: ¿Quién es el cúbit culpable?
Link to heading
En este contexto, considere el diagrama a continuación (crédito: Laurent Prost de Alice & Bob). Z 1 Z 2 y Z 2 Z 3 representan mediciones de verificación de paridad conjunta (estabilizador) entre el Qubit 1 y el Qubit 2, y entre el Qubit 2 y el Qubit 3, respectivamente. A diferencia de las plaquetas bidimensionales anteriores, este diagrama asume que cada cúbit físico está vinculado a un solo cúbit, lo que indica un código de repetición unidimensional.
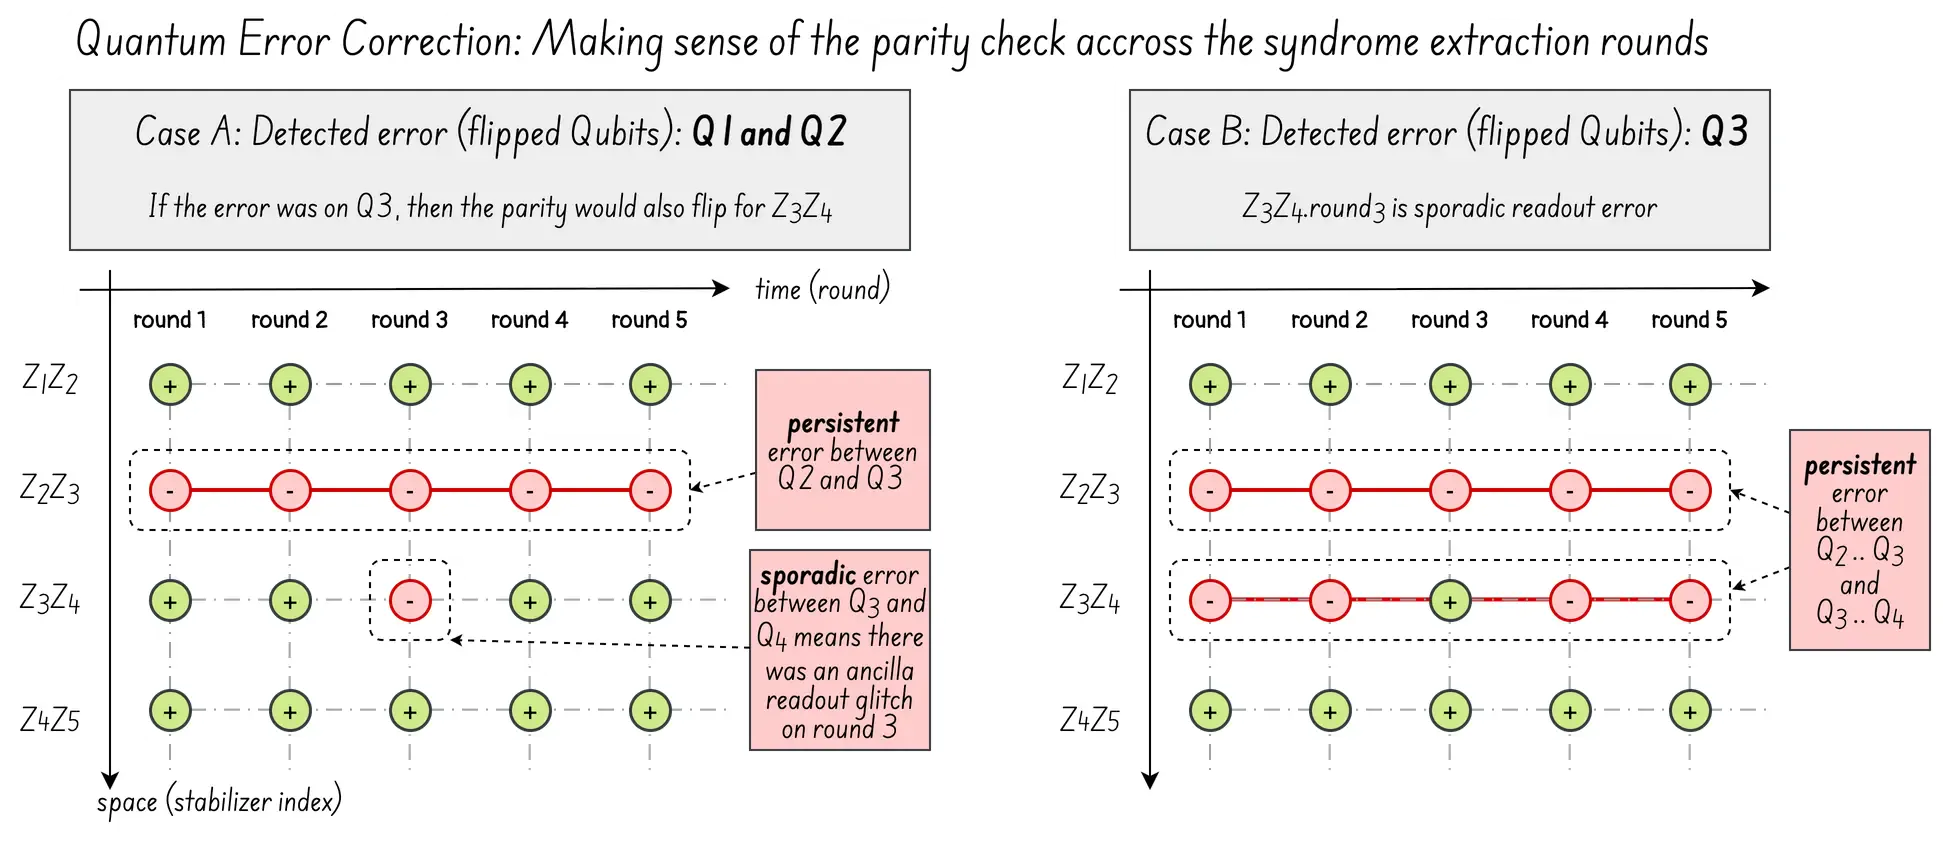
En el diagrama de la izquierda (caso A), parece que el error está en el cúbit de datos 3, pero en realidad indica errores en los cúbits de datos 1 y 2. La línea horizontal roja muestra que el error ocurre solo en Z 2 Z 3 . Si el error estuviera en el cúbit 3, Z 3 Z 4 también se invertiría. Por lo tanto, Z 1 Z 2 representa un error Bizantino, lo que significa que tanto Q1 como Q2 se han invertido. El diagrama de la derecha (caso B) muestra el resultado esperado si el error estuviera en el cúbit 3.
Detrás de escena: La “magia” de QEC
Link to heading
Esta segunda sección es un poco más densa, pero es importante para comprender los siguientes memorandos sobre la orquestación de cúbits físicos dentro de un grupo lógico. Intento que sea lo más concisa posible, sin entrar en los complejos detalles matemáticos que mis colegas de QEC podrían explicar mucho mejor.
Barreras de dominio y errores degenerados
Link to heading
El error bizantino Q 1 +Q 2 es en realidad un problema común denominado error degenerado. En concreto, se refiere a una situación en la que dos o más errores físicamente distintos producen el mismo bit de síndrome, lo que imposibilita distinguirlos.
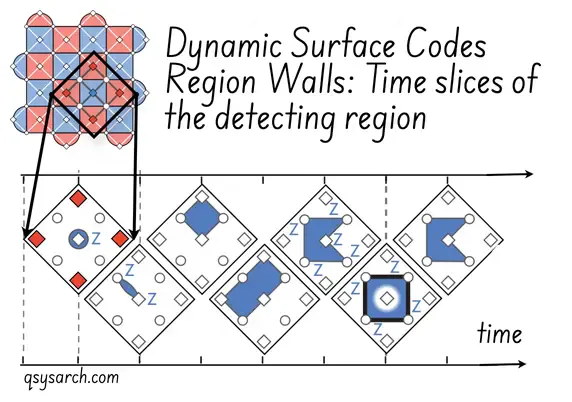 Pero esto no es un problema en QEC: los estabilizadores no se utilizan para detectar errores directamente. En cambio, los estabilizadores se utilizan para identificar los límites físicos del cúbit (también conocidos como paredes de dominio) en los que reacciona un síndrome de error. Luego, al aumentar la redundancia para superponer los límites, se pueden determinar errores individuales (o, alternativamente, usar el código de superficie time-dynamic de GoogleAI como se muestra en el diagrama de la derecha).
Diseñar esta redundancia en sistemas cuánticos es fundamentalmente complejo y requiere una sólida formación matemática. Para comprender el concepto general, debemos volver a lo básico: ¿Cómo funciona realmente la comprobación de paridad?
¿Cómo funciona realmente la comprobación de paridad?
Link to heading
Al principio, puede parecer confuso cómo funciona la comprobación de paridad, ya que determinar la paridad requiere conocer el bit de síndrome esperado, que depende del estado del cúbit de datos. Sin embargo, conocer el estado del cúbit de datos de antemano iría en contra del propósito de la computación cuántica. En otras palabras:
“Si no conocemos el estado cuántico, ¿cómo podemos saber si ha cambiado?”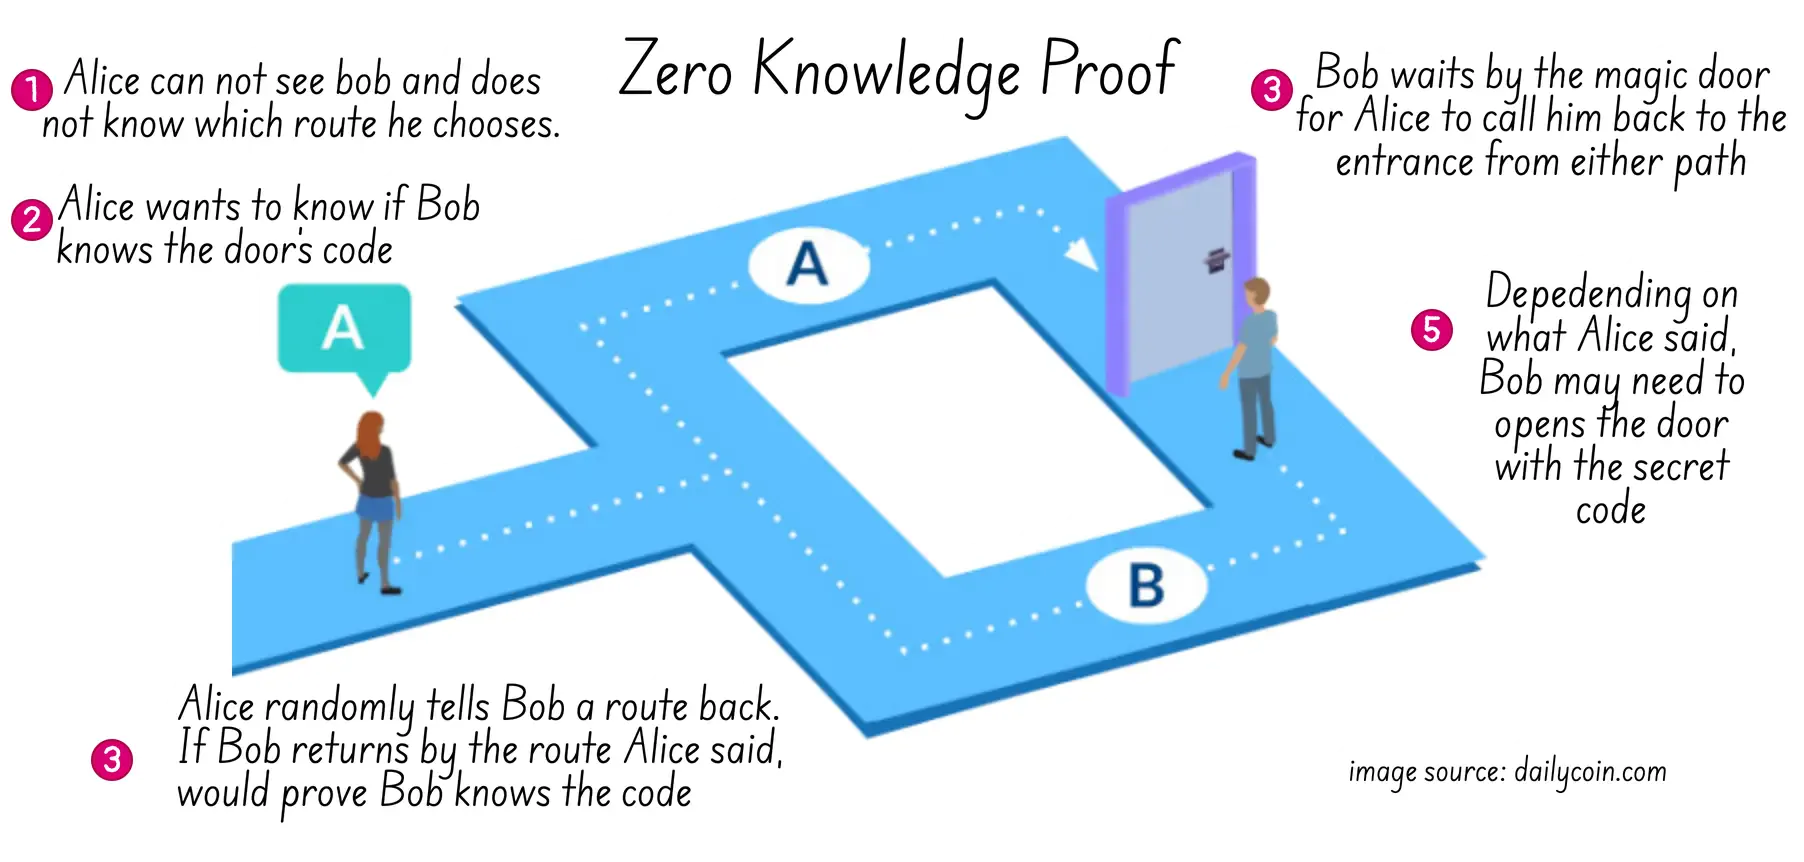 Para resolver este desafío, la clave es recurrir al mismo truco utilizado para la prueba de “conocimiento cero” utilizada en el experimento de la cueva de Alibaba: solo se necesitan hacer preguntas específicas cuyas respuestas se conocen independientemente de cuál sea la información cuántica codificada (créditos de la imagen: dailycoin)
Estas preguntas específicas corresponden a los operadores estabilizadores de Pauli. El bit de síndrome, o resultado de la medición, puede considerarse como la ruta A o la ruta B. En QEC, la ruta A representa el estado válido, mientras que la ruta B indica un error. Lo que necesita el “motor” de QEC es construir el circuito cuántico que opera sobre el cúbit lógico de manera que se preserve esta restricción, también llamada “estado protegido”.
Codificación de estados protegidos
Link to heading
Aquí es donde la ingeniería se vuelve crucial. Para garantizar que la medición del síndrome siempre devuelva la ruta A cuando no hay error, y la ruta B en caso contrario, la información de paridad de múltiples cúbits debe codificarse de tal manera que las relaciones entre los cúbits sean fijas para cada estado codificado válido.
Esta es la función del circuito de codificación. Su propósito es mapear un estado de entrada simple y no corrupto (como un único cúbit físico \(|ψ> = α|0> + β|1>\) con cúbits auxiliares vacíos \(|00...0>\) en un estado de cúbit lógico altamente entrelazado \(|ψ_L>\) protegido por la corrección de errores cuánticos.
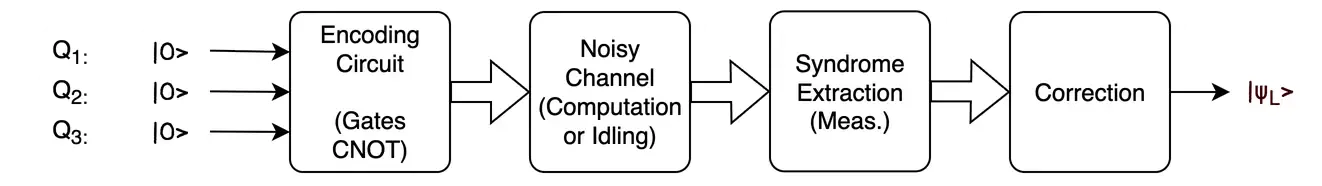
Analizaré el circuito de codificación con más detalle en un informe posterior. Por ahora, podemos considerarlo como un circuito cuántico especializado y diseñado para inicializar, o arrancar, el cúbit lógico en el estado protegido.
Para corregir los errores degenerados (es decir, los síndromes “bizantinos” Q 1 + Q 2 ), es posible aumentar la redundancia incrementando lo que se denomina distancia de código \( d \). A primera vista, se podría decir que la distancia de código \( d \) define la robustez de la protección contra errores.
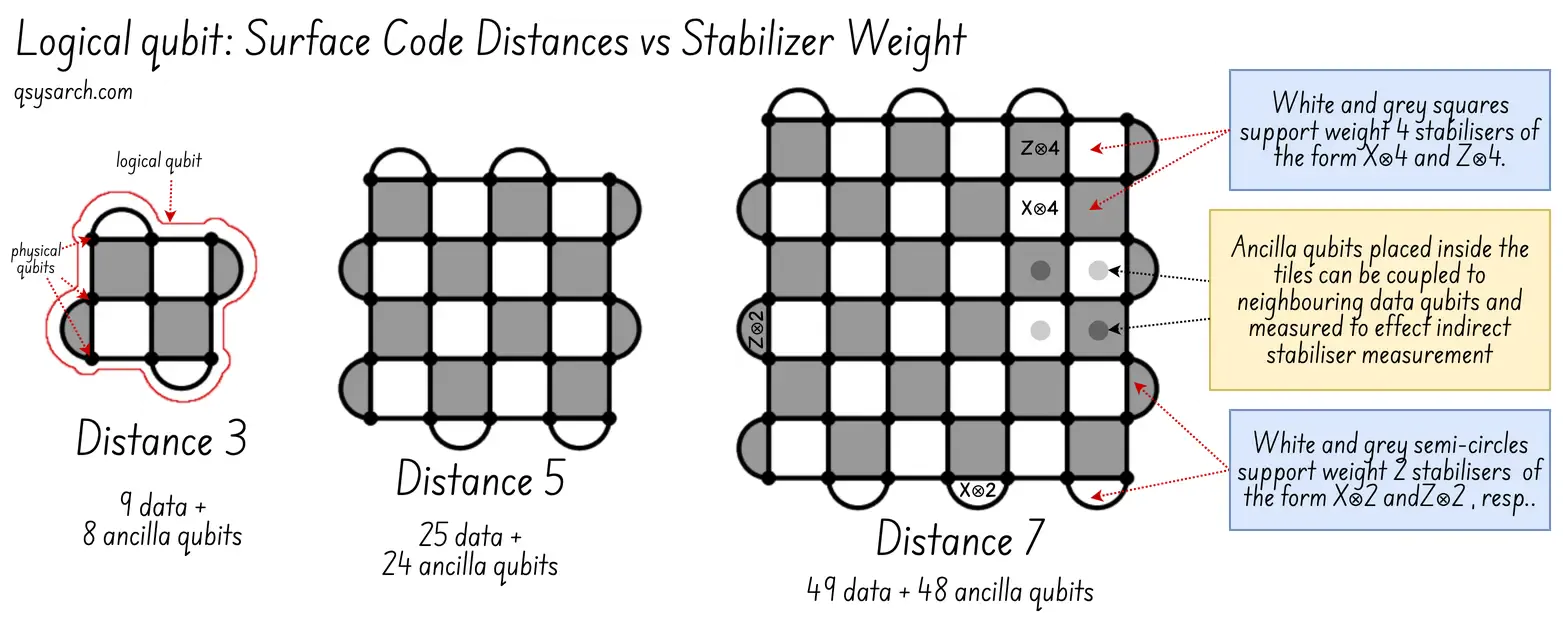
Si la distancia del código es \( d=3 \), invertir 2 cúbits adyacentes destruye la información, y QEC no logra corregir el cúbit lógico, es decir, no logra mantener el cúbit lógico en el estado protegido. Con una distancia de código mayor, por ejemplo \( d=5 \), el decodificador QEC puede asegurar que incluso si Q 1 y Q 2 invierten y se enmascaran mutuamente en la verificación Z 1 Z 2 , entonces la medición del estabilizador de aumento le dará al decodificador suficiente contexto para identificar Q 1 y Q 2 como una falla doble. Desde una perspectiva matemática, esto se puede escribir como:
Un código con distancia \( d \) puede detectar hasta \( (d-1) \) errores y corregir hasta \( \lfloor (d - 1)/2 \rfloor \) errores.
Si la redundancia resuelve el problema, ¿por qué no usar simplemente código de superficie con dimensiones mayores? El desafío radica en que, por cada cúbit físico adicional (para aumentar la redundancia), se necesitan medir más estabilizadores. Y más mediciones implican más riesgos (de que se produzcan errores físicos).
Lo que lleva al llamado Teorema del Umbral
Un circuito cuántico de tamaño \(N\) puede implementarse con alta precisión mediante un circuito cuántico ruidoso, siempre que la probabilidad de error en cada ubicación del circuito ruidoso sea inferior a un valor umbral fijo \(p_{th}>0\). El tamaño del circuito ruidoso escala como \( O(N.log^c(N)) \) para una constante positiva \(c\).
En términos sencillos, el teorema del umbral significa que siempre que la tasa de error de los cúbits físicos \(p\) esté por debajo de un umbral \(p_{th}\), entonces es posible agregar más cúbits físicos para mejorar la corrección de errores, y que el número de cúbits aumentados tiene una complejidad de \(N.log(N)\).
¿Por qué es importante? Porque indica que, incluso si los cúbits “no se comportan” correctamente todo el tiempo, siempre que no ocurra con demasiada frecuencia, es posible lograr que un conjunto mayor de cúbits se comporte mejor que la suma de los cúbits individuales, lo que abre la puerta a la era posterior a NISQ, es decir, la era FTQC o Computación Cuántica Tolerante a Fallos.
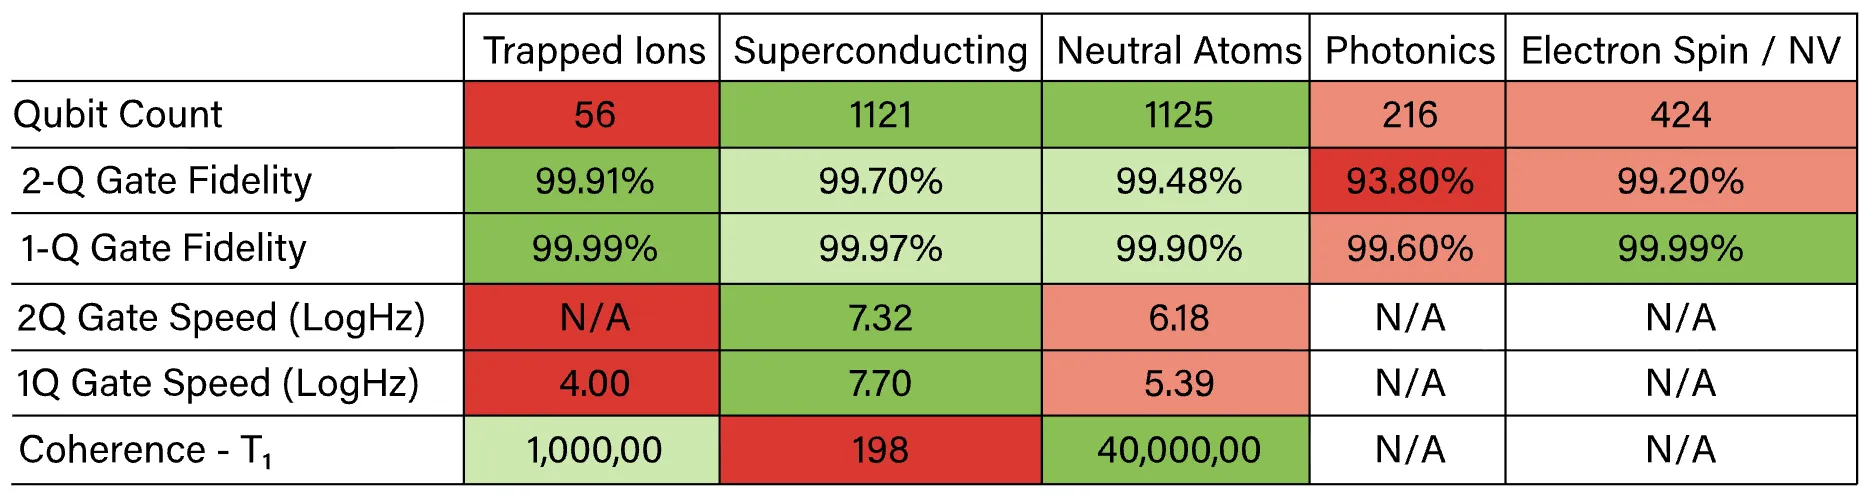
Por supuesto, la pregunta esencial aquí es cuál es este umbral \ (p _ {th} ). Están en el orden del 0,1% al 1%, y aunque pueda parecer bajo, esto no es un problema ya que los cúbits modernos ya pueden alcanzar fidelidades del 99,9% (para puertas de un cúbit).
He aquí, este breve memorándum sienta las bases de los conceptos utilizados en la corrección de errores cuánticos.
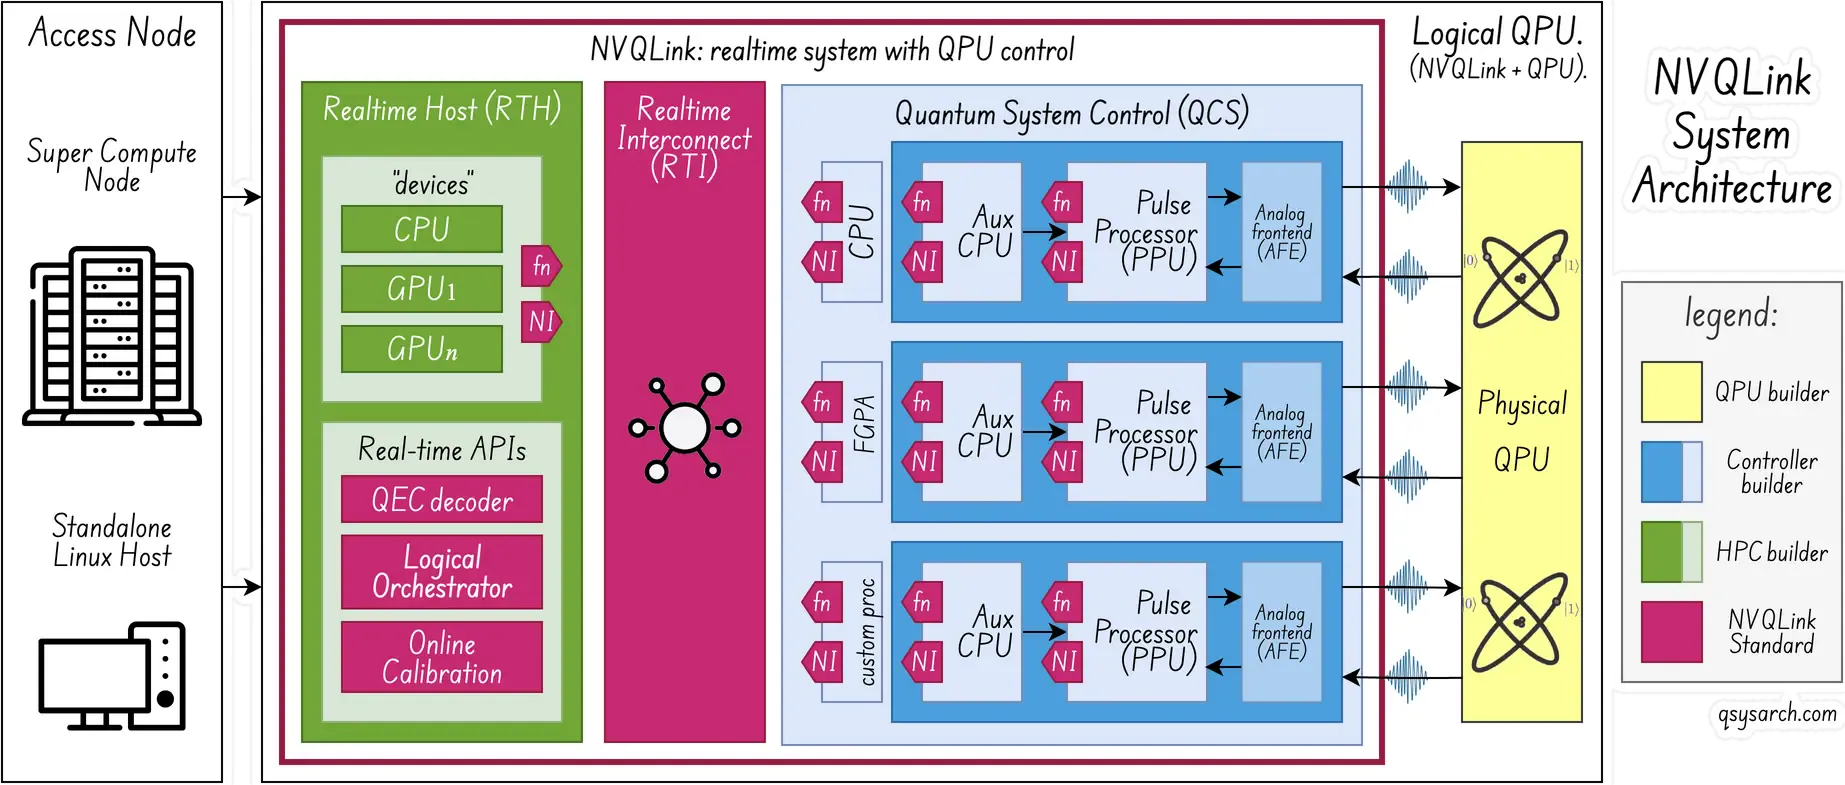
Los próximos dos informes serán más prácticos. El segundo analizará qué significa concretamente para el Sistema de Control Cuántico (y el decodificador de errores) operar el cúbit físico como un cúbit lógico, en términos de control, lectura y secuenciación. El tercer informe se centrará en el sistema de decodificación, así como en la baja latencia y el procesamiento en tiempo real entre el decodificador y el sistema de control.
Este memorando es en realidad el primero de una serie. Los próximos memorandos de QEC se centrarán en los siguientes temas:
Orquestación de la extracción del síndrome desde la perspectiva del Sistema de Control Cuántico
Decodificación de errores en tiempo real: ASIC, GPU y redes neuronales de latencia ultrabaja.
Qubits inteligentes de diseño conjunto: El caso de los qubits protegidos contra errores de Alice y Bob
Compiladores de código de superficie a gran escala: maximizar la tolerancia a fallos para miles de millones de operaciones físicas.
Arquitecturas de decodificación jerárquica: principio de localidad y procesamiento multicapa
Orquestación lógica de cúbits: Cirugía de retículos y entrelazado
Más allá de los códigos de superficie: El cambio a los códigos qLDPC
Destilación en estado mágico y rotaciones análogas
¡Parece que esto me va a mantener ocupado durante los próximos 6 meses!
References:
DrawIO diagrams used in this memo: