Estoy muy feliz de ser parte del equipo en Qblox que ha estado y sigue trabajando activamente con Nvidia para promover el estándar NVQLink, como una forma de interconectar sistemas heterogéneos calculados en GPU, CPU y QPU (procesador cuántico, incluidos los controladores cuánticos de interfaz que Qblox está desarrollando).
NVQLink no es otro “cable” para conectar GPU a procesadores Quantum, sino más bien un marco completo que permite interconectar dispositivos heterogéneos, desde la red hasta la pila de software:
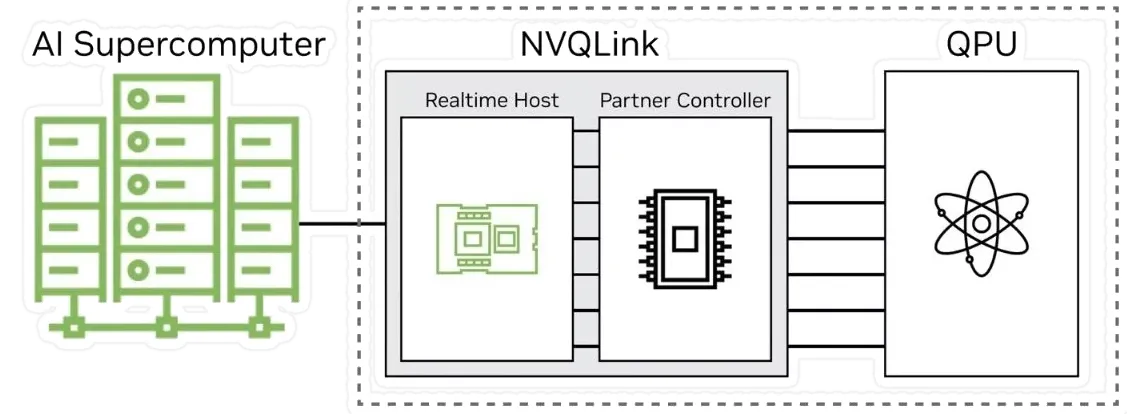 Crédito de la imagen: Nannod
¿Qué especificaciones de rendimiento?
Link to heading
Las especificaciones clave de “hardware” hacen hincapié en el rendimiento de los recursos de red e informáticos:
Rendimiento de red: Hasta 400 Gb/s desde la GPU a la QPU.
Latencia de red: latencia de ida y vuelta (FPGA → GPU → FPGA) inferior a 4,0 microsegundos.
Hardware de GPU: Host en tiempo real construido sobre los superchips NVIDIA GB200 Grace Blackwell, con una gran cantidad de TFLOPS.
Quizás te preguntes: “¿Por qué es importante esto?”
Crea un estándar abierto para integrar estrechamente el hardware cuántico con la computación acelerada por GPU.
Permite flujos de trabajo híbridos: calibración de redes neuronales, corrección de errores cuánticos (QEC), etc.
Proporciona una plataforma abierta que integra software y hardware como uno solo, lo que permite a cualquiera interactuar con computadoras cuánticas, sin tener que ahogarse en un océano de conocimiento, gracias a Cuda-Q.
Especificación NVQLink: Diseño de arquitectura
Link to heading
El documento técnico de NVQLink ya está disponible en https://arxiv.org/abs/2510.25213, así que profundicemos en los detalles de la arquitectura propuesta:
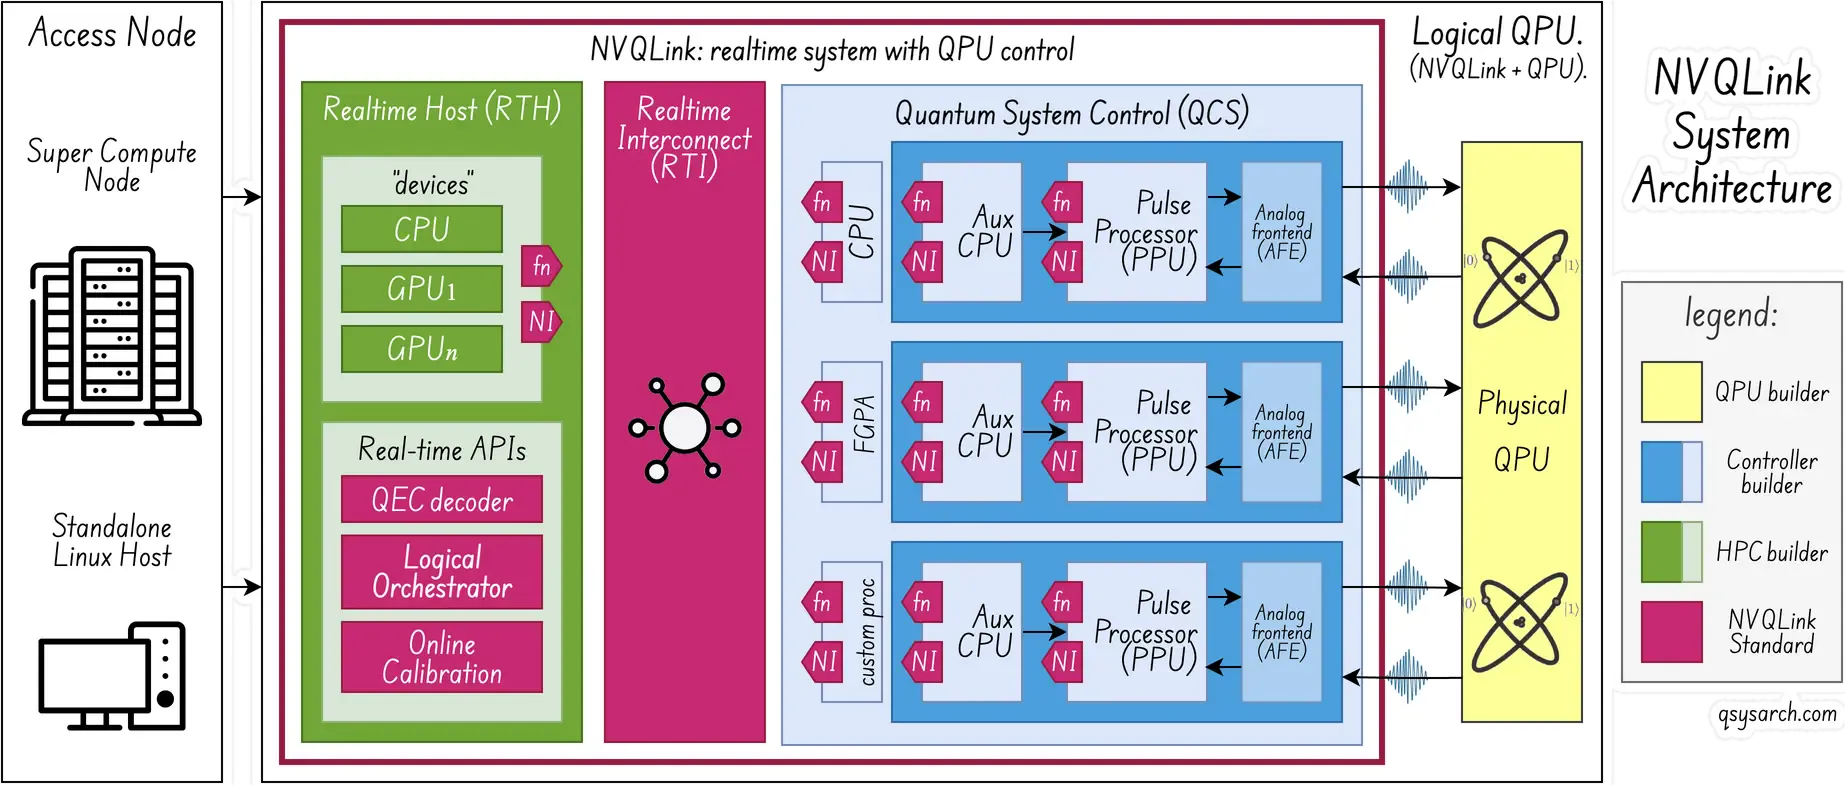 (diagrama del sistema adaptado de la imagen original del documento técnico)
Como era de esperar, los detalles coinciden con la descripción general de Nannod. Desde la perspectiva de los componentes, la arquitectura NVQLink comprende el Host en Tiempo Real (RTH) y el Sistema de Control de la QPU (QSC). Estos dos componentes están conectados por una Interconexión en Tiempo Real (RTI) escalable y de baja latencia. El RTH dispone de recursos de computación de alto rendimiento (HPC) tradicionales, como CPU y GPU. En cuanto al QSC, normalmente incluye las Unidades de Procesamiento de Pulsos (PPU), que controlan la QPU.
Este diagrama introduce dos palabras clave importantes: fn y NI. En el modelo mental de NVQLink («modelo de programación»), cada una de las CPU, GPU, PPU (u otros circuitos integrados/FPGA especializados) se denomina «dispositivo», y NVQLink permite realizar llamadas a procedimientos remotos («callbacks» o fn) en cualquiera de estos dispositivos. Se trata de una solución muy potente, donde NVQLink actúa como nexo de unión para el sistema heterogéneo. La implementación del entorno de ejecución de fn está altamente optimizada, hasta el punto de que se gestiona incluso la serialización. De esta forma, se pueden garantizar latencias de unos pocos microsegundos. En cuanto a NI, significa Interfaz de Red y se conceptualiza como una tarjeta/interfaz/cable de red «pequeña» y opcional que todos los participantes pueden utilizar para tener un sistema unificado e interconectado.
El NVQLink también introduce el concepto muy importante de dominios de tiempo: esto es necesario porque no se espera que todas las “unidades de procesamiento” involucradas en el sistema sigan el “mismo reloj”.
Existen 4 categorías de relojes o dominios de tiempo, desde el más rápido hasta el más lento:

Dominio de tiempo físico (PTD): Normalmente el reloj de la QPU.
Dominio de tiempo determinista (DTD): Normalmente el reloj de los QSC/FPGA, capaz de operar con escalas de tiempo cuánticamente coherentes.
Dominio en tiempo real (RTD): Generalmente en la CPU o GPU clásica. Puede estar dentro del tiempo cuántico coherente o entre dos experimentos cuánticos coherentes.
Dominio de tiempo de la aplicación (ATD): ¡Normalmente el portátil en el que se ejecuta Jupyter Notebook!
Como era de esperar, NVQLink utiliza RDMA y GPUDirect para evitar cualquier procesamiento innecesario de la CPU y garantizar una latencia óptima. Tal como se indica en la especificación, «gracias a estas dos tecnologías, solo la NIC y la GPU intervienen en el procesamiento de los paquetes que entran y salen del QSC, sin ninguna intervención del host».
La especificación también recomienda utilizar el modo RDMA de “conexión no fiable”, ya que el coste de latencia que suponen las conexiones fiables (RC) puede ser excesivo en comparación con una red diseñada correctamente.
La especificación proporciona una “prueba de concepto” para la arquitectura de red, como medio para verificar la latencia que se puede lograr. Se utiliza el módulo Holoscan Sensor Bridge, que permite enviar datos entre una FPGA y una NIC mediante el protocolo RDMA sobre Ethernet convergente (RoCE), además de gestionar los pasos de enumeración y las señales de control. Con esta arquitectura, la especificación demuestra que es posible lograr una latencia de ida y vuelta inferior a 4 microsegundos para una carga útil RDMA de 32 bytes, equivalente a una trama Ethernet de 92 bytes.
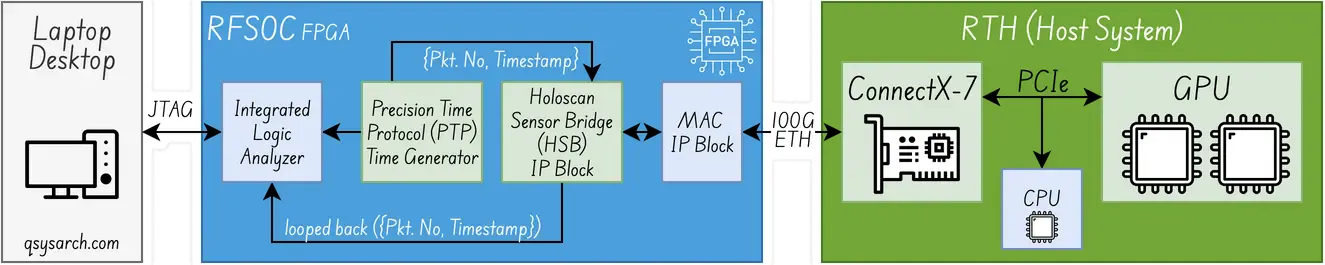 (diagrama adaptado de la imagen original del documento técnico)
Arquitectura de compilación (también conocido como modelo de programación CudaQ+NVQLink)
Link to heading
NVQLink distingue entre modalidades lentas y rápidas, y en esta sección analizaré específicamente el impacto de la arquitectura de modalidad rápida (la denominada «alta sensibilidad a la latencia»). La principal diferencia con las modalidades lentas radica en que la arquitectura permite la compilación Just-in-Time (JIT), así como la posible mediación RTH durante la ejecución.
Para que CudaQ + NVQLink funcione con modalidades rápidas, la especificación estipula que los programas ISA completos deben cargarse en las FPGA con antelación y ejecutarse de forma atómica, con una comunicación interactiva mínima con el host en tiempo real durante la ejecución. JIT es una tecnología realmente interesante, por lo que es una lástima que no se pueda usar para modalidades rápidas. Sin embargo, la especificación deja claro que las FPGA pueden recibir actualizaciones dinámicas del RTH (a través de una cola de instrucciones), siempre que dicha cola permanezca abierta hasta la finalización del programa. Esto se asemeja a la planificación “justo a tiempo”.
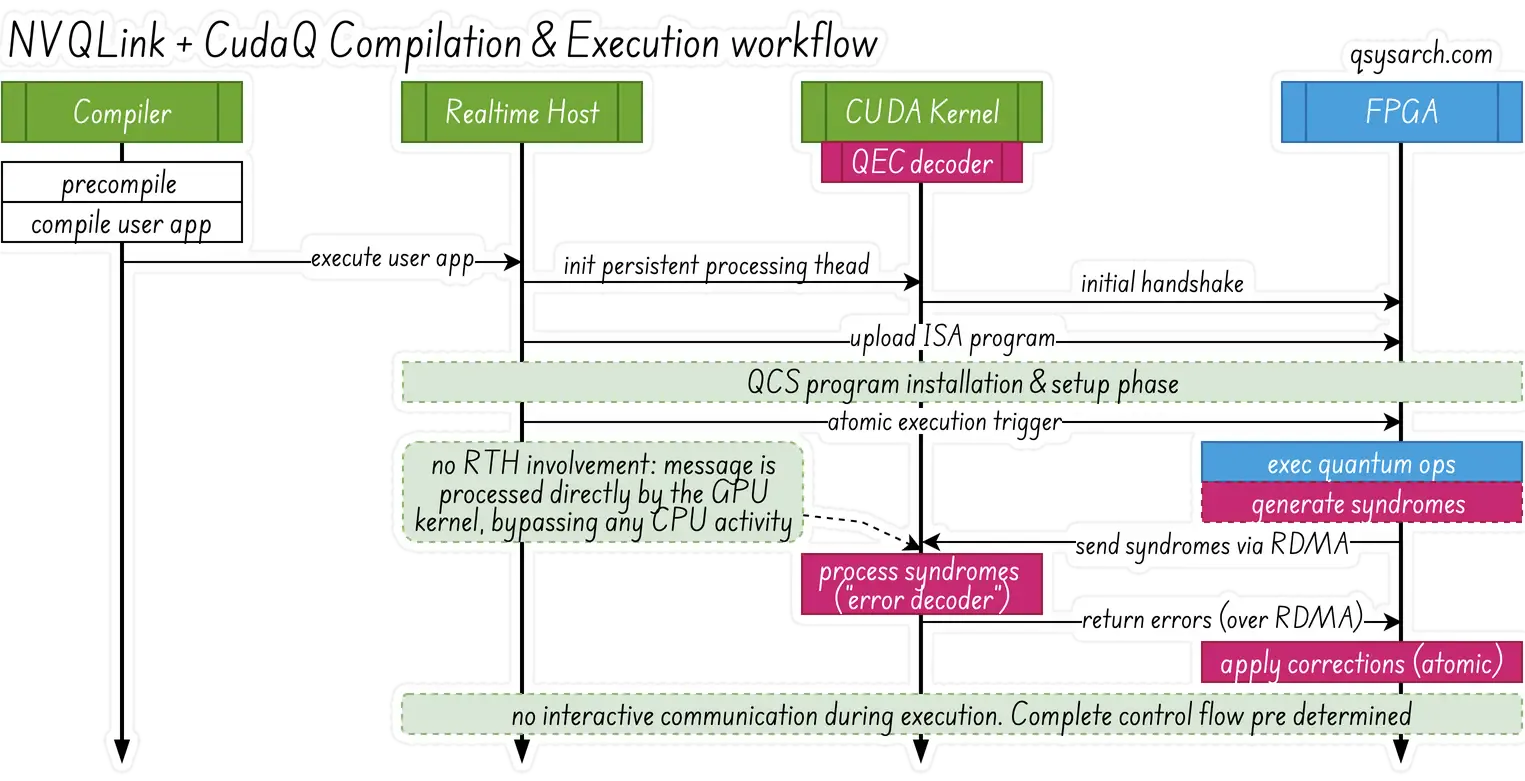
Como era de esperar, la especificación deja claro que la compilación debe realizar optimizaciones agresivas por adelantado, algo que todos los proveedores de pilas de control cuántico hacen habitualmente. También se menciona que, si se necesita ejecutar alguna función de devolución de llamada en la GPU, el kernel CUDA de la GPU debe estar preinicializado y a la espera de eventos; nada especial, ya que se trata del flujo de trabajo estándar DOCA GPUNetIO.
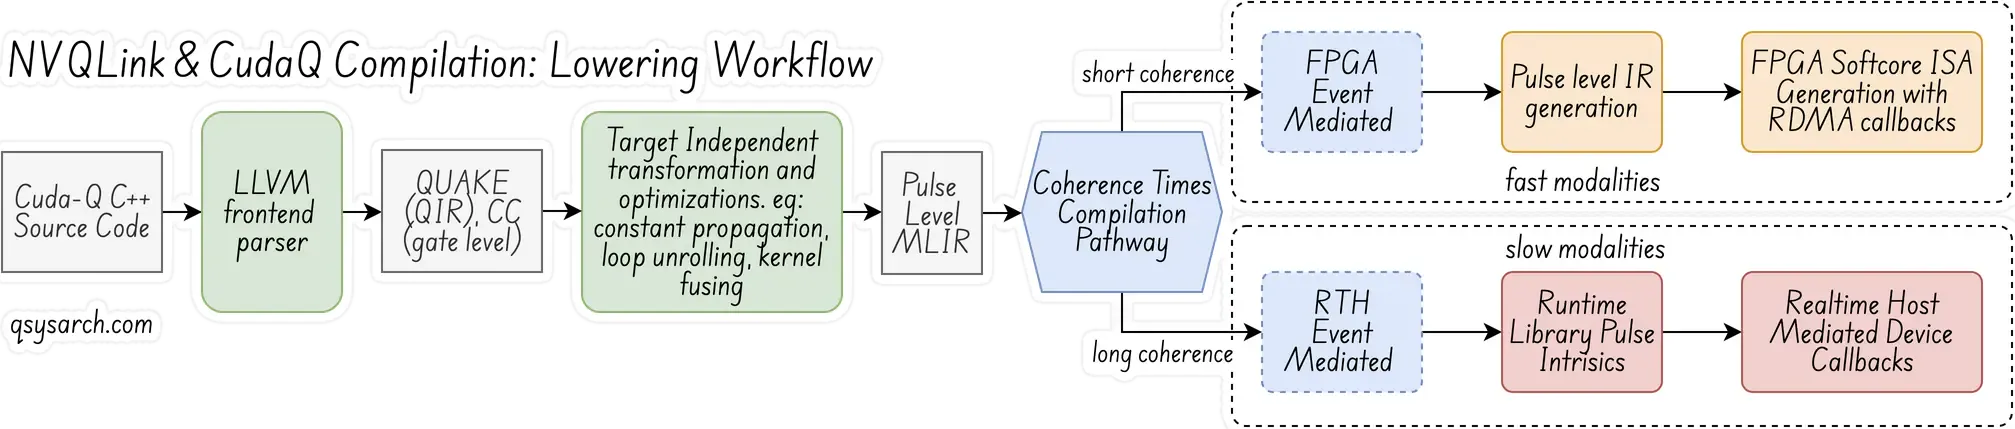
El flujo de trabajo de compilación y conversión de CUDA=Q a la arquitectura NVQLink se basa en la arquitectura LLVM MLIR estándar (véase el diagrama anterior). El primer paso consiste en analizar los kernels de CUDA y generar los IR intermedios Quantum IR (también conocido como QIR o QUAKE) y CC (computación clásica), que se abstraen a nivel de compuerta. Una fase posterior introduce la optimización y la fusión de kernels necesarias, produciendo un dialecto a nivel de pulso. A continuación, según el tipo de modalidad, la siguiente fase de conversión utiliza la mediación RTH o FPGA.
El “núcleo cuántico” se identifica mediante el prefijo __qpu__.
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
cudaq::qubit q;
h(q); // Operate an H gate on qubit q
auto readout = mz(q); // Read the Z axis of qubit q
return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
Durante la fase de compilación, primero se convierte (“reduce”) a una mezcla de representaciones intermedias (RI), o dialectos, de QUAKE (dialecto cuántico) y CC (dialecto de computación clásica):
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
%0 = quake.null_wire
%1 = quake.h %0 : (!quake.wire) -> !quake.wire
%measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
%2 = quake.discriminate %measOut : (!quake.measure) -> i1
%3 = cc.cast unsigned %2 : (i1) -> i32
%4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
return %4 : i32
}
En consonancia con el concepto de copia cero profundamente arraigado en RDMA, el entorno de ejecución NVQLINK también promueve un alto rendimiento y una abstracción sin sobrecarga, lo que se logra con dos conceptos esenciales clave:
Composición basada en rasgos: Es un método en tiempo de compilación para expresar cualquier comportamiento del dispositivo, y NVQLink propone un conjunto de rasgos estándar.
Polimorfismo estático: Es un medio en tiempo de compilación para que el compilador instancie el método correcto sin necesidad de indirección de tabla virtual.
Existen 4 características esenciales:
explicit_data_marshalling_trait: significa asignar y transferir datos a través del sistema.
device_callback_trait: significa invocar funciones del dispositivo (“RPC”)
quantum_control_trait: significa cargar e iniciar el programa en el QCS
rdma_trait: significa inicializar eficientemente la estructura desde el búfer de memoria sin procesar.
En la práctica, las características utilizan el lenguaje C++ a un nivel muy avanzado. Este es un ejemplo de la característica data marshaling.
template <typename Derived> class explicit_data_marshaling_trait {
public:
void *resolve_pointer(device_ptr &devPtr);
device_ptr malloc(size_t size) const;

template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

void free(device_ptr &d);

template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
void free(Ptrs &&...d) { (free(d), ...);
}
void send(device_ptr &dest, const void *src);
void recv(void *dest, const device_ptr &src);
};
Hay mucho que analizar en esta sintaxis, que en mi opinión es incluso más potente que la sintaxis de Rust (por ejemplo, cow). Esta sintaxis también se conoce como metaprogramación, y en el contexto de NVQLINQ, se refiere al polimorfismo en tiempo de compilación o estático. Echemos un vistazo a la línea template <typename… Sizes, enable_if_t<(conjunction_v<is_integral …>),int> = 0> con mayor detalle:
es_integral<Sizes> como α: verdadero si Sizes es un tipo entero, es decir, int, float, bool, etc…
conjunction_v<α...> como β: true si todos los valores en α... son verdaderos
enable_if_t<(β),int> como δ: una condición grupo 2 que debería fallar si β era falso.
plantilla<typename... Sizes, δ = 0> : Una construcción SFINAE que evita que δ falle.
Con esta sintaxis, es posible tener una asignación de memoria especializada de múltiples bloques a la vez:
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
Quizás te preguntes por qué esto importa. Es tan sencillo como brindar la posibilidad de una especialización óptima en tiempo de compilación. En este caso, la implementación de malloc puede agrupar el búfer de memoria de forma contigua, lo que la hace adecuada para intercambios RDMA y para la serialización atómica de múltiples datos. Genial, ¿verdad?
Arquitectura de tiempo de ejecución: núcleos
Link to heading
NVQLink proporciona un conjunto de interfaces estándar para compilar, cargar y ejecutar (activar) núcleos cuánticos. Como una imagen vale más que mil palabras, resumiré esta sección con este dibujo:
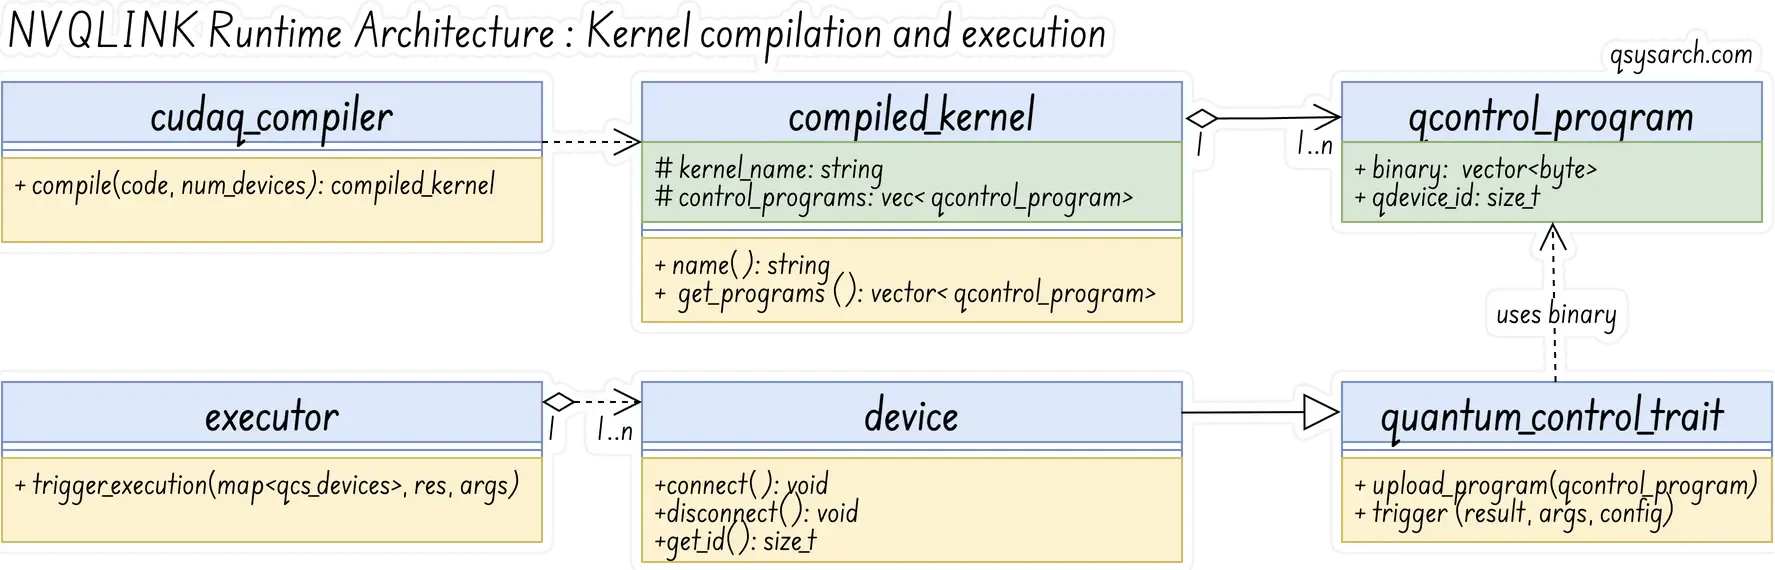
Un aspecto a tener en cuenta es que un QCS (Sistema de Control Cuántico) se compone de múltiples PPU (Unidades de Procesamiento de Pulsos). Por lo tanto, al compilar un kernel, es posible que deba ejecutarse de forma asíncrona en varias PPU. (Tenga en cuenta que NVQLink es independiente de la cosincronía, pero cada proveedor de QCS tiene su propia solución, como SYNQ para Qblox).
En el contexto de las interfaces NVQLINK, el concepto de PPU se abstrae y se reemplaza por QCS, que significa dispositivo cuántico genérico. Por lo tanto, al compilar un kernel, NVQLINK genera varios programas para cada uno de los QCS.
Arquitectura de tiempo de ejecución: “biblioteca” de abstracción de nivel superior
Link to heading
Dado que el código explicado en la sección anterior puede ser bastante complejo de comprender y desarrollar, NVQLINK proporciona un conjunto de API de nivel superior, en forma de funciones:
La biblioteca contiene funciones para gestionar las funciones básicas de inicialización y apagado, para gestionar la API de modificación de datos específica del dispositivo, como memcpy, para transferir datos hacia y desde la QPU lógica, y para gestionar la carga y ejecución. A continuación se muestra una versión simplificada de dichas funciones:
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
Ejemplo de aplicación: Vamos a teletransportarnos
Link to heading
por completar
NVQLINK es una potente abstracción a nivel de sistema que permite la interconexión de sistemas heterogéneos con un entorno de ejecución altamente eficiente y optimizado. Lo que lo hace más atractivo que cualquier otro framework es que el sistema NVQLink se compone de pilas estándar, incluyendo RDMA para la red, LLVM para el compilador y traits y API estandarizadas para el entorno de ejecución.
Con NVQLINK, los desarrolladores e integradores ya no tienen que preocuparse por la interconexión. En su lugar, pueden centrarse en componer su sistema heterogéneo y compilar sus kernels multidispositivo dentro de un único marco, dejando que el entorno de ejecución de NVQLINK orqueste la ejecución de los diferentes “dispositivos”, como si se tratara de un solo sistema. El entorno de ejecución de NVQLINK se encarga de la red, la serialización y las llamadas entre dispositivos, liberándolo de esa tarea.
Esto supone un gran avance: junto con CudaQ, permitirá a los ingenieros cuánticos crear aplicaciones potentes, del mismo modo que Nvidia CUDA impulsó las potentes aplicaciones de redes neuronales. Imagínese un máster en derecho con un toque cuántico…
Indicación: dibuje una imagen de un “Modelo de Qubits Grandes” que se esté calculando en una GPU adyacente conectada a través del sistema NVQLINK > > ChatGPT no entendió que NVLINK no es NVQLINK.
Indicación: ¿Puedes dibujar una imagen estilo caricatura de un sistema NVQLINK que interconecte un “Modelo de Qubit Grande” conectado a una GPU adyacente? ChatGPT aún no comprende que NVQLINK no es un “cable”, sino un marco de trabajo a nivel de sistema que permite componer kernels que se ejecutan en múltiples dispositivos heterogéneos. Y que, por ahora, se espera que el cable sea RDMA (porque es un estándar), pero que bien podría ser NVLink dentro de 5 años.
References
DrawIO diagrams used in this memo: