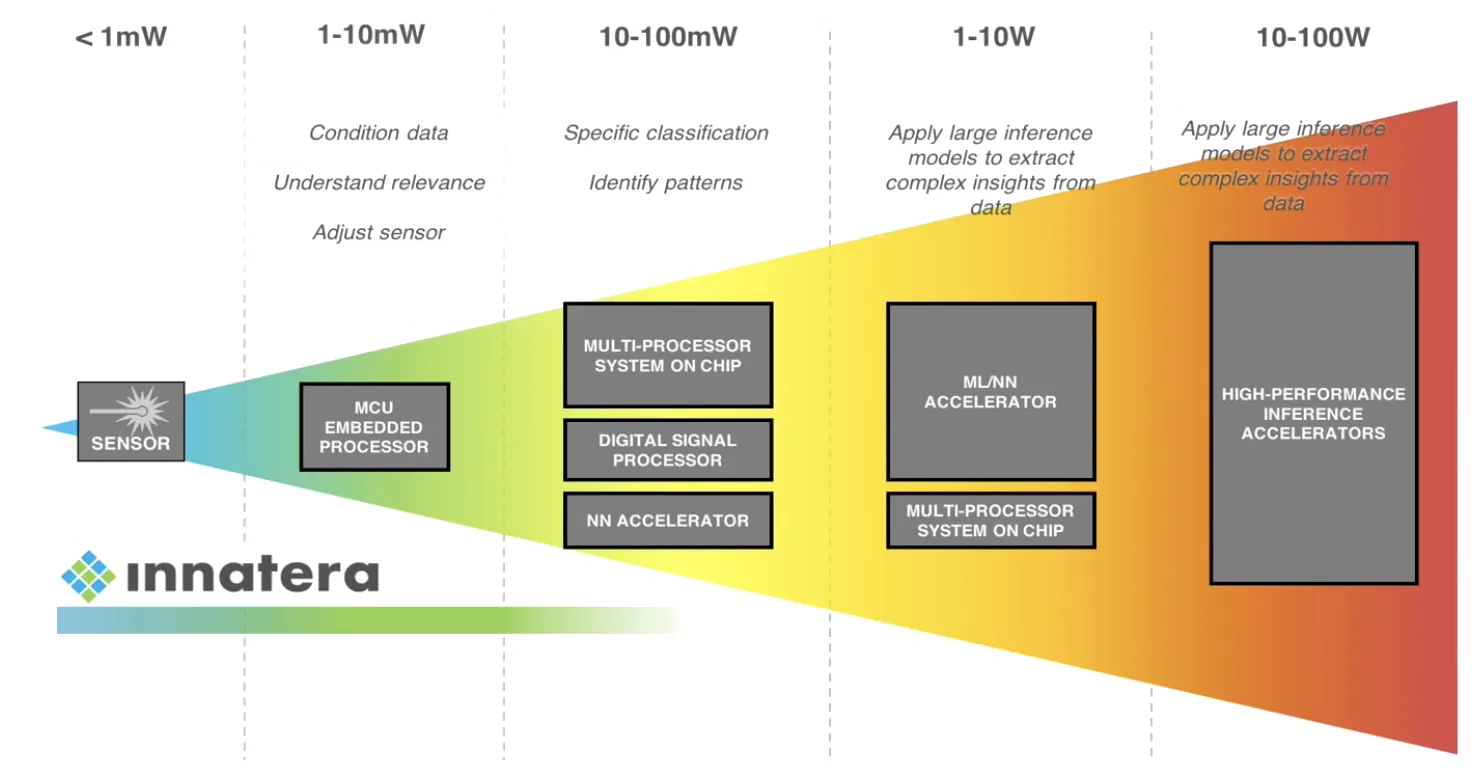
Recientemente escuché sobre las Unidades de Procesamiento Neuromórfico, o NPU, mientras hablaba de Neuralink.
 Estas NPU no tienen nada que ver con la computación cuántica, pero pensé que sería interesante dedicar un tiempo a inspirarme con una nueva arquitectura de procesamiento. Y, de hecho, uno de los principales proveedores de circuitos integrados en este campo es una empresa holandesa llamada Innatera. El último circuito integrado de Innatera, Pulsar, se basa en redes neuronales de impulsos de bajo consumo (ver la imagen de la derecha).
En este memorándum, intentaré descifrar, mediante ingeniería inversa, la mayor cantidad de información posible sobre cómo están diseñados esos circuitos integrados neuromórficos, cómo están diseñadas las redes neuronales de impulsos y qué pila de software está disponible para programar esos dispositivos.
Este es un intento de redibujar el diagrama de arquitectura para el circuito integrado Pulsar (imagen original [https://www.embedded.com/innatera-pulsar-brings-brain-intelligence-to-the-edge/), complementado con información del documento técnico):
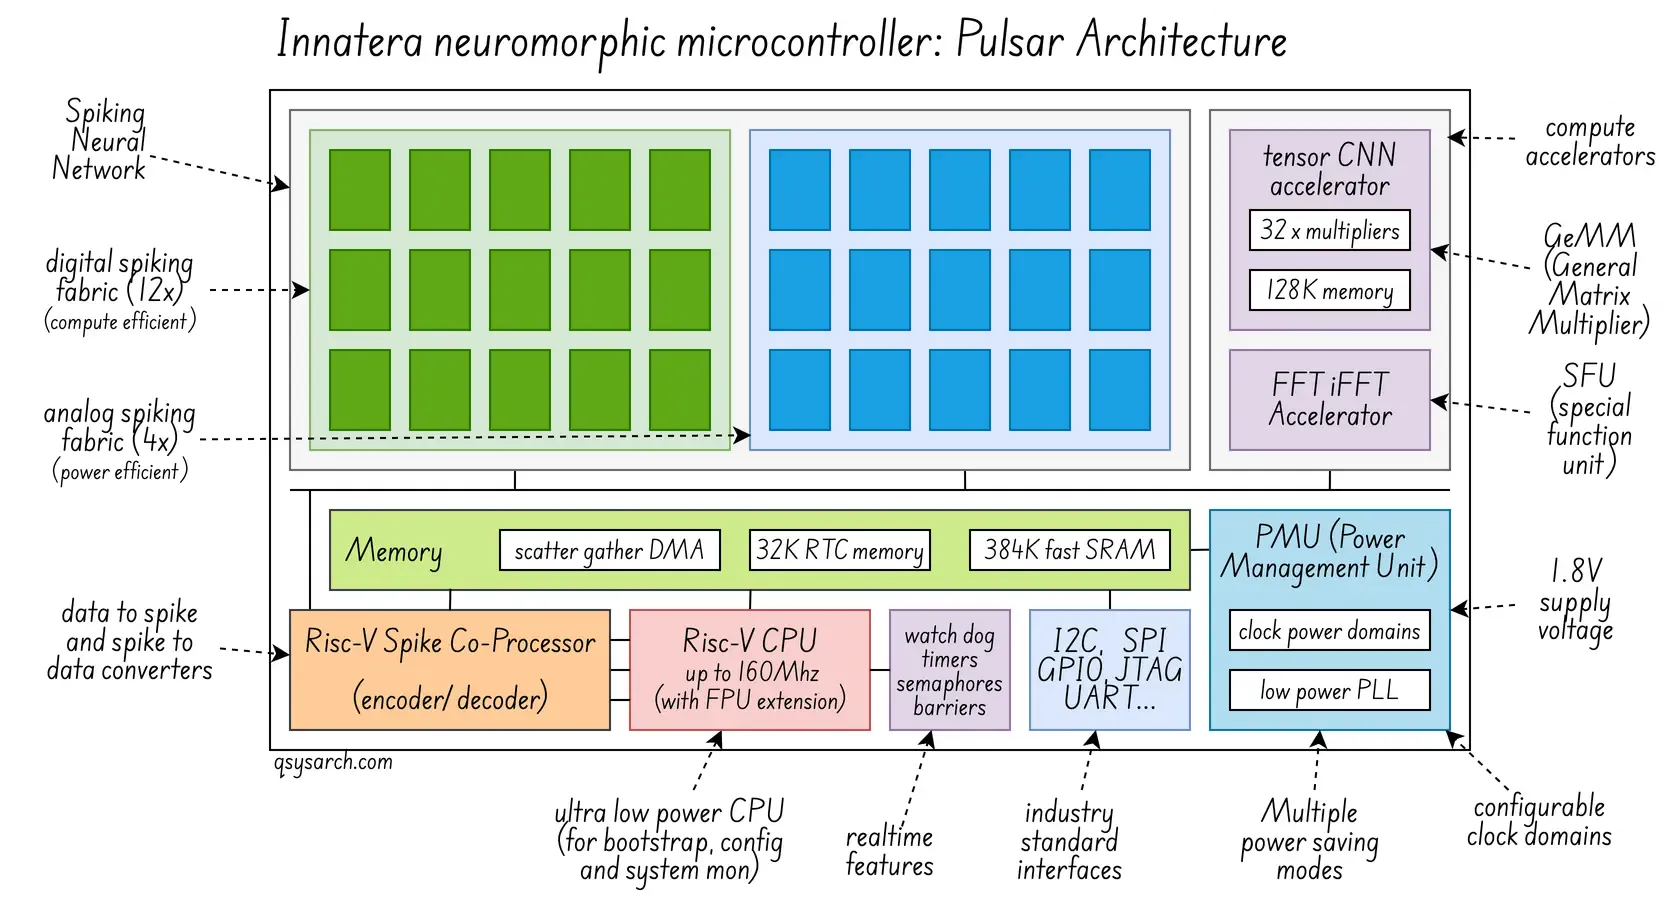
Me gusta la idea de usar una CPU RISC-V; es una clara señal de que el equipo de Innatera está tomando la decisión correcta en cuanto a la arquitectura desde el principio. En uno de los diagramas del chip T1 anterior de Innatera, la CPU RISC-V viene con una extensión F (compatibilidad con cálculos de punto flotante).
El CI integra muchas interfaces estándar (SPI, I2C, …) y una unidad de gestión de energía (PMU) que enciende y apaga partes del CI al entrar en modo de suspensión o ahorro de energía. Desafortunadamente, no pude encontrar datos sobre el consumo real de energía, excepto el de un paquete de bolas de menos de 1 mW. Suponiendo una tensión de alimentación de 1,8 V, esto sería menos de 500 µA (I=W/V). También me pregunto si la métrica de potencia por ciclo es relevante: en este caso, suponiendo una frecuencia de 100 Hz (periodo de actualización sináptica), esto significaría 5 µA por actualización sináptica en promedio.
El diagrama más reciente de Pulsar muestra dos aceleradores: una CNN y una FFT. Creo que podrían describirse de forma más general como un GEMM (multiplicador de matrices general, clave para el cálculo de redes neuronales) y una SFU (unidad de función especial, utilizada para acelerar el cálculo de la FFT). Consulta la publicación [/posts/cuda-compiler-architecture/] sobre la arquitectura de la GPU para obtener más información. También hay un codificador-decodificador de picos, que parece haber sido desarrollado como un coprocesador para RISC-V, pero no pude encontrar muchos más detalles.
Arquitectura de red neuronal de impulsos
Link to heading
La pregunta que queda es sobre la red neuronal de impulsos, o SNN: ¿Cómo funciona?
Le pedí a Gemini que me diera una metáfora para un niño de 8 años sobre redes neuronales de picos. Esta es la historia que me dieron:
Imagina el cerebro como una gigantesca oficina de correos, y las “neuronas” como los pequeños mensajeros que llevan las notas.
- Mensajeros y notas:
En un programa informático normal, cada mensajero está constantemente hablando y gritando números de un lado a otro. En cambio, en una red neuronal de impulsos, los mensajeros son muy silenciosos y eficientes en el consumo de energía: solo envían un breve mensaje de “¡Oye!” cuando sucede algo importante, como un pequeño pico eléctrico.
- El medidor de chispas:
Cada mensajero tiene un medidor que se llena cuando escucha “¡Oye!” de otros: cuando el medidor se llena lo suficiente (alcanza el umbral), ese mensajero también se emociona y grita “¡Oye!”. Justo después de gritar, reinicia su medidor, por lo que no puede volver a gritar inmediatamente (el período refractario).
- El momento oportuno lo es todo:
Si un mensajero escucha muchos “¡Hey!” rápidamente, significa que el mensaje es importantísimo (como “¡Fuego!”). Si un mensajero grita “¡Hey!” un poco antes que los demás, podría ser una señal secreta de que algo especial está sucediendo (como “¡Tigre acercándose!”). Por lo tanto, los mensajeros deben estar atentos al tiempo.
- El aprendizaje es la clave:
Los mensajeros aprenden igual que tú: si el Mensajero A grita “¡Eh!” justo antes de que el Mensajero B grite “¡Eh!” (porque algo los emocionó a ambos), su amistad se fortalece y el mensaje del Mensajero A ayuda al Mensajero B a llenar su medidor más rápido la próxima vez.
Las redes neuronales de pulsos (SNN) son especiales porque están diseñadas para ser increíblemente rápidas y eficientes. No malgastan energía comunicándose constantemente; ¡solo se activan cuando reciben un pico de información para compartir! Ayudan a las computadoras a comprender la sincronización, reconocer patrones y consumen muy poca energía.
El verdadero diseño bajo el capó
Link to heading
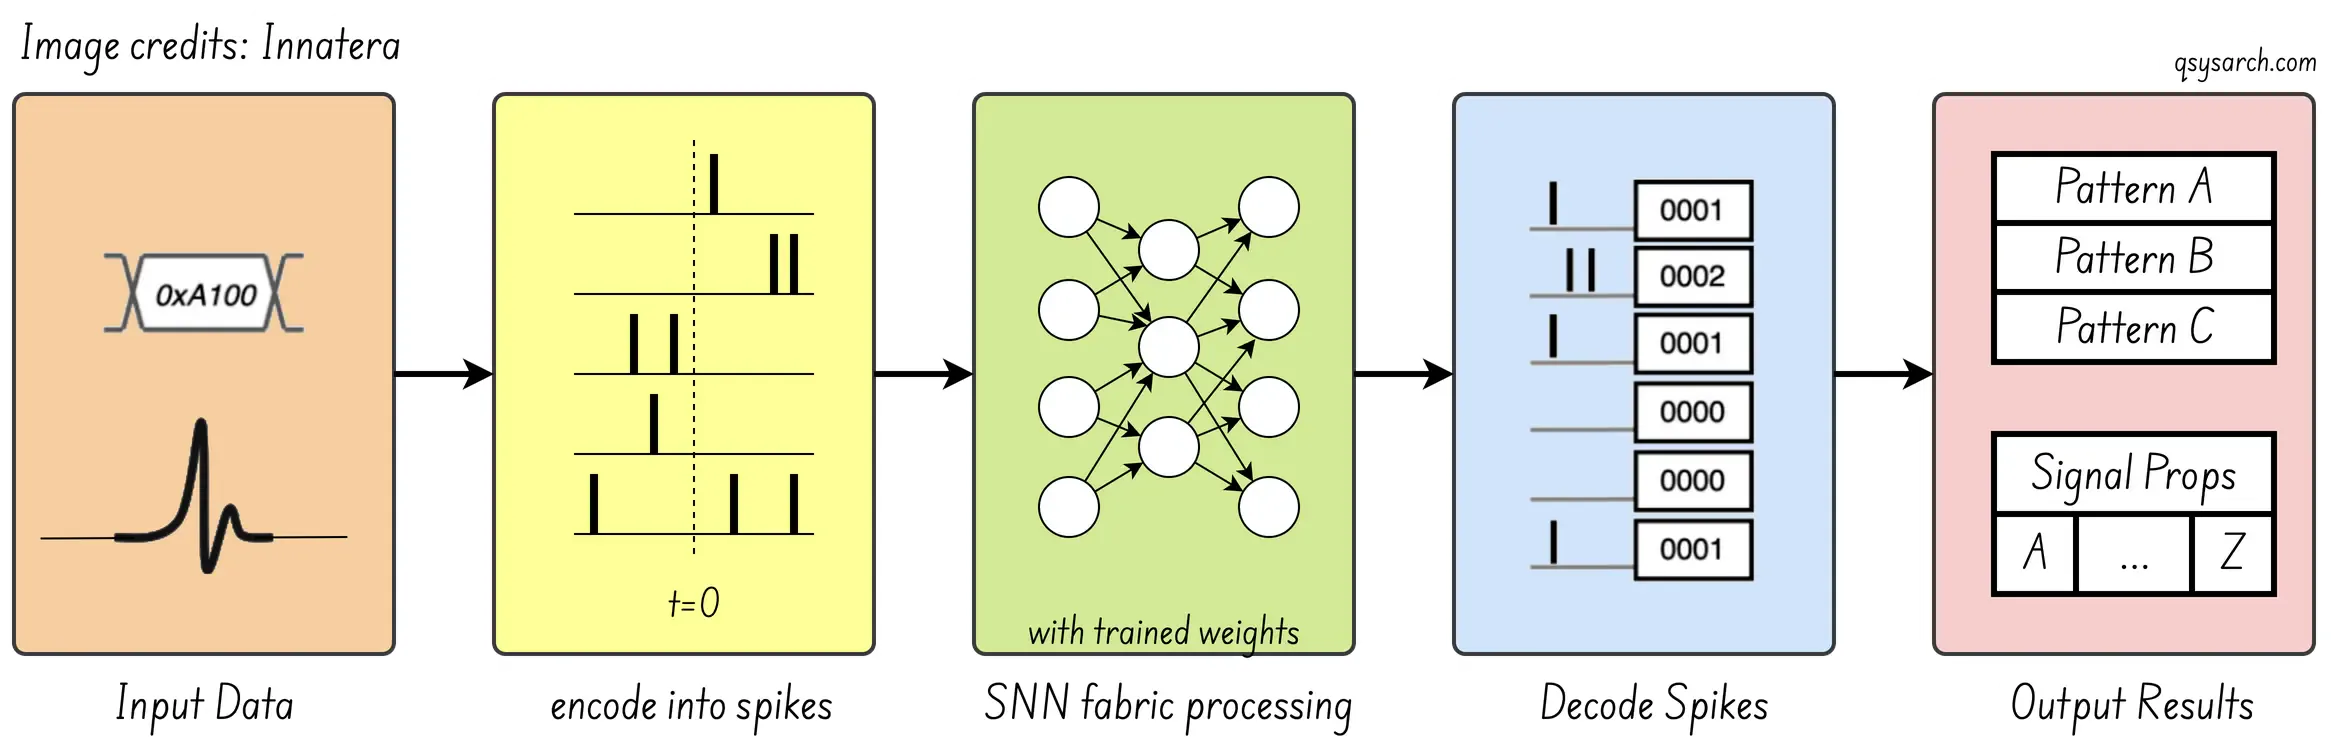
El blog Thinking in Pulses de Innatera ofrece una buena visión general de cómo se implementaría esto en hardware. Se codifican los “heys” en valores binarios, se procesan mediante una red neuronal y se extraen las características. Hasta ahora, nada especial; se trata de un proceso estándar de redes neuronales.
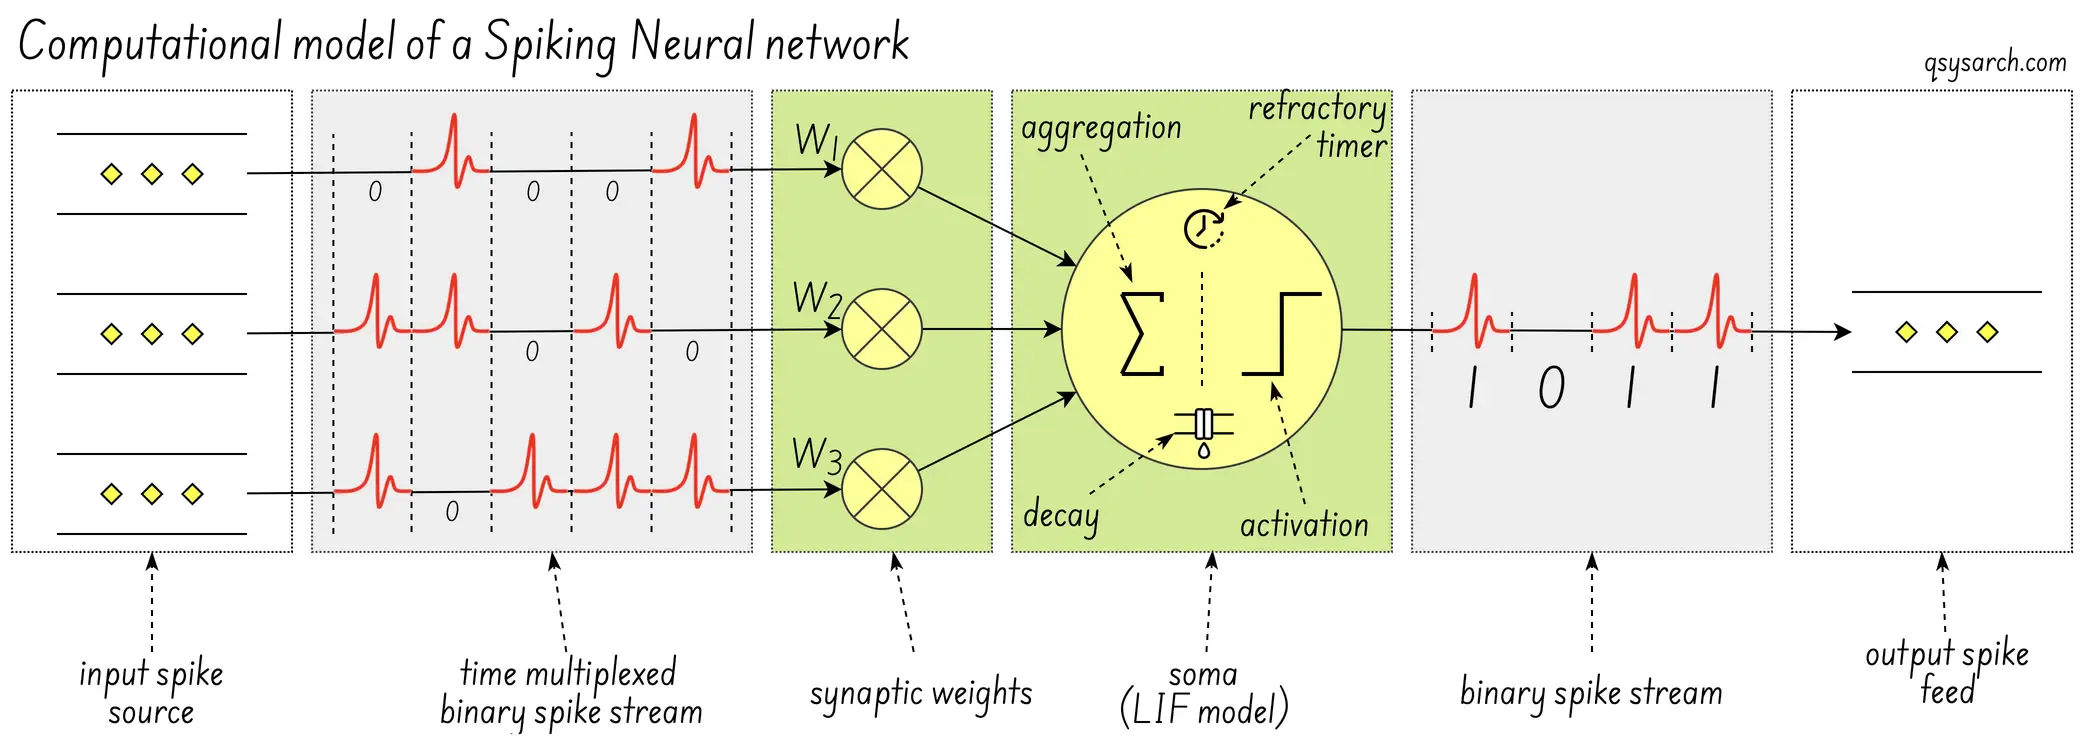
La pregunta más interesante es cómo se implementa esta SNN. La imagen de abajo parece ser un “modelo computacional” convencional de la neurona digital (imagen fuente), donde he añadido la noción explícita de “integración y disparo con fugas” (LIF) dentro del SOMA.
¿Qué hace que la implementación del hardware sea de bajo consumo?
Link to heading
Por completar: se necesitan explicaciones para
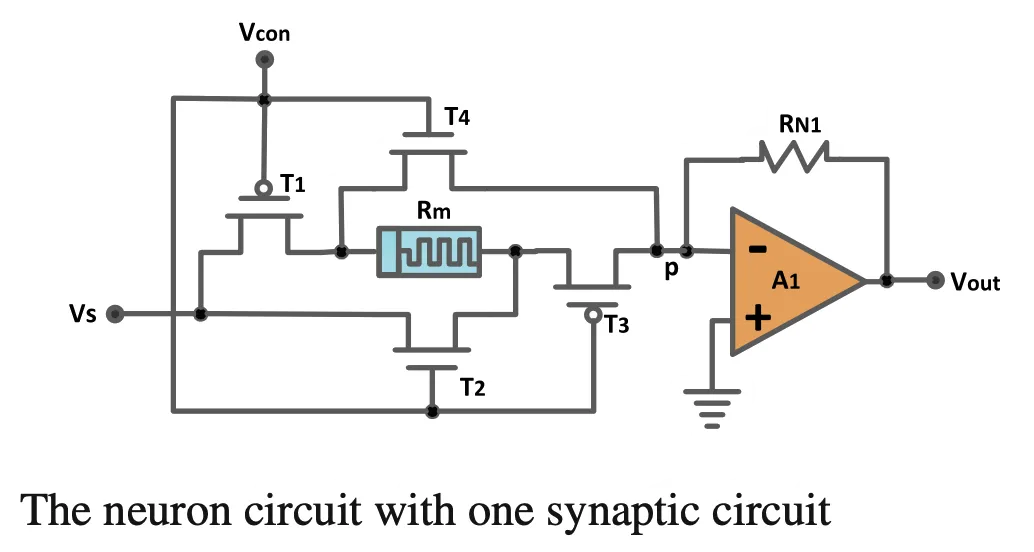
¿La mejora en el rendimiento (10x, 1000x o más)?
las latencias de propagación de la red neuronal alcanzables
las ventajas y desventajas
Rendimiento del diseño analógico frente al digital.
Consumo de energía relativo a las GPU/TPU
Una pregunta que surge del diseño de Pulsar es: ¿por qué hay dos redes neuronales de pulsos (SNN)? La respuesta es que la arquitectura SNN analógica (de señal mixta analógica patentada) de Innatera está optimizada para lograr la máxima eficiencia energética y un procesamiento de eventos ultrarrápido y de muy bajo consumo. Por otro lado, la arquitectura SNN digital es un diseño más programable y flexible que admite redes más configurables con un consumo de energía ligeramente superior. (Fuente)
En el sitio web de Innatera no hay mucha información sobre la arquitectura interna de su red neuronal de impulsos, pero afortunadamente, tienen algunas patentes que podemos intentar aplicar ingeniería inversa.
| Fecha de presentación | Número de publicación | Título (abreviado) |
| 9 de febrero de 2021 | US20220230051A1 | Red neuronal de impulsos |
| 09/12/2021 | EP4505212A1 | Método para el preprocesamiento eficiente de radares |
| 26/01/2022 | EP4323923B1 | Red neuronal de picos multisegmento reconfigurable jerárquica |
| 14/02/2022 | EP4238006A2 | Estructura computacional sináptica multicomponente distribuida |
| 22-03-2022 | EP4226281B8 | Adaptación de las redes neuronales de estado estable mediante sincronía transitoria |
| 8 de abril de 2022 | EP4548260A1 | Calibración de redes neuronales de impulsos |
| 3 de junio de 2022 | EP4562540A | Sistema y método para codificadores analógicos a de impulsos eficientes centrados en características. |
| 24/06/2022 | EP4573485A1 | Máquina neuronal secuencial para inferencia optimizada de memoria |
| 8 de septiembre de 2022 | WO2024038102A1 | Sistema y método para computación neurosináptica modular reconfigurable… |
| 18/10/2022 | WO2024153705A1 | Sistema de señal mixta sintetizable, escalable tecnológicamente y con alimentación directa y sincronización automática… |
| 18/05/2023 | WO2024175770A1 | Módulos y métodos de procesamiento de audio neuromórfico siempre activos |
| 24/05/2023 | WO2024175767A1 | Sistema y método para el mapeo de redes neuronales de impulsos en superficies neuromórficas… |
| 19/06/2023 | WO2025012331A1 | Método para entrenar modelos de aprendizaje automático para sustratos estocásticos |
| 22-06-2023 | WO2025017094A1 | Método para construir e implementar redes neuronales de impulsos en dispositivos de hardware. |
| 23-10-2023 | WO2025021573A1 | Sistema y método para la detección de ocupación mediante un sensor basado en marcos. |
| 6 de diciembre de 2023 | WO2025062034A1 | Extracción de características y codificación de redes neuronales de picos mediante redes neuronales convolucionales. |
| 8 de marzo de 2024 | WO2023242374A1 | Interconexión de picos en multidifusión de paquete único en chip |
¡Son muchísimas patentes para una startup! Para ahorrar tiempo, solo he analizado la primera y la última patente de esta lista.
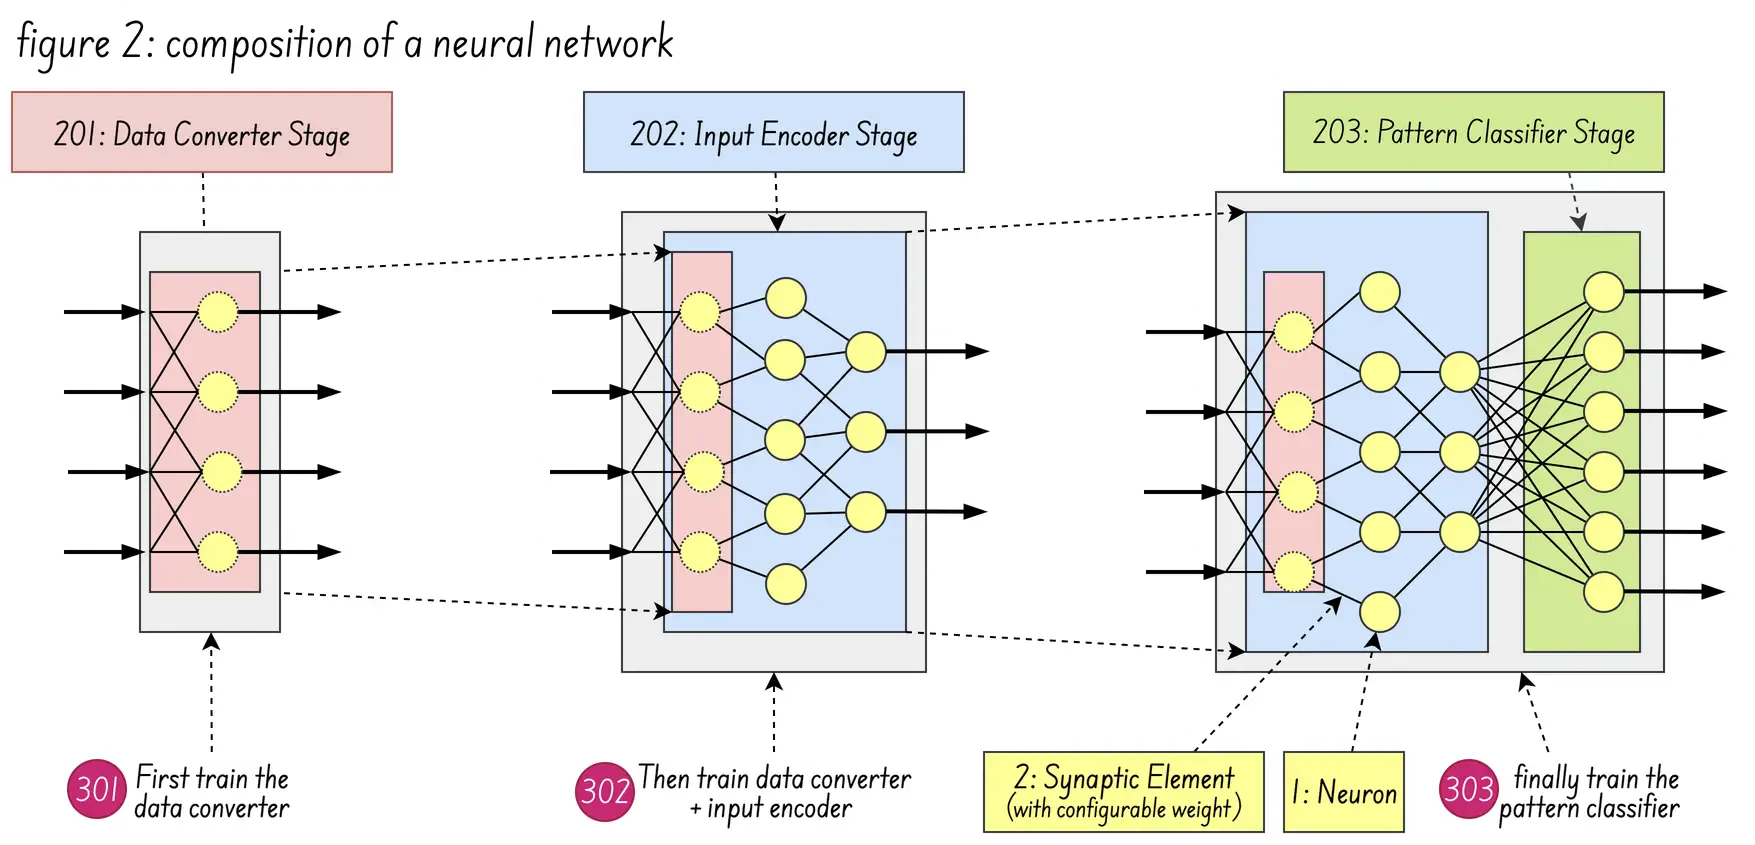
Comencemos con la primera patente US20220230051A1, que parece ser la que más se acerca a describir la implementación de hardware real de la SNN: La patente se centra en una metodología compositiva para construir SNN a partir de subredes especializadas y preentrenadas (“celdas”) utilizando un principio de “respuesta única”.
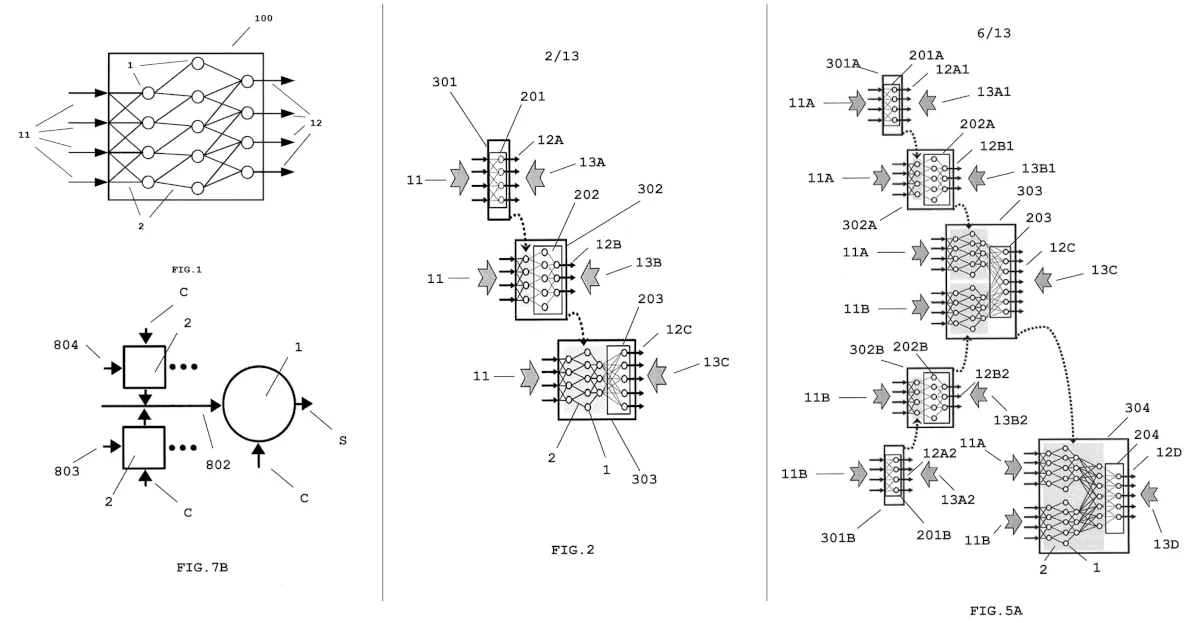
La figura 2 (abajo) muestra la composición de una red neuronal formada por la integración de una etapa convertidora de datos 201, una etapa codificadora de entrada 202 y una etapa clasificadora de patrones 203. En cuanto a la figura 5B (arriba), muestra cómo múltiples trenes de impulsos temporales se fusionan en un único tren de impulsos fusionado.
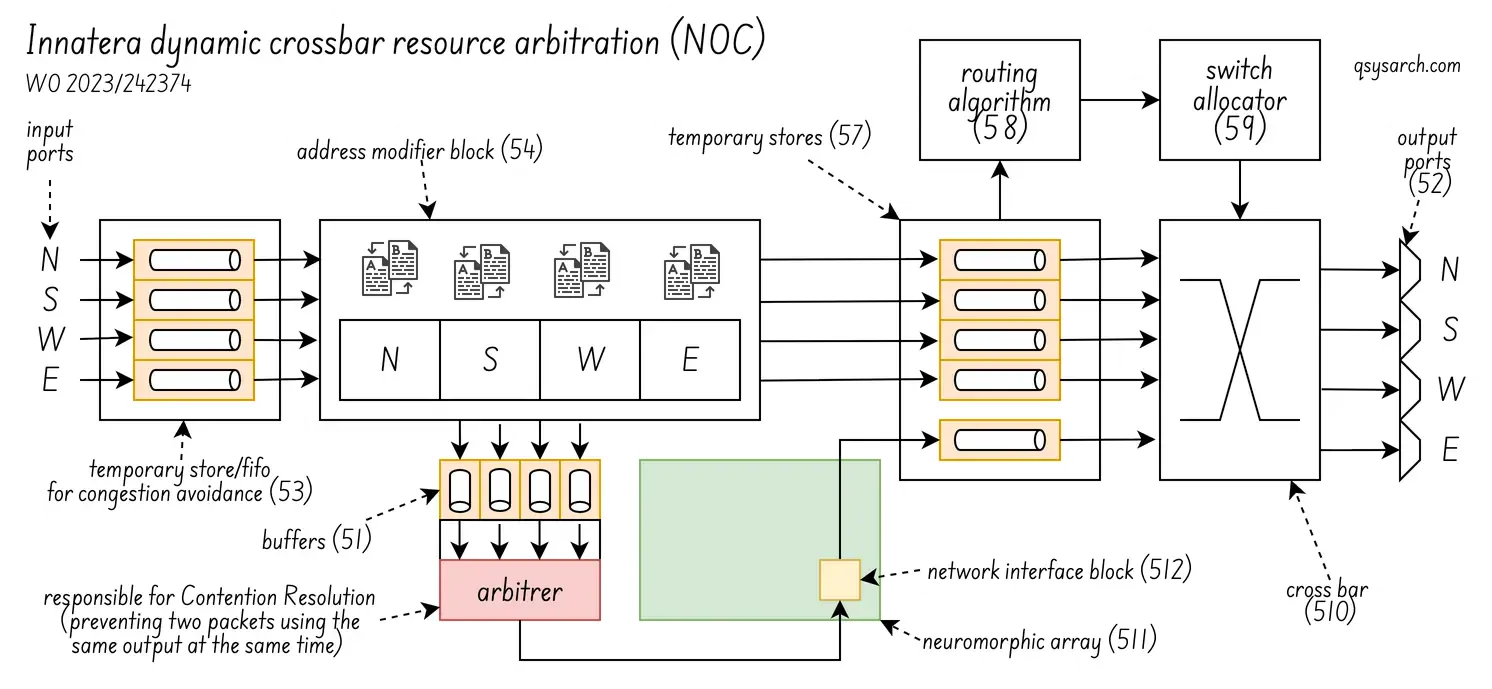
En cuanto a la última patente WO2023242374A1, describe la arquitectura de red neuronal de picos de Innatera, utilizada para implementar de forma eficiente la multidifusión de paquetes individuales mediante redes en chip. El objetivo es reducir la duplicación, la latencia y la sobrecarga en sistemas multinúcleo para la comunicación multidifusión.
El diagrama que aparece a continuación (figura 5 de la patente) muestra cómo funciona la arbitraje NOC. La idea es evitar que dos o más impulsos se envíen simultáneamente al mismo puerto de salida. Esta es una forma eficiente de enrutar los impulsos en cada ciclo. Sin embargo, me pregunto qué tan profundas son las FIFOs en el hardware real.
Lo que no me queda claro es cómo encajan el núcleo y la red neuronal: ¿Cuántas neuronas hay en un núcleo? ¿Están los núcleos interconectados o trabajan juntos? ¿O son unidades independientes que pueden procesar clasificaciones independientes en paralelo?
Otros diseños de núcleos neuronales
Link to heading
No tengo la respuesta sobre la arquitectura central exacta de Innera, pero existen numerosos artículos de investigación que ofrecen más detalles sobre las posibles implementaciones. El artículo «una perspectiva de diseño de sistemas sobre procesadores informáticos neuromórficos » resulta particularmente interesante, ya que compara varias arquitecturas.
Una de esas arquitecturas es el “sistema neuromórfico reconfigurable y muy eficiente”, o RAVENS, que se muestra en el siguiente diagrama:
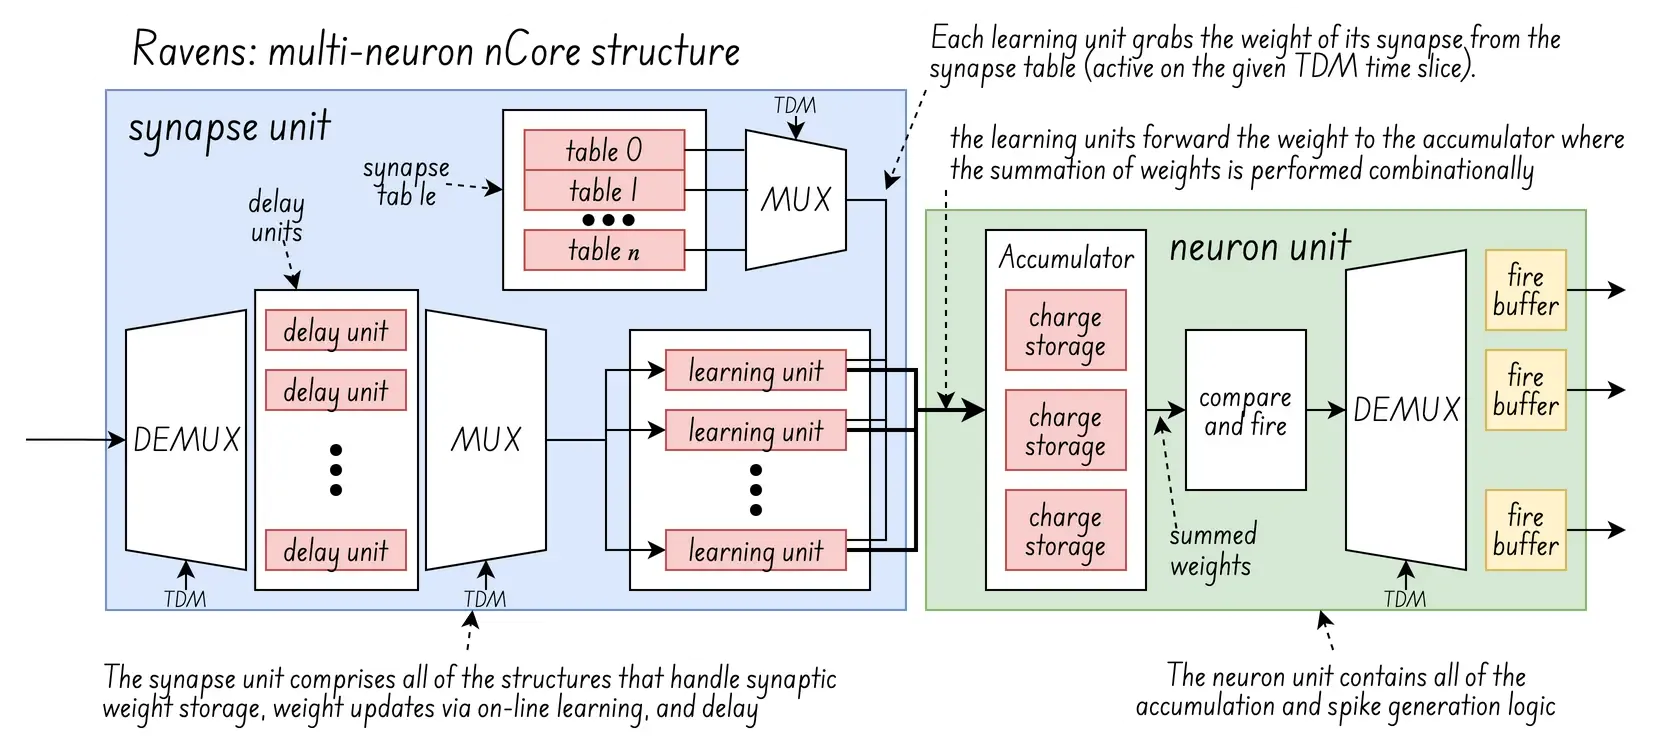 (diagrama actualizado a partir de la imagen original: )
La idea detrás de RAVENS es conectar varias “neuronas virtuales” mediante multiplexación por división de tiempo (TDM), en un proceso de dos etapas que consiste en acumulación y actualización.
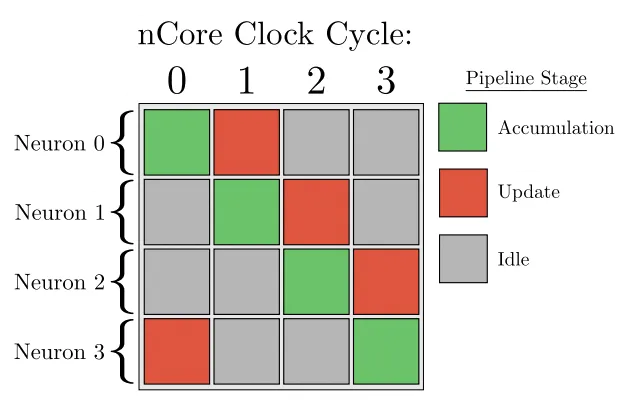
Etapa de acumulación: una neurona acumula carga de las sinapsis de entrada conectadas a ella y determina si debe ocurrir un evento de disparo o no, basándose en su umbral programado y su estado refractario.
Etapa de actualización: incluye cambios de aprendizaje en línea en los pesos sinápticos, fugas de carga, incrementos en los contadores refractarios, cambios de carga acumulada debido a la transición fuera de un período refractario.
Lo interesante aquí es el aprendizaje en línea: en los IC neuromórficos, el aprendizaje en línea cambia los pesos sinápticos usando algoritmos como el aprendizaje hebbiano o el aprendizaje por refuerzo para ajustar la fuerza sináptica en tiempo real basándose en la entrada de neuronas pre y postsinápticas.
En el caso de los núcleos analógicos, este ajuste se implementa físicamente mediante dispositivos como memristores o uniones túnel magnéticas (MTJ), cuya resistencia o conductancia se modula por la actividad neuronal, representando y almacenando directamente los pesos sinápticos. En el caso de los núcleos digitales, se realiza a través de las tablas de sinapsis, al menos en RAVENS.
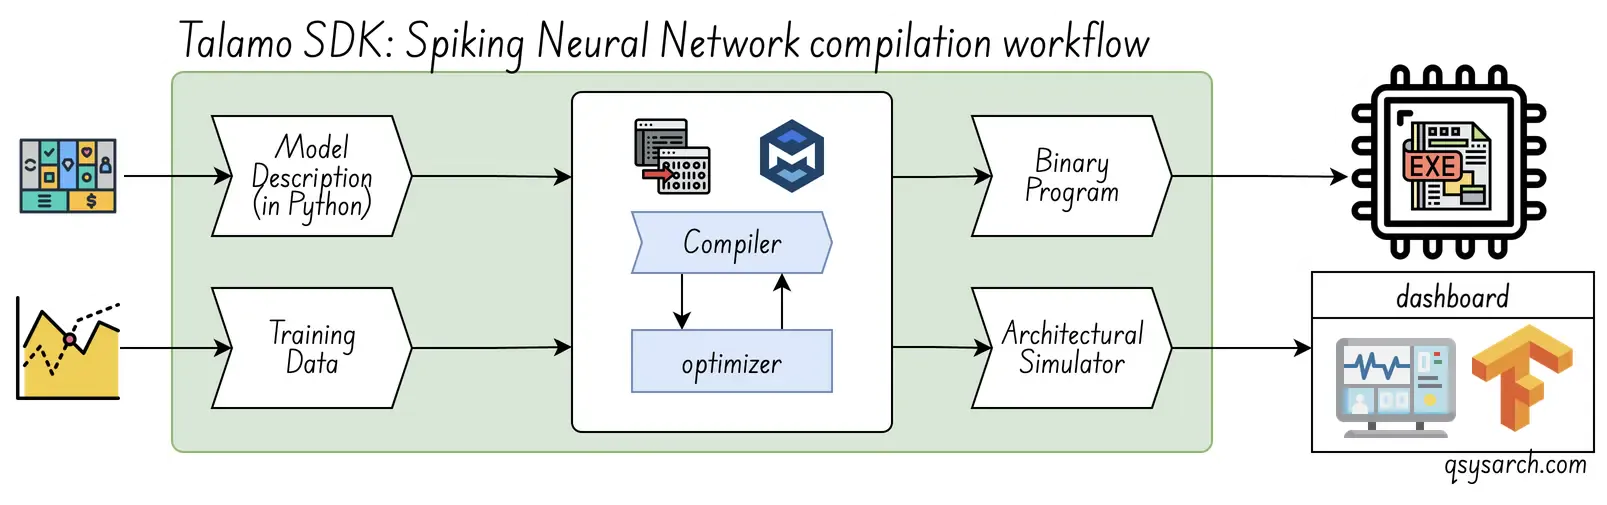
La oferta de Innatera incluye un SDK Talamo integrado, que no requiere experiencia en redes neuronales de picos (SNN), admite aplicaciones de extremo a extremo y utiliza un flujo de trabajo estándar de aprendizaje profundo. El kit Talamo ayuda a los desarrolladores a crear modelos de picos neuronales desde cero en un entorno basado en PyTorch. Es un kit completo.
El flujo de trabajo de compilación es muy estándar. El diagrama a continuación es una versión ligeramente actualizada del material original de Innatera, asumiendo que el compilador es la parte central del flujo de trabajo. También me pregunto si el simulador toma el ejecutable binario como entrada, en cuyo caso se denominaría emulador. Sería muy útil obtener más información sobre el proceso de optimización y si existen parámetros que el usuario pueda modificar (como reducir los pesos a 1,58 bits).
Una vez generado el programa binario, se utiliza este flujo de trabajo de ejecución, que sigue más o menos el proceso definido en la patente WO2023242374A1.
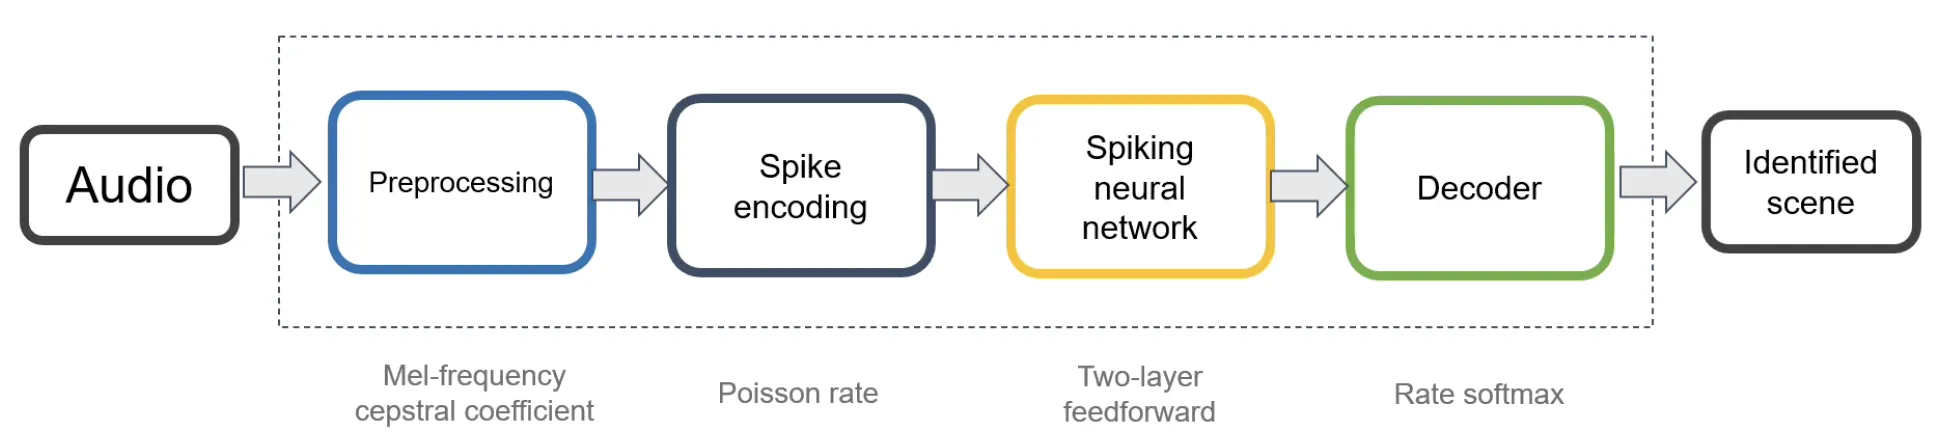
El hardware de Innatera incluye un potente procesador RISC-V, un módulo GEM de alto rendimiento y un acelerador de cómputo SFU. Algunos usuarios avanzados podrían encontrar más atractivo tener acceso directo al hardware, en comparación con simplemente cargar los pesos en una biblioteca C compatible con la arquitectura de Innatera.
Quizás sería beneficioso ofrecer algún tipo de SDK de firmware de código abierto. Como alternativa, se podría considerar CudaNN, que ofrecería una experiencia de Unidad de Procesamiento Neuronal de Propósito General (GPNPU), al igual que existe Cuda-Q para la industria cuántica. ¿Y también un NVNLink, similar a NVQLink, que permitiría redes NPU a gran escala y arquitecturas híbridas?
Quizás a esto se refiere el camino hacia el éxito comercial de las tecnologías neuromórficas : «no fue hasta la llegada de modelos y herramientas de programación sencillos, junto con un acceso API directo al hardware, que los procesadores tensoriales alcanzaron una adopción generalizada». ¿Basta con sustituir procesadores tensoriales por unidades de procesamiento neuromórfico (NPU)?
Para mí, todo se reduce a la experiencia del usuario (UX) y la experiencia del desarrollador (DX). Y estoy convencido de que la facilidad de uso y la experiencia del desarrollador son factores clave, o pilares estratégicos, para crear experiencias de producto verdaderamente excepcionales.
 (Créditos de la imagen: archi monarch)
Con esto concluimos este breve informe sobre la arquitectura general de los circuitos integrados neuromórficos. Sin duda, esta arquitectura de hardware es una tecnología alternativa y potente con un gran potencial. Sin embargo, se podría argumentar que los circuitos integrados neuromórficos carecen de una aplicación revolucionaria. Pero, ¿acaso no es precisamente ahí lo más emocionante de los circuitos integrados neuromórficos? ¿Significa eso que hay que crear todo un mundo nuevo para ellos?
Creo firmemente que el equipo de Innetera se encuentra entre aquellos que tienen una visión diferente del mundo. Y ante la preocupación por el consumo energético desmesurado de los centros de datos de IA, ¿acaso los circuitos integrados neuromórficos no representan una respuesta a la pregunta fundamental: cómo obtener mayor valor con menor consumo de energía? Si esto es así, ¿qué se necesita para escalar los circuitos integrados neuromórficos hasta alcanzar la capacidad de procesamiento necesaria para los centros de datos de IA?
Además, me pregunto si añadir un poco de silicio fotónico a la SNN sería de alguna ayuda. Podría ser útil tanto para la computación neuronal como para crear una red de interconexión a gran escala entre los circuitos integrados de la SNN.
Diagramas de DrawIO utilizados en este memorándum: