
Este memorándum tiene como objetivo comprender el funcionamiento interno de RDMA, y especialmente lo que se necesita para crear una “NIC compatible con RDMA” que se interconecte con un subsistema PCIe, como el connectX-7 de 200 Gb integrado con el DGX Spark (imagen de la derecha).
RDMA como protocolo “cliente-servidor”
Link to heading
Comencemos este memorándum con una descripción general de RDMA como protocolo.
Al configurar los canales de datos RDMA, los búferes de memoria deben registrarse en la tarjeta de red antes de poder utilizarlos. El proceso de registro consta de los siguientes pasos:
Fije la memoria para que el sistema operativo no pueda intercambiarla.
Almacene la información de traducción de direcciones en la NIC.
Establecer permisos para la región de memoria.
Crea claves remotas y locales, utilizadas por la NIC al ejecutar los verbos RDMA.
La comunicación RDMA se basa en un conjunto de tres colas.
SQ: Cola de envío
RQ: Cola de recepción
CQ: Cola de finalización
El par de colas RDMA, o QP, se refiere a la cola de envío + la cola de recepción.
Elementos de la cola de trabajo RDMA
Link to heading
Las aplicaciones emiten un trabajo mediante una solicitud de trabajo, también conocida como elemento de cola de trabajo (WQE). Una solicitud de trabajo es una pequeña estructura con un puntero a un búfer:
En una cola de envío, es un puntero a un mensaje que se va a enviar.
En una cola de recepción, indica dónde debe colocarse un mensaje entrante.
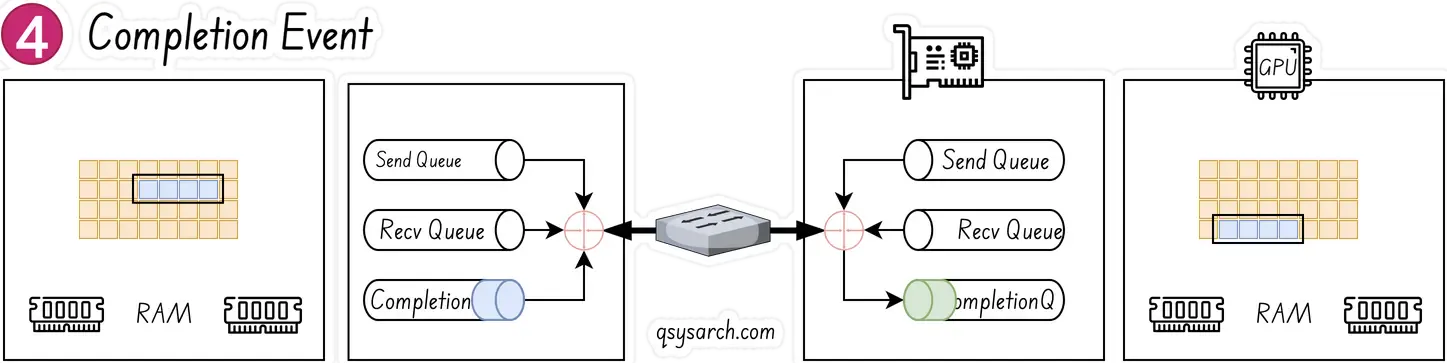
Una vez que se ha completado una solicitud de trabajo, el adaptador crea un elemento de cola de finalización y lo agrega a la cola de finalización.
Ejemplo sencillo de escritura RDMA
Link to heading
Las entidades emisora (izquierda) y receptora (derecha) han creado sus pares de colas y colas de finalización, y han registrado regiones en la memoria para que se realice la transferencia RDMA. La entidad emisora identifica un búfer que desea transferir a la entidad receptora. La entidad receptora dispone de un búfer vacío para almacenar los datos.
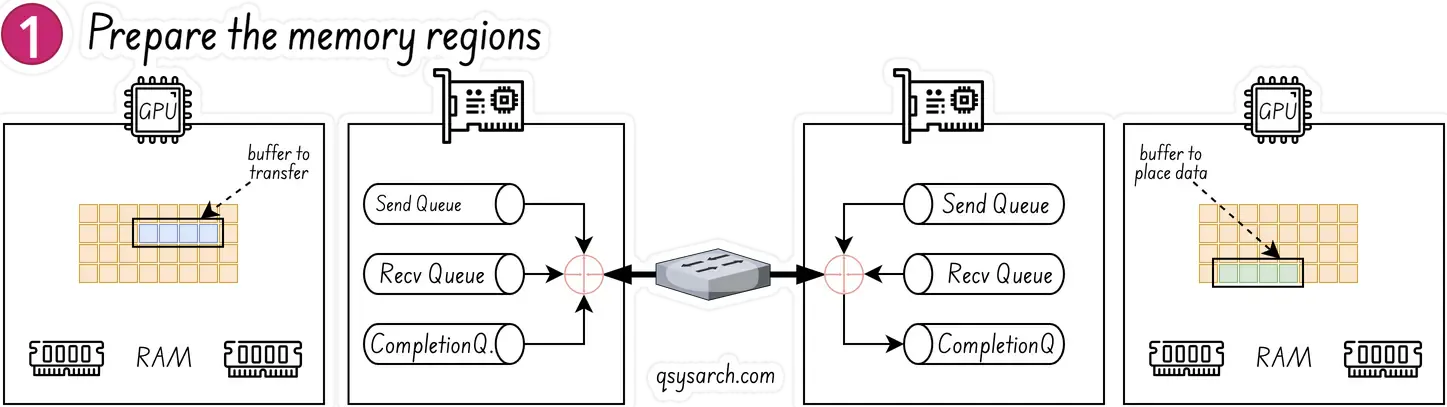
La entidad receptora de la derecha crea un elemento de cola de trabajo (WQE) WOOKIE y lo coloca en la cola de recepción. Este WQE contiene un puntero al búfer de memoria donde se almacenarán los datos. La entidad emisora de la izquierda también crea un WQE que apunta al búfer en su memoria que se transmitirá.
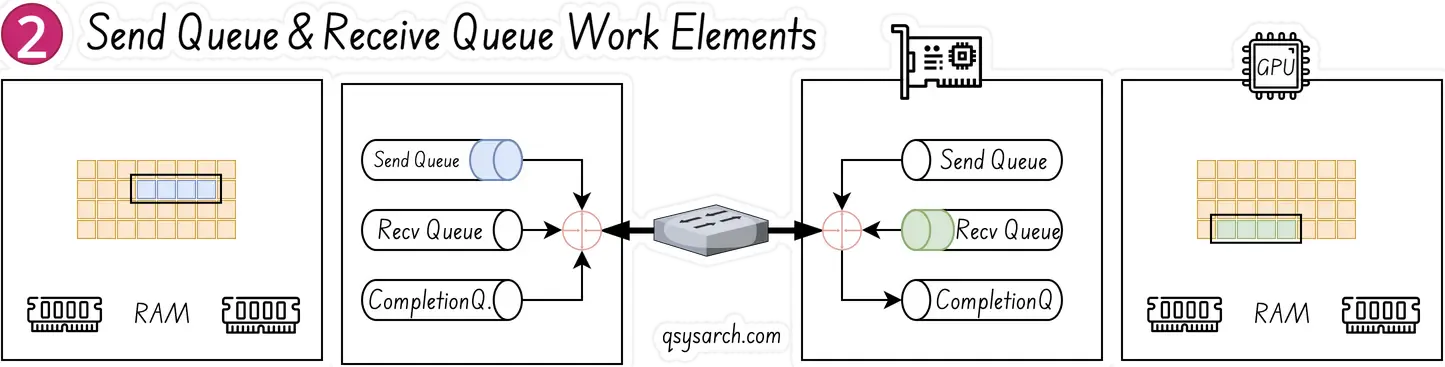
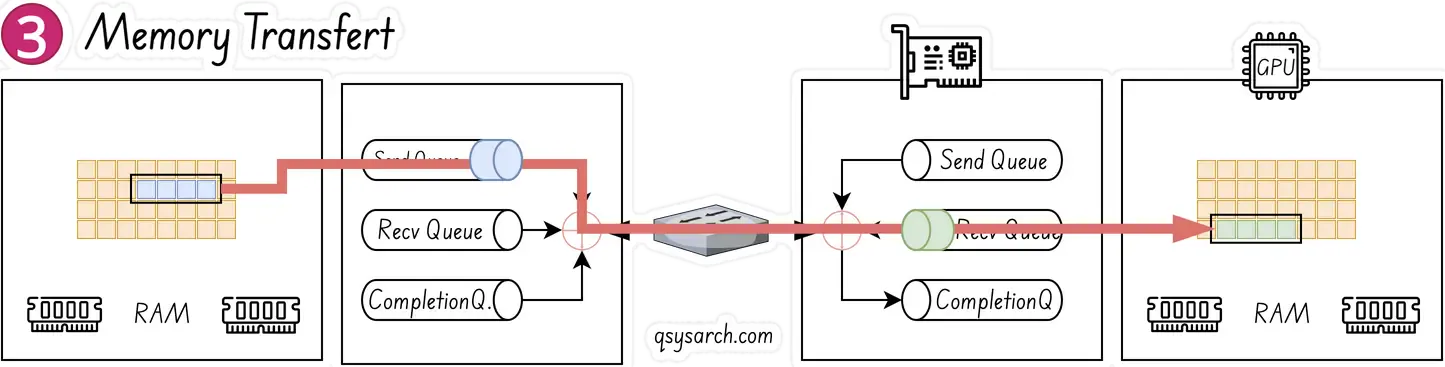
La NIC (entendida como la NIC de hardware compatible con RDMA, también conocida como RNIC) realiza sondeos constantes en busca de WQE en la cola de envío. Esto se realiza sin la intervención de la GPU ni la CPU, ya que el sondeo solo afecta a la RNIC. Una vez que la CPU envía un WQE, la RNIC lo consume en la entidad emisora y comienza a transmitir los datos desde la región de memoria a la entidad receptora. Cuando los datos comienzan a llegar a la entidad receptora, la RNIC consume el WQE en la cola de recepción para determinar dónde debe colocar los datos.
Como último paso, una vez completada la transferencia de datos, el RNIC crea un evento de finalización CQE “COOKIE”, que se coloca en la cola de finalización. Este evento indica que la transacción ha finalizado. Por cada WQE consumido, se genera un CQE.
Créditos de la imagen
Es importante tener en cuenta que solo el emisor está activo; el receptor es pasivo; el lado pasivo no realiza ninguna operación, no utiliza ciclos de CPU y no recibe ninguna indicación de que se haya producido una “lectura” o una “escritura”.
Para emitir una lectura o escritura RDMA, la solicitud de trabajo debe incluir:
Esto significa que la parte activa debe obtener la dirección y la clave de la parte pasiva con antelación.
RDMA desde la perspectiva de los paquetes de red
Link to heading
Esta parte se basa en el excelente trabajo de Toni Pasanen en Network Times.
Establecimiento de sesión RDMA
Link to heading
La aplicación en el nodo de cómputo del cliente (también conocido como CCN) inicia el establecimiento de la conexión enviando un mensaje de solicitud de comunicación (REQ) a la aplicación en el nodo de cómputo del servidor (SCN).
El mensaje REQ incluye un medio para identificar la RNIC física y el puerto:
- Identificador de comunicación local (
LID) e identificador único global para el adaptador de canal (GUID de CA local). El GUID de CA local identifica la RNIC, mientras que el ID de comunicación local identifica el puerto en la NIC.
El mensaje REQ también contiene toda la metainformación sobre los pares de colas.
Número QP local (0x1234 5678)
Tipo de servicio QP (Conexión no confiable)
Número de secuencia de paquete inicial (PSN: 0x1882)
Valor de la clave de partición (0x8012)
tamaño de la carga útil (1024).
El mensaje REP confirma la recepción de los metadatos QP. Finalmente, el cliente envía un mensaje Ready to Use (RTU) para confirmar al servidor que la conexión QP se ha establecido. Una vez establecida la sesión, la aplicación en la CCN puede iniciar el proceso de escritura RDMA.

Terminología:
CCN: nodo de cómputo del cliente
SCN: nodo de cómputo del servidor
PD: Dominio de protección
L_Key, R_Key: teclas locales y remotas
QP: Par de colas (QP) = Cola de envío + Cola de recepción.
CQ: Cola de finalización
RC: Conexión confiable
UD: Datagrama no fiable
REQ: CCN envía ID local, número QP, P_Key y PSN.
Respuesta: SCN responde con IDs, información de QP y PSN.
RTU: Listo para usar: CCN confirma la conexión.
WR: Solicitud de trabajo
Mensaje de solicitud de trabajo RDMA
Link to heading
Se completará más adelante; no hay nada destacable sobre los mensajes WR que merezca la pena mencionar aquí. Si desea más detalles, consulte Network Times de Toni Pasanen y el Protocolo de transporte InfiniBand.
RDMA desde una perspectiva de transferencia de red
Link to heading
RDMA UC (Unreliable Connected) no realiza retransmisiones; en su lugar, depende de la aplicación para gestionar la fiabilidad y manejar los paquetes perdidos, ya que UC es un servicio de datagramas no fiable y sin conexión. La tarjeta de interfaz de red (NIC) descarta los paquetes sin intentar retransmitirlos, y la aplicación es responsable de rastrear y solicitar nuevamente los datos faltantes. Esto contrasta con los QP de conexión fiable (RC), donde el hardware de red gestiona las retransmisiones. Entonces, ¿cómo sabe una aplicación RDMA UC si se ha perdido un paquete?
- Detección de pérdida de paquetes a nivel de aplicación
Números de secuencia de paquetes (PSN): La aplicación asigna un número secuencial único a cada paquete que envía. El receptor realiza un seguimiento de estos números de secuencia. Una interrupción en los números de secuencia indica que se ha perdido uno o más paquetes.
Tiempos de espera: El protocolo de nivel de aplicación puede implementar un mecanismo de tiempo de espera. Si no se recibe una respuesta o una confirmación dentro de un período determinado, la aplicación asume que el paquete se perdió e inicia una retransmisión.
- Recuperación de pérdida de paquetes a nivel de aplicación

Si el receptor detecta la pérdida de un paquete en la secuencia, debe informar al remitente para que lo retransmita. Si el paquete utilizado para informar al remitente también se pierde, pueden surgir situaciones bastante complejas.
- Tiempo de espera: El remitente espera que el receptor confirme la recepción de los paquetes recibidos. Si no lo hace, el remitente reenvía proactivamente el paquete que aún no ha sido confirmado.
¿Siempre necesitamos implementar un módulo de confiabilidad independiente sobre RDMA QP? No necesariamente. En algunos casos, es aceptable considerar la pérdida de un paquete como motivo para marcar toda la sesión como fallida, en lugar de simplemente reenviar el paquete faltante. Este enfoque funciona porque la red subyacente suele ser lo suficientemente confiable como para proporcionar una confiabilidad extremadamente alta, como por ejemplo, un solo error por cada billón de paquetes.
Control de flujo prioritario (PFC) y notificación explícita de congestión (ECN)
Link to heading
RDMA UC no detecta automáticamente la pérdida de paquetes debido a su naturaleza poco fiable; por lo tanto, la pérdida de paquetes la gestiona la aplicación o una capa superior. La garantía de “transmisión sin pérdidas” en RDMA se logra mediante tecnologías de red subyacentes como el Control de Flujo Prioritario (PFC) y la Notificación Explícita de Congestión (ECN), que evitan la pérdida de paquetes desde el principio.
Este protocolo encapsula el segmento de datos RDMA dentro del segmento de datos UDP, agrega la cabecera UDP, luego la cabecera IP y, finalmente, la cabecera Ethernet, lo que da como resultado un paquete de datos de tres capas. Se puede clasificar utilizando el campo PCP en la VLAN Ethernet o el campo DSCP en la cabecera IP.
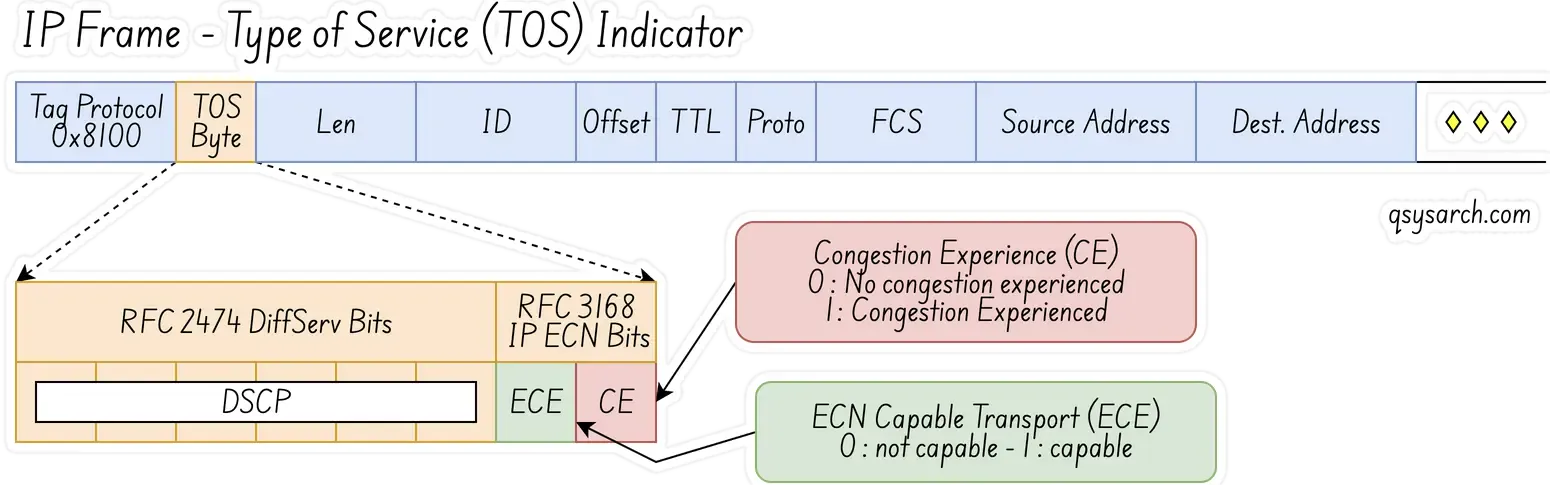
En términos sencillos, en una red de capa 2, PFC utiliza el bit PCP de la VLAN para distinguir los flujos de datos. En una red de capa 3, PFC puede usar tanto PCP como DSCP, de modo que los diferentes flujos de datos disfruten de un control de flujo independiente. Actualmente, la mayoría de los centros de datos utilizan redes de capa 3, por lo que usar DSCP resulta más ventajoso que PCP.
Créditos de la imagen
RDMA desde la perspectiva de PCIe
Link to heading
 El análisis de PCIe se basa en el excelente artículo: SmartIO: Zero-overhead Device Sharing through PCIe Networking de Dolphin.
Registros de direcciones base PCIe
Link to heading
La característica principal de PCIe es que los dispositivos se asignan al mismo espacio de direcciones que la CPU y la memoria del sistema, como se muestra en la figura de la derecha. Gracias a esta asignación, la CPU puede leer y escribir en la memoria del dispositivo del mismo modo que accede a la memoria del sistema. Esto se conoce comúnmente como E/S mapeada en memoria (MMIO).
Durante la inicialización, cuando el sistema verifica el árbol PCIe, se reserva un rango de direcciones de memoria (por parte de la BIOS o el kernel) para las regiones de memoria de cada dispositivo. Esta dirección reservada se escribe en los Registros de Dirección Base (BAR) del dispositivo. Un dispositivo puede tener hasta seis BAR.
PCIe utiliza interrupciones señalizadas por mensaje (MSI) en lugar de líneas de interrupción físicas. Los dispositivos compatibles con MSI envían una escritura de memoria a la CPU, utilizando una dirección y una carga útil específicas proporcionadas por el sistema. La CPU lee esta escritura de memoria y utiliza la información para generar una interrupción.
MSI-X es una extensión de MSI que permite hasta 2048 vectores de interrupción diferentes. Una ventaja es que una interrupción MSI-X puede dirigirse a un núcleo de CPU específico en sistemas multinúcleo. Además, los distintos vectores MSI-X pueden señalizar diferentes tipos de eventos.
Diseño optimizado de ConnectX-8
Link to heading
[1] Comunicación GPU a GPU a través de dos zócalos de CPU: En el diseño tradicional, esta ruta puede encontrar cuellos de botella en la CPU host y entre zócalos, lo que limita la velocidad a 25 GB/s o menos, según la utilización del enlace entre CPU. En cambio, el diseño optimizado basado en CX8 permite hasta 50 GB/s por GPU de ancho de banda de E/S para toda la comunicación entre GPU dentro del clúster, ya que NCCL enruta todo el tráfico directamente a través de la red.
[2] Comunicación GPU-NIC: La arquitectura optimizada proporciona a cada GPU un ancho de banda de 50 GB/s en una configuración GPU-NIC de 2:1, independientemente de si la GPU o el sistema host admiten PCIe Gen5 o Gen6.
[3] GPU a GPU a través del mismo conmutador PCIe: Los sistemas equipados con PCIe Gen6 se benefician del doble de ancho de banda en comparación con Gen5, lo que acelera significativamente las transferencias de GPU punto a punto a través del mismo conmutador PCIe.
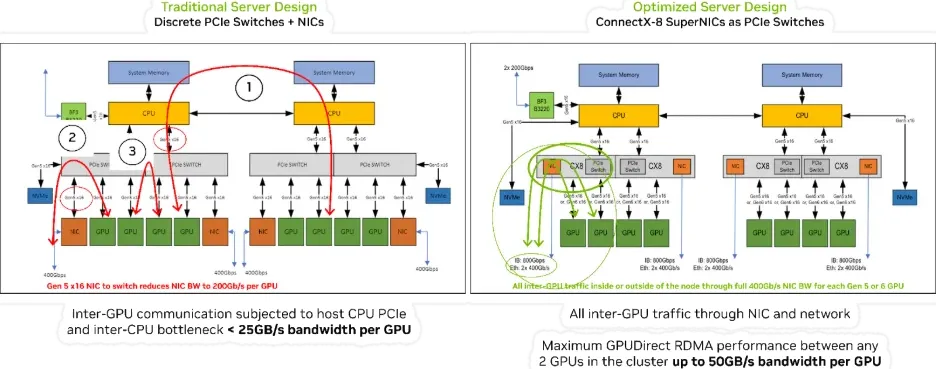
Referencia: Arquitectura de la plataforma NVIDIA ConnectX-8 SuperNICs
RDMA desde una perspectiva de API programática
Link to heading
Esta sección se basa en el tutorial de Netdev 0x16 RDMA.
Cree los objetos necesarios, incluidos PD y CQ.
struct ibv_pd *pd = ibv_alloc_pd(verbs_context);
if (!pd) { /* error handling… */ }

struct ibv_cq_init_attr_ex cq_attr = {
.cqe = num_entries, cq_context = my_context, … };
struct ibv_cq_ex *cq = ibv_create_cq_ex(verbs_context, &cq_attr);
if (!cq) { /* error handling… */ }
Asigne un búfer para almacenar los datos y regístrelo con libibverbs:
void *buf = malloc(BUF_SIZE);
struct ibv_mr *mr = ibv_reg_mr(pd, buf, BUF_SIZE, IBV_ACCESS_LOCAL_WRITE);
Establecimiento de conexión con librdmacm
Link to heading
Similar a los sockets, con una interfaz asíncrona basada en eventos. (No es estrictamente necesario, pero proporciona una abstracción que cubre múltiples transportes). Primero, cree un “canal de eventos”:
struct rdma_event_channel *channel;
channel = rdma_create_event_channel();
if (!channel) { /* error handling… */ }
Ambas partes resuelven la dirección del servidor:
struct rdma_addrinfo hints, *rai;
memset(&hints, 0, sizeof hints);
hints.ai_flags = RAI_PASSIVE;
hints.ai_port_space = RDMA_PS_TCP;
err = rdma_getaddrinfo(server_addr, port, &hints, &rai)
El lado pasivo (SCN) crea y vincula un “ID” de escucha y escucha:
struct rdma_cm_id *listen_id;
err = rdma_create_id(channel, &listen_id, myctx, RDMA_PS_TCP);
err = rdma_bind_addr(listen_id, rai->ai_src_addr);
err = rdma_listen(listen_id, 0);
/* events will be generated for incoming connection requests */
El lado activo crea un ID y resuelve la dirección del servidor:
struct rdma_cm_id *cma_id;
err = rdma_create_id(channel, &cma_id, myctx, RDMA_PS_TCP);
err = rdma_resolve_addr(cma_id, rai->ai_src_addr, rai->ai_dst_addr, 2000);
/* rdma_resolve_addr will generate an event on completion */
Bucle de eventos para gestionar eventos de conexión:
struct rdma_cm_event *event;
while (true) {
err = rdma_get_cm_event(test.channel, &event);
switch (event->event) {
case RDMA_CM_EVENT_ADDR_RESOLVED: /* etc */
}
rdma_ack_cm_event(event);
}
Eventos importantes a gestionar:
case RDMA_CM_EVENT_ADDR_RESOLVED: /* call rdma_resolve_route() */
case RDMA_CM_EVENT_ROUTE_RESOLVED: /* call rdma_create_qp() and rdma_connect() */
case RDMA_CM_EVENT_CONNECT_REQUEST: /* call rdma_accept() */
case RDMA_CM_EVENT_ESTABLISHED: /* start communication */
case RDMA_CM_EVENT_UNREACHABLE:
case RDMA_CM_EVENT_REJECTED: /* handle these and other errors */
case RDMA_CM_EVENT_DISCONNECTED: /* handle disconnection */
Solicitud de trabajo recibida después de publicar
Link to heading
Complete una lista dispersa y ponga en cola las solicitudes de trabajo para recibirlas:
struct ibv_recv_wr wr, *bad_wr;
struct ibv_sge sge;
wr.sg_list = &sge;
wr.num_sge = 1;
wr.wr_id = (uint64_t) my_id;
sge.addr = (uintptr_t) buf;
sge.length = BUF_SIZE;
sge.lkey = mr->lkey;
err = ibv_post_recv(qp, wr, &bad_wr);
Complete la lista de recopilación y ponga en cola las solicitudes de trabajo para enviarlas a la cola:
ibv_wr_start(qp);
qp->wr_id = MY_WR_ID;
qp->wr_flags = 0; /* ordering/fencing etc */
ibv_wr_set_sge(qp, mr->lkey, (uintptr_t) buf, BUF_SIZE);
/* ibv_wr_set_sge_list() for multiple buffers */
err = ibv_wr_complete(qp);
Verificación no bloqueante para entradas de la cola de finalización
struct ibv_poll_cq_attr attr = {};
err = ibv_start_poll(cq, &attr);
while (!err) {
end_flag = true;
/* consume cq->status, cq->wr_id, etc */
err = ibv_next_poll(cq);
}
if (end_flag) ibv_end_poll(cq);
RDMA desde una perspectiva directa de la GPU
Link to heading
Aquí es donde empieza a ponerse… muy… confuso. ¿Cuál es la relación entre “GPUDirect RDMA” y RDMA? Como se mencionó en una publicación anterior (/posts/the-confusing-world-of-rdma-and-infiniband/), la documentación oficial de Nvidia afirma que no hay ninguna relación. Para entender el motivo, debemos remontarnos a sus inicios, cuando aún era una tecnología de Mellanox, alrededor de 2016 (https://github.com/Mellanox/nv_peer_memory/blame/master/README.md). Esto es lo que decía la especificación en ese momento:
El último avance en comunicaciones GPU-GPU es GPUDirect RDMA. Esta nueva tecnología proporciona una ruta de datos P2P (peer-to-peer) directa entre la memoria de la GPU y los dispositivos NVIDIA HCA/NIC. Esto reduce significativamente la latencia en las comunicaciones GPU-GPU y libera completamente a la CPU de toda comunicación entre GPU en la red.
En la especificación GPUNetIO [https://docs.nvidia.com/doca/sdk/doca+gpunetio/index.html#src-4012579584_id-.DOCAGPUNetIOv3.1.0-EnablingNIC-GPUMemoryInteraction], se menciona que para habilitar la interacción entre la memoria NIC y la GPU:
Para habilitar la NIC para enviar y recibir paquetes usando la memoria de la GPU, cargue el módulo del kernel de NVIDIA nvidia-peermem, que normalmente se incluye con la instalación de CUDA Toolkit.
Una aplicación de red de procesamiento de paquetes mediante GPU se puede dividir en dos fases fundamentales:
Fase de configuración en la CPU (configuración de dispositivos, asignación de memoria, lanzamiento de kernels CUDA…)
Fase de la ruta de datos donde la GPU y la NIC interactúan para ejercer sus funciones.
Durante la fase de configuración en la CPU, las aplicaciones deben:
Prepara todos los objetos en la CPU.
Exportar un controlador de GPU para ellos.
Iniciar un kernel CUDA pasando el controlador de GPU del objeto para trabajar con el objeto durante la ruta de datos.
Por este motivo, DOCA GPUNetIO se compone de dos bibliotecas:
libdoca_gpunetio con funciones invocadas por la CPU para preparar la GPU, asignar memoria y objetos.
libdoca_gpunetio_device con funciones invocadas por la GPU dentro de los kernels de CUDA durante la ruta de datos
Este es el caso de uso más genérico de recibir y analizar encabezados de paquetes. Diseñado para mantenerse al día con 100 Gb/s de tráfico de red entrante, el kernel CUDA responsable del tráfico UDP dedica un bloque CUDA de 512 subprocesos CUDA (archivo gpu_kernels/receive_udp.cu) a una cola de recepción UDP Ethernet diferente.
El bucle de la ruta de datos es:
Reciba paquetes con la función GPUNetIO llamada doca_gpu_dev_eth_rxq_receive_block.
Cada hilo CUDA procesa un subconjunto de los paquetes recibidos.
Recuperar el búfer DOCA que contiene el paquete.
Analizar la carga útil del paquete para distinguir los paquetes DNS de otros paquetes UDP genéricos.
Borre la carga útil del paquete para asegurarse de que los paquetes antiguos no se vuelvan a analizar.
Cada bloque CUDA envía estadísticas al hilo de la CPU mediante un semáforo DOCA GPUNetIO.
El hilo de la CPU comprueba los semáforos para obtener las estadísticas y las imprime en la consola.
__global__ void cuda_kernel_receive_udp(uint32_t *exit_cond,
struct doca_gpu_eth_rxq *rxq0,
struct doca_gpu_eth_rxq *rxq1,
struct doca_gpu_eth_rxq *rxq2,
struct doca_gpu_eth_rxq *rxq3,
int sem_num,
struct doca_gpu_semaphore_gpu *sem0,
struct doca_gpu_semaphore_gpu *sem1,
struct doca_gpu_semaphore_gpu *sem2,
struct doca_gpu_semaphore_gpu *sem3)
{
__shared__ uint32_t rx_pkt_num;
__shared__ uint64_t rx_buf_idx;
__shared__ struct stats_udp stats_sh;

doca_error_t ret;
struct doca_gpu_eth_rxq *rxq = NULL;
struct doca_gpu_semaphore_gpu *sem = NULL;
struct doca_gpu_buf *buf_ptr;
struct stats_udp stats_thread;
struct stats_udp *stats_global;
struct eth_ip_udp_hdr *hdr;
uintptr_t buf_addr;
uint64_t buf_idx = 0;
uint32_t lane_id = threadIdx.x % WARP_SIZE;
uint8_t *payload;
uint32_t sem_idx = 0;

if (blockIdx.x == 0)      { rxq = rxq0; sem = sem0; }
else if (blockIdx.x == 1) { rxq = rxq1; sem = sem1; }
else if (blockIdx.x == 2) { rxq = rxq2; sem = sem2; }
else if (blockIdx.x == 4) { rxq = rxq3; sem = sem3; }

if (threadIdx.x == 0) {
DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}
__syncthreads();

while (DOCA_GPUNETIO_VOLATILE(*exit_cond) == 0) {
stats_thread.dns = 0;

/* No need to impose packet limit here as we want the max number of packets every time */
ret = doca_gpu_dev_eth_rxq_receive_block(rxq, 0, MAX_RX_TIMEOUT_NS, &rx_pkt_num, &rx_buf_idx);
/* If any thread returns receive error, the whole execution stops */
if (ret != DOCA_SUCCESS) { ... }

if (rx_pkt_num == 0) continue;

buf_idx = threadIdx.x;
while (buf_idx < rx_pkt_num) {
doca_gpu_dev_eth_rxq_get_buf(rxq, rx_buf_idx + buf_idx, &buf_ptr);
doca_gpu_dev_buf_get_addr(buf_ptr, &buf_addr);
raw_to_udp(buf_addr, &hdr, &payload);

if (filter_is_dns(&(hdr->l4_hdr), payload)) stats_thread.dns++;

/* Double-proof it's not reading old packets */
wipe_packet_32b((uint8_t *)&(hdr->l4_hdr));
buf_idx += blockDim.x;
}
__syncthreads();

for (int offset = 16; offset > 0; offset /= 2) {
stats_thread.dns += __shfl_down_sync(WARP_FULL_MASK, stats_thread.dns, offset);
__syncwarp();
}

if (lane_id == 0) {
atomicAdd_block((uint32_t *)&(stats_sh.dns), stats_thread.dns);
}

__syncthreads();

if (threadIdx.x == 0 && rx_pkt_num > 0) {
ret = doca_gpu_dev_semaphore_get_custom_info_addr(sem, sem_idx, (void **)&stats_global);
if (ret != DOCA_SUCCESS) { ... }

DOCA_GPUNETIO_VOLATILE(stats_global->dns) = DOCA_GPUNETIO_VOLATILE(stats_sh.dns);
DOCA_GPUNETIO_VOLATILE(stats_global->total) = rx_pkt_num;
doca_gpu_dev_semaphore_set_status(sem, sem_idx, DOCA_GPU_SEMAPHORE_STATUS_READY);
__threadfence_system();

sem_idx = (sem_idx + 1) % sem_num;

DOCA_GPUNETIO_VOLATILE(stats_sh.dns) = 0;
}

__syncthreads();
}
}
En el ejemplo anterior, RDMA no interviene directamente. GPUNetIO simplemente permite que la GPU procese los datos de los paquetes directamente. La única similitud con RDMA radica en que el paquete se transfiere de la tarjeta de red a la GPU mediante una transferencia DMA directa, sin pasar por la memoria de la CPU.
Antes de concluir, queda un punto que genera confusión: DOCA RDMA. En la sección anterior, analizamos DOCA GPUNetIO. Pero, ¿qué es DOCA RDMA y en qué se diferencia de la API “ibv” anterior, que ya vimos?
La respuesta es sencilla: DOCA RDMA es el marco de software de NVIDIA para realizar operaciones RDMA utilizando la CPU o la GPU. IBV es la biblioteca tradicional de bajo nivel InfiniBand Verbs, que forma parte de la API estándar para programar hardware InfiniBand y RoCE. La diferencia clave radica en que DOCA RDMA es un SDK de nivel superior y más completo que se basa en las capacidades fundamentales de la interfaz Verbs, permitiendo la aceleración por GPU y la descarga de tareas RDMA de la CPU a la GPU.
Por ejemplo, este es el código para enviar un paquete RDMA:
doca_error_t rdma_send(struct rdma_config *cfg)
{
struct rdma_resources resources = {0};
union doca_data ctx_user_data = {0};
const uint32_t mmap_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
const uint32_t rdma_permissions = DOCA_ACCESS_FLAG_LOCAL_READ_WRITE;
struct timespec ts = { .tv_sec = 0, .tv_nsec = SLEEP_IN_NANOS};
doca_error_t result, tmp_result;

/* Allocating resources */
result = allocate_rdma_resources(cfg, mmap_permissions, rdma_permissions,
doca_rdma_cap_task_send_is_supported,  &resources);

result = doca_rdma_task_send_set_conf(resources.rdma, rdma_send_completed_callback,
rdma_send_error_callback, NUM_RDMA_TASKS);

result = doca_ctx_set_state_changed_cb(resources.rdma_ctx, rdma_send_state_change_callback);

/* Include the program's resources in user data of context to be used in callbacks */
ctx_user_data.ptr = &(resources);
result = doca_ctx_set_user_data(resources.rdma_ctx, ctx_user_data);

/* Create DOCA buffer inventory */
result = doca_buf_inventory_create(INVENTORY_NUM_INITIAL_ELEMENTS, &resources.buf_inventory);

/* Start DOCA buffer inventory */
result = doca_buf_inventory_start(resources.buf_inventory);

/* Start RDMA context */
result = doca_ctx_start(resources.rdma_ctx);

/*
* Run the progress engine which will run the state machine defined in
* rdma_send_state_change_callback(). When the context moves to idle, the context change
* callback call will signal to stop running the progress engine. */
while (resources.run_pe_progress) {
if (doca_pe_progress(resources.pe) == 0)
nanosleep(&ts, &ts);
}

// ... cleanup
}
En la sección anterior, hemos examinado diversos aspectos de RDMA. El objetivo principal de RDMA es transferir datos entre CPU, GPU y la pila de control cuántico con una latencia de unos pocos microsegundos. Se transfiere mucha información, ya sean los datos de lectura suave I/Q, las muestras de pulsos de control (“ondas”) o simplemente la configuración paramétrica de los pulsos, generalmente en el contexto de una red neuronal. También es necesario transferir información más sencilla, como los síndromes de los cúbits lógicos, y llamar remotamente a un decodificador QEC en la unidad de cómputo. En este último caso, es aceptable llamar a las cosas por su nombre y simplemente denominar a este comportamiento “llamada a procedimiento remoto” o RPC.
 Lo bueno es que hay mucha literatura disponible sobre RPC sobre RDMA, como mRPC, que presenta cifras de latencia muy interesantes, basadas en la NIC Mellanox Connect-X5 RoCE de 100 Gbps. Hay confusión en el documento, ya que afirma que “En RDMA, mRPC acelera a eRPC en 1,3× y 1,4× en términos de latencia mediana y de cola (respectivamente)” mientras que la tabla indica que eRPC es más rápido que mRPC. Pero, por ahora, se puede asumir que las cifras de latencia son empíricamente posibles.
 Lo más interesante es ver el seguimiento de mRPC documento, donde se utiliza un Compute Express Link (CXL) para crear un RPC aún más rápido que denominan “HydraRPC”. Las cifras hablan por sí solas; véase la tabla de la derecha. La pregunta que cabe plantearse es: ¿cómo será esto dentro de 5 años? En mi opinión, NVLink también parece una oportunidad muy atractiva…
¡Listo! Me tomó más tiempo completar este memorándum, pero creo que me ayudó a comprender mejor el tema. Creo que la confusión entre RDMA y GPUDirect se debe a que RDMA fue desarrollado inicialmente por Mellanox como una mejora puramente de red. Tras la adquisición de Mellanox por parte de Nvidia, se amplió para conectarse a la GPU, pero esta extensión nunca se concibió como un concepto inicial y terminó siendo un complemento dentro del ecosistema DOCA.

References:
DrawIO diagrams used in this memo: