Este documento retoma los fundamentos de las GPU. Se centra en la operación clave del aprendizaje profundo: la multiplicación de matrices. Primero, describiré la implementación básica y académica. Luego, analizaré las optimizaciones necesarias para usar la GPU de manera eficiente.
Entendiendo el multiplicador de matrices ingenuo
Link to heading
Comencemos con este ejemplo básico que se suele encontrar en los libros de texto.
/**
* Kernel to perform matrix multiplication C = A × B
* A is of size N x M, B is M x N, and C is N x N
* Each thread computes one element of matrix C.
*/

__global__ void naive_matrix_multiply(float* A, float* B, float* C) {

// Calculate global row and column for this thread
int row = blockIdx.y /* 0...16 */ * blockDim.y + threadIdx.y;
int col = blockIdx.x /* 0...16 */ * blockDim.x + threadIdx.x;

if (row < N && col < N) {
float sum = 0.0f;
for (int k = 0; k < M; k++) {
// C[row][col] = sum(A[row][i] * B[i][col])
sum += A[row * N + k] * B[k * N + col];
}
C[row * N + col] = sum;
}

}
A primera vista, esto parece sencillo. Simplemente se calcula cada celda de la matriz de salida C. Este código kernel parece cumplir con su cometido. Aquí se muestra una representación más visual del kernel.
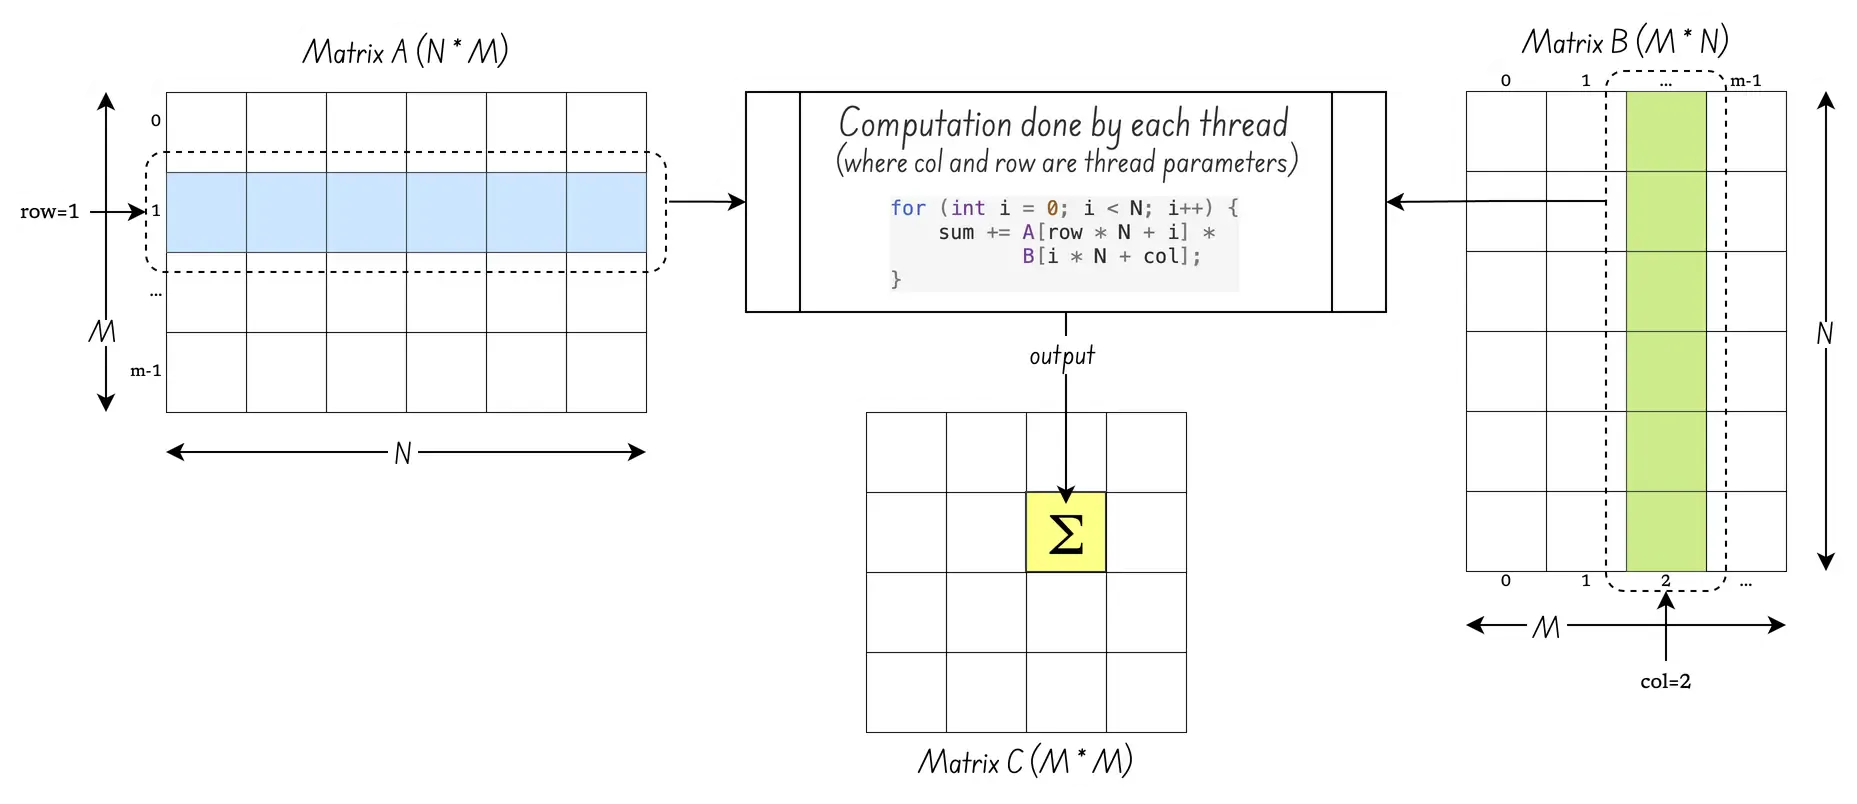
La realidad es un poco más compleja. ¿Cómo se interpretan blockIdx, blockDim y threadIdx? Para entenderlo, volvamos a cómo se organizan las GPU en torno a hilos, warps y multiprocesadores de flujo. Aquí hay una representación subjetiva de la microarquitectura de GPU H100 “Hopper” de Nvidia:
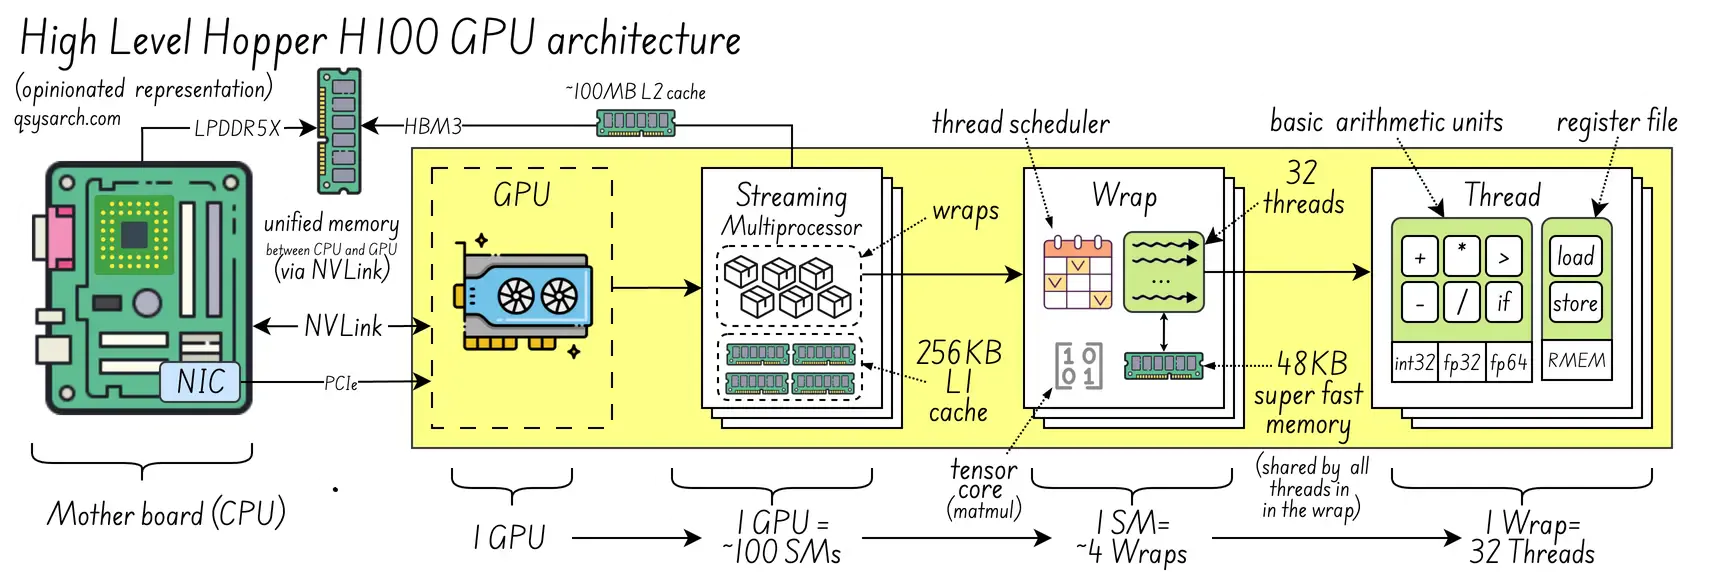
A grandes rasgos:
1 GPU = 10 ~ 100 multiprocesadores de transmisión
1 multiprocesador de flujo = 4 ~ 64 envolturas
1 vuelta = 32 ~ 64 hilos
Pero, entonces, ¿cómo se asocia el fragmento de código que calcula sum con un hilo, un warp o incluso un multiprocesador de flujo? ¿Dónde se toman las decisiones de asignación y mapeo? Primero, necesitamos entender cómo está configurado el kernel:
int launch_kernel(float *d_A, *d_B, *d_C) {

dim3 block_size(16, 16);  // 16x16 threads per block -> 256 threads
dim3 grid_size(4, 4);     // 4x4 blocks per grid = 64 blocks

// 2. Launch the kernel with the specified dimensions
naive_matrix_multiply<<<grid_size, block_size>>>(d_A, d_B, d_C);
}
Esta configuración jerárquica se asigna al hardware de la GPU de la siguiente manera:

Con esta configuración, es posible multiplicar una matriz de tamaño N de 16*4 = 64. ¿Qué ocurre si N es 1000? En ese caso, basta con establecer el tamaño de la cuadrícula en (1000+15)/16.
¿Qué ocurre con la asignación al hardware real? ¿Significa eso que los bloques se asignan a los warps? ¿Qué sucede si el número de hilos en el bloque es mayor que el número de hilos del hardware?
Bueno, aquí es donde se debe introducir la planificación de la GPU. A simple vista, si se necesitan más hilos de los que hay en el hardware físico, la GPU asignará varios warps:
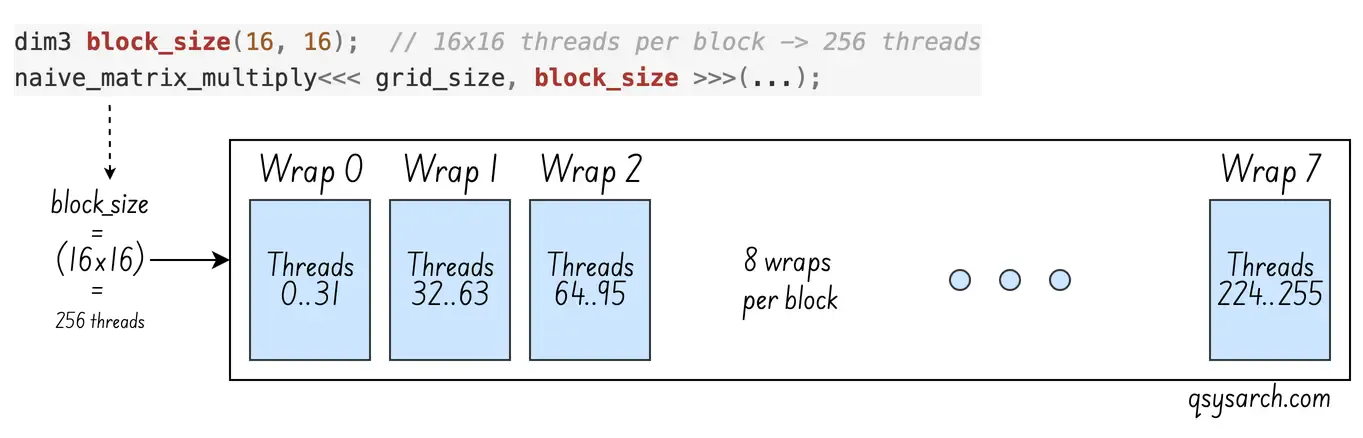
La siguiente pregunta es cómo se relacionan los 8 warps necesarios por bloque con el multiprocesador de flujo, especialmente cuando este tiene menos warps de los que requiere un bloque. La respuesta es excelente: un multiprocesador de flujo puede tener más de 4 warps, que programa de forma alternada. Cuando un warp se detiene debido a un acceso a memoria, el multiprocesador cambia inmediatamente a otro warp. Esto se conoce como ocultación de latencia y es la estrategia fundamental de rendimiento de la GPU. Sin esto, la eficiencia no sería tan alta.
Ahora bien, consideremos grid_size. ¿Está grid_size directamente relacionado con los recursos de hardware? No. La cuadrícula es simplemente un concepto lógico. Garantiza que haya suficientes bloques disponibles para cubrir la matriz. grid_size no se corresponde con el hardware. Los bloques se asignan a cada SM en tiempo de ejecución desde una cola.
La asignación se basa en los recursos que necesita el bloque (cada envoltura tiene un número limitado de registros, y debe asegurarse de que cada bloque tenga su propio conjunto de registros asignados estáticamente.
Cuando un bloque finaliza su cálculo, el SM extrae un nuevo bloque de la cola del planificador para reemplazar el que ya ha finalizado. Una vez asignado, el bloque queda fijado a ese SM y sus registros se asignan para su ejecución.
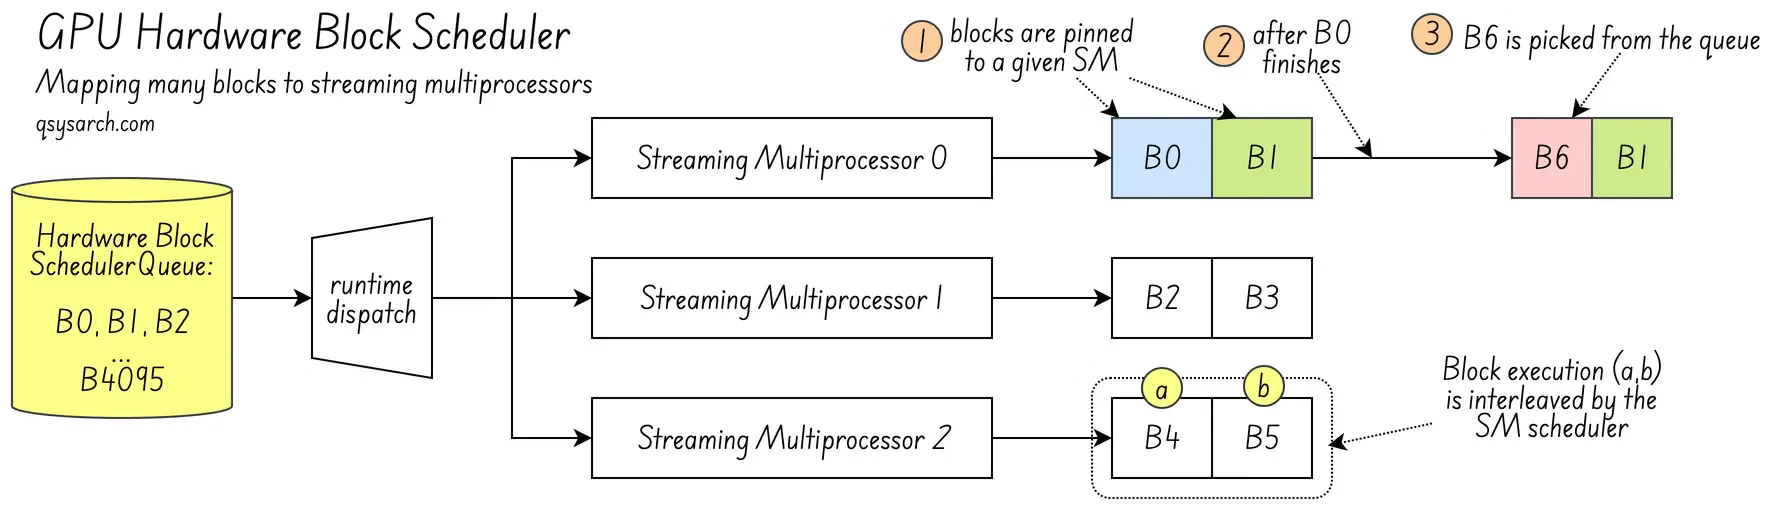
Una última pregunta: ¿Los bloques están asignados al SM o al warp? ¿La memoria utilizada por los hilos en el bloque se asigna dentro del warp? Si no, el SM tendría que mover memoria entre warps. Sí, dentro del SM, los warps de un bloque están asignados. Si el bloque 0 se asigna al warp 0 y el bloque 1 al warp 1, esto siempre será así.
Mejorando el multiplicador de matrices ingenuo
Link to heading
Ahora que comprendemos la ejecución concurrente de hilos, consideremos el núcleo de multiplicación de matrices simple. Todos los hilos compiten por el acceso a la memoria de las matrices A y B. Cada hilo obtiene una fila completa de A y una columna de B de la memoria global. No hay reutilización. Se accede a B columna por columna (B[i * N + col]), por lo que el acceso en ráfaga y el almacenamiento en caché de memoria no se pueden utilizar eficazmente.
La respuesta más sencilla es usar memoria compartida. Primero, carga parte de la matriz en la memoria del warp como un bloque de tamaño T*T. Luego, permite que los hilos lean solo de esta memoria local. De esta manera, los hilos no compiten por el acceso a la memoria. Mediante el entrelazado de warps, el SM garantiza que mientras un warp carga memoria en la caché, el otro warp calcula la suma. Aquí está el kernel mejorado:
__global__ void matmul_tiled(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x,  ty = threadIdx.y;
int row = blockIdx.y * T + ty;   // global row in C
int col = blockIdx.x * T + tx;   // global col in C

float accumulator = 0.0f;
for (int t = 0; t < M; t += T) {

// Read [T,T] subtile from matrix A and B.
// Assume that M and N are multiples of T (no bound check)
A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();   // wait all threads to finish loading

for (int k = 0; k < TILE; ++k)
accumulator += A_shared[ty][k] * B_shared[k][tx];

__syncthreads();   // all threads are ready to load again
}
C[row * N + col] = accumulator;
}
Para simplificar, asumo que M y N son múltiplos de T, por lo que no hay comprobación de límites al cargar la matriz global en A_shared y B_shared.
Este código tiene un toque de magia. Todos los hilos del bloque ejecutan la misma lectura de memoria: A[fila * M + t + tx]. Dado que t es contiguo, los hilos leen de la misma región de memoria. Esto permite la lectura en ráfaga y el almacenamiento en caché. El primer hilo inicia la lectura en ráfaga. Los demás hilos utilizan la caché generada por dicha lectura. B no está transpuesta, por lo que este truco no funciona para B. Además, __syncthreads() sincroniza los hilos dentro de un bloque, asegurando que se ejecuten en el mismo SM.
Con el multiplicador ingenuo anterior, el tamaño del bloque era arbitrario. Con el enfoque de mosaico, el tamaño del bloque debe ajustarse al tamaño del mosaico T*T, como muestra el diagrama:
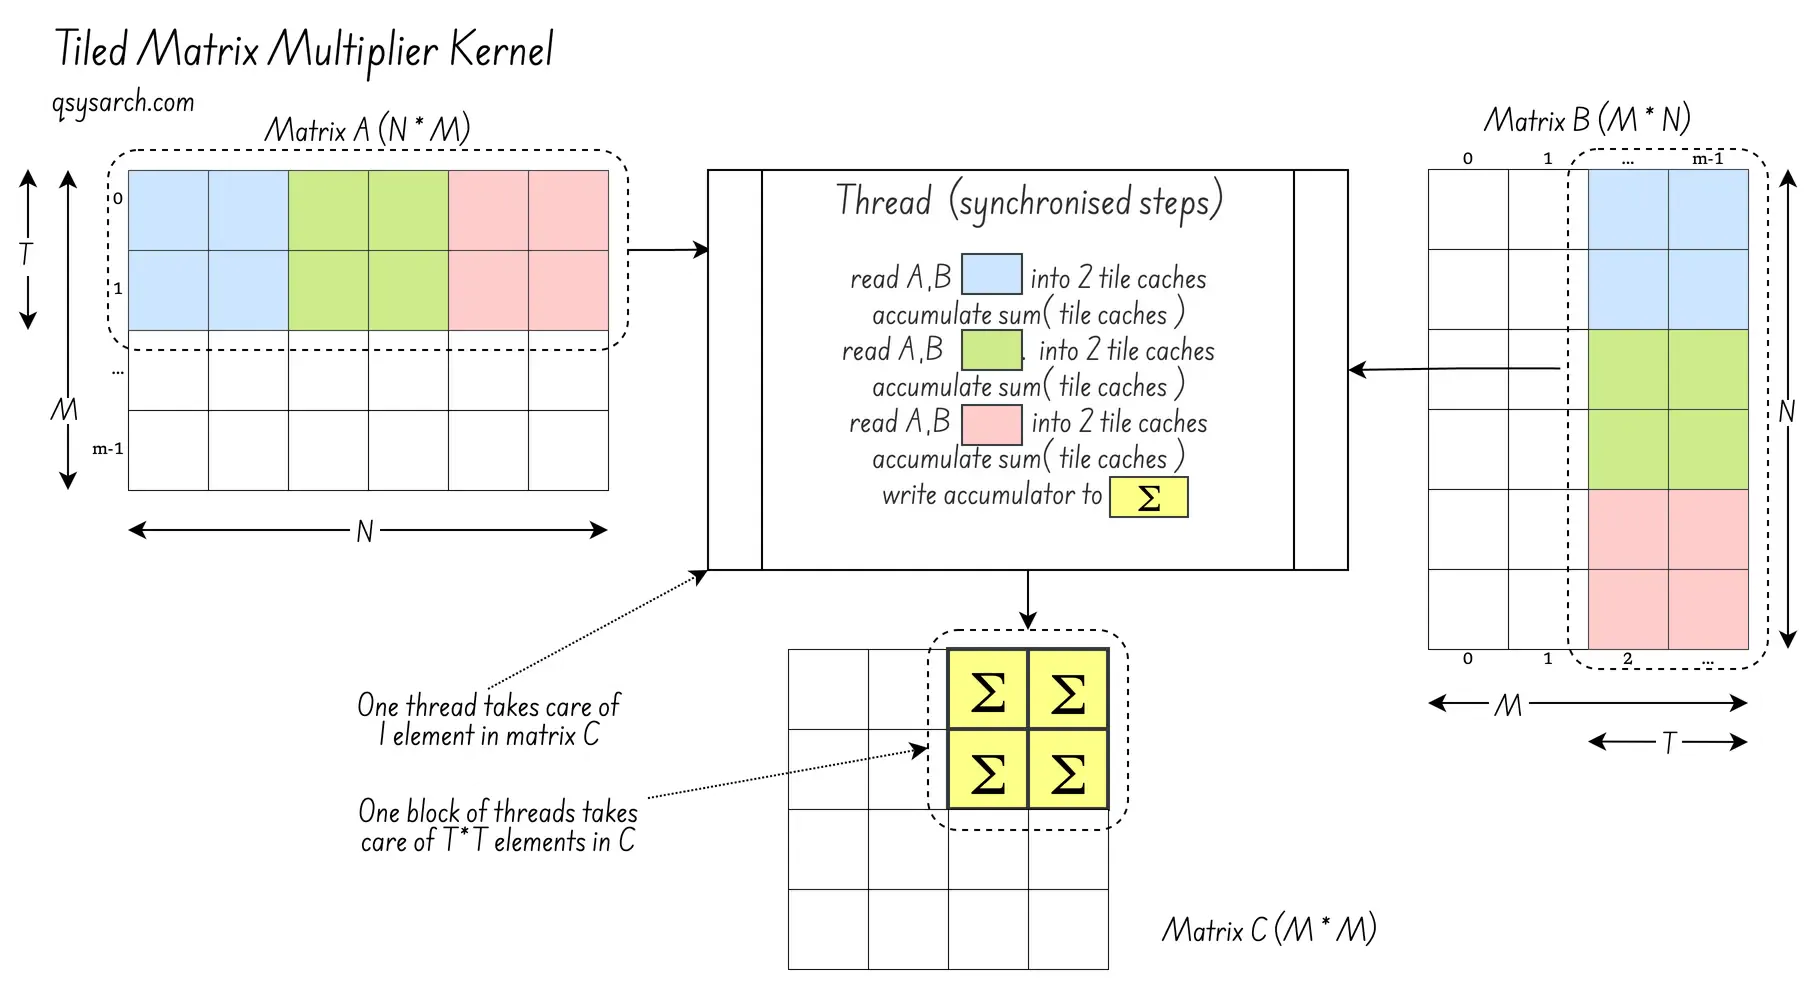
El enfoque por bloques permite que algunos bloques se carguen mientras otros realizan cálculos. En este caso, el cálculo puede ser ligero y tomar menos tiempo que la carga de memoria. Para solucionar esto, aumente el trabajo por hilo durante el cálculo. Cada hilo puede calcular un conjunto de 2x2 elementos en lugar de solo uno. Con K=2 y T un múltiplo de K, esto es posible.
_global__ void matmul_tiled_and_coarsened(float* A, float* B, float* C) {

__shared__ float A_shared[T][T];
__shared__ float B_shared[T][T];

int tx = threadIdx.x, ty = threadIdx.y;
int rowBase = blockIdx.y * T * K + ty;
int colBase = blockIdx.x * T * K + tx;

float accumulators[K][K]; // That's register memory

for (int t = 0; t < M; t += TILE) {

A_shared[ty][tx] = A[row * M + t + tx];
B_shared[tx][ty] = B[(t + ty) * N + col];

__syncthreads();

for (int k = 0; k < TILE; ++k)
for (int wr = 0; wr < K; ++wr)
for (int wc = 0; wc < K; ++wc)
acc[wr][wc] += A_shared[ty + wr * (T/K)][k] * B_shared[k][tx + wc * (T/K)];

__syncthreads();
}

// Write out the T×T accumulated result
for (int wr = 0; wr < T; ++wr)
for (int wc = 0; wc < T; ++wc) {
int r = rowBase + wr * (T/K);
int c = colBase + wc * (T/K);
C[r * N + c] = acc[wr][wc];
}
}
¡Listo! Así es básicamente como funciona una unidad GEMM (Multiplicación General de Matrices).
A continuación, presentaré hardware especializado como Tensor Core (NVIDIA) o Matrix Fused Multiply-Add (AMD). Se trata de unidades especializadas en el multiprocesador de flujo que calculan las multiplicaciones acumuladas T*T*K. ¡Lo dejaré para una nota posterior!
References:
DrawIO diagrams used in this memo: