Al compilar para GPU NVIDIA, CUDA suele considerarse el marco de compilación de referencia. Pero, ¿cómo funciona realmente el compilador? ¿Qué tipo de arquitectura de conjunto de instrucciones (ISA) necesita generar al crear un ejecutable para la GPU? ¿Y cómo funciona realmente el compilador? ¿Qué tipo de arquitectura se utiliza para generar código que se pueda lanzar desde una CPU y ejecutar en una GPU?
Este informe dominical pretende ser una descripción general de alto nivel de la arquitectura del compilador de GPU de NVIDIA. Cubre el conjunto de instrucciones de la GPU, el compilador NVCC en el marco de trabajo CUDA y, finalmente, arquitecturas alternativas que utilizan el conjunto de instrucciones de la GPU.
Arquitectura de GPU de bajo nivel
Link to heading
Al programar un dispositivo como una GPU, necesitamos un conjunto de instrucciones. En el caso de NVIDIA, este dispositivo es el multiprocesador de flujo (SM), representado en el diagrama de la derecha. Lo interesante del diagrama es que contiene muchas unidades concurrentes, como los sumadores IN32, la unidad de función especial y el núcleo tensorial GEMM+++, y que el compilador debe asegurarse de que se utilicen (en paralelo) de la forma más eficiente (donde la eficiencia se define como la minimización del tiempo de inactividad).
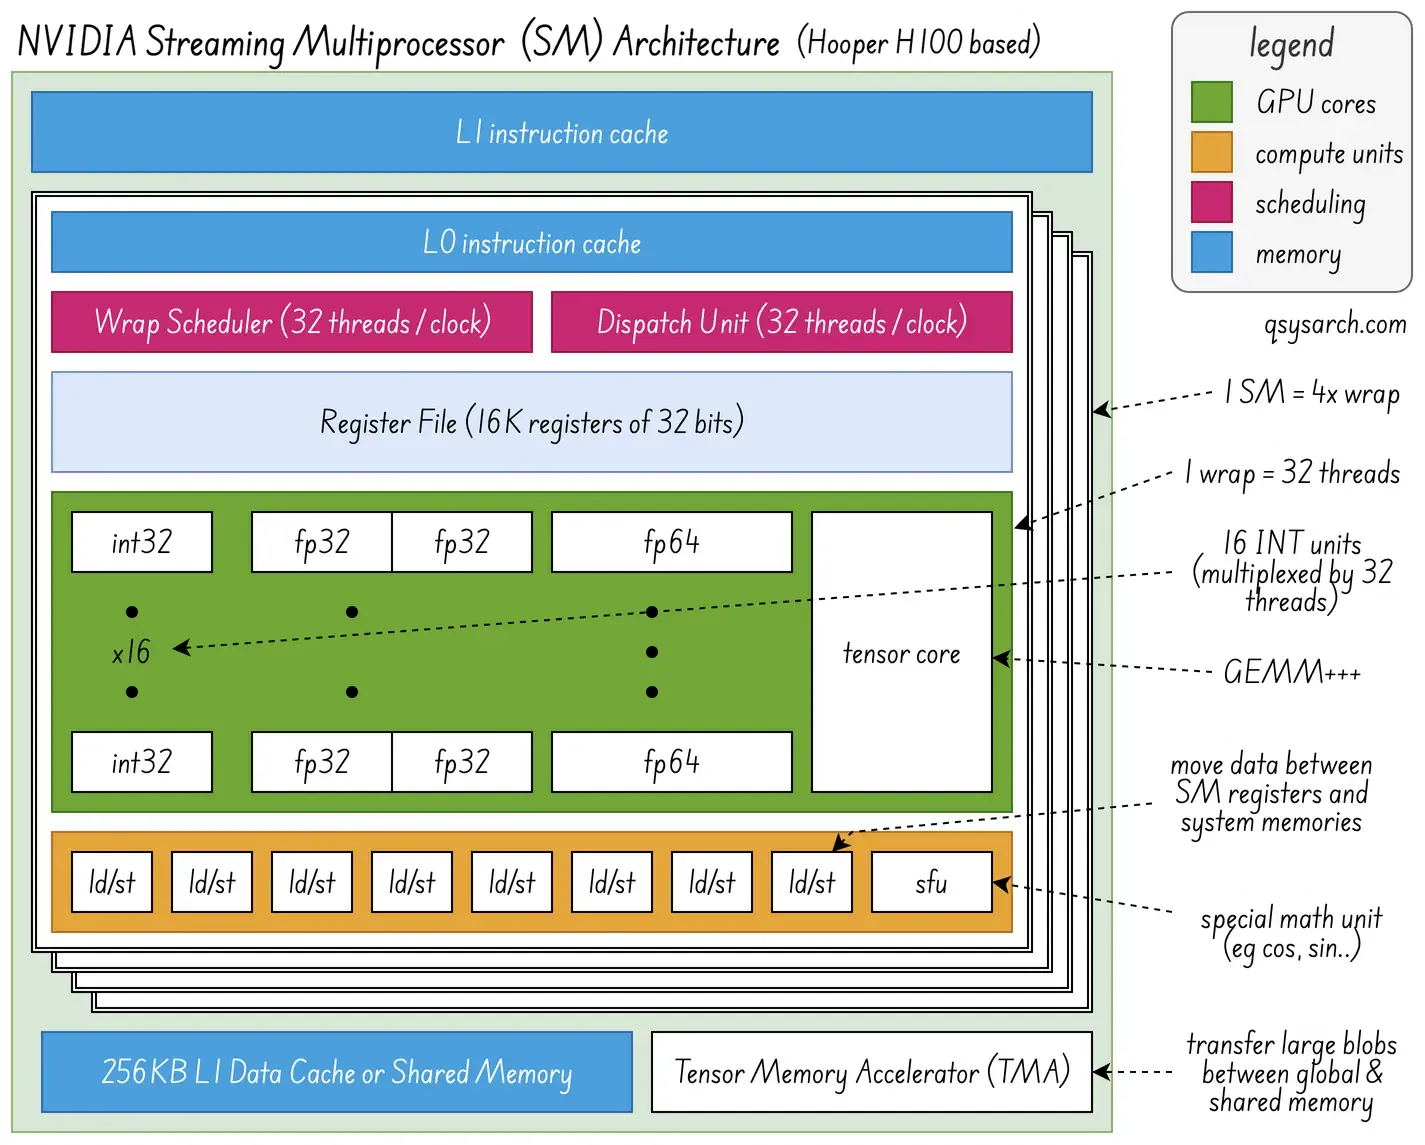
Esta es la terminología que se utiliza:
ISA (Arquitectura del Conjunto de Instrucciones): conjunto de instrucciones.
Código máquina: Representación compacta y binaria de las instrucciones
Ensamblaje (lenguaje): representación textual menos compacta de las instrucciones
Existen dos conjuntos de instrucciones (ISA) para las GPU de NVIDIA:
PTX: Ejecución de subprocesos paralelos: ensamblador intermedio utilizado al compilar kernels de CUDA.
SASS: Ensamblador de transmisión. Ensamblador de bajo nivel, específico para cada arquitectura de GPU.
Consideremos que queremos compilar este kernel:
__global__ void normalizeVector(float* x, float* y, float* z, int n)
{
int i = blockIdx.x * blockDim.x + threadIdx.x;

float vx = x[i], vy = y[i];
float len2 = vx*vx + vy*vy;
float invLen = rsqrtf(len2);  // Use SFU fast reciprocal square root
z[i] = invLen; // Normalized length
}
La magia aquí es que rsqrtf debe enviarse a la canalización SFU. ¿Cómo funciona esto? La línea float invLen = rsqrtf(len2); se convierte a PTX como rsqrt.approx.ftz.f32 y luego a SASS como MUFU.RSQ como se muestra en la imagen a continuación de [godbolt](https://godbolt.org/#g:!((g:!((g:!((h:codeEditor,i:(filename:'1',fontScale:14,fontUsePx:'0',j:1,lang:cuda,selection:(endColumn:2,endLineNumber:15,positionColumn:2,positionLineNumber:15,selectionStartColumn:2,selectionStartL ineNumber:15,startColumn:2,startLineNumber:15),source:’global+void+normalizeVector(float*+x,+float*+y,+float*+z,+int+n)%0A%7B%0A++++int+i+%3D+blockIdx.x++blockDim.x+%2B+threadIdx.x%3B%0A%0A++++float+vx+%3D+x%5Bi%5D%3B%0A++++float +vy+%3D+y%5Bi%5D%3B%0A++++float+len2+%3D+vxvx+%2B+vyvy%3B%0A%0A++++//+Uso+SFU+rápido+recíproco+raíz+cuadrada%0A++++flo at+invLen+%3D+rsqrtf(len2)%3B+%0A%0A++++//+Normalizar+el+vector%0A++++x%5Bi%5D+%3D+vx+++invLen%3B%0A++++y%5Bi%5D+%3D+ vy++invLen%3B%0A%7D’),l:‘5’,n:‘0’,o:‘CUDA+C%2B%2B+source+%231’,t:‘0’)),k:33.333333333333336,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:compiler,i:(compiler:nvcc130u2,filters:(b:‘0’,binary:‘1’,binaryObject:‘1’,commentOnly:‘0’,debugCalls:‘1’, desmantelar:‘0’,directivas:‘0’,ejecutar:‘1’,inteligencia:‘0’,código de biblioteca:‘0’,recortar:‘1’,desmantelamiento detallado:‘0’),flagsViewOpen:‘1’,fontScale:14,fontUsePx:‘0’,j:1,lang:cuda,libs:!(),options:’-arch+sm_90+-use_fast_math+-O3’,overrides:!(),selection:(en dColumn:1,endLineNumber:1,positionColumn:1,positionLineNumber:1,selectionStartColumn:1,selectionStartLineNumber:1,startColumn:1,startLineNumber:1),source:1),l:‘5’,n:‘0’,o:’+NVCC+13.0.2+(Editor+%231)’,t:‘0’)),k:33.333333333333336,l:‘4’ ,n:‘0’,o:’’,s:0,t:‘0’),(g:!((h:dispositivo,i:(nombre_compilador:‘NVCC+13.0.2’,dispositivo:‘SASS+(sm_90)’,editorid:1,escala_fuente:14,fontUsePx:‘0’,j:1,selección:(columna_fin:6,número_línea_fin:21,columna_posición:1,número_línea_posición:1,columna_inicio_selección:6,s electionStartLineNumber:21,startColumn:1,startLineNumber:1),treeid:0),l:‘5’,n:‘0’,o:‘Device+Viewer+NVCC+13.0.2+(Editor+%231,+Compiler+%231)’,t:‘0’)),k:33.33333333333333,l:‘4’,n:‘0’,o:’’,s:0,t:‘0’)),l:‘2’,n:‘0’,o:’’,t:‘0’)),version:4).
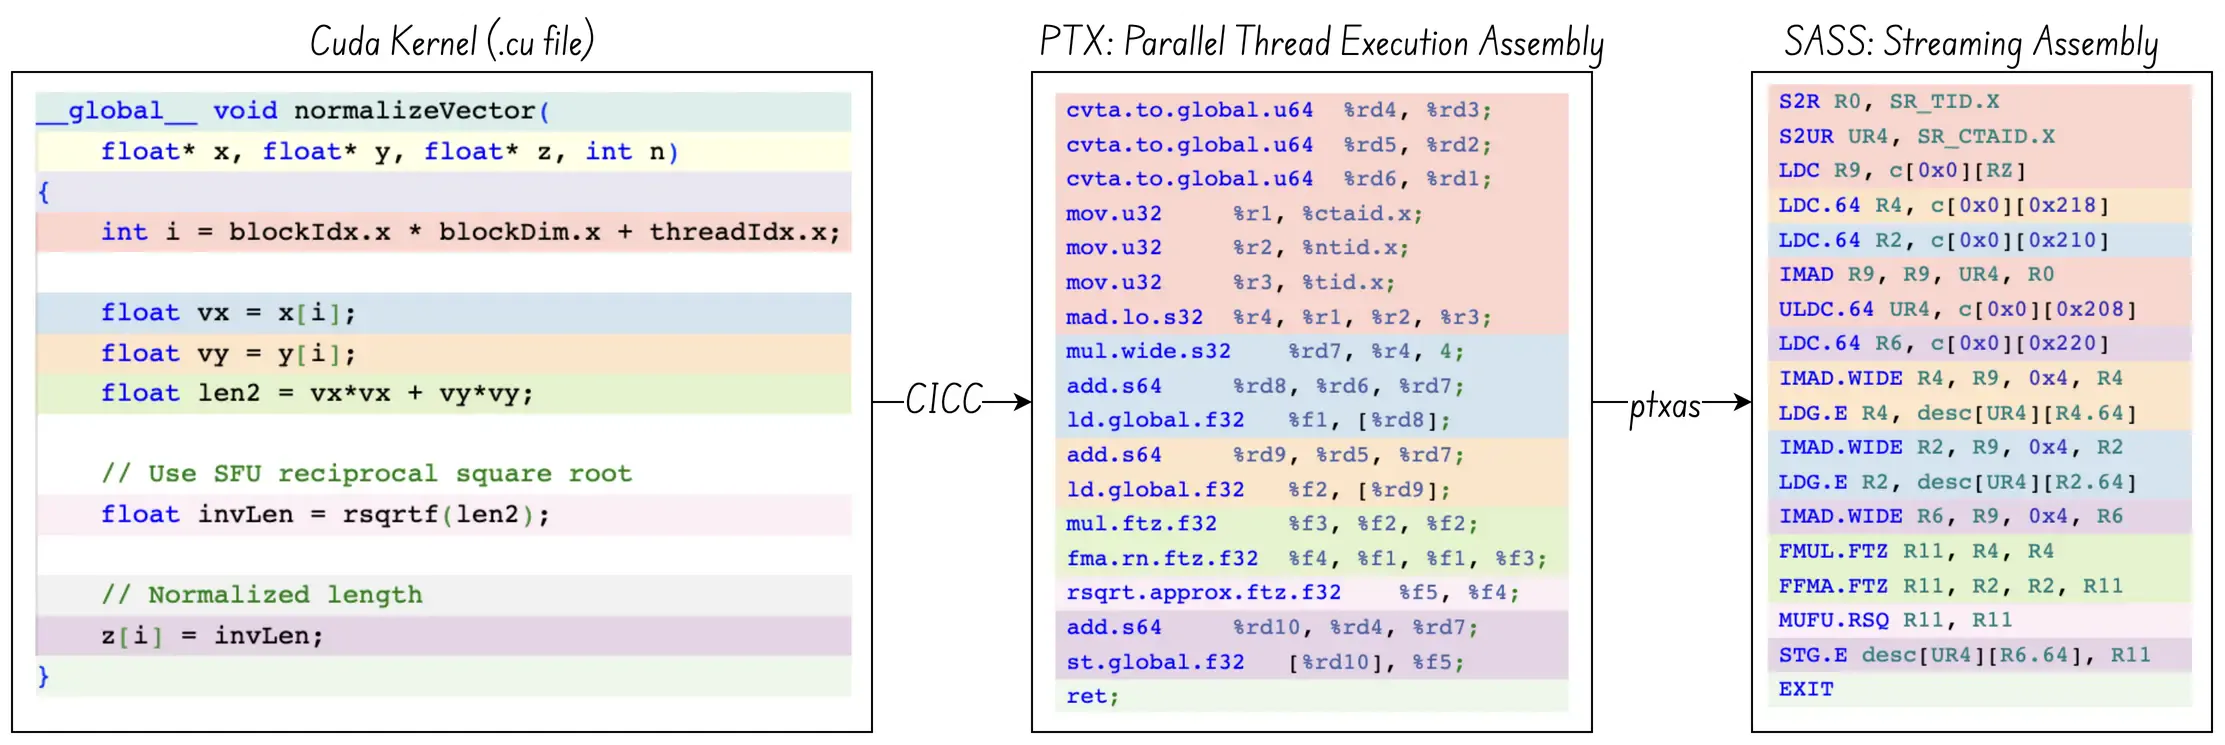
MUFU significa unidad multifuncional, también conocida como SFU, la unidad de función especial. La instrucción MUFU.RSQ envía el registro a través de la tubería de raíz cuadrada de la unidad SFU. Existen muchas otras instrucciones en el lenguaje ensamblador SASS, como FMUL (multiplicación fusionada) o FFMA (multiplicación y acumulación fusionadas), que se envían a la unidad central de tensores. La unidad de despacho se encarga de enviar las instrucciones a la unidad de tubería correcta.
Hay tres cosas que vale la pena destacar:
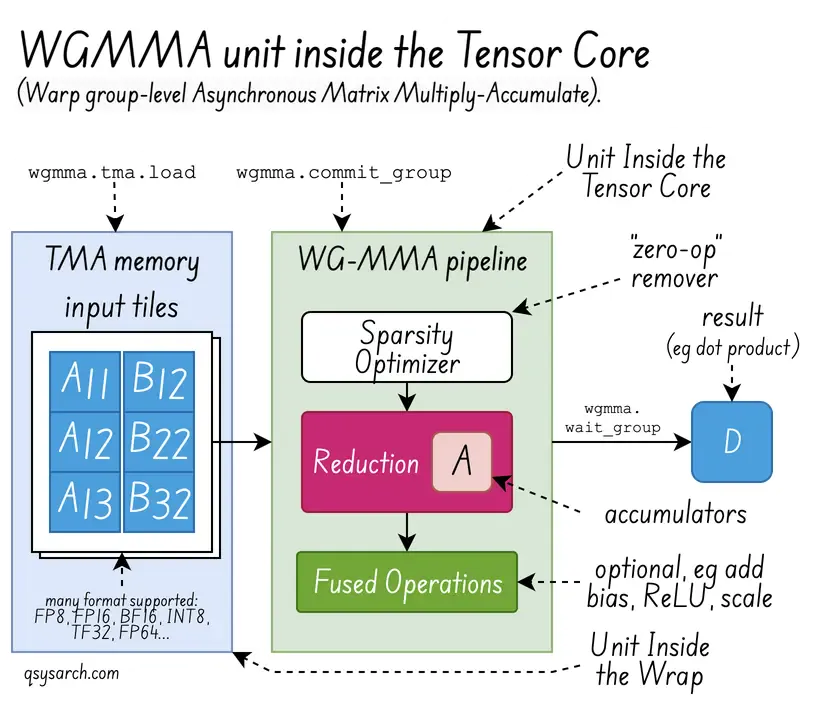
El tensor es mucho más que un multiplicador de matrices general (GEMM): por ejemplo, puede realizar operaciones de reducción (suma, min/max, producto escalar) a través de una unidad MMA (multiplicación-acumulación de matrices) dentro del núcleo del tensor.
La diferencia entre una unidad INT32 y un registro: La unidad es responsable del cálculo (por ejemplo, ADD, SHIFT, XOR, … o, de forma más general, operaciones aritméticas o ALU) mientras que el segundo es responsable de almacenar valores.
Solo hay 16 unidades INT32, pero 32 hilos. Esto no es un error: la razón es que el planificador de hilos alternará entre dos conjuntos de hilos en cada ciclo. Así, en el ciclo 0, las unidades realizarán operaciones de la ALU para los hilos del 0 al 15, y en el ciclo 1, para los hilos del 16 al 31.
Las instrucciones de multiplicación y acumulación de matrices a nivel de grupo de deformación asíncrona (WGMMA) son bastante potentes. Puedes encontrar más información en la documentación de NVIDIA y en el fantástico blog de Aleksa Gordić.
Arquitectura del compilador NVIDIA CUDA
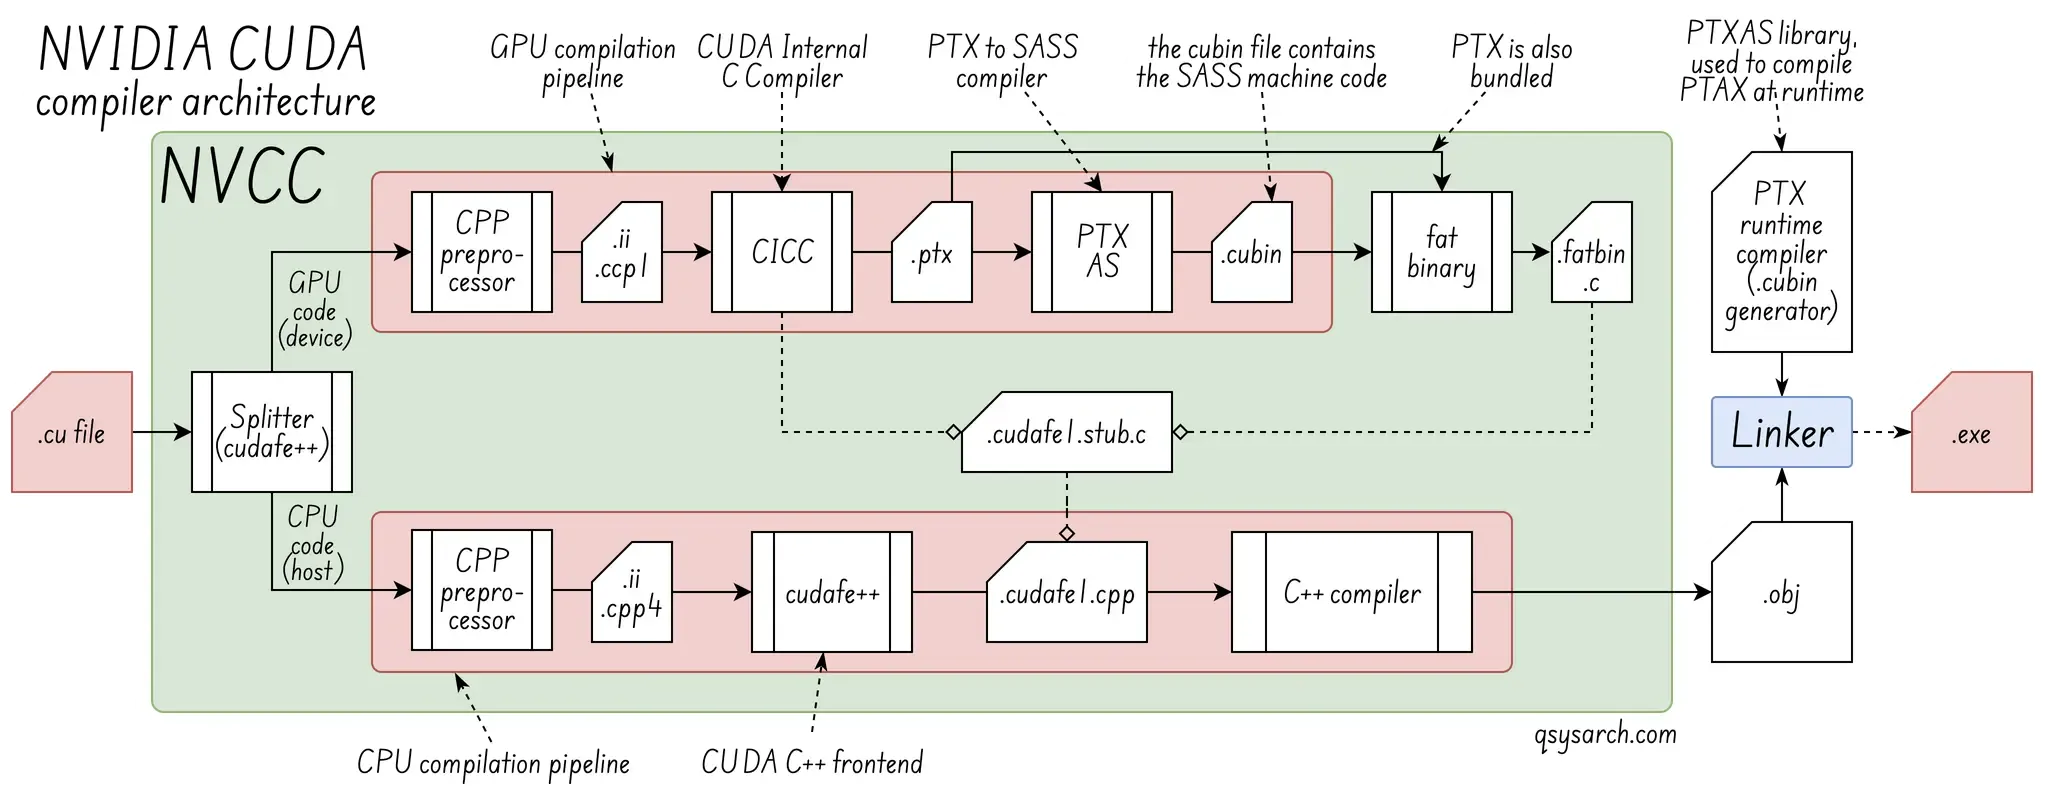
Ahora que entendemos un poco mejor el conjunto de instrucciones de bajo nivel de la GPU para programar el multiprocesador de transmisión de la GPU, intentemos comprender cómo se compilan los kernels de C++ de alto nivel a SASS. Sabemos que el compilador que se utiliza para convertir los kernels de CUDA (archivos .cu) a PTX se llama NVCC.
¿Cuál es la diferencia entre NVCC y LLVM? NVCC es un controlador de compilador especializado que utiliza la infraestructura de compilación de código abierto LLVM como base. En cambio, LLVM es un marco de compilación flexible, a diferencia de NVCC, que es un compilador listo para usar.
Programa controlador: NVCC es un controlador que gestiona el proceso de compilación del código CUDA C/C++. Separa el código del host (CPU) del código del dispositivo (GPU).
Conjunto de herramientas: NVCC es un conjunto de herramientas que utiliza un compilador C++ anfitrión (por ejemplo, GCC/Clang en Linux) para el código de la CPU y un compilador interno específico de NVIDIA (por ejemplo, CICC) para el código de la GPU (PTX y SASS).
Binarios completos: NVCC suele producir “binarios completos” que incluyen tanto el ejecutable del host como el código compilado para la GPU, a menudo con varias versiones para diferentes arquitecturas de GPU.
Marco de trabajo: LLVM es una colección de tecnologías, bibliotecas y herramientas de compilación gratuitas, abiertas, modulares y reutilizables, diseñadas para construir una amplia variedad de compiladores y cadenas de herramientas de lenguaje.
Representación intermedia (IR): LLVM IR es una “capa intermedia” independiente de la máquina que actúa como el enlace universal entre los front-ends (C++, Go…) y los back-ends ISA (x86, ARM…).
Optimización: El optimizador de LLVM aplica varias mejoras de rendimiento (como el desenrollado de bucles y la eliminación de código muerto) al IR, independientemente del lenguaje de origen o la arquitectura de destino.
Cabe destacar que LLVM puede compilar CUDA: el front-end de Clang (parte del proyecto LLVM) puede manejar código CUDA con el back-end LLVM PTX, sin necesidad del controlador nvcc.
Arquitectura del compilador Triton
Link to heading
El lenguaje Triton es un potente lenguaje específico de dominio (DSL) basado en Python, diseñado para ayudar a crear algoritmos vectorizados de alto nivel que se pueden compilar a código paralelizado eficiente para objetivos de GPU.
Este es un ejemplo del kernel más simple, que carga datos de un bloque de memoria y los escribe en otro bloque. El valor de offsets es [pid*BLOCK_SIZE….(pid+1)*BLOCK_SIZE-1]. La magia, que no se muestra en este fragmento, es que Triton puede operar eficientemente en el vector v, por ejemplo, realizando operaciones matemáticas.
import triton.language as tl

@triton.jit
def move_kernel(in_ptr, out_ptr, BLOCK_SIZE: tl.constexpr):
pid = tl.program_id(axis=0)
offsets = pid * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
v = tl.load(x_ptr + offsets)
tl.store(output_ptr + offsets, v)
Triton no se limita a vectores 1D y puede manejar más dimensiones usando tensores. Por ejemplo:
import triton.language as tl

@triton.jit
def load_2d_tensor( input_ptr, output_ptr,
stride_row, stride_col,  # Stride of the input tensor (elements per row, elements per column)
M , N , # Number of rows and columns
BLOCK_SIZE_M,BLOCK_SIZE_N, # Block size for rows and columns
):
# X and Y tile position
pid_m, pid_n = tl.program_id(axis=0), tl.program_id(axis=1)
# Ptr in memory based on the stride
base_ptr = input_ptr + (pid_m * BLOCK_SIZE_M * stride_row) + (pid_n * BLOCK_SIZE_N * stride_col)
# Offsets for X and Y indices
offs_m, offs_n = tl.arange(0, BLOCK_SIZE_M), tl.arange(0, BLOCK_SIZE_N)
offsets_2d = (offs_m[:, None] * stride_row) + (offs_n[None, :] * stride_col)
# 2D loading ...that's magic!
loaded_2d_tensor = tl.load(base_ptr + offsets_2d)
return loaded_2d_tensor
En comparación con CUDA, Triton puede considerarse una abstracción de nivel superior, dedicada a la construcción de núcleos de redes neuronales (gracias al enfoque de bloques tensoriales), y que puede generar código GPU vectorizado y paralelo eficiente. Triton también admite múltiples GPU de backend:
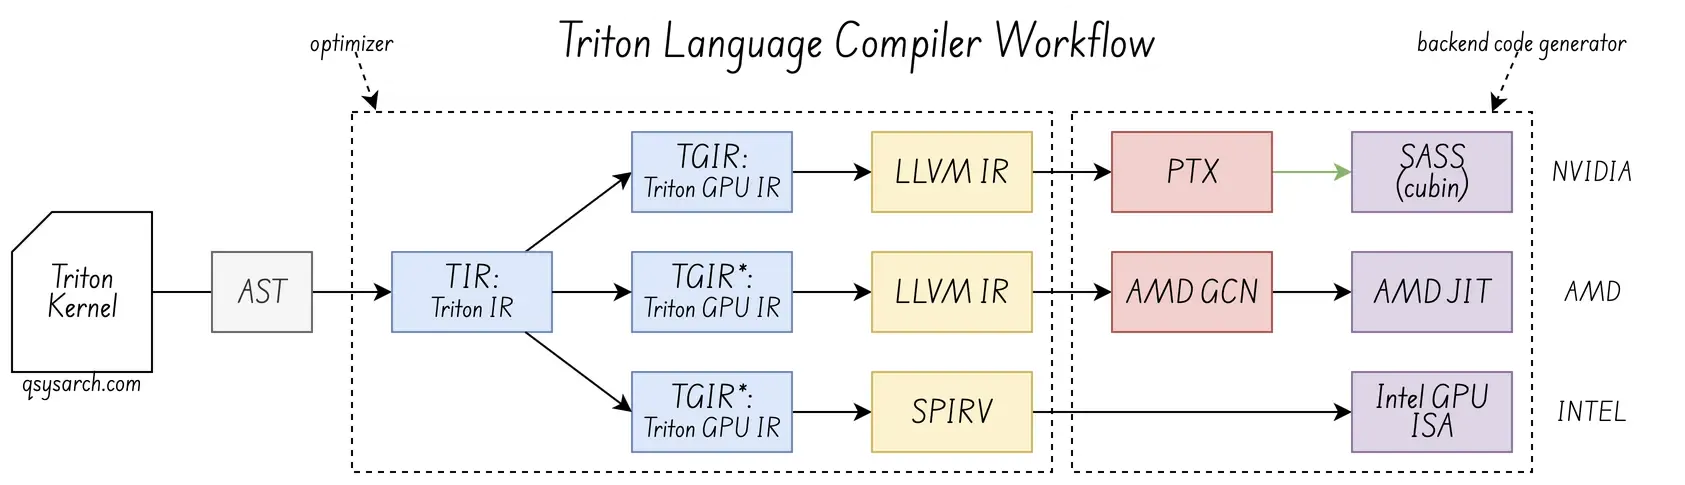
Triton no utiliza su propio analizador sintáctico. En su lugar, se basa en el entorno de ejecución y el AST de Python, y luego convierte ese AST en sus propias representaciones intermedias, TIR y TGIR, antes de generar el código para la GPU. El enlace entre el compilador de backend de CUDA y el compilador de frontend de Triton es el LLVMIR universal, y para las GPU de Intel se basa en SPIRV (aunque no estoy seguro de si TGIR se convierte directamente a SPIRV, en lugar de pasar por el LLVMIR intermedio).
Escribí “algoritmos vectorizados”, aunque el concepto central se centra más en modelos a nivel de bloque, en mosaico:
 El mosaico es el mecanismo principal. El modelo mental de Triton gira en torno a operaciones de programación en pequeños subconjuntos multidimensionales de forma estática, o “mosaicos”, que el compilador paraleliza automáticamente en los núcleos de la GPU.
La vectorización, entendida como la carga y el almacenamiento de múltiples elementos de datos en una sola instrucción, es una optimización: el compilador la utiliza como una estrategia clave de optimización interna para implementar eficientemente estos bloques en el hardware subyacente. Este concepto se alinea con las estrategias de teselado anidado (véase la figura de la derecha), cuyo objetivo es descomponer los bloques en microbloques y, finalmente, en nanobloques para que se ajusten lo mejor posible a las capacidades de cómputo y la jerarquía de memoria de la máquina.
Triton Language Reducción de etapas a Streaming Assembly
Link to heading
Veamos cómo se traduce la instrucción de alto nivel tt.load del lenguaje Triton a SASS. (Nota: El código que aparece a continuación es pseudocódigo y no funciona como tal).
La etapa inicial, tras analizar el AST de Python, es el Triton IR (TIR, un dialecto de MLIR) independiente de la máquina. En este nivel, se define una operación tt.load en un bloque de memoria, y esta operación es una instrucción de alto nivel, no optimizada, que expresa la carga de memoria de un bloque completo. El bloque puede ser un array simple, un array bidimensional o incluso uno de cualquier dimensión.
// simplified, illustrative TTIR fragment for 2 dimensionnal array
// load of 32 bits floating point values (without masks)
%ptrs = ...              : tt.tensor<MxN, ptr<global f32>>
%vals = "tt.load"(%ptrs) : (tt.tensor<MxN, ptr<global f32>>) -> tt.tensor<MxN, f32>
La operación de alto nivel tt.load sobre un puntero tensorial y un bloque de datos (mosaico). El primer parámetro de entrada %ptrs es tensor (matriz de n dimensiones) representado por tensor <MxN, ptr<global f32> >. Devuelve un tensor de la misma dimensión, pero con valores en lugar de punteros a valores.
En la práctica, la función tt.load también acepta un parámetro de máscara y un valor predeterminado, necesarios para leer desde los límites de la memoria (en caso de que las dimensiones del vector no estén alineadas con el paso).
%ptrs = ... : tensor<MxN, ptr<global f32>>
%mask = ... : tensor<MxN, i1>         // in-bounds mask (optional)
%fallback = constant 0.0 : f32
%vals = "tt.load"(%ptrs, %mask, %fallback) : (tensor<MxN, ptr<global f32>>, tensor<MxN, i1>, f32) -> tensor<MxN, f32>
En la siguiente etapa, se utiliza el IR de Triton-GPU para convertir diseños de tensores genéricos en diseños específicos del hardware, especialmente en lo que respecta a la distribución de la memoria entre hilos y warps. En otras palabras, TGIT transforma la carga multidimensional en operaciones de carga vectorial por hilo, que son más fáciles de implementar en LLVM.
// TGIR (illustrative)
%vec_ptr = tt.get_contiguous_vector_ptr %ptrs, vec_len=4
%vec_vals = ttg.load.global.v4f32 %vec_ptr  // a vectorized 4-wide global load
%vec_vals_cast = f32x4 -> f32  // unpack to tensor<MxN, f32> shape
El código intermedio (IR) de la GPU Triton se convierte en instrucciones por hilo representadas en el código intermedio de LLVM. Este código intermedio de bajo nivel representa fielmente las instrucciones de máquina finales y utiliza operaciones estándar de LLVM, como aritmética de punteros, cargas de memoria y primitivas de sincronización. La abstracción tensorial prácticamente desaparece, sustituyéndose por operaciones individuales de acceso a memoria para cada hilo.
// Example LLVM IR snippet (conceptual)
%thread_ptr = getelementptr inbounds float, ptr %base_ptr, i64 %thread_offset
%value = load float, ptr %thread_ptr, align 4
Representación: La carga de los bloques se divide en una serie de instrucciones de carga individuales con aritmética de punteros para el/los elemento(s) de datos específicos de cada hilo, y posiblemente operaciones de memoria compartida si se utilizó memoria compartida como área de preparación.
Cuando el backend de LLVM se dirige a las GPU de NVIDIA, el siguiente paso es convertirlas a PTX. Las instrucciones de carga de LLVM se asignan directamente a las instrucciones de carga de PTX correspondientes.
// Example PTX snippet
ld.global.f32 %r1, [%thread_ptr]; // Load from global memory
// Or if staged via shared memory:
ld.shared.f32 %r1, [%shared_ptr];
Finalmente, el compilador de controladores de NVIDIA (ptxas) convierte el código ensamblador PTX en SASS (Streaming Assembly), el código máquina nativo que ejecutan los núcleos de la GPU. Como se mencionó anteriormente, este paso generalmente se realiza justo a tiempo (JIT).
// Example SASS snippet (conceptual, might involve specific opcodes)
MOV R1, ...
LDG.E.32 R1, [R0]; // Load from global memory
Un aspecto a destacar es que CUDA es una forma muy práctica de generar código máquina para las GPU de NVIDIA. Triton utiliza CUDA al convertir de PTX a SASS. Esta conversión a PTX se realiza desde LLVM IR, pero requiere las bibliotecas incluidas en el kit de herramientas CUDA (por ejemplo, libdevice.bc).
 DeepSeek adoptó otro enfoque y optó por la optimización manual de PTX: se escribieron a mano ayudantes de kernel PTX personalizados, tratando PTX como el lenguaje ensamblador para la GPU. DeepSeek no dependió de un compilador de propósito general para generar este código específico y altamente no estándar. Triton, por el contrario, al ser un lenguaje genérico, utiliza el backend del compilador LLVM estándar con el destino NVPTX para traducir automáticamente su representación intermedia (Triton-IR/MLIR) en código ensamblador PTX optimizado.
 Envoltorio de búsqueda profunda en csrc/kernels/utils.cuh usando la instrucción mbarrier.try_wait
¿Por qué es importante esto? Citado del informe técnico de DeepSeek [https://arxiv.org/html/2412.19437v1]: Específicamente, nosotros (DeepSeek) empleamos instrucciones PTX (Parallel Thread Execution) personalizadas y ajustamos automáticamente el tamaño del bloque de comunicación, lo que reduce significativamente el uso de la caché L2 y la interferencia a otros SM. ¿Significa esto que el backend NVPTX de LLVM no es óptimamente eficiente? Para mí, esto significa que hay margen para más optimizaciones, pero no solo a nivel de LLVM, sino también para exponer mejor el ISA! ¡Es una situación beneficiosa para todos!
¡Listo! Este memorándum me ha llevado más tiempo del previsto. Sin embargo, se trata de un estudio preliminar imprescindible antes de presentar la arquitectura de Cuda-Q. Actualizaré esta publicación cuando esté lista.
 (crédito de la imagen: LLVM MOS)
Diagramas de DrawIO utilizados en este memorándum: