Recientemente me topé con el concepto de Ingeniería de Capacidad y Eficiencia, que es la disciplina de diseñar y operar sistemas de manera óptima. Es un pilar clave de la arquitectura de sistemas y es especialmente importante cuando la escala es crucial, como en los sistemas de computación cuántica.
En resumen, la ingeniería de capacidad y eficiencia es la ciencia o disciplina que optimiza la producción. Esto se logra equilibrando la producción máxima (capacidad) con el consumo de recursos (eficiencia).
Lo positivo de la Ingeniería de Capacidad y Eficiencia (ECE) es que se trata de un campo bien definido, ampliamente documentado en la literatura y respaldado por prácticas de ingeniería bien estructuradas. Este documento pretende extraer algunos conceptos clave utilizados en la ECE.
Pilares de ingeniería de capacidad y eficiencia
Link to heading
La ingeniería de capacidad y eficiencia se basa en tres pilares fundamentales: observabilidad, modelado y planificación.
Observabilidad
Modelado
Planificación
El objetivo final es crear un plan que pueda simularse eficazmente mediante un modelo. Este modelo debe validarse con observaciones empíricas. Al modelar el crecimiento, identificar los cuellos de botella y asignar los recursos estratégicamente, el plan previene la sobrecarga o la subutilización, lo que garantiza un funcionamiento óptimo del sistema.
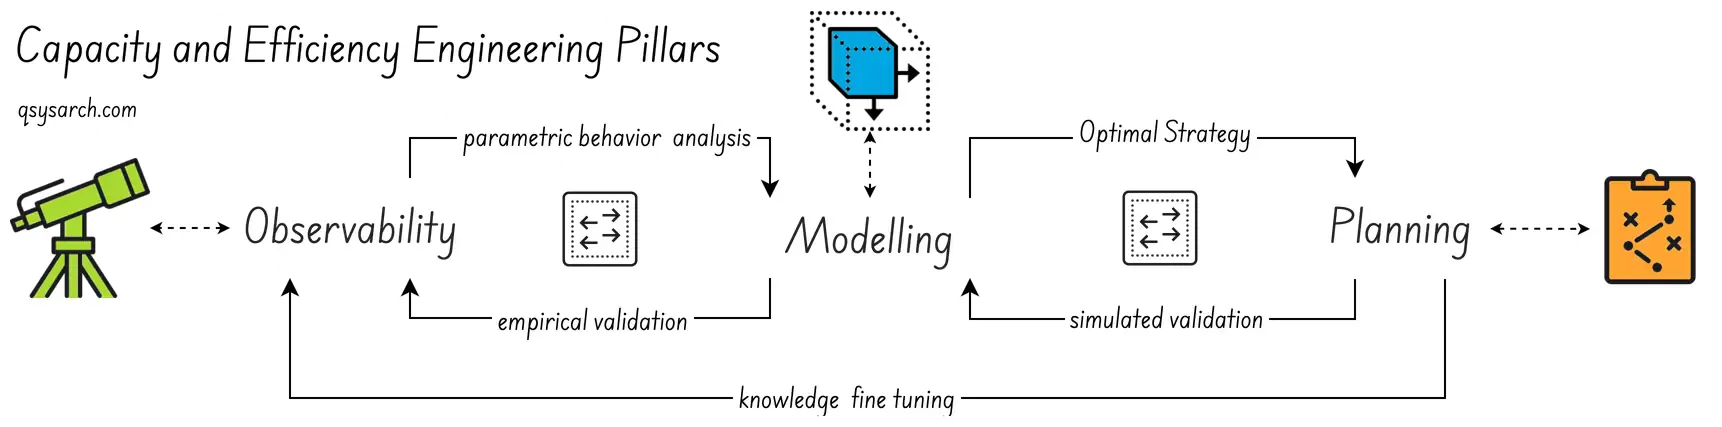
Cabe destacar que el recurso del sistema puede ser cualquiera. Podría abarcar desde recursos informáticos como la CPU o la memoria hasta personal o maquinaria. De hecho, CEE se puede aplicar en diversas áreas. Por ejemplo, puede ayudar a optimizar la asignación de personal en la gestión de proyectos o a reducir los costos de alojamiento en la nube en la gestión de infraestructura.
La observabilidad es el análisis empírico de un sistema. En los sistemas informáticos, los registros suelen confundirse con la observabilidad, pero son solo una parte del panorama. Por ejemplo, el estándar OpenTelemetry abarca múltiples señales observables: registros, métricas, trazas y datos adicionales. Para CEE, una observabilidad efectiva debería proporcionar:
Uso de recursos: Observar y realizar un seguimiento del consumo de recursos. La observación debe especificar qué, cuándo y quién utiliza el recurso, y si se produjo algún error.
Métricas de rendimiento: Seguimiento de indicadores clave de rendimiento (KPI), como la latencia y el rendimiento. Incluyendo tasas de rendimiento, desperdicio o errores.
Identificación de cuellos de botella: Determinar las limitaciones del sistema que degradan el rendimiento.
La clave reside en poder realizar un análisis post mortem del sistema, en todas las condiciones —ya sea durante cargas pesadas, mantenimiento o periodos de inactividad—. Es fundamental comprender en detalle qué sucedió, cuándo y por qué. Sin estos datos observables, sería imposible identificar las causas raíz de la falla del sistema.
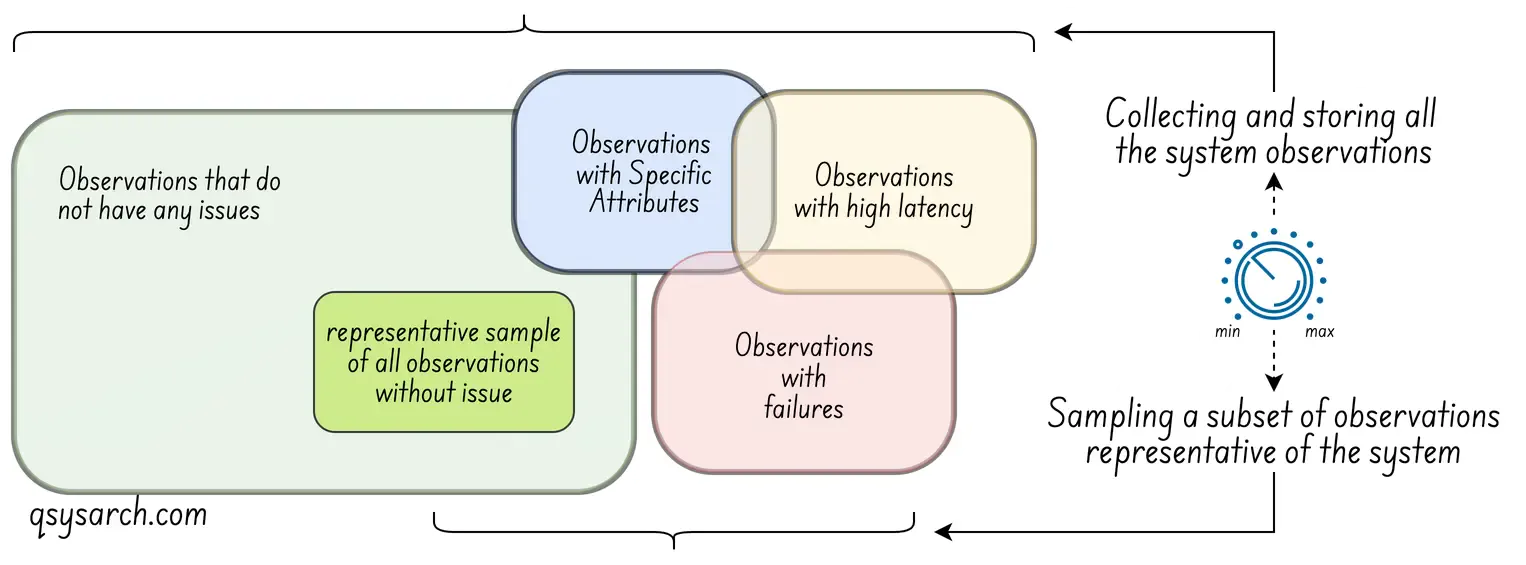
Por supuesto, recopilar la observación completa de un sistema presenta un desafío: las observaciones pueden ser muy costosas, o incluso destructivas (como en el caso de la computación cuántica, donde medir un sistema puede cambiar su estado, un fenómeno conocido como efecto observador). Esto significa que el simple acto de observar el sistema puede alterar su comportamiento y degradar su rendimiento. La solución es el muestreo (recopilar datos solo de algunos eventos en lugar de todos). La idea es convertir la tasa de muestreo (frecuencia de recopilación de datos) en un parámetro ajustable del sistema, como se muestra en el diagrama a continuación (créditos: OpenTelemetry).
En un sistema no informático, una observabilidad efectiva permitiría, por ejemplo, explicar el motivo del retraso de un proyecto. Los datos observables serían probablemente los documentos técnicos y no técnicos exigidos por la norma ISO 9001 que explican las decisiones rastreables tomadas durante cada fase del proyecto.
Una vez establecida la observabilidad, se puede comenzar a comprender el comportamiento paramétrico analítico del sistema. Este comportamiento constituye la base del siguiente pilar: se puede describir y traducir en un modelo paramétrico. El siguiente paso consiste en aclarar qué debe proporcionar dicho modelo, dado un conjunto de parámetros o condiciones.
Rendimiento: ¿Cuál es el rendimiento y la latencia máximos que puede proporcionar el sistema?
Costo operativo: ¿Cuánto cuesta operar el sistema, en función del número de recursos asignados? Este costo puede variar según la hora del día.
Reconfiguración: ¿Cuál es el impacto transitorio (efectos temporales) de actualizar los parámetros del sistema? Por ejemplo, al asignar un nuevo servidor o QPU y configurarlo correctamente.
La clave reside en simular el comportamiento del sistema y observar su rendimiento bajo diferentes condiciones de operación. Dado que el modelo incluye los costos de los recursos, puede mostrar las compensaciones de costos en dichas condiciones. Esta información es importante para la fase de planificación.
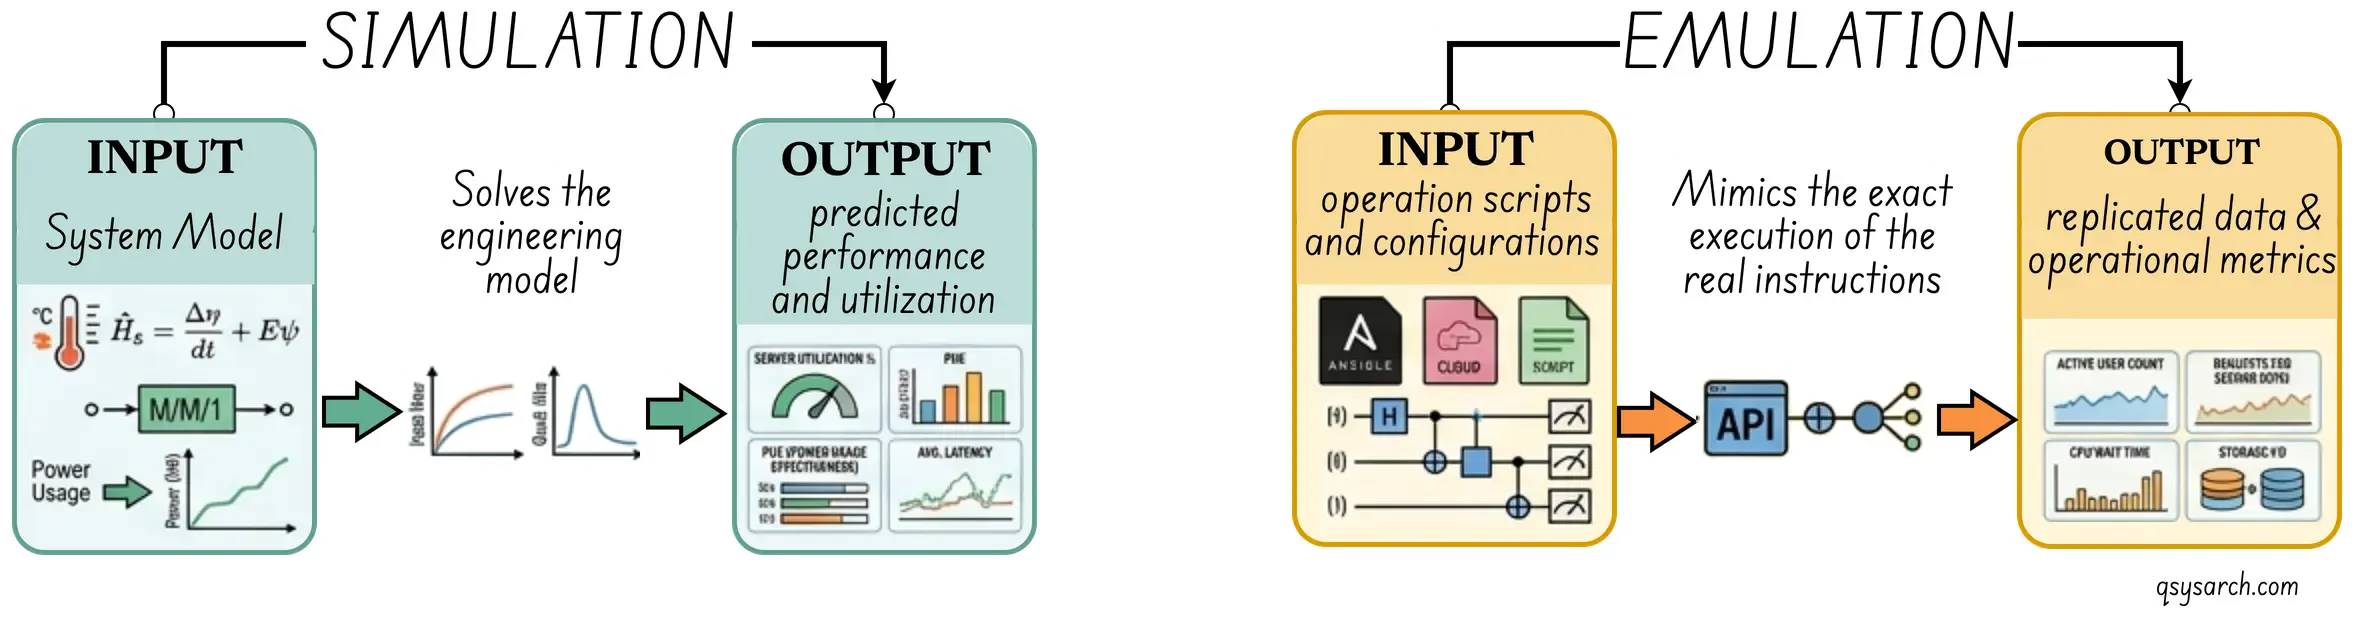
Cabe mencionar aquí la diferencia entre simulación y emulación. En términos generales, la emulación crea una versión simulada del sistema, mientras que la simulación opera sobre un modelo abstracto del mismo. Con la emulación, es posible comparar el rendimiento emulado con el rendimiento real, ya que las entradas son las mismas. Asumo que, en el contexto de CEE, el modelo se refiere principalmente a un simulador.
Un buen modelo para un sistema no informático podría predecir los efectos de añadir más recursos a un proyecto. Y, en efecto, a veces, añadir recursos disminuye el rendimiento del sistema. Este resultado contraintuitivo se conoce como la Ley de Brooks.
Con el modelo en mano, puede comenzar a planificar las operaciones del sistema. Utilice el modelo para simular diversas condiciones y encontrar las óptimas. Use estos resultados para asignar estratégicamente los recursos a la demanda. Un buen plan debe incluir pronósticos de la demanda, gestión de costos y mecanismos de seguridad. Los pronósticos predicen el uso, el tráfico o las necesidades futuras. Los controles de costos evitan el sobredimensionamiento, manteniendo la capacidad para los momentos de mayor demanda. Los mecanismos de seguridad proporcionan márgenes para gestionar demandas inesperadas.
La clave reside en operar el sistema de forma eficiente y fiable. Gestionar las cargas máximas sin fallos. Garantizar la rentabilidad. La capacidad prevista permite una reconfiguración proactiva. Proporcionar un margen suficiente para afrontar imprevistos.
El plan combina el mejor escenario posible, donde la demanda es la prevista, y el peor escenario posible, donde la demanda es mayor o menor de lo previsto. Este enfoque permite una asignación de capacidad óptima en términos de costos.
El dilema del huevo y la gallina
Link to heading
Diseñar un buen modelo es un dilema del huevo y la gallina. Si no se sabe qué observar y cómo observarlo en el sistema, es difícil construir un modelo eficiente y preciso. Sin un modelo preciso, es improbable que el plan dé buenos resultados.
Cuando se producen discrepancias entre el plan simulado y el comportamiento real, se intenta encontrar los parámetros que faltan. Esto suele hacerse analizando los registros del sistema observado a posteriori. El objetivo es identificar nuevos parámetros que se deben observar.
Este ciclo de aprendizaje se representa como ajuste fino del conocimiento en el diagrama anterior.
CEE por sí sola no sería suficiente sin una plataforma automatizada que respalde todo su flujo de trabajo. Esta plataforma de ingeniería se representa en el siguiente diagrama.
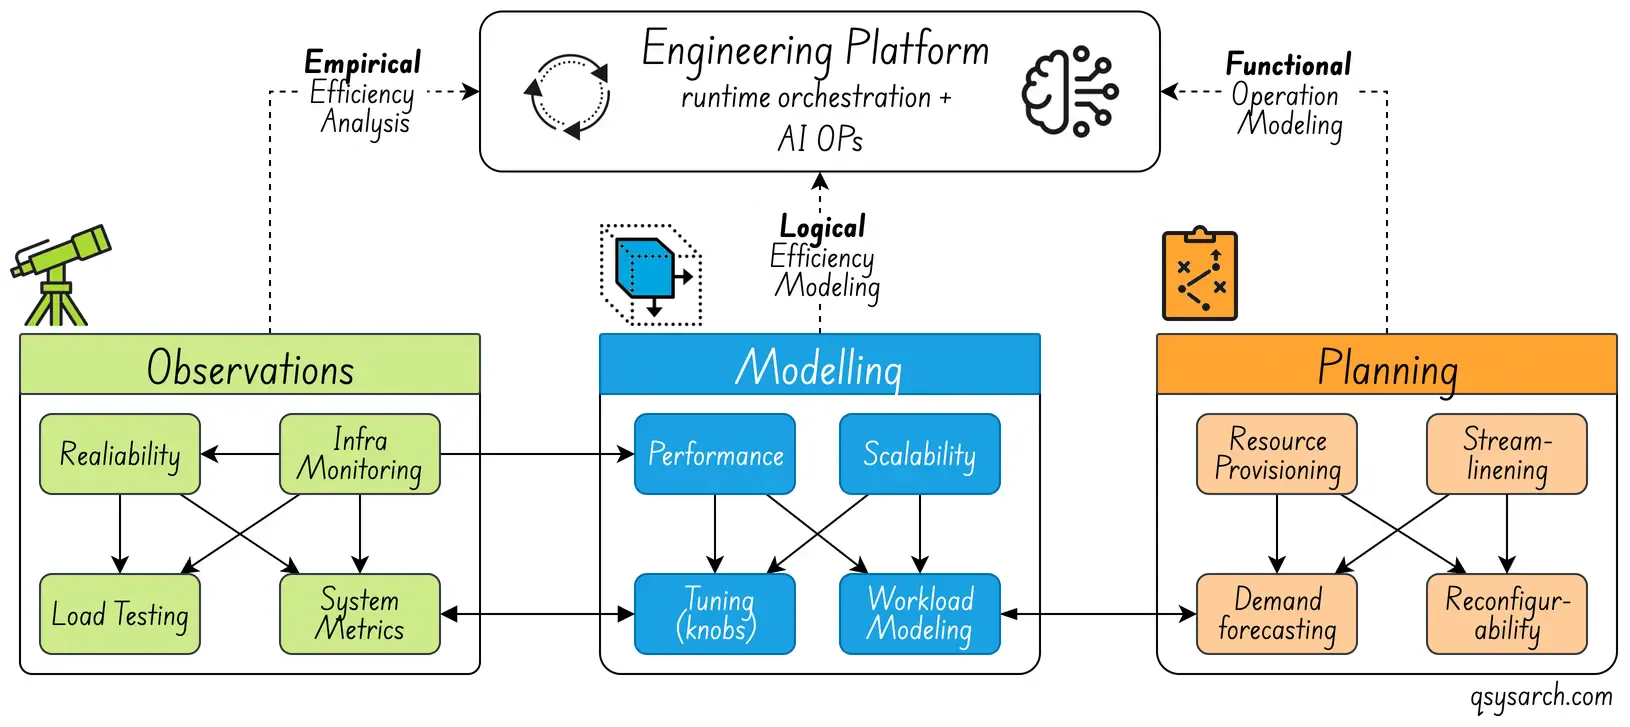
La idea de la plataforma de ingeniería no es solo automatizar el proceso de escalado del sistema, que puede delegarse a agentes de Ai Ops, sino también verificar continuamente la idoneidad del modelo simulado con respecto a observaciones empíricas y retroalimentar las discrepancias a un agente de aprendizaje automático que pueda ajustar el modelo. Es probable que este agente sea un agente basado en aprendizaje por refuerzo, que debería estar gobernado si se utiliza en tiempo real.
El coste de no escalar lo suficientemente rápido, también conocido como el coste de la demora.
Link to heading
Para que un sistema sea estable y robusto, el rendimiento debe limitarse a niveles estables, no a los máximos. Como regla general, el rendimiento estable se sitúa en torno a dos tercios del rendimiento máximo. Superado este umbral, el sistema se degrada. El coste del tiempo de inactividad puede entonces superar rápidamente —a menudo de forma exponencial— el coste del sobredimensionamiento.
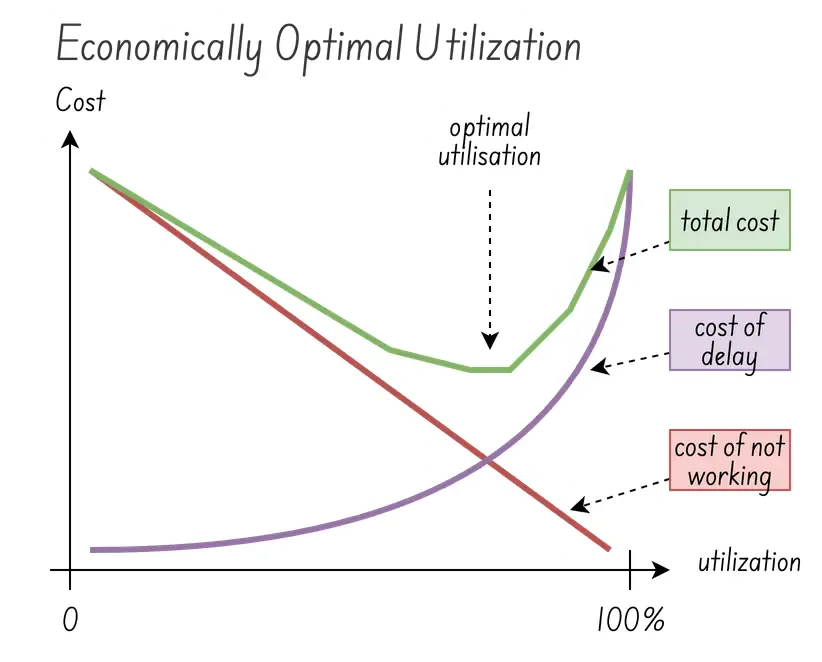
En la imagen de la derecha, el costo de la demora puede considerarse como el impacto financiero de no poder atender la demanda mientras se amplía el sistema (en tiempo real). Este es un costo transitorio. Cuando la utilización es baja, la demora afecta solo a unas pocas demandas. Pero cuando la utilización es alta, la demora afecta a muchas demandas y el costo de la demora aumenta exponencialmente.
El punto óptimo es la utilización ideal que minimiza tanto el coste de la demora como el coste de la inactividad (sobreaprovisionamiento). La curva verde muestra el coste total como la suma de estos dos factores. El mínimo local de esta curva, generalmente alrededor de 2/3 del rendimiento máximo, marca la utilización óptima. En realidad, hay mucho más que decir sobre el punto óptimo, que seguramente algunos argumentarán que ronda el 80%. La clave está en comprender que reducir el coste de la demora mediante la optimización del sistema permite aumentar la utilización óptima (créditos de la imagen: show me the data).
Si reducir el coste de un fallo en un sistema implica minimizar el tiempo necesario para escalarlo, imagínese un sistema que pueda ajustarse en milisegundos, o incluso microsegundos, para aumentar su escala y satisfacer la demanda. Por supuesto, desarrollar un sistema así puede ser muy costoso (pensemos en el trading de alta frecuencia). Pero, ¿y si el coste de desarrollar dicho sistema fuera menor que el beneficio de poder operarlo con una mayor utilización?
Este desafío también forma parte de la CEE. Al modelar el costo de mejorar el sistema, es posible crear un plan que equilibre el costo de la mejora con el beneficio. Se trata menos de un desafío operativo y más de una inversión estratégica. Sin embargo, se rige por los mismos principios de la CEE aplicados a la estrategia operativa de la empresa, entendida como un sistema.
En el contexto de la ingeniería de capacidad y eficiencia, el mapeo del flujo de valor (VSM, por sus siglas en inglés) se utiliza comúnmente como herramienta de diagnóstico para determinar dónde se consume la capacidad, lo que permite identificar las causas fundamentales del desperdicio y los cuellos de botella.
Un flujo de valor es cada paso o actividad en el flujo de trabajo que utiliza el sistema para prestar un servicio, y el mapa es una representación visual de este flujo de extremo a extremo. El VSM distingue entre tres tipos de actividades:
Valor añadido (VA): Pasos que contribuyen directamente al resultado que el cliente desea (por ejemplo, el cálculo real).
Pasos necesarios pero que no aportan valor añadido (NNVA, por sus siglas en inglés): Pasos requeridos por el sistema pero que no aportan ningún valor directo al cliente (por ejemplo, apretones de manos).
Desperdicio (Muda, o 無駄, un término japonés que significa “desperdicio”): Pasos que consumen capacidad sin agregar ningún valor.
El objetivo es eliminar los pasos Muda, y VSM destaca por identificarlos. El poder de VSM reside en su capacidad para identificar las optimizaciones adecuadas que pueden reducir el trabajo en curso (WIP). Esto es importante debido a la Ley de Little, que establece que el tiempo de entrega promedio (o tiempo de ciclo) es igual al trabajo en curso (WIP) promedio dividido por el rendimiento promedio:
Plazo de entrega = Trabajo en curso / ProducciónEsto significa que si el inventario en proceso (WIP) se duplica, el plazo de entrega también se duplica, incluso si el rendimiento se mantiene igual. Por lo tanto, controlar el WIP es una de las herramientas más directas para mejorar la latencia de entrega (el “retraso”) y, en consecuencia, la eficiencia del sistema.
¡Listo! Este breve informe dominical sobre Ingeniería de Capacidad y Eficiencia (CEE) me ayudó a comprender mejor el tema. Por ahora, lo que quiero recordar es que, cuando un sistema presenta una eficiencia muy baja, es muy probable que sea una señal de que el sistema, o sus flujos de trabajo, están sobrecargados de Muda. ¿La solución a este problema? ¿Invertir en reducir el costo de la demora en lugar de sobredimensionar los recursos?
References:
DrawIO diagrams used in this memo:
Curious about the relative perspective of various AI agents on CCE? Here is the summary:
| Dimension | Gemini | ChatGPT | Claude | Copilot |
|---|
| Primary lens | People & teams | Systems & infra. | Industry & operations | Reliability & scale |
Key
methods | VSM, WIP limits, Agile, CI/CD | Load testing, stress testing, metrics | Lean, Six Sigma, continuous improvement | Stress testing, bottleneck analysis |
Unique
angle | Burnout & work-life balance as a metric | Over/under provi-sioning as core risk | Traditional industry methods (no tech slant) | “Prevent bottlenecks before they happen” |
Metrics
emphasis | Cycle time, deployment frequency | Throughput, latency, cost per request | Utilization rates, cycle times | Workload forecasts, scaling thresholds |