xPU: Es un término genérico para una Unidad de Procesamiento (PU) especializada, donde “x” puede representar cualquier arquitectura de computación personalizada para una carga de trabajo específica. Las variantes comunes incluyen GPU (gráficos), TPU (tensor/IA), NPU (neuronales), DPU (datos) o PPU (pulsos, principalmente utilizadas para pilas de control cuántico).
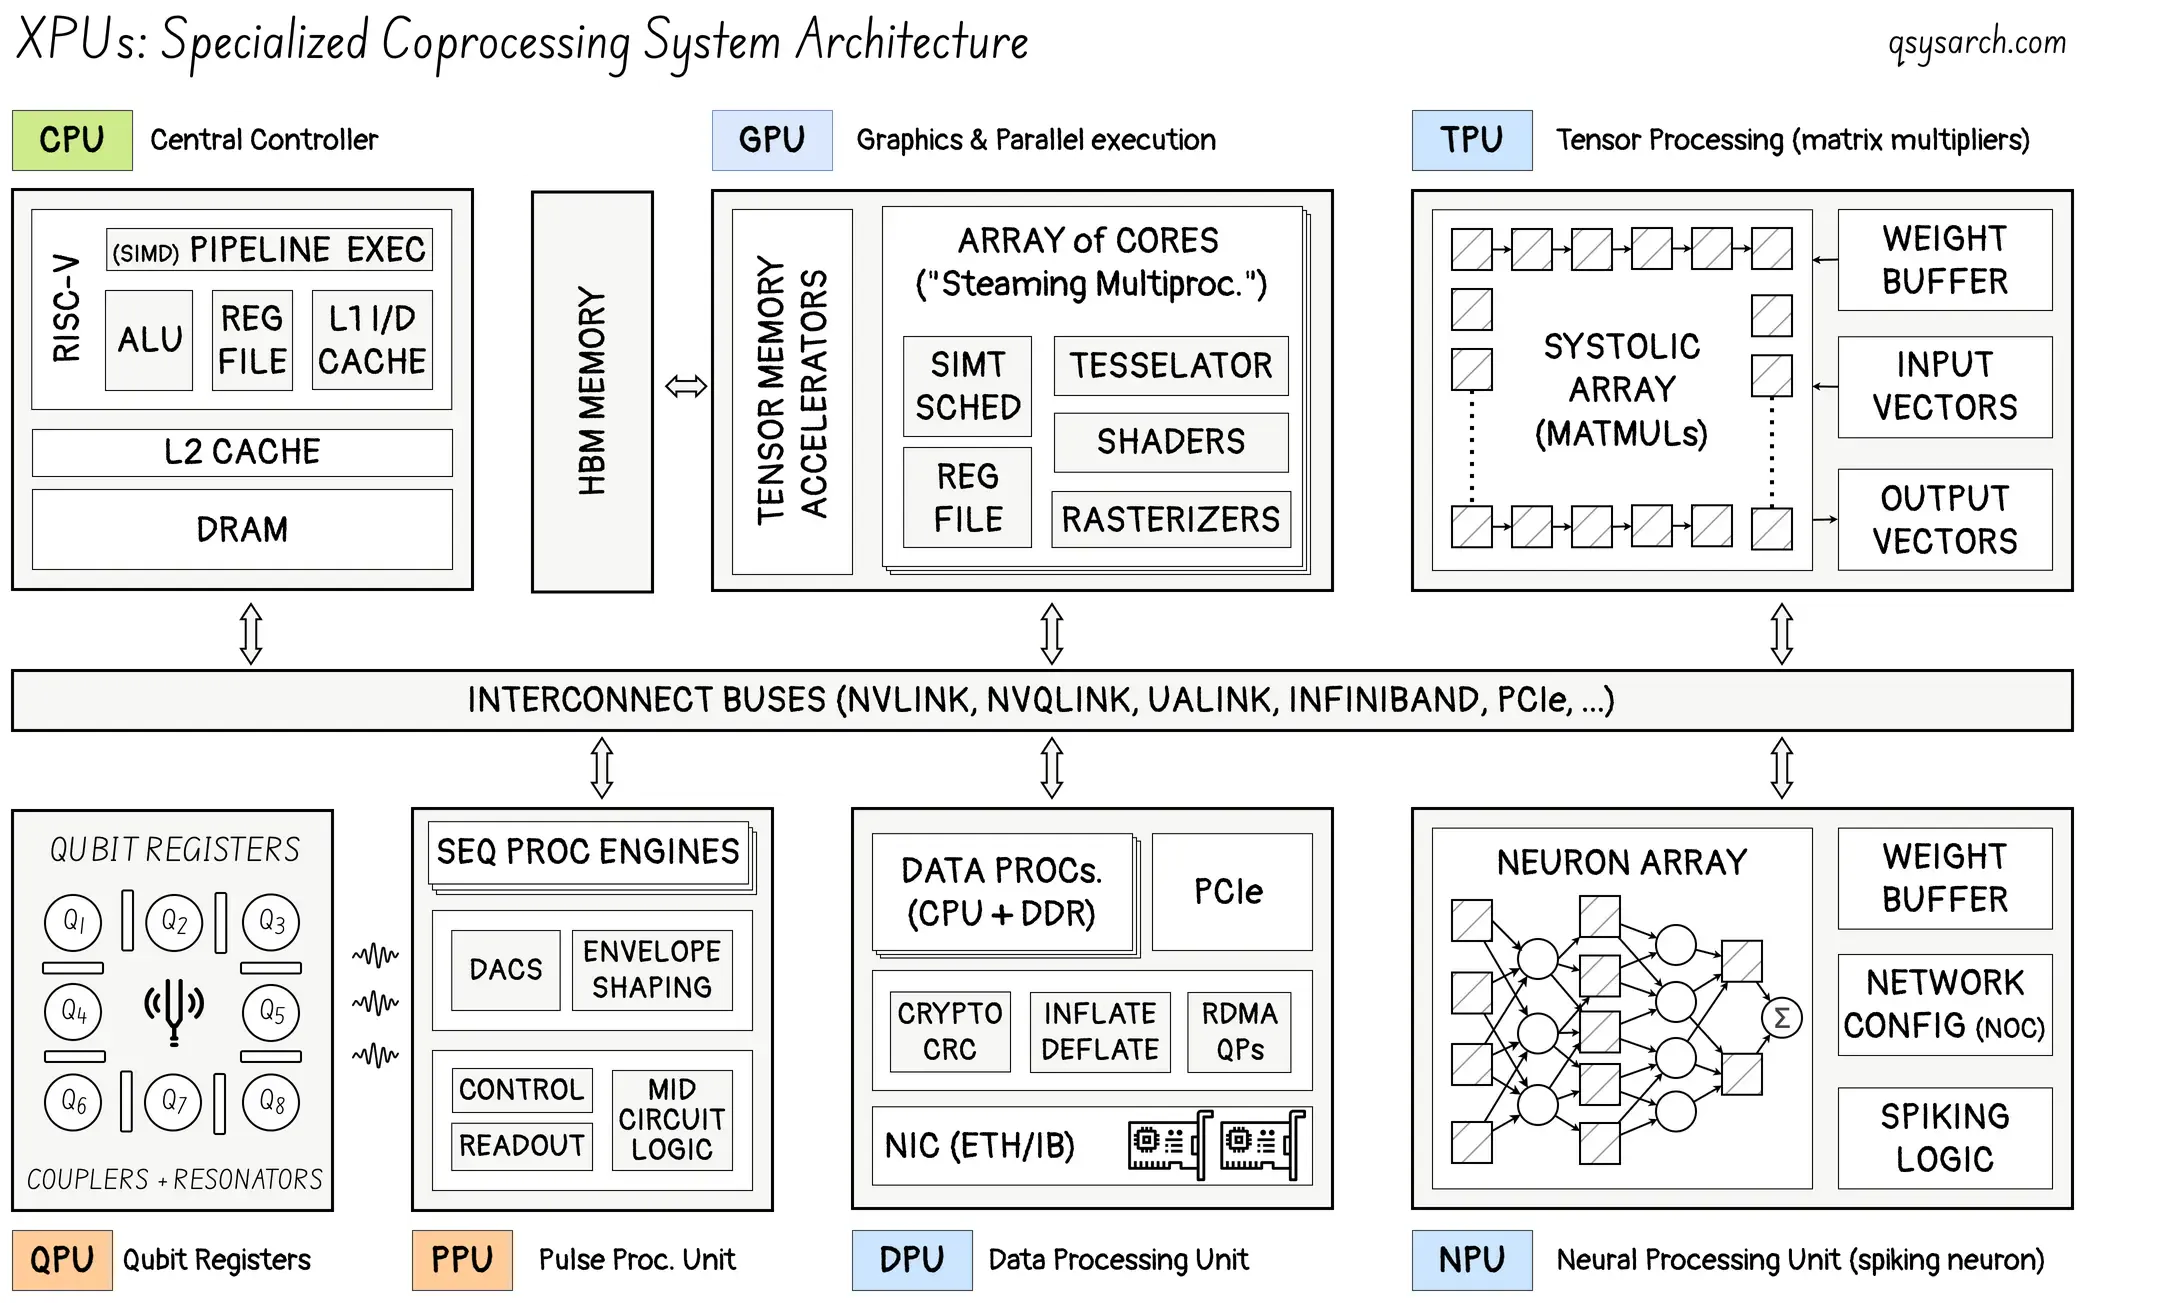
Este breve informe tiene como objetivo proporcionar información sobre el panorama del mercado de xPU aplicado a la inferencia de IA.
Al analizar el panorama del mercado de ASIC de inferencia de IA, el eje más útil puede no ser el rendimiento bruto, sino si la diferenciación de un proveedor es defendible en un horizonte de 3 a 5 años. Desde esta perspectiva, surgen tres grupos:
La plataforma universal: NVIDIA y los integradores verticales: AMD, Google
los retadores actuales Groq, Cerebras, FuriosaAI, Positron, SambaNova, Axelera AI.
Los desafíos futuros: Extropic, Normal Computing, Unconventional, Mottronix, Akhetonics
NVIDIA
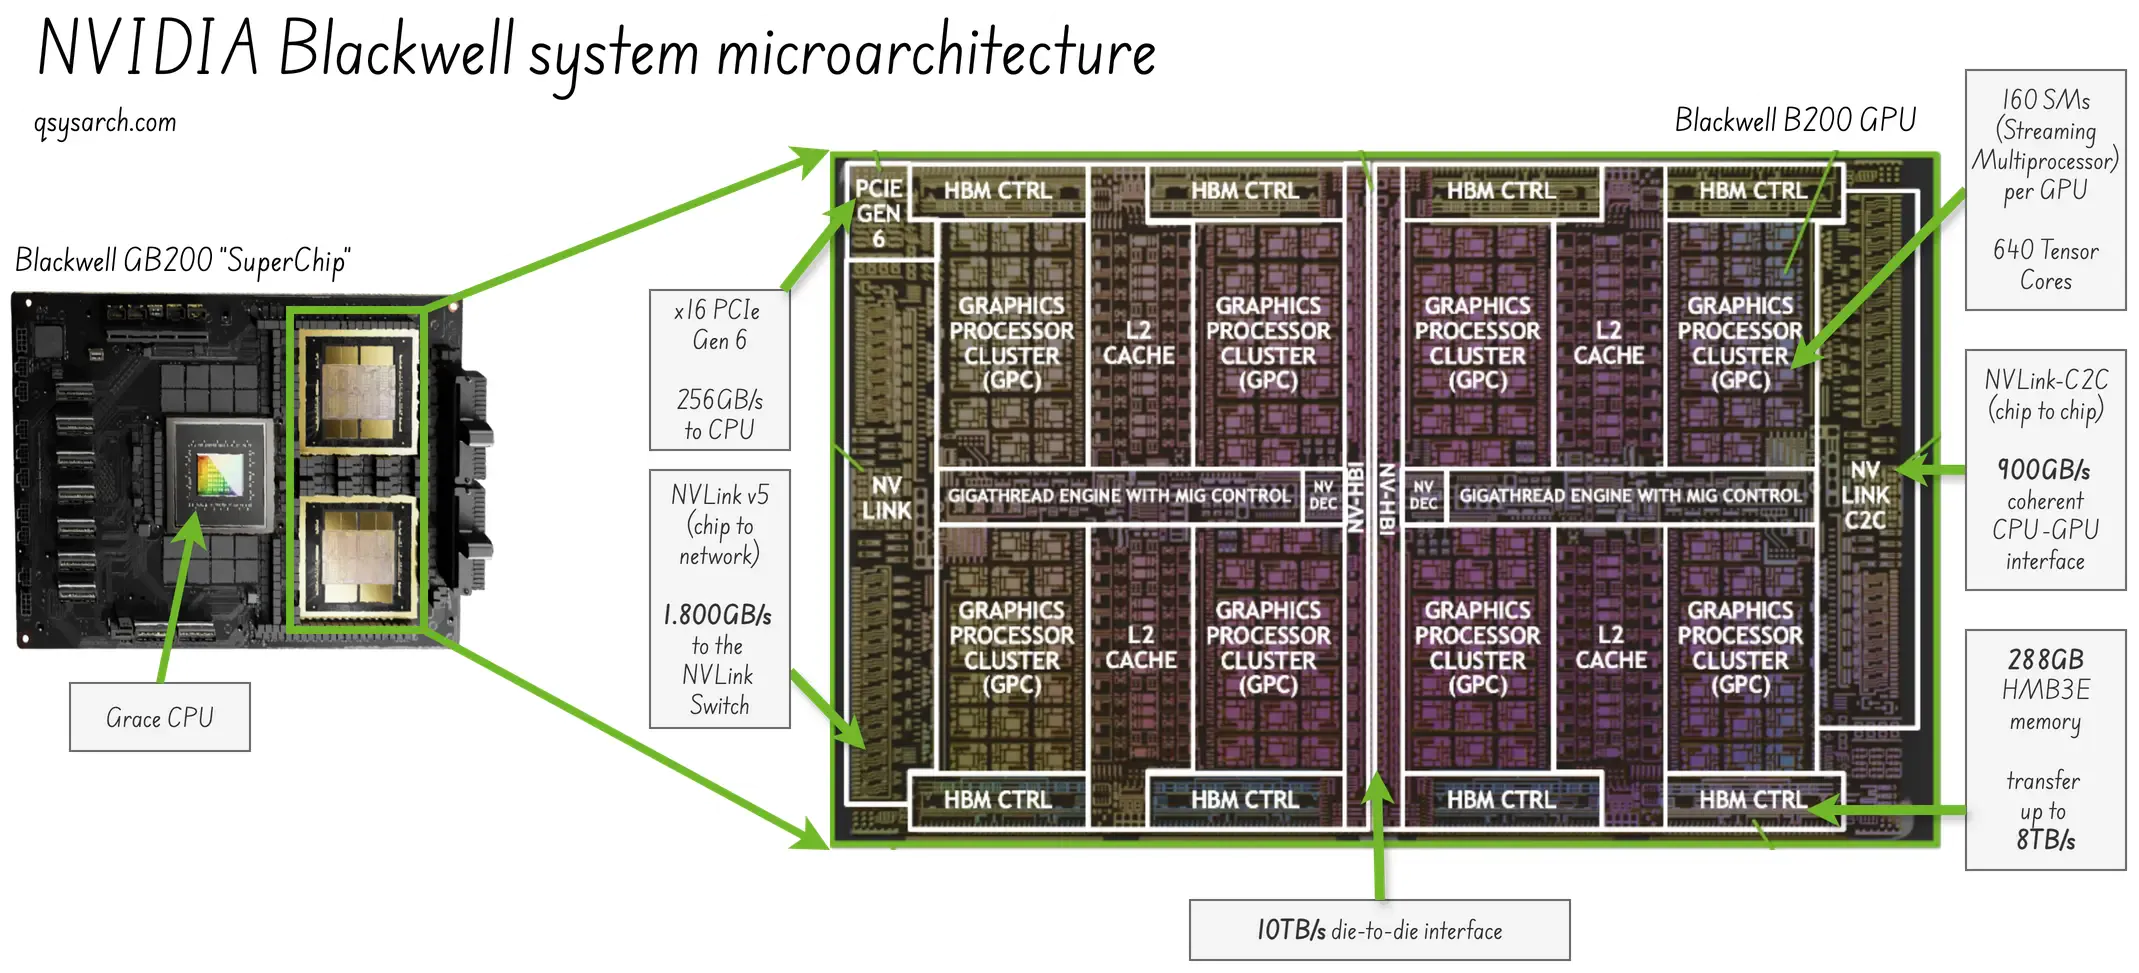
Arquitectura: GPU (arquitectura Blackwell en 2024)
Fortalezas principales: Dependencia del ecosistema, profundidad de la pila de software, integración completa del sistema
Carga de trabajo objetivo: Universal — Entrenamiento e inferencia LLM a gran escala - Shaders gráficos
Vulnerabilidad: Alto costo, alto consumo de energía; no está optimizado para computación dispersa.
Google
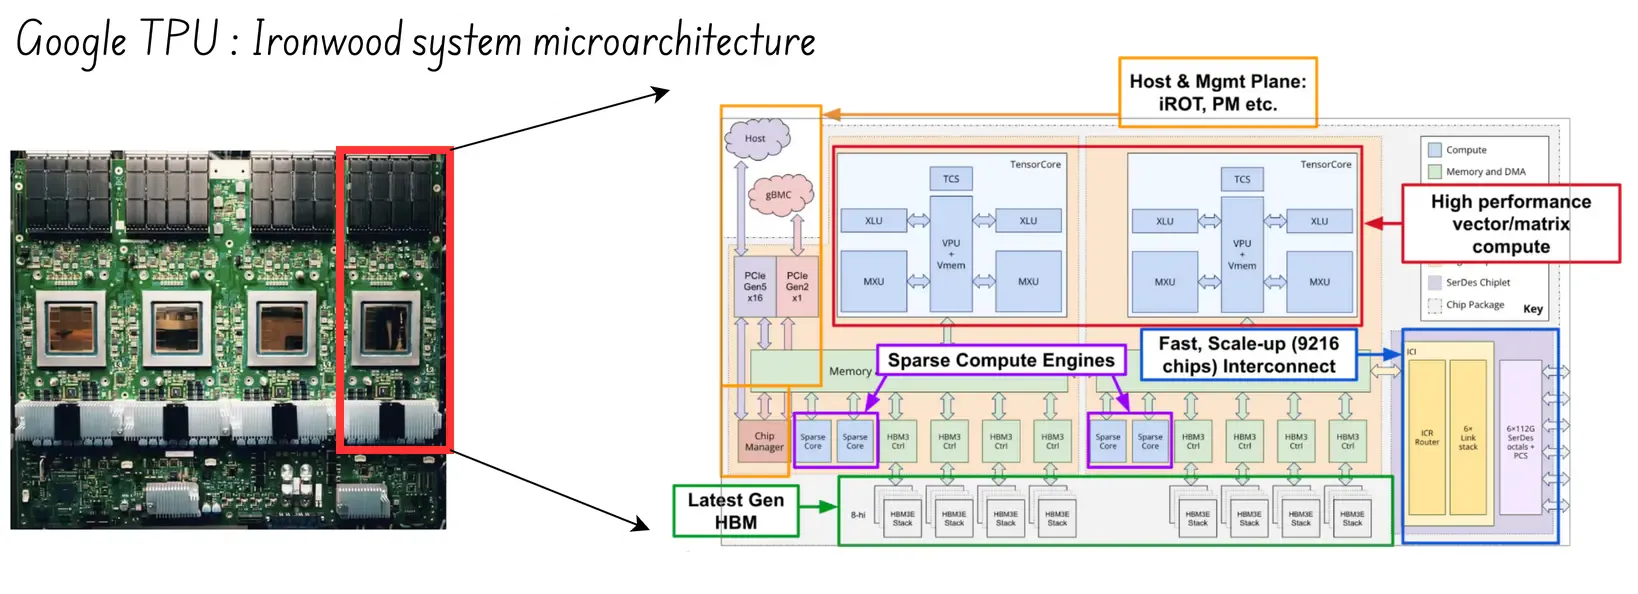
Arquitectura: TPU, ASIC personalizado (sistólico)
Fortaleza principal: Integración vertical; menor coste a escala de Google.
Carga de trabajo objetivo: Cargas de trabajo de Google Cloud, inferencia de Gemini
Vulnerabilidad: Solo disponible desde la nube de Google; no es posible comprar los núcleos TPU a Google.
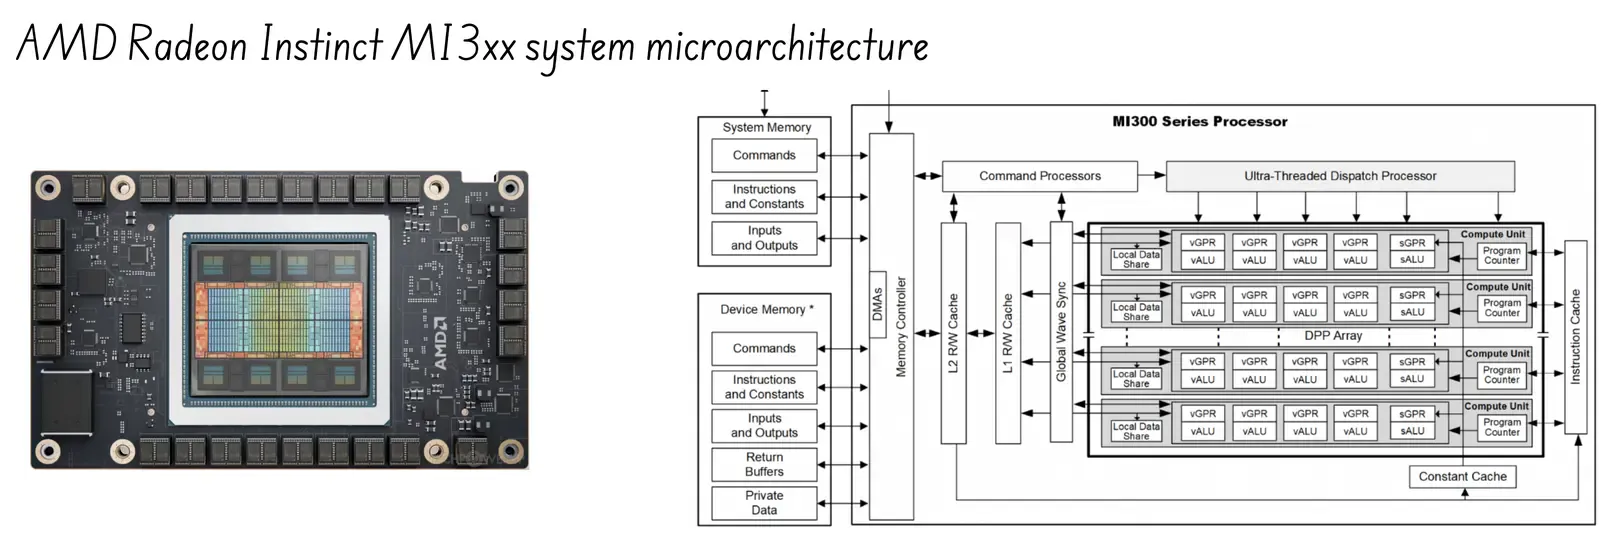
AMD
Arquitectura: MI300 Instinct + ROCm (CUDA propio de AMD)
Puntos fuertes principales: Alternativa de precios CUDA; modelo de GPU familiar;
Carga de trabajo objetivo: Computación de alto rendimiento (HPC) e inferencia sensibles al costo en la nube.
Vulnerabilidad: Brecha de software frente a CUDA; Retraso con respecto al ecosistema de vanguardia (por ejemplo, NVQLINK)
Groq (adquirida por NVIDIA)
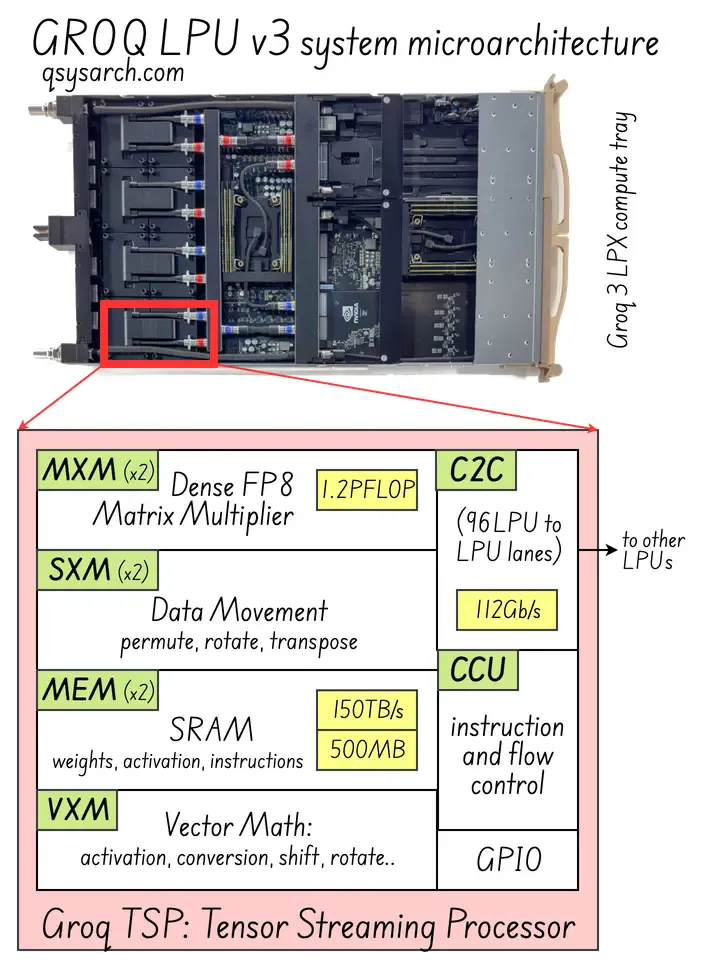
Arquitectura: LPU (Unidad de Procesamiento del Lenguaje)
Principio de funcionamiento: basado en la arquitectura central del procesador de transmisión de tensores (TSP), el tiempo de ejecución es totalmente predecible hasta el ciclo de reloj exacto.
Puntos fuertes principales: Latencia ultrabaja determinista; sin cuellos de botella de memoria; todo está “disciplinado” de antemano por el compilador.
Carga de trabajo objetivo: Inferencia en tiempo real
Vulnerabilidad: Intercambio de velocidad por espacio: No tiene una memoria HBM grande (memoria de alto ancho de banda), sino solo una pequeña memoria SRAM integrada súper rápida (¡aunque esto la convierte en un buen complemento para el ecosistema Blackwell de Nvidia ahora que ha sido comprado por NVIDIA!).
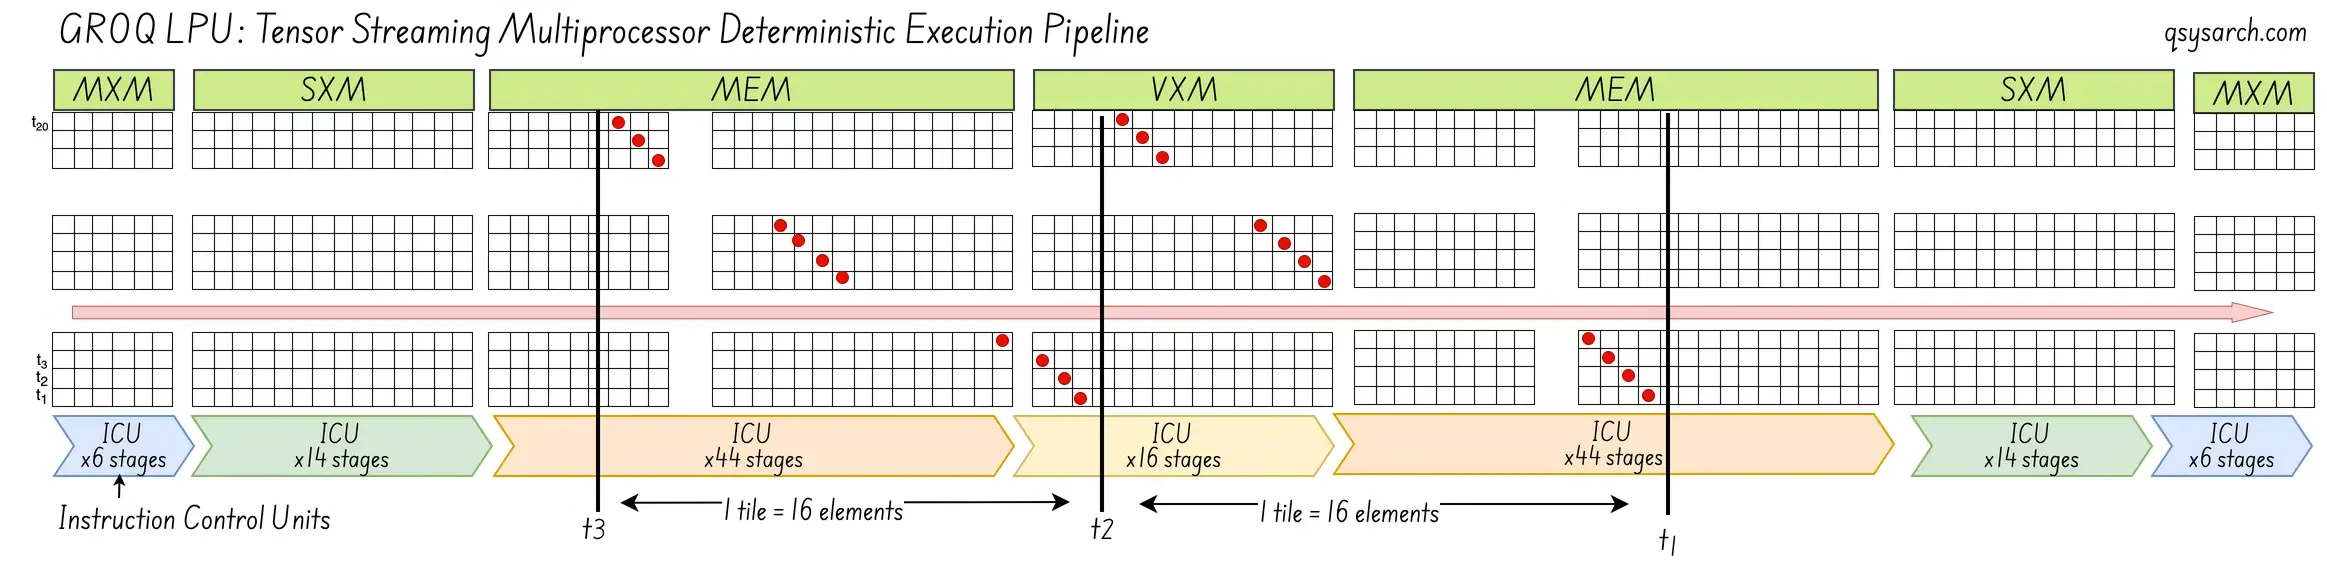
Cabe destacar que la arquitectura LPU de Groq se presentó en 2020, se lanzó comercialmente en 2024 y fue adquirida en 2026. Esto ofrece un buen panorama para las empresas que aspiran a convertirse en unicornios: 4 años para el desarrollo, 2 años para confirmar su aceptación en el mercado y la oportunidad de oro si un competidor más grande siente la presión de la rivalidad.
Estudiar adecuadamente las soluciones que se detallan a continuación podría llevar fácilmente varios días para cada proveedor; tiempo del que no dispuse para redactar este memorándum; por lo tanto, tome la descripción que aparece a continuación con cautela, ya que podría estar incompleta o ser subjetiva.
SambaNova [casi adquirido por Intel]
- Arquitectura: RDU (unidad de flujo de datos reconfigurable); permite canalizaciones de datos y procesamiento integradas y personalizadas para todo el grafo de computación, minimizando el movimiento de datos y resultando en una alta utilización del hardware. El diagrama a continuación muestra la arquitectura detallada de las PCU (Unidades de Computación de Patrón) y PMU (Unidades de Memoria de Patrón) utilizadas en su SN40L:
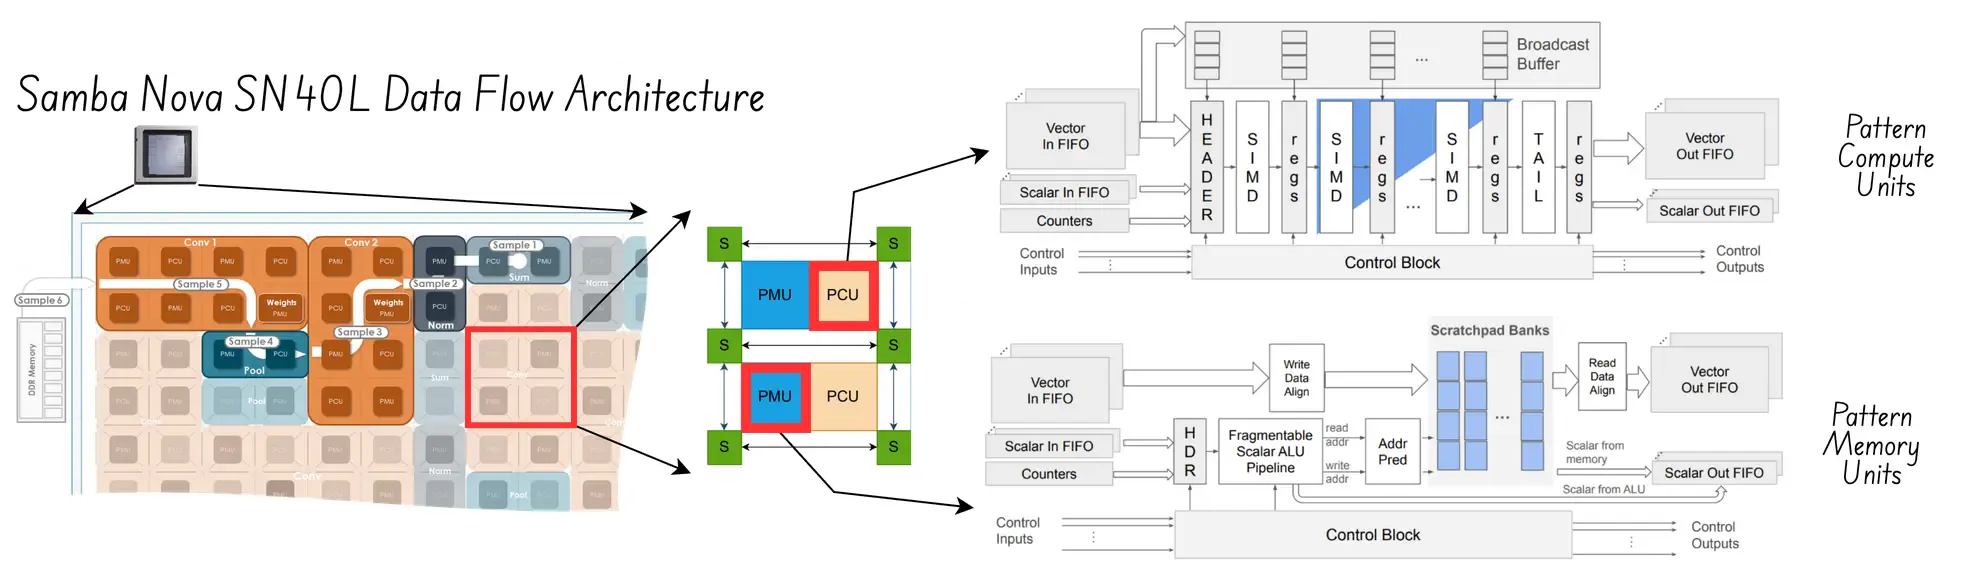
Fortaleza principal: Puede garantizar una utilización máxima del hardware mediante la partición cuidadosa de los flujos del sistema a través de las canalizaciones de inferencia concurrentes; Viene con una pila de software completa, que incluye integración de alto nivel con k8s, compilador para PyTorch y Tensor Flow, así como analizadores de DataFlow.
Carga de trabajo objetivo: Empresas, sectores verticales regulados con instalaciones propias.
Vulnerabilidad: alto costo inicial del sistema para el hardware, que debe amortizarse durante un largo período de tiempo para que el TCO sea interesante.
Cerebras
Arquitectura: Motor a escala de oblea (WSE) que actúa como un multiplicador de matriz segmentado gigante.
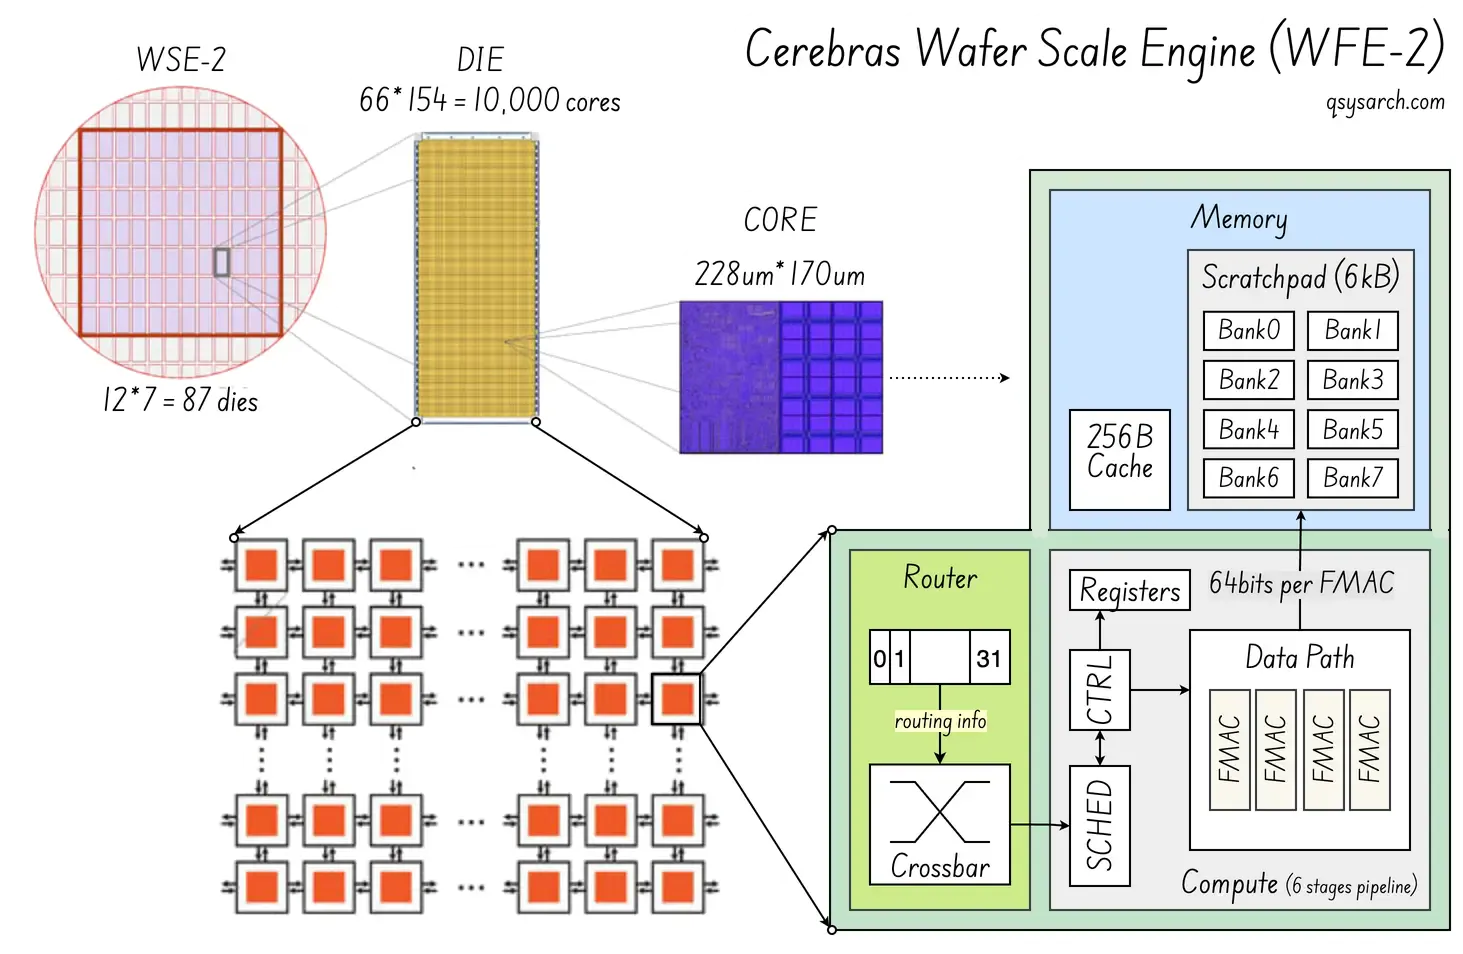
Potencia principal: Memoria SRAM masiva integrada en el chip que elimina el cuello de botella de la memoria HBM. Núcleos independientes de alta densidad (hasta 850 000 para el WSE-2) que pueden realizar cálculos tensoriales en memoria. Enrutador de tejido con latencia de un solo reloj entre nodos en la oblea.
Carga de trabajo objetivo: Inferencia LLM de gran tamaño, especialmente modelos dispersos.
Vulnerabilidad: Requiere una pila de software de primera categoría para aprovechar al máximo la escala masiva (como ocurre con todas las microarquitecturas “PIM” o de procesamiento en memoria).
FuriosaAI
- Arquitectura: Procesador de contracción tensorial (TCP), comercializado como el ASIC Renegade (RGND). En comparación con las matrices sistólicas TPU, que tienen una cuadrícula fija, la arquitectura TCP de Furuisa utiliza unidades de cómputo pequeñas y configurables que se pueden reorganizar dinámicamente (como un NOC superinteligente).
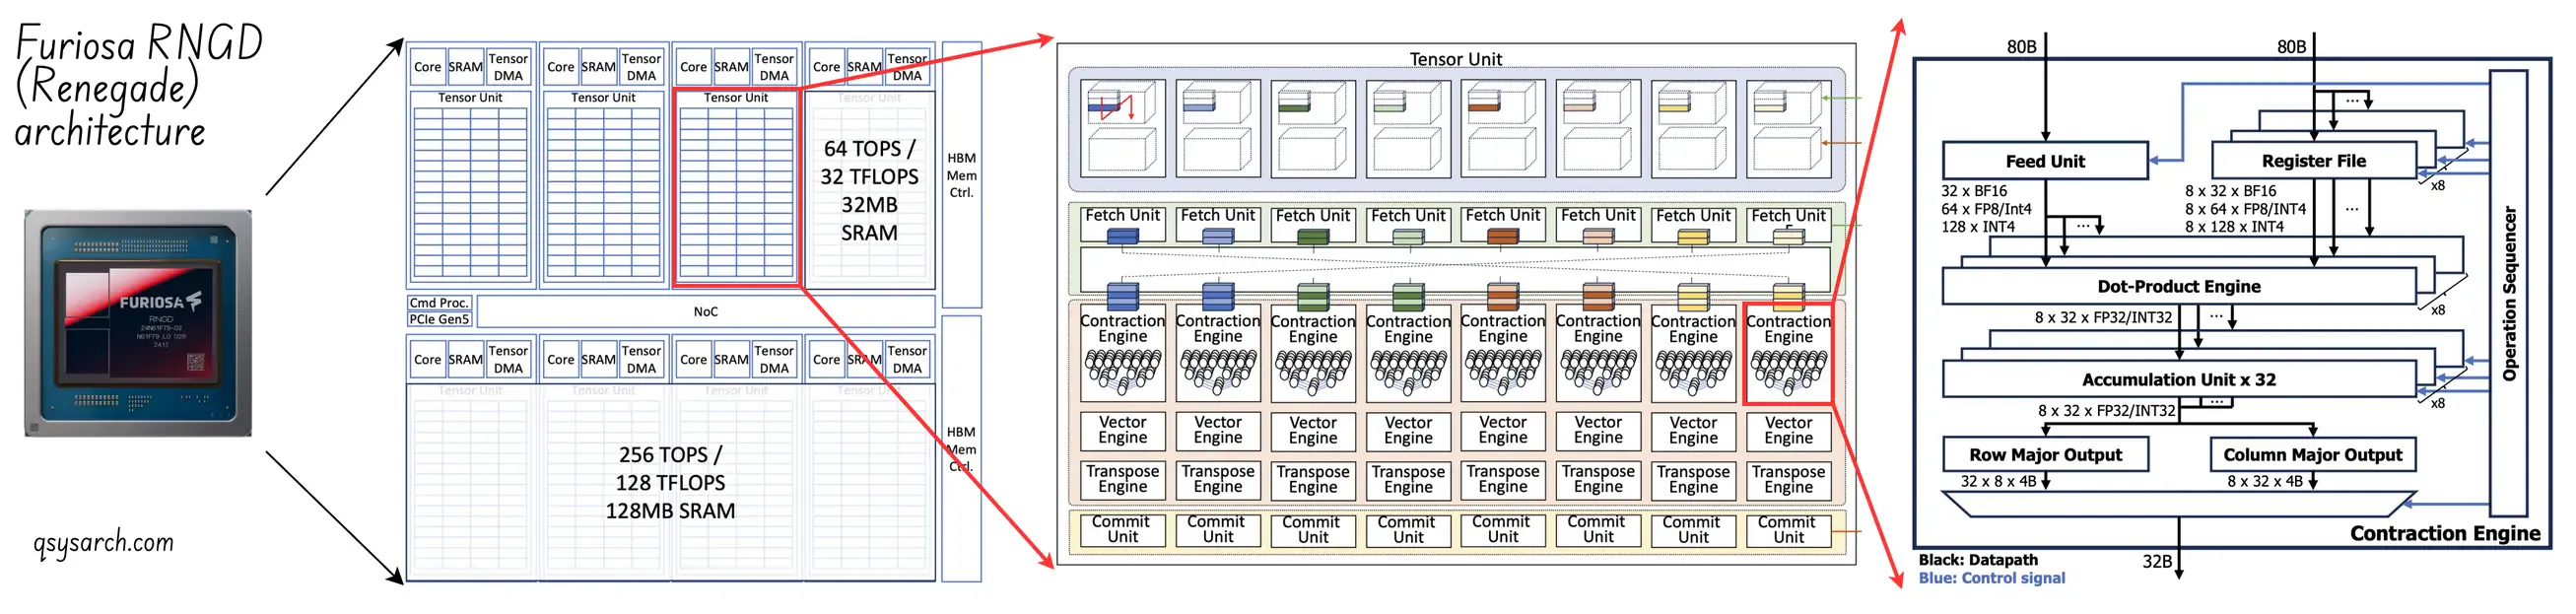
Fortaleza principal: Al introducir el NOC “fetch”, Furiosa introduce la programabilidad espaciotemporal de la red tensorial TPU, llevando el nivel de eficiencia a la siguiente etapa, al ajustarse perfectamente a la carga de trabajo de cómputo y a los procesadores de contracción de tensores.
Carga de trabajo objetivo: LLM, VLM,…
Vulnerabilidad: Ecosistema limitado; riesgo de concentración geográfica (aunque esto podría ser positivo si logran captar una parte del mercado asiático, lo que significa que serían una buena compra, por ejemplo, para Intel, que busca aumentar su cuota de mercado).
Positron
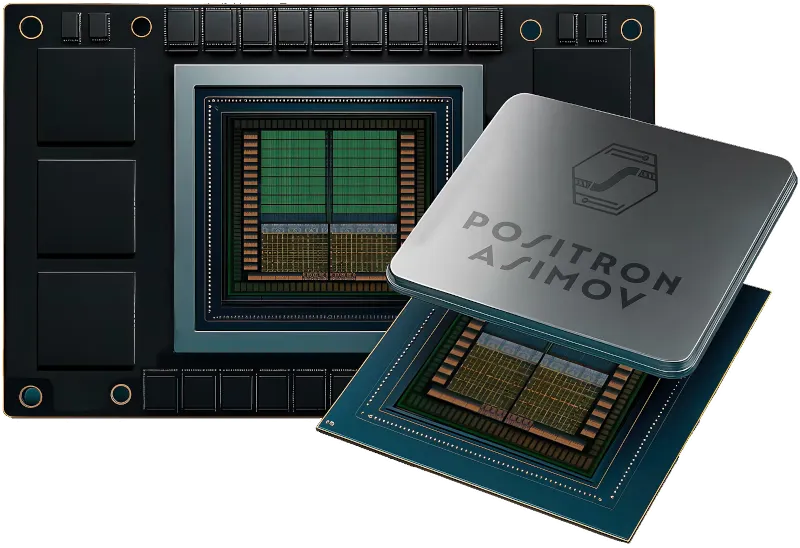
Arquitectura: ASIC de Asimov: no hay mucha información disponible, pero el mensaje clave que transmite Positron es que la memoria es fundamental: por lo tanto, si pueden integrar mucha más memoria DDR5 estándar en su ASIC, utilizando el apilamiento de chiplets, podrán ofrecer una alternativa atractiva en comparación con el NVIDIA Blackwell, que tiene un tamaño de memoria menor.
Ventaja principal: El enfoque en la alta utilización del ancho de banda de memoria (MBU) en lugar del ancho de banda de memoria alto estándar (HBM). Esto significa que pueden aumentar el ciclo de trabajo o la tasa de utilización del bus de memoria y, por lo tanto, proporcionar una potencia de memoria equivalente (o incluso mejor) (ancho de banda * ciclo de trabajo, como V*I = vatios para electricidad), lo que les permitiría superar a la competencia que aún tendría dificultades con memorias costosas.
Carga de trabajo objetivo: Se verá cuando el primer ASIC esté disponible, pero se puede suponer que se centrarán en LLM estándar.
Vulnerabilidad: Etapa muy temprana y necesidad de encontrar socios de fundición adecuados; es muy probable que falten entre 2 y 4 años para su disponibilidad general y soluciones comerciales. ¿Seguirá siendo la memoria un cuello de botella para entonces?
Axelera AI:
- Arquitectura: Metis y Europe AIPU; Es una arquitectura de computación en memoria con un sistema de flujo de datos de control basado en RiscV.
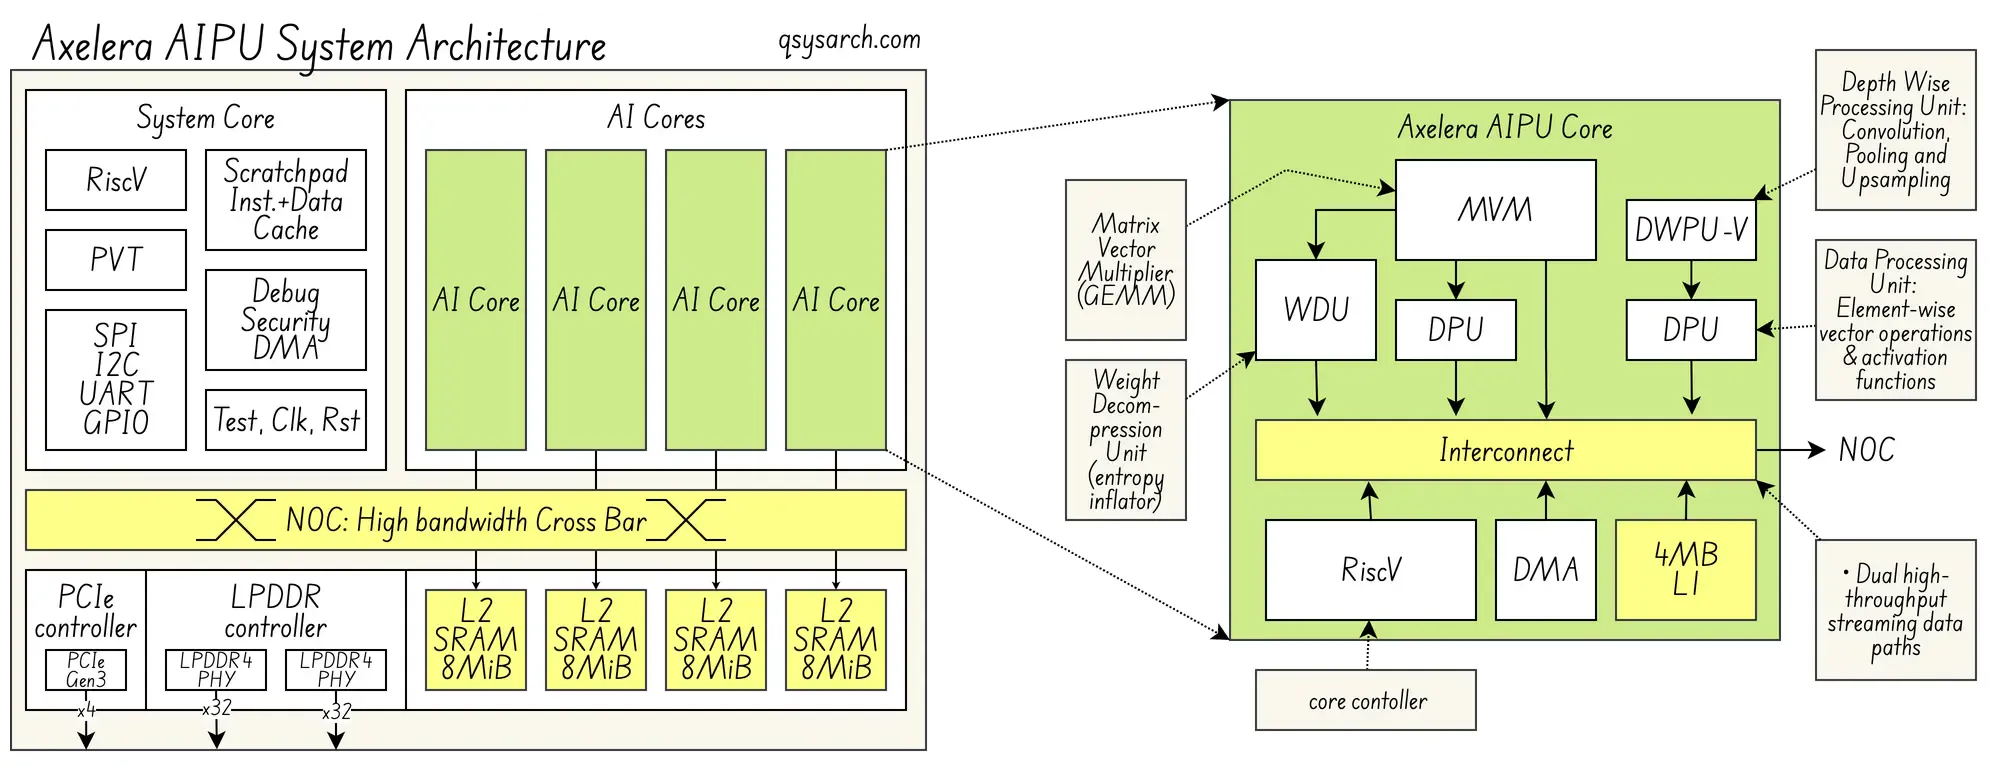
Punto fuerte: Gracias al procesamiento en memoria, puede realizar complejas operaciones matemáticas directamente dentro de las celdas de memoria digital, eliminando así la necesidad de mover datos. Esto permite alcanzar 15 TOPS/Watt (frente a los ~3 de NVIDIA Blackwell). Además, se trata de una propiedad intelectual de diseño totalmente europeo, lo que la convierte en una solución soberana.
Carga de trabajo objetivo: La primera generación se centró en la visión artificial y el análisis de vídeo multicanal; la generación más reciente (integración M2) también se puede utilizar para cargas de trabajo LLM y vLM en el borde.
Vulnerabilidad: La vulnerabilidad de Axelera no reside en su ingeniería; su tecnología es de primera clase. Su verdadera vulnerabilidad es la fricción del mercado: ¿podrán abrirse paso en el mercado sin diluir su enfoque?
Mientras buscaba información sobre las empresas mencionadas, me topé con otras compañías manufactureras innovadoras y disruptivas que podrían tener un papel importante en los próximos años. Y la última de ellas, Unconventional AI, sin duda no es la menos importante, gracias al éxito y la visión de su líder.

Extropic y Normal Computing
- Arquitectura: TSU (Unidades de Muestreo Termodinámico) / SPU (Unidad de Procesamiento Estocástico), utilizadas para operar con “p-bits” (también conocidos como bits probabilísticos).
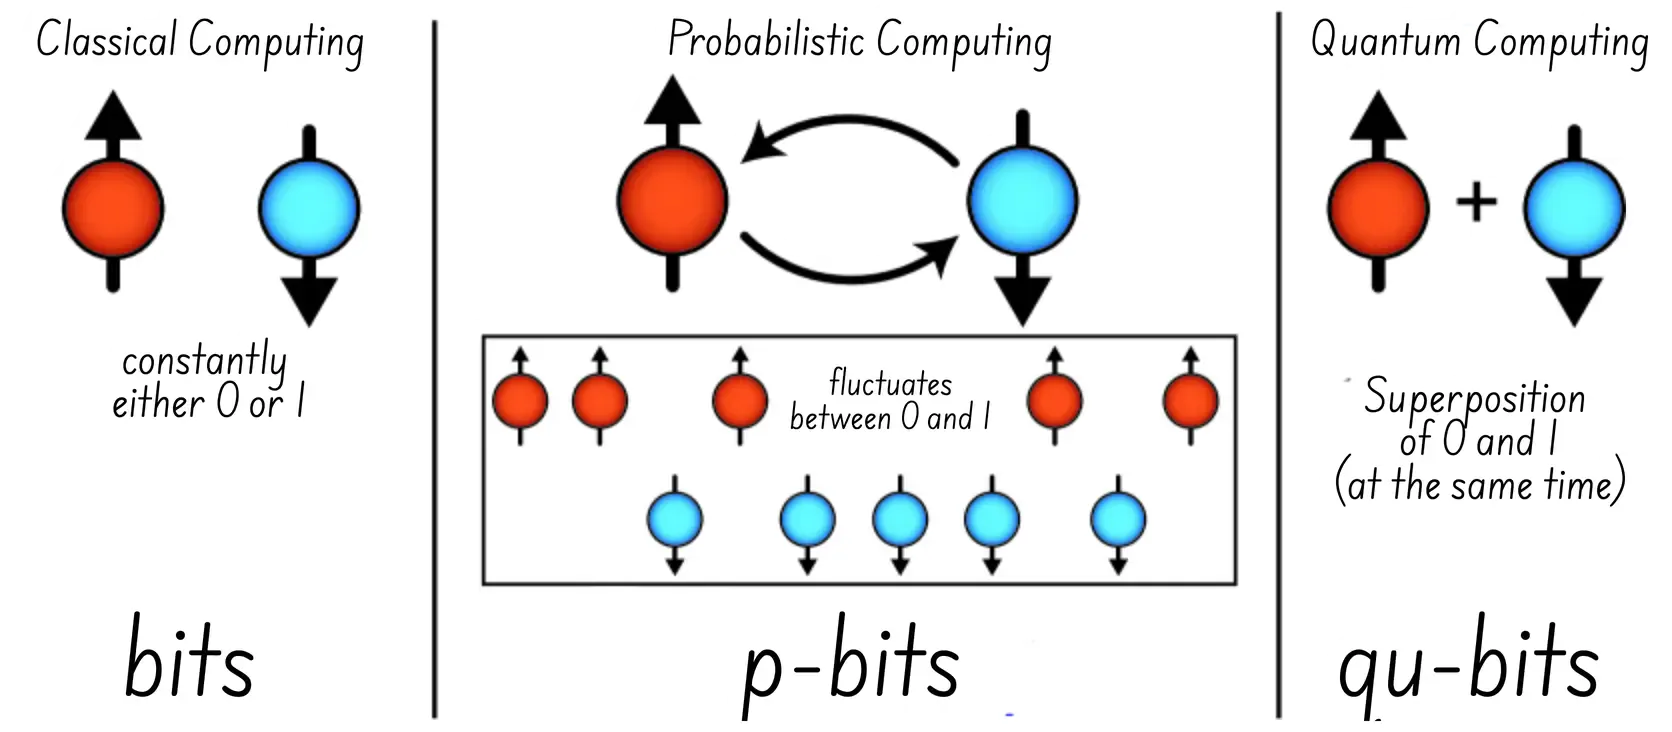
Por qué es importante: Afirman ser 10 000 veces más eficientes que las GPU para cargas de trabajo específicas, como el recocido simulado. Esto podría suponer un desafío importante para los cúbits.
Vulnerabilidad: Poder usarlo a escala todavía requiere bastante investigación.
Mottronix
Arquitectura: SPU (red neuronal de impulsos) que utiliza memorias Mott (Mott-RAM).
Por qué esto importa: Necesitamos personas con visión de futuro que consideren la memoria alternativa, como la memoria resistiva (ReRAM), o, en el caso de Mottronix, la Mott RAM.
Vulnerabilidad: Debe demostrar que puede pasar de la investigación a la comercialización de circuitos integrados.
Akhetonics
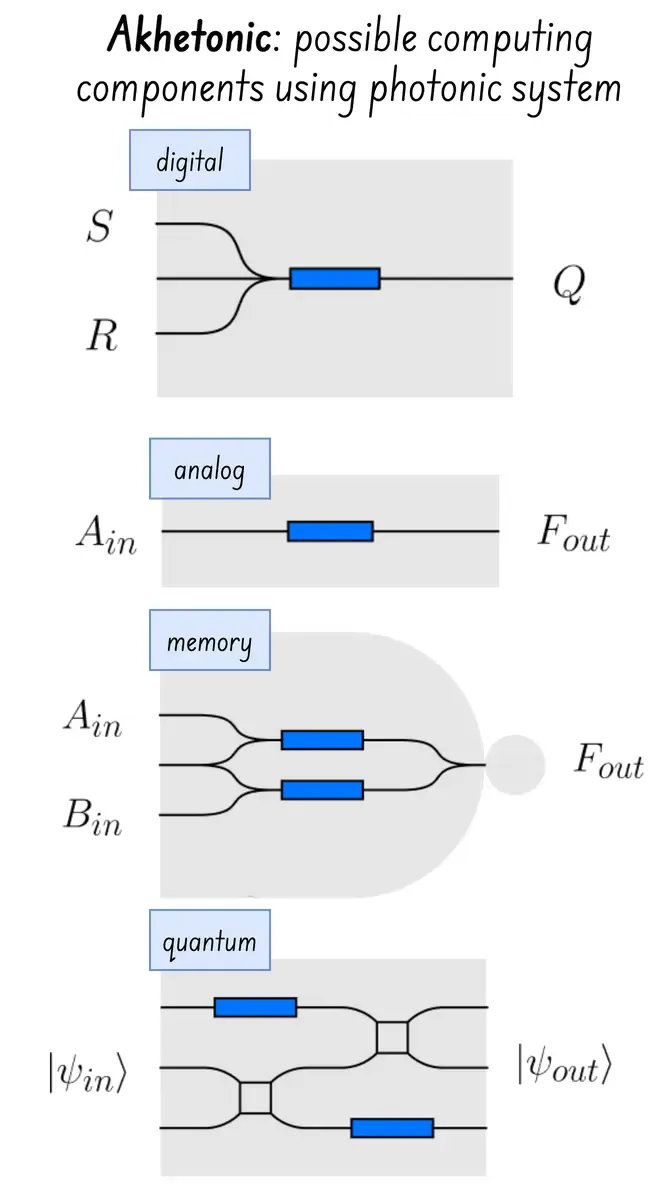
Arquitectura: RPU (Unidad de Procesamiento de Razonamiento) que utiliza un procesador digital totalmente óptico.
Por qué es importante: Los circuitos integrados fotónicos han experimentado una mejora tremenda en su rendimiento durante la última década. NVIDIA, por ejemplo, ahora puede producir comercialmente conmutadores de red fotónicos de silicio (https://www.nvidia.com/en-us/networking/products/silicon-photonics/), ¡y aplicar esto a la carga de trabajo computacional es el siguiente paso lógico! (¡lo que también permite la computación cuántica direccionada ópticamente!).
Vulnerabilidad: No está claro cuál es la diferencia entre la computación cuántica de OAQ y la computación de razonamiento de RPU, y en ambos casos, se necesita una calibración y puesta a punto cuidadosas antes de escalarlas a soluciones comerciales.
Arago
- Arquitectura: “JEF” como acelerador de IA fotónico, capaz de ofrecer reducciones de 10× a 30× en el consumo de energía. La información pública sobre Arago es muy limitada, pero parece ser una solución de integración híbrida determinista/clásica + acelerador fotónico, combinada con un SDK de software completo y compatible con PyTorch.
 Inteligencia artificial no convencional
Arquitectura: [UN]CPU (Unidad de Procesamiento [No]convencional) que utiliza el oscilador de Kuramoto
Por qué esto importa: Me encanta esta idea, y para que se haga realidad, la ejecución es clave: Tener el valor de pensar diferente es solo la mitad de la batalla; los verdaderos transformadores del mundo trabajan a diario para lograrlo. Y para ello, cuentan con un líder con una experiencia impresionante.
Vulnerabilidad: Todavía están en el día 0->1, por lo que la ejecución es clave.
Retrospectiva del mercado en junio de 2026
Link to heading
¿Cuáles son las líneas de batalla reales que podrían cambiar el panorama actual del mercado?
La ventaja estructural de NVIDIA no reside en la GPU, sino en el ecosistema CUDA que se ha desarrollado durante los últimos 10 años. Para ganar esta batalla es necesario triunfar en el software, no solo en el silicio, y ahí es donde muchas empresas innovadoras centradas en el hardware fracasan.
AMD es la amenaza a corto plazo más subestimada para NVIDIA: no necesita superar a CUDA, ya que cuenta con su propia herramienta, y solo necesita ser lo suficientemente buena para los compradores de servicios en la nube sensibles al precio. ROCm 6.x está reduciendo la brecha más rápido de lo esperado.
La mayoría de los innovadores están probando una variación del compromiso espacio-tiempo; ya sea colocando más memoria localizada ultrarrápida; ya sea permitiendo un flujo de datos configurable dinámicamente (pipelines); por ahora, el cuello de botella está en la RAM;
Quizás los ganadores sean aquellos que puedan abordar ambos problemas simultáneamente, lo cual será aún más relevante para el cálculo de matrices dispersas (con muchos ceros), donde se busca evitar la transferencia de ceros a la memoria, ¡pero también calcularlos! ¿Podría Renegade marcar la diferencia?
- Los fabricantes de chips de próxima generación ven el problema de la computación desde otro ángulo: ¿Quizás la clave sea modelar y alimentar un sistema dinámico en lugar de multiplicar imperativamente números uno tras otro?
¿Podría el límite ser una línea sensible entre la computación cuántica y la dinámica? ¿Podría esto resolver tanto el desafío de la crioconservación cuántica como el problema de la decoherencia de los cúbits mediante la introducción de un sistema intermedio que permita la computación exponencial sin incurrir en la decoherencia de los cúbits?
Tecnología y dirección del mercado (2026~2029)
Link to heading
El resumen que figura a continuación ofrece una visión subjetiva de los horizontes del nivel 1 al nivel 3. Tres cambios definirán el próximo ciclo. Se enumeran en orden de impacto.
Memory Power™: La memoria, más que la capacidad de procesamiento, es el factor que posibilita la potencia cuantitativa.
Link to heading
Los modelos LLM están cada vez más limitados por el ancho de banda de la memoria en lugar de por la capacidad de procesamiento. A medida que los modelos crecen y las ventanas de contexto se extienden a más de un millón de tokens, el costo y la latencia de transferir pesos hacia y desde la memoria HBM se vuelven predominantes. La disyuntiva radica en elegir entre un procesamiento cercano a la memoria con SRAM integrada y una memoria grande con suficiente ancho de banda: el indicador clave de rendimiento (KPI) crítico podría ser la potencia de la memoria, definida como ancho de banda multiplicado por el ciclo de trabajo.
Los modelos de mezcla de expertos que activan solo una fracción de parámetros por token (usando una matriz dispersa) también entran en esta categoría: la mayoría de los aceleradores aún no están optimizados para patrones de activación dispersos, y por eso NVIDIA introdujo TensorCore. Puede que no sea la solución definitiva, sino un parche de hardware mientras se espera algo más consistentemente robusto.
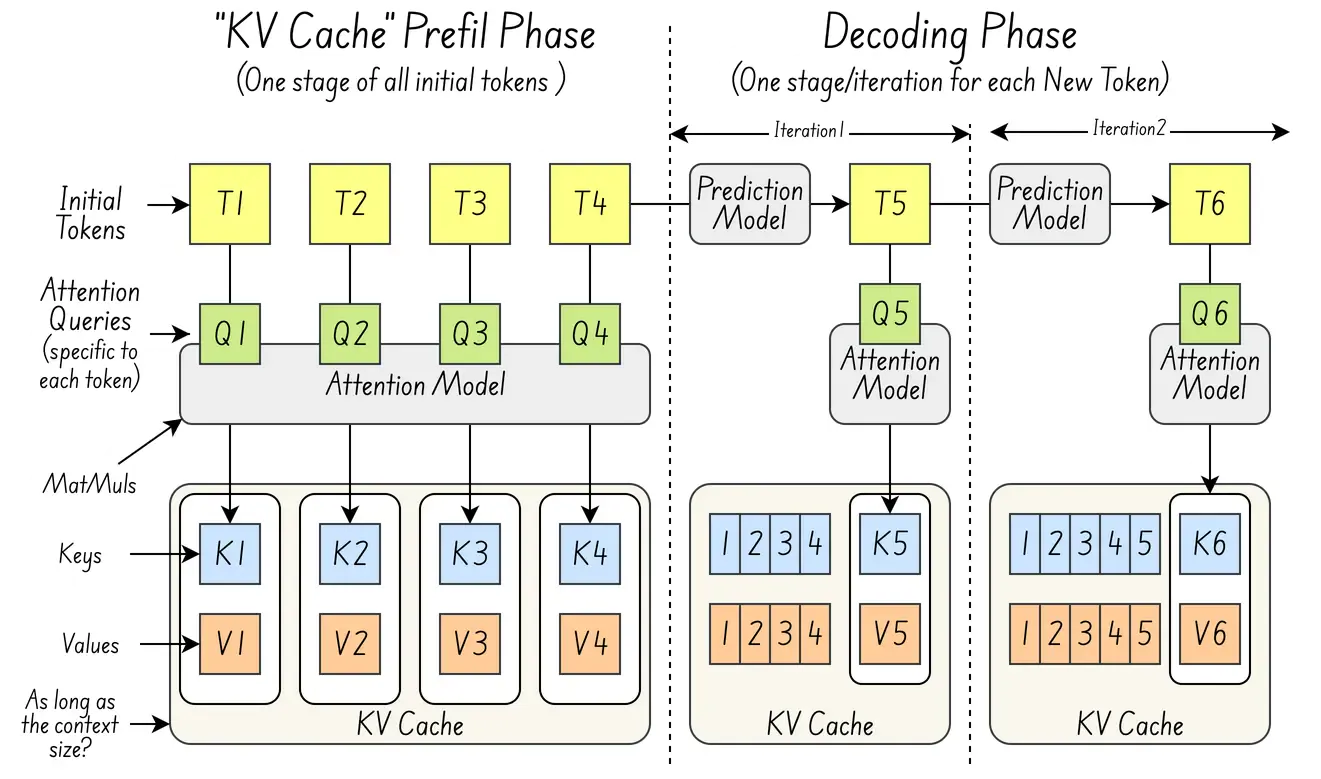 Por ejemplo, ahora es común emplear la desagregación de prellenado/decodificación (PD) para separar las etapas de prellenado (caché KV inicial construida a partir de muchos tokens) y decodificación (generación de un token a la vez) de un LLM. Esto abre la puerta a coprocesadores de inferencia diseñados específicamente, ya que el prellenado requiere una mayor capacidad de cómputo, mientras que la decodificación requiere una mayor potencia de memoria (al tener que cargar una nueva KVQ para cada token).
El núcleo NVIDIA Tensor para modelos Mixture-of-Experts dispersos también entra en esta categoría.
El precio de la inferencia ha caído aproximadamente diez veces en dos años. La adopción de la IA empresarial se ve limitada por el coste de la inferencia, no por la calidad del modelo. Esto implica que el hardware de inferencia estándar emerge por debajo de la gama alta (NVIDIA H100/B200) para el servicio LLM estándar. Aquí es donde los competidores tienen la oportunidad más clara. ¡Imagínese poder ejecutar GLM5.2 en su hardware estándar utilizando el procesador Positron Asimov!
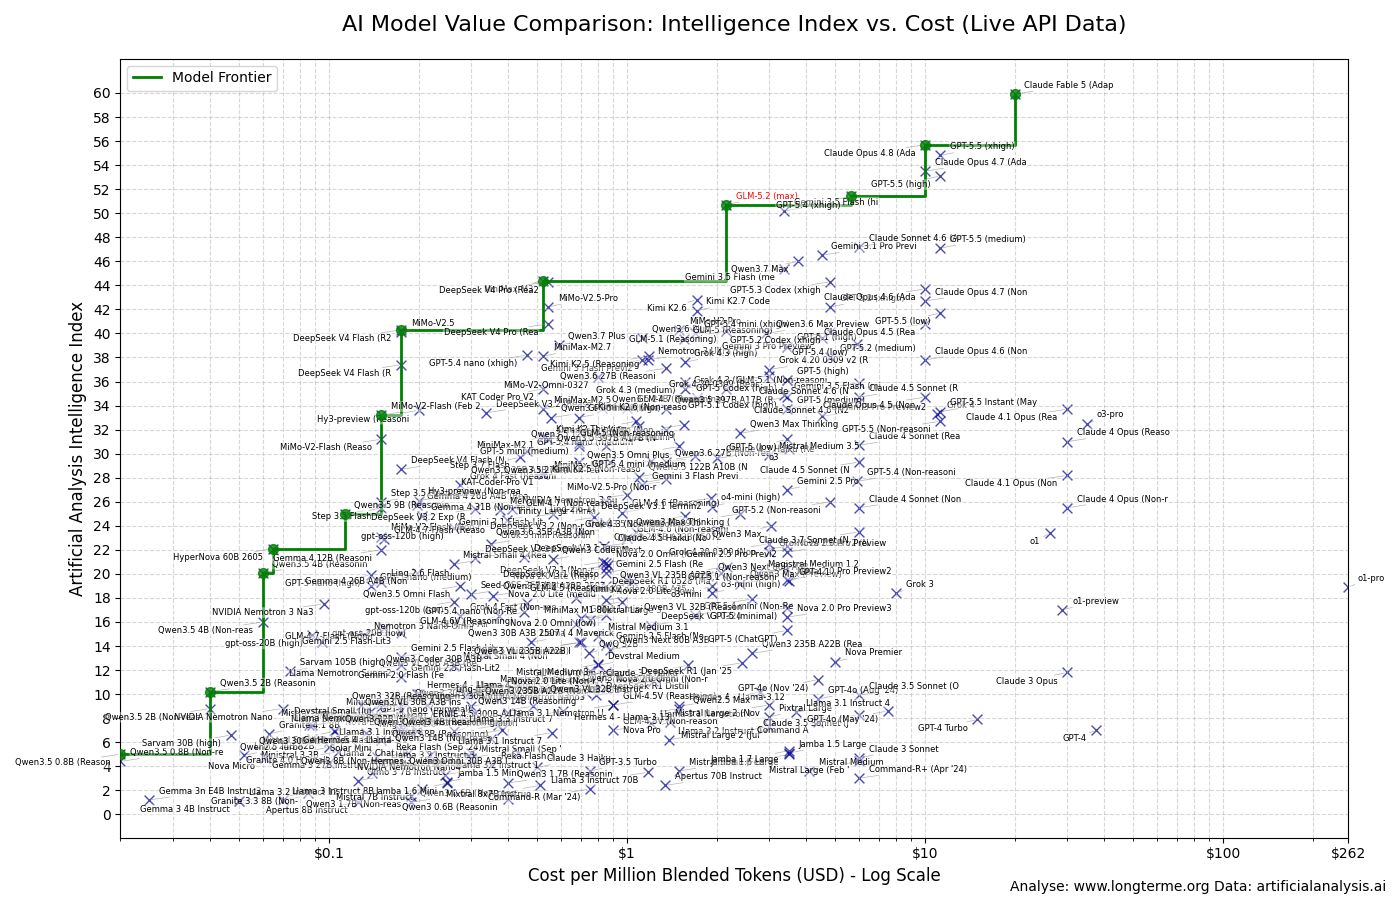 (fuente de la imagen: L’Observatoire du Long Terme - Z AI GLM5.2 es claramente un outsider en cuanto a inteligencia y costo, pero requiere cerca de 200 GB de memoria).
Simplicidad de implementación: Por último, pero no menos importante: facilidad de uso para hardware, software, interfaz de usuario y herramientas.
Link to heading
Las empresas subestiman sistemáticamente la complejidad operativa. Los proveedores que ofrecen soluciones de inferencia “listas para usar” con un entorno de ejecución sin configuración (no solo chips) obtendrán una parte desproporcionada del presupuesto empresarial.
Esto se verá acentuado por la necesidad de inferencia local debido a la presión regulatoria en la UE y APAC, porque, sí, muchas empresas no quieren inferir su conocimiento propietario en un sistema extranjero.
El mercado de inferencia entre 2024 y 2026 se asemeja al mercado de redes entre 2000 y 2003. NVIDIA, en su época, era como Cisco: dominante, con una ingeniería excesiva para muchos casos de uso y un precio elevado. La cuestión no es si se debe desafiar a NVIDIA en sus mejores cargas de trabajo, sino dónde NVIDIA está ofreciendo un servicio excesivo al mercado y dónde una alternativa diseñada específicamente para ello puede ofrecer el 80 % del rendimiento al 40 % del coste.
Al mismo tiempo, NVIDIA también está invirtiendo fuertemente en el ecosistema, y las excelentes contribuciones totalmente de código abierto, como CudaQ y NVQLink, que NVIDIA está ofreciendo gratuitamente a la comunidad, harán que sea más difícil para cualquier competidor de NVIDIA ganarse a esas comunidades.
¡Voilá! Este fue un breve y superficial informe de domingo por la mañana. Tendré que profundizar en los detalles arquitectónicos de los futuros competidores y, afortunadamente, podré elaborar un informe para al menos dos de ellos este verano. Mientras tanto, el próximo informe tratará sobre el tema tan esperado (que muchos lectores me pidieron que abordara): ¡Corrección de errores cuánticos en pocas palabras!
https://api-docs.deepseek.com/news/news260424
Inferencia de SNN en la plataforma neuromórfica heterogénea multinúcleo SpiNNaker2](https://arxiv.org/pdf/2406.17049)
Diagramas de DrawIO utilizados en este memorándum: