Raph Levien es famoso por su implementación ultraeficiente del motor de renderizado de glifos más rápido del mundo, utilizando un ingenioso diseño SIMD basado en Rust. Su trabajo me inspiró mucho cuando diseñaba una GPU SIMD en Bestechnics en 2023. Posteriormente, Ralf Levien también trabajó en una versión para GPU de este motor de renderizado de glifos.
Así que, cuando me topé con su última charla sobre “Cómo ganó Rust: la búsqueda de un software fiable y de alto rendimiento”, decidí dedicar una hora de mi tiempo a ver la charla y extraer cualquier idea que valiera la pena aprender.
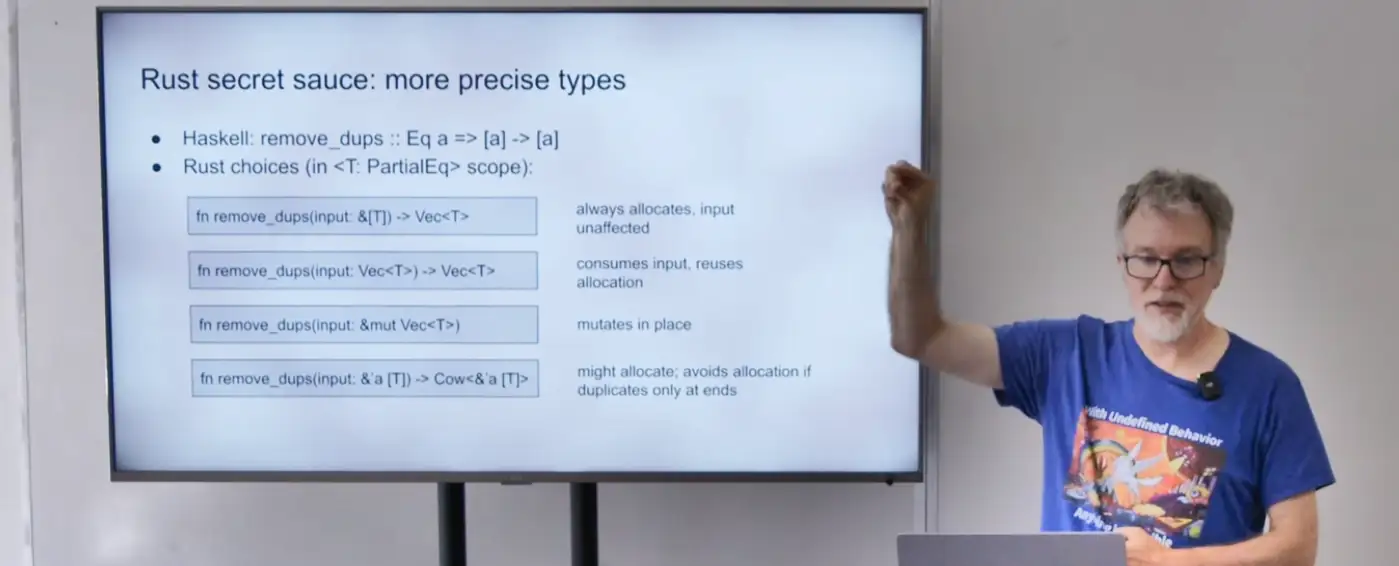
La parte intensa (también conocida como la zona de ahogamiento) comienza alrededor del minuto 55:00, con una diapositiva titulada Salsa secreta de Rust: tipo más preciso.
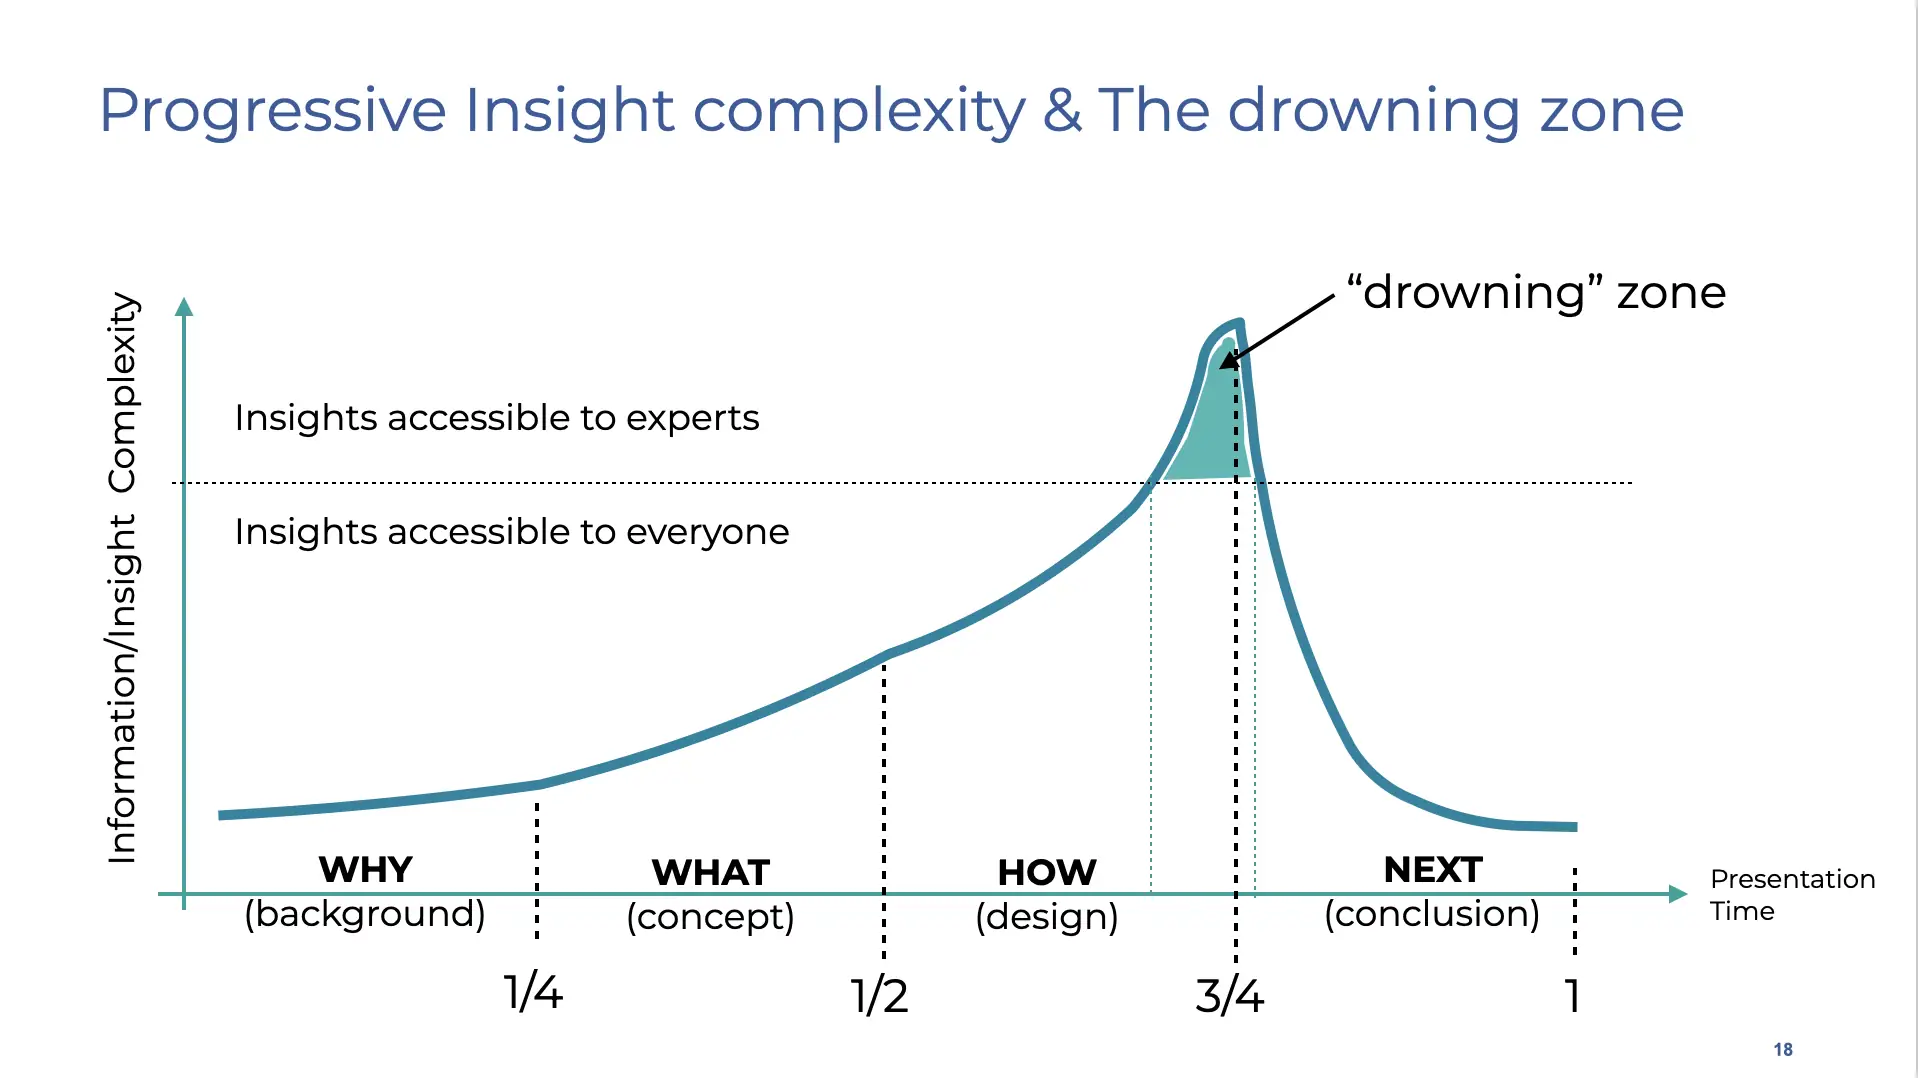
En el minuto 56:50, Raph dice: “Aquí es donde entra en juego el tipo afín; quieres modelar (la clonabilidad) como ’existe una instancia de esto’; y el tipo te permite especificar cuidadosamente, en la firma de la función, cómo se va a manejar esa propiedad; y omitiré el último ejemplo, pero es divertido, ¿verdad?”.
No pretendo ser un experto en Rust, y admito tener una ligera preferencia por Go. Por lo tanto, la pregunta es: ¿puedo comprender qué significa realmente el tipo afín? ¿Y se puede explicar con palabras sencillas sin tener que sumergirme en un mar de conocimientos?
Otra cuestión, que se menciona en los comentarios de YouTube: al parecer, el tipo de retorno de la última función debería ser Cow<'a, [T]> en lugar de Cow<&'a [T]>. Sinceramente, esto me parece incluso más complicado que los algoritmos cuánticos. ¡Pero quizás no tenga por qué ser así!
Así que echemos un vistazo más de cerca a estos ejemplos de “salsa secreta tipográfica más precisa”:
fn α( l: &[T] ) → Vec<T> : siempre asigna memoria, la entrada no se ve afectada
fn β( l: Vec<T> ) → Vec<T> : consume la entrada y reutiliza la asignación.
`fn δ( l: &mut Vec ): no hay asignación, solo modifica el vector de entrada.
fn ω( l: &'a [T]) → Cow<'a,[T]>: podría asignar memoria; evitar la asignación si hay duplicados solo en los extremos.
¿Cuál es el primer aspecto a comprobar en la plantilla genérica T? ¿Funciona realmente? ¿Se pueden compilar esas funciones tal cual? Probemos con la versión más sencilla de la función:
// fails with: error cannot find type T in this scope
fn α( l: &[T] ) -> Vec<T> { vec![] }
Obviamente esto no funciona y falla con el error no se puede encontrar el tipo T en este ámbito. Si está familiarizado con C++, anticipará que el tipo T debe declararse con el nombre de la función, por lo que declarar α<T> en lugar de α.
// all right with the T declaration
fn α<T>( l: &[T] ) -> Vec<T> { vec![] }
¡De esta forma funciona perfectamente! Pero al añadir una implementación básica (que solo convierte a vec, sin eliminar los duplicados), el compilador falla con el error la restricción de rasgo T: Clone no se cumple.
// fails with: the trait bound `T: Clone` is not satisfied
fn α<T>( l: &[T] ) -> Vec<T> { l.to_vec() }
Afortunadamente, Rust tiene una muy buena documentación sobre los genéricos y los traits, y después de una lectura de 10 minutos, se hace obvio que necesitamos cambiar el α<T> a α<T: Clone> como medio para expresar el límite del rasgo de tipo T.
// all right with the trait bound
fn α<T: Clone>( l: &[T] ) -> Vec<T> { l.to_vec() }
El siguiente paso es implementar una solución para eliminar duplicados. Para ello, un enfoque es utilizar un HashSet. Primero, el array se convierte en un iterador (let iterator: std::slice::Iter<T> = l.iter();), y luego construimos un conjunto hash a partir de este iterador (HashSet::from_iterator(iterator)), y finalmente convertimos el conjunto hash en un vector set.into_iter().collect().
//Fails with: the trait bound `T: Eq` is not satisfied
use std::collections::HashSet;
fn α<T: Clone>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Como era de esperar, ¡esto falla! Y eso es normal, porque si hubieras dedicado 10 minutos a leer la documentación del rasgo de Rust, sabrías que es probable que HashSet requiera algo que pueda “comparar” los elementos de tipo T. Esto es lo que hace el rasgo Eq, así que simplemente agreguémoslo al rasgo ligado (de α<T: Clone> a α<T: Clone + Eq> ):
//Fails with: the trait bound `T: Hash` is not satisfied
use std::collections::HashSet;
fn α<T: Clone + Eq>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Sigue fallando, y la razón es que olvidamos mencionar que el tipo T debe poder convertirse en un valor hash. Esto es lo que hace el rasgo Hash. Entonces, cambiemos de α.<T: Clone + Eq> aα<T: Clone + Eq + Hash> `
//Fails with: a value of type `Vec<T>` cannot be built from an iterator over elements of type `&T`
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
Aquí es donde entra en juego la parte interesante de la clonabilidad: el conjunto hash es una estructura que contiene punteros a los elementos que inicialmente estaban en la lista y que se pasaron por valor (para ser precisos, el array se pasó por puntero y contenía elementos referenciados por valor). Por lo tanto, necesitamos indicarle al conjunto hash que haga una copia de esos elementos, lo cual se puede hacer agregando cloned() antes del último collect (el collect se usa para transformar el iterador en una colección de vectores).
// all right!
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().cloned().collect()
}
Y voilà, ya tenemos listo el primer ejemplo de función:
fn main() {
println!("{:?}", α(&["A","A","B","D"]));
println!("{:?}", α(&[1,1,2,4]));
}
Sinceramente, esto es complejo y a la vez sencillo. Complejo porque el compilador impone reglas estrictas que deben declararse explícitamente en lugar de derivarse implícitamente, lo que dificulta el aprendizaje. No complejo, porque una vez que se han dedicado diez minutos a leer la documentación, debería ser más fácil. Quizás el problema no sea que se tarde diez minutos en leer el documento, sino que se necesiten diez horas para comprender lo que está escrito. Es una sensación de déjà vu…
Todavía tengo una pregunta sobre la clonabilidad. ¿Podríamos devolver un vector que contenga solo referencias a los elementos que se pasaron en el array? A primera vista, bastaría con cambiar Vec. aVec<&T>` … ¿y manejar correctamente las restricciones de tipo afines? Intentémoslo:
// All right - works fine
use std::collections::HashSet;
fn α<T: Clone + Eq + std::hash::Hash>( l: &[T] )  -> Vec<&T> {
let array_iterator: std::slice::Iter<T> = l.iter();
let hash_set: HashSet<&T> = HashSet::from_iter(array_iterator);
hash_set.into_iter().collect()
}
¡Pues funciona! ¿Y ninguna queja sobre el tiempo de vida? Es decir, ¿no estamos en un caso donde tomamos prestados los elementos, por lo que debería comprobarse el tiempo de vida? ¿El problema es que nuestra función main es demasiado simple? Entonces, probemos con algo más complejo:
// fails with expected named lifetime parameter
fn limited_lifetime() -> vec<&str> {
let l = ["A","A","B","D"];
α(&l)
}

fn main() {
let v = limited_lifetime();
println!("{:?}",v);
}
Esta vez, falla: el compilador se queja de que falta un parámetro de tiempo de vida, así que dediquemos esos 10 minutos adicionales a leer la documentación de Rust sobre Validación de referencias con tiempos de vida. A primera vista, solo necesitamos agregar ‘a ?
//  fais with: mismatched types; expected `&[str]`, found `&[&str; 4]`
fn limited_lifetime<'a>() -> Vec<&'a str> { ... }
Pero no, eso no funciona. Intentemos convertir la “cadena inmutable” a una “cadena” dinámica:
// fails with: cannot return value referencing local variable `l`
fn limited_lifetime<'a>() -> Vec<&'a String> {
let l = ["A".into(),"A".into(),"B".into(),"D".into()];
α(&l)
}
De acuerdo, este es el error que esperábamos: el verificador de préstamos funciona correctamente. Pero, ¿cómo podemos indicarle al compilador que queremos que se transfiera la propiedad de esas variables asignadas localmente? Para lograrlo, debemos informarle al compilador que queremos que el array l se asigne en el montón. Y para ello, necesitamos usar un vec en lugar del array.
// this works
fn β<T: Clone + Eq + std::hash::Hash>( l: Vec<T> )  -> Vec<T> {
let hash_set: HashSet<_> = l.into_iter().collect();
hash_set.into_iter().collect()
}

fn limited_lifetime<'a>() -> Vec<&'a str> {
let l2 = vec!["A","B","B","D"];
β(l2)
}

fn main() {
println!("{:?}",limited_lifetime());
}
Esta versión funciona porque la nueva función β toma un vector de elementos y devuelve el mismo elemento en lugar de un puntero a ellos. Por lo tanto, los elementos se clonan. ¿Qué pasaría si, en cambio, quisiéramos que la función β devolviera un puntero a los elementos de entrada?
Tercer desafío: Clonar en Write
Link to heading
¿Recuerdas la “Vaca” en la última función omega?
fn ω( l: &’a [T]) → Cow<&’a [T]>
Cow es en realidad una enumeración. Puede contener una referencia inmutable (prestada) o un clon mutable de la misma. Por ejemplo:
use std::borrow::Cow;
fn trim_input(input: &str) -> Cow<str> {
if input.ends_with(' ') {
Cow::Owned(input.trim_end().to_string())
}
else  Cow::Borrowed(input)
}
Entonces, ¿debemos escribir Cow<'a [T]> o Cow<&'a [T]>? A primera vista, dado que la entrada es un puntero & con una vida útil 'a a un objeto de tipo [T], la salida también es un puntero a un objeto del mismo tipo. La diferencia radica en que Cow<> también significa puntero. Por lo tanto, sí, la respuesta correcta debería ser Cow<'a, [T]>.
fn ω<'a, T>( l: &'a [T]) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
Lo interesante aquí es que, en Rust, los arrays tienen una longitud fija en tiempo de compilación. Entonces, ¿cómo podríamos asignar un nuevo array con un tamaño dinámico en tiempo de ejecución? Pues, aparentemente, según este comentario de Stack Overflow, no es posible. ¿Quizás Ralf se refería a usar un vec en su lugar?
fn ωx<'a, T: Clone + Eq + std::hash::Hash>( l: &'a Vec<T>) -> Cow<'a, Vec<T>> {
let hash_set: HashSet<_> = l.into_iter().collect();
if hash_set.len()==l.len() {
return Cow::Borrowed(l);
}
let own_copy = hash_set.into_iter().cloned().collect();
return Cow::Owned(own_copy);
}
Honestamente, debo admitir que me he ahogado en la sintaxis “fn ω<‘a, T>( l: &‘a [T]) -> Cow<‘a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }”, que debería significar simplemente “un clon del mismo”.
Si consideramos que &'a T se puede reescribir como Ptr<'a,T>, entonces también podemos reescribir la función como:
fn ω<'a, T>( l: Ptr<'a, [T]>) -> Cow<'a, [T]> where [T]: ToOwned { Cow::Borrowed(l) }
Si omitimos el hecho de que T es un array, el código anterior se puede reescribir como
fn ω<'a, T: ToOwned>( l: Ptr<'a, T>) -> Cow<'a, T> { Cow::Borrowed(l) }
¿Y qué tal si reescribimos el tipo como una expresión basada en macros en lugar de una sintaxis?
fn ω<'a, T>( l: Ptr<'a, T> ) -> !Cow(l) { Cow::Borrowed(l) }
Al permitir la reescritura, la macro !Cow(l) puede hacer implícito que el tipo T debe estar vinculado al rasgo ToOwned. Pensando de esta manera, podríamos anticipar que 'a y T son tipos genéricos que no necesitan especificarse explícitamente al usar el rasgo Ptr.
fn ω( l: Ptr ) -> !Cow(l) { Cow::Borrowed(l) }
Lo que resulta confuso entonces es que especifiquemos tanto el tipo en tiempo de compilación como la implementación en tiempo de ejecución sin ninguna distinción. Pero quizás de eso se trata realmente Rust.
Creo que el “secreto” de Ralf es algo que podría explicarse en una hora y requerir su propia presentación de diapositivas, no solo tres minutos en una charla de una hora. También valdría la pena analizarlo críticamente; ¿quizás no todo es tan agradable? ¿Quizás hay un exceso de complejidad que desanima a muchos desarrolladores? ¿Y quizás a eso se refiere con “diversión”? En fin, intentaré preparar algunas diapositivas para una charla de una hora durante las próximas semanas.
Volviendo al desafío de la computación cuántica, la pregunta es si necesitamos un nivel de complejidad similar para que los sistemas de computación cuántica funcionen. ¿Quizás este sea el desafío actual? Aunque aparentemente complejos, los algoritmos cuánticos son bastante simples en comparación con esta sintaxis rudimentaria. ¿Tal vez sí necesitemos anticiparnos para resolver el desafío de la “utilidad” de la computación cuántica? ¿Y que, sin esta complejidad adicional, seguiremos siendo capaces de realizar únicamente cálculos básicos?
Suponiendo que todo esto se reduce a la semántica de los objetos que queremos manipular, tal vez debamos darnos cuenta de que existe un nivel de abstracción lógica por encima de los cúbits, que aún no es evidente porque la industria todavía está luchando por lograr que los cúbits se comporten correctamente.