Der Einsatz von KI, genauer gesagt von neuronalen Netzen (NN), ist nicht nur naheliegend, sondern im Jahr 2025 nahezu unverzichtbar für jedes System. Daher überrascht es nicht, dass zahlreiche Forschungsarbeiten zu diesem Thema veröffentlicht wurden. Die jüngsten Forschungsergebnisse haben die Grenzen des Machbaren jedoch auf eine neue Ebene gehoben, indem sie die hochleistungsfähige Integration neuronaler Netze in Quantenkontrollsysteme ermöglichen.
Dieser Artikel basiert auf der Arbeit des Singapore Centre for Quantum Technologies CQT/NUS und insbesondere auf den Forschungen von Arthur Strauss, mit dem ich die große Ehre hatte, während der letzten SQA-Veranstaltung Ideen auszutauschen.
Ihre Idee ist faszinierend: Mithilfe eines Reinforcement-Learning-Ansatzes soll das Quantenkontrollsystem die Steuerung der Qubits (auch Gatter genannt) optimieren. Grundlage dafür ist ein Belohnungssystem, das die Effizienz der Steuerung maximiert. Sie fragen sich vielleicht, warum das wichtig ist. Wie bereits im vorherigen Artikel (link) erläutert, sind Qubits sehr empfindliche „Entitäten“, die besondere Aufmerksamkeit erfordern. Hier kommt das neuronale Netzwerk ins Spiel: Es hilft, die Qualität dieser Aufmerksamkeit, auch Fidelity genannt, zu quantifizieren.
Wie funktioniert das? Das Reinforcement Learning basiert auf einem Zyklus von Beobachtungen/Aktionen, die über ein iteratives Umgebung-Agent-Belohnungssystem gelernt werden (“a” im Diagramm unten), das üblicherweise mit einer GPU ausgeführt wird und dann, sobald es gelernt ist, auf einer eng gekoppelten matmul (oder nicht) auf dem Quantenkontrollsystem ausgeführt wird (“b” im Diagramm unten).
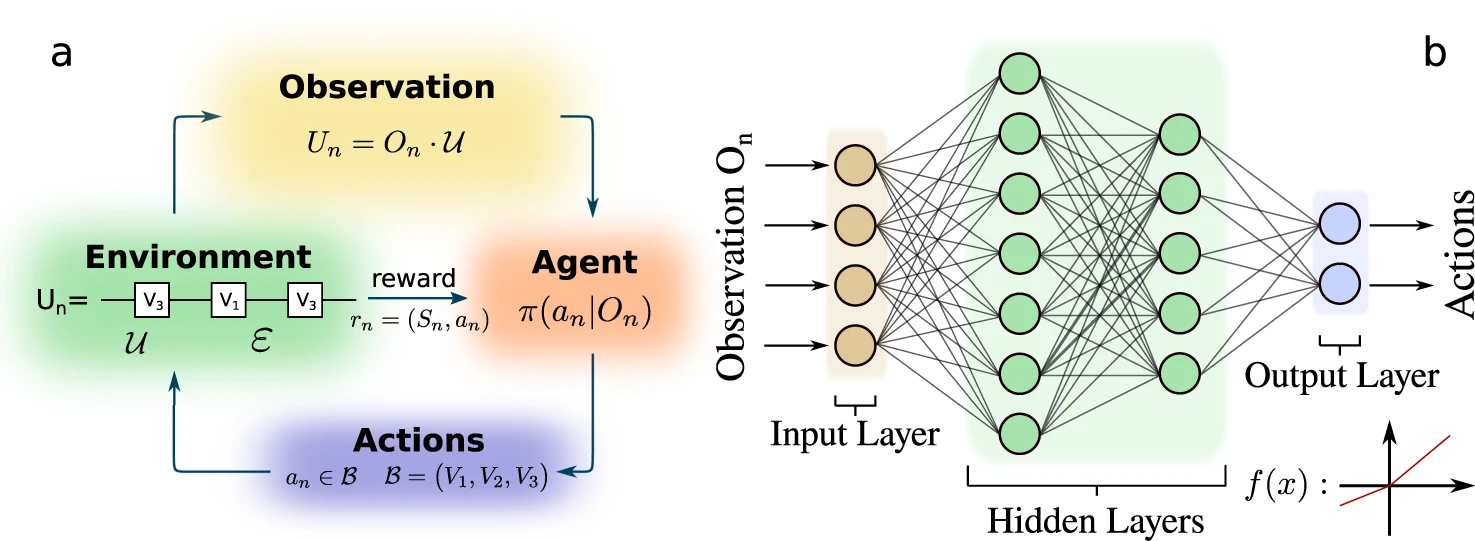 Bildnachweis: Nature
Da die Beobachtung (auch Qubit-Auslesen genannt) den Quantenzustand zerstört, wird im Lernzyklus zunächst der Qubit-Zustand zurückgesetzt, ein Kontrollgatter ausgeführt, der Qubit-Zustand ausgelesen und die Information an den Agenten weitergeleitet.
Werfen wir einen detaillierten Blick auf die 4 Komponenten des Reinforcement Learnings:
- Die Umgebung ist der Quantencontroller und das Qubit selbst.
Die Aktionen bestehen darin, die verschiedenen “Regler” oder Pulsparameter des HF-Generators anzupassen.
Die Beobachtung sind die Qubit-Charakteristika, nachdem sie von der Umgebung manipuliert wurden.
Der Agent ist derjenige, der die Strategie lernt, die auf die beobachteten Eigenschaften des Qubits reagiert und die Pulsparameter entsprechend anpasst.
RL-Methoden lassen sich im Allgemeinen in zwei große Kategorien einteilen: wertbasierte und politikgradientenbasierte Methoden.
Wertbasierte Methoden (siehe [https://gibberblot.github.io/rl-notes/single-agent/value-iteration.html]) konzentrieren sich auf die Schätzung einer Wertfunktion und die Ableitung von Strategien daraus. Strategiegradientenbasierte Methoden (siehe [https://gibberblot.github.io/rl-notes/single-agent/policy-based.html]) optimieren die Strategie direkt, indem sie die erwartete kumulative Belohnung mittels Gradientenaufstieg maximieren.
Der Vorteil der Policy-Iteration liegt in ihrer deutlich schnelleren Konvergenz im Vergleich zu wertbasierten Ansätzen, obwohl sie rechenintensiver ist. Hier kommen die Policy-Gradient-Algorithmen ins Spiel, die die Rechenkomplexität reduzieren. Beispiele für Policy-Gradient-Algorithmen, einschließlich des Reinforce-Algorithmus:
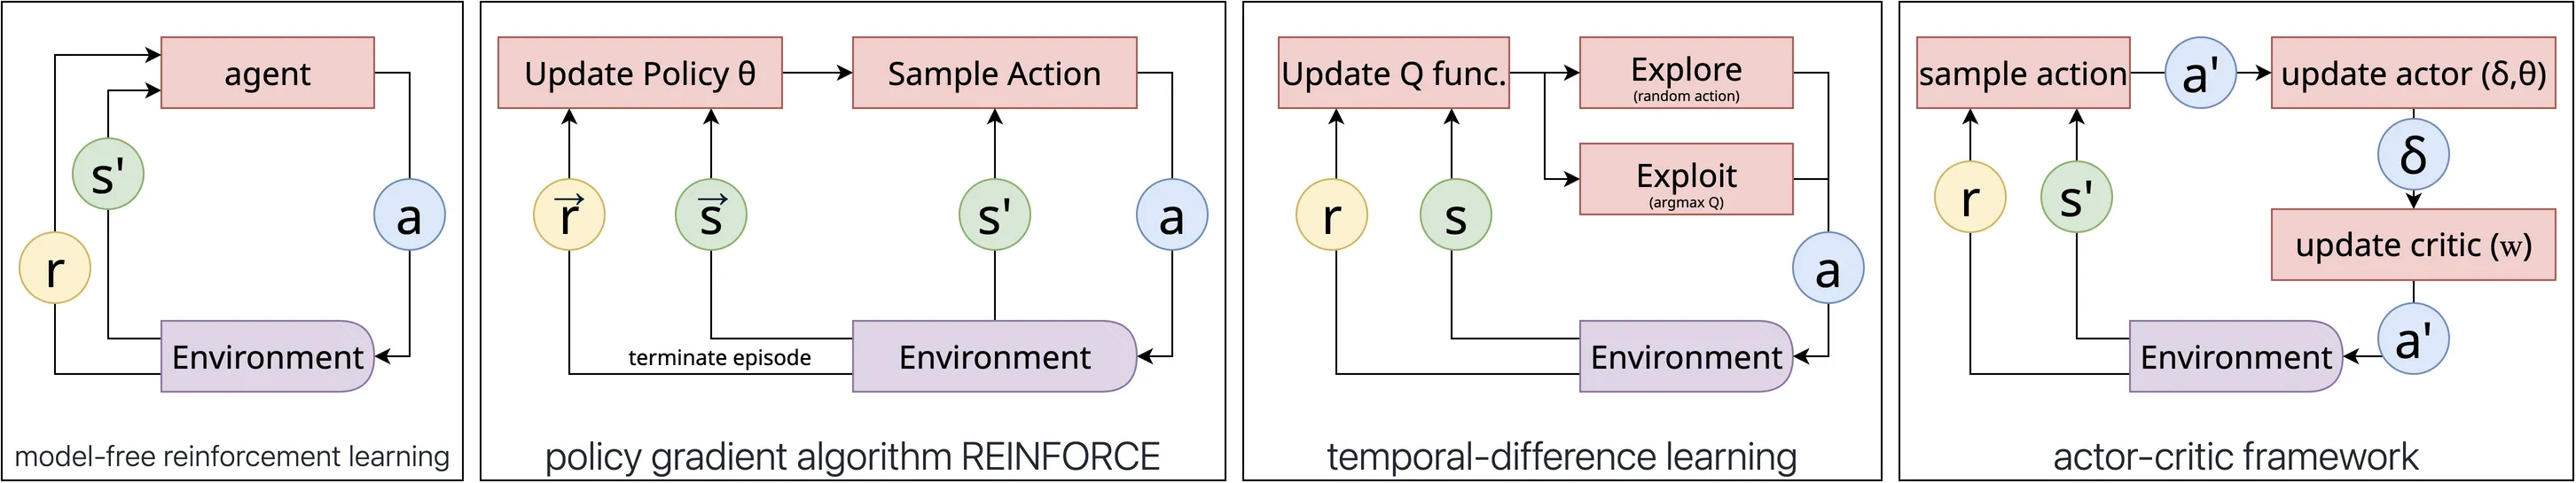
In den obigen Diagrammen steht s für den Zustand, a für die Aktion und r für die Belohnung.
Beim Reinforcement Learning sind Episode und Iteration unterschiedliche Konzepte:
Folge:
Eine Episode ist eine vollständige Abfolge von Interaktionen zwischen dem Agenten und seiner Umgebung, die von einem Anfangszustand ausgeht und in einem Endzustand (oder nach einem maximalen Zeithorizont) endet.
Beispiel: In einer Schachpartie ist eine Episode eine vollständige Partie – vom Startbrett bis zum Schachmatt, Remis oder der Aufgabe.
Iteration:
In einigen Veröffentlichungen/Codes kann eine Iteration einen Zeitschritt der Agent-Umgebung-Interaktion bedeuten (Zustand → Aktion → Belohnung → nächster Zustand).
Im Kontext der Optimierung kann eine Iteration einen Aktualisierungsschritt des Lernalgorithmus bedeuten (z. B. einen Gradientenabstiegsschritt, der auf mehreren Episoden oder Übergängen basieren kann).
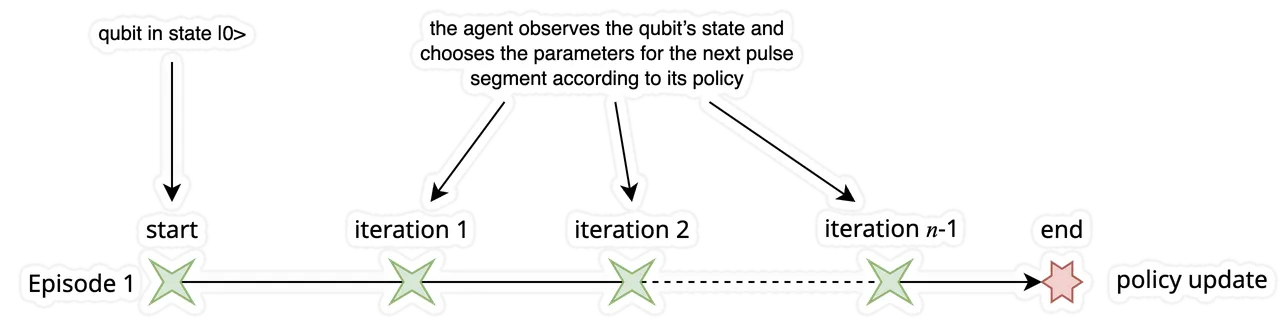
Lasst uns diese Ideen nacheinander umsetzen, angefangen mit der Episodenauswahl.
Die Episoden beginnen mit dem Qubit im Zustand |O>.
Starte die Beobachtungs-Handlungsschleife
Der Agent beobachtet den Zustand des Qubits
und wählt die Parameter für das nächste Impulssegment gemäß seiner Richtlinie aus.
Erkunden Sie die Aktionen durch Ausprobieren:
Anstatt deterministisch die „beste“ Aktion auszuwählen (zum Beispiel die mit der höchsten Wahrscheinlichkeit), bedeutet Sampling, dass der Agent zufällig eine Aktion aus dieser Verteilung gemäß den Wahrscheinlichkeiten auswählt.
Diese Stichprobenziehung ist bei der Verstärkungsmethode unerlässlich.
Berechne die Score-Funktion:
messen, wie viel wahrscheinlicher (oder unwahrscheinlicher) die gewählte Aktion wird, wenn die Netzwerkparameter in eine bestimmte Richtung verschoben werden.
Mit anderen Worten, werte ∇(𝜃) für die abgetastete Aktion aus.
Berechne die Belohnung, wenn das Ende des Pulsprogramms erreicht ist.
Die Punktzahl und die Belohnung steuern gemeinsam die Lernaktualisierung beim Policy-Gradient Reinforcement Learning:
noch zu erledigen
Tut mir leid, das sollte eigentlich ein kurzer Blogbeitrag werden, ist aber deutlich komplexer geworden. Vielleicht muss ich die Sache noch etwas vereinfachen. Wie dem auch sei, was haben wir gelernt? Der Optimierungsprozess zur optimalen Quantifizierung der Qubit-Qualität ist zu vieldimensional – und wenig überraschend eignen sich neuronale Netze hervorragend, um diese Herausforderung zu meistern. In diesem Blog haben wir uns auf die Optimierung der Genauigkeit eines einzelnen Qubits konzentriert. Stellen wir uns aber zwei oder mehr Qubits vor: Dann müssen wir die Auswirkungen des Übersprechens berücksichtigen. Es gibt viele Fragen und Herausforderungen, insbesondere hinsichtlich der Frage, wie man lernt: global auf der Ebene vieler Qubits oder lokal auf der Ebene einzelner Qubit-Paare. Vielleicht sogar hierarchisch auf der Ebene logischer Qubits. Viele Fragen, die ich im nächsten Blogbeitrag über Quantenfehlerkorrektur behandeln werde.
Weiterführende Informationen und Links: