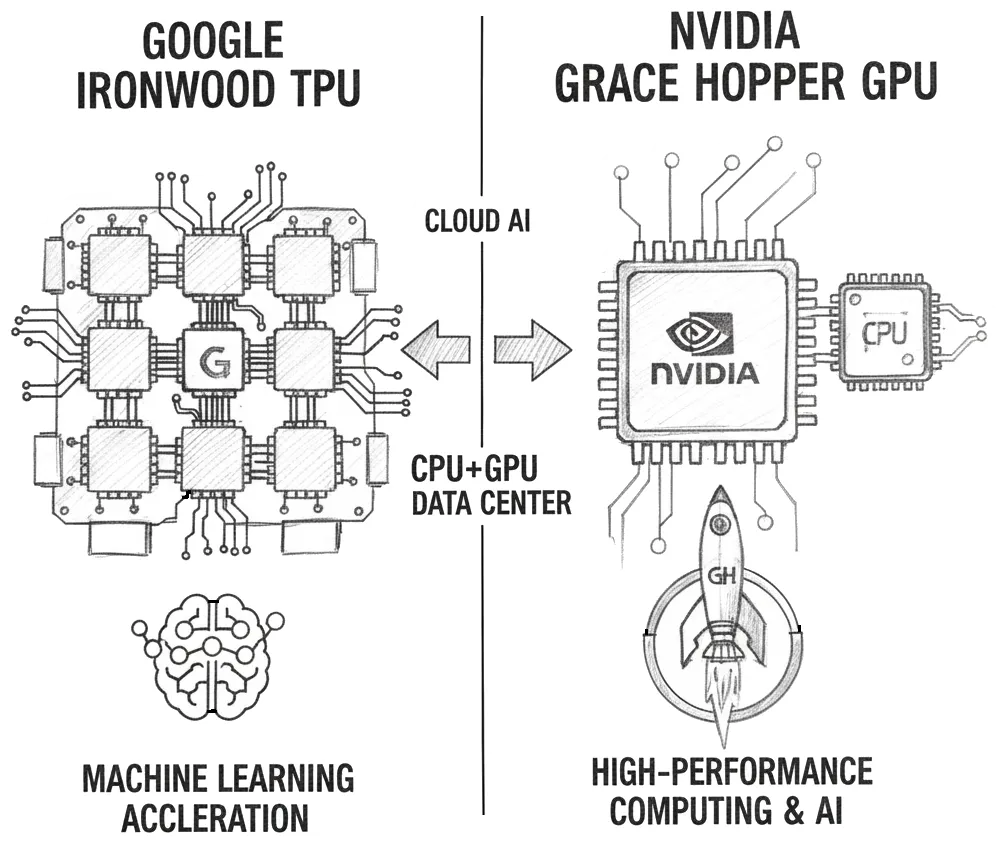
In einer Welt, in der KI extrem energieintensiv ist, stellt die Tensor Processing Unit (TPU) eine bahnbrechende Innovation dar. Es handelt sich um einen von Google speziell für maschinelles Lernen entwickelten Chip.
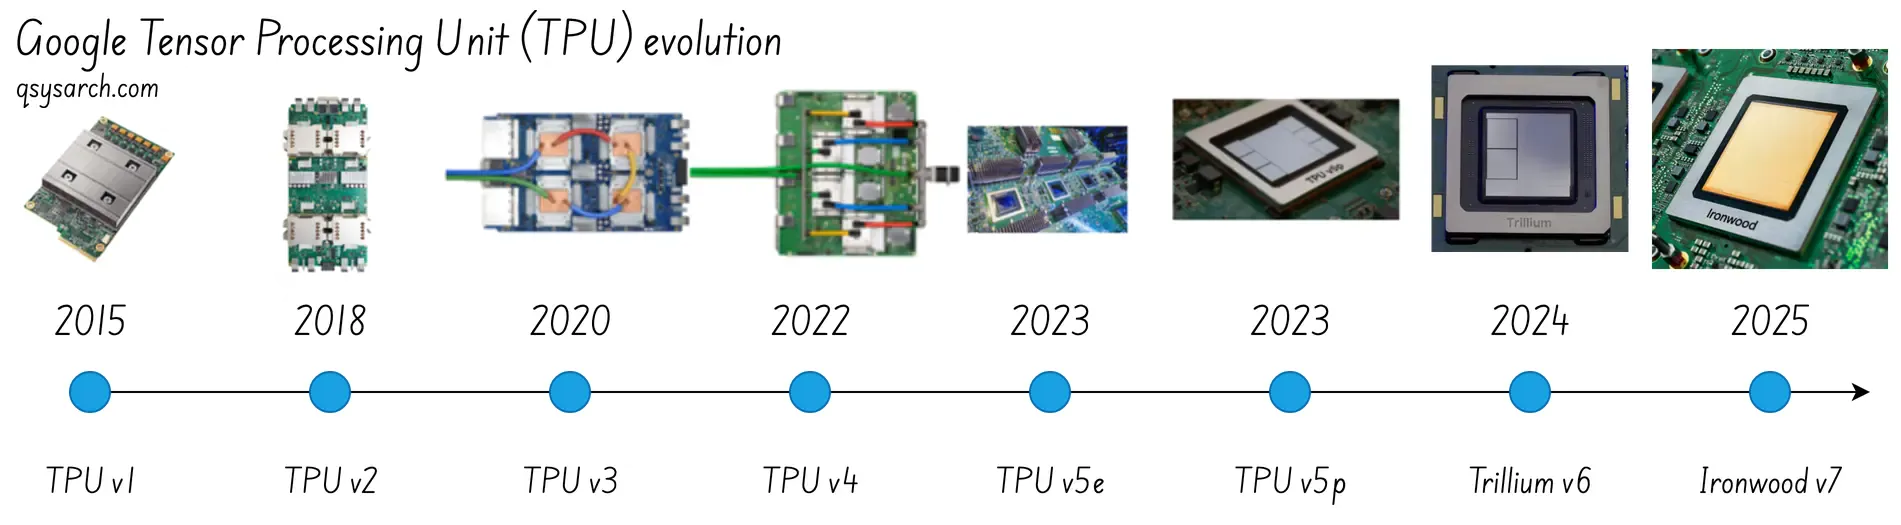
Dieses kurze Memo ist der Versuch, einen allgemeinen Überblick über die Architektur der TPUs und deren Entwicklung seit ihrer Einführung im Jahr 2016 zu geben.
Ich werde auch versuchen, diese grundlegende Frage zu beantworten: Wozu benötigen wir TPUs, wenn wir bereits GPUs haben? Welche Vorteile bieten sie gegenüber GPUs? Wie schneiden sie im Vergleich zu neuromorphen ICs ab? Und gibt es alternative Architekturen zu TPUs und GPUs?
 (Quelle: Google Cloud)
Warum es die TPU gibt – und welche Probleme sie löst
Link zu Überschrift
Die TPU verfolgt dasselbe Ziel wie die GPU: die durch die Verlangsamung des Mooreschen Gesetzes bedingten Einschränkungen durch massive Parallelverarbeitung zu überwinden. Im Gegensatz zu herkömmlichen CPUs, die für allgemeine Berechnungen eingesetzt werden können und dank des Konzepts der Mehrkernprozessoren (Dennard-Skalierungsgesetz) bis zu einem gewissen Grad auch eine gewisse Parallelverarbeitung ermöglichen, sind TPU und GPU spezialisierte Hardware, die für die Ausführung einfacher und spezifischer Aufgaben entwickelt wurde – und zwar wesentlich effizienter als jede CPU.
Im Prinzip kann man sagen, dass sie eine deutlich bessere Leistung und Effizienz als Allzweck-CPUs oder GPUs erzielen, indem sie „Allgemeinheit zugunsten der Leistung abwägen“.
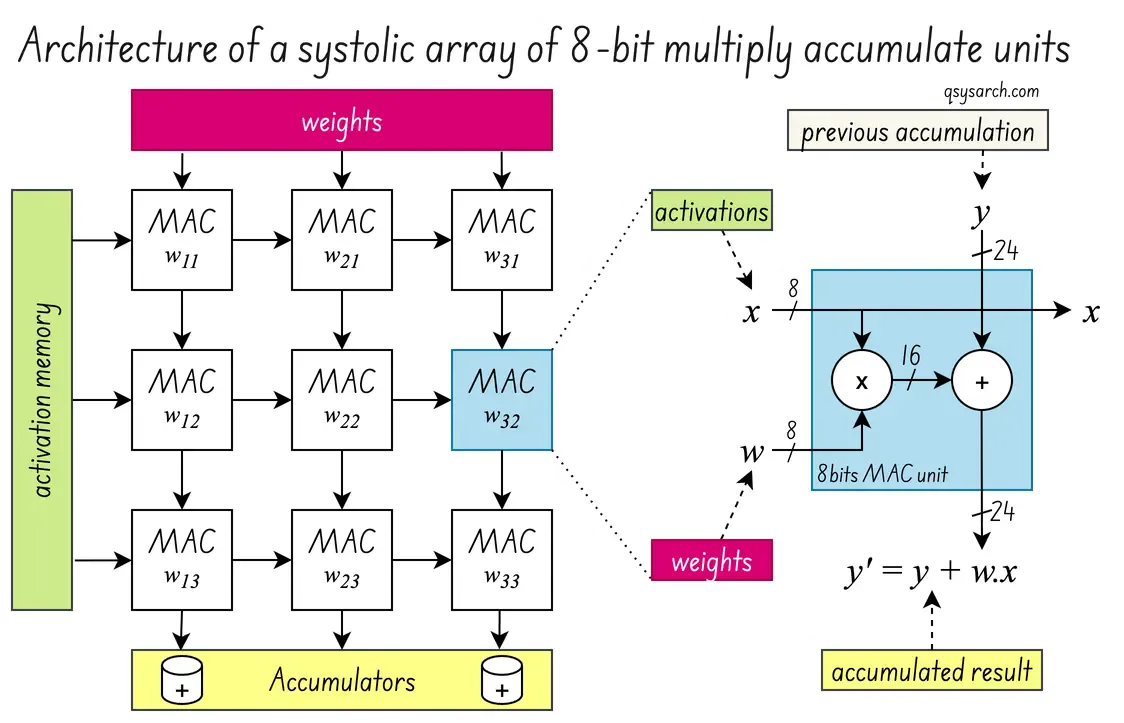
Die TPU ist grundsätzlich für rechenintensive Aufgaben der linearen Algebra konzipiert, wie Matrixmultiplikationen und Tensoroperationen, die von neuronalen Netzen verwendet werden.
Das Herzstück der TPU ist das systolische Array, eine Matrix von Verarbeitungselementen (üblicherweise PE genannt, im Diagramm rechts als MAC bezeichnet), die parallele Berechnungen durchführen können.
Im Fall der TPU ist diese Verarbeitungseinheit, auch MAC genannt, ein einfacher 8-Bit-Multiplizierer, der die Aktivierungswerte (das Embedding) mit den Gewichten des neuronalen Netzes multipliziert und akkumuliert. Nur durch die massiv parallele Ausführung dieser Operation erreicht die TPU einen deutlich höheren Durchsatz als eine CPU. Und das Gleiche gilt für GPUs! Doch zunächst werfen wir einen Blick auf die Entwicklung der TPU im Laufe der Zeit.
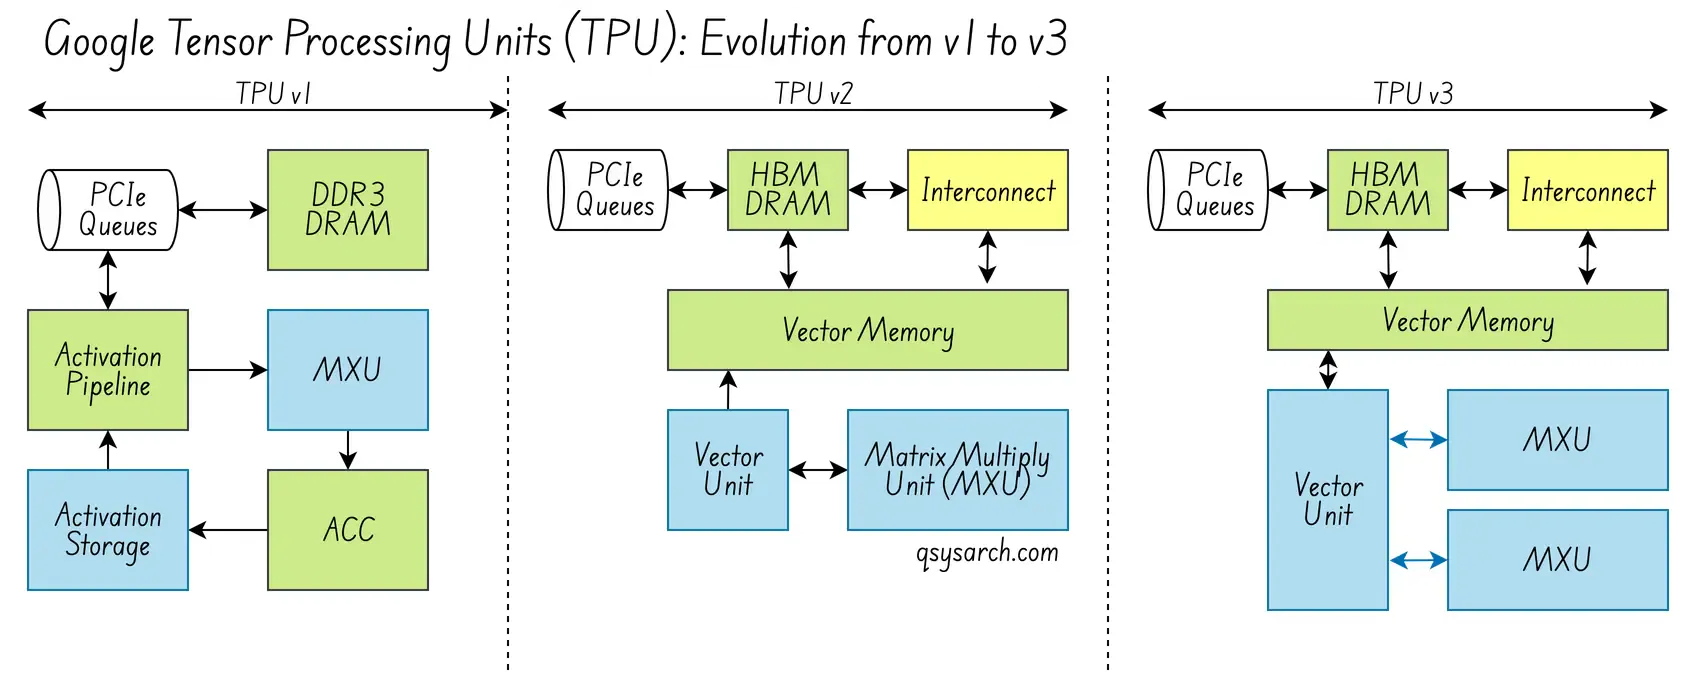
Die TPUv1 wurde in nur 15 Monaten entwickelt, mit dem Hauptziel, die Inferenz neuronaler Netze zu verbessern (nicht einmal das Lernen selbst, sondern ausschließlich die Inferenz). Dafür benötigte Google Matrixmultiplizierer und musste neben hoher Geschwindigkeit auch den Stromverbrauch reduzieren. Der Schlüssel zur Reduzierung des Stromverbrauchs lag in der Verbesserung der Speicherlokalität, d. h. in der Verringerung unnötiger Datenbewegungen zwischen externem Speicher und TPU-Speicher. Dies ermöglichte eine höhere arithmetische Intensität pro Steuereinheit, d. h. eine Reduzierung der Leerlaufzeit der TPU beim Warten auf Daten.
Aus Hardware-Sicht war das TPU v1-Design unkompliziert, aber elegant und effektiv:
Single-Threaded Co-Prozessor auf einer Standard-PCie-Karte.
Kein mehrstufiger Cache, kein Multithreading, keine Sprungvorhersage.
Schnelle deterministische Mathematik auf 8-Bit-Ganzzahlen über die MXU, oder Matrixmultiplikationseinheit.
Systolisches Array bestehend aus 256 * 256 * MXU
Die Komplexität wurde auf den Software-Scheduler verlagert, der zwei Hauptaufgaben übernahm:
Halten Sie die Pipeline ausgelastet, indem Sie die Operationen so planen, dass die MXU nie im Leerlauf ist.
Doppelte Pufferung des Speichers, um die Latenz des Speicherzugriffs zu verbergen.
TPUv2 und v3: Verbesserung von Speicher und Verbindungen
Link zu Überschrift
Die Schlüsselkonzepte in v2 und v3 sind das Training der nächsten Generation von Modellen, die Backpropagation, höhere Präzision und viel mehr verteilte, miteinander verbundene TPUs erfordern.
Aus Sicht der Hardware-Kernverarbeitung wurden einige interessante Konzepte eingeführt:
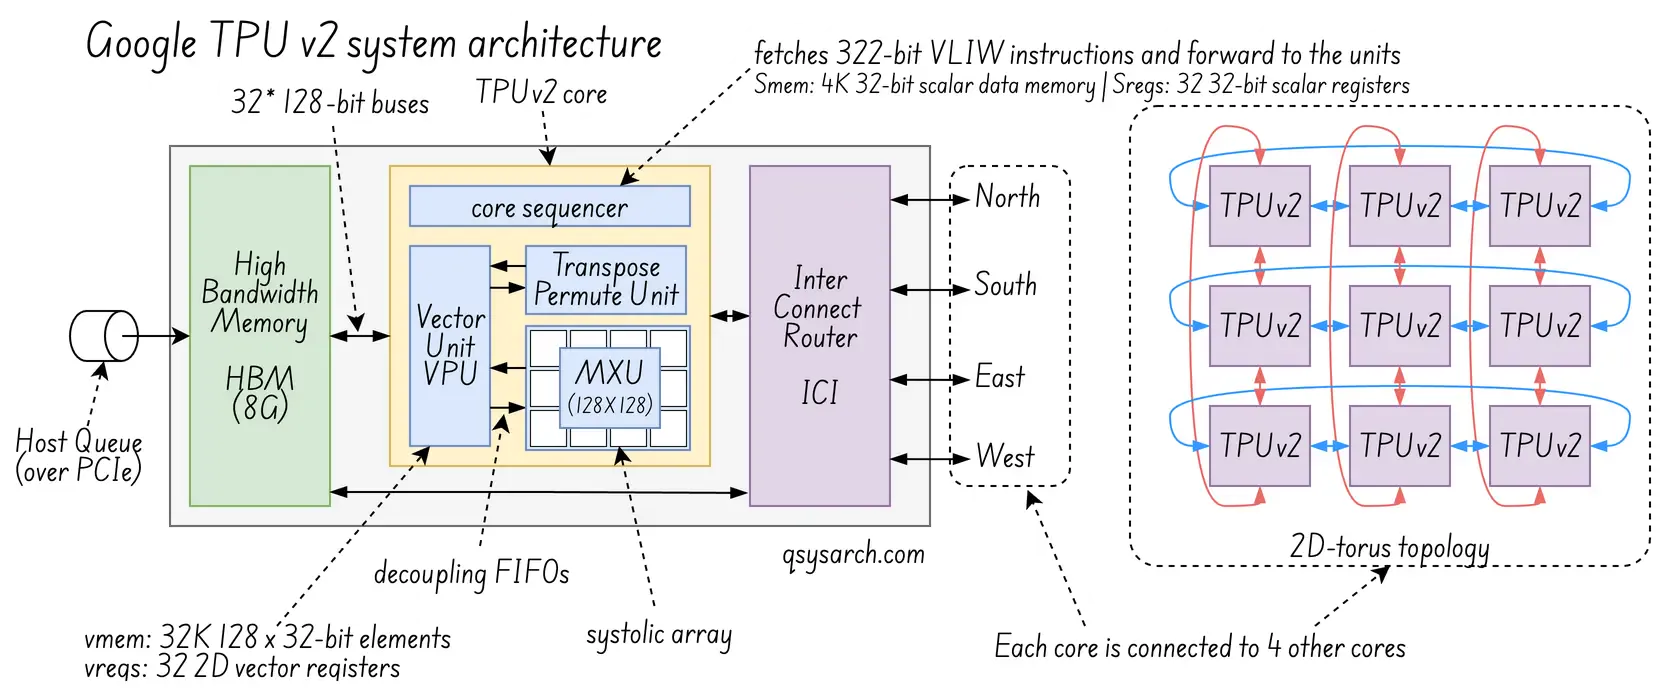
Ein Dual-Core-Chip, z. B. ein TPUv2, besteht aus zwei TPU-Kernen.
Jede TPU verfügte über ein viermal größeres systolisches Array, bestehend aus 128*128 MXU,
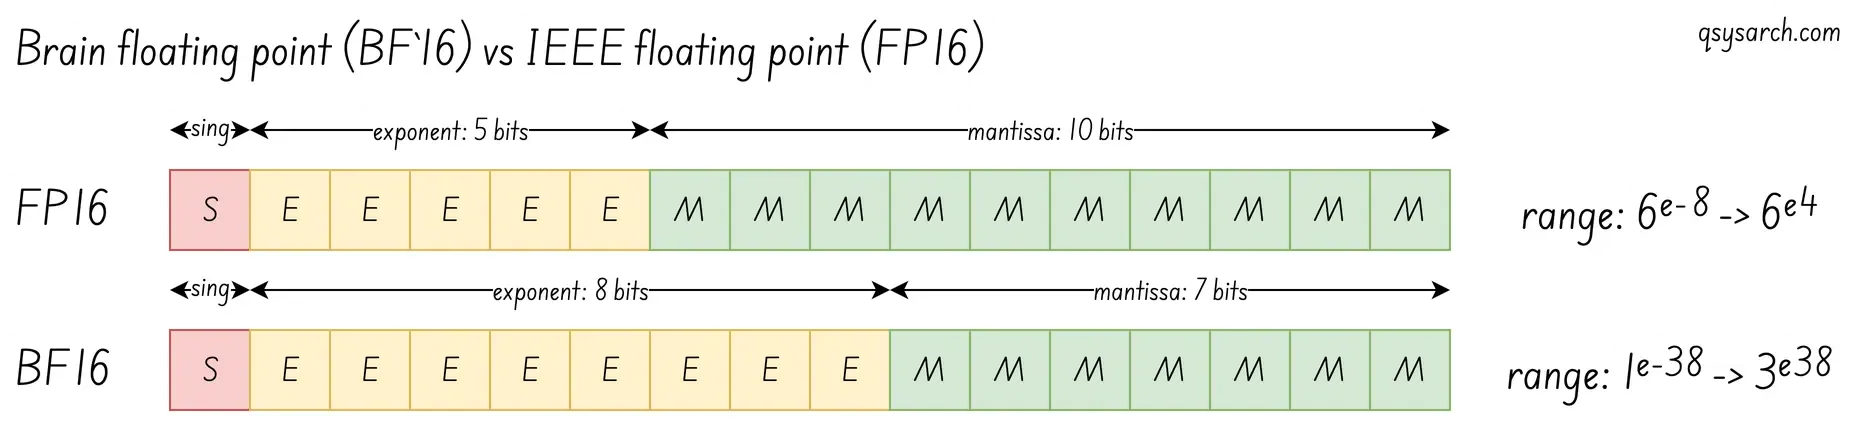
Fähigkeit zur Verarbeitung von Gleitkommazahlen unter Verwendung des Brain Floating Point Format (BF16), einer erweiterten Version des Standard-Gleitkommaformats IEEE 754 FP16.
Ein neuer Hochbandbreitenspeicher (HBM) innerhalb der TPU zur Reduzierung der Speicherzugriffslatenz; (TPUv1 verfügt nur über einen einfachen DRAM mit langsamer Zugriffszeit, während der HBM wesentlich schneller ist)
Aus Sicht der Hardware-Konnektivität,
- Ein Inter-Core-Interconnect (ICI), die Hochbandbreitenstruktur, die Skalierbarkeit ermöglicht, über ein 16x16 2D-Torusnetzwerk (Ringnetzwerk) - Supercomputer-Pod aus 256 Chips.
Aus Softwareperspektive ein leistungsstarker Compiler:
- XLA-Compiler: das Gehirn, das die vom Kernsequenzer (TCS) verwendeten VLIW-Befehle generiert.
Das Schlüsselkonzept in Version 4 war die Fähigkeit, KI-Modelle im Hypermaßstab auszuführen. Dies bedeutete, dass die wichtigste Kennzahl die Gesamtbetriebskosten (TCO) waren.
Die neuesten Generationen sind für das Training großer Datenmengen konzipiert. Die Chips sind in Racks oder Pods mit fortschrittlichen Speichersystemen und Verbindungen vernetzt. Sie unterstützen umfangreiche Tensoroperationen, verteiltes Training, Synchronisierung und effizienten Datenaustausch zwischen vielen Chips.
Aus Sicht der Hardware-Kernverarbeitung wurden einige interessante Konzepte eingeführt:
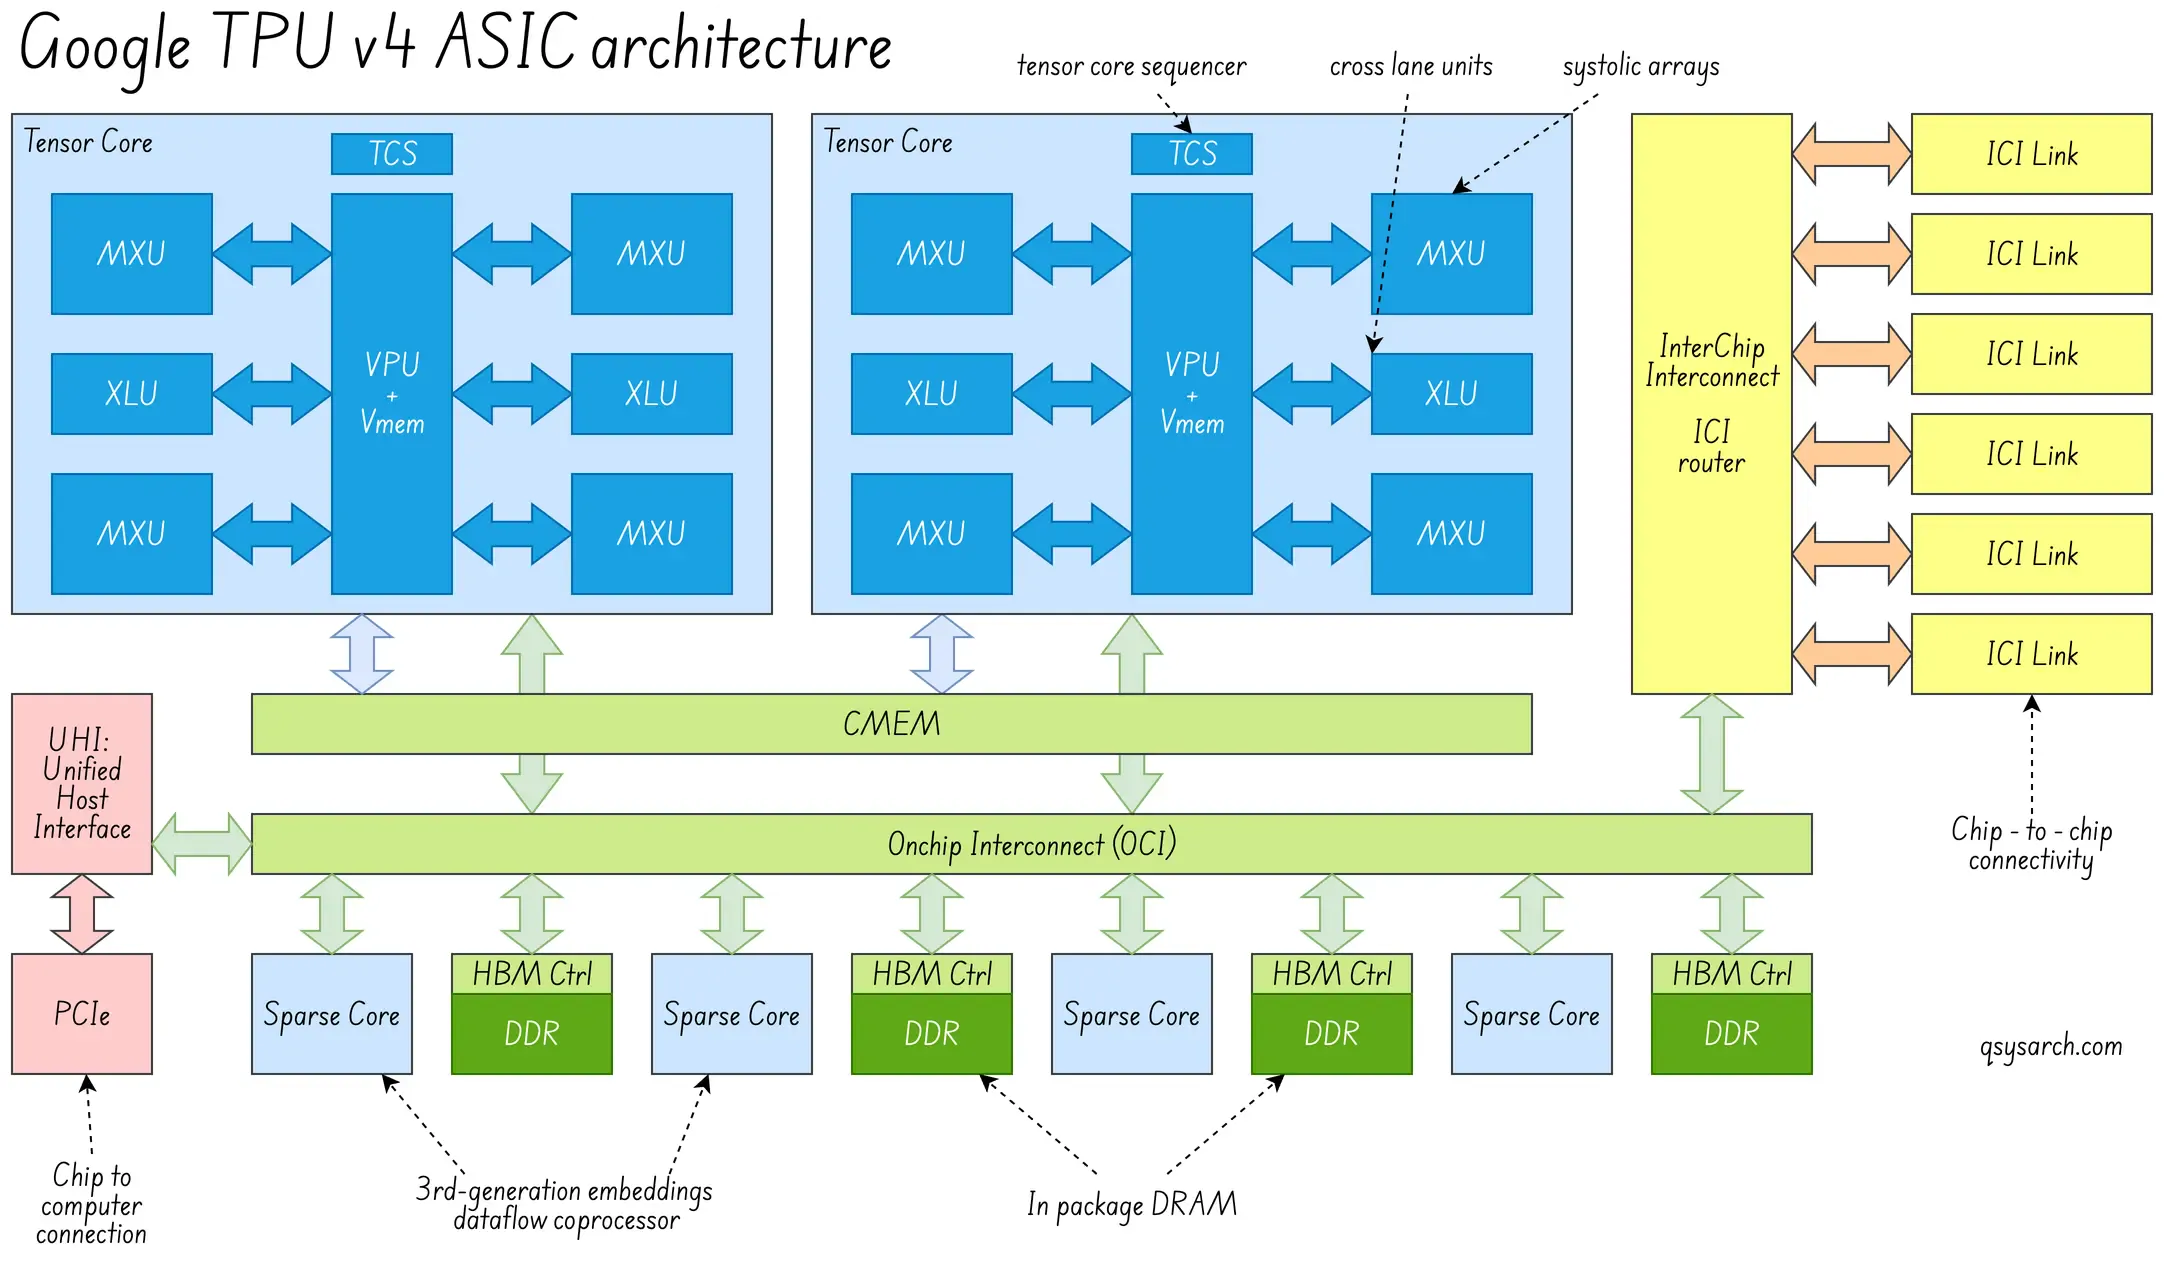
Ersatzkern: Verhindert, dass “Null-Operationen” auf die MXU treffen -> verbessert die Speicherauslastung.
Speichercache: (20x effizienter als der Zugriff auf entfernten RAM)
Aus Sicht der Hardware-Konnektivität,
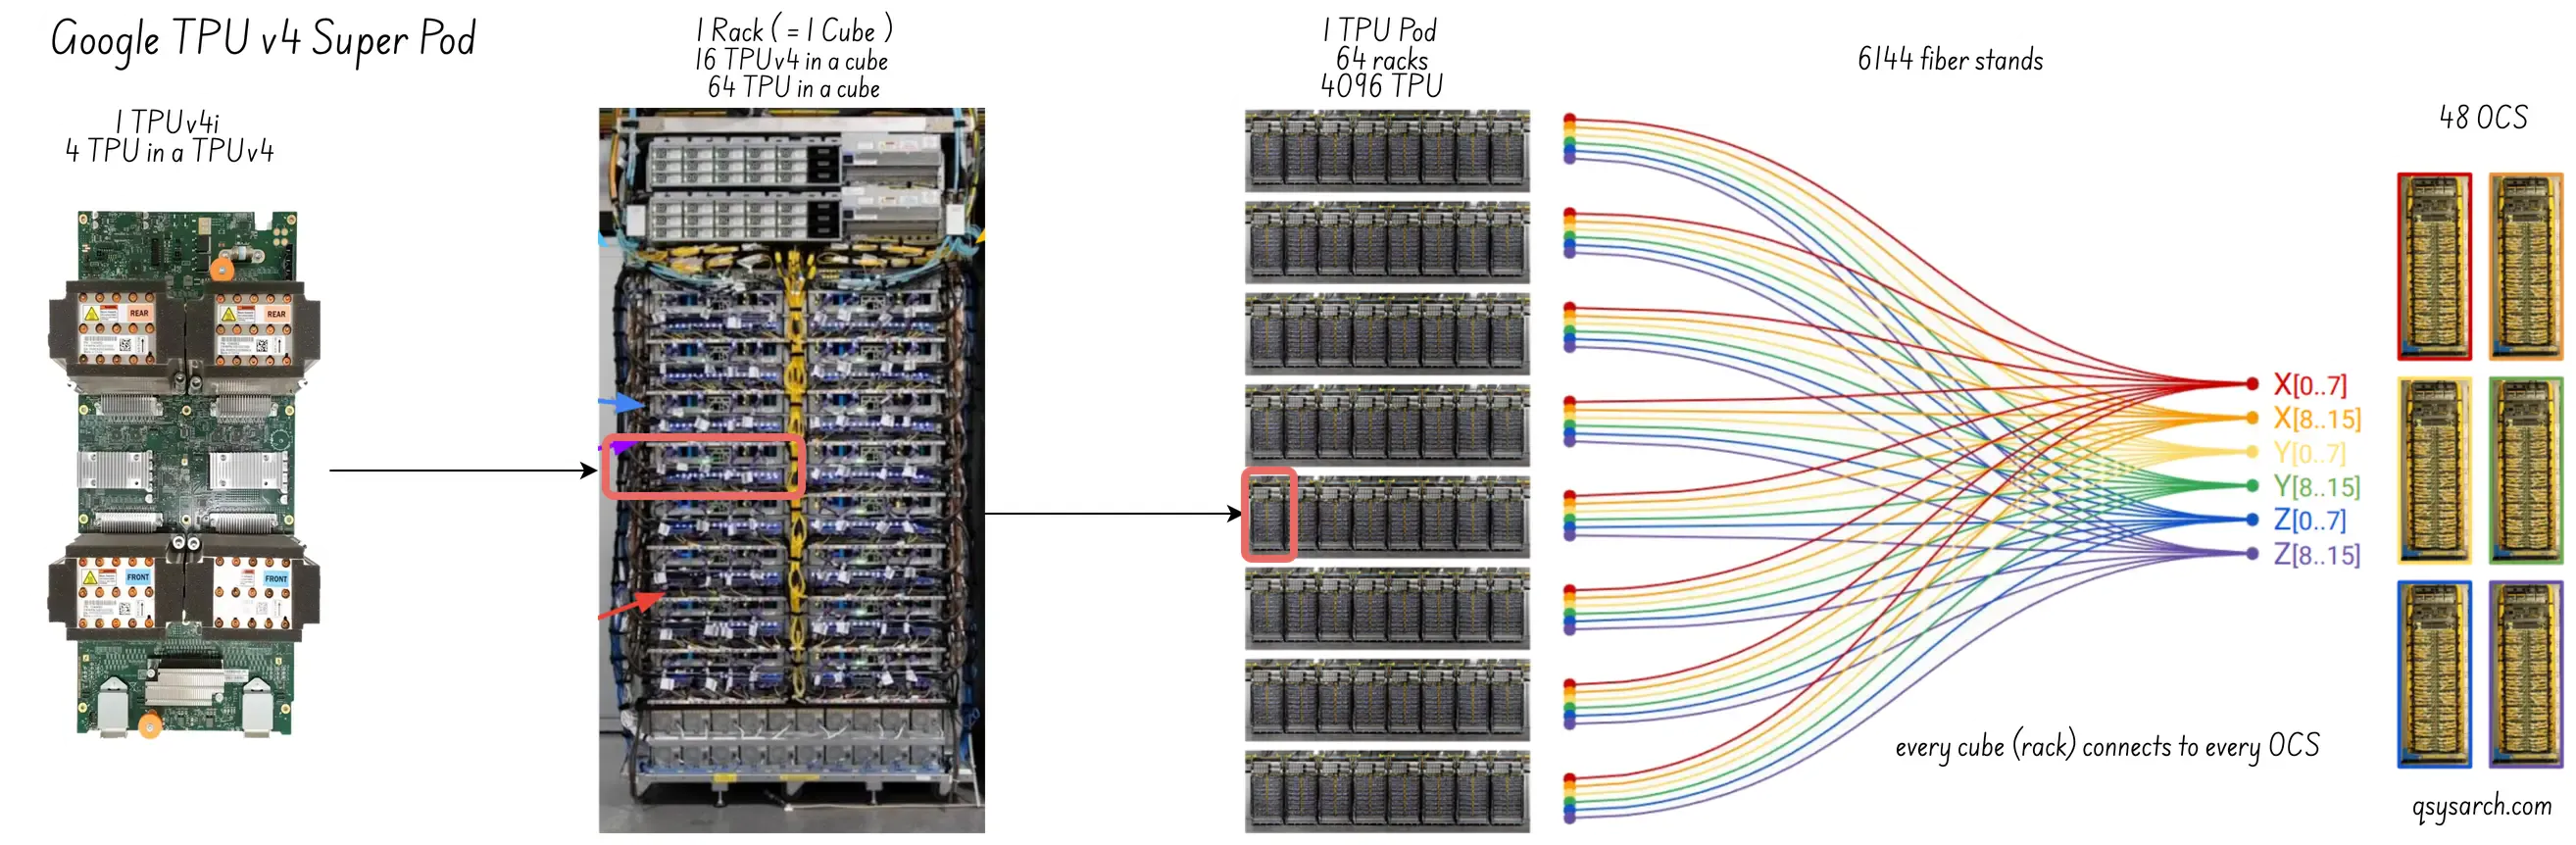
- Die TPUv4 verwendet, genau wie die TPUv2 und v3, weiterhin einen Interconnect-Router (ICI), der als elektrische Hochgeschwindigkeitsverbindung zwischen den TPUs innerhalb desselben Racks implementiert ist.
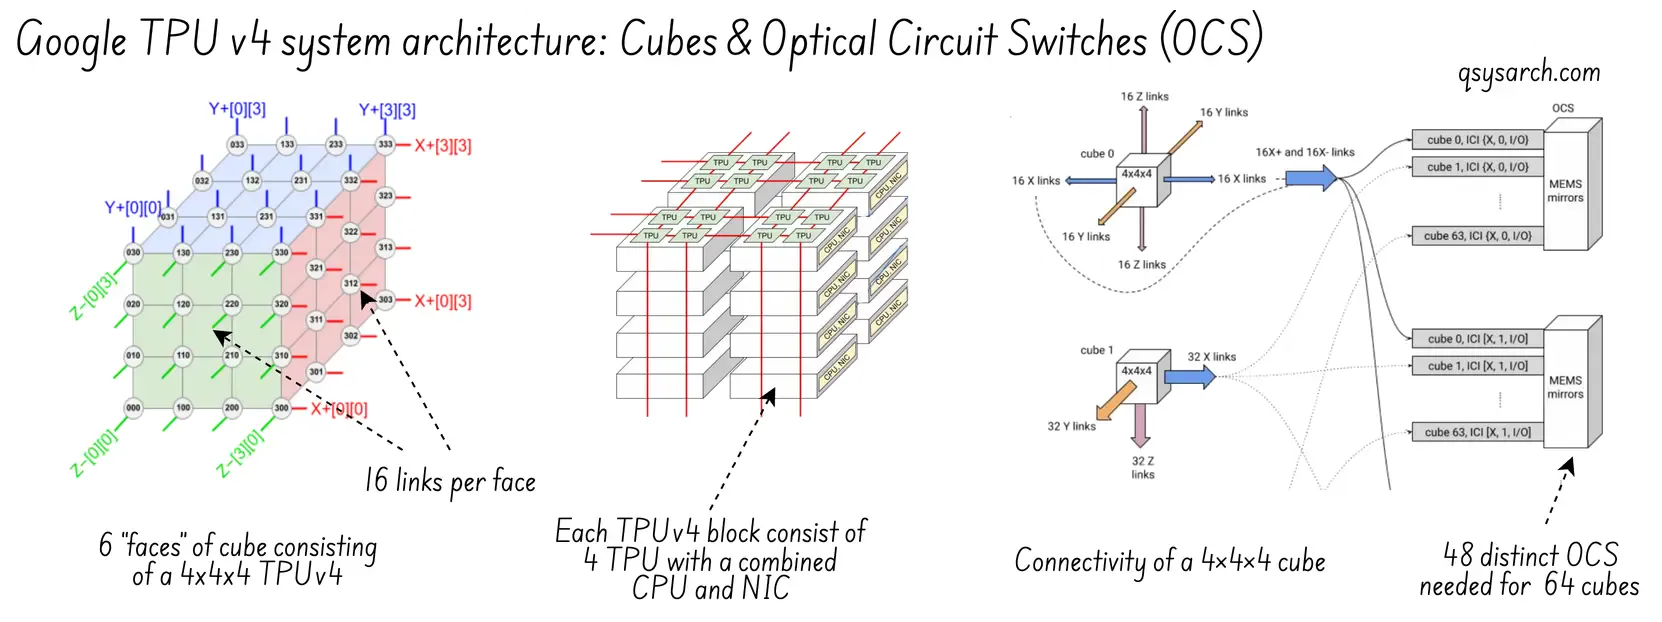
Die TPUv4 verfügt jedoch über eine zusätzliche optische Verbindung zwischen den Racks, die als Optical Circuit Switching (OCS) bezeichnet wird. Dadurch kann die Anzahl der TPUs in einem Pod auf 4.000 erhöht werden (im Vergleich zu 64 in einem einzelnen Rack), und Ausfälle können durch die Neukonfiguration des OCS-Routings minimiert werden.
- Zu guter Letzt wird das Routing nun dreidimensional, indem ein 3D-Torus implementiert wird, was den nicht zu vernachlässigenden Vorteil bietet, die Kommunikationseffizienz viel besser zu skalieren als der 2D-Torus.
Aus der Sicht der Software:
Einführung neuer Tools: Borg als Cluster-Manager; Pod-Manager zur Konfiguration des OCS; und Libpunet zum Einrichten der ICI-Routingtabellen und zur Bewältigung der Fehlertoleranz.
Erweiterter Single Program Multiple Data (SPMD)-Compiler: Dieser Compiler generiert mehrere Threads, wobei jeder Thread ein Programm darstellt, das auf einer anderen TPU innerhalb desselben Racks oder auf verschiedenen Geräten ausgeführt wird. Er ähnelt dem SIMT-Konzept der GPU, bei dem der Compiler Code für die Threads innerhalb eines GPU-Warps generiert.
Da viele TPUs das gleiche Programm ausführen, muss der Borg-Orchestrator sicherstellen, dass alle TPUs kompatibel sind - das ist die Aufgabe des Gang Schedulers.
- Erläutern Sie das Konzept der „Pfade“, die für die Verarbeitung asynchroner Datenflüsse für MoE erforderlich sind.
Der SparseCore (auch bekannt als SC) in TPUv4 beschleunigt Workloads mit dünnbesetzten Matrizen, deren Werte größtenteils null oder redundant sind (wie es bei den Einbettungen in LLMs der Fall ist). Er wird als „Einbettungs-Lookup“-Optimierer beschrieben, und jede TPUv4 enthält vier SparseCore-Prozessoren.
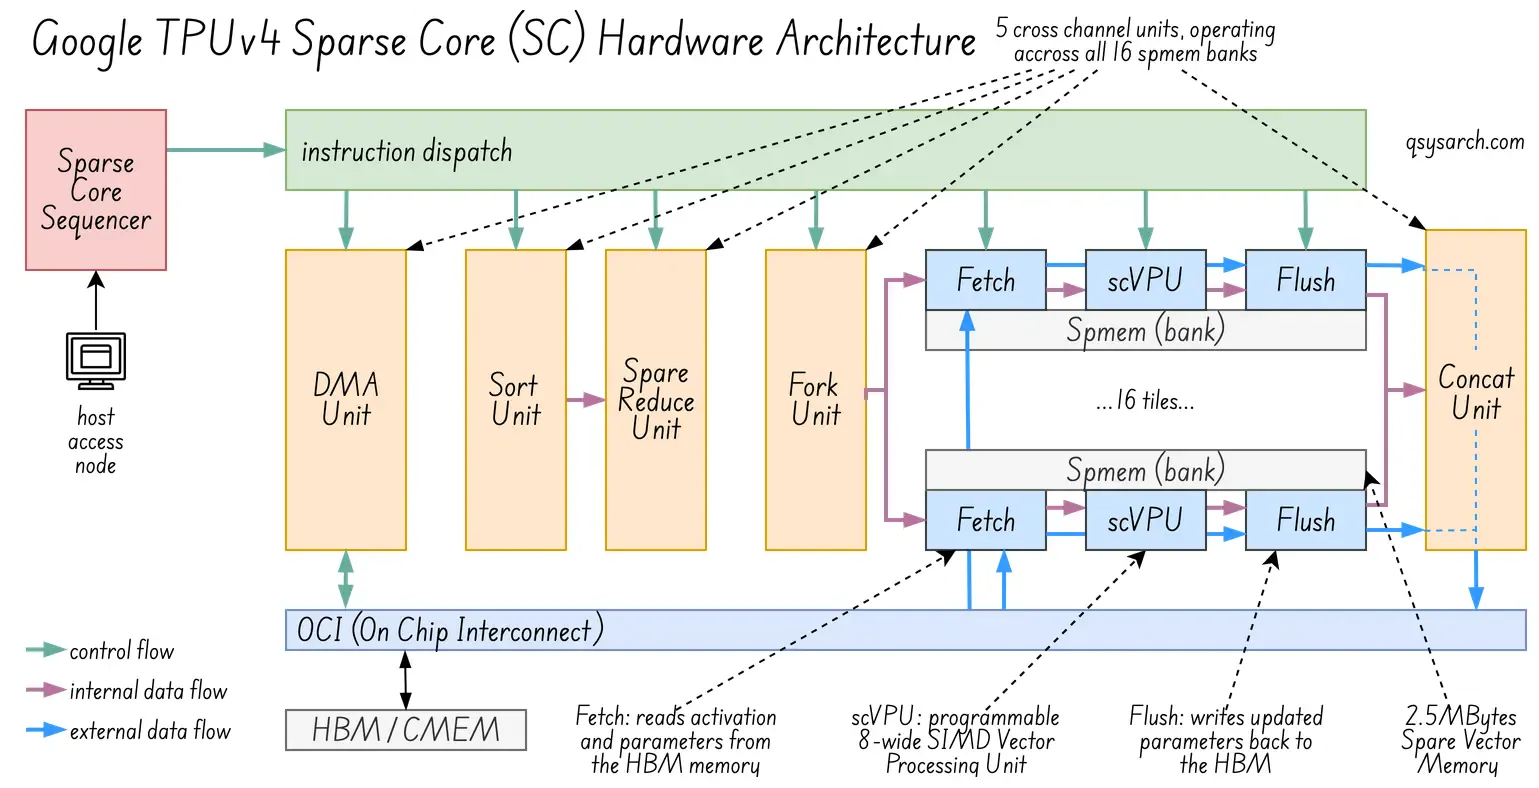 (Bild adaptiert vom Original Bildquelle)
Der SparseCore-Sequenzer (rot, oben links) ist die zentrale Steuereinheit, die die Befehle an die fünf Cross-Channel-Einheiten (orange) sowie an die drei SIMD-Einheiten für „Fetch/Process/Flush“ (blau) verteilt. Jede SIMD-Einheit arbeitet mit einem eigenen, eng gekoppelten 2,5 MB großen Arbeitsspeicher (grau).
Da jede SIMD-Einheit für Abruf, Verarbeitung und Leerung jeweils 8 Datenleitungen gleichzeitig bearbeitet (SIMD=8) und ein Sparse-Core-Prozessor 16 solcher SIMD-Einheiten enthält, handelt es sich um eine sehr leistungsstarke Verarbeitungseinheit – fast wie eine winzige GPU innerhalb der GPU! Oder genauer gesagt: 4 winzige GPUs innerhalb einer TPU!
Es wäre wirklich interessant, einen Blick auf die ISA zu werfen, die zur Programmierung dieser leistungsstarken SparseCore-Prozessoreinheit verwendet wird, aber ich konnte online keine Informationen dazu finden. Vermutlich liegt das daran, dass es sich eher um einen leistungsstarken „synchronen SIMD-ALU-fähigen DMA-Computer“ mit so spezifischen Befehlen handelt, dass es sinnvoll ist, eine Abstraktionsebene höherer Ordnung bereitzustellen, wie beispielsweise die JAX-Bibliothek (https://github.com/jax-ml/jax-tpu-embedding/tree/main/jax_tpu_embedding/sparsecore).
In der Praxis schreibt der Benutzer den funktionalen High-Level-Code, und der XLA-Compiler (Accelerated Linear Algebra) identifiziert Muster, die zu den Hardware-Fähigkeiten des SparseCore passen.
import jax
import jax.numpy as jnp
from flax import linen as nn

# 1. Define the Embedding Table
# Imagine 1 million items, each represented by a 128-dimension vector
vocab_size = 1_000_000
embed_dim = 128

class SparseModel(nn.Module):
@nn.compact
def __call__(self, indices):
embedding_layer = nn.Embed(num_embeddings=vocab_size, features=embed_dim)
return embedding_layer(indices)

# 2. Input data (Indices)
# Note that index 105 and 42 are represented twice - GH the XLA compiler
# be able to tell the SC to only fetch 3 memory location, and not just 5?
input_indices = jnp.array([105, 42, 28, 42, 105])

# 3. Generate the actual TPU/SC code (well, that's called compilation!)
model = SparseModel()
params = model.init(jax.random.PRNGKey(0), input_indices)
output = model.apply(params, input_indices)
Was passiert im Hintergrund? Die Methode model.apply ruft den XLA-Compiler auf, der den Code auf SparseCore herunterrechnet. Dazu greift sie auf nn.Embed (eine Gather-Operation) zu und generiert die folgenden „Pseudo-Anweisungen“:
Dedup: XLA stellt fest, dass die Zahlen 42 und 105 in Ihrer Eingabe doppelt vorkommen. Es generiert SparseCore-Anweisungen, um diese vor dem Abruf zu deduplizieren.
DMA: Generiert die SC-Skalar-Befehle zur Berechnung der Speicher-Offsets für die IDs 105, 42 und 28.
Push: Verschiebt den resultierenden 5*128-Tensor zurück in den Common Memory (CMEM).
Der XLA-Compiler muss sich auch um die Datenplatzierung kümmern. Da der Sparse Core auf die nn.Embed-Indizes zugreifen muss, müssen diese Indizes in einem für den Sparse Core zugänglichen Speicher abgelegt werden. Er könnte sie im CMEM speichern, dieser ist jedoch mit 128 MB recht klein, weshalb die Einbettung üblicherweise im großen HBM (32 GB für TPUv4) erfolgt. Die Ausgabe der Sparse-Core-Verarbeitung wird jedoch wieder im CMEM gespeichert, da sie nur einen Ausschnitt der Daten darstellt.
Erwähnenswert ist auch, dass sich die SparseCore-Architektur in den nachfolgenden v6+-Generationen weiterentwickelt hat.
Der Mixture-of-Experts-Ansatz (MoE) unterscheidet sich vom herkömmlichen Ansatz …
Das Konzept der „Pfade“ bezieht sich auf die physischen und logischen Wege, die Token nehmen, wenn sie auf Experten verteilt werden, die auf verschiedenen TPU-Chips arbeiten.
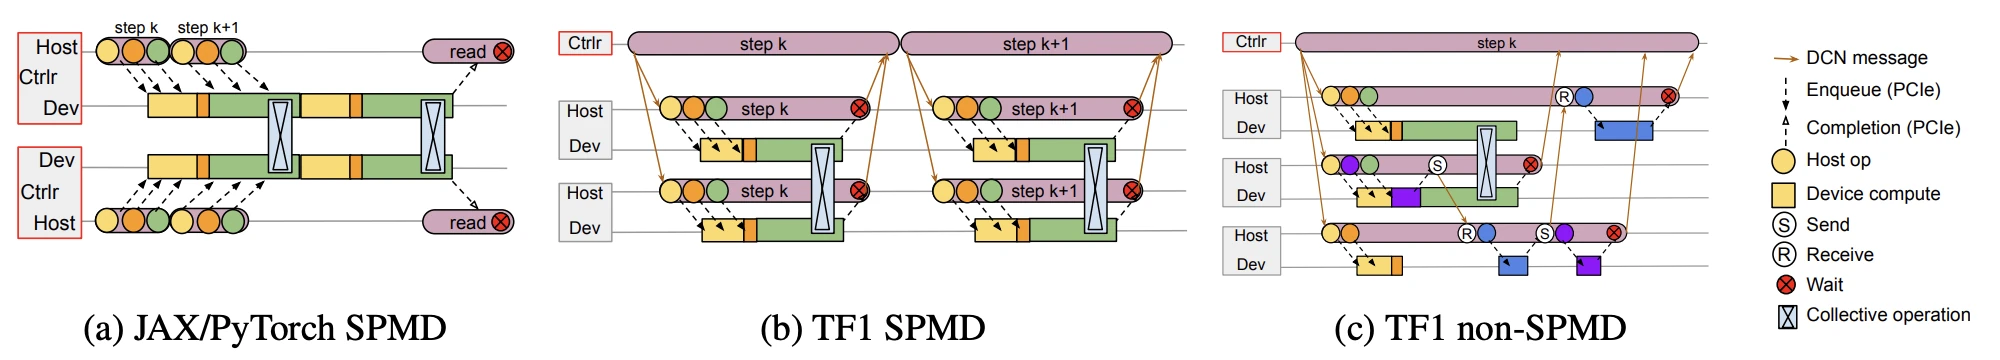 (Bildquelle)
Ab 2023: Version 5, Version 6 (Trillum) und Version 7 (Ironwood)
Link zu Überschrift
Über die neueren Generationen sind nicht viele Informationen verfügbar, daher sind dies die großen Scheinwerfer:
v5e: 16 GiB HBM3e pro Chip;
v5p: 95 GiB HBM3e pro Chip;
v6: 32 GiB HBM3e pro Chip; Verbesserte BF16-Leistung
v7: 192 GiB HBM3e; Neue FP8-Präzision
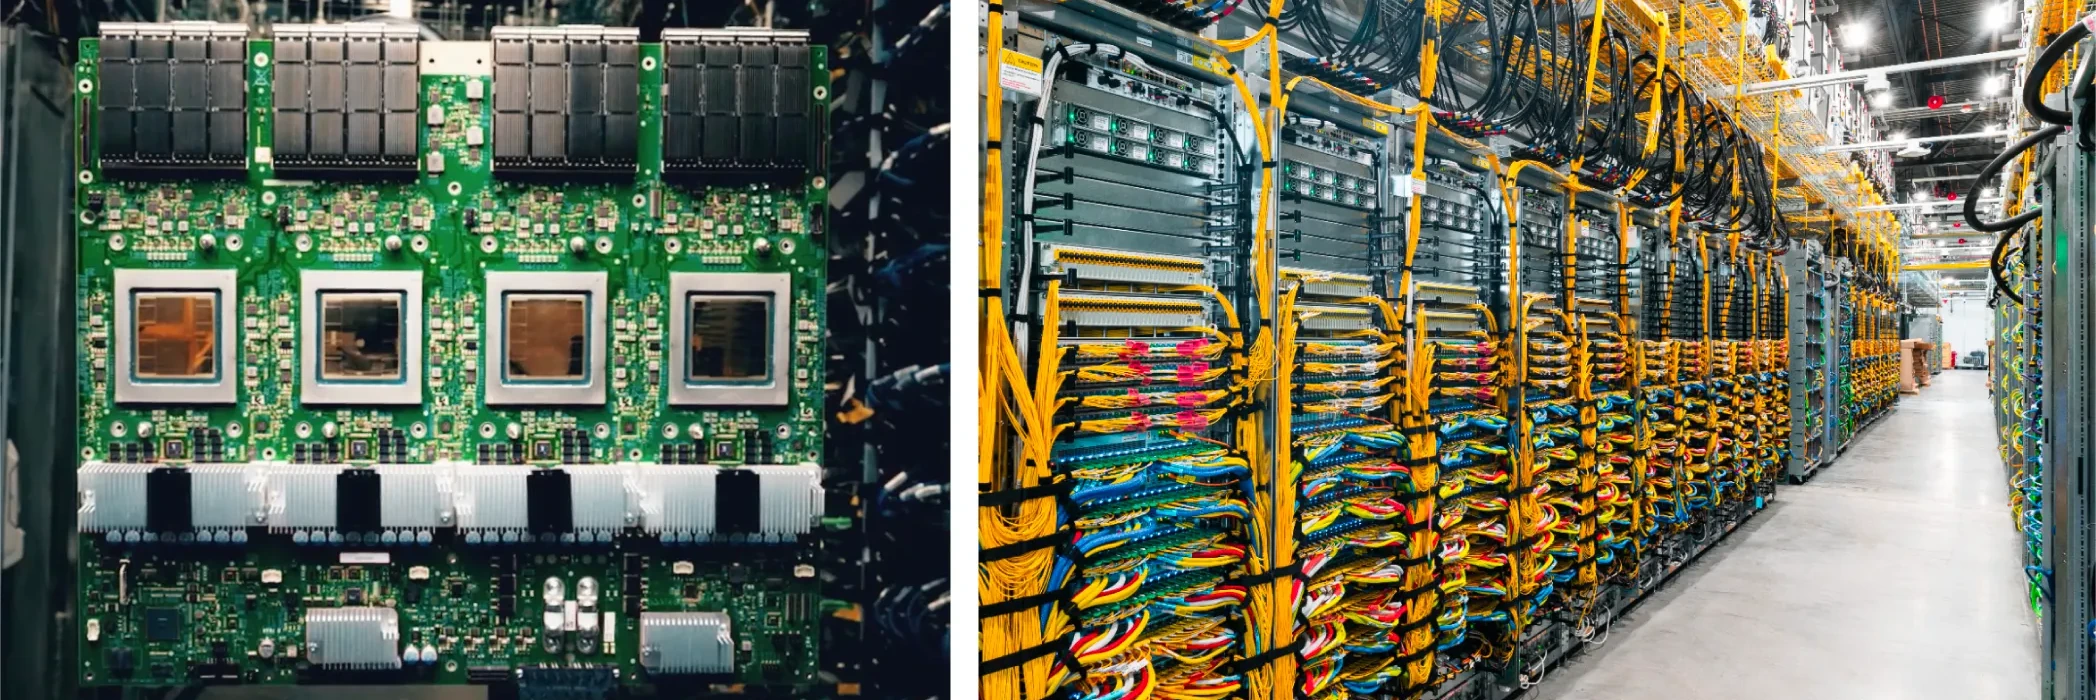
Bei Ironwood v7 besteht ein Super-Pod aus ca. 9.000 TPUs.
Warum benötigen wir also noch GPUs, wenn wir TPUs haben?
Das Design der TPU, das Speicher, Rechenleistung, Energieverbrauch und Datenkommunikation optimal aufeinander abstimmt, zeigt, dass der Aufbau leistungsstarker KI-Systeme in großem Maßstab nicht allein von schnellen Chips abhängt. Er erfordert auch die Koordination zwischen Hardware, Software, Systemen und Netzwerkverbindungen.
Verarbeitung von Pixeln vs. Verarbeitung von Matrizen
Link zu Überschrift
Obwohl KI-Workloads heutzutage vielfältiger sind und Inferenz, Training, Sparse-Modelle und Empfehlungssysteme umfassen, sind TPUs nicht für die Pixelverarbeitung ausgelegt. GPUs sind hingegen derzeit nicht weit verbreitet, da Nvidia ein Programmiermodell und eine Entwicklererfahrung bereitgestellt hat, die es GPUs ermöglichen, sich wie eine TPU zu verhalten.
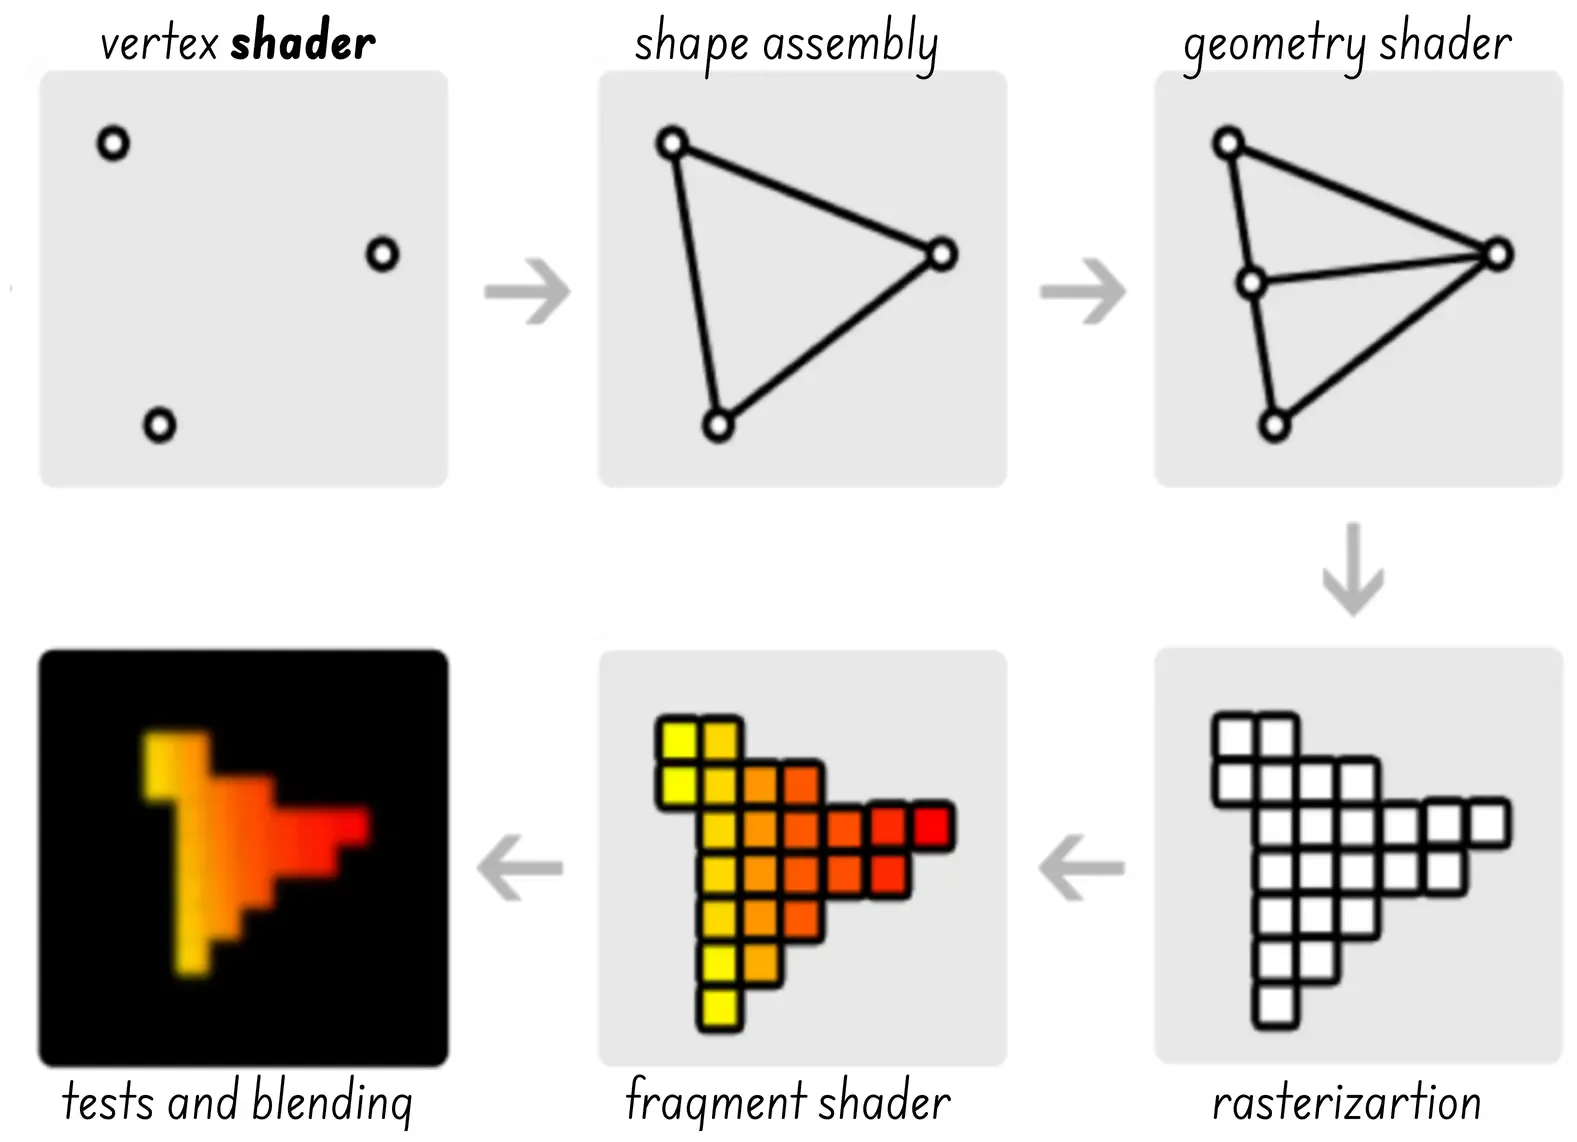
Bedeutet das, dass GPUs überlegen sind? Nicht unbedingt – bei bestimmten Arbeitslasten können TPUs effizienter sein als GPUs, insbesondere hinsichtlich Stromverbrauch und Leistung pro Watt. Und in der heutigen Zeit, in der KI-Rechenzentren immer mehr Energie verbrauchen, kann die TPU den entscheidenden Unterschied ausmachen.
Und wie sieht es mit analogen neuromorphen ICs aus?
Link zu Überschrift
Und was ist mit neuromorphen ICs? Im Vergleich zu TPUs streben sie durch analoge Datenverarbeitung und ereignisgesteuerte Verarbeitung mit niedrigeren Frequenzen einen noch geringeren Stromverbrauch an. Was ist nötig, damit neuromorphe ICs zum Standard werden und die gleiche Größenordnung wie die TPUv7-Superpods erreichen?
Eine der Herausforderungen, vor denen ich noch stehe, ist es, den relativen Stromverbrauch des systolischen Arrays (MXU + Ersatzkern) im Vergleich zum Rest der TPU (einschließlich ICI, OCI, TCS) besser zu verstehen und zu analysieren, wie sich dieses Verhältnis zum neuromorphen Spiking Neural Network (SNN) im Vergleich zur Steuerlogik (RiscV und Spike copro) verhält.
Sollten neuromorphe ICs die Größenordnung von TPUv7 erreichen, wären vermutlich ähnliche Investitionen in Software, Systeme und Netzwerkverbindungen erforderlich. Alternativ könnte man ein SNN in eine TPU integrieren und die Steuerlogik der TPU für die Kommunikation zwischen SNN und dem restlichen TPU/Rack/Pad nutzen. Doch ist das wirklich nötig? Welches Problem lösen wir damit? Vielleicht sollten wir unsere Herangehensweise überdenken.
Zurück in die Zukunft: die Sprachverarbeitungseinheit
Link zu Überschrift
Dieses Memo wäre nicht vollständig, ohne die Language Processing Unit zu erwähnen, einen neuen Prozessortyp, der zur Optimierung der Inferenz großer Sprachmodelle entwickelt wurde.
Ich werde ein separates Memo zu diesem Thema erstellen müssen. Daher handelt es sich vorerst nur um einen allgemeinen Vergleich, um zu verstehen, ob die LPU mehr ist als eine Neuentwicklung der TPUv1, die sich ausschließlich auf Inferenz und nicht auf Training konzentrierte.
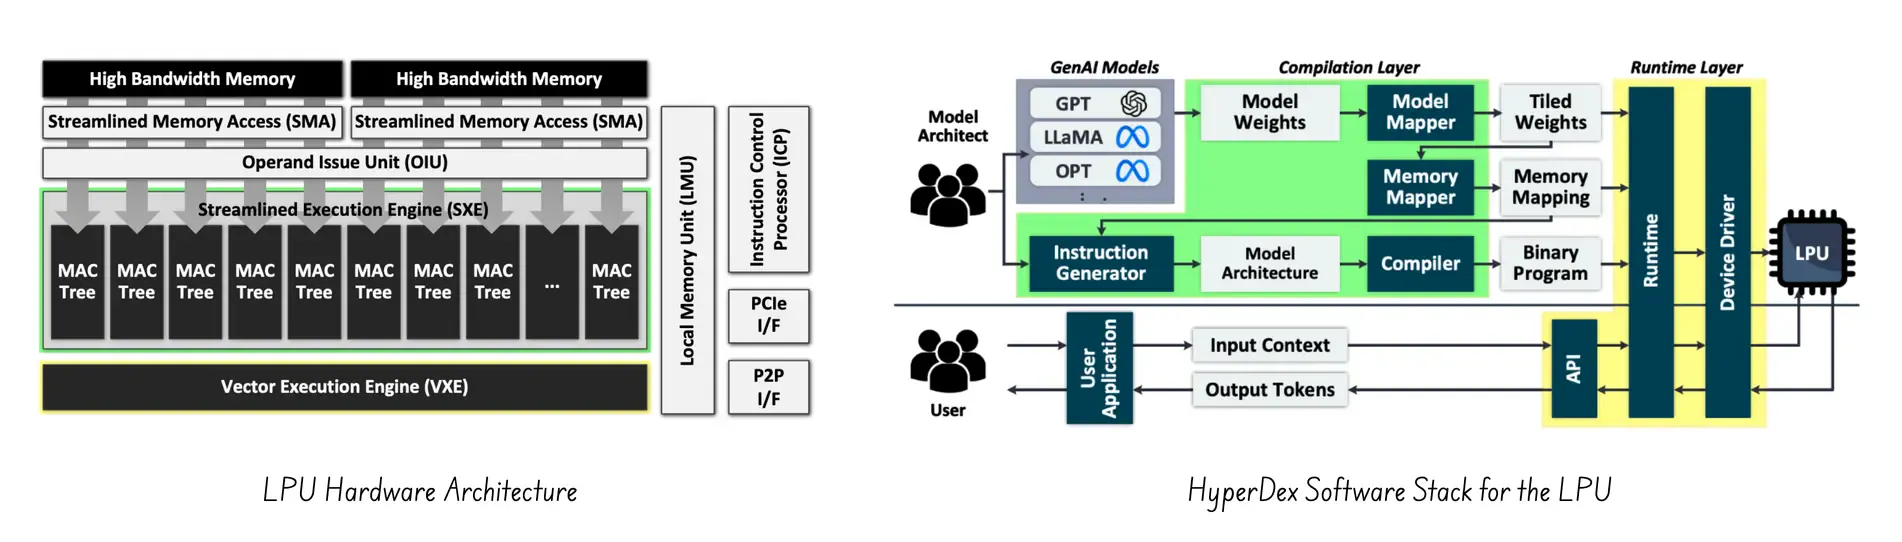
Im Prinzip haben TPU und LPU gemeinsam, dass sie einige Aufgaben mithilfe einer domänenspezifischen Architektur (DSA) sehr effizient und skalierbar erledigen müssen. Bei der konkreten Implementierung und Optimierung unterscheidet sich die LPU jedoch deutlich und verfolgt einen anderen Ansatz.
Der Hauptunterschied besteht darin, dass die TPUv1 bereits vor der Existenz des LLM entwickelt wurde (ChatGPT wurde erstmals 2022 veröffentlicht) und sich auf allgemeine Deep-Neural-Network-Inferenz (DNN) konzentrierte. Dies bedeutete, Durchsatz und Leistung pro Watt für massive, hochvolumige Operationen zu gewährleisten, implementiert durch ein zugrundeliegendes MXU-Systolenarray.
Die LPU hingegen ist darauf ausgelegt, die Inferenz großer Sprachmodelle (LLMs) zu optimieren. Ihr Fokus liegt auf der Verbesserung der Latenz pro Token. Dafür benötigt sie eine ISA, die eine vollständig deterministische, statisch geplante, VLIW-basierte Multi-Pipeline-Architektur unterstützt. Man könnte zwar argumentieren, dass die TPUv4 eine ähnliche VLIW-ISA für das TCS einführt. Der Hauptunterschied besteht jedoch darin, dass die LPU-ISA eine vollständig deterministische VLIW-Maschine ist, bei der jeder Lade-, Berechnungs- und Speichervorgang zyklusweise geplant wird. Die MXU der TPU hingegen ist ein „selbstgesteuertes“ systolisches Array.
Voilà, dies ist ein kurzes Memo, das mal wieder länger gedauert hat als erwartet. Was aus dieser detaillierten Analyse deutlich wird, ist, dass die Entwicklung der TPU-Architektur zeigt, dass die Entwicklung von KI-Beschleunigern eine komplexe Aufgabe ist, die die Berücksichtigung vieler Faktoren erfordert.
Das Design der TPU, das Speicher, Rechenleistung, Energieverbrauch und Datenkommunikation optimal aufeinander abstimmt, zeigt, dass der Aufbau leistungsstarker KI-Systeme in großem Maßstab nicht allein von schnellen Chips abhängt. Er erfordert auch die Koordination zwischen Hardware, Software, Systemen und Netzwerkverbindungen.
Das ist ein bisschen wie ein Déjà-vu-Erlebnis. Könnte es sein, dass die Quantenprozessoreinheit (QPU) der nächste Schritt in der Evolution von KI-Beschleunigern ist?
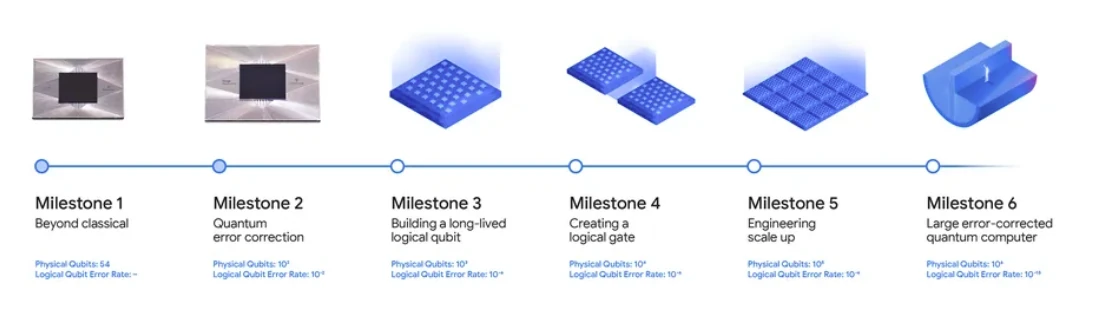 (Bildquelle: Google Willow)
In diesem Memo verwendete DrawIO-Diagramme: