Ich habe früher für Spirent gearbeitet, ein Unternehmen für Test- und Messgeräte, das Testsysteme für Hochleistungsnetzwerke entwickelt. Das Produkt hieß Test Center, und gemeinsam mit einem sehr talentierten Team entwickelten wir das System zum Testen von RoCEv2-Systemen. Mein Schwerpunkt lag insbesondere auf der Prioritätsflusssteuerung (PFC) und deren Aktivierung für den 800-Gbit/s-FPGA-basierten „Paketanalysator und -generator“ (auch bekannt als PGA).
Ich habe mir Layer 4 allerdings nie genauer angesehen, und dieses Memo versucht, diese Lücke zu schließen, indem es die Schlüsselelemente der InfiniBand-Transportschicht (L4) erläutert und sie anhand einiger Diagramme veranschaulicht.
Beginnen wir mit dem eigentlichen RoCEv2-Frame:
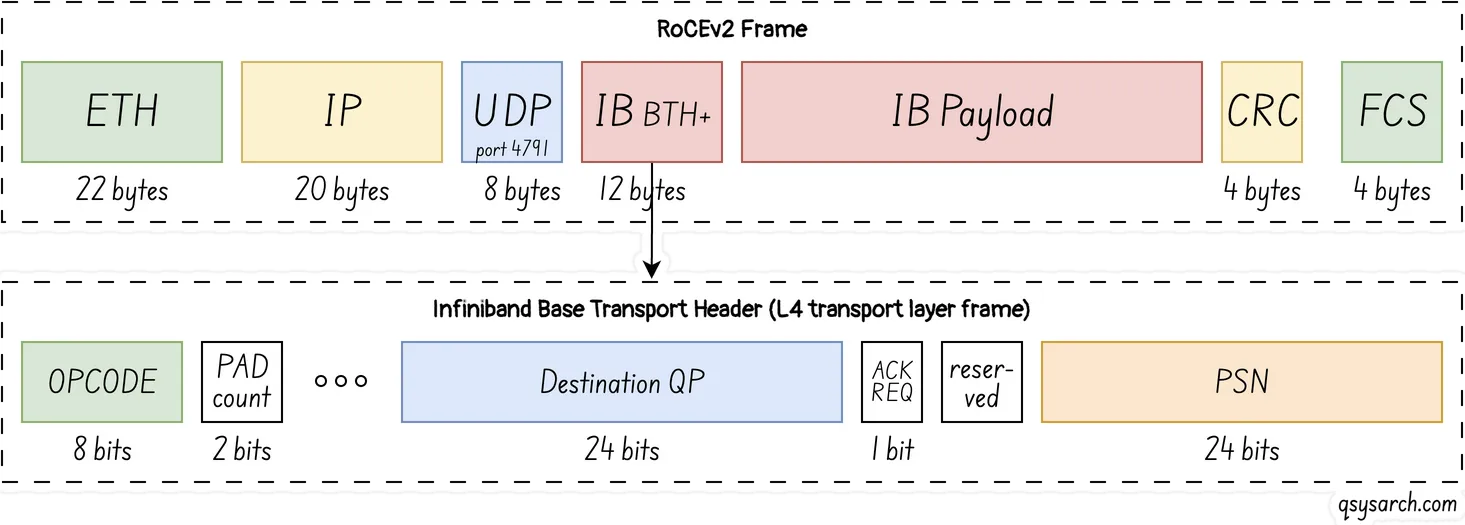
Wichtige Felder im BTH-Header:
Opcode: Wird verwendet, um den Typ der RDMA-Operation anzugeben, z. B. RDMA_WRITE, RDMA_READ, …
Ziel-QP: Wird verwendet, um zwischen verschiedenen Ziel-Warteschlangenpaaren für ein Paket zu unterscheiden.
Bestätigungsanforderung: Gibt an, ob die empfangende Seite eine Bestätigung (ACK) für dieses Paket zurücksenden muss.
Paketsequenznummer (PSN): Wird zur Verfolgung der Paketsequenz für eine zuverlässige Zustellung verwendet.
Da UDP ein unzuverlässiges Protokoll ist, bei dem Frames verloren gehen, in falscher Reihenfolge übertragen oder dupliziert werden können, wird das PSN verwendet, um die korrekte Zustellung sicherzustellen. Dies bedeutet jedoch auch, dass der IBTL die Möglichkeit haben muss, eine erneute Übertragung von Frames anzufordern. Dies wird mithilfe des AETH-Headers realisiert, der im Folgenden beschrieben wird.
Die InfiniBand-Transportschicht verfügt über mehrere erweiterte Header, die für spezifische Funktionen verwendet werden. Im Fall von RDMA sind die beiden interessantesten RETH und AETH.
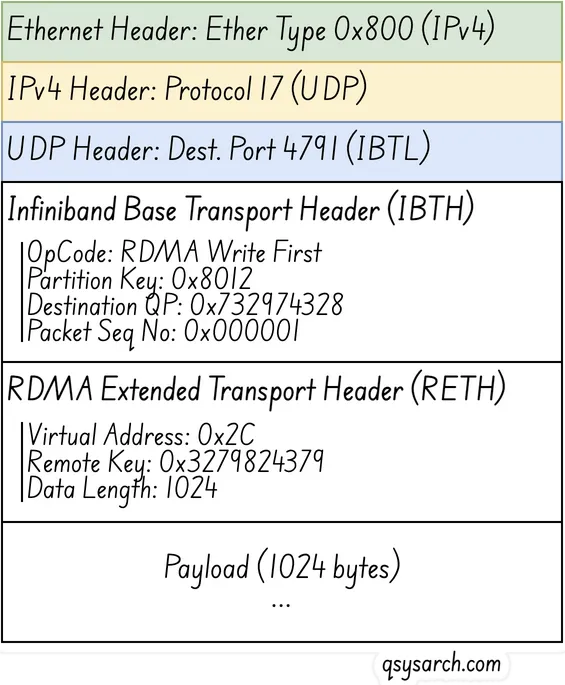
Die RDMA_WRITE-Operation erfordert mehrere Elemente, die in den Feldern des erweiterten RETH-Headers dargestellt werden. Dieser Header informiert die empfangende Hardware über die Details des Schreibvorgangs, einschließlich:
Virtuelle Adresse: Die Zielspeicheradresse, an die die Daten geschrieben werden.
Remote Key (R_Key): Der Zugriffsschlüssel, der die Berechtigungen für den Speicherbereich validiert.
Länge: Die Größe der zu übertragenden Daten.
Wie bereits erläutert, muss das IBTL den Absender im Falle einer unzuverlässigen Übertragung benachrichtigen. Dies geschieht mithilfe der EATH-Erweiterung, die folgendes Feld enthält:
Syndrom: Ein Feld, das Antwortcodes enthält, die Erfolg (ACK), Fehlerbedingungen (NAK) oder den Status „Empfänger nicht bereit“ (RNR) anzeigen, sowie Informationen zur Flusssteuerung.
Nachrichtensequenznummer (MSN): Gibt die Sequenznummer der zuletzt abgeschlossenen Nachricht an, was bedeutet, dass alle Nachrichten mit niedrigeren Sequenznummern erfolgreich empfangen wurden.
Die IBTL-Spezifikation (siehe Kapitel 9) enthält einige Erweiterungen, von denen einige meine Aufmerksamkeit erregten:
Compare And Swap: Ermöglicht die sperrfreie Synchronisierung.
Senden vs. Schreiben: Ersteres kann für den Kontrollfluss verwendet werden, während Letzteres für den Datenfluss verwendet wird.
Sofortige Erweiterung: Ermöglicht den Austausch von Metadaten über Seitenkanäle zusammen mit den zu übertragenden Daten.
Ich habe mich auch gefragt, wie man erkennt, welche Erweiterungen im Header vorhanden sind. Die Antwort ist einfach: Für jeden Opcode gibt es eine Liste der zu analysierenden Erweiterungen – diese Liste ist statisch als Teil der Spezifikation definiert.
Wie Toni Pasanen in seinem Blog „The Network Times“ (https://nwktimes.blogspot.com/2025/04/ai-for-network-engineers-understanding.html) ausführt:
Die GPU-zu-GPU-Kommunikation erzeugt enorme Datenmengen, die von RDMA-fähigen Netzwerkkarten mit Leitungsgeschwindigkeit übertragen werden. Diese Datenmengen können leicht zu Überlastungen im Backend-Netzwerk führen.
Die Fähigkeit von RDMA, Datenverkehr mit Leitungsgeschwindigkeit zu generieren, ist beeindruckend. Dies führt jedoch auch zu einem Problem mit der Flowlet-Größe (der Größe des Datenflusses zwischen zwei aufeinanderfolgenden Inaktivitätszeiten), da die Wahrscheinlichkeit, auf eine „Inaktivitätslücke“ zuzugreifen, bei der Verwendung von RDMA Elephant Flows deutlich geringer ist.
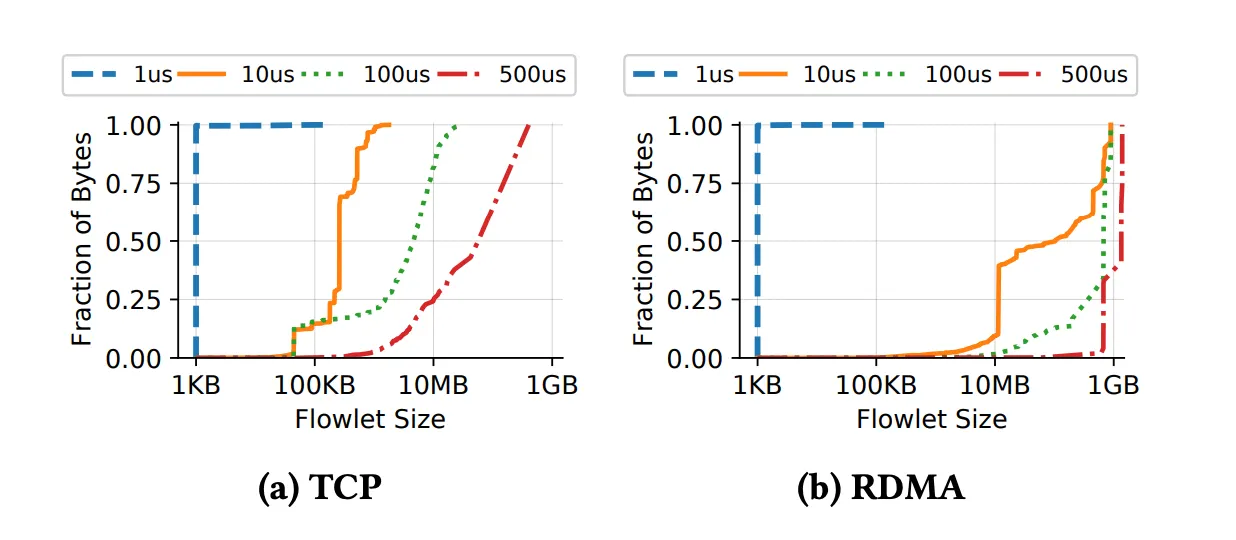 Abbildung aus: Netzwerklastausgleich mit Unterstützung für netzwerkinterne Neuanordnung für RDMA
Die Herausforderung der Lastverteilung
Link zu Überschrift
Die andere Komplexität betrifft den Lastausgleich bei Spine-Leaf-Topologien, bei denen Pakete in falscher Reihenfolge auf einem einzelnen Warteschlangenpaar empfangen werden können, wenn Packet Spraying verwendet wird. Dies führt zu einer Komplexität, die Nvidia durch die Einführung einer neuen RDMA-Operation namens „RDMA Write Only“ gelöst hat.
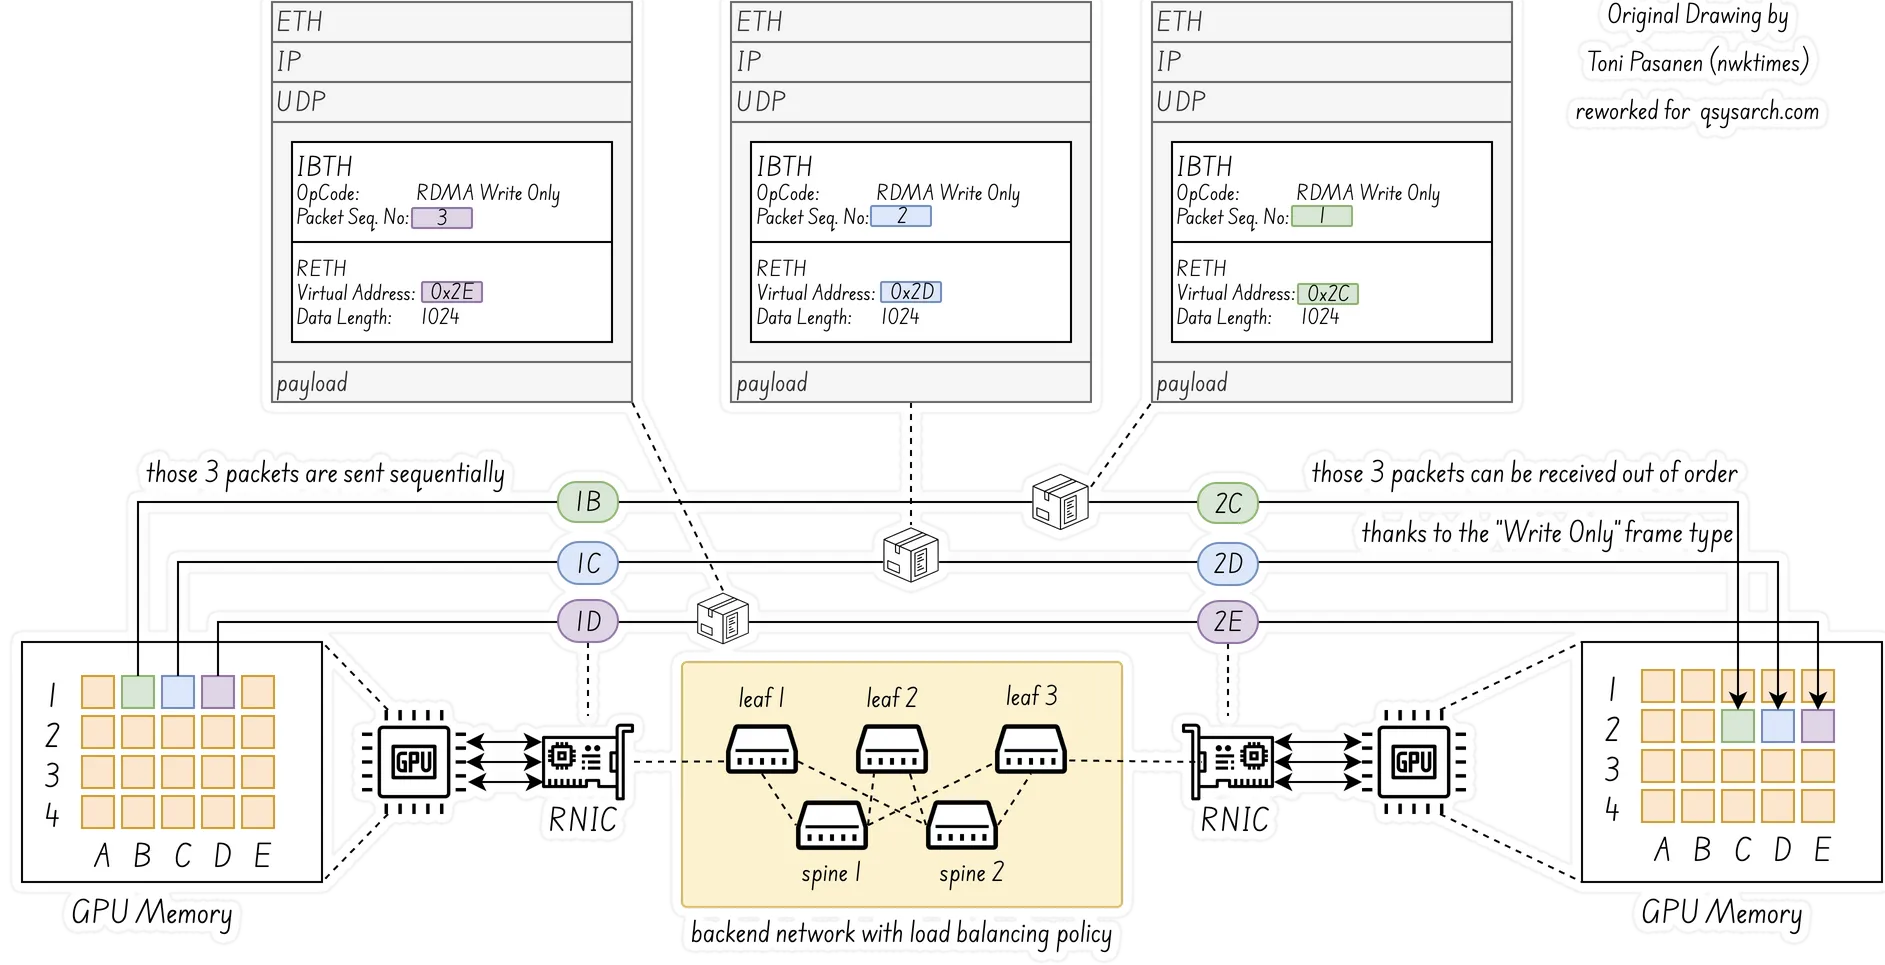 Originalbild von: The Network Times
Dies ist ein „aktives“ Memo, das ich fortlaufend aktualisieren werde, sobald ich weitere Informationen über die IBTL erhalte.
Es gibt noch keine endgültige Schlussfolgerung, außer dass RDMA ein sehr eleganter Ansatz ist, um die Herausforderung der Netzwerkeffizienz zu lösen, und der eine Reihe neuer Herausforderungen mit sich bringt.
References: