
Im Zusammenhang mit GPUs gibt es zahlreiche Schlagwörter rund um RDMA: GPU-direkt, NvLink, NVLink Fusion, InfiniBand, Quantum InfiniBand, GPUNetIO und DOCA. Das ist verwirrend, aber muss es nicht so sein?
Dieser Artikel ist in Form eines persönlichen Memos verfasst und versucht, die verschiedenen Technologien zu erläutern und anhand einiger Diagramme zu veranschaulichen.
GPU Direct und RDMA: Marketing vs. Technologie.
Link zu Überschrift
Beginnen wir in-medias-res mit der verwirrenden Seite GPUNetIO aus der offiziellen Nvidia-Dokumentation:
Beachten Sie, dass das Akronym RDMA das Protokoll für den direkten Fernzugriff auf den Speicher eines Computers auf den Speicher eines anderen Computers ermöglicht, ohne dass das Betriebssystem eines der beiden Computer involviert ist. … Es darf nicht mit GPUDirect RDMA verwechselt werden, das nicht mit dem RDMA-Protokoll verwandt ist.
Klar, GPUDirect RDMA ist also nicht dasselbe wie das RDMA-Protokoll! Nutzt GPUDirect RDMA denn wenigstens das RDMA-Protokoll? Ich hoffe es; sonst wäre das wirklich verwirrend.
GPUDirect RDMA ist eine der von NVIDIA innerhalb der GPUDirect-Technologiefamilie bereitgestellten Technologien. Sie ermöglicht es der Netzwerkkarte, Daten direkt über den GPU-Speicher zu senden und zu empfangen, wodurch die Speicherkopien der CPU und die Routinen des Betriebssystems umgangen werden. GPUDirect RDMA kann von jedem Netzwerk-Framework genutzt werden, das mit Ethernet, InfiniBand oder RoCE arbeitet.
Okay, zumindest ist es klar: GPUDirect RDMA lässt sich auf jeder Transportschicht implementieren, egal ob Ethernet (ETH) oder InfiniBand (IB). Aber was genau ist GPUNetIO und wie hängt es mit RDMA zusammen? Die Antwort ist einfach: GPUNetIO ist, wie der Name schon sagt, eine netzwerkbasierte Implementierung von GPU Direct RDMA über eine Netzwerkkarte. Das bedeutet nicht, dass GPU Direct zwingend von einer Netzwerkkarte gesteuert werden muss, sondern lediglich, dass GPUNetIO eine spezielle Version für diesen Netzwerkkartentyp ist.
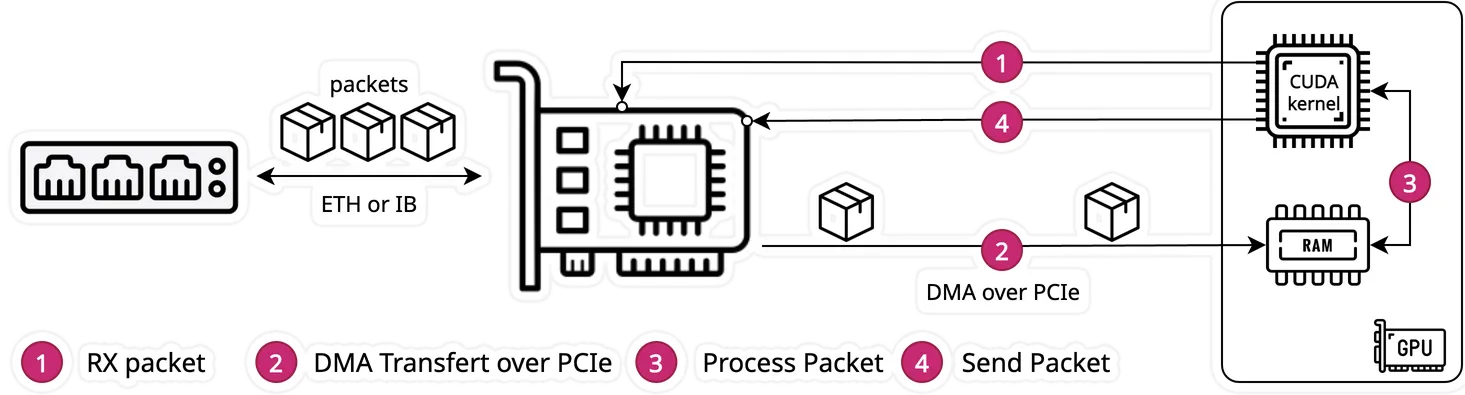
Im obigen Diagramm der GPUNetIO-Dokumentation (https://docs.nvidia.com/doca/sdk/doca+gpunetio/index.html) ist das Feld „CUDA“ etwas verwirrend. Ich nehme an, es handelt sich um einen Kernel, der auf der GPU läuft, aber schauen wir mal in der Dokumentation nach:
Herkömmliche Ansätze basieren häufig auf einem CPU-zentrierten Modell, bei dem die CPU mit der Netzwerkkarte (NIC) interagiert, um Pakete im GPU-Speicher mittels GPUDirect RDMA zu empfangen. Anschließend benachrichtigt die CPU einen CUDA-Kernel auf der GPU, die Pakete zu verarbeiten. … DOCA GPUNetIO begegnet dieser Herausforderung mit einer GPU-zentrierten Lösung, die die CPU aus dem kritischen Pfad entfernt.
Mir ist das noch nicht ganz klar – es heißt zwar „GPU-zentriert“ für den kritischen Pfad, aber was genau ist der kritische Pfad? Sind das die Schritte (1) bis (4) aus dem Diagramm? Und wofür wird die CPU noch benötigt? Um das herauszufinden, müssen wir uns den Modus „Async Kernel-Initiated“ ansehen, der die Möglichkeit bietet, dass „ein GPU-CUDA-Kernel die Netzwerkkommunikation zum Senden und Empfangen von Daten steuert“. GPUDirect IKA ermöglicht Folgendes:
Die GPU kann die Ethernet-Kommunikation (Ethernet/IP/UDP/TCP/ICMP) steuern.
Die GPU kann die RDMA-Kommunikation steuern (InfiniBand oder RoCE werden unterstützt).
Ein Eingriff der CPU ist im kritischen Pfad der Anwendung nicht erforderlich
Das ist also völlig klar:
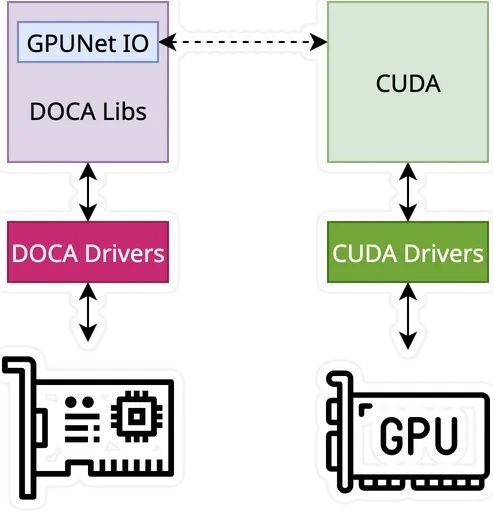
GPU Direct RDMA ermöglicht den direkten Datentransfer zum/vom GPU-Speicher ohne Zwischenspeicherung auf der CPU.
GPU Direct AKI gibt der GPU die Möglichkeit, die Netzwerkkarte zu “steuern”.
GPUNetIO ist eine Softwarekomponente, die sowohl GPU Direct RDMA- als auch AKI-Technologien unterstützt.
DOCA ist das SDK, das Nvidia zur Programmierung von GPUNetIO-fähiger Hardware (unter anderem) bereitstellt.
Ich vermute, die Verwirrung rührt daher, dass „AKI“ eigentlich als „GPU Direct RDMA + AKI“ bezeichnet werden sollte, da es die RDMA-Funktionalität ergänzt, die das Umgehen der CPU ermöglicht.
Wir wissen nun, dass GPU Direct RDMA, wie es von Nvidia unter dem Namen GPUNetIO vermarktet wird, eine netzwerkkartenbasierte Lösung (NIC) ist, die die GPU über eine PCIe-Verbindung mit der NIC verbindet. Betrachten wir diese PCIe-Verbindung genauer, abstrahieren wir den GPUNetIO-Teil und konzentrieren wir uns wieder auf den RDMA-Teil:
In der offiziellen CUDA GPUDirect RDMA-Dokumentation (https://docs.nvidia.com/cuda/gpudirect-rdma/index.html) heißt es, dass die einzige Voraussetzung ein PCIe-Root-Komplex ist:
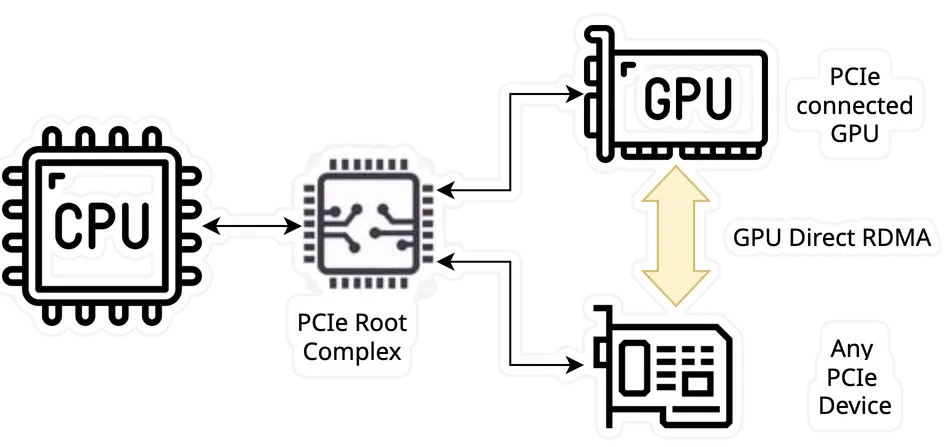
GPUDirect RDMA ist eine Technologie, die in GPUs der Kepler-Klasse und CUDA 5.0 eingeführt wurde und einen direkten Datenaustausch zwischen der GPU und einem Drittanbietergerät über die Standardfunktionen von PCI Express ermöglicht. … Es können einige Einschränkungen gelten, die wichtigste ist, dass beide Geräte denselben PCI-Express-Root-Komplex verwenden müssen.
GPUDirect RDMA ist eine Lösung, die es jedem PCIe-Gerät ermöglicht, direkt mit der GPU zu kommunizieren, sofern es sich im selben PCIe-Netzwerk befindet. Obwohl Nvidia diese Lösung hauptsächlich für Netzwerkkarten vermarktet, kann es sich im Prinzip um jede beliebige PCIe-Karte handeln, beispielsweise um eine PCIe-Karte für eine Hochgeschwindigkeitskamera. Das klingt vielversprechend, aber sehen wir uns genauer an, wie das funktioniert.
Bei der Einrichtung der GPUDirect-RDMA-Kommunikation zwischen zwei Peers sind alle physikalischen Adressen aus Sicht der PCI-Express-Geräte identisch. Innerhalb dieses physikalischen Adressraums befinden sich lineare Fenster, sogenannte PCI-BARs. Jedes Gerät verfügt über maximal sechs BAR-Register und kann somit bis zu sechs aktive 32-Bit-BAR-Bereiche haben. 64-Bit-BARs belegen zwei BAR-Register. Lese- und Schreibvorgänge an die BAR-Adressen eines Peer-Geräts erfolgen durch das PCI-Express-Gerät auf dieselbe Weise wie an den Systemspeicher.
Traditionell werden Ressourcen wie BAR-Fenster mithilfe der MMU der CPU als speicherabgebildete E/A-Adressen (MMIO) dem Benutzer- oder Kernel-Adressraum zugeordnet. Da aktuelle Betriebssysteme jedoch keine ausreichenden Mechanismen für den Austausch von MMIO-Bereichen zwischen Treibern bieten, stellt der NVIDIA-Kerneltreiber Funktionen bereit, um die notwendigen Adressübersetzungen und -zuordnungen durchzuführen.
Verwirrend ist hierbei, dass der Begriff „DMA“ im Vergleich zu „RDMA“ bei einem PCIe-internen System mit heterogenen Geräten zunächst passender erscheinen mag. Genau das ist aber der Punkt. DMA dient der Datenübertragung, während RDMA, das darüberliegende Protokoll, den übertragenen Daten mithilfe von Verben Semantik verleiht. DMA umfasst also im untenstehenden Diagramm lediglich die Schritte (4) und (5), während das RDMA-Protokoll in der Hardware auf der Empfangsseite nur Schritt (3) beinhaltet.
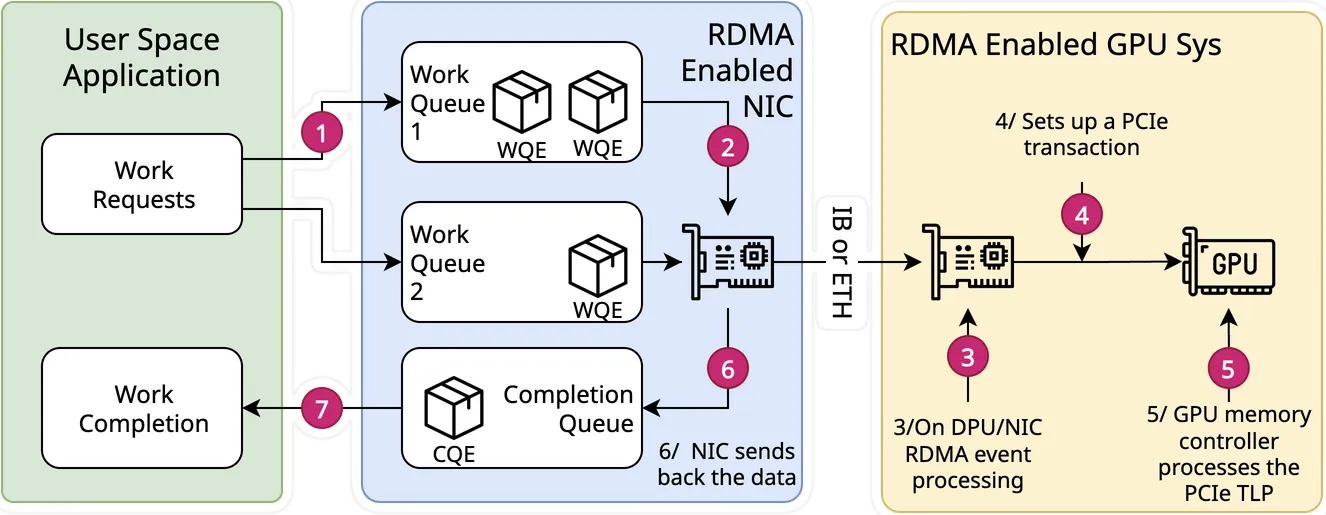
Eines ist zu beachten: Nvidia stellt klar, dass dies keine einfache Angelegenheit ist. Um die beste Leistung zu erzielen, ist es daher wahrscheinlich besser, eine bekannte Testumgebung zu verwenden:
Obwohl die einzige theoretische Voraussetzung für das Funktionieren von GPUDirect RDMA zwischen einem Drittanbietergerät und einer NVIDIA-GPU darin besteht, dass sie denselben Root-Komplex teilen, gibt es Fehler (hauptsächlich in Chipsätzen), die dazu führen, dass es schlecht funktioniert oder in bestimmten Konfigurationen überhaupt nicht funktioniert.
Es herrscht weiterhin eine deutliche Verwirrung in der Terminologie, insbesondere zwischen Ethernet, InfiniBand und RoCE: RoCE basiert auf Ethernet.

Der InfiniBand-Branchenverband beschreibt vereinfacht als Weiterentwicklung, dargestellt im obigen Diagramm. Ich habe bewusst die Bezeichnung „100G + PFC“ anstelle der ursprünglichen Bezeichnung „DCB“ (auch bekannt als Data Center Bridging) verwendet. Soweit ich das verstehe, ist DCB eine Erweiterung von PFC (auch bekannt als Priority Flow Control). Damit DCB/PFC funktioniert, benötigt man die entsprechende Netzwerkinfrastruktur, einschließlich der Switches, um diese Technologien zu implementieren. Andernfalls greift man auf Ethernet zurück.
Dieses Memo wäre ohne einen Hinweis auf NVLink unvollständig. Die zentrale Frage ist, ob NVLink und InfiniBand identisch oder verwandt sind. Kurz gesagt: Sie ergänzen sich, konkurrieren nicht miteinander.

NVLink: Schnelle Kommunikation innerhalb eines Knotens (innerhalb eines Servers, zwischen GPUs).
InfiniBand: Schnelle Kommunikation zwischen den Knoten (zwischen Servern in einem Cluster)
Im Diagramm rechts ist deutlich zu erkennen, dass die grünen Pfeile die GPUs untereinander verbinden. Die Verbindung zwischen den Netzwerkkarten erfolgt über InfiniBand.
Interessant ist, dass der NVLink-Anschluss im Gegensatz zu InfiniBand-Anschlüssen intern in die Nvidia-Hardware integriert und nicht nach außen zugänglich ist (siehe Abbildung unten). Der Quantum InfiniBand X800 ist ein extrem leistungsstarkes Gerät mit 800-Gbit/s-Verbindungen und integrierter Siliziumphotonik, hat aber nichts mit Quantencomputing zu tun.
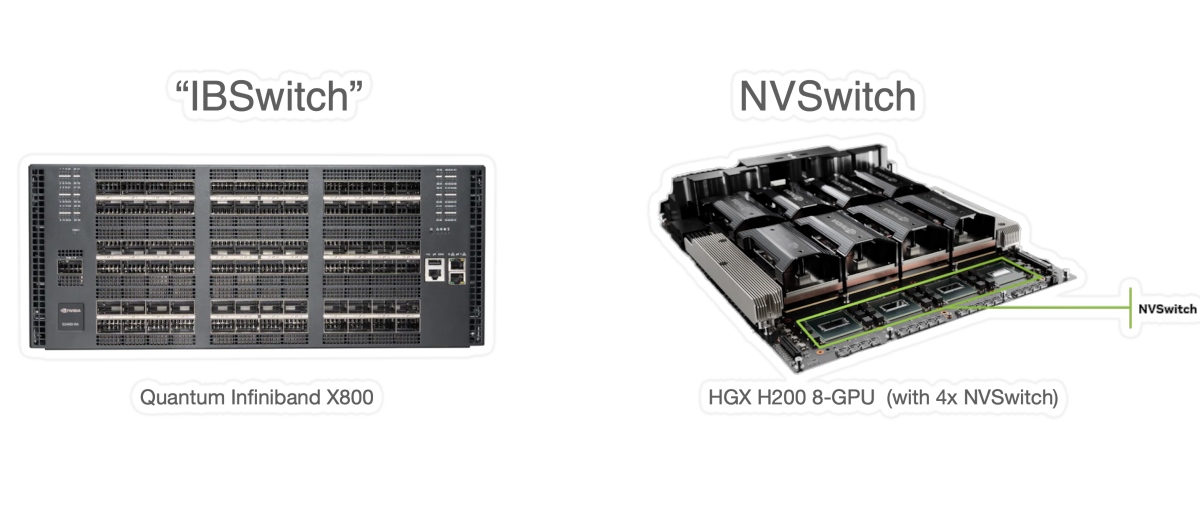
Ein letzter Punkt ist erwähnenswert: Nvidia hat NVLink Fusion (https://www.nvidia.com/en-us/data-center/nvlink-fusion/) eingeführt, um den NVLink-Standard zu öffnen. Daher werden wir morgen wahrscheinlich kundenspezifische Integrationen sehen, die möglicherweise weiterhin eine Leiterplatte als „Schalter“ (anstatt eines Kabels) benötigen, jedoch mit einem SoC, der nicht unbedingt von Nvidia stammen muss. Erwähnenswert ist auch, dass AMD mit UALink (https://ualinkconsortium.org/) auf Nvidias Standard reagiert hat.
Kurz gesagt, RDMA ist nicht besonders komplex:
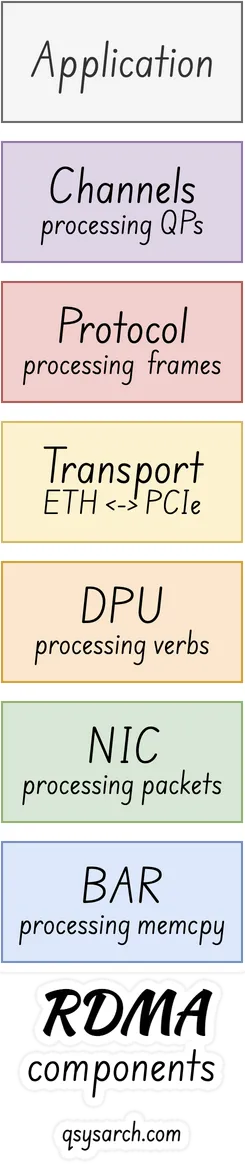
RDMA BAR: als PCIe BAR-Mapping: Auf der physikalischen Schicht gibt es ein PCIe-Gerät, das über denselben PCIe-Root-Komplex mit der GPU verbunden ist und die Speicher-BAR aller Geräte abbildet.
RDMA-Netzwerkkarte: als Hardware-Netzwerkkarte (NIC): Diese PCIe-Karte ist üblicherweise eine Netzwerkkarte – das muss aber nicht so sein. Allerdings scheint es derzeit nur eine einzige Netzwerkkarte auf dem Markt mit RDMA-Funktionalität zu geben.
RMDA DPU: als Hardware-Verbprozessor: Um die PCIe-Karte RDMA-kompatibel zu machen, muss die Hardware in der Lage sein, die RDMA-Verben direkt in der Hardware zu verarbeiten, üblicherweise mithilfe eines Prozessors namens DPU.
RDMA-Transport: als Transportschicht für die Netzwerkverbindung: Das PCIe-Gerät wird auf der Netzwerkseite als Transportschicht bereitgestellt, die Ethernet, Better Ethernet (RoCev2) und Infiniband sein kann.
RDMA-Protokoll: als Frame-Format: Das Protokoll, das zur Kommunikation über die Netzwerkverbindung verwendet wird, heißt ebenfalls RDMA - ich habe mir die Details des Frame-Formats nicht angesehen, aber es ist in RFC5040 beschrieben.
RDMA-Kanäle: als Kommunikationsweg über QP: Die Software / der Treiber / das SDK, das auf dem Host zur Kommunikation mit dem RDMA-Gerät verwendet wird, wird ebenfalls als RDMA bezeichnet, ist aber als Queue Paris and Channels definiert.
Voilà. Ich glaube, ich verstehe RDMA jetzt etwas besser.
Zurück zur Herausforderung des Quantencomputings – die Frage ist, warum man sich überhaupt mit RDMA beschäftigt? Nun, das liegt daran, dass Nvidia ihren InfinBand-Switch „Quantum InfiniBand“ genannt hat!
Aber obwohl ihr neuestes Produkt Quantum-X800 ein echtes Kraftpaket ist, hat es nichts mit Quantencomputing zu tun. Könnte es aber eine Schlüsselrolle bei der Verbindung der Quantensteuerung mit der GPU für die Herausforderung des Reinforcement Learning spielen?