Auf den ersten Blick erscheint die Quantenfehlerkorrektur unkompliziert: Man gruppiert physikalische Qubits zu einem logischen Qubit, wendet eine Methode an, um die Konsistenz zwischen ihnen aufrechtzuerhalten, und betreibt dann Quantenschaltungen mit diesen logischen Qubits.
Doch in der Praxis ist dieser erste Schritt alles andere als offensichtlich. Wie lassen sich diese logischen Qubits erzeugen und verwalten? Was ist beispielsweise aus der Perspektive eines Quantenkontrollsystems (QCS) – wie etwa QM OPX1000, ZIs ZQCS oder Qblox Q1 Cluster – nötig, um ein logisches Qubit zu „bedienen“ oder zu „orchestrieren“? Und sobald dieses logische Qubit „betriebsbereit“ ist, wie lässt es sich dann für Quantenberechnungen mithilfe von Quantenschaltungen aus 1- und 2-Qubit-Gattern nutzen? Diese einfache Frage betrifft nicht nur das Hardware-Steuerungssystem, sondern auch den Software-Stack, insbesondere die Compiler: Benötigen wir nun mehrere Compiler, einen für die physikalischen und einen für die logischen Qubits? Und wie können die Compiler die Skalierungskomplexität bewältigen, wenn sie 10.000 physikalische Qubits in einer heterogenen Umgebung aus hybriden GPUs/QPUs und QCS verarbeiten? Das sind einfache Fragen mit komplexen Antworten!
Dieses Memo ist das erste einer Reihe zum Thema Quantenfehlerkorrektur aus der Perspektive von Quantenkontrollsystemen. Dieses erste kurze Memo führt in die grundlegenden Konzepte ein, die zur Erzeugung eines konsistenten logischen Qubits auf der physikalischen Ebene erforderlich sind.
Was definiert ein „logisches Qubit“? Die Erzeugung logischer Qubits beginnt mit der Gruppierung physikalischer Qubits, denen jeweils eine spezifische Rolle zugewiesen wird. Einige dienen als Hilfs- oder Ancilla-Qubits, während andere als Daten- oder Haupt-Qubits fungieren.
Diese Gruppierung wird häufig durch das Diagramm rechts dargestellt, das einen „Oberflächencode 17 basierend auf Distanz 3“ zeigt (Bildquelle: Irréversible Inc).
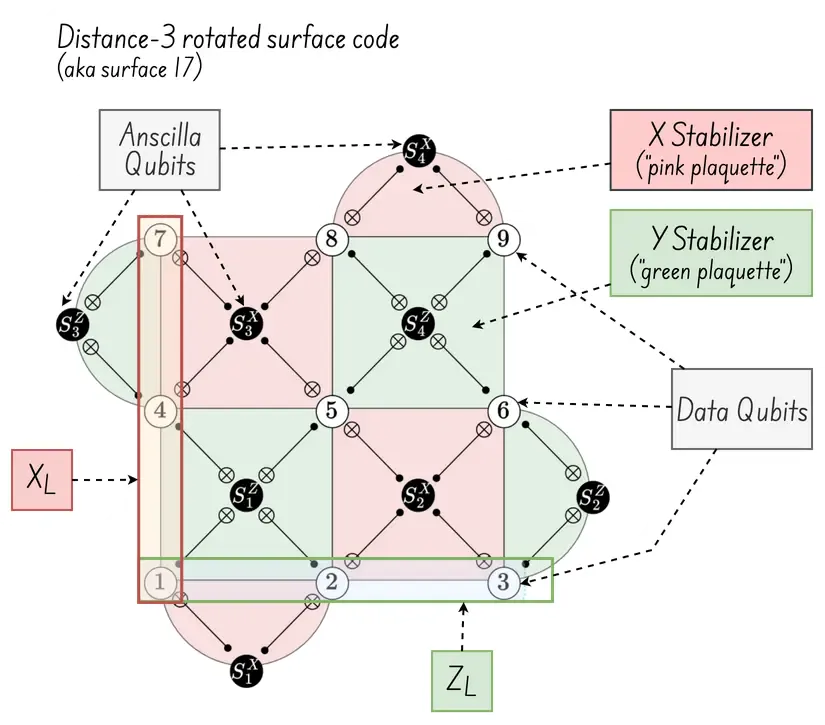
Hier die Grundstruktur, anwendbar für Oberflächencodes:
Die Datenqubits (weiße Kreise) speichern die Quanteninformation. Die Oberfläche 17 enthält 9 Datenqubits.
- Die Hilfsqubits (schwarze Kreise) führen zerstörungsfreie Paritätsprüfungen durch. Die Oberfläche 17 enthält 8 Hilfsqubits.
Die Wechselwirkung zwischen den Daten- und Hilfsqubits ist für jede „Plaquette“ spezifisch:
Die Plaketten (grüne und rosa Flächen) definieren die typologische Fehlerprüfungsbeziehung zwischen dem Hilfsqubit in der Mitte und seinen benachbarten Datenqubits.
Der Stabilisator: Jedes Hilfsqubit wird verwendet, um einen Pauli-Operator oder Stabilisator zu messen: Oberflächencodes haben zwei Stabilisatoren: Z-Typ-Stabilisatoren erkennen Bit-Flip-Fehler (X), während X-Typ-Stabilisatoren Phasen-Flip-Fehler (Z) erkennen.
Die Stabilisatormessung ist die Messung eines einzelnen Stabilisators, die durch sequentielles Koppeln eines Hilfsqubits an die benachbarten Datenqubits und anschließende Messung des Hilfsqubits realisiert wird.
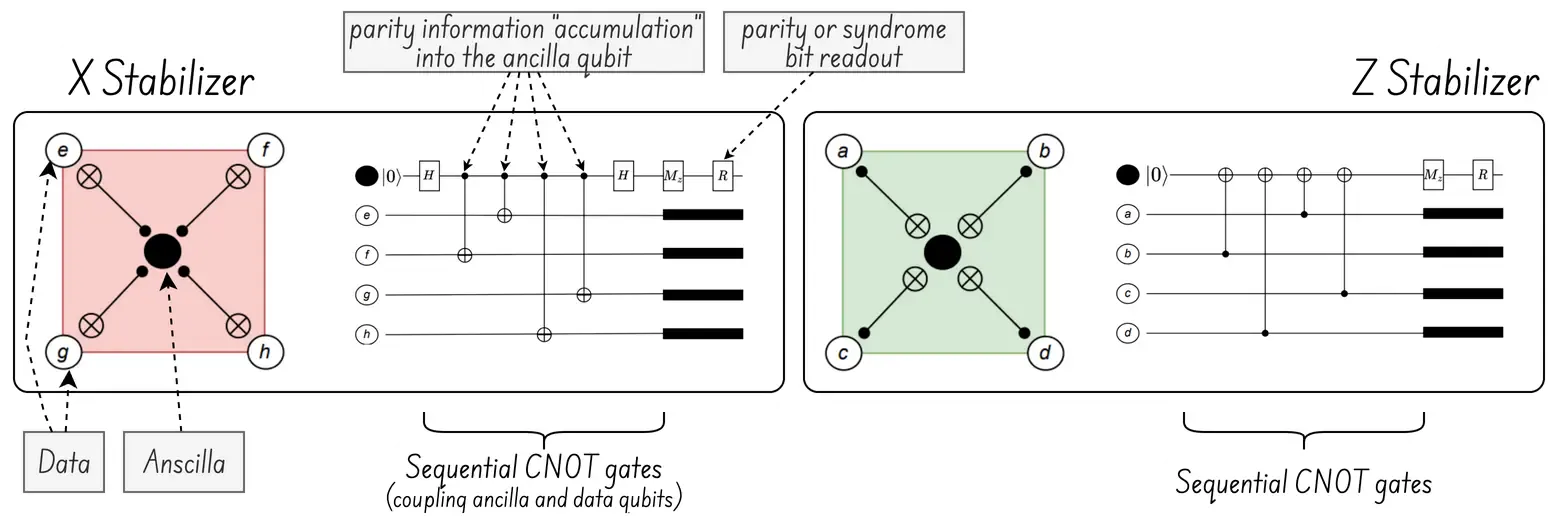
Die Syndrombits sind das Ergebnis der Messung des Paritätsprüfstabilisators. Für jeden Messzyklus wird ein Syndrombit erzeugt.
- Die Syndromextraktion ist der vollständige Prozess der Durchführung aller Stabilisatormessungen in einem Fehlerkorrekturzyklus, um das vollständige Fehlersyndrom zu erhalten.
Ein kleines Quiz: Wer ist der Qubit-Täter?
Link zu Überschrift
Betrachten Sie in diesem Kontext das folgende Diagramm (Quelle: Laurent Prost von Alice & Bob). Z 1 Z 2 und Z 2 Z 3 repräsentieren gemeinsame Paritätsprüfungsmessungen (Stabilisatoren) zwischen Qubit 1 und Qubit 2 bzw. zwischen Qubit 2 und Qubit 3. Im Gegensatz zu den vorherigen zweidimensionalen Plaketten geht dieses Diagramm davon aus, dass jedes physikalische Qubit nur mit einem anderen Qubit verbunden ist, was auf einen eindimensionalen Wiederholungscode hindeutet.
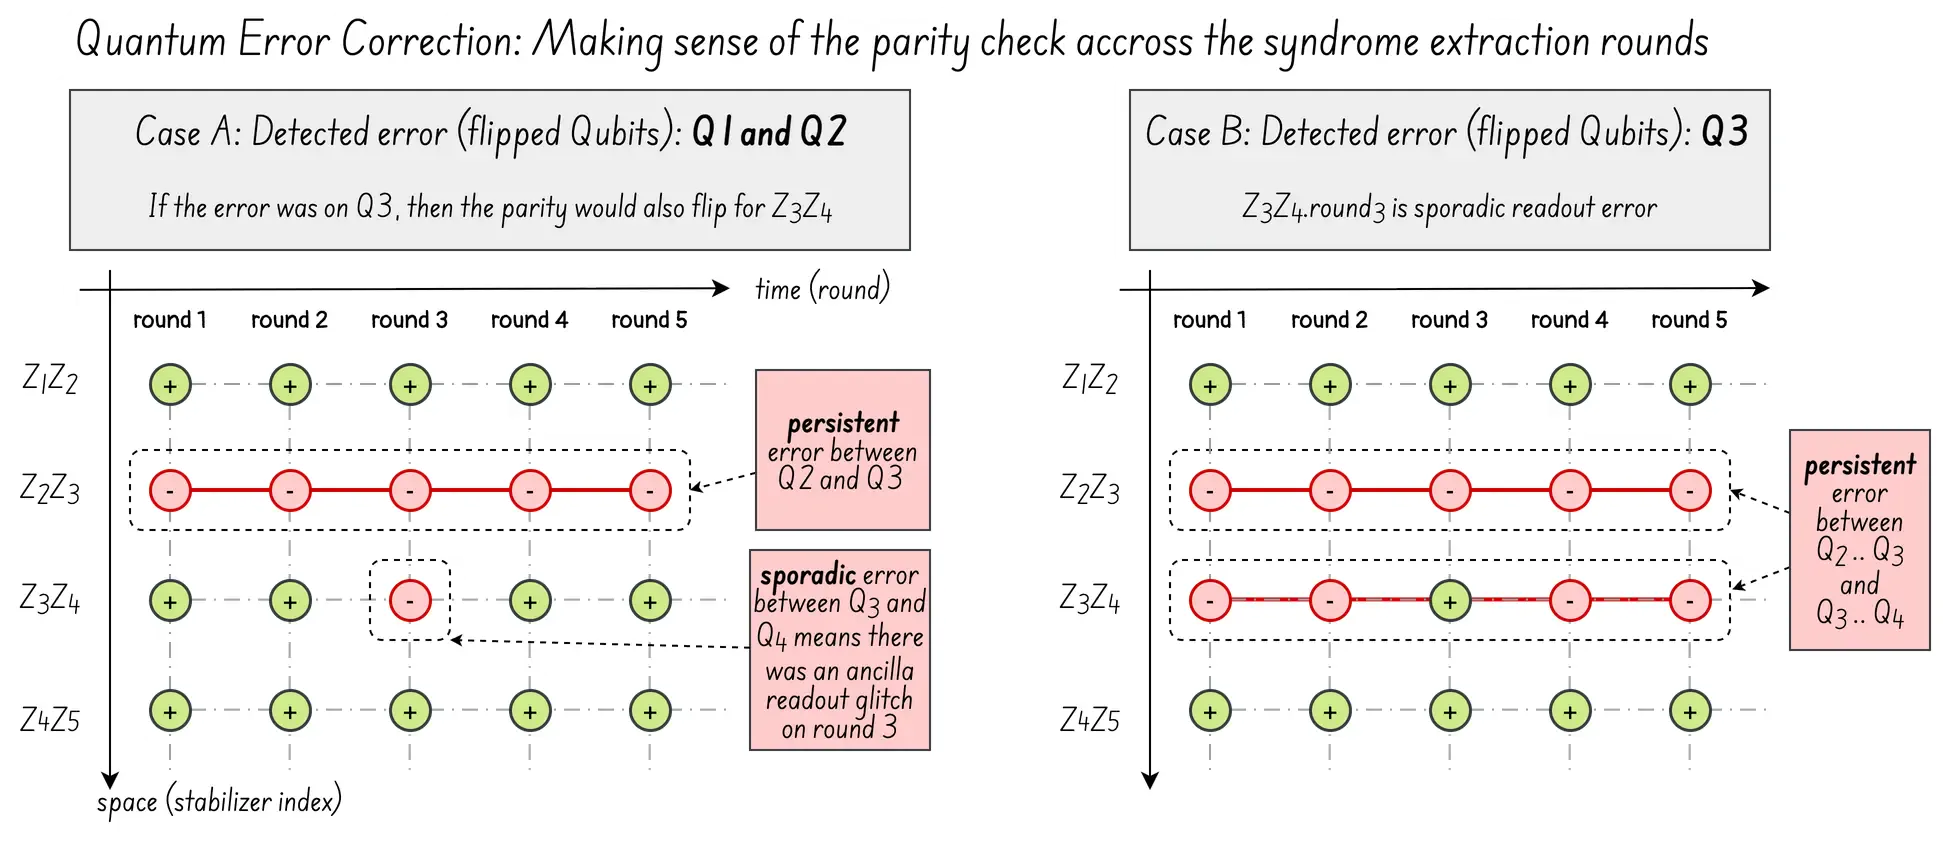
Im Diagramm links (Fall A) scheint der Fehler auf Datenqubit 3 zu liegen, tatsächlich betrifft er aber die Datenqubits 1 und 2. Die rote horizontale Linie zeigt , dass der Fehler nur in Z₂Z₃ auftritt. Wäre der Fehler auf Qubit 3, würde auch Z₃Z₄ invertieren. Daher stellt Z₁Z₂ einen byzantinischen Fehler dar, was bedeutet , dass sowohl Q1 als auch Q2 invertiert sind. Das Diagramm rechts (Fall B) zeigt das erwartete Ergebnis , wenn der Fehler auf Qubit 3 läge.
Hinter den Kulissen: Die “Magie” von QEC
Link zu Überschrift
Dieser zweite Abschnitt ist etwas umfangreicher, aber wichtig für das Verständnis der nachfolgenden Ausführungen zur Orchestrierung physikalischer Qubits innerhalb einer logischen Gruppe. Ich versuche, ihn so verständlich wie möglich zu halten, ohne auf die komplizierten mathematischen Details einzugehen, die meine Kollegen im QEC viel besser erklären können!
Der bizantinische Fehler Q1 + Q2 ist eine häufig auftretende Herausforderung, die als degenerierter Fehler bezeichnet wird. Genauer gesagt handelt es sich dabei um eine Situation, in der zwei oder mehr physikalisch unterschiedliche Fehler dasselbe Syndrombit erzeugen, wodurch es unmöglich wird, die Fehler zu unterscheiden.
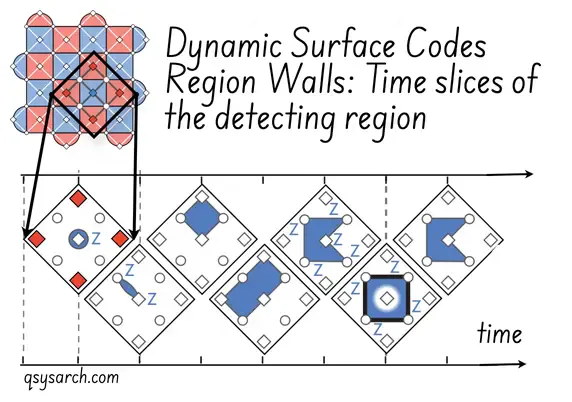 Dies ist jedoch in QEC kein Problem: Die Stabilisatoren dienen nicht der direkten Fehlererkennung. Stattdessen werden sie verwendet, um die physikalischen Qubit-Grenzen (auch Domänengrenzen genannt) zu identifizieren, an denen ein Fehlersyndrom auftritt. Durch Erhöhung der Redundanz zur Überlappung der Grenzen lassen sich einzelne Fehler präzise bestimmen (alternativ kann man den zeitdynamischen(https://quantumai.google/) Oberflächencode [https://www.nature.com/articles/s41567-025-03070-w) verwenden, wie im rechten Diagramm dargestellt).
Die Realisierung dieser Redundanz in Quantensystemen ist von grundlegender Komplexität und erfordert fundierte mathematische Kenntnisse. Um das übergeordnete Konzept zu verstehen, müssen wir zu den Grundlagen zurückkehren: Wie funktioniert die Paritätsprüfung genau?
Wie funktioniert die Paritätsprüfung genau?
Link zu Überschrift
Zunächst mag es unklar erscheinen, wie die Paritätsprüfung funktioniert, da die Bestimmung der Parität die Kenntnis des erwarteten Syndrombits erfordert, welches vom Zustand des Datenqubits abhängt. Die Kenntnis des Datenqubitzustands im Voraus würde jedoch den Zweck der Quantenberechnung zunichtemachen. Anders ausgedrückt:
„Wenn wir den Quantenzustand nicht kennen, wie können wir dann feststellen, ob er sich verändert hat?“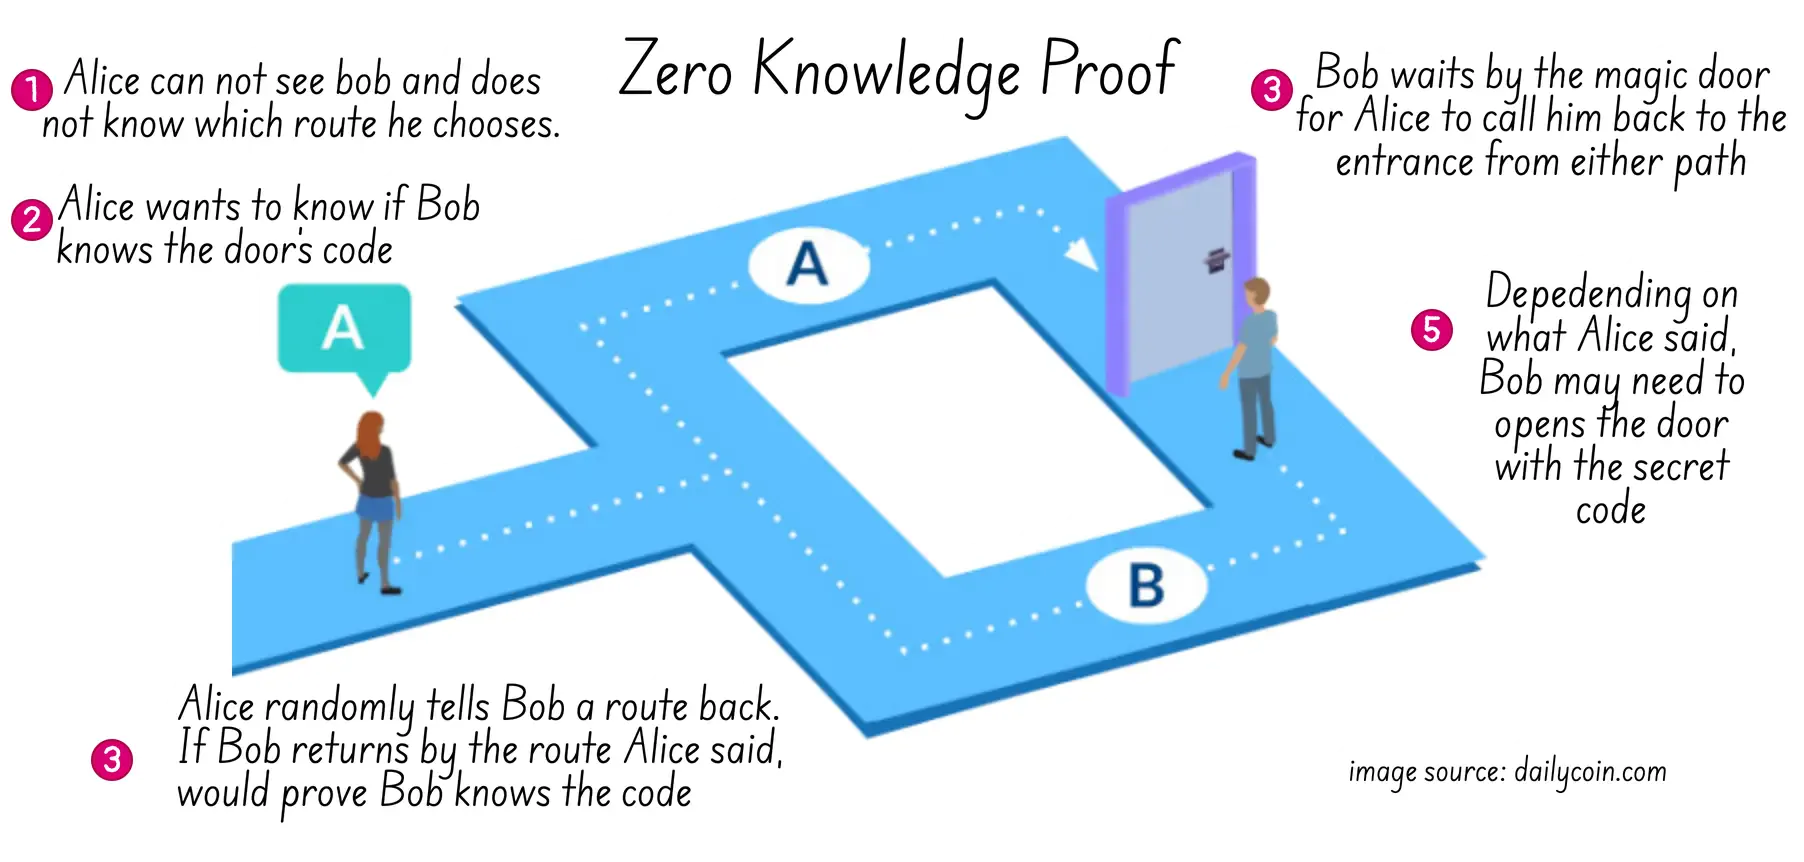 Um diese Herausforderung zu meistern, liegt der Schlüssel darin, denselben Trick anzuwenden, der auch für den „Zero-Knowledge-Beweis“-Beweis im Alibaba-Höhlenexperiment verwendet wurde: Man muss lediglich spezifische Fragen stellen, deren Antworten bekannt sind, unabhängig davon, welche Quanteninformation kodiert ist (Bildnachweis: dailycoin).
Diese spezifischen Fragen beziehen sich auf die Pauli-Stabilisatoroperatoren. Das Syndrombit bzw. das Messergebnis kann als Pfad A oder B betrachtet werden. In der Quantenelektrochemie (QEC) repräsentiert Pfad A den gültigen Zustand, während Pfad B einen Fehler anzeigt. Die Aufgabe der QEC-„Engine“ besteht darin, den Quantenschaltkreis zu konstruieren, der auf dem logischen Qubit so operiert, dass diese Einschränkung, auch „geschützter Zustand“ genannt, erhalten bleibt.
Hier wird die Ingenieursleistung entscheidend. Um sicherzustellen, dass die Syndrommessung immer Pfad A zurückgibt, wenn kein Fehler vorliegt, und ansonsten Pfad B, müssen die Paritätsinformationen der Mehrqubits so kodiert werden, dass die Beziehungen zwischen den Qubits für jeden gültigen kodierten Zustand festgelegt sind.
Dies ist die Funktion des Kodierungsschaltkreises. Sein Zweck ist es, einen einfachen, unverfälschten Eingangszustand (wie z. B. ein einzelnes physikalisches Qubit \(|ψ> = α|0> + β|1>\) mit leeren Hilfsqubits \(|00...0>\) in einen hochgradig verschränkten logischen Qubit-Zustand \(|ψ_L>\) abzubilden, der durch Quantenfehlerkorrektur geschützt ist.
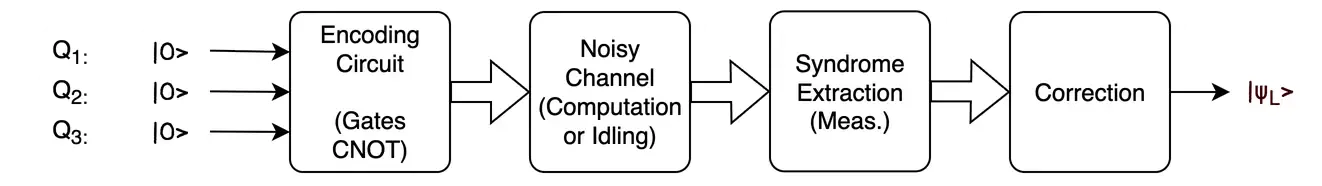
Ich werde den Kodierungsschaltkreis in einem späteren Memo genauer erläutern. Vorerst kann man sich den Kodierungsschaltkreis als einen speziell entwickelten Quantenschaltkreis vorstellen, der dazu dient, das logische Qubit im geschützten Zustand zu initialisieren oder zu booten.
Um die degenerierten Fehler (d. h. die „byzantinischen“ Q1 + Q2 -Syndrome) zu beheben, kann die Redundanz durch Erhöhung des sogenannten Codeabstands \( d \) gesteigert werden. Vereinfacht ausgedrückt definiert der Codeabstand \( d \), wie robust der Fehlerschutz ist.
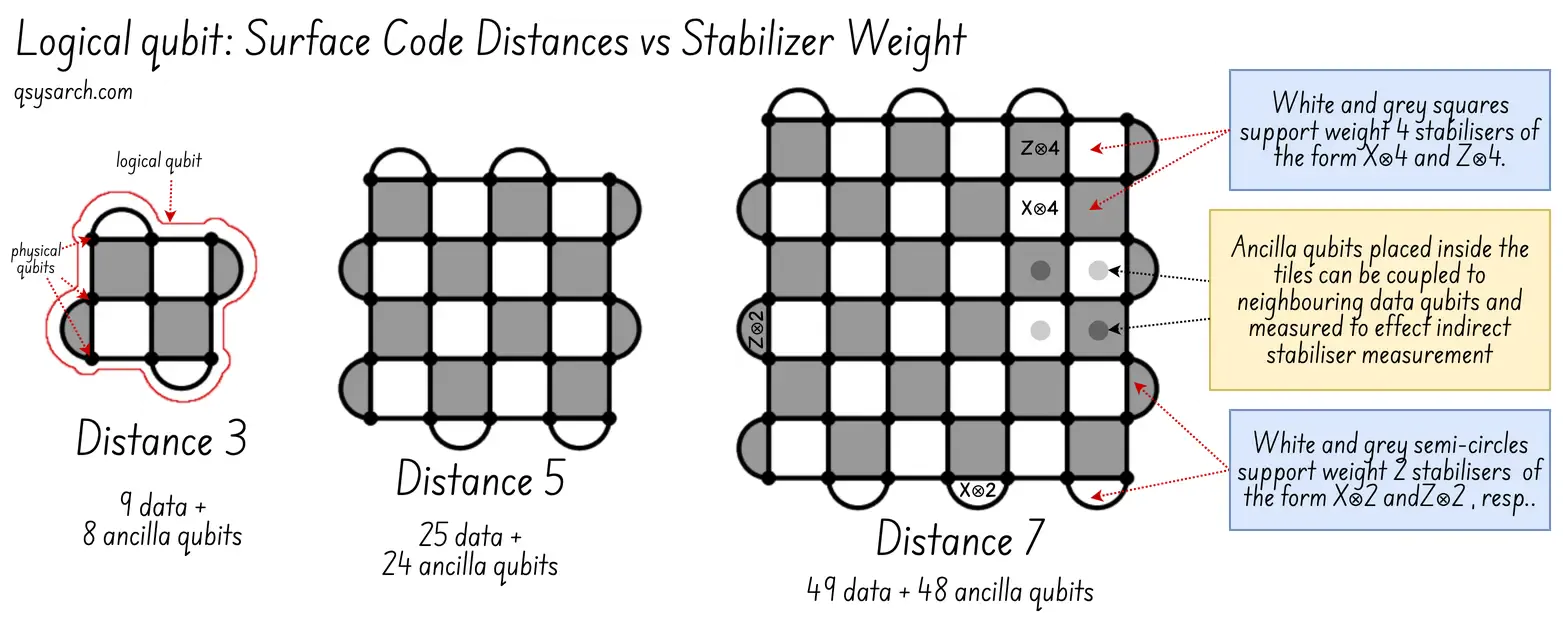
Bei einem Codeabstand von \( d=3 \) führt das Umklappen zweier benachbarter Qubits zum Informationsverlust, und QEC kann das logische Qubit nicht korrigieren, d. h. es kann den geschützten Zustand des logischen Qubits nicht aufrechterhalten. Bei einem größeren Codeabstand, z. B. \( d=5 \), kann der QEC-Decoder sicherstellen, dass selbst wenn Q1 und Q2 sich gegenseitig beim Z1Z2 - Check umklappen und maskieren, die Messung des erhöhten Stabilisators dem Decoder genügend Kontext liefert, um Q1 und Q2 als Doppelfehler zu identifizieren. Mathematisch lässt sich dies wie folgt ausdrücken:
Ein Code mit Distanz \( d \) kann bis zu \( (d-1) \) Fehler erkennen und bis zu \( \lfloor (d - 1)/2 \rfloor \) Fehler korrigieren .
Wenn Redundanz das Problem löst, warum nicht einfach Oberflächencode mit größeren Dimensionen verwenden? Die Herausforderung besteht darin, dass für jedes zusätzliche physikalische Qubit (zur Erhöhung der Redundanz) mehr Stabilisatoren gemessen werden müssen. Und mehr Messungen bedeuten mehr Gefahren (für das Auftreten physikalischer Fehler).
Dies führt zum sogenannten Schwellenwerttheorem
Ein Quantenschaltkreis der Größe \(N\) lässt sich mit hoher Genauigkeit durch einen verrauschten Quantenschaltkreis realisieren, vorausgesetzt, die Fehlerwahrscheinlichkeit an jeder Stelle des verrauschten Schaltkreises liegt unterhalb eines festen Schwellenwerts \(p_{th}>0\). Die Größe des verrauschten Schaltkreises skaliert mit \( O(N.log^c(N)) \) für eine positive Konstante \(c\).
Vereinfacht ausgedrückt bedeutet der Schwellenwertsatz, dass, solange die Fehlerrate der physikalischen Qubits \(p\) unterhalb eines Schwellenwerts \(p_{th}\) liegt, es möglich ist, weitere physikalische Qubits hinzuzufügen, um die Fehlerkorrektur zu verbessern, und dass die Anzahl der hinzugefügten Qubits in einer Komplexität von \(N.log(N)\) liegt.
Warum ist das wichtig? Weil es besagt, dass selbst wenn sich die Qubits nicht immer korrekt verhalten, vorausgesetzt, dies geschieht nicht zu oft, es möglich ist, eine größere Gruppe von Qubits dazu zu bringen, sich besser zu verhalten als die Summe der einzelnen Qubits. Dies ebnet den Weg für die Zeit nach NISQ, d. h. für das FTQC-Zeitalter (Fault-Tolerant Quantum Computing).
Die entscheidende Frage ist natürlich, wie hoch dieser Schwellenwert \ (p _ {th} ) ist. Er liegt in der Größenordnung von 0,1 % bis 1 %, und obwohl das niedrig erscheinen mag, stellt es kein Problem dar, da moderne Qubits bereits eine Genauigkeit von 99,9 % (bei Ein-Qubit-Gattern) erreichen können.
Voilà, dieses kurze Memo legt den Grundstein für die Konzepte, die bei der Quantenfehlerkorrektur Anwendung finden.
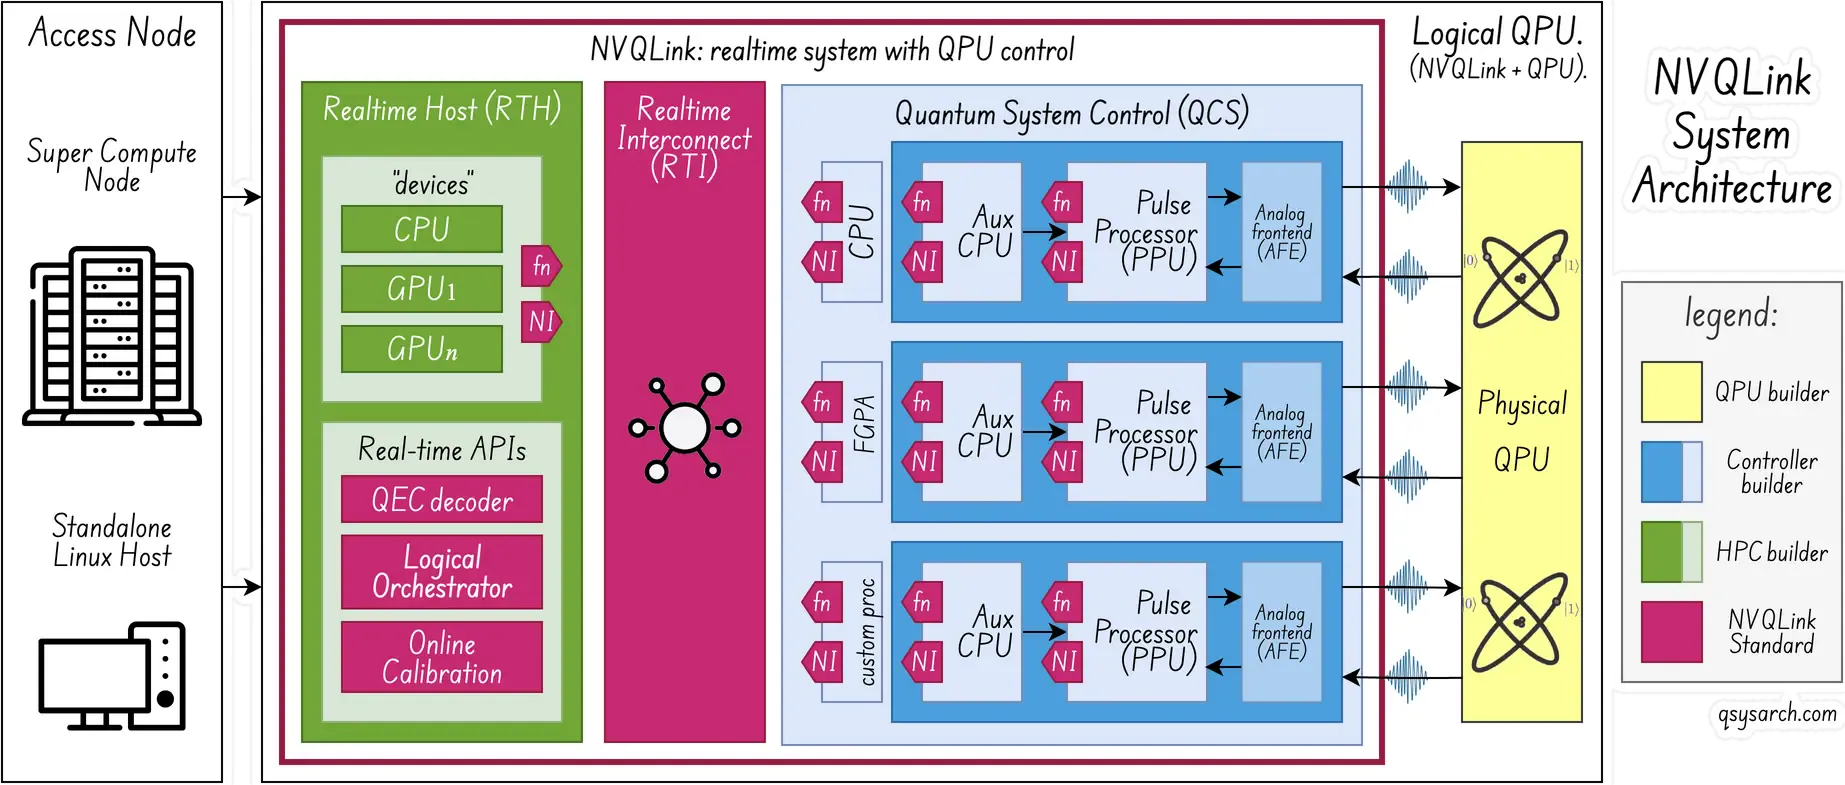
Die nächsten beiden Memos sind praxisorientierter. Das zweite analysiert konkret, was die Umwandlung eines physikalischen Qubits in ein logisches Qubit für das Quantenkontrollsystem (und den Fehlerdecoder) hinsichtlich Steuerung, Auslesen und Sequenzierung bedeutet. Das dritte Memo konzentriert sich auf das Decodierungssystem sowie auf geringe Latenz und Echtzeitfähigkeit der Kommunikation zwischen Decoder und Kontrollsystem (siehe Link).
Dieses Memo ist das erste einer Reihe. Die nächsten QEC-Memos werden sich mit folgenden Themen befassen:
Orchestrierung der Syndromextraktion aus der Perspektive des Quantenkontrollsystems
Echtzeit-Fehlerdekodierung: Extrem niedrige Latenz dank ASIC, GPU und neuronalen Netzen.
Gemeinsam entwickelte intelligente Qubits: Der Fall der fehlergeschützten Qubits von Alice und Bob
Oberflächencode-Compiler im großen Maßstab: Maximierung der Fehlertoleranz für Milliarden von physikalischen Operationen
Hierarchische Dekodierungsarchitekturen: Lokalitätsprinzip und mehrschichtige Verarbeitung
Logische Qubit-Orchestrierung: Gitterchirurgie & Verflechtung
Jenseits von Oberflächencodes: Der Übergang zu qLDPC-Codes
Magic State Destillation & Analog Rotationen
Das wird mich wohl die nächsten 6 Monate beschäftigen!
References:
DrawIO diagrams used in this memo: