Ich freue mich sehr, Teil des Teams bei Qblox zu sein, das aktiv mit Nvidia zusammenarbeitet, um den NVQLink- Standard zu fördern, als Möglichkeit, heterogene Systeme zu verbinden, die auf GPUs, CPUs und QPUs (Quantenprozessoren, einschließlich der von Qblox entwickelten Upfront-Quantencontroller) berechnet werden.
NVQLink auf einen Blick Link zu Überschrift
NVQLink ist nicht einfach nur ein weiteres “Kabel” zur Verbindung von GPUs mit Quantum-Prozessoren, sondern ein komplettes Framework, das die Verbindung heterogener Geräte ermöglicht, vom Netzwerk bis zum Software-Stack:
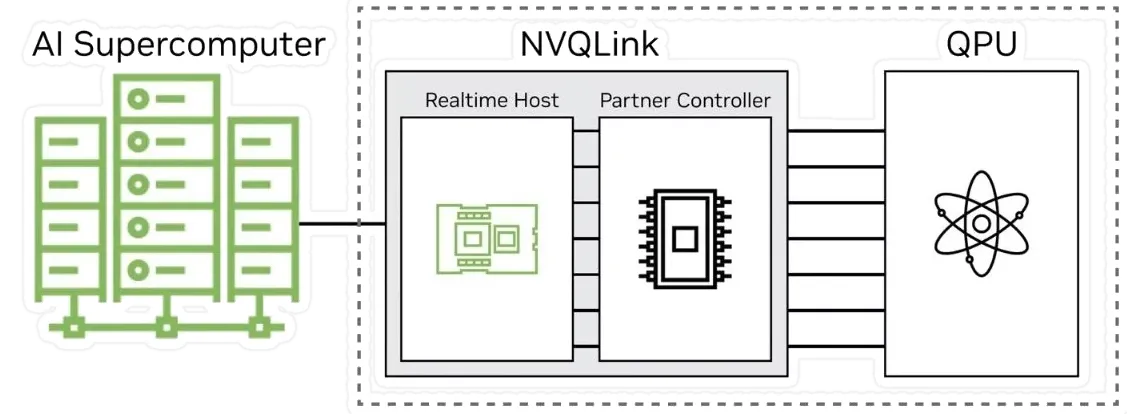 (Bildquelle: Nannod)
Welche Leistungsspezifikation Link zu Überschrift
Die wichtigsten Hardware-Spezifikationen betonen die Leistungsfähigkeit der Netzwerk- und Rechenressourcen:
Netzwerkdurchsatz: Bis zu 400 Gbit/s von der GPU zur QPU.
Netzwerklatenz: Roundtrip-Latenz (FPGA → GPU → FPGA) weniger als 4,0 Mikrosekunden.
GPU-Hardware: Echtzeit-Host, der auf NVIDIA GB200 Grace Blackwell Superchips basiert und über eine hohe TFLOPS-Leistung verfügt.
Warum NVQLink benötigt wird Link zu Überschrift
Sie fragen sich vielleicht: „Warum ist das wichtig?“
Es schafft einen offenen Standard zur engen Integration von Quantenhardware mit beschleunigter GPU-Berechnung.
Es ermöglicht hybride Arbeitsabläufe: Kalibrierung neuronaler Netze, Quantenfehlerkorrektur (QEC) usw.
Es bietet eine offene Plattform, die Software und Hardware zu einer Einheit integriert und es so jedem ermöglicht, mit Quantencomputern zu interagieren, ohne in einem Meer von Wissen ertrinken zu müssen – dank Cuda-Q .
NVQLink-Spezifikation: Architekturentwurf Link zu Überschrift
Das NVQLink-Whitepaper ist jetzt unter https://arxiv.org/abs/2510.25213 verfügbar. Lassen Sie uns also die Details der vorgeschlagenen Architektur genauer betrachten:
Systemarchitektur Link zu Überschrift
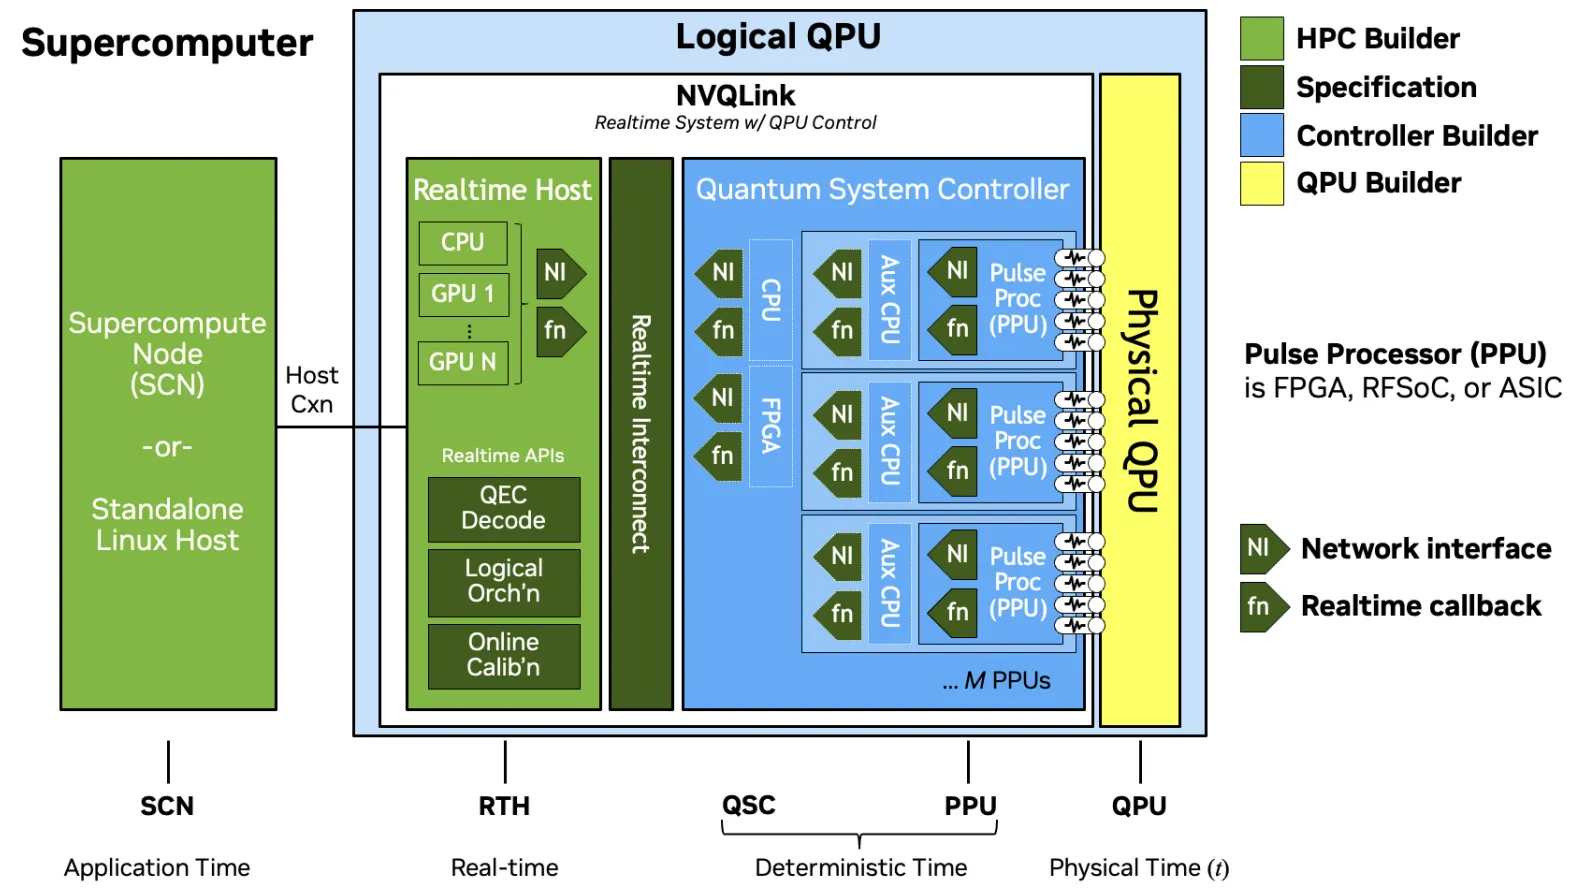
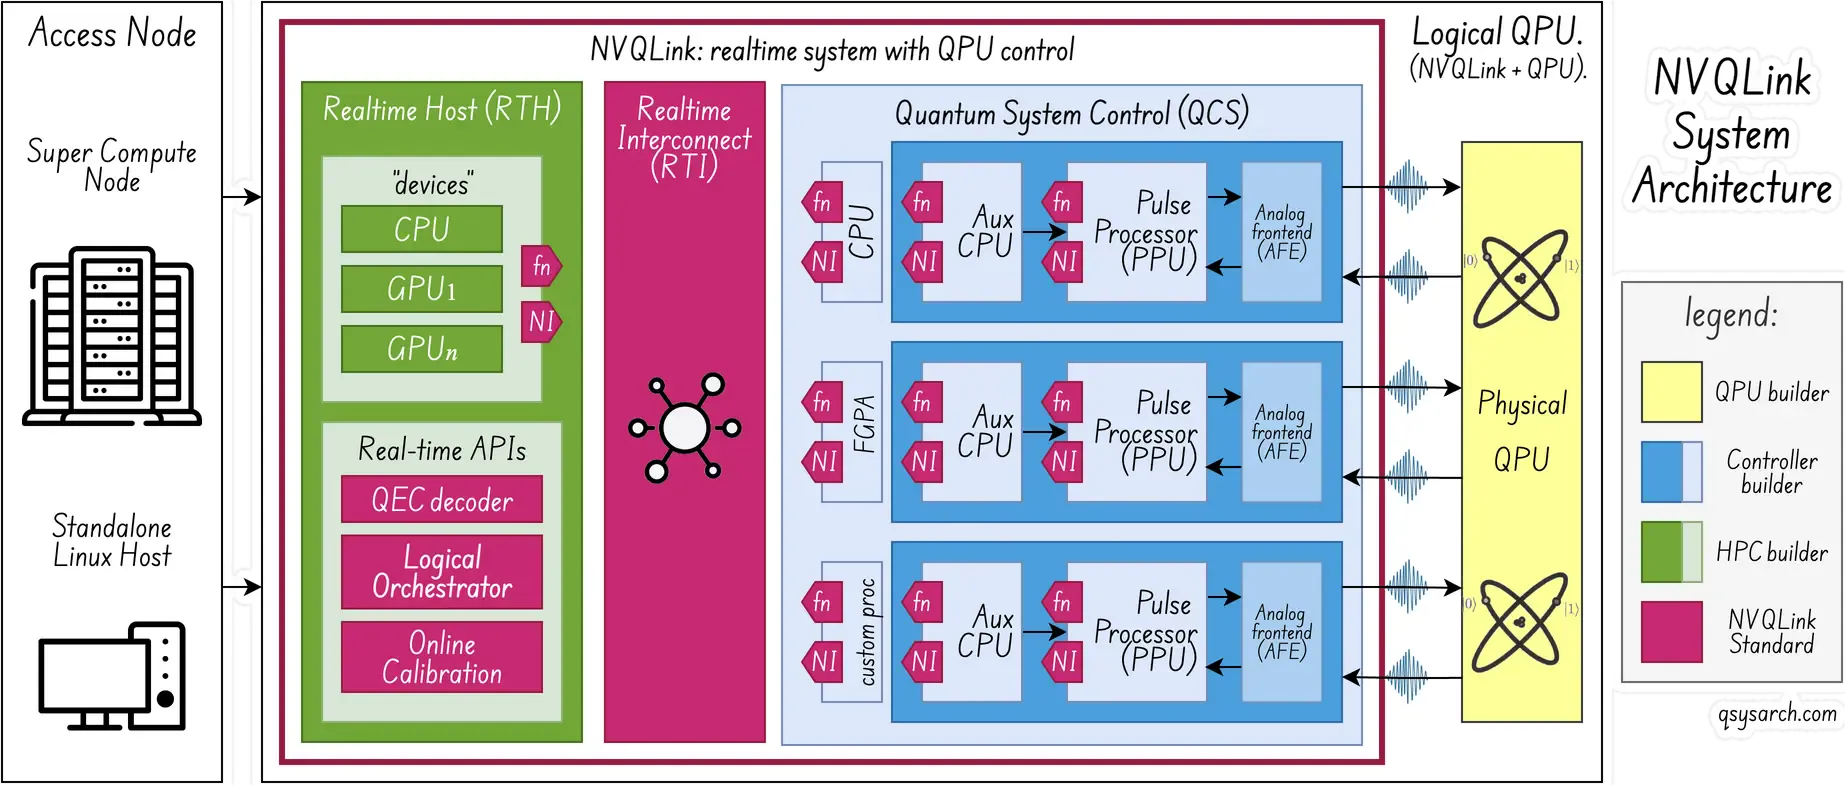 (Systemdiagramm adaptiert von der Originalabbildung aus dem Whitepaper)
Wie erwartet, entsprechen die Details der Übersicht von Nannod. Aus Komponentensicht besteht die NVQLink-Architektur aus dem Echtzeit-Host (RTH) und dem QPU-Steuerungssystem (QSC). Diese beiden Komponenten sind über eine skalierbare Echtzeitverbindung mit geringer Latenz (RTI) verbunden. Der RTH verfügt über herkömmliche HPC-Rechenressourcen wie CPUs und GPUs. Das QSC umfasst typischerweise die Pulsverarbeitungseinheiten (PPU), die die QPU steuern.
Dieses Diagramm führt zwei wichtige Schlüsselwörter ein: fn und NI. Im NVQLink-Modell (Programmiermodell) werden alle CPUs, GPUs, PPUs (oder andere spezialisierte ICs/FPGAs) als „Geräte“ bezeichnet. NVQLink ermöglicht Remote Procedure Calls (Callbacks oder fn) an jedes dieser Geräte. Dies ist eine äußerst leistungsstarke Lösung, bei der NVQLink als Bindeglied zwischen heterogenen Systemen fungiert. Die eigentliche Implementierung der fn-Laufzeitumgebung ist so hochgradig optimiert, dass sogar das Marshalling übernommen wird. Dadurch lassen sich Latenzen von wenigen Mikrosekunden gewährleisten. NI steht für Network Interface (Netzwerkschnittstelle) und ist als kleine, optionale Netzwerkkarte/Schnittstelle/Kabel konzipiert, die von allen Beteiligten für ein einheitliches, vernetztes System genutzt werden kann.
Zeitdomänen Link zu Überschrift
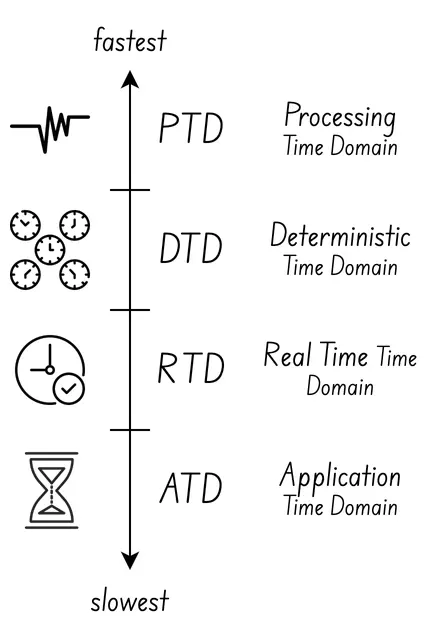
Der NVQLink führt außerdem das sehr wichtige Konzept der Zeitdomänen ein: Dies ist notwendig, da nicht alle am System beteiligten „Verarbeitungseinheiten“ dem „gleichen Takt“ folgen.
Es gibt vier Kategorien von Takt- bzw. Zeitdomänen, von der schnellsten zur langsamsten:

Physikalische Zeitdomäne (PTD): Üblicherweise der QPU-Takt.
Deterministische Zeitdomäne (DTD): Üblicherweise der Takt von QSC/FPGAs, der mit quantenkohärenten Zeitskalen arbeiten kann.
Echtzeitbereich (RTD): Üblicherweise auf der klassischen CPU oder GPU. Kann innerhalb der Quantenkohärenzzeit oder zwischen zwei Quantenkohärenzexperimenten stattfinden.
Anwendungszeitdomäne (ATD): Normalerweise der Laptop, auf dem Jupyter Notebook ausgeführt wird!
Netzwerkarchitektur Link zu Überschrift
NVQLink nutzt erwartungsgemäß RDMA und GPUDirect , um unnötige CPU-Verarbeitung zu vermeiden und eine optimale Latenz zu gewährleisten. Wie in der Spezifikation beschrieben, sind „dank dieser beiden Technologien bei der Verarbeitung der vom und zum QSC gesendeten Pakete ausschließlich die Netzwerkkarte (NIC) und die GPU beteiligt, ohne dass der Host involviert ist“.
Die Spezifikation empfiehlt außerdem die Verwendung des RDMA-Modus „Unreliable Connection“, da der Latenzaufwand für zuverlässige Verbindungen (RCs) im Vergleich zu einem ordnungsgemäß konzipierten Netzwerk übertrieben sein kann.
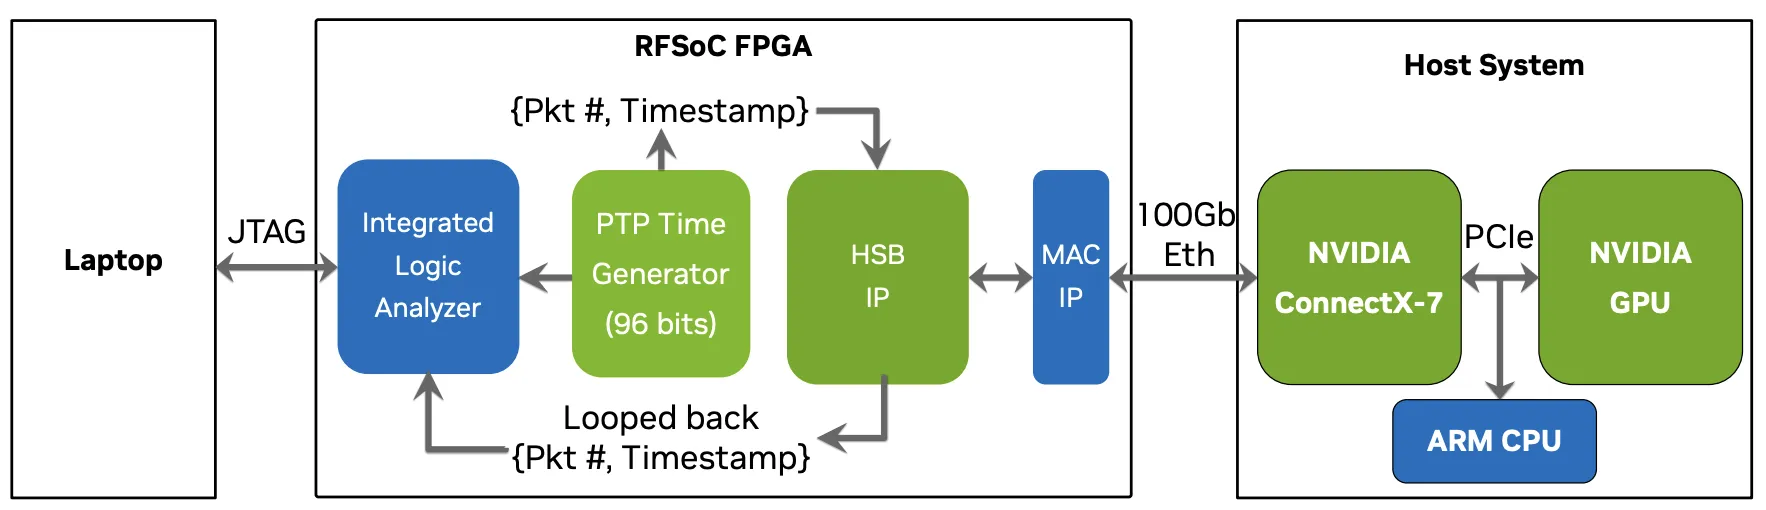
Die Spezifikation liefert einen Machbarkeitsnachweis für die Netzwerkarchitektur, um die erreichbare Latenz zu verifizieren. Dabei kommt das Holoscan Sensor Bridge- Modul zum Einsatz, das die Datenübertragung zwischen einem FPGA und einer Netzwerkkarte (NIC) mittels RDMA over Converged Ethernet (RoCE) ermöglicht und zudem die Enumerationsschritte und Steuersignale verarbeitet. Die Spezifikation zeigt, dass mit dieser Architektur eine Roundtrip-Latenz von unter 4 Mikrosekunden für eine 32 Byte große RDMA-Nutzlast, entsprechend einem 92 Byte großen Ethernet-Frame, erreicht werden kann.
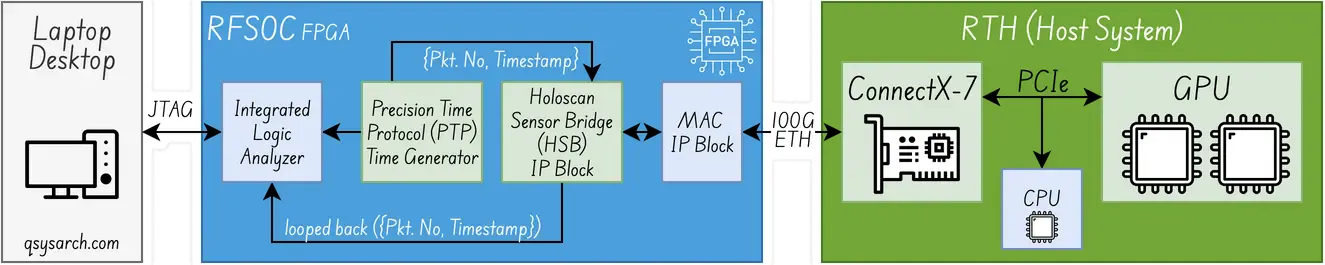 (Diagramm adaptiert von der Originalabbildung aus dem Whitepaper)
Kompilierungsarchitektur (auch bekannt als CudaQ+NVQLink-Programmiermodell) Link zu Überschrift
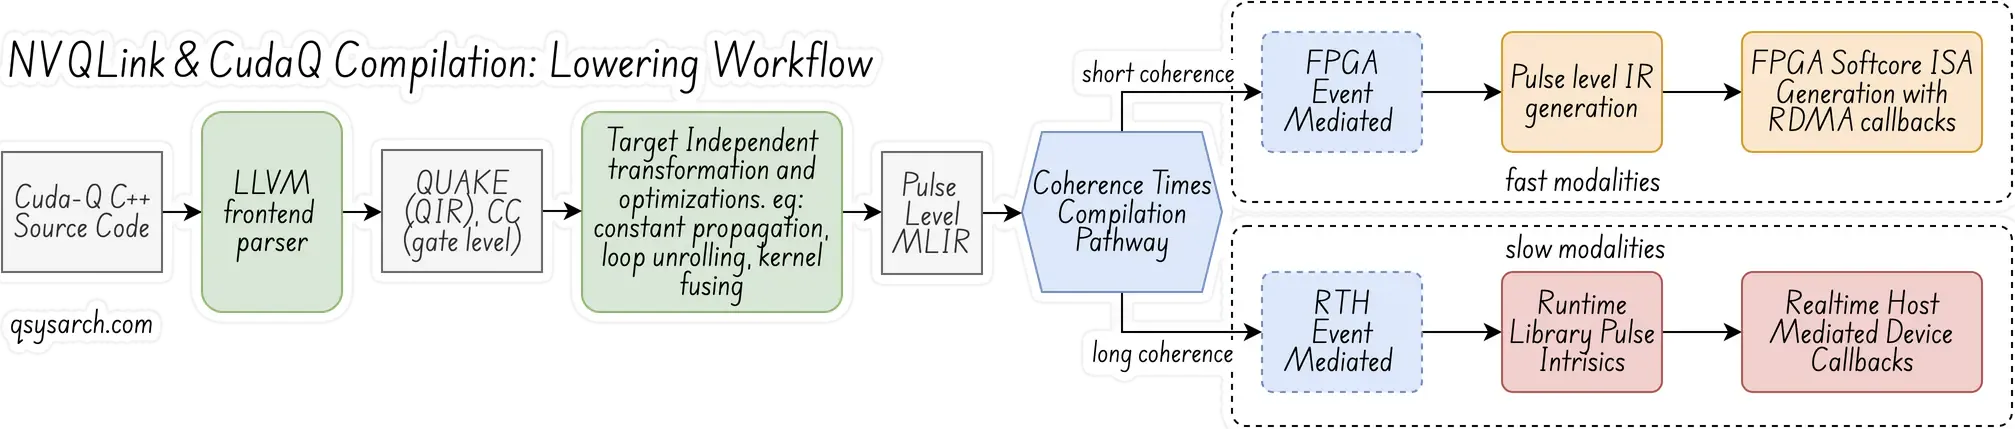
NVQLink unterscheidet zwischen langsamen und schnellen Modalitäten. In diesem Abschnitt werde ich insbesondere die Auswirkungen der Architektur der schnellen Modalität (sogenannte „Hohe Latenzempfindlichkeit“) untersuchen. Der Hauptunterschied zu langsamen Modalitäten besteht darin, dass die Architektur sowohl Just-in-Time-Kompilierung (JIT) als auch eine mögliche RTH-Mediation während der Ausführung ermöglicht.
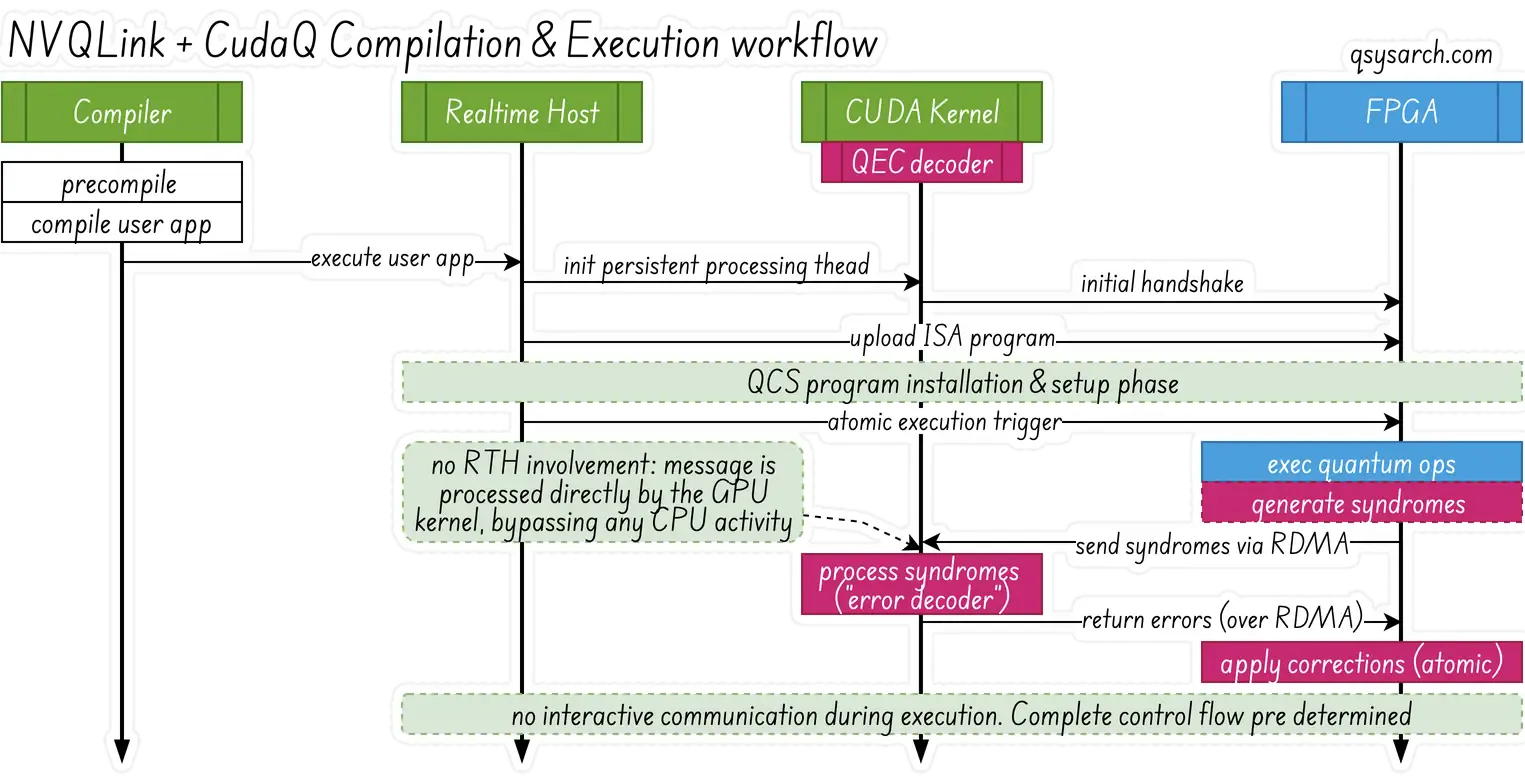
Damit CudaQ + NVQLink mit schnellen Modalitäten funktioniert, schreibt die Spezifikation vor, dass die vollständigen ISA-Programme im Voraus auf die FPGAs hochgeladen und atomar ausgeführt werden müssen, mit minimaler interaktiver Kommunikation mit dem Echtzeit-Host während der Ausführung. JIT ist eine wirklich tolle Technologie, daher ist es schade, dass sie nicht für schnelle Modalitäten genutzt werden kann. Die Spezifikation stellt jedoch klar, dass die FPGAs dynamische Aktualisierungen vom RTH empfangen dürfen (über eine Befehlswarteschlange), vorausgesetzt, die Befehlswarteschlange bleibt bis zum Programmende nicht leer. Das klingt nach Just-in-Time-Scheduling.
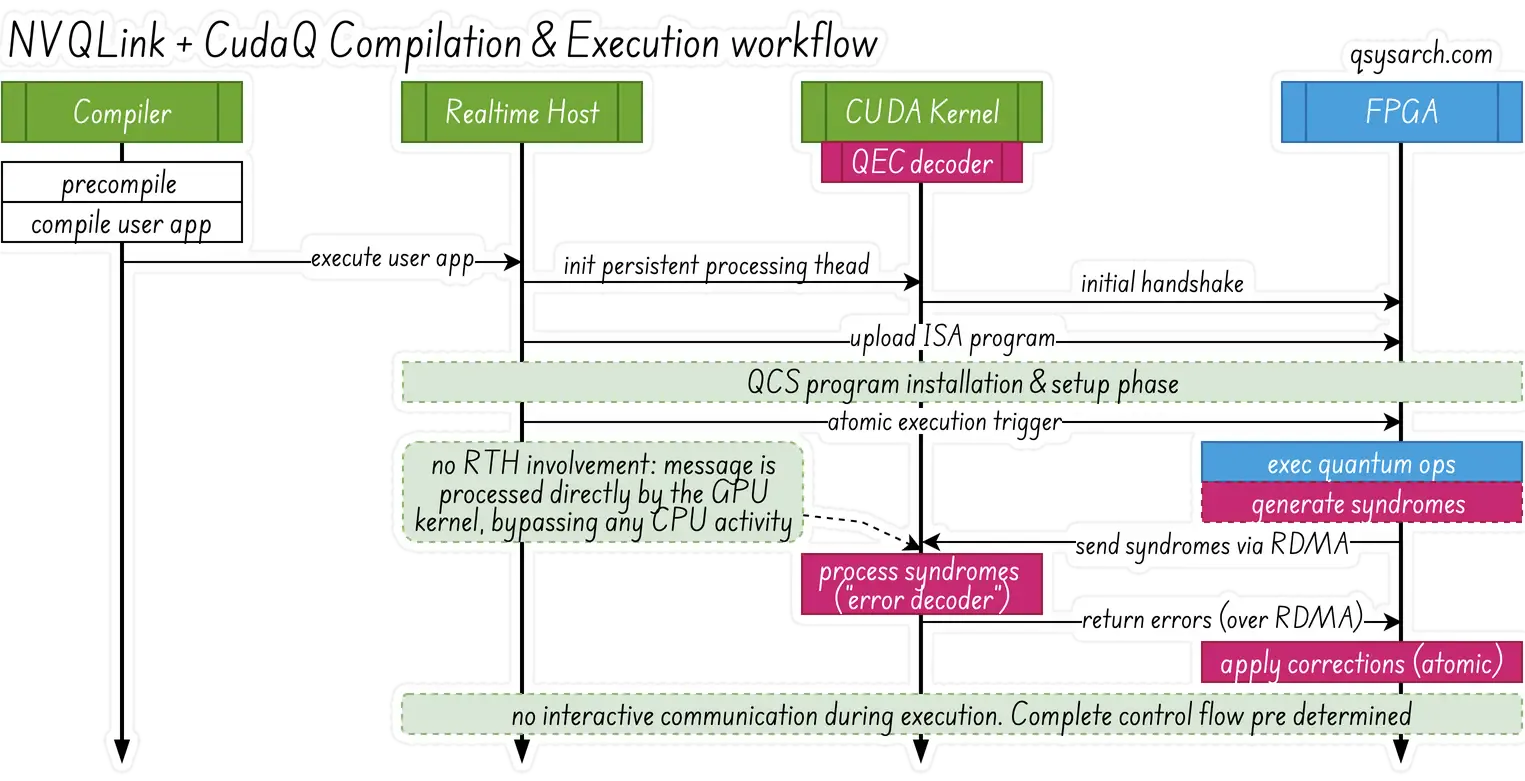
Die Spezifikation macht wenig überraschend deutlich, dass die Kompilierung aggressive Voraboptimierungen durchführen muss – ein Prinzip, das alle Anbieter von Quantensteuerungs-Stacks standardmäßig anwenden. Weiterhin wird erwähnt, dass der CUDA-Kernel auf der GPU vorinitialisiert sein und aktiv auf Ereignisse warten muss, falls ein Callback auf der GPU ausgeführt werden soll – nichts Ungewöhnliches, dies entspricht dem Standard -Workflow von DOCA GPUNetIO.
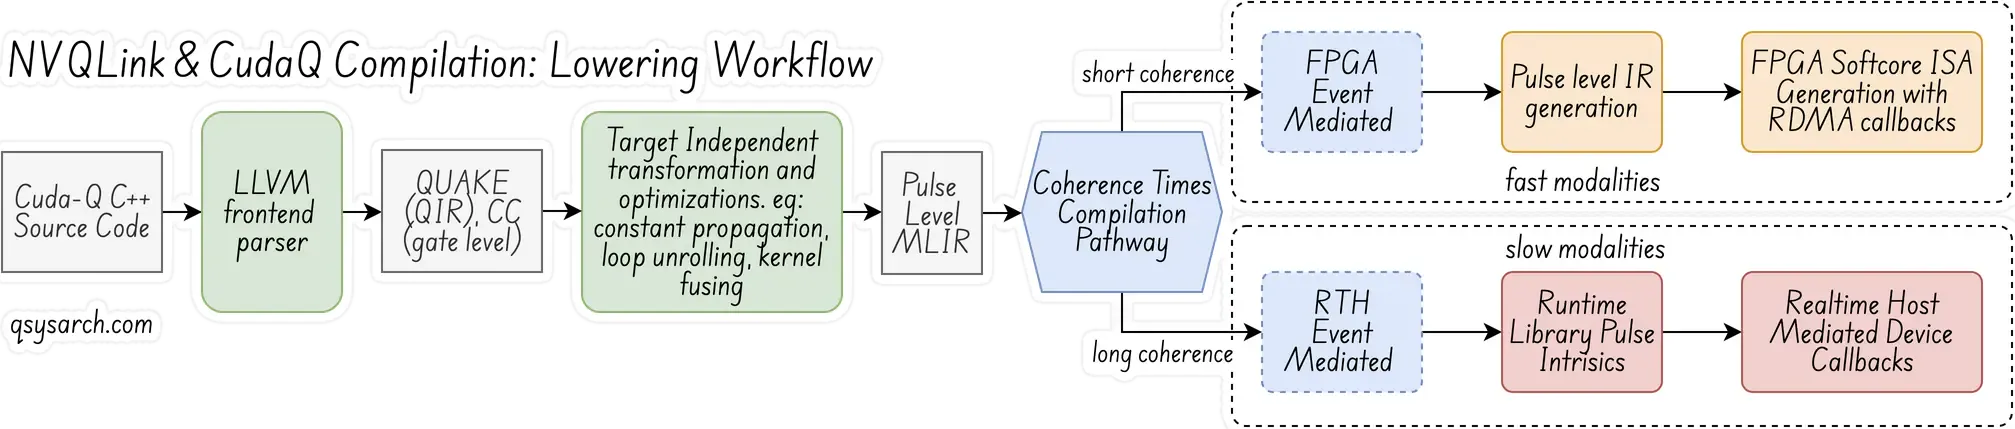
Der Workflow für die CUDA=Q-Kompilierung und -Umwandlung in die NVQLink-Architektur basiert auf der standardmäßigen LLVM MLIR-Architektur (siehe Abbildung oben). Im ersten Schritt werden die CUDA-Kernel analysiert und die Quantum IR (auch bekannt als QIR oder QUAKE ) und die CC (Classic Compute) Zwischen-IRs generiert, die auf Gatterebene abstrahiert werden. In einer späteren Phase erfolgen die notwendige Optimierung und Kernelfusion, wodurch ein Puls-Level-Dialekt entsteht. Abhängig vom Modalitätstyp nutzt die nächste Umwandlungsphase entweder die RTH- oder die FPGA-Mediation.
Der „Quantenkernel“ wird durch das Präfix __qpu__ gekennzeichnet.
int gpu_adder(int, int);  // This function is executed on GPU
__qpu__ int simple_quantum_kernel(int i) { // This function (kernel) is executed on the QCU
    cudaq::qubit q;
    h(q); // Operate an H gate on qubit q
    auto readout = mz(q); // Read the Z axis of qubit q
    return cudaq::device_call(2, gpu_adder, i, readout); // This is tail function call
}
Während der Kompilierungsphase wird es zunächst in eine Mischung aus QUAKE (Quanten-Dialekt) und CC (Klassischer Rechen-Dialekt) Zwischenrepräsentationen (IR) oder Dialekten umgewandelt (“niedriger”):
func.func @simple_quantum_kernel(%arg0: i32) -> i32 {
    %0 = quake.null_wire
    %1 = quake.h %0 : (!quake.wire) -> !quake.wire
    %measOut, %wires = quake.mz %1 : (!quake.wire) -> (!quake.measure, !quake.wire)
    %2 = quake.discriminate %measOut : (!quake.measure) -> i1
    %3 = cc.cast unsigned %2 : (i1) -> i32
    %4 = cc.device_call @gpu_adder on 2 (%arg0, %3) : (i32, i32) -> i32
    return %4 : i32
}
Laufzeitarchitektur: Metaprogrammierung mit Traits Link zu Überschrift
Im Einklang mit dem in RDMA tief verwurzelten Konzept des Zero-Copy fördert die NVQLINK-Laufzeitumgebung auch eine hohe Leistungsfähigkeit und Abstraktion ohne Overhead, die durch zwei wesentliche Schlüsselkonzepte erreicht wird:
Trait-basierte Komposition: Es handelt sich um ein Kompilierzeitmittel zur Beschreibung des Verhaltens eines beliebigen Geräts, und NVQLink schlägt eine Reihe von Standard-Traits vor.
Statischer Polymorphismus: Es handelt sich um ein Mittel zur Kompilierzeit, mit dem der Compiler die richtige Methode instanziieren kann, ohne dass eine Indirektion der virtuellen Tabelle erforderlich ist.
Es gibt 4 wesentliche Merkmale:
explicit_data_marshalling_trait: Mittel zur Zuweisung und Übertragung von Daten im System.
device_callback_trait: Mittel zum Aufrufen von Gerätefunktionen (“RPC”)
quantum_control_trait: bedeutet, ein Programm auf den QCS hochzuladen und zu starten
rdma_trait: Mittel zur effizienten Initialisierung einer Struktur aus dem Rohspeicherpuffer.
In der Praxis nutzen die Traits die C++-Sprache auf einem äußerst fortgeschrittenen Niveau. Ein Beispiel hierfür ist der Datenmarshalling-Trait.
template <typename Derived> class explicit_data_marshaling_trait {
public:
  void *resolve_pointer(device_ptr &devPtr);
  device_ptr malloc(size_t size) const;

  template <typename... Sizes, enable_if_t<(conjunction_v<is_integral<Sizes>...>),int> = 0>
  auto malloc(Sizes... szs) { return make_tuple(static_cast<Derived *>(this)->malloc(szs)...); }

  void free(device_ptr &d);

  template <typename... Ptrs, typename = enable_if_t<(conjunction_v<is_same< remove_cv_t<remove_reference_t<Ptrs>>, device_ptr>...>)>>
    void free(Ptrs &&...d) { (free(d), ...);
  }
  void send(device_ptr &dest, const void *src);
  void recv(void *dest, const device_ptr &src);
};
Diese Syntax birgt viel Potenzial und ist meiner Meinung nach sogar noch leistungsfähiger als die Rust-Syntax (z. B. [cow](/posts/4-rust-to-the-rescue/#third-challenge-clone-on-write) ). Sie wird auch als Metaprogrammierung bezeichnet und bezieht sich im Kontext von NVQLINQ auf Kompilierzeit- oder statischen Polymorphismus. Betrachten wir die Zeile _template. <typename… Sizes, enable_if_t<(conjunction_v<is_integral
is_integral<Sizes>als α:true, fallsSizesein ganzzahliger Typ ist, z. B. int, float, bool usw.conjunction_v<α...>as β:true, wenn alle Werte inα...wahr sindenable_if_t<(β),int>als δ: eine Bedingung der Gruppe 2 , die fehlschlagen sollte, wennβfalsch war.Vorlage<typename... Sizes, δ = 0>: Ein SFINAE- Konstrukt, das verhindert, dassδfehlschlägt.
Mit dieser Syntax wird es möglich, mehrere Blöcke gleichzeitig mit einem speziellen malloc zu reservieren:
class gemm_device : public explicit_data_marshalling_trait {  ... }
gemm_device gpu_gemm; // "gemm" stands for general matrix multiply
auto [column, row, matrix] = device.malloc(1024, 1024, 1024*1024);
Sie fragen sich vielleicht, warum das wichtig ist. Ganz einfach: Es ermöglicht eine optimale Spezialisierung bereits zur Kompilierzeit. In diesem Fall kann die Implementierung von malloc den Speicherpuffer zusammenhängend bündeln, wodurch er sich für RDMA-Austausche und das atomare Marshalling mehrerer Daten eignet. Genial, oder?
Laufzeitarchitektur: Kernel Link zu Überschrift
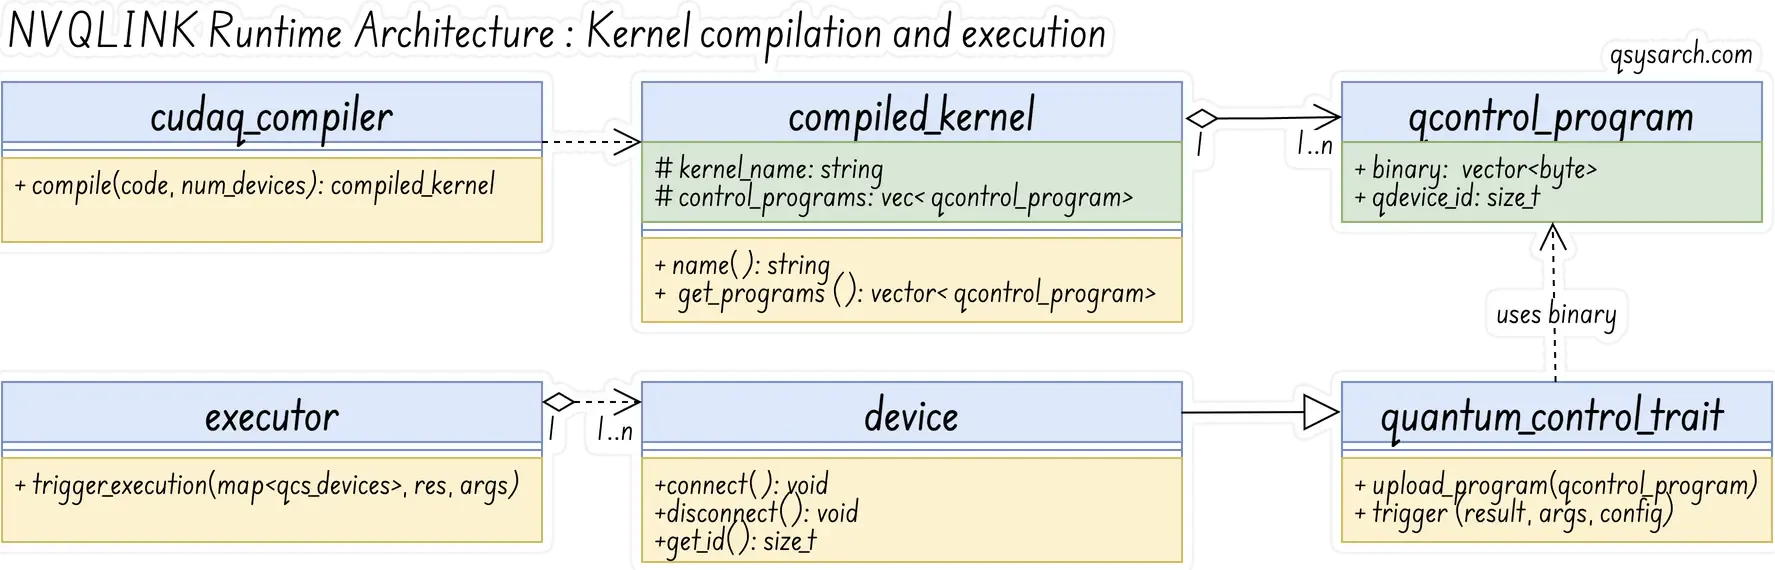
NVQLink bietet eine Reihe von Standardschnittstellen zum Kompilieren, Hochladen und Ausführen (Auslösen) von Quantenkernen. Da ein Bild mehr sagt als tausend Worte, fasse ich diesen Abschnitt mit dieser Zeichnung zusammen:
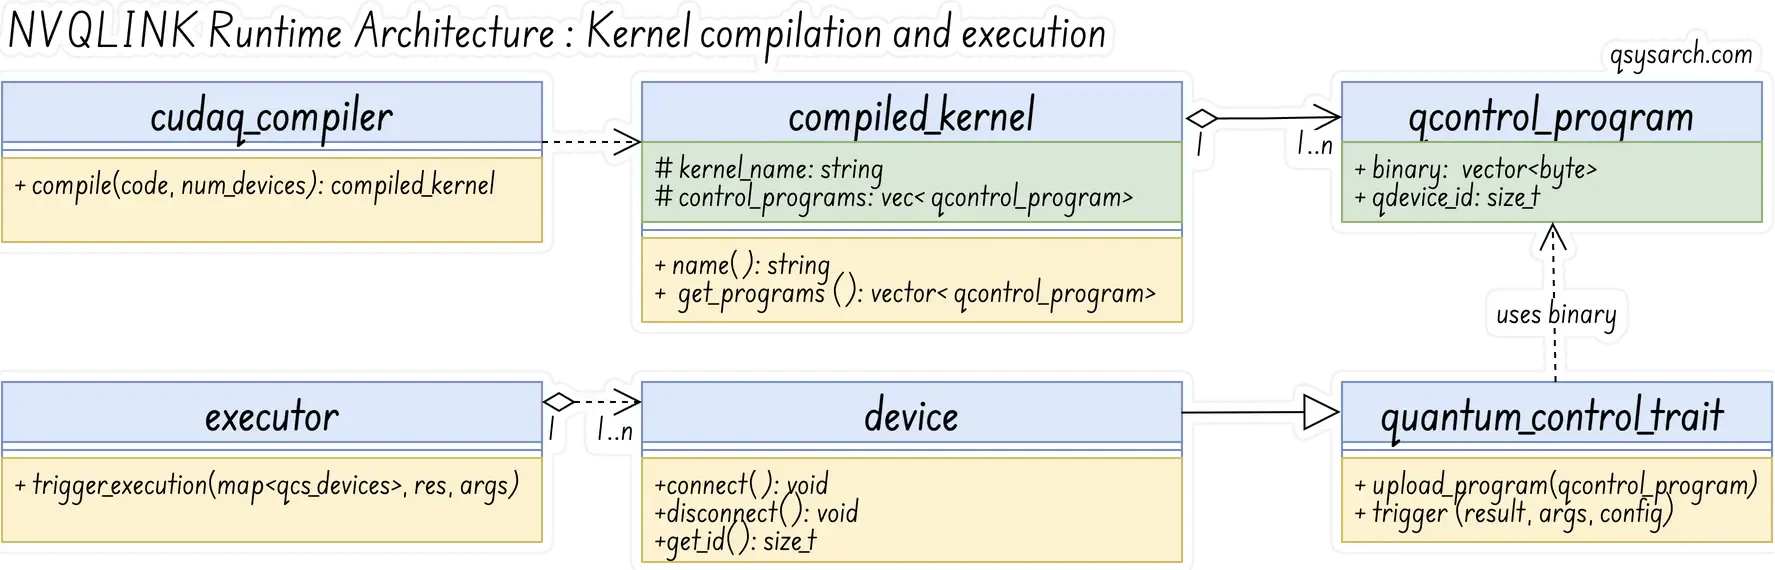
Zu beachten ist, dass ein QCS (Quantum Control System) aus mehreren PPUs (Pulse Processor Units) besteht. Daher muss ein Kernel beim Kompilieren möglicherweise kosynchron auf mehreren PPUs ausgeführt werden. (NVQLink ist unabhängig von der Kosynchronität, aber jeder QCS-Anbieter hat seine eigene Lösung, z. B. SYNQ für Qblox.)
Im Kontext der NVQLINK-Schnittstellen wird das Konzept der PPUs abstrahiert und durch das QCS (Generic Quantum Device) ersetzt. Daher generiert NVQLINK beim Kompilieren eines Kernels mehrere Programme für jedes QCS.
Laufzeitarchitektur: Abstraktion höherer Ebene „Bibliothek“ Link zu Überschrift
Da der im vorherigen Abschnitt erläuterte Code recht komplex sein kann und schwer zu verstehen und weiterzuentwickeln ist, bietet NVQLINK eine Reihe von übergeordneten APIs in Form von Funktionen an:
Die Bibliothek enthält Funktionen für grundlegende Initialisierungs- und Herunterfahrvorgänge, für gerätespezifische Datenänderungs-APIs wie memcpy, zum Verschieben von Daten zur und von der logischen QPU sowie für Upload und Ausführung. Nachfolgend finden Sie eine vereinfachte Version dieser Funktionen:
void initialize(DeviceTypes &&...in_devices);
void shutdown();

device_ptr malloc(size_t size, size_t devId);
void free(device_ptr &d);

void memcpy_to_qpu(device_ptr &arg, const void *src);
void memcpy_from_qpu(void *dest, const device_ptr &src);

handle load_kernel(const string &code, const string &kernel_name);
void launch_kernel(handle kernelHandle, device_ptr &result, const vector<device_ptr> &args);
Anwendungsbeispiel: Lasst uns teleportieren Link zu Überschrift
noch zu erledigen
Abschluss Link zu Überschrift
NVQLink ist eine leistungsstarke Abstraktion auf Systemebene, die die Verbindung heterogener Systeme mit einer hocheffizienten und optimierten Laufzeitumgebung ermöglicht. Im Vergleich zu anderen Frameworks zeichnet sich NVQLink dadurch aus, dass es aus standardisierten Komponenten besteht, darunter RDMA für das Netzwerk, LLVM für den Compiler sowie Traits und standardisierte APIs für die Laufzeitumgebung.
Mit NVQLINK müssen sich Entwickler und Integratoren keine Gedanken mehr um die Verbindung von Systemen machen. Stattdessen können sie sich auf die Zusammenstellung ihres heterogenen Systems konzentrieren und ihre Multi-Device-Kernel in einem einzigen Framework kompilieren. Die NVQLINK-Laufzeitumgebung orchestriert die Ausführung der verschiedenen „Geräte“ – genau wie bei einem einzigen System. Die NVQLINK-Laufzeitumgebung kümmert sich um Netzwerkkommunikation, Marshalling und die Kommunikation zwischen den Geräten.
Das ist ein gewaltiger Fortschritt – zusammen mit CudaQ ermöglicht es Quanteningenieuren die Entwicklung leistungsstarker Anwendungen, ähnlich wie Nvidia CUDA leistungsstarke neuronale Netzwerkanwendungen ermöglicht hat. Man könnte es als ein Masterstudium mit einem Hauch von Quantenphysik bezeichnen.
Aufforderung: Zeichnen Sie ein Bild eines “Large Qubits Model”, das auf einer benachbarten GPU berechnet wird, die über das NVQLINK-System verbunden ist. >
ChatGPT hat nicht verstanden, dass NVLINK nicht NVQLINK ist.
Aufforderung: Können Sie eine Zeichnung im Cartoon-Stil eines NVQLINK-Systems anfertigen, das ein „großes Qubit-Modell“ mit einer benachbarten GPU verbindet? >
ChatGPT versteht immer noch nicht, dass NVQLINK kein „Kabel“ ist, sondern ein Systemframework, das die Komposition von Kerneln ermöglicht, die auf mehreren heterogenen Geräten ausgeführt werden. Und dass das Kabel vorerst ein RDMA-Verfahren sein soll (weil es ein Standard ist), aber in fünf Jahren durchaus NVLink sein könnte.
References
- Platform Architecture for Tight Coupling of High-Performance Computing with Quantum Processors
- An LLVM-based C++ Compiler Toolchain for Variational Hybrid Quantum-Classical Algorithms and Quantum Accelerators
DrawIO diagrams used in this memo:


In the press Link zu Überschrift
QPU Vendor Link zu Überschrift
- Pasqal: Integrated with their Qadence/Pulser stack.
- Quandela: Integrated with the Merlin framework
- IQM: Together with Zurich Instruments.
- Infleqtion: Integrated with the Superstaq.
- OQC|Oxford Quantum Circuits:
- Orca Computing: PT-Series systems
- Rigetti
- Silicon Quantum Computing:
- SEEQC:
- Alice & Bob
- Quantinuum
- IonQ