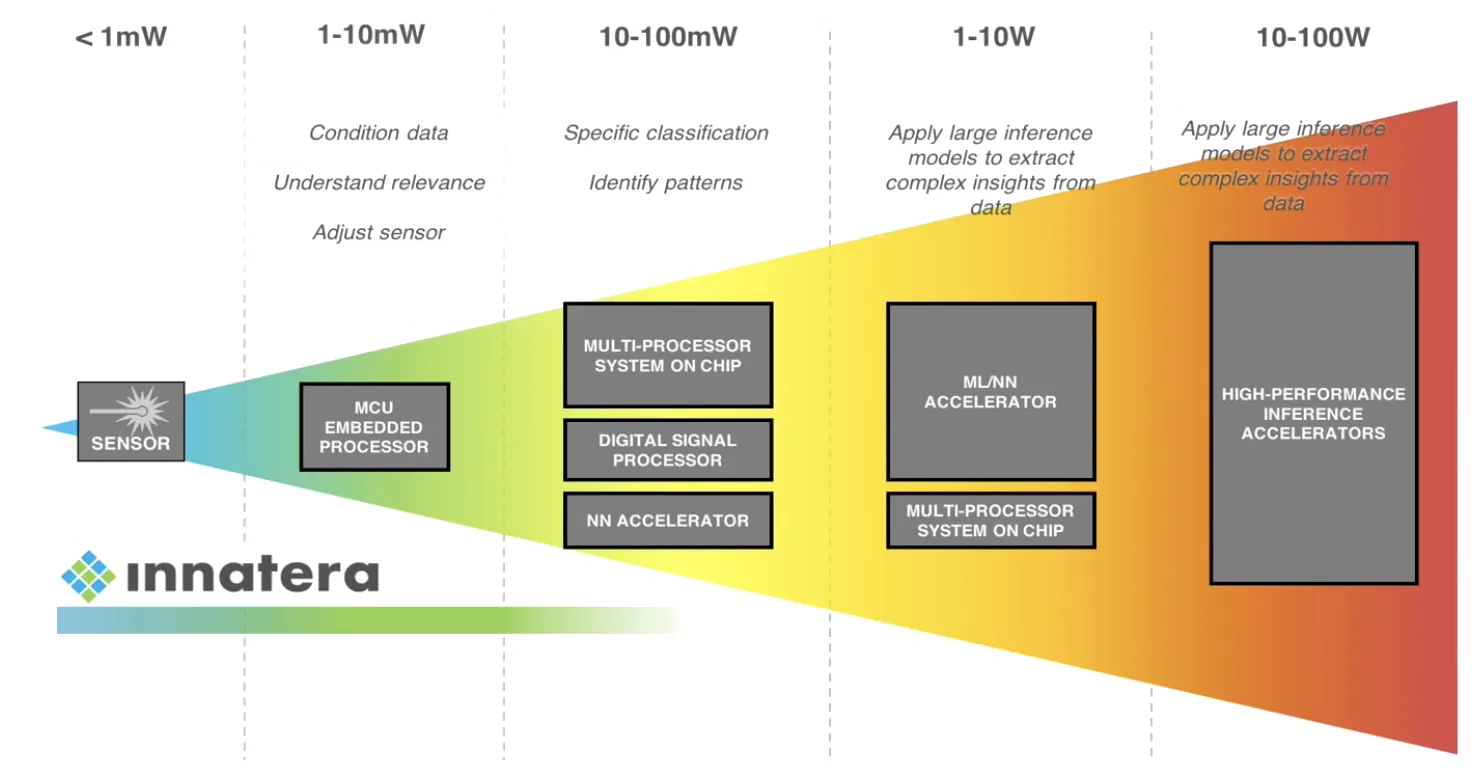
Kürzlich hörte ich im Zusammenhang mit Neuralink von neuromorphen Verarbeitungseinheiten (NPUs). Diese NPUs haben zwar nichts mit Quantencomputing zu tun, aber ich fand es interessant, mich etwas mit dieser neuen Verarbeitungsarchitektur auseinanderzusetzen. Tatsächlich ist einer der führenden IC-Hersteller in diesem Bereich das niederländische Unternehmen Innatera. Der neueste IC von Innatera, Pulsar, basiert auf energieeffizienten Spiking Neural Networks (siehe Abbildung rechts).
In diesem Memo werde ich versuchen, so viele Informationen wie möglich über die Architektur dieser neuromorphen ICs, das Design der Spiking Neural Networks und den Software-Stack, der zur Programmierung dieser Geräte verwendet wird, zu gewinnen.
Dies ist ein Versuch, das Architekturdiagramm für den Pulsar IC neu zu zeichnen (Originalbild image, ergänzt durch Erkenntnisse aus dem Whitepaper):
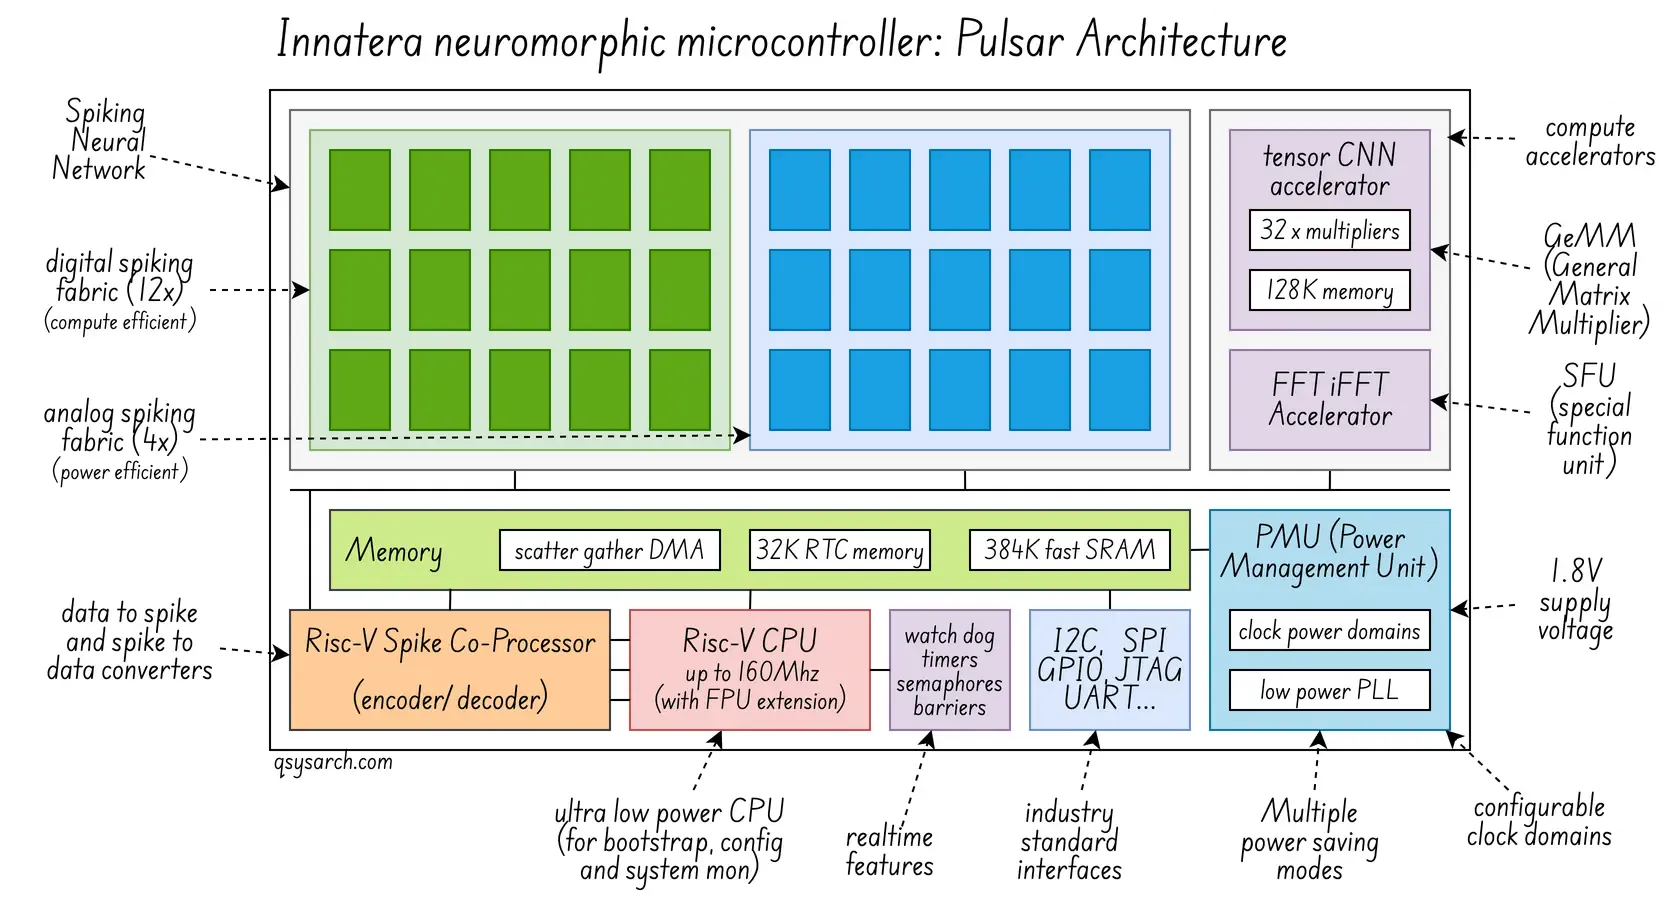
Ich finde die Idee, eine RISC-V-CPU zu verwenden, gut – das ist ein klares Zeichen dafür, dass das Team von Innatera von Anfang an die richtige Architekturentscheidung getroffen hat. In einem der Diagramme des früheren T1-Chips von Innatera ist die RISC-V-CPU mit einer F-Erweiterung (Unterstützung für Gleitkommaarithmetik) ausgestattet.
Der IC integriert zahlreiche Standardschnittstellen (SPI, I2C usw.) und eine Energiemanagementeinheit (PMU), die beim Wechsel in den Schlaf- oder Energiesparmodus Teile des ICs ein- und ausschaltet. Leider konnte ich keine Daten zum tatsächlichen Stromverbrauch finden, außer der Angabe „weniger als 1 mW“. Bei einer Versorgungsspannung von 1,8 V ergäbe dies weniger als 500 µA (I = W/V). Ich frage mich auch, ob die Angabe des Stromverbrauchs pro Zyklus relevant ist: Bei einer angenommenen Frequenz von 100 Hz (synaptische Aktualisierungsperiode) wären das durchschnittlich 5 µA pro synaptischer Aktualisierung.
Das neueste Diagramm von Pulsar zeigt zwei Beschleuniger: ein CNN und eine FFT. Diese lassen sich vermutlich allgemeiner als GEMM (General Matrix Multiplier, Schlüsselkomponente für die NN-Berechnung) und SFU (Special Function Unit, zur Beschleunigung der FFT-Berechnung) beschreiben. Weitere Informationen zur GPU-Architektur finden Sie im Beitrag. Außerdem gibt es einen Spike-Encoder/Decoder, der anscheinend als Koprozessor für RISC-V entwickelt wurde, aber ich konnte keine weiteren Details dazu finden.
Architektur von neuronalen Netzen mit Spikes
Link zu Überschrift
Die Frage, die bleibt, betrifft das Spiking Neural Network, oder SNN: Wie funktioniert es?
Ich habe Gemini gebeten, eine Metapher für ein achtjähriges Kind zum Thema Spiking Neural Networks zu finden. Hier ist die Geschichte, die ich erhalten habe:
Stellen Sie sich das Gehirn wie ein riesiges Postamt vor, und die „Neuronen“ sind die kleinen Boten, die die Nachrichten überbringen.
- Boten und Notizen:
In einem herkömmlichen Computerprogramm senden die Boten ständig Nachrichten und rufen Zahlen hin und her. In einem Spiking Neural Network hingegen sind die Boten sehr leise und energieeffizient: Sie senden nur dann eine kurze „Hey!“-Nachricht, wenn etwas Wichtiges passiert – wie beispielsweise ein kleiner elektrischer Impuls.
- Das Funkenmessgerät:
Jeder Bote besitzt eine Art Anzeige, die sich füllt, wenn er von anderen „Hey!“ hört. Sobald die Anzeige voll genug ist (den Schwellenwert erreicht), wird auch dieser Bote aufgeregt und ruft „Hey!“. Unmittelbar nach dem Ruf wird die Anzeige zurückgesetzt, sodass er nicht sofort wieder rufen kann (die Refraktärzeit).
- Timing ist alles:
Hört ein Bote viele „Hey!“-Rufe in schneller Folge, ist die Nachricht extrem wichtig (wie „Feuer!“). Ruft ein Bote etwas früher als die anderen „Hey!“, könnte das ein geheimes Zeichen sein, dass etwas Besonderes bevorsteht (wie „Tiger im Anflug!“). Boten müssen also die Zeit im Blick behalten.
- Lernen ist der Schlüssel:
Die Boten lernen genau wie du: Wenn Bote A “Hey!” ruft, kurz bevor Bote B “Hey!” ruft (weil etwas sie beide aufgeregt hat), wird ihre Freundschaft stärker, und die Nachricht von Bote A hilft Bote B, seine Anzeige beim nächsten Mal schneller zu füllen.
SNNs sind besonders, weil sie auf extreme Geschwindigkeit und Effizienz ausgelegt sind. Sie verschwenden keine Energie durch ständiges Datensprechen; sie werden nur aktiviert, wenn sie einen Informationsschub zu übermitteln haben! Sie helfen Computern, Zeitabläufe zu verstehen, Muster zu erkennen und verbrauchen dabei sehr wenig Strom.
Die wahre Konstruktion unter der Haube
Link zu Überschrift
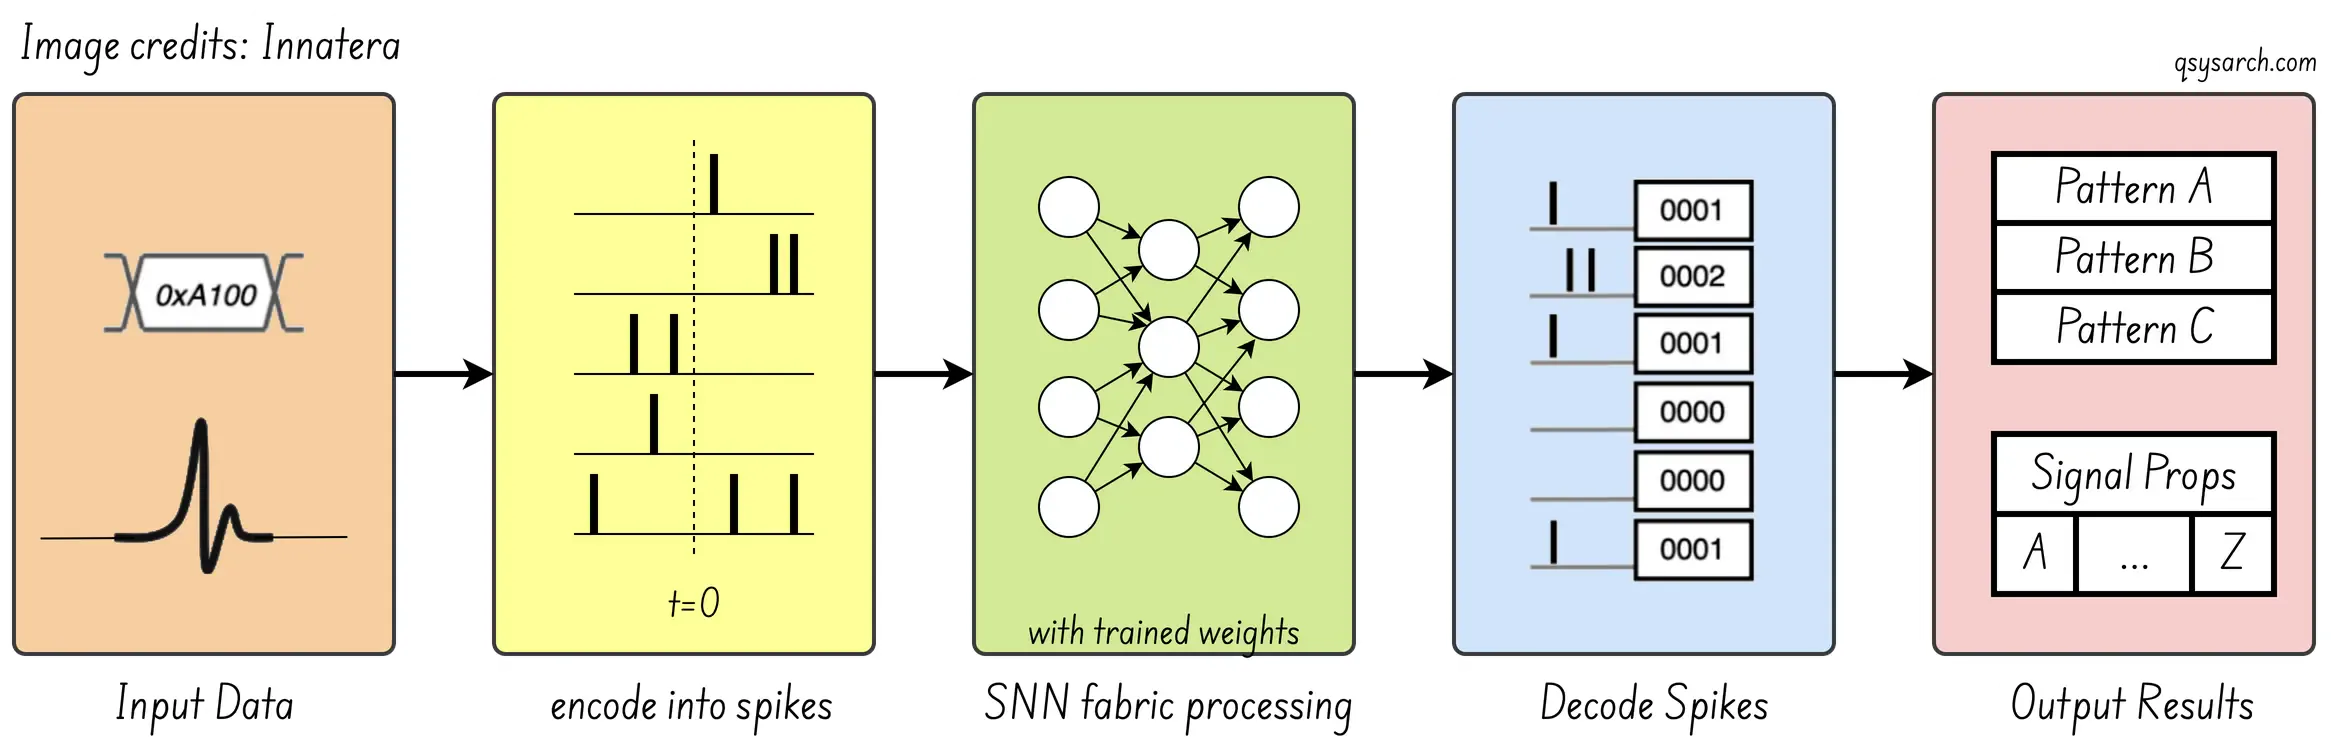
Innateras Blog „Thinking in Pulses“ (https://innatera.com/blog/thinking-in-spikes) bietet einen guten Überblick darüber, wie dies in Hardware umgesetzt werden könnte. Die „Hey“-Signale werden in Binärwerte kodiert, durch ein neuronales Netz geleitet und die Merkmale extrahiert. Soweit nichts Besonderes; es handelt sich um ein Standardverfahren für neuronale Netze.
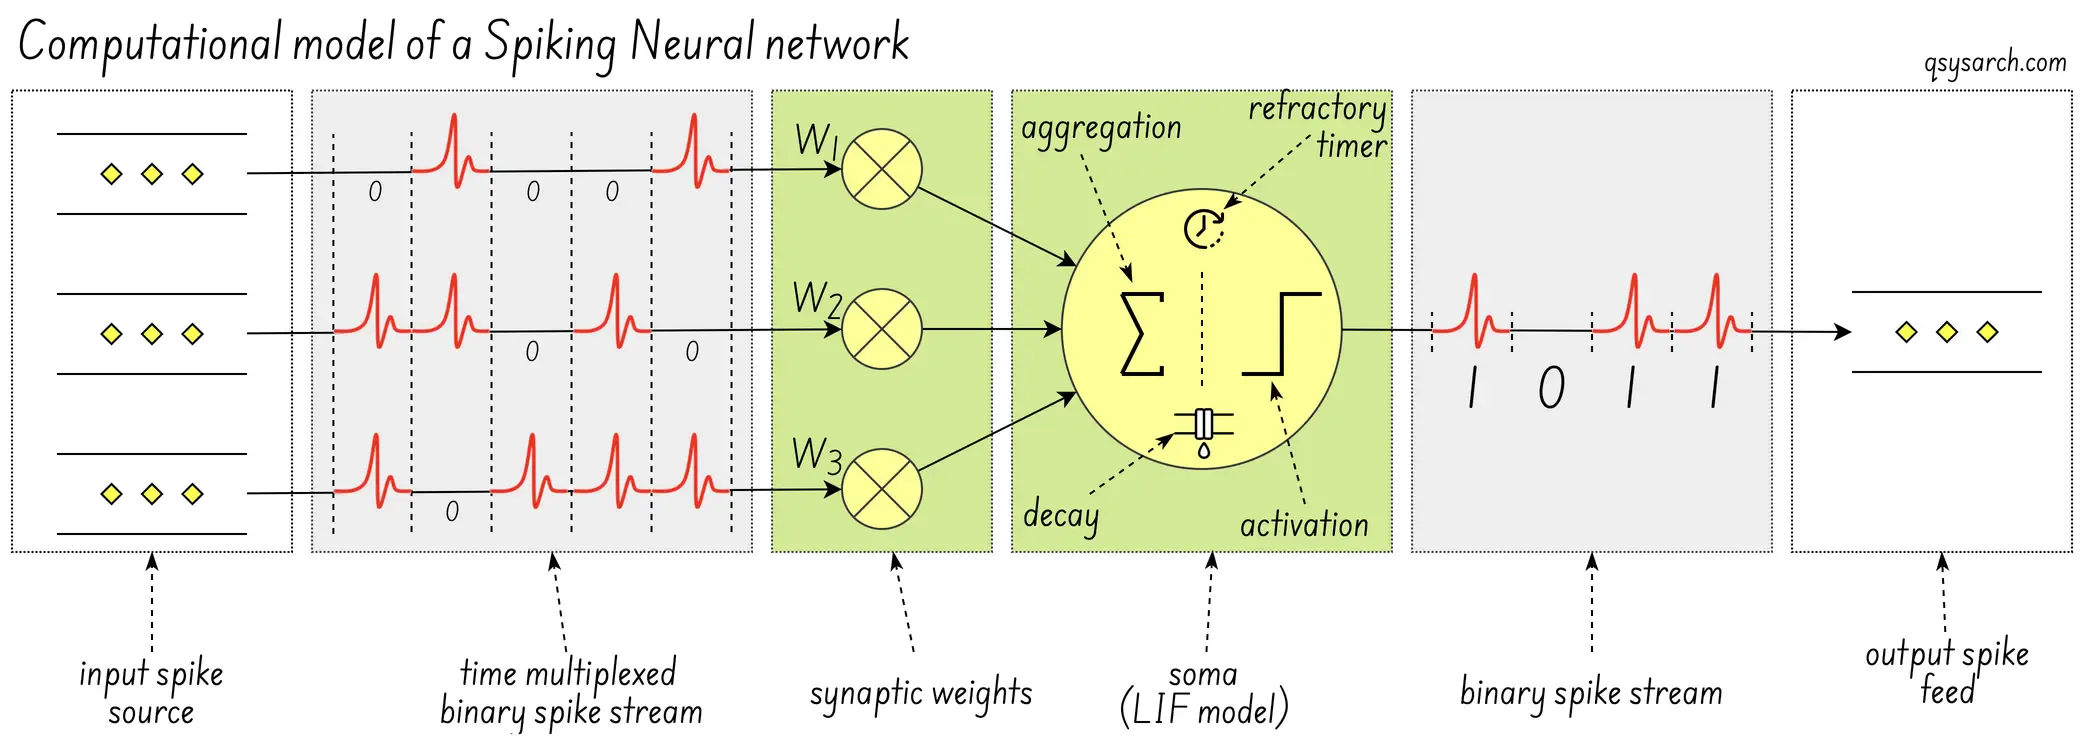
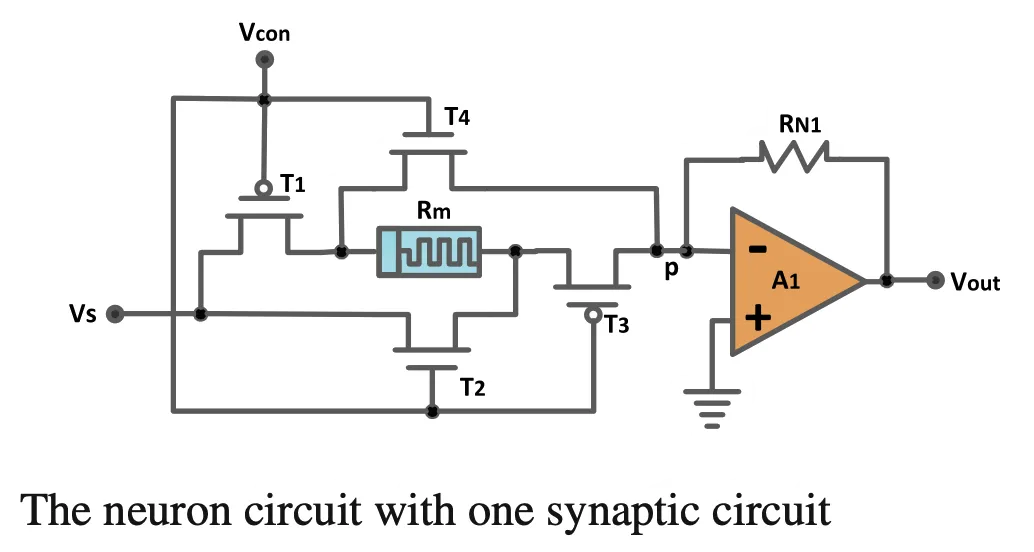
Die interessantere Frage ist, wie dieses SNN implementiert wird. Die Abbildung unten scheint ein herkömmliches „Rechenmodell“ des digitalen Neurons zu sein (Bildquelle: https://www.mdpi.com/1099-4300/27/4/333), in das ich die explizite Idee des „Leaky Integrate-and-Fire“ (LIF) innerhalb des SOMA (Self-Only Network) integriert habe.
Was macht die Hardware-Implementierung energiesparend?
Link zu Überschrift
wird noch ergänzt: Erklärungen erforderlich für
die Leistungssteigerung (10x, 1000x oder mehr?)
die erreichbaren NN-Ausbreitungslatenzen
die Kompromisse und Einschränkungen
Leistung von analogem vs. digitalem Design.
Stromverbrauch im Verhältnis zu GPUs/TPUs
Eine Frage zum Pulsar-Design lautet: Warum gibt es zwei SNNs? Die Antwort liegt darin, dass Innateras analoge (proprietäre analog-gemischte Signal-) SNN-Architektur für maximale Energieeffizienz und sehr schnelle, extrem stromsparende Ereignisverarbeitung optimiert ist. Die digitale SNN-Architektur hingegen ist programmierbarer und flexibler und unterstützt stärker konfigurierbare Netzwerke bei etwas höherem Stromverbrauch. (Quelle: https://spectrum.ieee.org/innatera-neuromorphic-chip)
Auf der Website von Innatera finden sich nicht viele Informationen über die interne Architektur ihres spikenden neuronalen Netzwerks, aber glücklicherweise besitzen sie einige Patente, die wir durch Reverse Engineering analysieren können!
| Einreichungsdatum | Publikationsnummer | Titel (abgekürzt) |
| 09.02.2021 | US20220230051A1 | Spiking Neural Network |
| 09.12.2021 | EP4505212A1 | Verfahren zur effizienten Radar-Vorverarbeitung |
| 26.01.2022 | EP4323923B1 | Hierarchisches rekonfigurierbares mehrsegmentiges spikendes neuronales Netzwerk |
| 14.02.2022 | EP4238006A2 | Verteilte synaptische Mehrkomponenten-Rechenstruktur |
| 22.03.2022 | EP4226281B8 | Anpassung von SNNs durch transiente Synchronität |
| 08.04.2022 | EP4548260A1 | Kalibrierung von spikenden neuronalen Netzen |
| 03.06.2022 | EP4562540A | System und Verfahren für effiziente, merkmalsorientierte Analog-zu-Spike-Encoder |
| 24.06.2022 | EP4573485A1 | Sequenzielle neuronale Maschine für speicheroptimierte Inferenz |
| 08.09.2022 | WO2024038102A1 | System und Verfahren für rekonfigurierbare modulare neurosynaptische Rechensysteme … |
| 18.10.2022 | WO2024153705A1 | Selbstgetaktete, vorwärtsgerichtete, synthetisierbare und technologisch skalierbare Mixed-Signal-Systeme … |
| 18.05.2023 | WO2024175770A1 | Neuromorphe Audioverarbeitungsmodule und -methoden für den Dauerbetrieb |
| 24.05.2023 | WO2024175767A1 | System und Verfahren zur Abbildung von spikenden neuronalen Netzen auf neuromorphe … |
| 19.06.2023 | WO2025012331A1 | Verfahren zum Trainieren von Modellen des maschinellen Lernens für stochastische Substrate |
| 22.06.2023 | WO2025017094A1 | Methode zum Erstellen und Bereitstellen von spikenden neuronalen Netzen auf einem Hardwaregerät |
| 23.10.2023 | WO2025021573A1 | System und Verfahren zur Anwesenheitserkennung mittels eines rahmenbasierten Sensors |
| 06.12.2023 | WO2025062034A1 | Merkmalsextraktion und Kodierung von spikenden neuronalen Netzen mittels Faltung |
| 08.03.2024 | WO2023242374A1 | Spike-Verbindung auf dem Chip, Einzelpaket-Multicast |
Das sind ganz schön viele Patente für ein Start-up! Aus Zeitgründen habe ich mir nur das erste und das letzte Patent in dieser Liste angesehen.
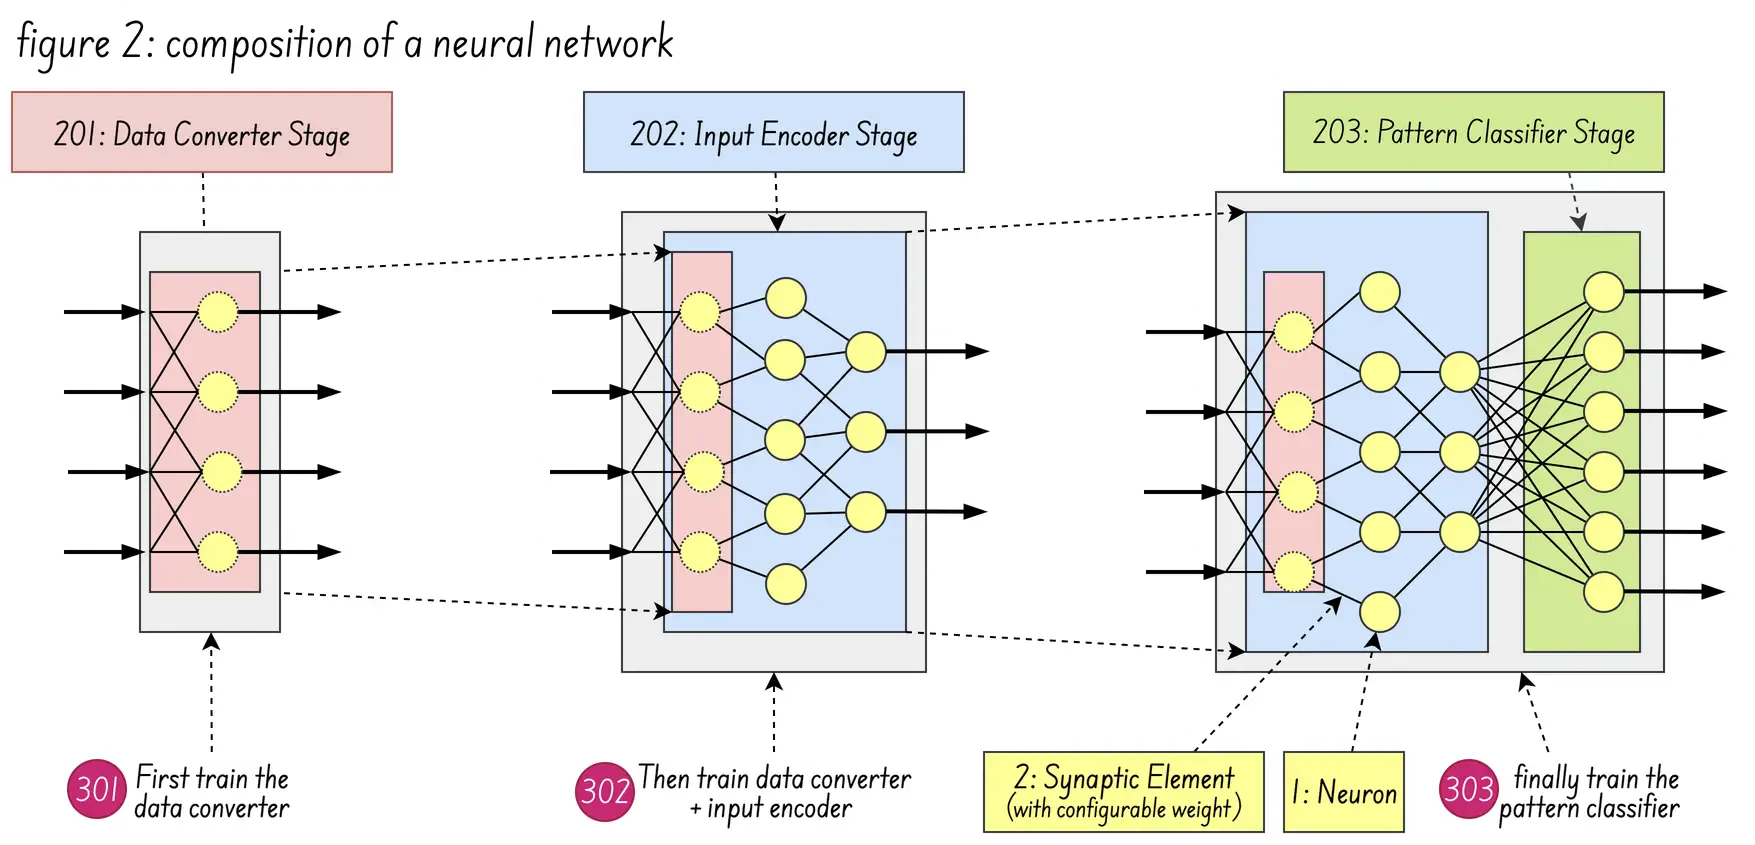
Beginnen wir mit dem ersten Patent US20220230051A1, das die eigentliche Hardware-Implementierung des SNN am besten zu beschreiben scheint: Im Mittelpunkt des Patents steht eine Kompositionsmethodik zum Aufbau von SNNs aus spezialisierten, vortrainierten Teilnetzwerken (“Zellen”) unter Verwendung eines “einzigartigen Antwortprinzips”.
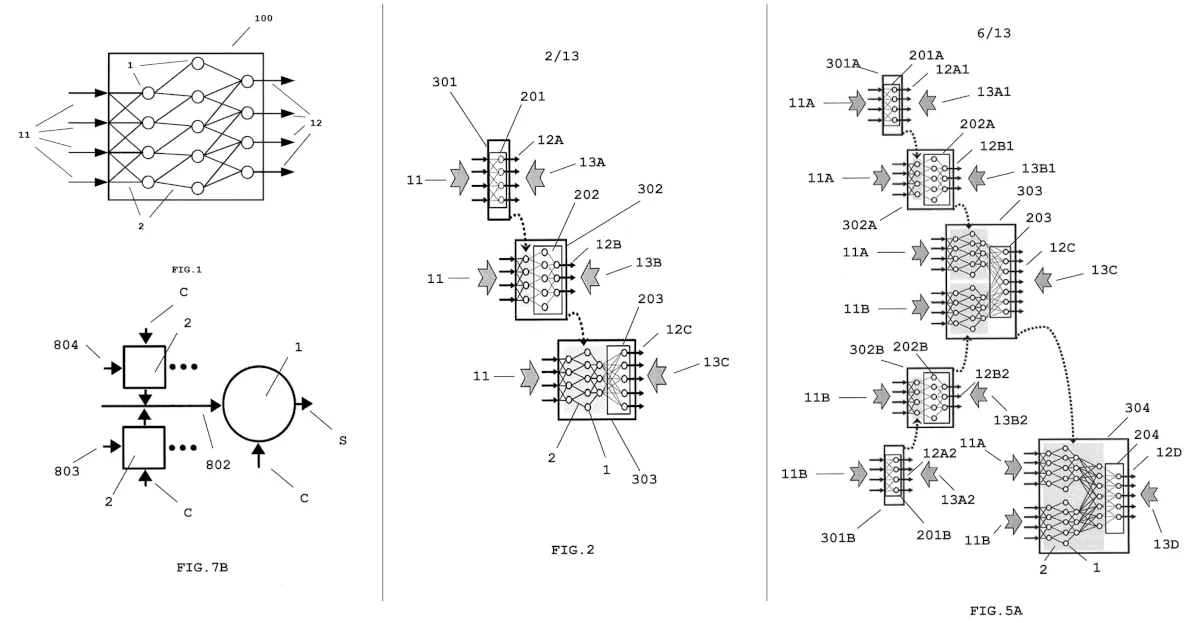
Abbildung 2 (unten) zeigt den Aufbau eines neuronalen Netzes, das aus der Integration einer Datenkonvertierungsstufe 201, einer Eingabecodierungsstufe 202 und einer Musterklassifizierungsstufe 203 besteht. Abbildung 5B (oben) veranschaulicht, wie mehrere zeitliche Spike-Züge zu einem einzigen fusionierten Spike-Zug verschmolzen werden.
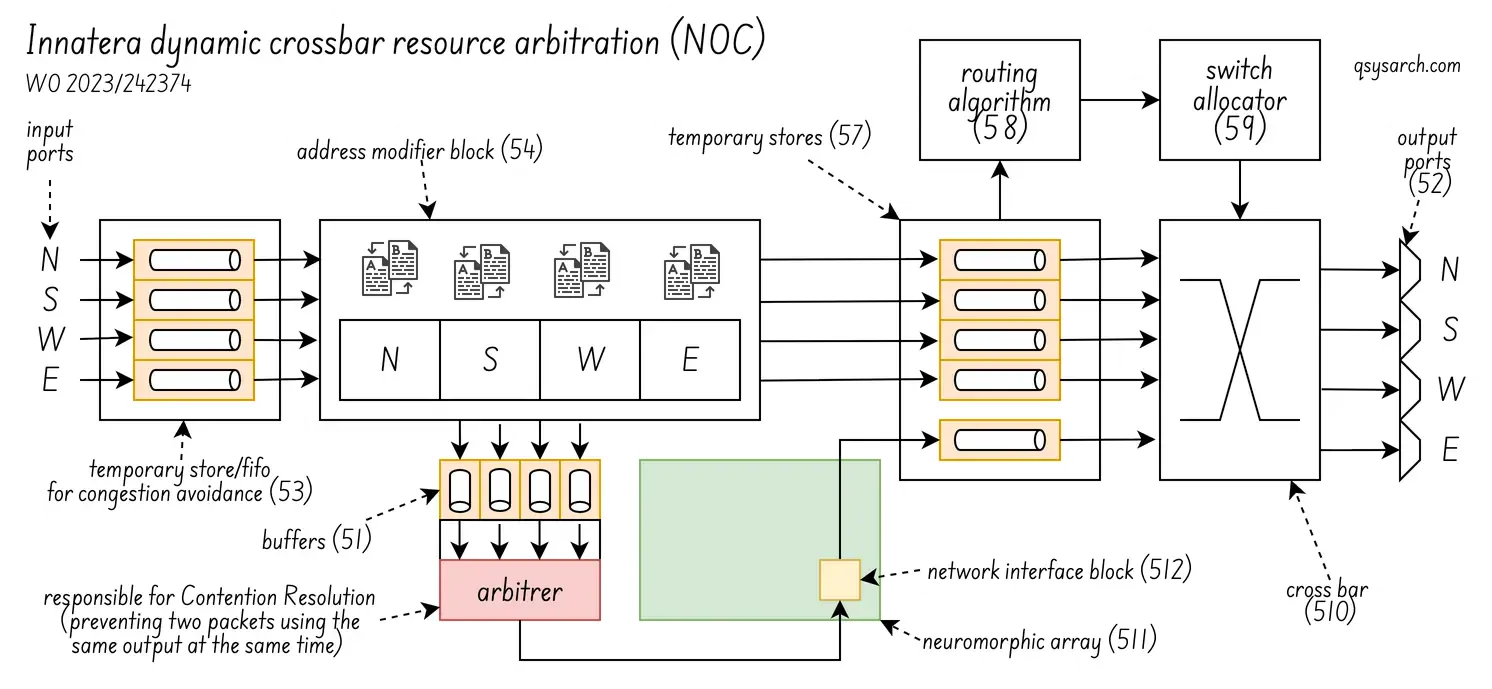
Das letzte Patent WO2023242374A1 beschreibt Innateras „Spiking Neural Network Architecture“, die zur effizienten Implementierung von Single-Packet-Multicast in Network-on-Chip-Netzwerken dient. Ziel ist die Reduzierung von Redundanz, Latenz und Overhead in Multicore-/Manycore-Systemen für die Multicast-Kommunikation.
Das untenstehende Diagramm (Abbildung 5 im Patent) veranschaulicht die Funktionsweise der NOC-Arbitrierung. Ziel ist es, zu verhindern, dass zwei oder mehr Spikes gleichzeitig an denselben Ausgangsport gesendet werden müssen. Dies ermöglicht ein effizientes Routing der Spikes in jedem Zyklus. Ich frage mich allerdings, wie tief die FIFOs in der tatsächlichen Hardware verschachtelt sind.
Mir ist nicht klar, wie der Kern und das Spike-Netzwerk zusammenhängen: Wie viele Neuronen befinden sich in einem Kern? Sind die Neuronen im Kern miteinander verbunden oder arbeiten sie zusammen? Oder handelt es sich um unabhängige Einheiten, die unabhängig voneinander Klassifizierungen parallel verarbeiten können?
Ich kenne die genaue Kernarchitektur von Innera nicht, aber es gibt zahlreiche Forschungsarbeiten, die detailliertere Informationen zu möglichen Implementierungen liefern. Besonders interessant ist die Arbeit „a system design perspective on neuromorphic computer processors “, da sie verschiedene Architekturen vergleicht.
Eine dieser Architekturen ist das „rekonfigurierbare und sehr effiziente neuromorphe System“ oder RAVENS, das im folgenden Diagramm dargestellt ist:
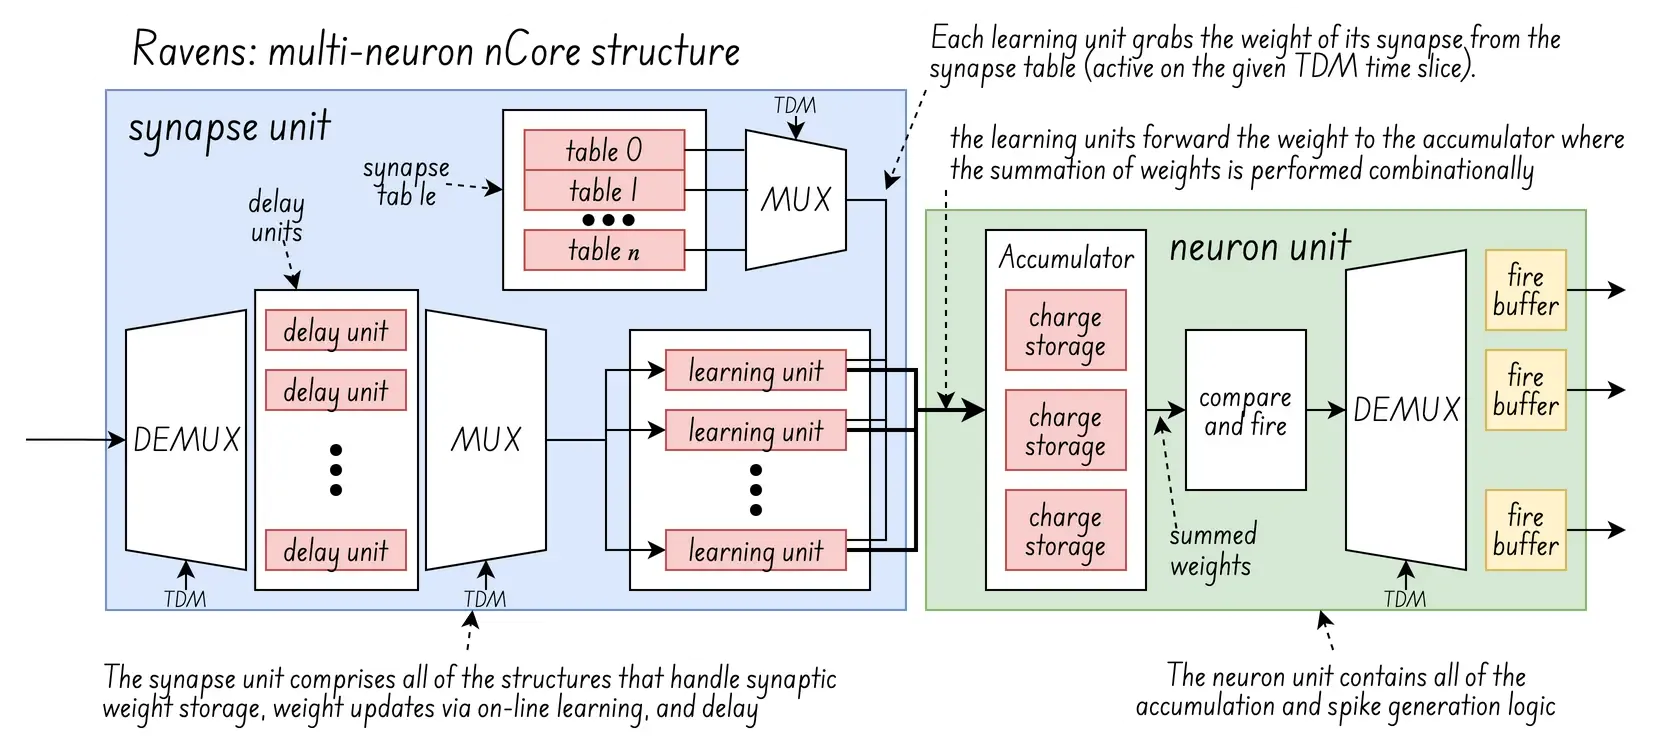 (Diagramm aktualisiert vom Originalbild: )
Die Idee hinter RAVENS besteht darin, mehrere „virtuelle Neuronen“ mithilfe von Zeitmultiplexverfahren (TDM) in einem zweistufigen Prozess aus Akkumulation und Aktualisierung zu verketten.
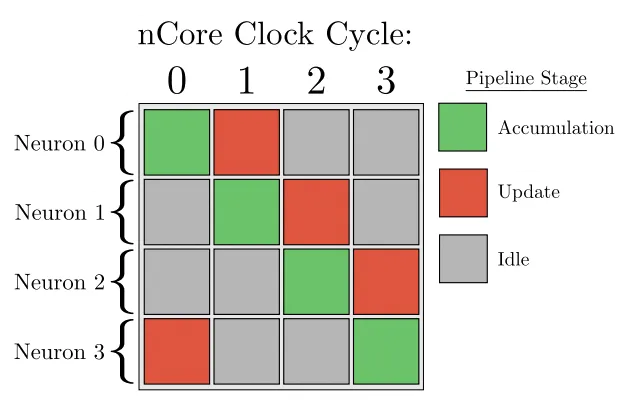
Akkumulationsphase: Ein Neuron akkumuliert Ladung von den mit ihm verbundenen Eingangssynapsen und entscheidet anhand seines programmierten Schwellenwerts und Refraktärzustands, ob ein Aktionspotenzial ausgelöst werden soll oder nicht.
Aktualisierungsphase: Berücksichtigung von Online-Lernen, Änderungen der synaptischen Gewichte, Ladungsverlusten, Erhöhungen der Refraktärzähler und akkumulierten Ladungsänderungen beim Übergang aus der Refraktärperiode.
Der interessante Aspekt hierbei ist das Online-Lernen: In neuromorphen ICs verändert das Online-Lernen synaptische Gewichte mithilfe von Algorithmen wie Hebbian-Lernen oder Reinforcement Learning, um die synaptische Stärke in Echtzeit auf der Grundlage von Eingaben von prä- und postsynaptischen Neuronen anzupassen.
Bei analogen Kernen wird diese Anpassung physikalisch durch Bauelemente wie Memristoren oder magnetische Tunnelkontakte (MTJs) realisiert, deren Widerstands- oder Leitfähigkeitszustand durch neuronale Aktivität moduliert wird und so die synaptischen Gewichte direkt repräsentiert und speichert. Bei digitalen Kernen erfolgt dies – zumindest bei RAVENS – über die Synapsentabellen.
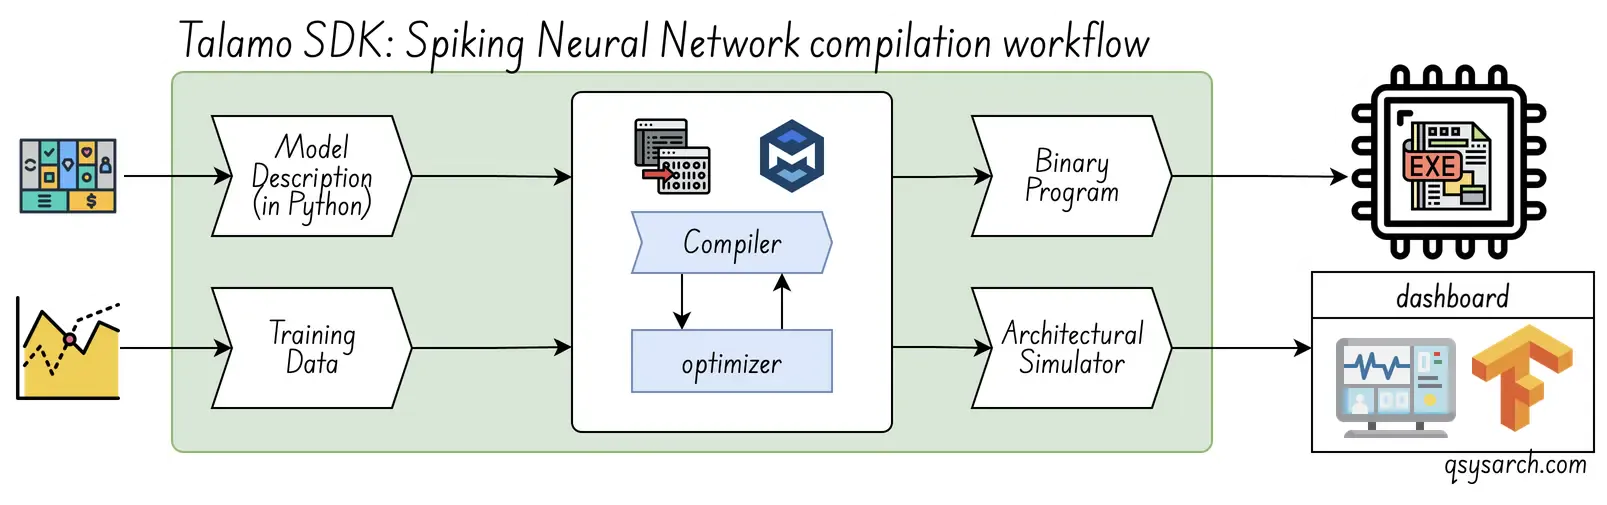
Innateras Angebot umfasst ein integriertes Talamo SDK (https://innatera.com/products/talamo-software-development-kit), das keine SNN-Kenntnisse erfordert, End-to-End-Anwendungen unterstützt und einen Standard-Workflow für Deep Learning nutzt. Mit dem Talamo-Kit können Entwickler Spiking-Modelle von Grund auf in einer PyTorch-basierten Umgebung erstellen. Es ist sofort einsatzbereit (siehe Video: https://www.youtube.com/watch?v=p9n6Pi46wT0).
Der Kompilierungsablauf ist sehr standardisiert. Das untenstehende Diagramm ist eine leicht aktualisierte Version des Originalmaterials von Innatera (https://innatera.com/products/talamo-software-development-kit), wobei davon ausgegangen wird, dass der Compiler die zentrale Komponente des Ablaufs darstellt. Ich frage mich außerdem, ob der Simulator die ausführbare Binärdatei als Eingabe verwendet. In diesem Fall würde er als Emulator bezeichnet werden (https://stackoverflow.com/questions/1584617/simulator-or-emulator-what-is-the-difference). Besonders hilfreich wären weitere Informationen zum Optimierungsprozess und ob es Parameter gibt, die vom Benutzer angepasst werden können (z. B. die Gewichtung auf 1,58 Bit reduzieren).
Sobald das Binärprogramm generiert wurde, wird dieser Ausführungsablauf verwendet und folgt mehr oder weniger dem im Patent WO2023242374A1 definierten Prozess.
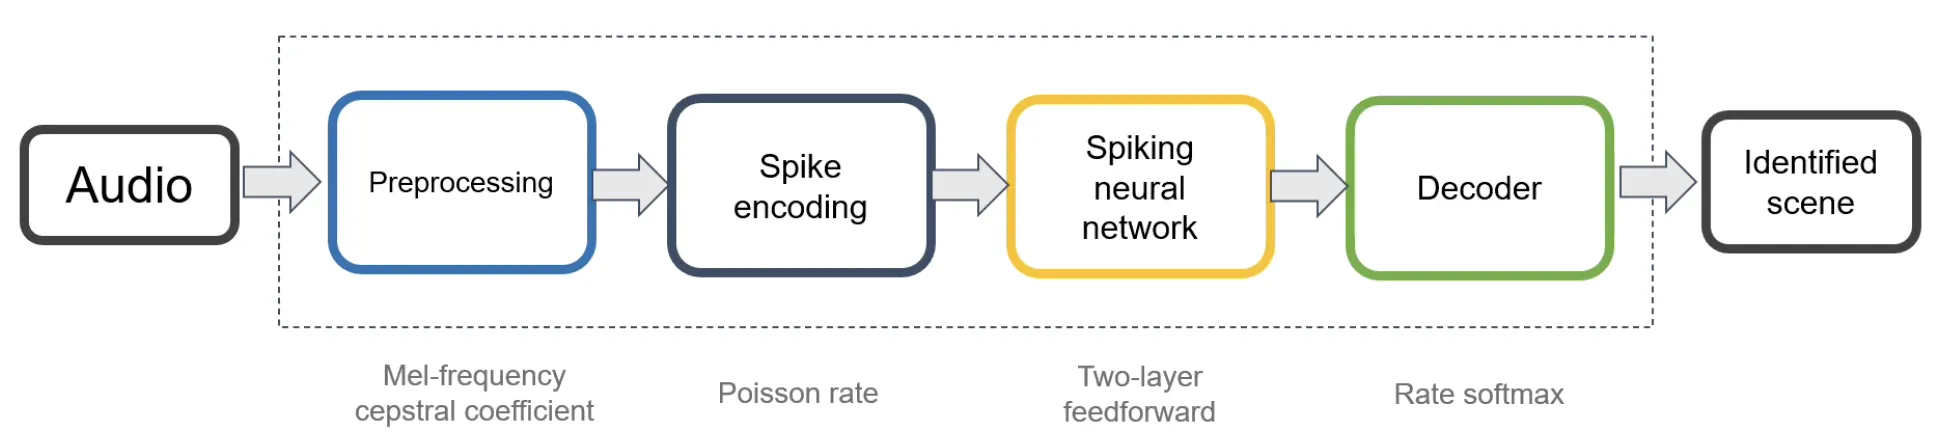
Die Hardware von Innatera umfasst einen leistungsstarken RISC-V-Prozessor, einen leistungsfähigen GEM-Prozessor und einen SFU-Rechenbeschleuniger. Für manche fortgeschrittene Anwender könnte der direkte Zugriff auf diese Hardware attraktiver sein als das bloße Laden von Gewichten in eine C-Bibliothek, die für die Architektur von Innatera geeignet ist.
Vielleicht wäre ein Open-Source-Firmware-SDK von Vorteil. Alternativ könnte man an CudaNN denken, das eine universelle neuronale Prozessoreinheit (GPNPU) bereitstellt, ähnlich wie Cuda-Q für die Quantenindustrie existiert. Und wie wäre es mit einem NVNLink, ähnlich NVQLink, der großflächige NPU-Netzwerke und Hybridarchitekturen ermöglicht?
Vielleicht ist dies gemeint in „Der Weg zum kommerziellen Erfolg neuromorpher Technologien“ : „Erst mit dem Aufkommen einfacher Programmiermodelle und -werkzeuge sowie dem unkomplizierten API-Zugriff auf die Hardware konnten sich Tensorprozessoren weit verbreiten.“ Sollte man Tensorprozessoren einfach durch neuromorphe Verarbeitungseinheiten (NPUs) ersetzen?
Für mich läuft das im Kern auf Benutzererfahrung (UX) und Entwicklererfahrung (DX) hinaus. Und ich bin fest davon überzeugt, dass Benutzerfreundlichkeit und Entwicklererfahrung zu den Schlüsselfaktoren bzw. strategischen Säulen für die Schaffung wirklich herausragender Produkterlebnisse gehören.
 (Bildnachweis: archi monarch)
Damit wäre diese kurze Abhandlung zur Architektur neuromorpher ICs abgeschlossen. Zweifellos stellt diese Hardwarearchitektur eine alternative, leistungsstarke Technologie mit erheblichem Potenzial dar. Man könnte jedoch argumentieren, dass neuromorphen ICs eine bahnbrechende Anwendung fehlt. Aber ist das nicht gerade das Spannende an neuromorphen ICs? Bedeutet das, dass die damit verbundene Welt erst geschaffen werden muss?
Ich bin überzeugt, dass das Team von Innetera zu denjenigen gehört, die die Welt anders sehen. Und angesichts der Bedenken hinsichtlich des enormen Energiebedarfs von KI-Rechenzentren: Sind neuromorphe ICs nicht eine Antwort auf die zentrale Frage: Wie lässt sich mit weniger Energie mehr Wert gewinnen? Wenn ja, was ist dann nötig, um die neuromorphen ICs so zu skalieren, dass sie die Rechenleistung erreichen, die KI-Rechenzentren benötigen?
Ich frage mich außerdem, ob die Integration von Silizium-Photonik (siehe https://prucnal.princeton.edu/research/photonic-spiking-neural-networks) in das SNN hilfreich wäre. Dies könnte sowohl die neuronale Datenverarbeitung verbessern als auch die Schaffung eines großflächigen Verbindungsnetzwerks zwischen den SNN-ICs ermöglichen.
In diesem Memo verwendete DrawIO-Diagramme: